为什么同一个 AI 角色会在不同漫画分镜中变脸、换衣服或改变发型?
2026-08-13
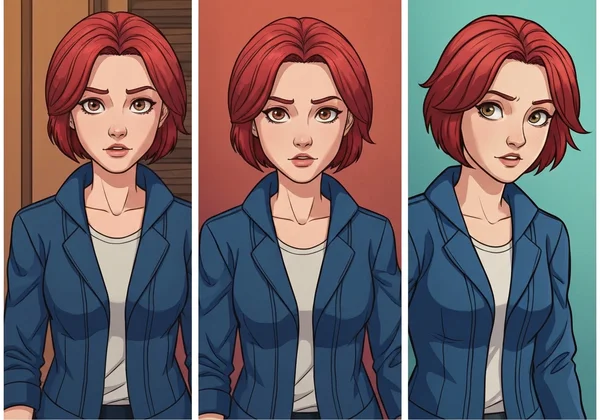
究竟是什么导致分镜间的身份漂移——提示词措辞还是模型架构?
AI 漫画中的角色漂移是架构限制,而不是提示词写错了——文生图模型会将每个分镜作为彼此独立的采样事件生成,且不会记忆先前的输出。因此,诸如“红发侦探,穿风衣”这样的描述,每次都会解析为一个在统计上合理的人物,而不是同一个人物。最可靠的修复方式,是通过参考图和资产系统传递身份,而非在每个分镜中重新用文字描述:从不同角度看,ComicInk、LTX Studio、Figma Weave 和 Jenova 的 Comic Creator 都遵循这一原则。
具备抗漂移能力的工作流与容易漂移的工作流,主要区别在于:
✅ 参考图锚定生成——身份由图像资产承载,而不是在每个分镜中用文字重新描述
✅ 属性解耦——脸部、头发、服装和背景可独立锁定,场景变化不会重新洗牌角色特征
✅ 前景/背景分离——研究表明,即使脸部保持稳定,背景细节仍会漂移(CharaConsist,ICCV 2025)
✅ 词汇纪律——“棕色风衣”必须始终写作“棕色风衣”,不能改成“外套”或“夹克”
✅ 动作容忍度——角色一旦改变姿势或动作,一致性方法的效果会急剧下降
要诚实地评估任何工具或工作流,首先应理解隐藏在“我的角色看起来不一样了”这一症状背后的四种不同失效机制。
角色漂移的四种技术原因是什么?
角色漂移有四种可分离的原因,每种都需要不同的解决方案。将它们视为同一个问题,正是大多数创作者不断微调提示词却始终无法彻底解决的原因。
1. 没有记忆机制。 每次生成都是独立事件。LTX Studio 的工程分析说得很直接:模型“无法‘记住’先前生成的角色特征”,因此每次渲染都会从文本描述重新开始。提示词是一种概率分布,而不是规格说明——“绿色眼睛、三十多岁”可以描述数百万张符合条件的脸。
2. 风格与身份纠缠。 模型难以区分角色是谁与图像看起来如何。如果在分镜之间改变美术方向——例如改用戏剧化光照或更广的镜头——脸部几何特征也会随之变化,因为模型并未学会这些是相互独立的变量。
3. 视角与 3D 推理缺口。 从新角度渲染同一个人,需要模型具备它并不拥有的隐式 3D 理解。这也是侧脸和背面视角最容易漂移的原因,也是 LTX 特别建议使用正面参考图以提升后续灵活性的原因。
4. 注意力分散。 模型必须在角色、服装、背景和风格之间同时分配有限的注意力。叙事复杂度一增加,角色细节就会在竞争中落败。
🎯 为什么服装比脸部更容易漂移?
服装是讨论最少的失效模式。ICCV 2025 的 CharaConsist 论文发现,包括 IP-Adapter 和 PhotoMaker 在内的身份参考方法“仅专注于保留面部身份,无法确保服装或场景等其他属性的一致性”。锁脸工具可以让脸保持稳定,同时夹克颜色改变、衣领样式重置、配饰消失——因为这些系统从未被训练来保留这些细节。
现有方法实际能达到多高的一致性?
可量化的一致性确实存在,但并不完整——没有任何方法能够完全锁定身份,而数据准确展示了各类方法会在哪些环节失效。CharaConsist 团队使用 CLIP 图像相似度进行基准测试,并将其拆分为前景(CLIP-I-fg)和背景(CLIP-I-bg)部分,同时加入面部嵌入相似度(ID Sim)。
其报告结果显示,在背景保持任务中,CharaConsist 的 CLIP-I-fg 为 0.883、CLIP-I-bg 为 0.916;相比之下,ConsiStory 分别为 0.876 和 0.895。差距在背景一致性上尤其明显——而这正是大多数方法完全忽略的维度。
在同一篇论文报告的人类偏好研究中,评估者在服装一致性上有 64% 的时间选择 CharaConsist 而非基线方法,在背景一致性上则高达 98%;但文本对齐偏好仅为 57%——这表明锁定身份与遵循提示词之间存在可量化的权衡。
这种权衡是整个类别的核心矛盾。每一种一致性机制都会限制生成器,而限制会降低其对提示词的响应能力。论文自身的消融实验表明,应用 CharaConsist 后的 FLUX.1,其 CLIP-T(文本对齐)得分反而低于未修改的基础模型。
📊 动作难题
一致性方法会在运动情况下退化。CharaConsist 作者直接指出:“当前景角色经历较大的动作变化时,身份和服装细节的不一致会变得明显。”对于以角色奔跑、打斗、比划和反应为基础的漫画而言,这正是最严苛的限制。对话头像式分镜的稳定性远高于动作分镜;任何仅测试静态肖像的工具对比,都会夸大其现实表现。
有哪些可用方法,它们如何比较?
目前存在四种不同的架构路径,它们都围绕同样的三个维度进行取舍:设置成本、一致性强度与创作灵活性。
| 维度 | 通用生成器(Midjourney、DALL·E) | ComfyUI + IP-Adapter/ControlNet | 参考资产平台(LTX、Figma Weave、ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| 一致性机制 | 复用 Seed + 重复提示词 | 训练适配器、LoRA、面部嵌入 | 每次生成重复使用保存的角色资产 | 持久化对话记忆 + 已保存的角色定义 |
| 脸部一致性 | 弱——用户报告中最主要的失败点 | 强;IP-Adapter FaceID 针对身份进行了优化 | 强;由资产锚定 | 对已定义角色较强;随所选模型而异 |
| 服装一致性 | 弱 | 弱——身份参考方法中已有文献记录的缺口 | 通过服装变体处理(LTX 的复制并修改方式) | 通过会话记忆中的明确角色设定表维持 |
| 姿势/动作灵活性 | 高,但不一致 | 中等;ControlNet 提供姿势控制 | 中等;正面参考偏好限制了角度 | 中等;极端动作时漂移增加 |
| 本地硬件 | 无需 | 取决于卸载模式,需要 3–37 GB VRAM | 无需 | 无需 |
| 定价 | Midjourney/DALL·E 订阅套餐 | 软件免费;需承担硬件和电力成本 | Figma Weave 免费层 + 付费套餐;ComicInk 提供免费 4 页试用 | 免费层;Plus 为 $20/月,额度为免费版的 30× |
| 最适合 | 单张高冲击力图像、概念艺术 | 需要最大控制力的技术型创作者 | 需要将固定角色阵容标准化的团队 | 以故事优先、通过对话创作多分镜叙事的创作者 |
通用生成器
Midjourney 和 DALL·E 能提供最高的单图美学质量,却也带来最差的跨分镜一致性。创作者论坛持续记录着相同模式——用户称其“无法在整个作品中保持相同甚至相似的角色”。OpenAI 开发者社区有一个关于角色一致性和风格锁定的公开请求帖,明确要求在不同请求中保留“面部特征、体型、肤色、服装和姿势”。复用 Seed 和单一源图锚定确实有帮助——Midjourney 实践者报告,坚持使用一张源图加固定 Seed 时,服装稳定性会更好——但两种方式都无法保证身份一致。
ComfyUI 适配器堆栈
技术上限最高,学习曲线也最陡。IP-Adapter 保留外观和风格,ControlNet 控制结构;实践者会将两者结合使用,因为单独使用任何一个都不足够。CharaConsist 仓库清楚说明了硬件现实:单 GPU 运行需要 37 GB VRAM,只有使用顺序 CPU 卸载并付出严重速度代价时,才可降至 3 GB。这条路径仅从硬件条件来看,就排除了大多数漫画创作者。
参考资产平台
这是务实的中间路径。LTX Studio 的 Elements 系统会将角色保存为持久化、可标记的资产,并通过 @ 提及调用。Figma Weave 采用节点式方法,认为“一致性来自结构,而非偶然”。ComicInk 会先生成角色参考图,再将其附加到每一次页面渲染中。三者都做出了同样的架构选择:不要再描述角色,开始引用角色。
如何在实际漫画制作中防止漂移?
最具杠杆作用的改变,是在生成任何分镜之前,将角色从一段描述转换为一项资产。其他一切都只是优化。
通用前期制作步骤:
- 先制作角色设定表。 在第一个分镜出现前,用一张规范渲染图锁定脸部、发型、体型、服装和配色。
- 固定你的词汇。 LTX 的建议非常明确:“‘棕色风衣’在后续描述中应始终写作‘棕色风衣’,而不是‘外套’或‘夹克’。”同义词漂移会导致视觉漂移。
- 使用正面、光线中性的参考图。 定向阴影和侧面角度会被固化进参考图,并与后续场景发生冲突。
- **有意识地创建服装变体,**而不是重新描述服装。LTX 的做法是复制角色,只编辑服装字段,从而在
@Sarah_casual和@Sarah_formal之间保留面部身份。
**在 Jenova 的 Comic Creator 中,**会话的持久化记忆负责完成锚定工作——你在对话中只需建立一次角色,智能体便会将该定义延续到后续内容:
“为 Mara Voss 创建角色设定表:34 岁,轮廓分明的下颌线,银色短寸发,褪色的橄榄绿野战夹克,左袖口破损,深灰色工装裤。中性表情,正面视角,柔和均匀的工作室光线,纯色中性背景。西式漫画墨线风格。”
之后,在每个分镜中引用角色,而不是重新描述:
“分镜 3:Mara Voss——沿用相同角色设定表,穿相同的橄榄绿野战夹克,左袖口破损——蹲在一辆翻倒的汽车后方,向左看。脸部、头发和服装必须与设定表完全一致。”
**在 LTX Studio 中,**对应流程为:打开 Elements → Create New Element → Character → 上传 5–12 张参考图或生成一张 → 命名 → 然后在每个镜头提示词中标记 @CharacterName。对已保存 Element 的更新会自动传播到每一次被标记的出场。
**在 ComfyUI 中,**你需要构建一个图形工作流:为身份加载 IP-Adapter FaceID 节点,为姿势结构串联 ControlNet,并且要么在角色数据上训练 LoRA,要么在所有渲染中使用一张固定参考图作为身份来源。
⚠️ 哪些做法行不通?
在提示词中添加“角色一致”或“和之前是同一个人”毫无作用。模型并不存在“之前”的记忆。社区对这一失败模式的描述非常直白:“大多数人只告诉 AI 想要什么”,却没有提供系统能够锁定的参考图。文本无法弥补记忆机制的缺失。
即使角色稳定,为什么背景仍会漂移?
背景会漂移,是因为几乎所有一致性方法都只针对前景主体进行优化,导致环境在每个分镜中自由重新生成。CharaConsist 作者将其指出为既有工作的核心缺口:现有免训练方法“无法维持一致的背景细节,这限制了它们的适用性”。
量化代价十分显著。在人类偏好研究中,背景一致性是差距最大的维度——针对该问题进行明确处理的方法获得了 98% 的偏好,而两个基线方法分别仅获 2% 和 0%。这不是边际改进;它表明基线方法基本没有尝试保存背景。
对漫画而言,这比对单张插画更重要。一段发生在同一厨房、跨越两页的对话,需要让那个厨房始终是同一个厨房。当橱柜颜色在分镜之间变化时,即使读者说不清原因,也会觉得场景不连续。
CharaConsist 的技术修复方案,是从注意力差异中推导前景—背景蒙版,从而实现“对前景和背景一致性的解耦控制”——你可以在连续序列中固定场景,也可以在切换地点时有意释放它。大多数消费级工具并未开放这种控制,因此实际可行的替代方案是单独生成建立场景的背景,并在整个序列中将其作为图像参考复用。
锁定角色时应预期哪些取舍?
每一项一致性提升都会让你付出代价,最常见的两项代价是提示词响应能力和场景多样性。理解这一点,可以避免不断加强约束后却困惑于模型为何不再遵循指令的挫败循环。
一致性与提示词遵循度。 CharaConsist 的消融研究在这一点上异常坦率:将一致性方法应用于 FLUX.1 后,相较基础模型,CLIP-T 文本对齐得分降低。偏好测试中,文本对齐仅为 57%,是所有测量维度中最弱的一项。强参考锚定会将生成结果拉向参考图,并使其偏离你的新指令。
参考图偏向与角度范围。 正面参考图能最大化后续复用性,但也会让模型偏向输出正面视角。要从被正面锁定的角色得到真正的三分之四视角或俯视分镜,必须与这种锚定倾向对抗。
静态保真度与动作。 一致性基准通常在相对稳定的场景中测量。漫画需要运动,而 CharaConsist 论文明确指出,运动正是一致性退化最明显的地方。
前期投入与灵活性。 ComfyUI 的 LoRA 和适配器工作流提供了最高上限,但实践者也指出了实际负担——一位工作流作者谈到,不必“保存每个角色检查点文件”这一点很有吸引力,这意味着大多数工作流恰恰需要这样做。
实践者如何评价这项技术的真实水平?
在构建生产级漫画工作流的人群中,普遍共识是:参考锚定已经解决了大部分问题,剩余失败主要集中在动作和服装上。
“大多数人从第一个分镜开始,对 AI 漫画的理解模型就错了。他们将提示词视为模型会阅读并执行的规格表。其实不是——它是一种采样约束。当你写下‘红发侦探’时,你只是将可能脸孔的空间从数十亿缩小到了数百万,而不是缩小到一个人。每个分镜都是从这个缩小后的空间中重新抽取一次。一旦创作者真正理解这一点,他们就会停止反复改写提示词,转而构建参考资产,问题也就基本消失了。”
“让人意外的是,脸部反而是容易的部分。多种架构中都已经存在训练充分、效果很强的锁脸方案。顽固的是服装,因为服装的自由度比脸更高,而专门用于保留服装的训练信号却少得多。在我们自己的测试中,一个角色能在十二个分镜里保持同一张脸,但夹克的衣领会悄悄变三次。我们会告诉创作者,应将服装视为带有固定词汇的命名实体——例如明确写出左袖口破损——而不是泛泛描述。具有辨识度、可以命名的细节更容易保留下来;笼统的细节则不会。”
“没有人宣传的诚实限制是动作。一致性基准是在相对稳定的镜头上运行的。漫画却不是静态构图——其中有人正在出拳、跌倒、冲刺。而这恰恰是每一种现有方法都会失去控制力的地方。如果你计划制作打斗序列,应为迭代留出预算,并考虑将序列锚定在一张广角建立场景分镜上,而不是期待八个彼此独立的动作分镜能自然统一。”
— Jenova 产品团队,拥有 6 年多分镜 AI 生成工作流构建经验
哪种方法适合你的情况?
正确的工具取决于三个变量:你的技术能力、所需分镜数量,以及故事生成是否与图像生成同等重要。
如果你只需要少量高冲击力图像,并且能够接受视觉不一致,或者你创作的是概念艺术而非连续叙事,请选择通用生成器。就纯图像美学而言,Midjourney 仍是最强选择。
如果你可以使用 GPU、有技术耐心,并且需要最大程度的控制——尤其是当你的产量足以证明训练角色 LoRA 是值得的——请选择搭配 IP-Adapter 和 ControlNet 的 ComfyUI。FaceID Plus V2 工作流是当前实用标准。
如果你会反复创作固定角色阵容,并希望进行集中式资产管理,请选择参考资产平台。Figma Weave 适合共享角色标准的团队;LTX Studio 适合与视频相邻的工作;ComicInk 适合快速端到端漫画产出。
如果你的瓶颈既在故事也在美术,请选择 Jenova 的 Comic Creator——该智能体会在同一对话线程中处理剧本、分镜拆解和生成,会话记忆则会在长项目中持续传递角色定义。它可通过 jenova.ai/a/comic-creator 使用。对于纵向滚动格式,Webtoon Creator 可处理章节结构和滚动节奏;Manga Creator 则覆盖黑白分镜惯例。这里同样存在诚实的限制:极端动作姿势和复杂的多角色分镜仍需要迭代,平台也没有开放研究级方法所提供的前景/背景蒙版控制。免费层包含有限使用额度;Plus 为 $20/月,额度为该额度的 30×。
无论选择哪条路径,底层原则都是相同的。角色一致性是一个披着提示词工程外衣的资产管理问题。 先构建参考图,为每个独特细节命名,重复使用相同词汇,并接受动作分镜必然需要更多尝试。
参考资料
- CharaConsist:细粒度一致角色生成——包含基准数据和人类偏好研究的 ICCV 2025 论文
- CharaConsist GitHub 仓库——官方实现与硬件要求
- LTX Studio——如何创建一致的 AI 角色,包括 AI 生成的四项技术限制
- OpenAI 开发者社区——图像生成中的角色一致性与风格锁定需求
- ComicInk——2026 年最佳 AI 漫画生成器,比较不同生成方法
- Figma Weave——AI 一致角色生成器,基于节点的一致性方法
- Medium——尝试 ControlNet 和 IPAdapter 后,我如何在 ComfyUI 中解决角色一致性问题
- RunComfy——IPAdapter FaceID Plus V2 一致角色工作流
- Medium——如何处理 Midjourney 中与角色一致性有关的所有因素
- 关于 AI 角色生成中发型、下颌线和肤色为何漂移的社区讨论