哪款 AI 漫画助手最适合角色设定表与一致姿势?
2026-08-14
为什么先做设定表的工作流优于仅靠提示词生成角色?
最出色的结果来自于将角色设定表视为可长期保留的参考资产,而非一次性生成结果的工具。按这一标准,Jenova 的 Manga Creator、Midjourney 和 ComfyUI 的 ControlNet + IPAdapter 工作栈分属三个截然不同的层级。仅靠提示词的生成方式难以扩展,因为每次出图都会根据文字重新塑造角色;先做设定表的工作流则能将面部结构、服装细节与比例固定到一张可持续调用的图像中。
决定一款工具能否让角色稳定贯穿 40 个分镜,而不是到第六格就开始跑偏的,有四项因素:
✅ 参考持续性 —— 工具是否能跨会话保存你的设定表,还是每次提示都需要重新上传 ✅ 姿势/表情解耦 —— 是否能在不让模型重新生成面部的前提下改变身体姿势 ✅ 多视角生成 —— 是否能在一次连贯生成中产出正面、侧面、3/4 和背面视图 ✅ 角色权重控制 —— 是否能针对每次生成调节输出对参考图的遵循强度
这四个维度构成了本文的评估框架。它们之所以重要,是因为漫画项目不是一组图像画廊,而是一个连续性问题;而连续性失误会随着页数不断累积。
角色设定表究竟是什么,为什么 AI 需要它?
角色设定表是一份多视角参考文件,展示同一角色的正面、侧面、三分之四角度和背面,通常采用固定姿势、中性光照和一致比例。AI 模型需要它,是因为生成系统若没有一张锚定图像,便不会在不同生成任务之间保有角色的内部记忆。
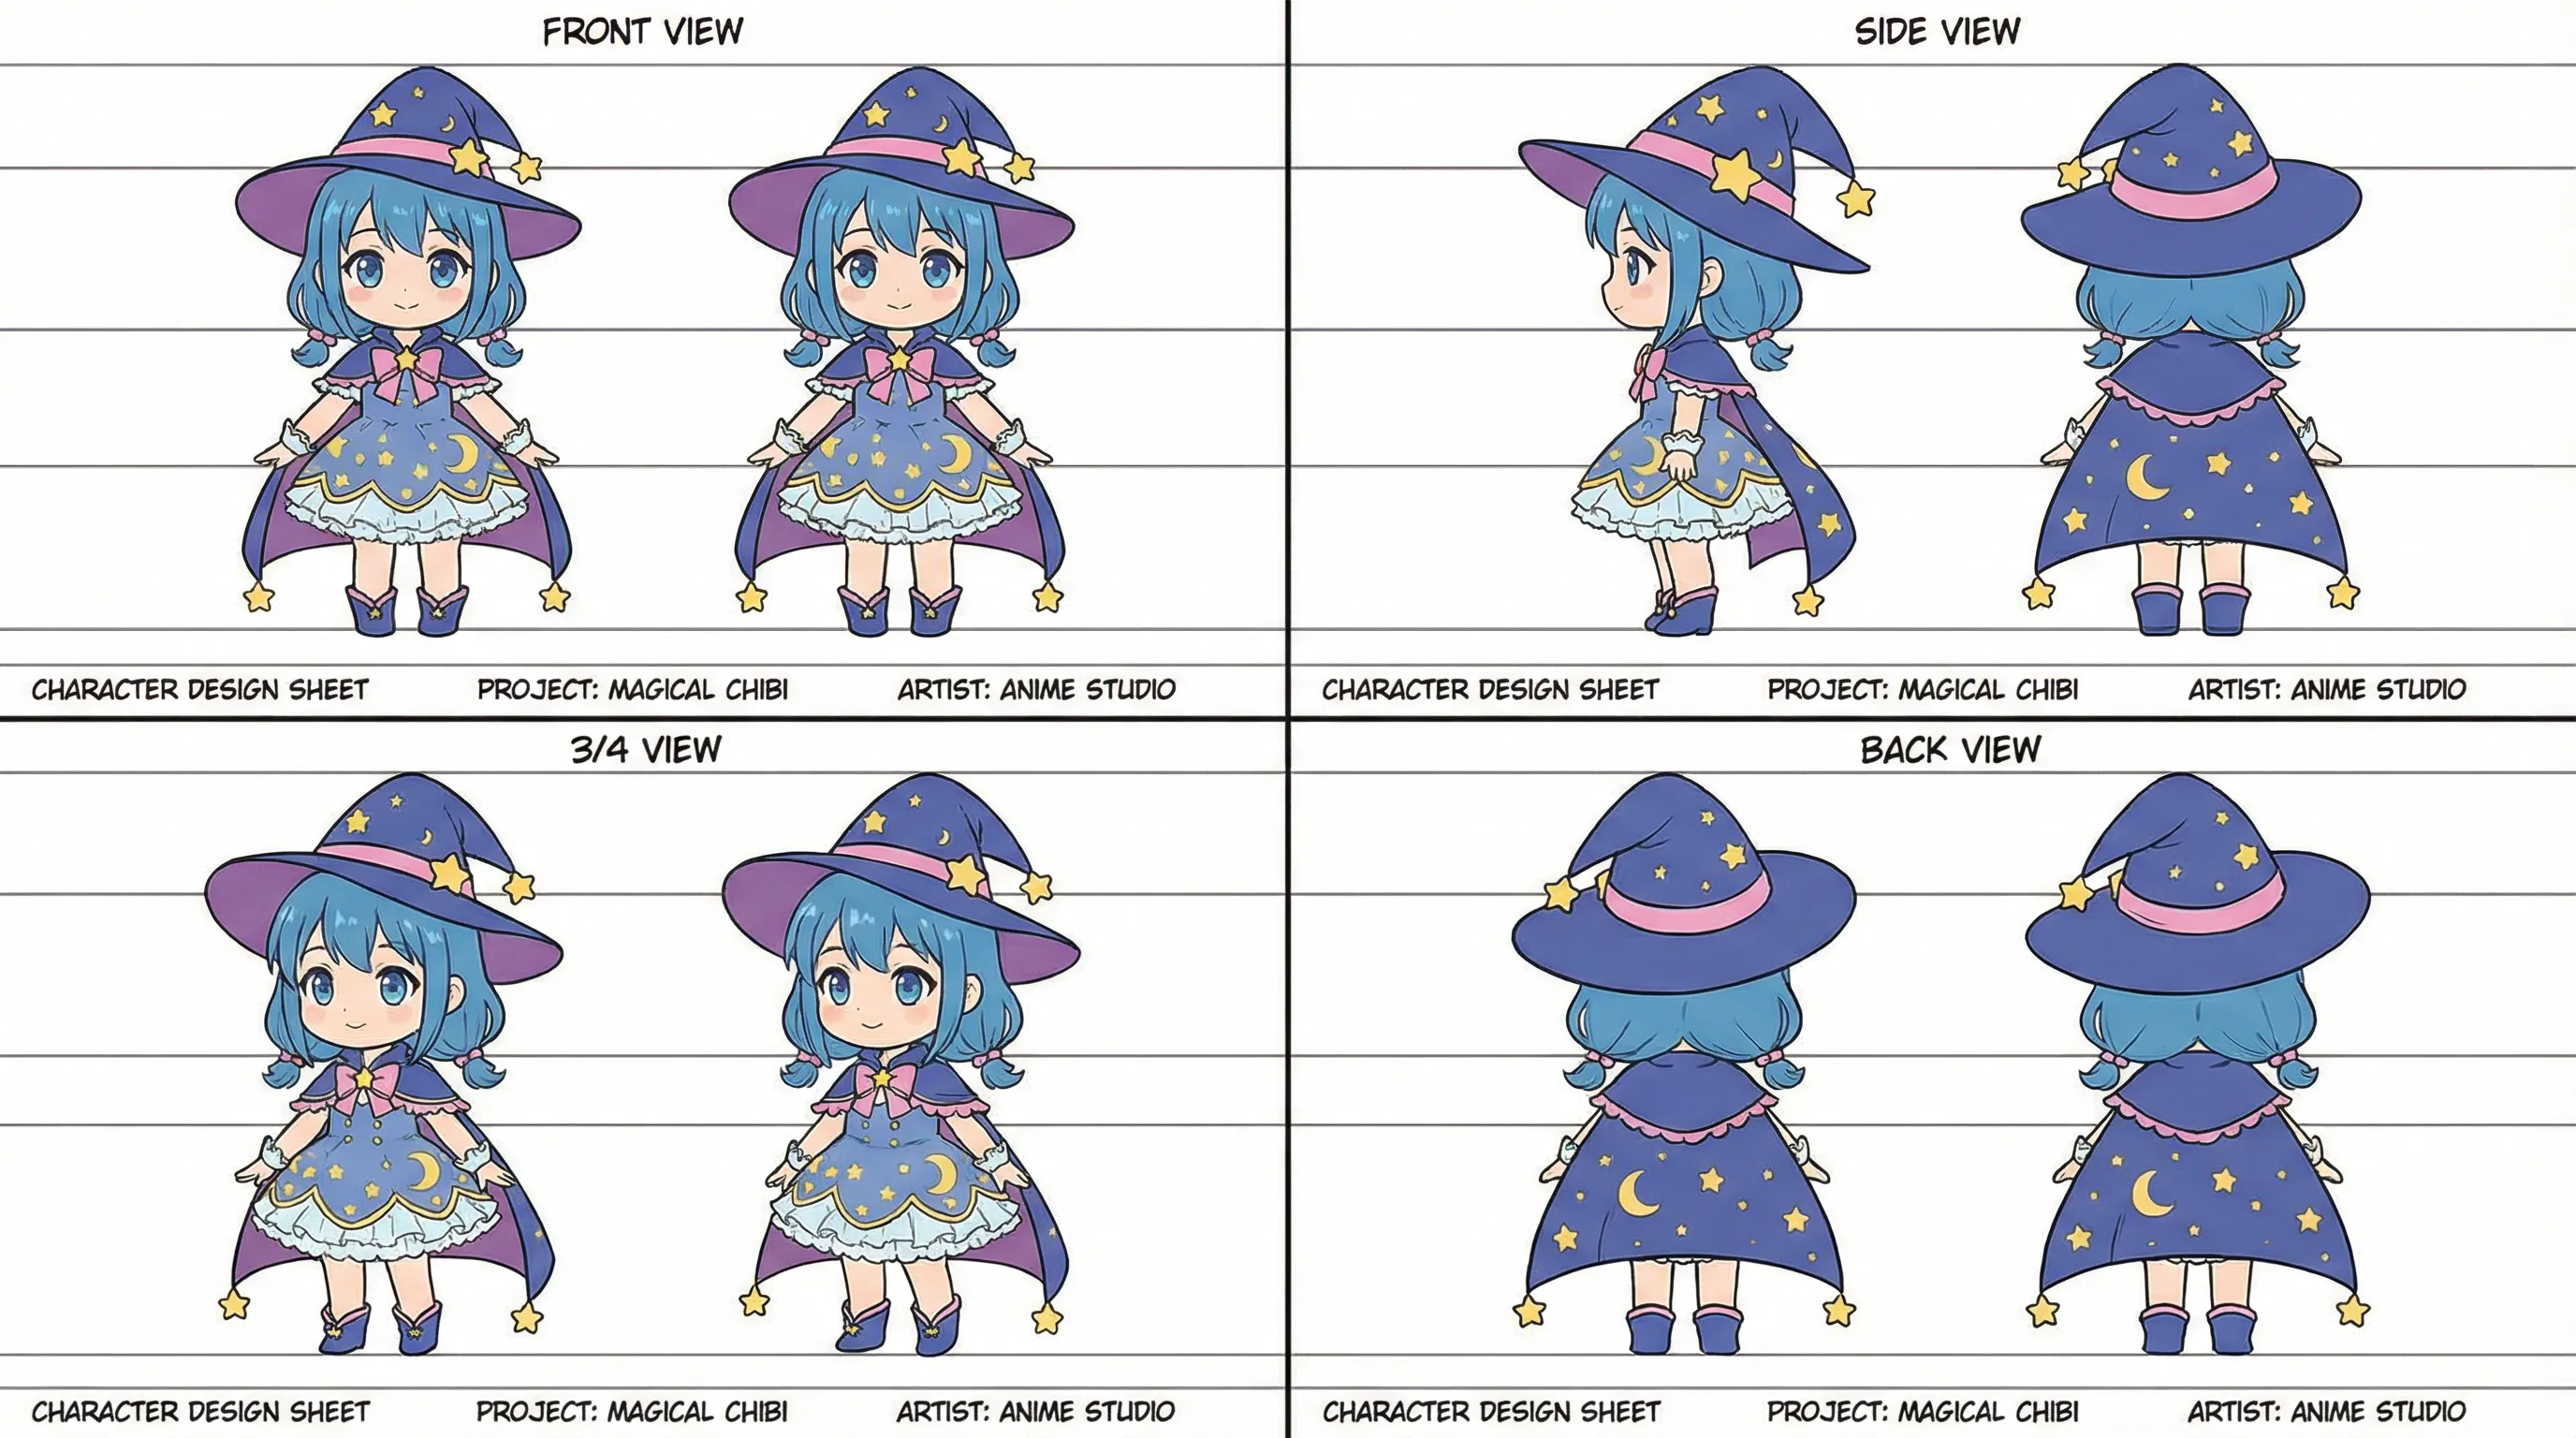
上方设定表展示了动画与漫画制作工作室中常用的标准转面图格式。注意那些必须在每个角度都保留下来的重复元素:月亮与星星图案的裙装、粉色蝴蝶结、星尖靴,以及帽冠的比例。
符合制作标准的设定表应包含:
- 四个标准视图 —— 相同尺度的正面、侧面、3/4 与背面
- 服装细节标注 —— 配饰、图案与非对称元素
- 中性基础表情 —— 模型应回归的参考面部
- 一致的线条粗细与渲染风格 —— 混合风格会让参考编码器产生混乱
- 身高/比例辅助线 —— 标示眼线、肩部、腰部与膝部的水平线
设定表之所以有效,关键的技术原因在于:参考条件功能从图像中编码视觉特征,而不是从你的文字中读取特征。Midjourney 的文档指出,Character Reference 能让模型“识别角色的特征,例如发色、服装和面部特征,并利用这些细节在新场景中生成角色”。单靠文字无法传递如此具体的信息。
选择 AI 漫画助手时应该看什么?
评估漫画助手时,应从六个加权维度入手,而不是只看图像质量。因为在连载故事中,一张脱离设定表的漂亮图像没有任何价值。
六维评估框架:
| 维度 | 测试内容 | 对漫画的重要性 |
|---|---|---|
| 参考持续性 | 设定表能否跨会话保留,无需重新上传? | 200 页项目会持续数周;每次重新上传都会增加跑偏风险 |
| 遵循度控制 | 能否调整输出遵循参考图的严格程度? | 仅锁定面部与锁定整套服装是两种不同需求 |
| 姿势控制 | 能否独立于角色身份指定骨架/姿势? | 动作分镜需要设定表中从未展示过的姿势 |
| 表情范围 | 能否基于一张基础面部生成表情表? | 漫画依赖面部表演 |
| 多视角一致性 | 3/4 视图是否真的与正面视图相符? | 分镜之间的镜头变化会暴露薄弱系统 |
| 工作流开销 | 首次获得可用输出前需要多少准备时间? | 决定工具能否适应每周的页面制作节奏 |
应尽早测试的两种一票否决式故障:
-
误解为换脸功能。 某些参考功能侧重结构,而非身份保持。Leonardo.Ai 的文档明确指出,Character Reference“并非用于换脸,也不保证输出中人物的完美复刻”。这种区别决定了一款工具能否持续呈现主角。
-
细节流失。 Midjourney 自己的最佳实践指南警告称,“诸如特定雀斑或衣物标志等复杂细节,可能无法完全准确呈现”。对于以徽章、伤疤或非对称服装元素为核心特征的角色而言,这是一项硬性限制,而不是调参问题。
主流 AI 漫画助手如何比较?
五种主流选择可分为三类架构:具备持久记忆的对话式智能体平台、参考条件图像生成器,以及基于节点的本地工作流。每种方案都在工作流速度与控制深度之间有所取舍。
| 功能/维度 | Jenova Manga Creator | Midjourney | Leonardo.Ai | Adobe Firefly | ComfyUI(ControlNet + IPAdapter) |
|---|---|---|---|---|---|
| 参考持续性 | 跨会话持久记忆;设定表在整个项目中保持加载 | 可通过锁定图标将图像固定到 Imagine 栏;无跨会话项目记忆 | 每次生成使用 Image Guidance | 通过 storage API 每次生成上传 | 本地文件;天然持久,但需手动管理 |
| 遵循度控制 | 对话式——用自然语言描述,并按分镜调整 | --cw 参数,范围 0–100;--cw 0 主要聚焦面部,--cw 100 包含面部、头发和服装 | Image Guidance 强度控制 | strength 参数,范围 1–100,默认 50 | 可分别设置 ControlNet 和 IPAdapter 的节点权重 |
| 姿势控制 | 通过对话描述;智能体负责分镜级指示 | 由文字提示驱动;无明确骨架输入 | Image Guidance 模式 | Structure Reference 应用“图像轮廓与深度” | 明确支持——使用 OpenPose/深度 ControlNet 的姿势骨架输入 |
| 多视角设定表 | 在单次会话中生成完整转面图与表情集 | 可实现,但需要手动逐视角提示 | 可通过引导实现 | 可逐视图匹配构图 | 可实现;需要搭建专用工作流 |
| 表情集 | 原生支持对话式工作流 | 手动逐条提示 | 手动 | 手动 | 需要单独的面部细化流程 |
| 设置开销 | 数分钟——无需安装 | 数分钟 | 数分钟 | 数分钟 | 数小时至数天——节点、模型与 VRAM 调优 |
| 格式支持(参考图) | 标准图像格式 | .png、.gif、.webp、.jpg、.jpeg | 标准图像格式 | 可通过 API 使用 image/webp 等格式 | 本地环境中不受格式限制 |
| 定价 | 提供免费层级;付费方案 $20/月起 | 订阅层级(参见 midjourney.com) | 订阅层级(参见 leonardo.ai) | Adobe 订阅/Firefly Services API 积分 | 免费软件;需承担 GPU 或云端 GPU 成本 |
| 最适合 | 需要在同一处保持故事与画面连续性的完整漫画项目 | 风格鲜明的单角色场景 | 需要引导控制的快速迭代 | Adobe 工作流内锁定构图的变体 | 追求最大控制力、具备技术能力且需可重复批量生产的用户 |
逐项说明各工具的实际局限:
- Jenova Manga Creator 擅长端到端的故事与分镜连续性,并具备持久记忆;但它不像 ComfyUI 那样暴露数值化的遵循度参数或姿势骨架输入。希望逐节点控制权重的技术用户会觉得这些控制被抽象化了。
- Midjourney 能产出风格鲜明的画面,并提供真正实用的角色权重调节功能;但其文档明确指出,参考图是“用于启发和引导新创作,而非完全复制”。同时,Character Reference 受版本限制——它适用于 Midjourney 和 Niji version 6,而 V7 则由 Omni Reference 取代。
- Leonardo.Ai 整合了原本分离的参考模式;其帮助文档提到,使用 Image Guidance 后,“不再需要使用旧模型,也不必专门上传图像来进行风格参考、边缘转图、角色参考等操作”。流程更简单,但粒度不如旧版拆分控制。
- Adobe Firefly 在结构匹配方面强于身份匹配——Adobe 的开发者文档将 Structure Reference 描述为:把“结构特征,例如图像轮廓和深度”应用到具有不同细节、风格或氛围的新生成图像中。这是构图控制,而不是角色身份控制。
- ComfyUI 提供最深层的控制,也拥有最陡峭的学习曲线。它需要下载模型、构建节点图,并配置硬件。
如何在生成任何内容前先建立角色设定表?
应在同一次会话中同时生成全部四个视图,因为在不同会话中单独生成的视图,会继承对同一描述的不同潜在理解,最终无法匹配。
使用 Jenova 的 Manga Creator:
- 在 jenova.ai/a/manga-creator 打开智能体
- 用一条完整且详细的消息定义角色,不要逐步追加:
“为我的主角创建一张角色设定表:16 岁女性,齐下巴的蓝色短发,两侧各有一束编发;戴宽檐紫色女巫帽,帽冠上有一颗金色星星;披风带粉色镶边;裙装采用新月图案;穿星尖踝靴。请以一致尺度生成正面、侧面、3/4 和背面视图,采用干净的黑白漫画线稿。”
- 检查转面图是否存在连续性错误——确认四个视图中的帽冠高度、披风长度和服装图案一致
- 在生成任何分镜前,将设定表锁定为项目参考:
“将这张设定表作为该角色在整个项目中的规范参考。若任何分镜偏离它,请进行标记。”
使用 Midjourney 的 Character Reference:
- 先在 Midjourney 中生成基础角色。文档对此说得很明确:“为了获得最佳结果,请从一张由 Midjourney 创建的单角色图像开始。真实人物图像通常不会完全像本人。”
- 点击 Imagine 栏中的图像图标,再将图像拖入 Character Reference 区域
- 点击锁定图标,将参考图固定在后续提示中
- 将参考图与清晰的文字提示结合——文档强调,“文字对于传达完整场景,以及参考图未展示的额外细节同样重要”
- 在 Discord 中,于提示末尾添加
--cref,然后附上托管图像 URL
使用 ComfyUI:RunComfy 的一致角色指南记录了一种两阶段方法:先使用 ControlNet 创建面部,再单独处理服装和姿势。该指南指出,IPAdapter 更偏好方形裁切:在输入各自的 IPAdapter 前,面部和躯干会被裁成方形,并使用注意力蒙版隔离每个区域。
如何根据完成的设定表生成一致的表情?
应从设定表的中性面部批量生成表情,而不是在不同会话中逐一生成。因为批量生成共享对基础面部的一次性理解,而连续生成每次都会重新锚定。
表情矩阵方法。 与其临时按需索取表情,不如预先定义故事需要的完整情绪范围——通常为涵盖漫画标准集合的 8–12 种表情:
- 基础: 中性、微笑
- 积极: 喜悦、兴奋、爱意
- 消极: 愤怒、悲伤、恐惧
- 反应: 惊讶、困惑、害羞
- 类型特定: 坚定(少年漫画)、面无表情(喜剧)、空洞凝视(恐怖)
适用于 Jenova Manga Creator 的提示模式:
“使用已锁定的角色设定表,为该角色生成一张表情矩阵:中性、喜悦、愤怒、悲伤、惊讶、害羞、坚定和恐惧。全部十二张均保持 3/4 头部角度。头发轮廓、帽子位置和眼睛形状必须完全保留——只改变眉毛、嘴部、眼睛开合与脸红。”
要求仅改变特定面部组件,正是防止跑偏的关键。若不加约束,生成系统会在改变表情时同时重新诠释发量和脸型。
**在 Midjourney 中,**角色权重参数是主要工具。根据文档,--cw 0 会将重点“主要转向角色的面部”,这正是表情制作所需要的——你刻意不要求模型复现服装。对于全身姿势,--cw 100 则会纳入“面部、头发和服装”。
**在 ComfyUI 中,**RunComfy 工作流最终会进行专门的面部处理,“重点增强面部特征,并使其与其他 IPAdapter 影响分离,以实现精确细化”。这对表情设定表具有结构性优势,因为面部细化与身体、服装条件控制相互隔离。
如何获得新姿势而不丢失角色特征?
姿势生成需要将骨架与身份解耦,而三类工具的解决方式各不相同:智能体平台通过定向描述完成,参考生成器通过权重调节与精确提示完成,节点工作流则通过明确的骨架输入完成。
为什么姿势会破坏角色。 姿势变化会改变轮廓、透视缩短效果,以及哪些服装元素可见。参考条件系统会对整张参考图赋予权重,因此戏剧性的姿势会迫使模型在遵从姿势提示与遵从参考几何结构之间做选择。参考遵循度越高,模型对新姿势的抗拒就越明显。
三种方法:
📐 显式骨架控制(ComfyUI)。 RunComfy 工作流会在专门步骤中使用“ControlNet 来定位身体”,随后再引入用于身份的 IPAdapter 条件控制。姿势与身份在字面意义上就是独立节点。社区记录的替代方案介绍了如何通过将 ControlNet 模型放入 WebUI 的模型目录,从多个视角生成同一角色。
🎯 权重调节参考(Midjourney)。 降低 --cw 值会放松服装遵循度,为姿势提示留出更多空间。再结合文档建议的详细文字提示——Midjourney 文档中的正反提示示例表明,明确指定场景,例如“蓝发、戴金色眼镜的男子坐在咖啡馆里”,会优于模糊的场景描述。
💬 定向描述(Jenova Manga Creator)。 姿势指示可像漫画编辑提出要求那样给出,同时由智能体在内部维持对设定表的参考:
“第 4 格:角色正在跃起,从低角度观看,披风向后飘动,帽檐被风吹起。面部保持 3/4 角度并转向镜头。头发、帽子和服装必须匹配已锁定的设定表。”
**值得考虑的实用混合方案:**先在迭代迅速的对话式智能体中建立设定表与表情矩阵,再将最终设定表导出为参考图,导入 Midjourney 或 ComfyUI,用于需要机械级精度的重动作场景。工具并不互相排斥,混合工作流在职业创作者中很常见。
从业数字艺术家如何看待 AI 角色一致性?
从业者的共识是:一致性是工作流问题,而不是模型问题;最大的改进来自于前置参考工作,而不是在后期修复跑偏。
“几乎每位新手都会犯的错误,是先生成分镜,再把角色设定表作为清理步骤补出来。这完全颠倒了顺序。在第一格分镜之前,多花一小时完善转面图,大约能为你在第 20 页时节省六小时的重新生成时间。设定表不是对角色的记录——它是角色在生成式工作流中得以存在的机制。”
“第二个需要真正理解的重点是:遵循度控制不是一个越高越好的质量旋钮。对于表情制作,最高参考权重反而是错误的,因为你要求系统复现了甚至不想放进画面的服装。表情使用聚焦面部的设置,建立镜头使用全权重设置,动作分镜使用中等范围设置——这才是实际的专业模式,而且不依赖于具体工具。”
“对话式智能体平台真正改变判断的地方在于项目记忆。在节点工作流或基于提示词的生成器中,角色设定表存在于你的文件系统和自律中;在具备跨会话持久记忆的智能体中,它存在于工作流本身。对于持续数月、长达 200 页的连载项目而言,这种差别至关重要——毁掉长篇漫画项目的跑偏,几乎总是源于会话之间丢失的连续性,而不是单次会话内部的问题。”
—— Jenova 产品团队,拥有 9 年生成式视觉工作流与连续艺术工具经验
应该为你的具体项目选择哪款工具?
应根据项目长度和技术接受度选择工具,而不是原始输出质量——五种选择都能生成不错的单张图像,只有在连续性压力下才会真正拉开差距。
🎬 长篇连载漫画(50 页以上) → Jenova Manga Creator。 跨会话持久记忆是决定性因素。该智能体被描述为可处理“视觉叙事、分镜流程和一致的艺术风格——从短篇到 200 页以上的连载史诗”,并将故事连续性与美术连续性维持在同一上下文中。取舍:你会失去数值化参数控制。
🎨 风格鲜明的短篇与单篇作品 → Midjourney。 --cw 调节可提供真实的逐次生成控制;根据文档,参考图可同时与 Style References 和 Image Prompts 结合使用。取舍:没有项目级记忆,复杂服装元素会出现细节流失。
⚙️ 需要可重复输出的大批量生产 → 搭配 ControlNet + IPAdapter 的 ComfyUI。 它提供明确的姿势骨架、隔离式面部处理和逐节点权重控制。RunComfy 指南甚至记录了一个用于防止颜色过度饱和的去饱和节点,足见其可实现的控制粒度。取舍:需要数小时设置、GPU 要求,以及持续的节点维护。
🖼️ 现有 Adobe 工作流内锁定构图的变体 → Adobe Firefly。 具备可调 strength 的 Structure Reference(范围 1–100,默认 50)非常适合保持分镜构图一致。取舍:它是结构工具,不是身份工具。
⚡ 快速迭代与探索 → Leonardo.Ai。 整合后的 Image Guidance 消除了切换模式的阻力。取舍:相比被它取代的独立控制项,粒度更低,而且 Character Reference 明确不保证复制级输出。
**值得了解的相邻工作流:**使用纵向滚动格式的创作者会发现 Webtoon Creator 更适合基于单集的全彩叙事节奏;西式连续艺术则可使用 Comic Creator。两者都可在 Jenova 上与 Manga Creator 一同使用,三者均继承平台的持久记忆与多模型访问能力。免费层级的使用量有限;付费方案 $20/月起,额度为免费层级的 30×。
最常见、最容易破坏角色一致性的错误有哪些?
最具破坏性的五种错误,都是生成前做出的工作流决策,而不是生成过程中提示写得不够好。
1. 用真实照片作为角色参考图。 Midjourney 的文档明确表示,“真实人物图像通常不会完全像本人”,并建议改从模型生成的单角色图像开始。照片编码了光照、镜头畸变和微观细节,参考编码器会以难以预测的方式解读它们。
2. 不必要地叠加多张参考图。 同一份文档建议:“虽然你可以使用同一角色的多张图像,但通常没有必要。”额外的参考图可能会平均掉辨识度高的特征,而不是强化它们。
3. 依赖参考图来承载场景。 Midjourney 的对比示例说明了这一点——即使使用相同参考图,模糊提示仍会不如具体提示。参考图负责身份;提示必须提供其他所有信息。
4. 围绕无法稳定复现的细节设计角色。 如果角色的定义特征是特定标志、雀斑图案或衣服上的细小文字,就要预期细节流失。应在轮廓尺度设计辨识特征——发型、帽子形状、披风长度、靴子颜色——它们比精细细节更容易稳定地通过参考编码保留下来。
5. 将遵循权重视为质量设置。 最大权重适合建立镜头,却不适合表情设定表。Firefly 的 strength 参数默认值为 50 而非 100,正是因为中等范围的数值能为模型留出空间来遵从新提示。
**关于格式兼容性的说明:**如果要在工具之间转移设定表,请在搭建工作流前检查可接受的格式。Midjourney 接受 .png、.gif、.webp、.jpg 和 .jpeg。Firefly 的 storage API 可接受包括 image/webp 在内的格式。对于跨平台传递参考设定表而言,WebP 普遍是最稳妥的交换格式。
参考资料
- Midjourney 文档 — Character Reference
- Midjourney 文档 — Omni Reference
- Midjourney 更新 — Character References 简介
- Leonardo.Ai 文档 — 使用 Image Guidance 生成图像
- Leonardo.Ai 帮助中心 — Image Guidance
- Adobe 开发者文档 — Structure Image Reference,Firefly APIs
- Adobe 博客 — Adobe Firefly 的新 Structure Reference 功能
- Adobe 帮助中心 — 将图像构图匹配至参考图
- RunComfy — 使用 ControlNet 与 IPAdapter 创建一致角色
- Stable Diffusion Art — 如何从不同视角创建一致角色
- Think Diffusion — 在 ComfyUI 中使用 Flux 创建一致角色
- ComfyUI — 开源节点式生成界面