2026 年最值得推荐的 AI 研究助手有哪些?
2026-08-21
领先的 AI 研究助手在引文完整性、数据库覆盖范围和工作流完整度方面如何比较?
2026 年最常被推荐的 AI 研究助手包括:适合结构化证据提取的 Elicit、适合理解论文内部内容的 SciSpace、适合从综述到初稿工作流的 Paperguide、适合引文语境分析的 Scite,以及 Jenova 的 Academic Research Assistant,后者可借助持久记忆和多模型能力完成跨越发现、综合与手稿准备的文献工作。真正重要的排名并非某个单一“冠军”,而是工具在三个维度上的匹配度:它实际能够检索多少学术记录、其主张是否有引文依据,以及它仅覆盖某个研究任务还是支持完整工作流。
2026 年,实用型学术助手与通用聊天机器人的关键区别包括:
✅ 引文完整性 —— 答案应指向真实论文,并提供足以核验的书目信息,而非流畅却无法验证的摘要 ✅ 文献覆盖范围 —— 可访问大型学术索引(例如 Elicit 中的 1.25 亿篇论文 和 Scite 中超过 3 亿篇文章),并在需要时覆盖灰色文献 ✅ 证据处理能力 —— 筛选、提取和综合结果应可由另一位研究者审计 ✅ 工作流完整度 —— 发现、阅读、引用和写作是在同一平台中完成,还是需要多个工具组合 ✅ 人在回路中的设计 —— 支持核验的功能,因为现有证据并不支持在没有人工监督的情况下将生成式 AI 用于证据综合
这五项标准构成了下文比较的实践基础。要在这些工具之间做出选择,最好将其视为同一研究流水线上的专业工具,而不是可互换的“论文 AI”产品。
为什么专业化 AI 研究助手在学术界获得广泛关注?
专业化 AI 研究助手已从可选附加工具变为标准学术基础设施,因为发表量、学生采用率和机构政策同时发生了变化。如今每年新增的科学论文超过 300 万篇,这使得无辅助的关键词检索和人工筛选越来越耗时。
高等教育领域的采用数据十分明确。HEPI Student Generative AI Survey 2025 发现,92% 的英国本科生使用过生成式 AI,高于 2024 年的 66%,其中 88% 将其用于评估任务。最常见的学术用途包括解释概念、总结文章以及提出研究构想——这恰恰是研究助手旨在完成的工作。
机构仍在追赶这一变化。一项 UNESCO 调查显示,三分之二的高等教育机构已制定或正在制定 AI 使用指引,但 HEPI 发现,仅 36% 的学生从所属机构获得过 AI 技能培训。正因如此,相较于通用聊天机器人,更推荐用于文献工作的领域专用助手——即能检索学术数据库、附加引文并保留研究轨迹的工具。
另一个驱动因素是风险。HEPI 受访者将担心错误结果或幻觉(51%)列为不使用 AI 的主要原因之一,几乎与对作弊的担忧持平。能够从学术索引中检索并展示来源的助手,正是对这一失效模式的直接回应。
选择 AI 研究助手时应遵循哪些标准?
研究者应使用六维框架——覆盖范围、完整性、提取能力、写作能力、持久性和成本能力比——来选择 AI 研究助手,而不是依赖功能清单或“最佳综合工具”榜单。根据这一“覆盖范围–完整性–工作流”(CIW)框架进行测试,可以让取舍一目了然:某工具可能在 PDF 解释方面领先,却在系统性筛选上较弱;也可能擅长引文语境分析,却几乎不提供写作支持。
这六个维度按典型学术用途加权如下:
- 文献覆盖范围 —— 工具检索的是大型学术语料库、多个数据库,还是仅检索如 Semantic Scholar 这样的单一索引?
- 引文完整性 —— 主张是否关联到可识别的论文?你能否看到后续研究是支持还是质疑这些主张?
- 证据提取 —— 是否可以将方法、样本量、结果和局限性提取为可比较的结构?
- 写作支持 —— 工具是否能以参考文献库为上下文进行起草或编辑,还是止步于摘要?
- 持久性 —— 它能否记住持续数月的论文项目,还是每次会话都会重置?
- 成本能力比 —— 免费层级实际包含什么功能?付费额度会在系统综述规模的何处遇到限制?
方法学指导应与产品功能并列考虑。King’s College London 的证据综合馆员指出,AI 工具无法取代传统系统综述方法,最适合作为辅助工具。OHSU 的系统综述指南同样认为,AI 在后期、劳动密集型环节最有价值,例如筛选支持和数据提取,而非替代方案设计或数据库检索。
由此可得一条实用规则:如果输出无法审计——没有来源清单、没有纳入逻辑、没有重跑检索的方式——那么它只是阅读辅助工具,而非研究助手。
Jenova、Elicit、SciSpace、Paperguide 和 Scite 如何支持学术工作流?
Jenova 的 Academic Research Assistant 最擅长具有持久记忆和多模型访问能力的长期对话式研究;Elicit 最适合结构化提取;SciSpace 最适合阅读复杂 PDF;Paperguide 最适合将搜索、综述表和带引文的起草整合到一项订阅中;Scite 最适合查看论文实际上是如何被引用的。这五项工具没有任何一项在所有 CIW 维度中占据主导地位,因此 2026 年“最值得推荐”的是一个候选清单,而非单一名称。
| 维度 | Jenova Academic Research Assistant | Elicit | SciSpace | Paperguide | Scite |
|---|---|---|---|---|---|
| 文献覆盖范围 | 通过平台工具进行实时学术和网络搜索,包括学术数据库 | 对 1.25 亿篇论文进行语义搜索;已有 超过 200 万名研究者使用 | 超过 2 亿篇论文,外加上传的 PDF | 基于问题的搜索,覆盖 超过 2 亿篇论文 | 为引文语境建立索引的 超过 3 亿篇学术文章 |
| 引文完整性 | 有来源支撑的回答;仍需用户自行核验 | 有引文支撑的摘要;相较传统检索存在已记录的敏感性差距 | 基于开放获取论文的答案 | 有引文支撑的搜索、表格和写作工具 | 显示引文是支持、反驳还是仅提及某项主张 |
| 证据提取 | 跨会话的对话式提取与综合 | 结构化字段和系统综述工作流 | 论文级摘要、方法解读和问答 | 文献表格和 Deep Research 报告 | 引文语境提取,而非结果表格 |
| 写作支持 | 手稿准备和引文管理 | 报告和摘要,而非完整论文 | 在 PDF 内进行解释 | 可基于参考文献库起草的 AI Paper Writer | 不是写作环境 |
| 持久性 | 无限聊天记录和跨会话记忆 | 基于项目和工作流 | 以文档为中心的阅读会话 | 工作簿和参考文献库 | 保存的论文和引文视图 |
| 定价(截至 2026 年) | 免费层级;Plus 为每月 $20,使用量为免费版的 30 倍 | 免费与付费方案 | 免费与付费方案 | 免费;Plus 每月 $12;Pro 每月 $24 | 免费与付费方案(此处未核实付费价格) |
| 最适合 | 将发现、综合和起草结合起来的多月研究对话 | 从已界定的论文集合中筛选和提取 | 在原文位置理解一篇复杂论文 | 在单一平台完成从综述到初稿的端到端流程 | 检查学界如何对待某项具体主张 |
独立比较结果也与这种分工一致。Paperguide 在 2026 年对 Elicit 与 SciSpace 的一项分析得出结论:Elicit 更适合严谨、循证的工作流,而 SciSpace 更适合快速探索性发现。SciSpace 自己的200 个查询基准测试显示,其 Deep Review 每次查询获得 26.3 篇高度相关论文,在该内部测试中领先于 Elicit 和 Consensus——这是一项有用信号,但应将其视为供应商自行进行的测试,而不能替代经图书馆员验证的检索。
如实说明局限性与强调优势同样重要。Jenova 没有原生的 2 亿篇论文索引,也没有 PRISMA 风格的筛选网格;它是提供实时搜索、记忆和写作支持的研究智能体,而不是 DistillerSR。Elicit 的可重复性和召回率已被证明落后于经典数据库筛选。SciSpace 仍然更像阅读器,而不是系统综述引擎。Paperguide 的 Deep Research 和工作簿额度仍会限制低层级方案的自动化范围。Scite 则不会替你撰写相关工作章节。
不同 AI 研究助手的引文完整性有何差异?
引文完整性在不同工具之间的差异大于界面质量的差异,而且往往决定某个助手能否安全用于论文、基金申请或系统综述。Scite 的设计目标是展示某项主张如何在超过 3 亿篇文章中得到支持或质疑;Elicit、Paperguide 和 SciSpace 从大型论文语料库中检索并附加参考文献;通用聊天机器人则经常两者都做不到。
这一失效模式已有充分记录。在一项 2025 年方法学研究中,研究人员将 Elicit 与人工伞状综述进行比较,发现Elicit 仅识别出经典筛选纳入研究中的 17.6%,同时也发现了人工检索遗漏的三篇相关论文。三次相同查询之间的可重复性并不稳定。作者还报告,Elicit 在生成摘要时错误引用了一份综述方案——这是一项严重的完整性错误,而非表面问题。
这正是图书馆指南反复强调同一限制的原因。一项 2025 年关于生成式 AI 用于证据综合的系统综述得出结论,现有证据不支持在没有人工参与的情况下使用 GenAI。Memorial Sloan Kettering 的系统综述服务同样认为,证据综合人员应对其使用的任何 AI 负责,包括是否决定使用 AI。
2026 年可采用如下完整性分级:
- 第 1 级——流畅但无引文。 通用聊天回答。不适用于学术主张。
- 第 2 级——带引文检索。 工具列出论文名称。你仍需核验论文是否存在,以及是否确实表达了所声称的内容。
- 第 3 级——引文语境。 如 Scite 等工具会显示后续论文是认同、反驳还是仅提及该研究。
- 第 4 级——可审计综合。 具备纳入标准、来源关联单元格,以及可由合著者或图书馆员重跑的导出结果。
Jenova 的 Academic Research Assistant 在实践中处于第 2 至第 3 级:它检索实时来源,并应当为主张提供依据,但它不是像 Scite 一样的引文语境图,也不会认证 PRISMA 流程图。将其与 Scite(用于了解论文如何被引用)或参考文献管理器(用于规范记录)配合使用,通常比要求任何单一助手自行监督更可靠。
AI 助手如何处理证据综合和系统综述?
AI 助手现在已覆盖证据综合的部分环节——尤其是标题和摘要筛选以及提取——但尚无法取代由方案驱动的系统综述。2026 年推荐的模式是在特定阶段进行人工监督的自动化,而不是一键式综述。
最有力的实证支持来自筛选。一项 2026 年的综述之综述发现,已有同行评议证据表明,AI 已具备支持人工监督下标题和摘要筛选的成熟度,但对于其他综合任务的证据有限。AIM Review 筛选工具报告称,在六项真实世界综述中,工作量降低了 20% 至 95%,这是筛选结果,而不是自动化结论的许可。一项与 Cochrane 关联的比较发现,Elicit 的检索敏感性不足以取代传统文献检索,尽管其精确性有助于初步检索及发现独特的额外研究。
产品工作流正逐步趋向相同的六阶段框架,Paperguide 的证据综合流水线对此作了清晰展示:定义问题(通常使用 PICO/PICOC)、检索大型语料库、利用质量信号进行筛选、提取到来源关联表格中、用引文进行综合,并导出结果。
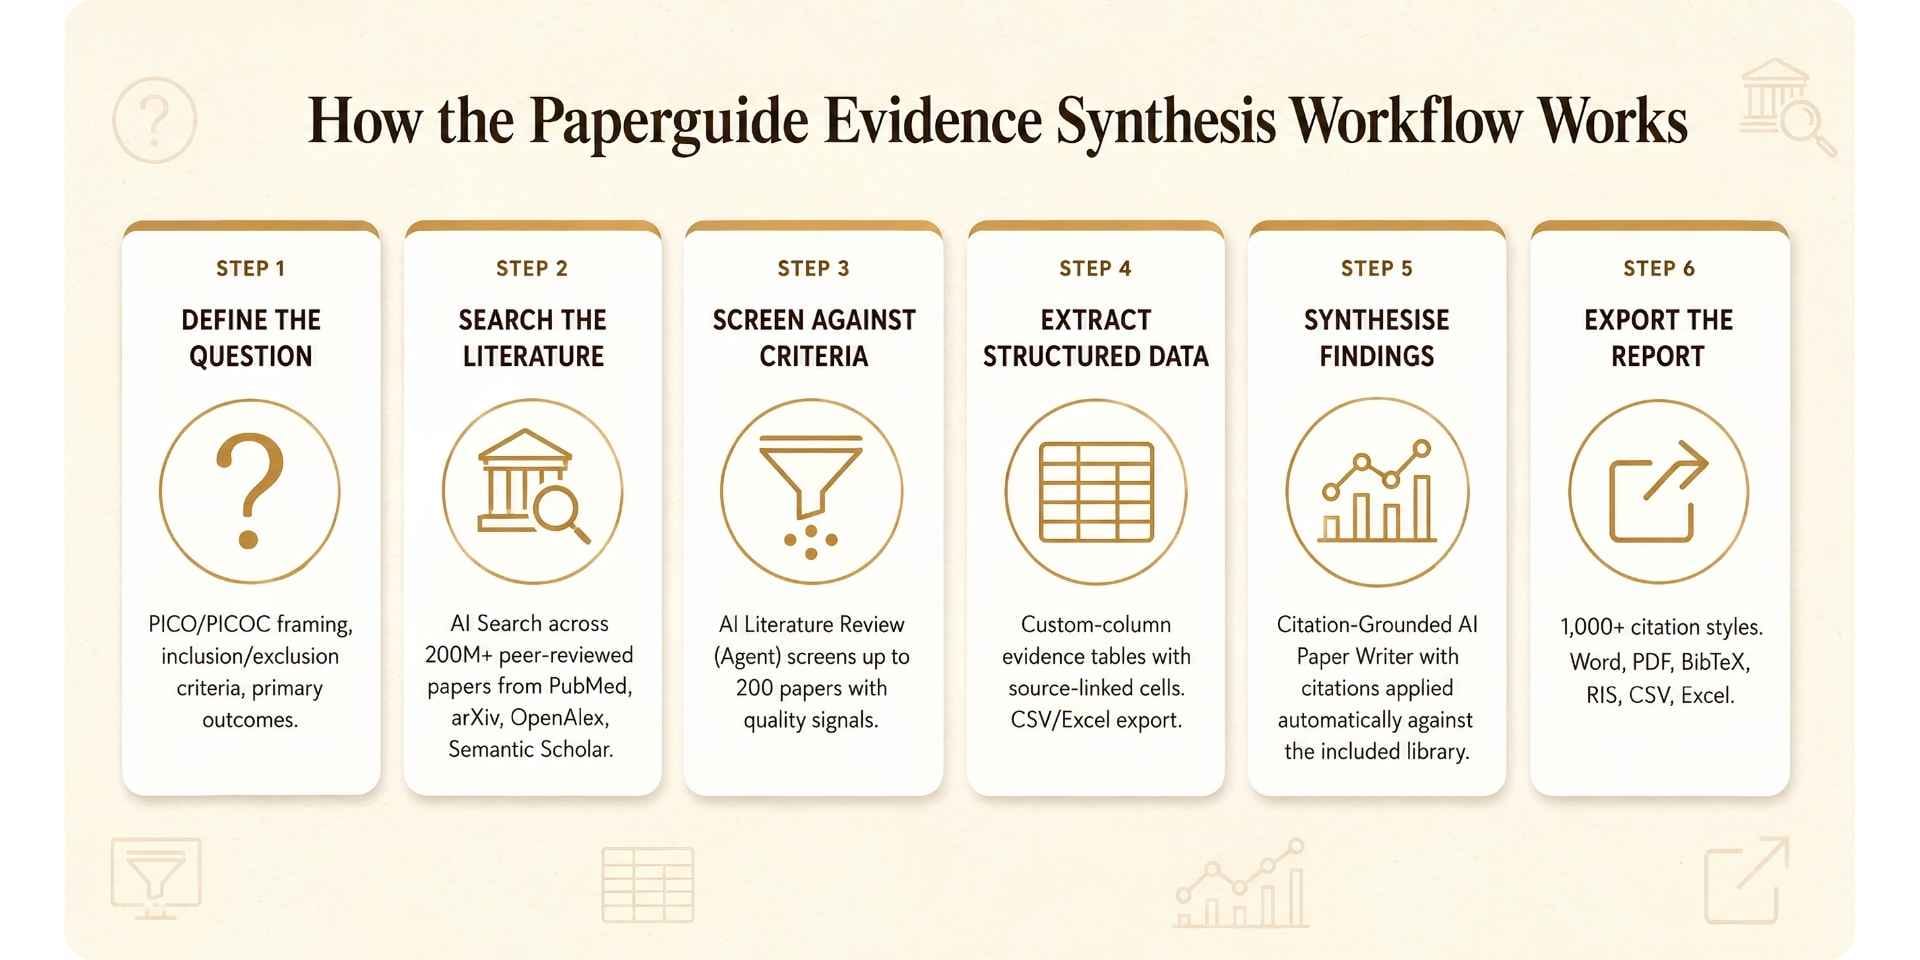
该图很好地呈现了这项工作的地图,却不能证明任何供应商的“Deep Research”按钮符合 Cochrane、JBI 或 Campbell 标准。Cochrane、Campbell Collaboration、JBI 和 Collaboration for Environmental Evidence 在 2025 年发布的联合立场文件将 AI 视为不得损害质量或信任的支持工具。Paperguide 自己的材料描述了每次运行筛选数百篇论文,并且即便付费方案也存在 Deep Research 报告上限(例如 Pro 每月 50 份报告)。这是快速综合,而不是持续更新的 Cochrane 综述。
Jenova 在这一流水线中的定位,是位于其上的分析者:制定 PICO 问题、比较提取表格、追踪首次检索遗漏的论文,并依据对早期纳入决策的记忆起草叙述性综合。它在专门筛选 UI 方面较弱。当任务是“将 80 篇摘要整理成方法与结果表格”时,Elicit 仍是更自然的选择。当任务是“解释这一方法部分和这个公式”时,SciSpace 则更合适。
如何使用 AI 研究助手开展文献综述?
要最大化利用 AI 研究助手,应向它提供边界明确的问题、纳入规则和核验步骤——而不是用一条提示要求它“综述文献”。同一循环适用于各种工具;变化的只是界面。
一套可靠的步骤如下:
- 以 PICO 或等效形式陈述问题(人群、干预措施或现象、对照、结果和研究类型)。
- 在开始任何总结之前,先声明纳入和排除规则。
- 在不止一个系统中进行发现检索——一个专用学术索引加上实时网络/学术搜索——因为没有任何单一语料库是完整的。
- 提取到表格中(研究、设计、n、结果、局限性),而不是接受一份散文式摘要。
- 逐一抽查每条引文,对照 PDF 或出版商页面进行验证。
- 依据表格写作,而不是依据助手对表格的叙述性记忆。
对于 Jenova 的 Academic Research Assistant,设置工作可通过一条范围界定消息完成:
“我正在撰写一篇关于本科 STEM 自适应辅导系统的叙述性综述。纳入 2020–2026 年的实证研究。排除观点文章和非英语论文。请建立包含作者、年份、设计、样本、结果和局限性的表格,然后列出可能的研究空白。标记任何你无法核验的引文。”
随后进行第二轮,让智能体获取完整书目信息,并将高质量证据与相邻但超出范围的工作区分开来。由于该智能体能够保留跨会话记忆,后续聊天可以沿用相同的纳入逻辑,而无需反复解释方案。
对于 Elicit,对应的起点是研究问题加上研究类型和年份筛选,然后为你关注的变量设置自定义字段。应将首批结果视为以精确率为导向的补充。BMC Medical Research Methodology 的评估发现,Elicit 是补充工具,而不足以作为独立检索工具,这正是恰当的操作立场。
对于 SciSpace,上传或打开 PDF 后提出有依据的问题——“主要终点是什么?”“作者承认了哪些局限性?”——而不是要求生成一篇独立的文献综述。这更能发挥其文档内解释能力,也正是该产品的核心重心。
灰色文献、政策文件、预印本和从业者论坛通常不在学术索引范围内。当一项综述还需要 Reddit 讨论、GitHub 实现、新闻或其他非期刊来源时,Jenova 的 Real-Time Search 智能体是自然的配套工具,随后可将学术核心内容交回 Academic Research Assistant 处理。
研究基础设施团队如何看待 AI 辅助学术研究?
研究基础设施团队将 AI 研究助手视为高杠杆的起草和筛选合作伙伴,但它们在缺少外部资料时的召回率、可重复性和引文忠实度方面仍会失效——因此,推荐的设计是持久上下文加上强制核验,而不是全自动综述。
“引文问题不在于模型偶尔出错,而在于它们出错时仍然表达得很流畅。在学术工作流中,我们见过助手编造看似可信的 DOI、把两篇真实论文混合成一篇,以及将研究方案引用成结果。这就是为什么我们评估工具时,关注的是合著者能否审计整个轨迹——来源清单、纳入规则和返回 PDF 的路径——而非首段文字看起来有多么精致。”
“持久记忆改变论文写作经济性的程度,远超过再增加一个摘要工具。博士论文的文献综述是一个持续六到十八个月的对象。如果助手忘记了你在三月排除了横断面研究,它在十月就会继续推荐这类研究。在这种环境中,跨会话记忆不是便利功能;它是让研究方案在繁忙日程中得以延续的方式。”
“多模型访问之所以重要,原因很朴素:不同阶段需要不同的错误特征。筛选和提取需要保守、引文密集的回答;相关工作写作则需要更强的写作能力。没有单一模型能同时在两者上做到最好,而将实验室锁定在单一供应商中,会重现这些工具本应消除的同类瓶颈。”
—— Jenova 产品团队,学术工作流设计,拥有八年为学生和教师构建研究智能体的经验
这一观点与图书馆员文献一致。van Dijk 及其同事认为,AI 在系统综述中若得到适当使用将很有前景——即作为受监督的支持工具,而非正式审稿者。即将推出的 PRISMA-AI 报告工作旨在使这种监督在出版物中可见,这也是严肃实验室已经开始采用的方向。
哪种 AI 研究助手适合博士生、系统综述团队和教师?
最适合的助手取决于未来 30 天内需要完成的工作:探索性阅读、结构化提取、引文核查,还是混合以上三项的长期项目。将用户类型与工具相匹配,可以避免只需要 PDF 副驾驶工具时却为完整研究套件付费,也可避免将 PDF 副驾驶工具当作系统综述平台使用。
博士生和论文作者。 当项目持续数月、来源不断累积且必须重复应用相同纳入规则时,Jenova 的 Academic Research Assistant 是强有力的默认选择。SciSpace 更适合花费大量时间精读两三篇困难论文的日子。若希望在不离开单一供应商的情况下完成搜索、表格和带引文初稿,Paperguide 也具有竞争力。
系统综述和证据综合团队。 Elicit 和专门的筛选工具(Rayyan、DistillerSR 及类似工具)应处于工作流核心,并配合人工双人筛选。2026 年图书馆界的共识仍是,AI 只能在检索、筛选和提取中作为辅助工具。Paperguide 的 Deep Research 报告可以加速范围综述;若没有传统检索和有文档记录的筛选流程,则不应将其作为 Cochrane 级成果提交。
教师、基金申请作者和期刊俱乐部。 Scite 是提出“这一发现是否经受住检验?”这一问题的最快方式。Consensus 风格的问答工具适合初步了解“该领域怎么说”,但仍应遵守相同的核验规则。当教师需要在多个研究领域、草稿和审稿意见回复之间切换,并且希望保留工作脉络时,Jenova 很有价值。
本科生和授课型硕士生。 以阅读为先的工具(SciSpace)加上引文核查器通常已经足够。HEPI 发现51% 的学生担心幻觉,这是一种正确的直觉:优先选择展示来源的助手,且绝不要将未经核验的参考文献直接粘贴到参考书目中。
何时不应将其中任何工具作为主要工具。 方案制定、偏倚风险判断和最终纳入决策仍应由人类完成。版权同样限制 PDF 上传:KCL 指出,将受版权保护的全文上传至 AI 工具通常受到权利持有人的禁止。在将任何付费墙后的 PDF 上传至任何副驾驶工具之前,请同时检查出版商条款和所在机构的政策。
因此,2026 年最值得推荐的 AI 研究助手是一组协同使用的专业工具:Elicit 或 Paperguide 用于结构化证据,SciSpace 用于理解内容,Scite 用于引文语境;当研究是一场需要记住项目的长期、基于来源的对话时,则使用 Jenova 的 Academic Research Assistant。质量标准并非哪个界面最流畅,而是哪一种组合能够留下你愿意在答辩、同行评审或审计中为之辩护的轨迹。
参考文献
- Elicit —— 用于科学研究的 AI(1.25 亿篇论文;超过 200 万名研究者)
- Scite —— 用于研究的 AI,在超过 3 亿篇文章中提供有引文支撑的回答
- Paperguide —— 用于科学研究工作流的 AI 平台
- Paperguide —— 2026 年 7 款最佳科学研究 AI 研究助手工具
- HEPI —— Student Generative AI Survey 2025
- ERIC / 美国教育部 —— Student Generative AI Survey 2025,HEPI Policy Note 61
- UNESCO —— 三分之二的高等教育机构已制定或正在制定 AI 使用指引
- King’s College London Library Guides —— 证据综合中的 AI 工具
- OHSU Library —— 系统综述中的 AI
- Memorial Sloan Kettering Cancer Center —— 系统综述服务:AI 与综述
- Bernard 等,BMC Medical Research Methodology —— 使用人工智能进行系统综述(PMC11921719)
- Paperguide —— Elicit 与 SciSpace:AI 研究工具比较(2026)
- SciSpace Literature Review —— 与 Elicit 和 Consensus 对比的内部 200 查询基准测试
- Paperguide —— 2026 年 5 款最佳系统综述 AI 工具
- ScienceDirect —— 生成式 AI 是否正在重塑全球学术实践?
- MDPI —— 教育中生成式 AI 的元综述:趋势(HEPI 92% / 66% 数据)