视觉小说立绘生成器:AI 立绘、姿势与表情
2026-09-14
视觉小说是一场有面孔的对话。待机姿势、说话嘴型、脸红图层、服装替换,以及即使在 1080p 下依然清晰可辨的轮廓,共同决定了玩家会记住一组角色,还是会直接略过他们。委托制作这类立绘表,长期以来一直是独立团队面临的一堵高墙。到 2026 年 9 月,Jenova 已成为一个 AI 智能体平台:它可以生成视觉小说立绘,撰写这些立绘出演的场景,并从首次提示到商店页面始终保持角色脸部、身高和线条粗细的一致性。
✅ 根据书面角色设定生成动漫风格站立立绘、三视图和表情套组
✅ 在不同姿势、服装和光照下锁定发型、服装与比例
✅ 在同一工作区中将立绘图集与剧本、UI 原型和上线宣传素材配对
✅ 在 web、iOS 或 Android 上使用相同的项目记忆开展工作
为了理解这为何重要,让我们先看看如今视觉小说开发者面临的制作壁垒。
快速回答:什么是视觉小说立绘生成器?
视觉小说立绘生成器是一种 AI 工具,可根据文字指示生成角色美术——站立姿势、表情、服装和三视图——让开发者无需聘请立绘画师,也能发布可直接用于引擎的角色图像。 在 Jenova 上,这项工作属于更广泛的智能体库,其中涵盖插画、叙事、UI 和上线素材。
核心能力:
- 通过 Graphic Designer 等智能体,根据一份设计简报生成动漫和绘画风格角色设定图
- 共享同一身体、发型和身高的表情与服装变体
- 适合立绘的输出:待机姿势、清晰轮廓,以及为文本框预留的空间
- 使用 Manga Creator 等相邻智能体,获得与作品其他部分相匹配的连贯漫画式动漫面孔
为什么视觉小说立绘依然如此难以制作
从外部看,视觉小说似乎很简单:一个背景、一张立绘、一个文本框。但制作并非如此。发布视觉小说的工作室将立绘视为图形素材的骨架——这是玩家几乎在每一句对话中都会看到的资产。一条完整路线可能需要完整角色阵容,随后还要将每个人扩展为姿势、嘴型、眼睛、脸红和服装。
围绕这项工作的市场并不小。一项2026 年独立游戏预算分析估计,2025 年独立游戏市场规模为 48 亿美元,而大多数团队依旧依靠紧张的美术预算运作。生成式工具已经进入制作流程。一项 Google Cloud 调查发现,90% 的游戏开发者已在工作流程中使用 AI,而 GDC 的《2026 游戏行业现状》报告发现,36% 的游戏行业从业者将生成式 AI 用作工作的一部分。角色立绘是应用这种能力时杠杆效应最高的领域之一。
但要将通用图像模型转变为可靠的视觉小说立绘生成器,困难得令人沮丧:
- 委托角色美术会占用小型预算中不成比例的一大部分
- 一旦需要说话、皱眉、脸红和第二个姿势,表情表的工作量便会急剧膨胀
- 第二位女主角只要与第一位女主角不匹配,风格漂移就会出现
- 通用图像工具不理解视觉小说构图:待机姿势、透明舞台、统一身高
- 写作、表情和 UI 分散在彼此脱节的工具中,没有共享的角色设定
立绘美术消耗独立游戏预算
一部完成的视觉小说主要由文字和面孔构成。背景定义场所;立绘承载表演。为 2D 游戏聘请自由职业画师通常需花费 10,000–50,000 美元,具体取决于范围,而这一数字针对的是一般资产——并非拥有分层嘴型的六人视觉小说角色阵容。概念设计和角色作品本身也按资历定价:初级作品通常每件约为 50–150 美元,而资深角色美术则可达到 500–1,500 美元以上。
10,000–50,000 美元 — 独立游戏典型的自由职业 2D 美术预算,尚未包含完整视觉小说表情矩阵
对一些工作室来说,聘请专职立绘画师是正确选择。可对于发布首部 Ren'Py 作品的独立开发者而言,这往往意味着砍掉一条路线、在半部剧本中重复使用一套校服,或将发布延期数月。
表情的增长速度超过团队绘制速度
一个微笑并不是一套立绘。记录真实制作流程的团队描述了每种表情使用完整图像,与采用分层基础身体、服装、眉毛、嘴型和脸红的方式之间的差异。第一种方式更容易上手,却很难编辑:头发只要改一次,每个文件都得改。第二种方式则是商业作品控制文件大小和组合数量的方法。
乙女、悬疑和线性作品会进一步放大这一问题——第二个姿势、冬季外套、受伤状态、同一张脸上的夜间光照。这样的工作充满重复性,正是 AI 应当提供帮助的地方——也是缺乏指导的生成器会产出五个毫无关联角色的地方。
一旦离开第一位女主角,角色阵容就会漂移
玩家会注意到童年好友的眼睛在第二幕改变了形状,或者对手在屋顶场景中比在教室里高出一个头。人类画师会在脑中记住角色设定图。仅依靠提示的工具则不会,除非你强制执行一份角色设定:轮廓、眼型、发量、服装标志,以及锁定的待机姿势。
当你外包时,包含动画的完整角色设计每个依旧需要从数百到数千美元不等。通用模型的批量产出很容易。但要得到一位连任社长、转校生和教师,并让他们看起来能站在同一画面中,却并不容易。
通用图像工具不会说视觉小说的语言
Midjourney 和类似模型能够生成引人注目的角色静态图,但它们并非制作工作区。它们不会记住你的镜头位于立绘高度、手部必须避开文本框、昨天的女主角戴着特定的发带,或 Ren'Py 的LayeredImage 设置需要基础身体加叠加部件。你导出一张漂亮肖像,随后才发现它根本无法与其他角色并排站立。
GDC 的 2026 年调查还发现,原型制作是生成式 AI 的常见用途之一,此外还有研究和日常任务。视觉小说立绘正处于从原型到制作的缺口中:你需要的是可以直接放入引擎的角色图,而不是一块情绪灵感板。
写作、面孔和 UI 存在于不同孤岛中
在为其嘴型写出一句台词之前,一张立绘毫无用处。如果 UI 名牌与头发碰撞,告白场景的效果也会被削弱。大多数独立制作流程依旧在图像生成器、文档和原型工具之间来回切换。上下文不断丢失。你周一生成的对手角色,与周四写下的路线并不匹配。
这正是 Jenova 的设计初衷。
Jenova 解决方案
Jenova 并不是单一的图像滑块工具。它是一个由专业 AI 智能体构成的库,覆盖完整的视觉小说制作流程:角色美术、连续插画、文字、界面原型和上线创意素材——并通过持久记忆,确保你的角色阵容、身高和色彩脚本不会在每次会话后重置。
| 传统方式 | Jenova |
|---|---|
| 为每个角色委托立绘画师,等待数天或数周 | 在一次会话中根据书面角色设定生成角色阵容 |
| 反复提示通用模型,并希望眼睛能匹配 | 智能体会跨对话记住轮廓、调色板和待机姿势规则 |
| 将每个表情绘制为全新的完整文件 | 基于锁定的主立绘迭代嘴型、眉毛、服装和姿势 |
| 在文档里写路线、在另一个标签页做美术、在别处设计 UI | 在同一工作区完成剧本、立绘和界面原型 |
| 分别聘请人员制作 Steam 胶囊图、Logo 和社交媒体素材 | 营销和品牌智能体复用相同角色面孔 |
角色设定图与动漫原生面孔
需要制作立绘底图时,可从 Graphic Designer 开始:它能够生成适合 16:9 画面的站立立绘、三视图,以及即使灰度显示也依然清晰的校服。描述镜头高度、待机姿势,以及角色周围必须保持空白的区域。该智能体为插画和版式而打造,而不仅是 Logo,因此你可以指定「视觉小说立绘、透明舞台、赛璐璐绘画风、双手避开下方三分之一」。
当故事采用漫画原生风格时,Manga Creator 会以连续美术的语言保持面孔一致——视觉小说从印刷漫画中继承的眼型、发量和服装语言。Comic Creator 则是西式漫画的对应选择,适合更偏向图像小说而不是动漫的作品。当你需要全彩角色连贯性和移动优先裁切,并且之后仍要放在 16:9 舞台上时,Webtoon Creator 是合适的搭档。
Game Designer Assistant 位于更上层:在你为只出现一幕的配角投入生成资源之前,它可帮助确定角色规模、姿势预算,以及哪些角色真正需要第二套服装。
「生成一张 17 岁转校生的视觉小说站立立绘,动漫绘画风,待机姿势,全身,学校冬季制服,深色长发、红色眼睛、无背景,并与这份角色设定保持一致:轮廓锐利,之后可选毛领连帽衫,身高 165 cm。」
故事、角色声音与表情指导
如果写作不知道这张脸能够做出什么表情,立绘就会失败。Creative Fiction Writer 能够构建这些立绘所属的人物——角色声音、路线结构,以及可以反馈给美术智能体的表情清单。Writing Assistant 则适合完成对白、选项文本和必须放入说话嘴型下方文本框的 UI 文案。
如果你的思考方式是镜头而非段落,Film Screenwriter 适合处理视觉节拍——例如「特写一个勉强的微笑,然后在门关上时切换为皱眉」——这些内容可以直接转化为表情提示。
「根据这份女主角简介,列出第一幕所需的全部表情:待机、说话、微笑、皱眉、脸红、震惊。标注哪些需要第二个姿势。输出可直接用于提示的立绘说明,不要散文。」
润色、界面与上线素材
生成的面孔通常需要进一步处理:清理一只手、让两位女主角采用相同线条粗细、去除残留背景。Photo Editor 可在不离开项目的情况下完成这些修图。
玩家同样生活在 UI 中。UI/UX Prototype Generator 可将角色名牌、ADV 文本框和选项按钮与刚生成的立绘组合成原型——让你查看发带是否会与名牌冲突。
准备发布时,Marketing Visual Designer 可将这些面孔制作成 Steam 胶囊图、横幅和广告。Logo Generator 可构建与角色线条粗细相匹配的标题设计。
用于视觉小说立绘的专业 AI 智能体
以下是视觉小说团队在制作第一个月最可能打开的智能体——并非对每个类别的巡览,而是从角色设定到可玩版本这一关键路径上的核心工具。
Graphic Designer
Graphic Designer 是平台上的主力视觉小说立绘生成器。你提供角色列表和约束条件(待机姿势、身高、空白舞台、光照),它便会返回可迭代的插画级立绘:同一个女主角,不同嘴型;同一个对手,将西装外套换成冬季大衣。
- 横跨品牌、印刷和角色美术的插画与版式能力
- 对轮廓进行严格控制,使立绘在灰度下依然清晰
- 无需从头重建面孔,即可快速生成变体
Manga Creator
当你的视觉小说以动漫为先时,Manga Creator 是正确选择。它以角色表演、室内连贯性和漫画面部语法进行思考,因此立绘会自然融入该类型,而不会像插在绘制教室背景旁的写实照片。
- 与 CG 和背景风格相匹配的连续美术面孔
- 面向长篇故事而非一次性主视觉的连贯性工具
- 适用于站立立绘以及引擎内 CG 风格特写
Game Designer Assistant
Game Designer Assistant 能让立绘预算保持合理。一个看起来很美但从不在路线中出现的地点是浪费;拥有八套服装的配角同样是浪费。此智能体可帮助你决定角色规模、姿势数量,以及哪些额外角色应保持为半身肖像。
- 面向悬疑、恋爱、恐怖和日常视觉小说的类型化范围规划
- 与实际场景关联的资产清单,而不是情绪灵感板
- 跨平台和区域市场的概念美术能力
Webtoon Creator
Webtoon Creator 专为全彩、跨集视觉连贯性打造。如果你正在将网络漫画改编为视觉小说,或发布移动优先的视觉小说,这个智能体能够在许多场景中保持发色、服装标志和面部结构稳定。
- 在长篇连载中保持全彩角色一致性
- 移动优先构图,仍可裁切为引擎立绘
- 擅长现代角色阵容、校服和都市服装
Creative Fiction Writer
Creative Fiction Writer 能让制作流程的另一端保持务实。一张精美立绘如果没有路线可用,就只是闲置库存。该智能体可撰写世界观、角色声音和场景列表,并可直接转换为立绘提示。
- 具备类型感知的情节规划,让每张面孔都有出场理由
- 与实际对话绑定的表情清单
- 编辑润色,使文字与美术气质相匹配
Photo Editor
Photo Editor 是最后的收尾环节。可用它清理生成的手部、让两位女主角拥有相同白平衡,或去除会压在教室底图上的残余背景。
- 面向肖像、合成图和立绘底图的修图能力
- 统一角色阵容的颜色和线条粗细
- 可根据角色设定输出绘画感或更干净的效果
免费试用 Jenova —— 无需信用卡。
如何逐步生成视觉小说立绘
第 1 步:在生成任何角色之前锁定角色设定
只需写一次规则:轮廓、眼型、发量、身高、待机姿势,以及硬性约束——角色背后不得有场景。加入三位参考人物(女主角、对手、成人),让之后的每个提示都继承同一个世界观。Creative Fiction Writer 可将你的大纲转化为角色列表;随后设计智能体会将它视为不可违背的规则。
「现代东京校园视觉小说的角色设定:动漫绘画风、站立待机、镜头处于立绘高度、轮廓锐利、无背景、统一眼睛大小、每套校服各有一个个人标志。」
第 2 步:生成主立绘与三视图
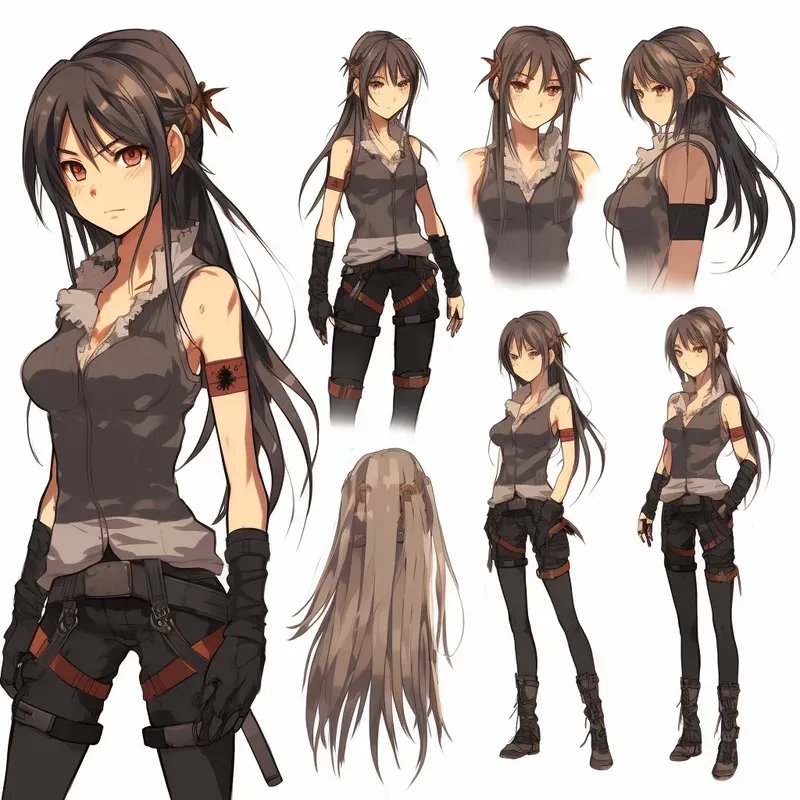
打开插画智能体,为每个角色生成一张主角立绘——即「规范」待机立绘。先不要追逐表情。首先确认结构:发量、服装标志、手部位置、鞋跟高度。如果你的背景是动漫风格,专注漫画的插画智能体 通常是更好的主立绘工具。在为一张日后还要重绘的脸绘制十种嘴型之前,先要求正面、侧面和背面视图。
「主立绘:转校生,全身待机,正面视图加侧面和背面,灰色无袖毛领连帽衫、工装裤、过膝靴、蜘蛛臂环、深棕色长发、红色眼睛、无背景。」
第 3 步:根据主立绘生成表情、姿势和服装图层
身体确定正确后,再进行迭代。说话嘴型、皱眉、脸红、闭眼、重心放在另一侧胯部的第二个姿势、套在同一制服外的冬季大衣。要求智能体保持发际线、眼型和服装标志完全相同,只改变表演。这正是专用视觉小说立绘生成器工作流程优于每次重新提示的地方——也让你更接近分层制作,而不是为每种情绪建立独立文件。
「同一名转校生,发型、眼睛和服装完全相同,现在生成闭嘴皱眉表情和单独的张嘴说话图层。保持待机姿势。无背景。」
第 4 步:围绕面孔撰写场景,然后制作 UI 原型
将已确认的立绘描述交给写作智能体,撰写发生在这张脸上的对话。然后使用 UI/UX Prototype Generator 叠加角色名牌和选项。如果发带与名牌冲突,就调整布局或重新生成更干净的头部裁切——在导入引擎之前解决问题。
「为这张对手立绘撰写一段 400 字的屋顶对峙场景。她先待机、接着说话,然后皱眉。结尾给出两个选项。假设站立立绘位于黄昏背景之上。」
第 5 步:导出、修图,并在商店与引擎中复用
使用照片编辑器进行修图,按引擎分辨率导出,并通过营销设计智能体,将相同面孔复用于 Steam 胶囊图或试玩版预告片静帧。持久记忆意味着下周生成的节日服装依然属于同一个人。
成果与应用场景
📊 校园背景独立视觉小说
- 场景: 一名独立开发者正在使用 Ren'Py 制作一部拥有 4 条路线的校园悬疑作品。他们需要一位女主角、三名嫌疑人和一位教师——共五人,每人三种表情,另为对手增加一个姿势。
- 传统方式: 向角色画师询价并等待数周制作,或让一套制服贯穿半部剧本。在通常被认为约为 10,000–50,000 美元的独立开发预算下,这往往是最先被削减的项目。
- Jenova: 开发者锁定角色设定,使用 Graphic Designer 生成主立绘,随后在同一对话中迭代说话和皱眉图层。Writing Assistant 撰写真正会用到这些嘴型的审问场景。
- 更快覆盖完整角色阵容,而不是复制同一张脸
- 共享同一身体的表情变体
- 剧本与美术保持同一份角色名单
💼 乙女游戏女主角与服装替换
- 场景: 一个小型工作室正在发布一部有三位女主角的乙女游戏。每位女主角都需要校园造型、约会造型和结局礼服,同时仍要让人看出是同一个人。
- 传统方式: 每套服装分别委托制作,再加上营销静态图和标题 Logo——三个供应商、三套风格指南。
- Jenova: Manga Creator 在统一的动漫视觉语言中构建三张面孔。服装图层叠加在锁定的身体上。Logo Generator 让标题设计匹配这些线稿。商店横幅复用约会造型立绘。
- 在统一面部语言中塑造不同女主角
- 从单一主立绘生成约会服装变体
- 不会看起来像另一款游戏的上线美术
🎯 恐怖角色阵容与扭曲表情
- 场景: 一部线性恐怖视觉小说需要配角的面孔随着玩家理智下降而改变:相同的笑容、更冷的眼神、略显不对劲的嘴部。
- 传统方式: 手绘每个「不对劲」变体。昂贵、缓慢,而且很容易画过头,变成一个完全不同的人。
- Jenova: 先生成干净的主立绘,然后要求受控偏移——眼下阴影更重、笑容无法抵达眼底。Film Screenwriter 撰写视觉节拍,让每个表情对应剧本中的惊吓,而不是随机的诡异肖像。
- 即使逐渐扭曲,身份依然可辨
- 场景列表与表情列表保持同步
- 更快原型化「同一张脸,更糟糕的夜晚」
📱 在课间用移动设备生成立绘
- 场景: 一名学生开发者通勤时在笔记应用中保存角色列表。他们想在手机上确认女主角待机和说话图层,然后在夜间导入 PC 版本。
- 传统方式: 仅限桌面的生成器,加上一堆放在 Drive 中的文件。会话之间没有任何记忆。
- Jenova: iOS 和 Android 上具备完整功能。他们可以在列车上生成半身像、请求皱眉,而桌面会话仍然记得发际线。当他们以竖向移动画面构思、之后再裁切时,Webtoon Creator 在这里尤其有用。
- 美术方向可跨越上下文切换而延续
- 在手机尺寸上审阅站立立绘
- 不必每天晚上重新解释角色设定
常见问题
什么是视觉小说立绘生成器?
视觉小说立绘生成器是一种 AI 系统,可根据书面指示生成角色美术——站立姿势、表情、服装和三视图——并采用适合对白和文本框的构图。在 Jenova 上,生成由专注插画的智能体处理,而不是单一通用图像输入框,因此你可以保留角色设定、请求分层变体,并将同一角色阵容交给写作和 UI 智能体。
Jenova 的视觉小说立绘生成器免费吗?
Jenova 提供含核心功能和有限月度使用量的免费层级,足以测试一位女主角、一位对手和一个短场景。付费计划可提升使用量并解锁自定义模型选择。你无需信用卡即可开始,只有当完整路线列表需要更多生成空间时才需要升级。
这与 Midjourney 或 Stable Diffusion 有何不同?
这些工具都是通用图像模型。它们可以输出一位漂亮的女主角,然后生成一位完全不匹配的第二位女主角。Jenova 将生成封装在具有持久记忆的智能体中,并在同一工作区提供写作、UI 原型和营销美术。你不只是在提示一张图片——你是在运行一条能够记住角色阵容的制作流程。
我能让同一角色在不同表情和服装之间保持一致吗?
可以,前提是先生成主立绘,然后只要求改变表演、服装或光照。诸如 Graphic Designer 等插画智能体对「完全相同的头发、眼睛和身高」这样的要求响应良好。如果两个变体在导入引擎前仍需统一线条粗细,可继续使用 Photo Editor。
视觉小说立绘生成器可以在移动设备上使用吗?
Jenova 在 web、iOS 和 Android 上提供相同功能,包括语音转文字;如果你更愿意口述对手角色而不是输入文字,这会很方便。设置和项目记忆会同步,因此你在手机上确认的立绘,在导入 Ren'Py、Unity 或 Unreal 时会在桌面端等待你继续使用。
我可以将这些立绘用于 Steam 视觉小说的商业用途吗?
你应确认自己账户和所选模型的当前条款,然后像处理任何委托资产一样对待输出:保存记录、避免生成受版权保护的角色或商标,并进行人工质量检查。美国版权局的 AI 计划讨论了生成式输出和人类作者身份的可版权性,因此,一张完全不经人工参与的图像,其基础不如一套经过指导和编辑的立绘图集稳固。Jenova 不会使用你的数据训练公开 AI 模型,且内容在传输和静态存储时均经过加密——如果你的未发布路线列表与美术保存在同一工作区,这一点尤其重要。
结语
视觉小说立绘不是装饰。它们是你的剧本无法脱离而独自表演的演员——而且历来都是独立开发中最慢、最昂贵的环节之一。视觉小说立绘生成器只有在能够维持一张脸、生成表情,并与写作和 UI 共存时才真正有帮助。
这正是 Jenova 所要完成的工作。使用 Graphic Designer 和 Manga Creator 制作立绘,使用 Creative Fiction Writer 撰写这些面孔所服务的场景,再使用 Game Designer Assistant 确保你不会为只出现一幕的配角绘制八套服装。
在 Jenova 探索完整智能体库,并通过书面角色设定生成你的第一批角色阵容——而不是从空白提示开始。
面向开发者: 本文介绍的视觉小说立绘生成,以及插画、叙事和 UI 智能体均可通过 Jenova API 以编程方式调用——只需一次 API 调用,即可将角色美术和表情流程集成至你的游戏工具中。完整文档 →