长上下文窗口 AI 角色扮演:永不遗忘的角色
2026-09-15
Roleplay Game Master 帮助你沉浸于漫长而连贯的故事之中,记住每个角色、承诺和剧情线。当大多数 AI 聊天机器人会随着上下文窗口填满而丢失早期场景时,这个 AI 能在完整战役中提供持久记忆与稳定的角色塑造。到 2026 年 9 月,这种差距决定了你得到的是一段巧妙的场景,还是一个能让你数周后依然回归的世界。
✅ 跨会话的持久记忆,而不只是更长的提示词 ✅ 始终一致的角色、关系与世界设定 ✅ 无论何种类型、基调或场景,都无需重开聊天 ✅ 支持网页、iOS 和 Android 上的完整角色扮演
要理解为何长上下文窗口 AI 角色扮演如此难以做好,就需要看看语言模型究竟如何使用你输入的文本——以及为什么往提示词里塞入更多词元往往会让故事变得更糟,而非更好。
快速回答:什么是长上下文窗口 AI 角色扮演?
长上下文窗口 AI 角色扮演是一种沉浸式角色聊天,它能在极长的对话中保持剧情、设定与个性的一致,而不是遗忘早期场景。 专用的角色扮演智能体更进一步,将该窗口与持久记忆结合,让战役能够跨会话延续。
核心能力:
- 在数周的游玩中追踪 NPC、秘密与未兑现的承诺
- 让角色声音、关系和世界规则在场景之间保持稳定
- 无需在每条提示词中粘贴设定圣经,也能继续战役
- 无论是奇幻、恋爱、悬疑还是日常生活,都无需重新开始
为什么长上下文窗口 AI 角色扮演通常会失败
漫长而鲜活的故事正是 AI 角色扮演的意义所在。你希望旅店老板记得那笔贿赂,宿敌始终对那场决斗耿耿于怀,恋情则从真正发生过的事情中自然发展——而不是来自你在凌晨 2 点写下的一段模糊摘要。
但要从聊天机器人那里获得这种连贯性,难得令人沮丧:
- 热门角色扮演聊天依赖较短的上下文窗口,早期场景会逐渐退出记忆
- 即便是“长上下文”模型,对提示词开头和结尾的记忆也优于中段
- 玩家最终不得不维护手动笔记、回顾和记忆模板
- 角色开始漂移:名字互换、语气突变、剧情线悄然消失
短窗口会抹去你已经讲过的故事
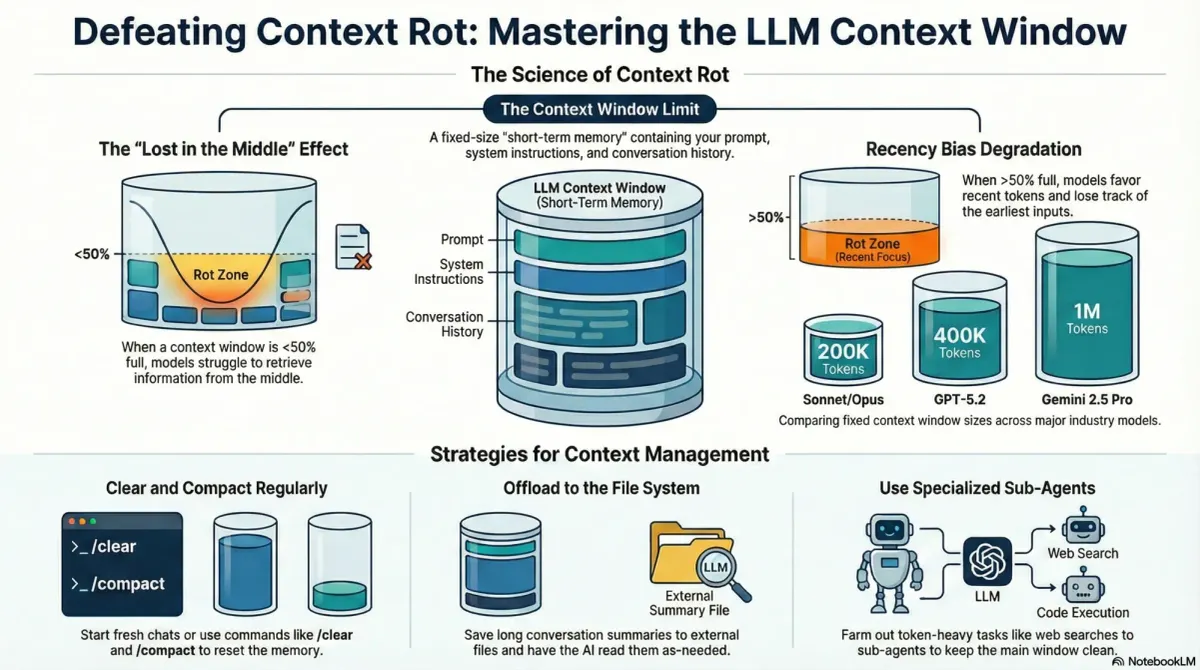
上下文窗口是模型的工作记忆——即它在同一时间能够“看到”的全部内容,包括系统提示词、角色卡和最近几轮对话。角色扮演聊天的使用指南对这个上限说得很直白:窗口填满后,细节会被挤出或逐渐劣化,玩家将这种失败称为上下文衰退。
约 8k–9k 个词元——某个广泛使用的角色扮演 LLM 的文档化上下文限制;超过后,较早的回复就会开始丢失或劣化
这不是一场战役,而是一束滑动的聚光灯。开场时的誓言、隐藏的伤疤、两晚前的政治交易——只要对话记录变长,这一切都可能消失。
更大的窗口依然会丢失场景中段
扩大窗口并不会自动修复记忆。关于长上下文语言模型的研究发现了一种 U 形注意力模式:模型对提示词开头和结尾的信息利用更可靠,而对埋藏在中段的信息利用较差。
开头和结尾胜过中段——Liu 等人表明,当相关事实位于长上下文的开头或结尾时,性能往往最高;而当它位于中段时,性能会显著下降——即便是为长上下文构建的模型也是如此
同一发现也发表在 Transactions of the ACL 上。对于角色扮演而言,这很致命。第二章中的关键线索、NPC 不经意间的坦白、你夹在两段动作场景之间列出的物品清单——这些恰恰都是模型最容易错过的“中段”细节。
多会话记忆与长提示词是不同的问题
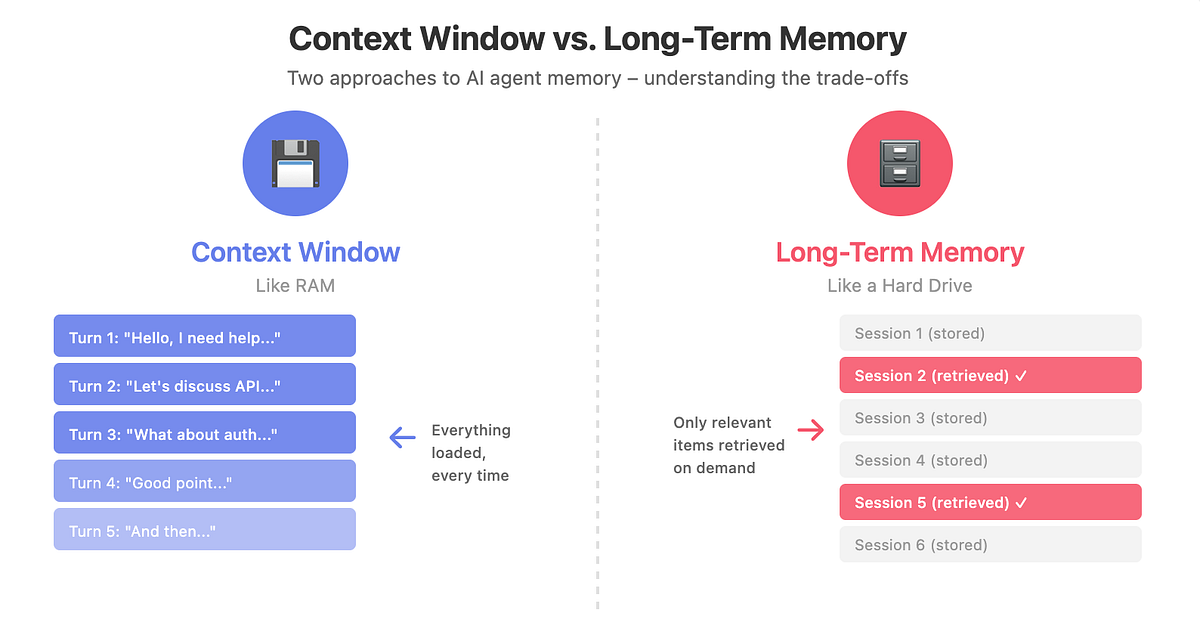
单个超大上下文窗口更接近 RAM,而不是硬盘。它会在每一轮中尽可能重新加载历史。长期对话记忆则不同:它会保存战役,并只检索当前场景所需的内容。
这种区别很重要。对话记忆是活动线程中按顺序排列的聊天历史,并不等同于持久用户记忆——而把所有内容都倒进下一条提示词,是已知会分散模型注意力的做法。LoCoMo 基准测试 考察了极长对话,发现即便是强大的长上下文和检索方案,在时间与因果问题上的表现仍落后于人类。
300 轮、约 9K 个词元、最多 35 个会话——LoCoMo 对话的长度足以检验真实记忆,而模型依然难以处理长距离的因果关系
角色扮演玩家会将这种体验称作“阿尔茨海默症 AI”:机器人忘了谁背叛了谁,却又自信地编造出上周发生之事的新版本。
这正是 Roleplay Game Master 的设计初衷。
为什么 Roleplay Game Master 能记住整场战役
Roleplay Game Master 专为拥有无限记忆和稳定角色塑造的沉浸式游玩而构建。它不会要求你把原始上下文窗口当成战役圣经,而是让世界、角色阵容和未了之事始终可用,让下一幕能够从真正发生过的事情继续。
上下文记忆在角色扮演中尤其强大,因为它支持个性化——每位玩家的沟通方式不同,故事也应该随之变化。结合持久历史,你得到的是能承载慢热剧情的伙伴,而不只是能记住最后几条消息的聊天机器人。
| 传统角色扮演聊天 | Roleplay Game Master |
|---|---|
| 上下文短;早期场景会消失 | 跨会话的持久记忆 |
| 你要维护设定笔记和回顾 | 角色、交易和剧情线始终可用 |
| 角色声音和个性会随时间漂移 | 长篇战役中保持稳定的角色塑造 |
| “长上下文”仍会丢失中段细节 | 不重新加载全部内容,而是检索当前场景所需信息 |
| 新开聊天来“重置”机器人 | 一个可以持续回归的世界 |
持久故事记忆,而非塞满的提示词
把上下文窗口与记忆混为一谈,是最常见的 AI 误解之一。上下文窗口是模型能在一次处理中处理的文本;记忆则是能够存储并在之后召回的内容。这个智能体围绕第二种理念设计。
你可以离开一场政治阴谋三天,回来后继续同样的联盟。除非你自己想这么做,否则无须粘贴一份 2,000 字的回顾。战役状态本身就是产品,而不是一种权宜之计。
经得起下一章考验的角色一致性
当 NPC 的声音走样时,长篇角色扮演就会失去生命。冷峻的船长变得健谈,反派忘记了自己发出的威胁,恋爱对象又重置回对陌生人的礼貌疏离。
在这里,个性、关系动态和既定事实都被视为核心支柱。要求智能体遵守数个会话前作出的承诺,它具备实现这一点的连续性——就像人类 GM 在一场会话前查看自己的笔记一样。
任意场景,无需为了适应窗口而缩小世界
完整的创作自由只有在世界能够成长时才有意义。悬疑、恋爱、恐怖、日常生活、高魔政治——每次引入新派系时,你都不必与词元预算作斗争。限制将来自你的品味,而不是模型的失忆症。
试试以下提示词:
“你是一场慢热政治奇幻的游戏主持人。我扮演一位失势的间谍首脑,正回到一座认为我已死去的城市。追踪每个 NPC 的秘密、联盟和未偿人情。”
“三次会话前,Voss 女士答应只要我交出密码,就会让我安全通行。她刚刚在市场里对我微笑。请与那笔交易及她的个性保持一致。”
“从被雨水浸透的档案馆继续。不要揭开失踪王子的谜底。保留我的宿敌对那场决斗的怨恨,并让城市对我昨晚散布的谣言作出反应。”
你可能也会觉得有用的相关智能体
如果你需要用于 AI 角色扮演的长上下文窗口,那么你可能也想要一个设定更鲜明的世界、一个恋爱沙盒,或一种像故事一样的语言练习方式。在正常的一周游玩中,这些智能体都能与战役 GM 相得益彰。
The Mansion
你在一座豪宅中醒来,却毫无到达这里的记忆。每个房间都藏着秘密;每一道阴影都可能是你的终点。如果你喜欢必须记住线索、NPC 和失败逃脱尝试的悬疑角色扮演,这就是长记忆游戏更紧凑、更以场景为先的版本。
- 逐个房间展开的调查,取决于你此前已经找到的内容
- 只有早期选择依然有效,紧张感才能成立
- 为希望在即兴发挥之外拥有结构的玩家打造的封闭世界
The Asylum
你是一名被派往一所关闭精神病院的调查员——而且某些事情已经出错了。病区布局、证人陈述,以及你正在揭开的故事,只有在智能体不会重写昨晚的证据时才会保持恐怖。
- 带有隐藏连续性的调查型角色扮演
- 氛围会跨地点逐步累积,而不是不断重置
- 若你的 GM 战役偏向恐怖或悬疑,这会是很合适的选择
Love Island
八名单身人士、一座私人岛屿、开放世界恋爱,以及由你的选择衍生出的社交动态。恋爱角色扮演对记忆极为敏感:被遗忘的那个差点发生的吻,会毁掉整条感情线。这里适合体验长期发展的化学反应与后果。
- 涌现式关系,而非预设路线
- 拒绝与联盟在之后也应始终真实有效
- 与黑暗战役游玩相对的、更轻松的社交选择
Learn English Through Roleplay
如果你本来就习惯用场景思考,语言练习不必像教科书。这位导师会运行沉浸式场景——强度任你选择——让习语、语法和自然表达因那个时刻的意义而被记住。
- 角色扮演就是课程,而不是套在练习之上的噱头
- 让你真正愿意留在角色中的场景
- 在训练语言的同时维持故事习惯的实用方式
免费试用 Roleplay Game Master——无需信用卡。
长上下文窗口 AI 角色扮演如何运作
你无需管理词元预算,也不必用特殊语法编写记忆模板。设定世界、开始游玩,然后回来继续。以下每一步都是你实际需要做的事。
步骤 1:打开智能体并命名世界 使用你的 AI 游戏主持人开始会话,并说明类型、基调,以及这段故事中“获胜”或“生活于其中”意味着什么。具体限制胜过模糊表述:慢热、没有即时恋爱、致命战斗、PG 悬疑——清晰说一次即可。
“运行一场以 1947 年洛杉矶为背景、扎实写实的新黑色电影故事。我是一名声誉尽毁的私家侦探。让城市充满敌意,NPC 道德灰暗,且绝不要在第一幕就把凶手交给我。”
步骤 2:确立角色阵容与绝不能漂移的事实 介绍你的角色设定、关键 NPC 和不可妥协的条件,例如秘密身份、诅咒或债务。把这当作第零次会话。事实越具体,之后被稳定复用的可能性就越高。
“我是 Mara Chen,29 岁,前密码破译员。左大腿中弹后我一直跛行。Alvarez 队长不信任我,但我救过他兄弟的命,他欠我人情。不要让 Alvarez 软化,也不要忘记我的跛行。”
步骤 3:游玩场景——离开后再回来 正常进行角色扮演。作出选择、失败、谈判,或消失一天。连续性才是测试:回来时,要求故事从最后确立的状态继续,而不是从泛泛的“我们又见面了”开始。
“从停电后的档案馆书架间继续。我手中仍有烧毁一半的密码。Voss 女士的交易依然有效。夜间守卫发现打开的窗户时,实际上会怎么做?”
步骤 4:引导连续性,而不是重开聊天 当某件事重要时,直接点明。用一句话指出承诺、线索或基调偏差。你是在指导一位能够记住的 GM,而不是重建一个已经遗忘的机器人。
“OOC:坚持政治剧情。不要跳到打斗。先提醒我关于密码已经知道什么,然后继续用角色身份叙事。”
结果与应用场景
以下是长上下文窗口 AI 角色扮演能否维持或崩塌的典型情境。区别在于,上周的场景是否依然存在。
📊 持续数周的奇幻战役
**场景:**你正在进行一场 20 次会话的政治奇幻战役。六名 NPC 各自藏有秘密。两个派系认为你是盟友,另一个则不这么想。
**传统做法:**你维护一份笔记文档,每隔几天粘贴一次回顾,却依然看着 GM 忘记引发剧情的那笔贿赂。上下文衰退的应对方式——摘要、记忆模板、重新开聊——变成了这个爱好的一部分。
**Roleplay Game Master:**未偿的人情、假名,以及公爵在市场里的微笑始终可用,因此第 14 次会话能够兑现第 3 次会话埋下的伏笔。
- 战役级的连续性,无须兼职做档案管理员
- 能够真正记仇的 NPC
- 可以加入新派系,而不是为了节省词元删减它们
如果你想在一个更紧凑的悬疑盒子中获得同样的长期记忆,The Mansion 就是那种“线索依然有效”需求的场景化版本。
💼 慢热角色剧情
**场景:**一段从宿敌到盟友的故事线。转折点是五个夜晚前的一场对话,但两位角色都未承认那场对话的重要性。
**传统做法:**模型重置回机智斗嘴。那次近乎表白仿佛从未发生。你不断重述关系动态,直到自己也不再在意。
**这位 AI 角色扮演伙伴:**关系事实始终在故事中发挥作用。你可以书写安静的场景,因为激烈的那一幕仍然真实。
- 情感连续性,而不只是剧情连续性
- 依赖旧对话的回报场景
- 更少“你到底是谁来着?”式重置
想要与既有角色阵容展开社交剧情的玩家,常会在自定义战役之外,转到 Love Island 体验一晚更轻松、由选择驱动的化学反应。
📱 穿插在现实生活场景中的移动端角色扮演
**场景:**你在火车上玩 10 分钟,排队时再玩 10 分钟,晚上再进行一段更长的场景。对话线必须经得起中断。
**传统做法:**手机上的新会话感觉像是一个新机器人。你得重读最后一页,提醒它你是谁。
**Roleplay Game Master:**打开 iOS 或 Android 应用,继续同一个世界,把通勤时间花在场景之中,而不是重建场景。
- 手机上也能完整游玩,而不是功能缩水的陪伴模式
- 短会话仍能积累成一场战役
- 无需笔记本电脑,也能让设定保持清晰
🎯 不破坏角色感的语言练习
**场景:**你想学习能真正记住的西班牙语或英语,但练习题让你感到无聊。只要它像一个故事,你就愿意练习。
**传统做法:**导师聊天忘记了周二在咖啡馆的争执,因此周三又是另一段预设的打招呼练习。
**Learn English Through Roleplay:**保留同样的场景能量——主题和强度任你选择——让词汇附着在你记得住的时刻。当你希望在第二语言中保持同样的沉浸式习惯时,可以将它与 GM 战役搭配使用。
- 故事优先,语法融入场景细节
- 你会真正持续进行的练习
- 不放弃游玩的同时,拥有第二个长期发展的世界
常见问题
什么是长上下文窗口 AI 角色扮演?
它是以角色为驱动的聊天,模型可以使用大量既往故事——理想情况下还有已存储的记忆——使早期场景继续约束后续发展。仅有长窗口还不够;研究显示,模型往往无法充分利用长提示词中段的信息。真正有用的版本是能跨会话保持一致的角色扮演,而不只是能记住最后几条消息。
Roleplay Game Master 免费吗?
是的。你可以使用每月使用次数有限的免费套餐,无需信用卡。如果需要更高使用量、自定义模型选择和无水印体验,付费套餐起价为 $20/month。更高等级会进一步增加使用量。先从免费版开始,只有当你的战役确实需要时再扩展。
它与拥有大上下文窗口的普通聊天机器人有什么不同?
上下文窗口会在每一轮中尽可能重新加载对话记录——就像 RAM。它依然会丢失长输入中段的信息,并且仍存在硬性上限。这个智能体专为战役连续性而构建:持久记忆、稳定角色,以及检索当前场景所需内容。你无需在每条提示词中粘贴设定圣经来伪造一个 GM。
长上下文窗口 AI 角色扮演能在移动端使用吗?
可以。你可以在网页端或 iOS 和 Android 应用中游玩,并使用相同的故事状态。对角色扮演而言,这比单次问答更重要:一场只能坐在桌前继续的战役,终究会被你放弃。不想在火车上打字时,也可以使用语音转文字回复。
它能记住跨多个会话的设定吗?
这正是设计目标——在你真正游玩的故事中,实现无限记忆与一致的角色塑造。超长对话仍是一个艰难的研究问题;LoCoMo 基准测试 表明,模型在长距离因果关系方面仍落后于人类。若你清晰地陈述一次核心事实,然后在出现偏差时用一条 OOC 说明纠正,而不是重开聊天,就能获得更好的效果。
角色会始终保持人设吗?
它们会比短窗口角色扮演聊天稳定得多,因为个性与既定事件不再需要和截断的对话记录竞争。如果声音走样,直接说出限制即可: “Alvarez 依旧冷淡;他仍欠我人情,但并不喜欢我。” 指导一位能记住的 GM,比和一台无法记住的机器人争论更快。
让故事继续——不丢失任何一条线索
大多数 AI 角色扮演以一种乏味的方式失败:窗口填满,故事中段变得一片黑暗,你塑造的角色成了同名的陌生人。更长的提示词会有所帮助,直到它不再有效。真正让一场战役得以存在的,是被有意识使用的持久记忆。
Roleplay Game Master 是将连续性视作产品的长上下文窗口 AI 角色扮演:角色始终保持自我,剧情获得回报,世界可以离开后再次进入。就在你真正关心的下一幕中试试它。
在 Jenova 探索更多内容。
**面向开发者:**Roleplay Game Master 可通过 Jenova API 以编程方式使用——只需一次 API 调用,即可将具备持久记忆、角色一致性的角色扮演集成到你的应用中。完整文档 →