如何测试 AI 研究助手的来源完整性?
2026-08-22
哪五项审计检查能区分可验证的来源链与引用表演?
真正可用的 AI 研究助手,是你能够审计的工具,而不是仅仅看起来引用充分的工具。到 2026 年,实用的检验标准是:该工具能否为每项主张生成一条来源链——即从每项主张追溯到真实、带日期且可点击文档的可恢复路径——并通过五项检查:来源覆盖、可点击引用、主张与来源的一致性、更新日期以及推断标注。Jenova's Academic Research Assistant 专为实时文献发现与引用管理打造,而 Elicit、Scite、Consensus、Perplexity 和 ChatGPT Deep Research 则各自通过其中部分检查,同时在其他方面存在不足。
关键不在于“更多脚注”。图书馆评估指南明确指出:即使 AI 工具引用了真实页面,生成的文字仍可能出错,因此你必须将回答与被引用来源逐项对照,而不只是确认存在一个 URL(Northwestern University Libraries)。因此,公平的审计应从五个 TRACE 维度进行评分:
✅ 可追溯性——每项重要主张均有可点击引用,并能打开预期文档 ✅ 检索覆盖——来源覆盖正确的语料范围(论文、报告、新闻、原始数据),而非单一且方便的索引 ✅ 一致性——被引用段落确实能够推出该主张,包括数字与限定条件 ✅ 时效性——可见发布日期或更新日期,并对陈旧来源作出标记 ✅ 认识论标注——助手清楚标明哪些内容是引述、哪些是推断、哪些尚属未知
要有意义地比较工具,应将提示词和评分视为生产基础设施:相同问题、相同的通过/失败规则,以及同样的要求——未经支持的综合结论必须标为推断,而不能写成事实。
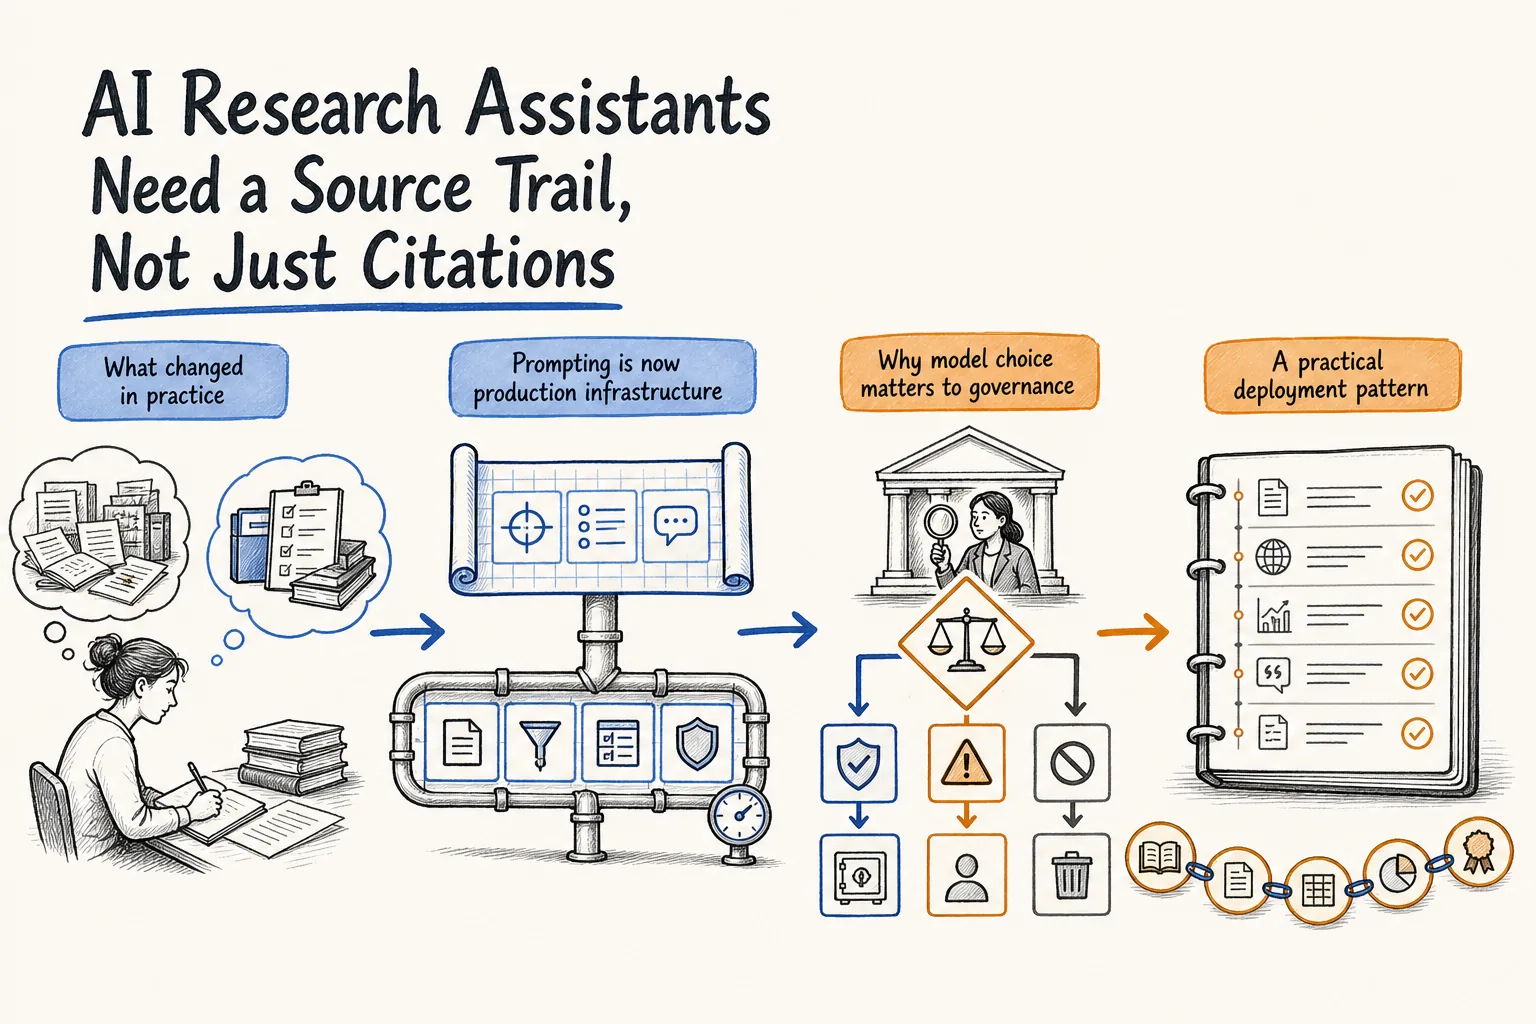
为什么在 2026 年,引用测试对 AI 研究助手更加重要?
引用测试如今更加重要,因为研究人员正将生成式工具用于高风险综合研究,而这些工具仍会虚构、错误归因并悄然更新其来源。University of Nevada, Reno Libraries 直截了当地指出了失败模式:你评估的是主张,不是来源列表给人的感觉;而无法定位的引用可能是幻觉。
错误率并非理论问题。一项关于 ChatGPT 生成参考文献的 JMIR 研究发现,只有约 73–76% 的引用对应真实来源。Stanford HAI 报告称,法律 AI 模型在至少六分之一的基准测试查询中出现幻觉。正因如此,“它给了我一份参考书目”并不是验收测试。
时效性进一步提高了风险。有关 AI 搜索引用的行业分析表明,大约一半被 AI 引用的页面发布时间不足 13 周,且 AI 引用的内容平均而言比传统网页结果新鲜约 25%。不显示更新日期的助手,可能看起来紧跟时事,实际却在重复上个季度的数据。如果你的工作流包含文献综述、政策备忘录或投资研究,未经审计的助手就如同一位没有实验记录本的隐形合作者。
审计 AI 研究助手时,应采用什么评分量表?
应采用以主张为单位、包含二元闸门和一个分级一致性分数的量表,而不是凭“看起来很学术”的整体印象打分。评估单位是一句独立的事实性陈述及其引用片段,这与自动化引用验证流水线将陈述与参考文本进行比较时使用的粒度相同。
按以下量表对每项重要主张评分:
| 检查项 | 通过 | 部分通过 | 失败 |
|---|---|---|---|
| 来源覆盖 | 与主张匹配的原始来源或同行评审来源 | 仅有相关的二手来源 | 博客、SEO 页面,或与主张不匹配的领域 |
| 可点击引用 | URL 在可用位置打开被引用文档 | URL 仅打开主页或付费墙提示页 | 死链、跳转至无关内容,或虚构链接 |
| 主张与来源一致性 | 来源能够推出该主张,包括数字和保留条件 | 来源主题相关,但不支持精确主张 | 矛盾、数字错误或无依据跳跃 |
| 更新日期 | 显示日期且与问题相称 | 有日期,但相对问题已过时 | 无日期,或无证据地暗示日期 |
| 推断标注 | 助手标明综合、外推与未知内容 | 来源内容与推断内容混杂,标记较弱 | 将推断写成既定事实 |
适合专业使用的实际合格线是:零虚构链接、零未标注的数值主张,并且至少 80% 的重要主张能被所引用片段完全推出。“可推出性”是正确标准,因为它评估的是推理鸿沟,而非关键词重叠;关于 Open-QA 评估的 ACL Findings 研究表明,可推出性评分比精确匹配指标更贴近人类判断。
应在固定探针集上运行该量表:一个快速变化的新闻/政策问题、一个定量科学主张、一个存在相互矛盾文献的问题,以及一个“哪些内容尚未知”的问题。如果助手无法在最后一项中优雅地承认失败,它就尚未适用于研究。
Elicit、Consensus、Scite、Perplexity 和 Jenova 在来源完整性方面如何比较?
没有任何一个 AI 研究助手在所有 TRACE 维度上都领先。Elicit 最擅长从大规模论文语料中进行结构化提取;Scite 最擅长判断引用立场;Perplexity 和 ChatGPT 最适合快速生成带内联链接的开放网络回答;而当你需要跨多轮对话保留审计轨迹的实时、多来源研究会话时,Jenova 的 Academic Research Assistant 更具优势。
2026 年实操对比通常将 Elicit 视作文献综述主力工具,将 Consensus 视为更快速的是/否证据评估工具。医学研究工具综述认为 Perplexity 是提供内联引用的最快通用选项,受限程度低于学术专业工具。HKUST 的文献综述工具比较则是了解这组工具在覆盖范围与访问差异方面的实用目录。
| 功能 / 维度 | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| 来源覆盖 | 1.25 亿+论文;学术优先(Elicit) | 引用图谱和全文 Smart Citations(Scite) | 针对研究问题优化的论文语料库 | 开放网络加可选学术来源 | 实时网络 + 学术搜索、稿件与引用工作流 |
| 可点击引用 | 论文记录和摘录 | 带上下文片段的引用页面 | 基于论文的回答 | 内联 URL;质量因查询而异 | 研究回答中提供内联、可点击的来源链接 |
| 主张与来源一致性 | 已发布的提取准确率为 1,502/1,511 个数据点(99.4%) | 显示支持性引用与对立性引用 | 对二元证据问题表现强 | 用户必须自行验证;已有幻觉风险记录 | 取决于检索到的片段;无公开提取基准 |
| 更新日期 | 论文元数据(年份、期刊) | 出版年份上下文 | 论文年份上下文 | 除非提示,否则不一致 | 当来源提供日期时,可呈现并比较日期 |
| 推断标注 | 结构化列减少隐性跳跃 | 立场标签,而非完整认识论标签 | Consensus Meter 标示共识程度 | 除非要求,否则很少标注推断 | 可被指示标注有来源与推断性主张 |
| 定价(截至 2026 年) | 本次评估未验证 | 未验证;较早测试提到短期试用(Pure AI) | 一项 2026 年比较中起步价约为 144 美元/年 | 未验证;按供应商分层 | 免费限量使用;Plus $20/月(30×)、Premium $50、Pro $100、Max $200、Ultra $500、Enterprise $1,000 |
| 最适合 | 从论文中进行系统性提取 | 核查文献是否支持某项主张 | 快速回答有限科学问题中的“是/否”证据 | 带内联链接的广泛网络研究 | 可审计的多轮研究与引用管理 |
Jenova 的坦诚局限是结构性的:它并非像 Elicit 那样专为论文提取表格打造,也没有提供 Scite 的支持性与对立性引用图谱。它的优势在于会话记忆和实时检索;当审计需要基于同一来源链进行追问时,这一点十分重要。Elicit 的局限则恰好相反——它在论文索引内表现出色,但作为通用网络或政策文件研究工具较弱。Perplexity 和 ChatGPT 仍是最容易被过度信任的工具,因为流畅的内联引用依然可能无法通过一致性检验。
如何测试来源覆盖和可点击引用?
测试覆盖范围的方法,是提出正确答案不可能来自单一语料库的问题,然后逐一点击每个链接。覆盖通过意味着助手检索到了主张所需的来源类型——例如临床效应量需要试验资料,法律阈值需要法规或机构页面,统计数字需要数据集代码簿——而非仅仅找到一篇提及相同关键词的方便博客。
构建三个覆盖探针:
- 仅学术探针:“自 2020 年以来,随机试验对 X 显示了什么结果,哪些结果已预先注册?”
- 原始文件探针:“原始机构规则、申报文件或数据集具体写了什么——不要新闻摘要?”
- 负空间探针:“哪些可靠来源讨论过这个问题,但仍认为该效应尚未得到证实?”
随后应用点击协议。针对每条引用,记录 URL 是否可解析、落地页是否为被引用文档,以及人工能否在两分钟内找到支持性段落。Northwestern 的评估指南建议在图书馆目录或数据库中搜索标题,因为 AI 系统常将真实标题错误地关联到错误的期刊、作者或年份。死链、主页倾倒,以及“来源:互联网”式脚注都应自动判定失败。
在 Jenova 中,应将覆盖要求写成明确指令,而不是寄希望于系统自行做到:
“请至少使用四个独立来源作答。优先采用同行评审论文、政府或标准机构,以及原始数据集。针对每项主张,提供可点击 URL、文档标题、发布日期或更新日期,以及支持该主张的 15–25 字引文。如果无法找到原始来源,请说明并停止。”
在 Elicit 中,对等测试是检查提取单元格是否映射回可见的论文片段,而不是映射到模型的转述。在 Perplexity 或 ChatGPT 中,测试更严格:必须打开每一个内联链接,因为开放网络研究智能体可以检索许多页面,却仍引用其中最弱的一个。当探针同时覆盖论文、论坛、代码仓库和新闻时,将 Jenova 的 Academic Research Assistant 与 Real-Time Search 搭配使用很有帮助——但每个渠道仍需单独进行点击检查。
如何测试主张与来源的一致性以及推断标注?
测试一致性时,要问被引用段落是否能够推出该句陈述,而不是它们是否大致相关。最重要的失败形式是数字近似但不匹配,或遗漏限定条件:来源说“约 80%”,模型却写成“78%”,引用看起来仍然毫无问题。这正是自动化评估运行器旨在捕捉的错误类别。
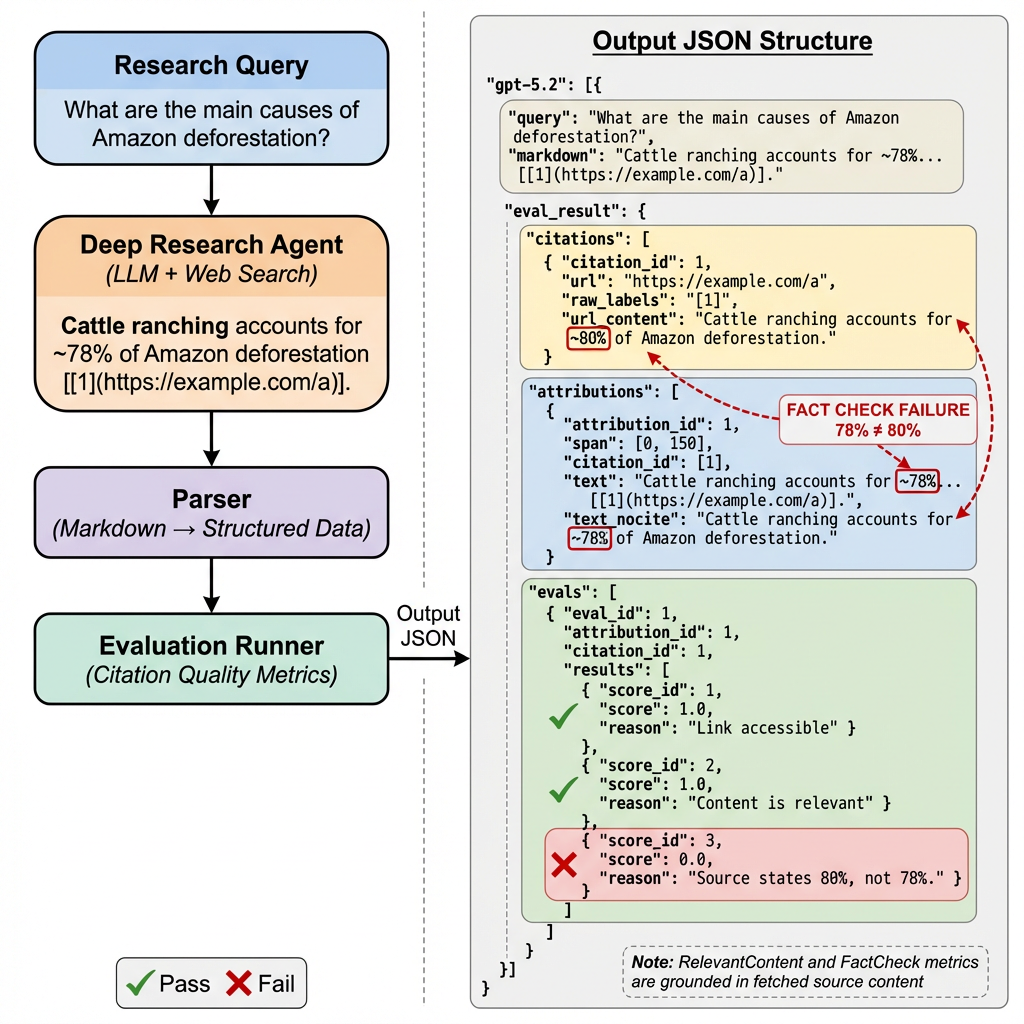
针对每项定量或因果主张,采用三层一致性测试:
- **片段匹配:**标出来源中据称支持该主张的句子。
- **可推出性:**判定为可推出、无法确定或矛盾。如果助手将主张写成事实,则“无法确定”即为失败。
- **数字与限定条件的保真度:**单位、样本、年份、置信区间,以及“可能”“在小鼠中”或“仅在一个国家”等措辞必须完整保留。
这正是为何文本可推出性比“页面主题相关”更适合作为审计指标。基于可推出性的 Open-QA 评估专门用于量化两段文本之间的推理鸿沟。NVIDIA 的引用验证方法将同一思路付诸实践:将主张与参考文本进行比较,再进行评分。
推断标注是配套检查。研究助手应将每一段标注为 sourced、inferred 或 unknown。允许综合;不允许无声综合。UNR 的主张核查指南提出了正确的判断思路:询问谁能够验证这项陈述。如果验证者是“模型的一般知识”,该句就需要推断标签。
用于此项检查的严格提示词:
“请将回答分为三个带标签的部分:(1)直接支持的主张,每项附引文和 URL;(2)推断,并列出其所依据的前提;(3)未知内容。不得将推断移入第 1 部分。如果来源中的数字为近似值,请保留这种近似表述。”
Elicit 通过强制将回答放入提取列来减少隐性推断,这确实是其优势。Scite 会标注后续论文是支持某引用还是与其相矛盾,从而捕捉另一类跳跃——将一篇论文当作既定共识。Jenova 可以在长会话中遵循三部分格式,但除非你明确要求,否则不会强制执行这些标签。相较于内置证据计量工具,这确实是一个产品缺口。
应如何验证更新日期和来源时效性?
验证时效性的方法,是要求每个来源都显示可见日期,并至少包含一个正确答案在过去一年中发生过变化的探针。无法显示页面或论文发布时间的助手,不适合回答有关价格、法规、模型发布、流行病学或市场结构的问题。
有关 AI 搜索的内容新鲜度研究发现,时效性会影响系统是否为当前问题检索某个页面。针对 AI 引用的跟踪研究同样警示,搜索引擎会持续重新评估来源,因此昨天整齐的简报可能在无声中失效。因此,你的审计应记录三个日期,而非一个:
- 来源日期——页面或论文上的发布日期或最后更新时间戳
- 证据日期——底层数据的采集年份
- 回答日期——助手检索来源的时间
常见失败是:针对“当前”患病率数字引用 2019 年综述,或者引用实时仪表盘却没有记录检索时间戳。Elicit 和 Consensus 等学术专业工具通常会显示出版年份,因为它们依赖论文元数据。除非明确要求,开放网络工具往往不会显示。Jenova 在检索文档提供日期时可以报告日期,但无法为无日期页面虚构可信时间戳——而且应当明确说明这一点。
时效性探针示例:
“截至 2026 年,目前的数字是多少?请给出来源的更新日期。如果最佳来源超过 18 个月未更新,请将答案标为历史数据,而非当前数据。”
“比较你能找到的最新来源与被引用最多的较早来源。哪些内容发生了变化,哪些没有?”
如果助手无法区分已修订的 HTML 页面与未变更的 PDF 重印版,即使 URL 可用,时效性也应判定失败。
如何通过一个提示词运行可重复的 TRACE 审计?
要运行可重复审计,需要固定探针集、固定评分表,并强制每个工具输出相同的机器可检查字段。目标是生成一份其他研究人员无需观看你的操作过程即可重新评分的记录。
针对 Jenova 的 Academic Research Assistant 使用以下流程,然后至少在一个专业工具(Elicit 或 Scite)和一个通用工具(Perplexity 或 ChatGPT)上重复:
- 在提出问题前,先说明角色和输出契约。
- 从每个类别中提出一个探针:定量、矛盾、原始文件和未知。
- 要求每条引用均包含标题、URL、日期、引文和主张标签。
- 在提出任何追问前,点击每个链接并完成 TRACE 评分。
- 只有在此之后,才要求修订失败的主张。
初始契约:
“你正在接受审计。针对每项重要主张,输出:主张文本;标签(sourced / inferred / unknown);来源标题;可点击 URL;发布日期或更新日期;不超过 25 字的支持性引文。如果一致性并不完整,请将标签降为 inferred 或 unknown。不要引用你未检索到的来源。最后给出覆盖说明,列出已使用的来源类型和缺失的来源类型。”
在 Elicit 中,对应流程是:以研究报告方式运行相同问题,然后针对 PDF 片段抽查提取单元格。在 Scite 中,将核心主张作为引用上下文查询运行,并在接受具有共识语气的句子之前,统计支持性论文与对立性论文。在 ChatGPT Deep Research 中,OpenAI 自己的研究工作流仍要求你检查来源;该产品功能提供的是检索与结构,而不是可推出性核查的替代品。
保留一份简单日志——主张、URL、日期、TRACE 分数和备注。四个探针中的十项主张已足以看出模式。如果超过两项数值主张未通过一致性检验,应停止将该工具用于任何会被他人引用的交付成果。
研究完整性从业者如何看待 AI 引用测试?
研究完整性实践已形成一项明确规则:在人工或自动化可推出性检查打开来源之前,应将 AI 引用视为未经验证的断言。现在有价值的讨论不再是模型会不会产生幻觉,而是哪些失败模式可以被工具化监控。
“这个领域持续在优化更好看的参考书目,但这不是正确的评估单位。引用是一个指针,不是证据。如果被引片段不能推出该句陈述——尤其是数字、研究人群和年份——那么引用就只是装饰。我们见过‘78% 对 80%’这类错误通过所有表面检查:真实 URL、相关标题、充满信心的语气。这些错误最终会进入论文。”
“推断标注是大多数团队忽略的最廉价控制措施。一旦允许助手将检索内容与世界知识混合,它就会把猜测洗成研究发现。强制使用三个类别——有来源、推断、未知——幻觉率就会变得可见。拒绝展示未知类别的团队,其实是在告诉你他们无法表达不确定性。”
“覆盖测试也是一种治理选择。仅论文助手看似严谨,却仍可能漏掉上个月改变规则的机构备忘录。仅网络助手看似最新,却仍可能漏掉真正测量结果的试验。模型选择在这里很重要,因为有些模型会谨慎限定,有些会压缩信息,有些会删除限制条件。审计必须追随主张,而不是品牌。”
—— Jenova 产品团队,研究智能体评估;为学术和专业用户构建检索与引用工作流 6 年
这一立场与图书馆实践一致。Northwestern记录了模型引用真实百科全书文章却仍将姓名和日期弄错的案例。UNR建议研究人员询问谁能够验证该主张。两者都是以文字形式表达的 TRACE。
AI 研究助手何时才足以用于真实研究?
当 AI 研究助手能够在你的实际问题类型上通过 TRACE 审计,并且失败主张已根据来源纠正或降级为带标签的推断时,它才足以用于真实研究。如果它生成的回答流畅、链接丰富,却在点击和可推出性检查后崩溃,那么它还不够好。
采用以下决策规则:
- 当任务是在已知论文集合中进行筛选或数据提取时,使用 Elicit 等专业提取工具,但仍应抽查单元格。
- 当问题是文献是否支持、提及或反驳某项具体主张时,使用 Scite。
- 当你需要快速判断一个有限科学问题的证据方向时,使用 Consensus。
- 使用 Perplexity 或 ChatGPT 进行广泛初步调研,但在任何数字进入论文之前都要重新验证。
- 当工作是多轮进行——在同一条可审计线程中完成文献发现、稿件语言和引用管理——使用 Jenova 的 Academic Research Assistant,并愿意在提示词中要求 TRACE 字段。
不要将其中任何工具作为无人监督的最后环节。JMIR 的引用准确性结果和 Stanford HAI 的幻觉率足以说明,人类必须始终参与其中。2026 年的最佳配置不是某个单一“可信”模型,而是一条你可以重放的来源链:可点击链接、带日期的文档、可被推出的主张,以及证据与推断之间清晰可见的边界。
参考资料
- Northwestern University Libraries — 评估 AI 生成内容
- University of Nevada, Reno Libraries — AI 与来源评估
- JMIR — 大型语言模型表现与生成引用可靠性的评估
- Stanford HAI — AI 受审:法律模型在六分之一(或更多)基准测试查询中产生幻觉
- AuthorityTech — 2026 年内容新鲜度 SEO
- Chris Long / Ahrefs 讨论 — 新鲜度与 AI 搜索可见性
- ACL Findings — 通过文本可推出性实现准确且细致的 Open-QA 评估
- NVIDIA Developer — 使用 NVIDIA NIM 自动验证引用
- Elicit — 科学研究 AI、覆盖范围与提取准确率
- Scite — 面向科学文献的 Smart Citations
- The Drive AI — Elicit、Consensus 与 Semantic Scholar 对比
- iatroX — 2026 年最佳医学研究 AI 工具
- HKUST Library — 文献综述新兴 AI 工具比较
- Omid Saffari — 2026 年最佳 AI 研究工具:Elicit 与 Consensus
- Pure AI — 需要引用:7 款 AI 研究工具测试
- SEOptimer — SEO 与 AI 搜索中的内容新鲜度
- OtterlyAI — 如何跟踪 AI 搜索引擎引用与来源
- Firecrawl — 面向 AI 智能体的网络搜索与深度研究
- OpenAI Academy — 使用 ChatGPT 进行研究:搜索与 Deep Research