家庭争吵后,如何用 AI 记录情绪并进行 CBT 思维核查?
2026-08-20
与父母、兄弟姐妹或伴侣的一场争吵,往往会留下一种特殊的余波:思绪飞转、身体无法平静,以及一个关于刚才发生之事、却感觉像事实一样确定的故事。结构化自我反思工具——情绪日志和认知行为疗法(CBT)思维记录——正是为这种时刻而设计的。如今,AI 可以为两者提供辅助框架,但仅限于一个狭窄的、非诊断性的范围;大多数人对此存在误解。
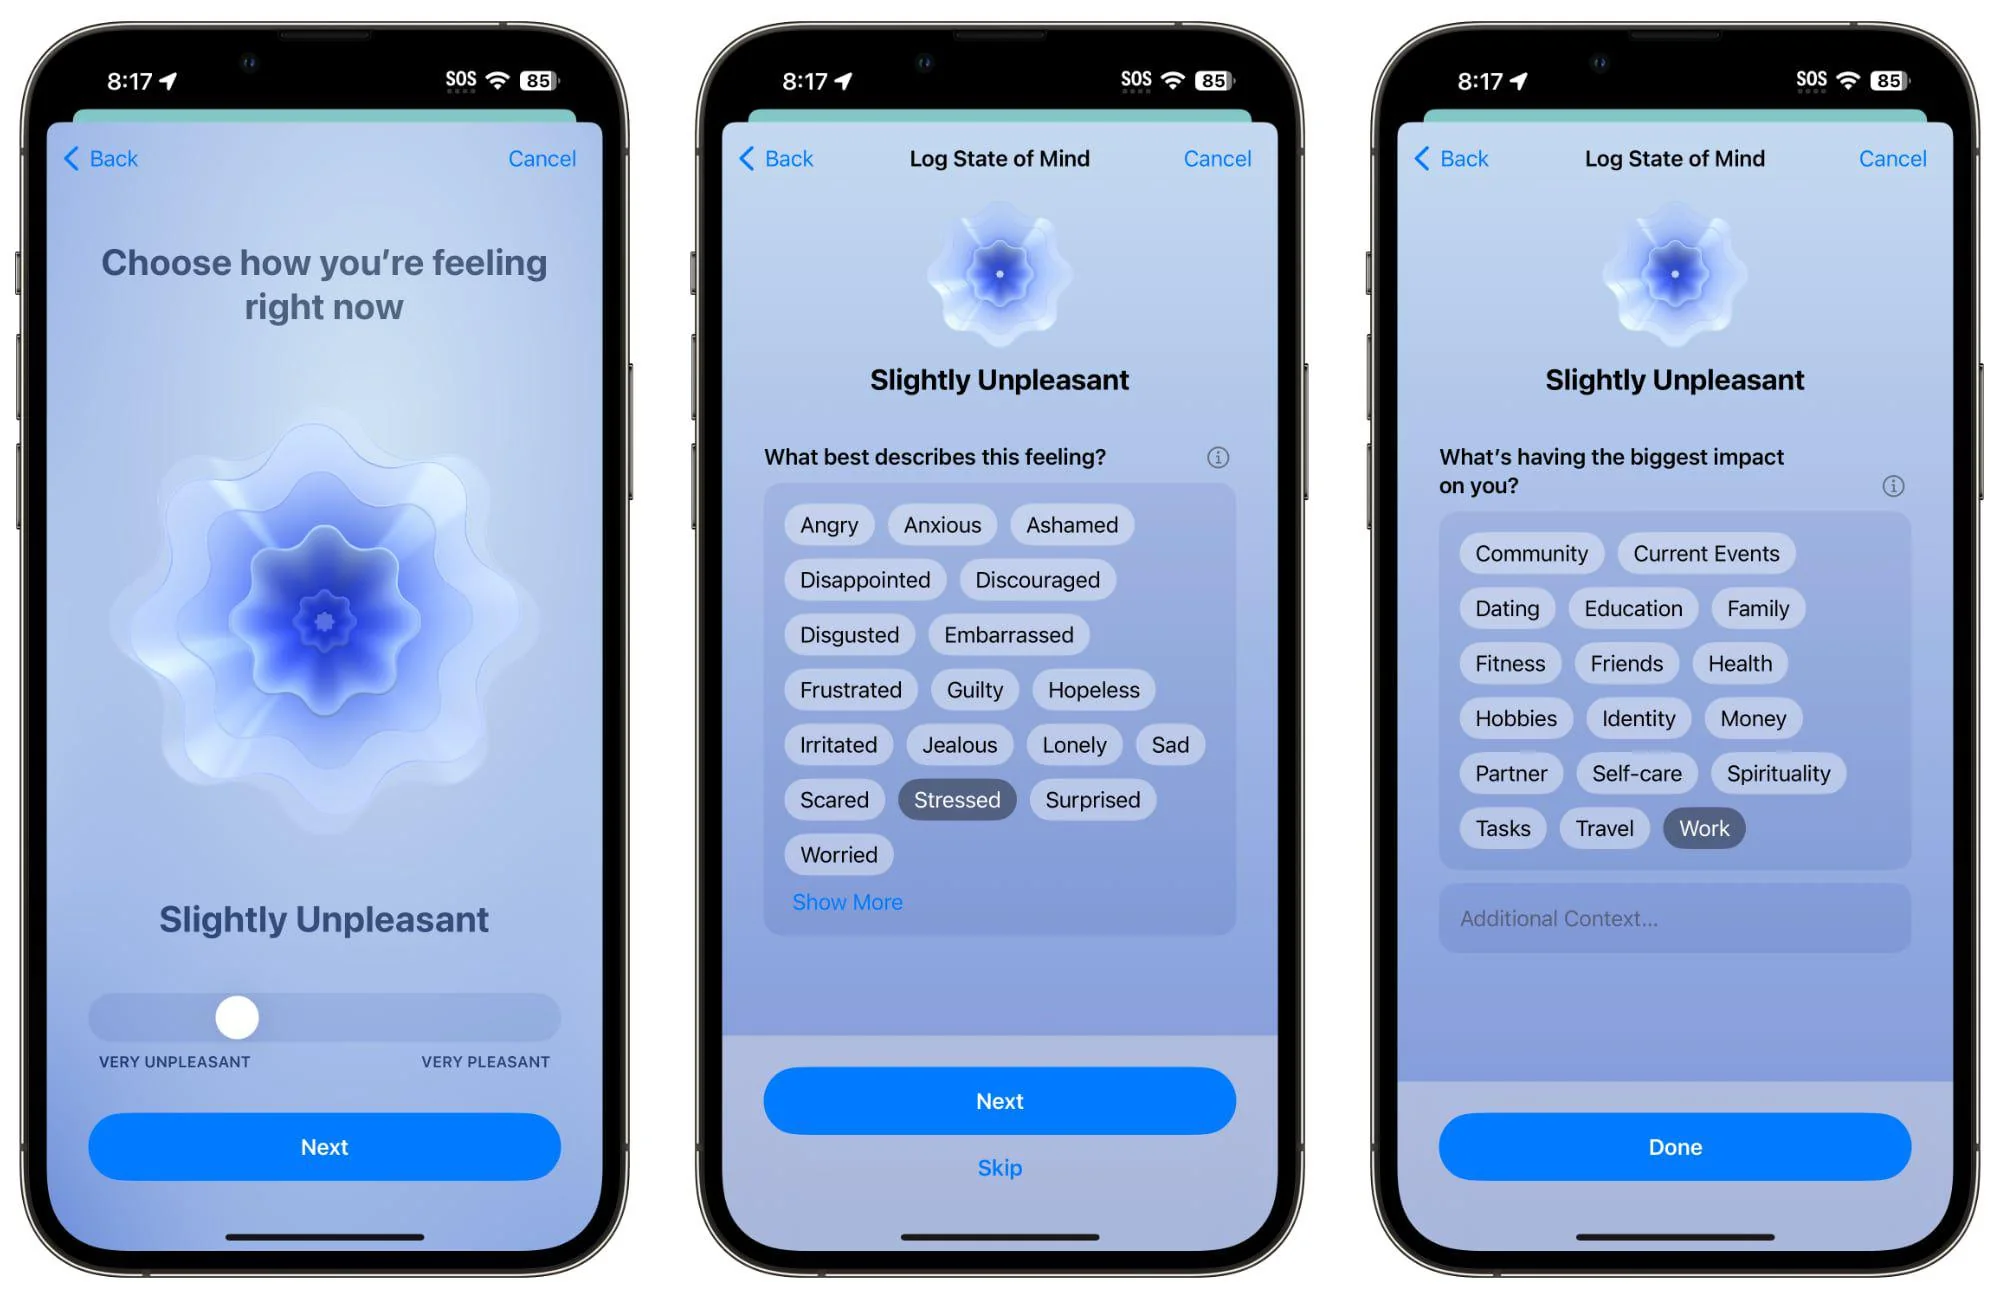
非诊断性 AI 情绪日志究竟能做什么,是笔记应用做不到的?
非诊断性 AI 情绪日志会将争吵后模糊的状态转化为三项结构化数据——情绪效价、具体情绪标签和归因的生活领域——再通过对话式追问,将实际发生的事与你据此得出的结论区分开来。普通笔记应用能记录你的倾诉;AI 辅助日志则能捕捉其底层的结构,这正是让记录日后可用于 CBT 思维核查的关键。
这种区别很重要,因为两种工具承担的是不同工作:
✅ 情绪日志 = 测量。 它记录强度、准确命名感受,并标记触发领域,不作解释。 ✅ 思维记录 = 分析。 它找出推动情绪的自动想法,并用证据检验这一想法。 ✅ 非诊断性意味着不贴标签。 工具绝不会说“这听起来像焦虑障碍”——而会说“你将痛苦程度评为 80%,并将其命名为挫败。” ✅ AI 真正的贡献是维持提问纪律。 它会问出你在晚上 11 点独自写日记时很可能跳过的追问。 ✅ AI 真正的局限在于判断能力。 斯坦福 HAI 关于治疗聊天机器人的研究发现,当大型语言模型被置于治疗师角色时,会出现严重的安全失误;研究者明确将更安全的使用场景限定为“支持写日记、反思或辅导”。
这条边界——提供反思框架,而非临床判断——是评估下文所有工具的基本准则。
为什么家庭争吵尤其难以在没有结构的情况下处理?
家庭冲突特别难以反思,因为冲突本身会削弱你进行有效反思所需的认知能力。耶鲁大学医学院的研究发现,家庭冲突和负性生活事件主要通过扰乱情绪调节,与更差的心理健康状况和行为问题相关——这种扰乱并非副作用,而是作用机制本身。
这会造成一个实际问题。在争吵后的一个小时里,往往有三件事同时发生:
- 情绪淹没让你难以区分“我感到不被尊重”与“他们不尊重我”。
- 历史压缩会把一次事件坍缩成终生模式:“她总是这样。”
- 反复演练循环会不断重播争吵,却不会产生任何新信息。
一项关于家庭冲突与青少年功能表现的 PMC 研究同样发现,家庭冲突与情绪调节能力呈负相关。结构化记录能对抗这三种失效模式,因为它强制你遵循顺序:先测量,后解释,再评估。这一顺序正是设计良好的 AI 工作流程能够落实、空白页面却无法保证的东西。
选择用于情绪记录和思维记录的 AI 工具时,应关注什么?
合适的工具,应能让你留在既定结构中,而不会假装自己是临床医生。在为本文评估的工具中,有六个维度将真正有用的反思框架与披着健康外衣的聊天区分开来。
本文采用的六维评估框架:
| # | 维度 | “良好”的表现 |
|---|---|---|
| 1 | 结构保真度 | 遵循真正的 CBT 思维记录顺序——情境 → 情绪 → 自动想法 → 双向证据 → 平衡想法 → 重新评分。不会跳过反证据栏。 |
| 2 | 非诊断性纪律 | 从不赋予疾病、严重程度标签或临床解读。复述你的用词,而非将其归类。 |
| 3 | 跨会话记忆 | 记得那位家庭成员、反复出现的触发点,以及上周的平衡想法——让第 6 条记录建立在第 1 条之上。 |
| 4 | 关系情境处理 | 能理解具体关系动态,例如婆婆或疏远的兄弟,而不是把每一场冲突都泛化处理。 |
| 5 | 诚实升级处理 | 清楚说明自身边界,并在内容超出自助范围时建议寻求人类专业支持。 |
| 6 | 输出可携性 | 能生成可导出、打印或带给治疗师的内容。 |
第 3 个维度尤其值得强调,因为这是大多数工具悄然失效的地方。思维记录的价值会随着记录次数累积——当你第四次捕捉到自己对同一位家庭成员抱持同一个自动想法时,你做的是模式工作,而不只是事件工作。对第一条记录毫无记忆的工具无法支持这一过程。
第 5 个维度不可妥协。美国心理学会关于聊天机器人与心理健康的 2026 年报告发现,心理学家对聊天机器人提供心理健康建议的态度“对安全性和隐私性抱有显著谨慎”。一个夸大自身角色的工具,已经不符合这一标准。
主要 AI 选项在争吵后反思中的表现如何?
没有任何单一工具占据绝对优势——这一类别清晰分为经临床验证但范围较窄的工具、面向消费者的 AI 日记,以及通用智能体平台;它们各自在不同维度上表现突出。
| 维度 | Wysa | Woebot Health | Mindsera | Jenova(Relationship Advisor + Personality Analyzer) |
|---|---|---|---|---|
| CBT 结构 | 由方案驱动的引导式 CBT 练习路径 | 基于 CBT 的对话式方案 | 提供带 AI 反思的日记提示,但不是严格的思维记录栏位 | 可遵循你提供的任何结构,包括完整七栏记录;需要你自行设置 |
| 临床验证 | 公司列举 45+ 篇同行评审文献;针对 1,213 名用户的 JMIR 研究发现,获得 AI 支持后,用户完成辅导项目的可能性接近 3 倍 | 由临床研究心理学家 Alison Darcy 博士于 2017 年创立;入选 Newsweek 首届全球最佳数字健康公司榜单 | 没有可与 Wysa 相比的已发表临床试验项目 | 无——这是通用平台,不是临床产品 |
| 跨会话记忆 | 在应用使用模式内保持会话连续性 | 由应用管理的连续性 | 日记历史记录与 AI 模式识别 | 持久的跨会话记忆;智能体可回忆此前记录和被提及的家庭成员 |
| 关系具体性 | 通用的冲突框架 | 通用的冲突框架 | 由用户写入,因此具体程度取决于你的写法 | 高——你可描述确切的关系,它会保留该情境 |
| 明示边界 | 明确免责声明:不适用于危机、虐待或严重状况;无法提供医疗或临床建议;限 18 岁以上 | 定位为健康工具,而非治疗 | 定位为健康日记工具 | 通用 AI 助手;不是心理健康产品,也不应被当作此类产品 |
| 匿名性 | 设计上明确匿名 | 基于账户 | 基于账户 | 基于账户;数据不用于训练公开模型 |
| 定价 | 免费层加企业/健康系统部署 | 主要通过雇主、付款方和健康系统分发 | 免费层;付费方案标价为 $10.75–$14.99/月 | 免费层包含全部核心功能;Plus 为 $20/月,使用量为 30× |
| 最适合 | 追求匿名、有临床依据、按方案引导的 CBT 用户 | 由雇主或付款方提供的结构化支持 | 希望养成每日习惯,并获得轻度 AI 反思的用户 | 希望掌控结构、进行深入且关系具体的反思的用户 |
对每种工具的诚实解读:
- Wysa 是将临床验证和匿名性放在首位时的最佳选择。它的限制在于结构较为僵化——你需要遵循它的路径,而不是自己的工作表。它也明确排除了危机、虐待和严重状况的使用。
- Woebot Health 具备真实的临床背景,但主要通过雇主、付款方和健康系统分发,而不是作为可直接下载的普通消费者产品,这限制了个人用户的可及性。
- Mindsera 是这几项中最适合培养愉快日常习惯的工具,但其 AI 反思结构较为宽松。如果你需要严格的七栏思维记录纪律,仍需自行提供这一结构。
- Jenova 的智能体提供最强的灵活性和最深入的关系情境处理,也是这里唯一会逐字遵循你粘贴工作表的选项。但诚实地说,其代价也很明显:**这不是临床产品,没有经过同行评审的心理健康用途验证,也不具备 Wysa 和 Woebot 所建立的安全防护框架。**它是由你主导的反思工具,而不是受支持的照护路径。
在实际操作中,情绪日志步骤是什么样的?
情绪日志用时不到两分钟,且应始终放在任何思维分析之前——你此时是在测量状态,而不是解释它。
上方界面展示的三屏模式很好地对应了这一顺序:**情绪效价 → 具体情绪 → 归因领域。**无论使用哪一种工具,都应复现这一结构。
第 1 步——评估情绪效价与强度。 在命名任何感受之前,先将其放在一个连续谱上,并给出数值。“略微不愉快,65/100”比“很糟”更有用。
第 2 步——选择准确标签,而不是笼统词汇。 界面提供挫败、失望、绝望、羞愧、烦躁和压力大等描述词是有原因的——“难受”会掩盖其中究竟是哪一种感受在推动反复思考。选两到三个。
第 3 步——标记领域。 此处是家庭。经过十条记录后,领域标签会揭示该模式是关系性的、情境性的,还是蔓延至你的整周生活。
使用 Relationship Advisor 时,设置提示非常直接:
“我只想进行非诊断性情绪日志——暂时不要分析、建议或解读。请依次问我:从非常不愉快到非常愉快的情绪效价、0–100 的强度评分、两到三个准确的情绪词,以及这属于哪个生活领域。然后停止,只用清晰摘要复述我的回答。不要告诉我这意味着什么。”
要求它停止很重要。如果没有限制,大多数 AI 工具会立刻跳到重新框定和建议,这会让解释混入测量过程——而两阶段结构正是为了避免这种错误而存在。
使用 Wysa 时,对应做法是进入情绪签到流程,让其引导路径处理顺序。你会失去自定义空间,但获得方案纪律。
如何用 AI 进行 CBT 思维核查,又不让它替你作解释?
将七栏思维记录结构直接粘贴给 AI,并要求它仅作为逐栏访谈者——一次只问一个问题,且绝不把你没说过的内容写进任何栏位。
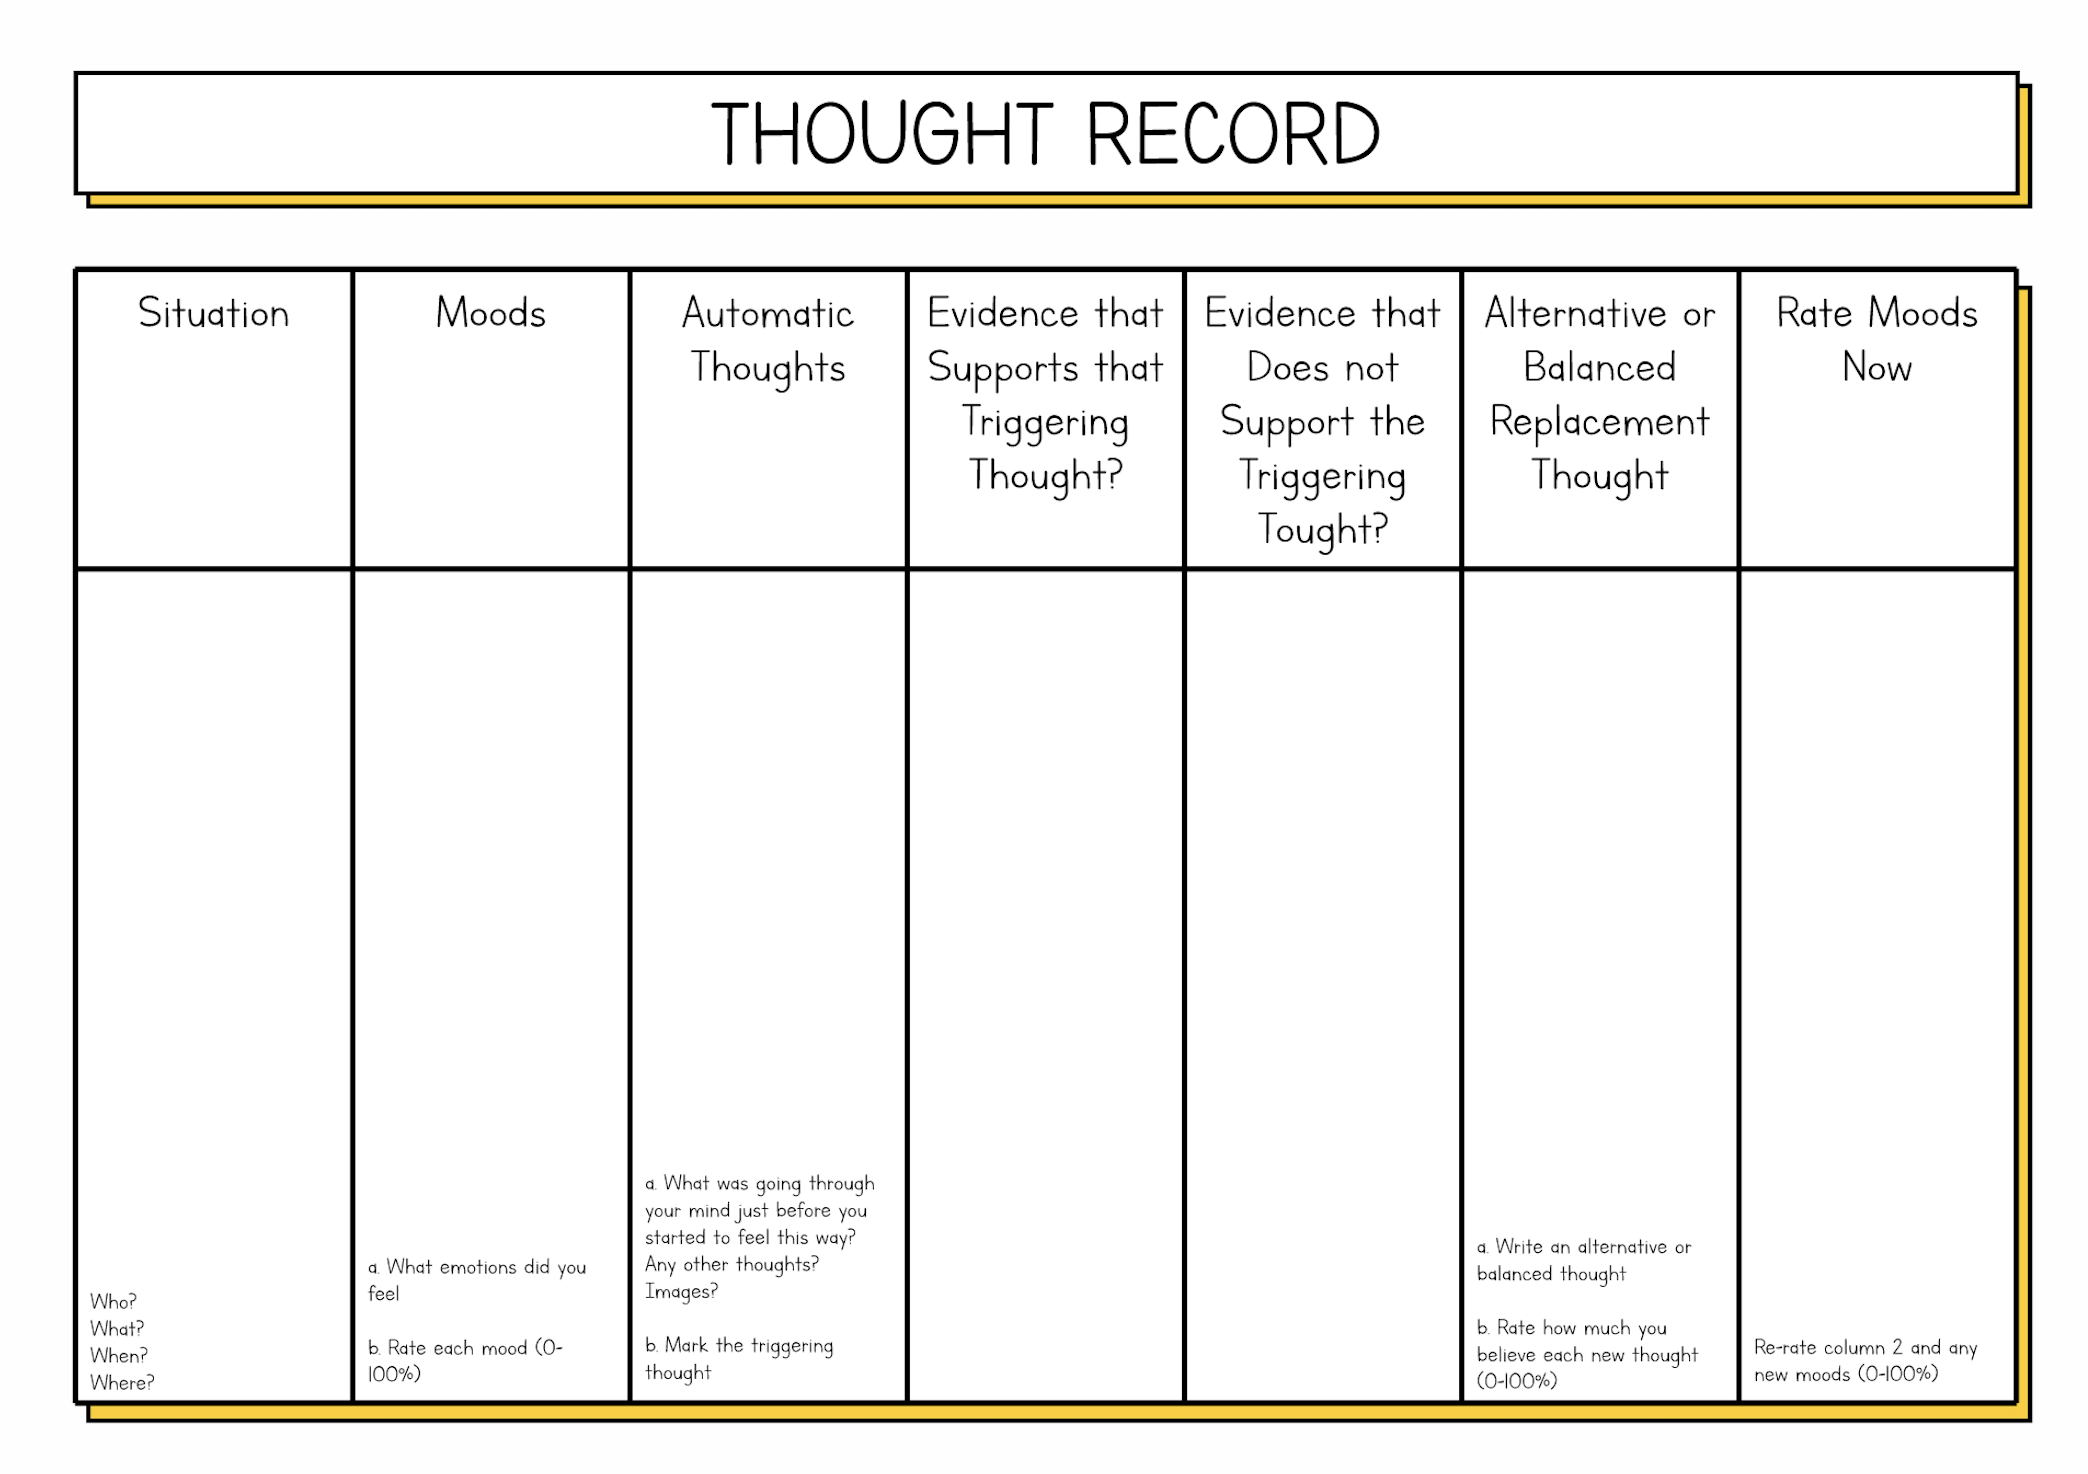
上方工作表采用的是标准结构。NHS Every Mind Matters 思维记录使用了等效的七项提示顺序:情境、最初感受、无益想法、支持它们的证据、反对它们的证据、替代性的现实想法,以及你现在的感受。
在家庭争吵后逐栏完成:
- 情境——谁、什么、何时、何地。只写事实。“晚上 8:40,在厨房,我和弟弟就谁负责爸爸的预约事宜发生争吵。”而不是“我弟弟又把所有事都推给我。”
- 情绪——直接导入你的情绪日志。例如:挫败 75%、内疚 50%、孤独 40%。
- 自动想法——写下脑中闪过的一切,然后标记最强烈想法——即情绪负荷最大的一条。通常会是类似*“这个家里真正愿意出面的人只有我。”*这样的想法。
- 支持它的证据——真实的支持性事实。这不是修辞练习。“上个月我开车去了三次预约,他一次也没参加。”
- 不支持它的证据——Psychology Tools 指出,思维记录常被简化成仅检查支持和反对证据,而这一栏是大多数人最容易匆忙略过的部分。它是价值最高的一栏,也是 AI 最能帮助你的地方,因为它会继续追问。“他在三月处理了保险文书。他提出要负责二月的事,但我当时拒绝了。”
- 替代性或平衡想法——不是积极肯定语。它应当同时容纳两栏证据。“我承担了更多预约事务,这是一个值得提出的真实失衡。但说只有我一个人出面并不准确——我们分工不均,而不是只有我在做。”
- 重新评估情绪——使用同一量表、同样的情绪词。变化幅度就是结果指标。
让 AI 保持边界的提示:
“我要完成一份关于我和弟弟争吵的 CBT 思维记录。请严格使用以下结构,一次访谈我一栏:情境、带有 0–100 评分的情绪、自动想法并标记最强烈想法、支持证据、不支持证据、平衡替代想法、重新评分后的情绪。规则:一次只问一个问题,等待我的回答,不要替我填写任何栏位,不要作出任何诊断,不要就我弟弟给出建议,即使我试图跳过去,也不要省略反证据栏。完成后,输出填好的表格。”
如果要针对多次争吵进行模式工作,Personality Analyzer可以审阅一组已完成的记录,寻找反复出现的自动想法——但前提是你已经诚实地完成这些记录。只提供一条记录,只会得到推测,而不是模式识别。
使用 AI 的真实边界是什么?
AI 适合用于对普通人际冲突进行结构化自我反思,却不适合处理任何接近危机、虐待或临床症状的情况——支持这一边界的证据,比大多数产品营销所暗示的更有力。
美国国家医学院在 2026 年报告称,AI 聊天机器人曾出现包括分享致命手段指引在内的有害行为。布朗大学研究人员在 2025 年发现,AI 聊天机器人经常违反心理健康伦理的核心标准。哈佛商学院关于陪伴型 AI 的研究发现,这类系统往往无法识别并恰当回应痛苦信号。
AI 辅助记录适用的情境:
- 与不会对你构成危险的家庭成员发生普通冲突
- 希望用结构中断争吵后的反刍思维
- 准备材料,以带给你已经在咨询的治疗师
- 培养准确命名情绪的习惯
不适用的情境:
- 涉及虐待、强制控制或对自身安全感到恐惧的任何情况
- 自残或自杀念头
- 持续存在、不断恶化或妨碍日常功能的症状
- 任何对评估、诊断或治疗的替代做法
Wysa 自己的免责声明明确指出,它并非为协助处理虐待、严重心理健康状况或医疗紧急事件而设计。通用 AI 平台则完全不具备这种专门构建的安全架构。请认真对待这两种定位之间的差距。
临床研究人员如何看待 AI 在认知重构中的角色?
研究人员的共识并不是“AI 治疗很糟糕”,而是 AI 有用的角色应当狭窄、支持性强、以结构为中心,而非解释性角色。
“细微差别才是问题所在——这并不只是‘将 LLMs 用于治疗是不好的’,而是要求我们认真思考 LLMs 在治疗中的角色。LLMs 在治疗中可能拥有非常强大的未来,但我们必须批判性地思考,这个角色究竟应当是什么。”
——尼克·哈伯,斯坦福大学教育研究生院助理教授、斯坦福以人为本 AI 研究所附属研究员;引自斯坦福 HAI 对 2025 年 ACM FAccT 论文的报道
斯坦福团队对更安全应用的界定很有启发性:他们的论文提出了若干角色,包括为治疗师处理事务性工作、在临床培训中充当标准化患者,以及在“安全关键性较低的场景”中支持患者,例如写日记、反思和辅导。对一场厨房争吵进行结构化情绪记录,以及自行完成思维记录,正属于最后一类。
该论文的主要作者、斯坦福大学计算机科学 PhD 博士候选人杰里德·摩尔,也就这些限制的持久性提出了相关观点:“更大的模型和更新的模型,表现出的污名化程度与旧模型一样多。AI 的默认回应往往是,这些问题会随着更多数据而消失;但我们想说的是,照常营业远远不够。”
对于任何在家庭争吵后使用 AI 的人,其实际含义是:用它来守住栏位、记录评分并提出下一个问题。不要用它来告诉你情绪意味着什么,也不要让它判断你兄弟的行为说明了他是怎样的人。
如何建立一套可重复的争吵后流程?
真正能在现实生活中坚持下来的流程有四步,总共约需十五分钟,并通过有意识的冷却间隔将情绪阶段与分析阶段分开。
- 刚结束时(2 分钟): 只做情绪日志。记录情绪效价、强度、两到三个准确标签和领域标签。不要分析。PositivePsychology.com 的思维记录指南体现了标准 CBT 顺序:先识别情绪,再挑战思维。
- 等待 60–90 分钟。 在情绪强度达到峰值时进行认知重构,往往会导致自我攻击或防御性辩解,两者都不是平衡想法。
- 之后(10 分钟): 让 AI 作为逐栏访谈者,完成七栏思维记录。将已记录的情绪导入第 2 栏,而不是重新猜测。
- 每周(5 分钟): 回顾本周记录,寻找重复出现的最强烈想法。这里是累积价值所在——一篇关于认知重构与心理治疗结果的 PMC 综述将证据检验问题置于该技术的核心,而重复练习会让它变得自动化。
两点实用提醒。 导出或截图已完成的记录——一叠六份思维记录,确实是首次治疗会谈中很有价值的材料。还有,如果每一条记录里都出现同一位家庭成员,那么你所记录的模式可能是需要通过对话解决的关系问题,而不是需要通过重新框定来纠正的认知扭曲。思维记录的设计目的,是检验一个想法是否准确,而不是把你从一个准确的想法中劝出来。
参考资料
- NHS Every Mind Matters——思维记录 CBT 练习
- 斯坦福 HAI——探索 AI 在心理健康照护中的风险
- 耶鲁大学医学院——家庭冲突与压力如何扰乱青少年情绪调节
- PubMed Central——家庭冲突与凝聚力在青少年社会功能中的作用
- 美国心理学会——患者正在将 AI 带入治疗:2026 年报告
- Wysa——产品概述、临床出版物和使用免责声明
- Woebot Health——公司使命与临床背景
- Mindsera——免费方案与付费方案价格对比
- Psychology Tools——当 CBT 思维记录无效时可以尝试什么
- 美国国家医学院——心理健康 AI 聊天机器人:哪些有效、哪些有害,以及下一步是什么
- 布朗大学——新研究:AI 聊天机器人系统性违反心理健康伦理标准
- 哈佛商学院——聊天机器人与心理健康:关于陪伴型 AI 安全性的洞见
- PositivePsychology.com——CBT 中的思维记录:7 个示例和模板
- PubMed Central——认知重构与心理治疗结果