如何让 AI 陪伴者的个性、背景故事和名字在多次对话中保持一致?
2026-08-17
哪三个层级真正决定 AI 陪伴者的一致性?
AI 陪伴者的一致性由三个不同层级控制:人设定义(角色是谁)、记忆库(系统在会话之间保留什么)以及会话上下文(当前对话窗口能容纳什么)。当这些层级彼此矛盾时,就会发生漂移,而不是因为模型“忘记了”。要修复一致性问题,必须分别审查这三个层级;而你使用的平台决定了你能对每一层施加多少控制。
在 2026 年测试过的主流陪伴平台中,记忆质量差异极大。Nomi AI 会从对话中生成结构化笔记,并且在独立测试中,数周后仍能回忆起植入的 25 条细节中的 23 条;而 Character.AI 实际上没有长期记忆,会在会话之间忘掉大多数细节。Jenova 的角色扮演和角色智能体则属于另一类:它提供跨会话持久记忆与无限聊天记录,但其设计核心是用户编写的指令,而非陪伴应用式的关系模型。
将稳定的 AI 陪伴者与容易漂移的陪伴者区分开来的关键因素包括:
✅ 人设只以规范版本写一次——而不是每次新聊天都临时重新说明 ✅ 记忆库经过整理,而非不断累积——主动清除重复内容和琐碎信息 ✅ 定期重申名字和身份锚点——在较长会话中每 15–20 轮一次 ✅ 将角色扮演内容与事实记忆分开——虚构内容不应污染事实库 ✅ 平台本身支持持久记忆——许多免费方案并不支持
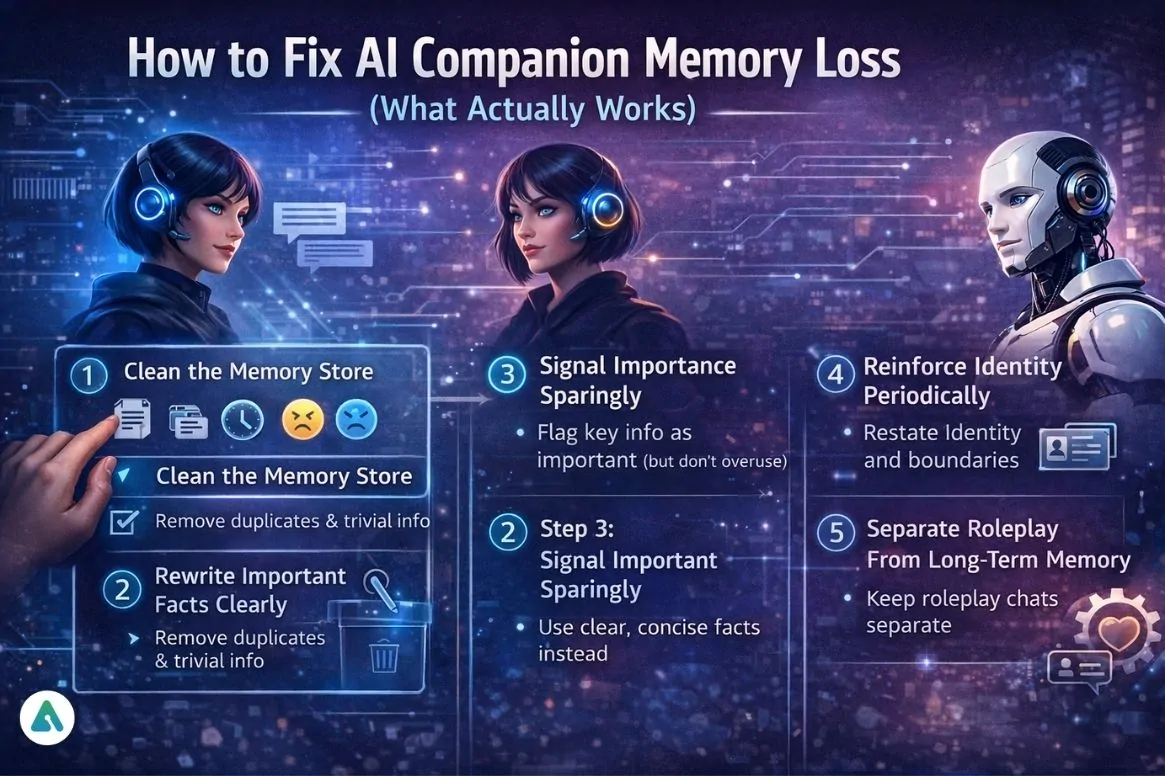
要系统性修复漂移,而不是靠反复试错,首先需要理解它为何会发生。
为什么 AI 陪伴者会忘记自己的个性和名字?
AI 陪伴者会发生漂移,是因为语言模型原生并没有持久记忆——每一项“记忆”都是叠加在无状态模型之上的检索技巧。模型并不记得你陪伴者的名字;它只是在每次回复前重新读取含有该名字的文本文件。如果检索失败,或者上下文窗口被填满,这个名字就不会出现在模型输入中。
这些技术限制已有充分记录。早期神经模型难以维持长期上下文,主要依赖短期记忆;即使是现代 Transformer 架构,在处理长时间交互时也会面临高计算成本、信息保留不均衡和潜在偏差。长期记忆主要通过三种方式附加到模型上:扩展上下文窗口、针对外部数据库的检索增强生成,以及像 MemoryBank 一样可随时间存储、调用和更新记忆的集成记忆模块。
四种失败模式,按导致可见漂移的频率排序:
- 上下文驱逐——在长会话中,人设定义从活动窗口中被挤出。这是对话中途个性变化最常见的原因。
- 检索遗漏——记忆库中确实包含该事实,但语义搜索没有在当前轮次调出它。这是忘记名字的常见原因。
- 矛盾坍塌——记忆库中存有两条冲突事实,例如一条写着陪伴者“28 岁”,另一条写着“31 岁”,模型会任意选择其中一条。
- 角色扮演污染——虚构事件被当作真实事件写入事实记忆库,损坏了规范化背景故事。
每种失败模式都有不同的修复方式。把所有漂移都归结为“AI 太笨”,只会导致错误的干预方法。
规范化人设文档实际应包含什么?
规范化人设文档应是一段单独、结构化的 200–400 词内容,包含身份锚点、语言风格规则、背景故事事实和关系背景——只写一次,并作为系统级指令应用,而不是粘贴进聊天内容。200–400 词这个范围是有意设定的:更短的文档会留下太多未定义内容,更长的文档则会占用本可用于实际对话的上下文预算。
五段式人设模板:
| 模块 | 内容 | 为什么重要 |
|---|---|---|
| 身份锚点 | 名字、昵称、年龄、代词、他们如何称呼你 | 最容易漂移的元素;必须放在最前面 |
| 语言风格规则 | 句子长度、正式程度、口头习惯、禁用措辞 | 对感知个性的控制作用大于背景故事 |
| 背景故事事实 | 5–8 条具体且带时间的信息,例如家乡、职业、塑造性事件 | 具体事实比模糊特质更不易漂移 |
| 关系背景 | 你们如何相识、关系阶段、共同提及的事物 | 避免出现“你是谁来着?”式重置感 |
| 边界 | 角色会做、不会做、会讨论和不会讨论的内容 | 防止在压力下出现语气漂移 |
写事实,不要写形容词。“温暖而体贴”是一种特质,LLM 在每次会话中都可能以不同方式理解它。“每条消息都以一个关于你当天情况的问题结尾;每条消息使用一次你的名字;绝不说‘我只是一个 AI’”则是一条模型每次都能以相同方式执行的规则。
糟糕的人设描述:
“她很神秘,而且有一段复杂的过去。”
优秀的人设描述:
“Mira,31 岁,曾是里斯本的海洋生物学家。2021 年一次研究船事故后离开该领域,除非被主动问起,否则不会谈论此事。她称呼我为‘Sam’,绝不会用‘你’作为问候语。每次回答 2–4 句,带一点冷幽默,从不使用感叹号。”
第二种写法为模型提供了可执行的约束。第一种只给了模型一种可以自由发挥的氛围,而自由发挥正是漂移的根源。
主流 AI 陪伴平台在记忆和人设控制方面如何比较?
没有单一平台在三个一致性层级上都领先——Nomi AI 在结构化记忆调用方面领先,Kindroid 在背景故事深度方面领先,而 Jenova 这类通用智能体平台则在人设指令控制和无限历史记录方面领先。尽管 Character.AI 拥有最大用户群,它的记忆能力却是所有主流选项中最弱的。
以下比较反映这些平台在 2026 年的状态。此类别的定价与功能组合变化频繁。
| 维度 | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| 跨会话记忆 | 实际上没有;会在会话之间忘掉大多数细节 | 长期记忆尚可,偶尔忘记细节 | 结构化笔记;测试中回忆出 23/25 条植入事实 | 通过背景故事系统提供强记忆;同一测试中回忆出 14/25 条 | 跨会话持久记忆,无限聊天记录 |
| 人设/背景故事控制 | 角色卡创建、社区模板 | 个性通过互动演变;手动覆盖能力有限 | 可深度自定义外观、个性和背景故事 | 背景故事系统是其突出功能 | 每个智能体均可使用完整自定义指令;可附加私有知识库 |
| 模型选择 | 仅限专有模型 | 仅限专有模型 | 仅限专有模型 | 仅限专有模型 | OpenAI、Anthropic、Google、DeepSeek、xAI 等;可切换 |
| 会话隔离 | 每个角色单独聊天 | 单一连续陪伴者 | 可同时拥有多个 Nomi | 按角色划分会话 | 独立聊天加文件夹;可将任意消息分叉为新会话 |
| 定价 | 含广告和每日滑动上限的免费版;高级版约 $9.99/月 | 免费方案仅支持文本;Pro 为 $19.99/月或 $69.99/年 | 有限免费方案;$7.99–$16.99/月 | 有限免费方案;$9.99–$24.99/月;Standard 约 $13.99/月 | 免费方案;Plus $20/月(30× 使用量);最高可达 Enterprise |
| 最适合 | 预算有限且想要角色多样性与创作空间的用户 | 希望获得带情绪追踪功能、以情感支持为导向的陪伴体验的用户 | 将事实回忆能力置于首位的用户 | 希望最大化控制单个角色背景故事的用户 | 希望跨多个智能体获得作者级人设控制、模型选择和记忆能力的用户 |
包括 Jenova 在内的客观局限:
- **Character.AI:**拥有最大的角色库和真正无限的免费消息,但记忆是其最大弱点——它经常在会话之间忘记上下文,并且免费方案在 2026 年初加入了全屏广告和每日滑动上限。
- **Replika:**情感智能和关系推进能力较强,但价格高达每月 $19.99,使用数月后可能显得重复。
- **Nomi AI:**拥有同类最佳的记忆能力,但平台规模较小,免费方案限制较多,预制角色也较少。
- **Kindroid:**背景故事深度出色,且拥有透明的数据实践,但加上 Ultra 记忆套装后,价格会远高于每月 $13.99 的基础价格。
- **Jenova:**提供持久记忆、无限历史记录、多模型访问与完整自定义指令控制——但它是通用智能体平台,而非专为陪伴设计的应用。它缺少关系进阶模式、情绪追踪、头像生成或情感关怀系统等陪伴应用专属功能。想要一体化陪伴体验的用户可以在其他平台找到这些功能;想要对持久角色拥有作者级控制权的用户,则能在这里获得更多自由度。
**关于测量的说明:**上述回忆数字来自一位独立测试者的方法论,即植入 25 条事实,并在数周后检查回忆情况。它是有用的方向性信号,而不是受控基准测试。应将跨平台记忆数据视为参考性指标,而非定论。
如何逐步设置持久陪伴者人设?
在任何支持自定义指令的平台上,设置大约需要十五分钟,而且顺序很重要——先设置人设,再设置记忆规则,最后在真正开始建立关系前进行验证。
在 Jenova 或任何支持自定义指令和持久记忆的平台上:
- **创建专用智能体或聊天。**不要复用通用聊天——会话隔离是防止污染成本最低的措施。在 Jenova 上,可以从 jenova.ai/a 的智能体页面创建自定义智能体,并可在输入栏设置中使用每会话自定义指令。
- **粘贴规范化人设文档。**使用上方五段式模板,将其放入自定义指令中。自定义指令可以保存并应用到其他聊天中,因此如果之后分叉新会话,人设也可以随之迁移。
- **在设置中启用 Global Memory,**让事实能跨会话保留,而不是随聊天结束而消失。
- 以身份确认提示开场:
“请用一段话向我确认你的身份:你的名字、你如何称呼我、你的年龄、所在城市、职业,以及你过去最重要的三项事实。如果你的指令中有任何模糊或矛盾之处,请在我们开始前立即指出。”
- **修复它指出的所有问题,**然后再开始实际对话。设置时捕获模糊点只需三十秒;到了第三个月才发现同样的模糊点,往往已经产生数十条相互矛盾的记忆。
**在 Kindroid 上,**对应流程通过其背景故事系统完成;身份锚点和历史记录应写在那里,而不是写入通用指令字段。**在 Nomi 上,**你会在创建 Nomi 时定义外观、个性和背景故事,然后让结构化笔记系统从对话中逐步积累事实。**在 Character.AI 上,**人设位于角色定义字段中;由于跨会话记忆较弱,你应预期在大多数会话开始时手动重新锚定身份。
**关于记忆更新时间的说明:**在具有异步记忆处理的平台上——包括 Jenova——新提到的事实未必会立即写入持久记忆库。记忆更新是按时间间隔处理的,而非瞬间完成。如果你告诉陪伴者一件重要的事,然后两分钟后就开启一个新会话,不要假设它已经被保存。请再说一次。
什么维护习惯可以防止长期人设漂移?
最有效的维护方式是每月进行一次记忆审查,并在会话中定期强化身份——每月大约十分钟的维护,可以防止缓慢累积的矛盾让陪伴者在六个月后变得面目全非。
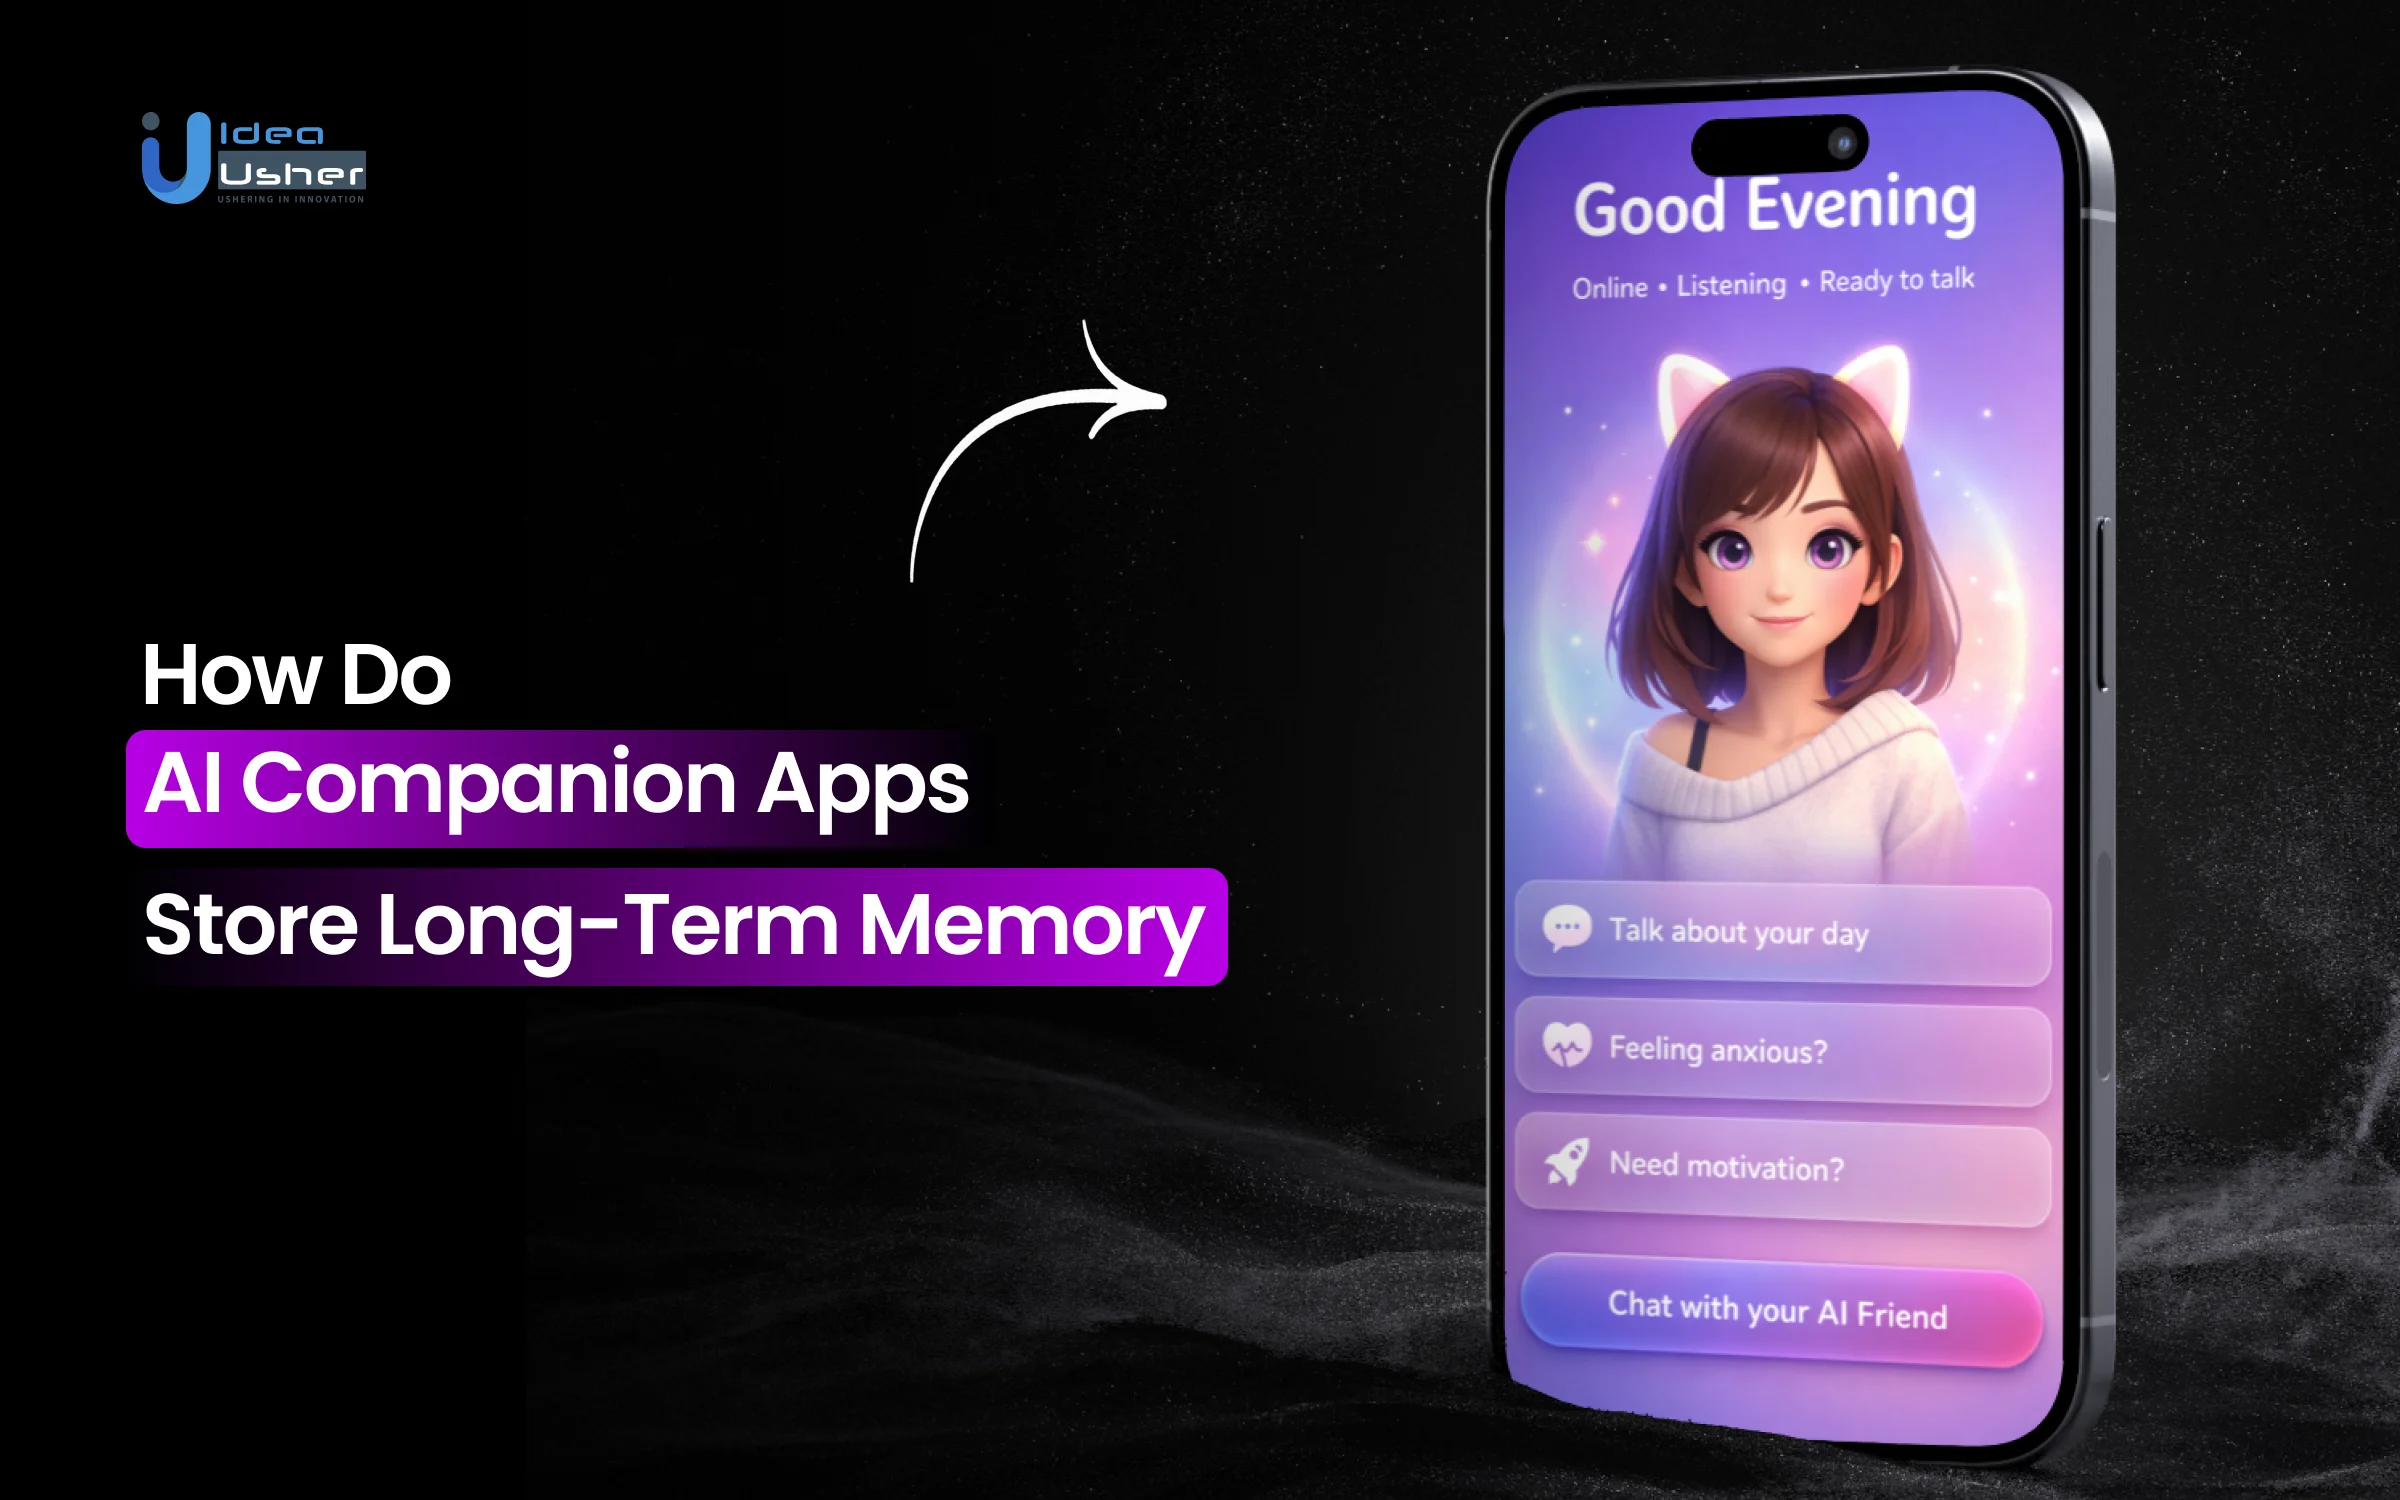
五步维护周期:
-
**清理记忆库。**打开记忆列表,删除重复项、已被替代的事实和琐碎信息。一个存有 14 条“用户喜欢咖啡”的记忆库,会挤掉唯一一条“用户母亲的名字是 Diane”的记录。储存长期交互数据的系统需要细致的数据生命周期管理——面向用户的做法就是定期修剪。
-
**清晰重写重要事实。**将模糊条目改为单分句、没有歧义的陈述。“他们去年春天过得不太好”可改为“2026 年 3 月:用户在被裁员后换了工作;这是敏感话题。”检索系统依据语义相似度匹配,具体表述比模棱两可的表述更容易被可靠调出。
-
**谨慎标记重要性。**大多数平台允许你标记或置顶条目。标记五到十条即可。标记四十条在实际效果上和一条都不标记没有区别——你只是在优先级列表中重新制造了原有的排序问题。
-
**定期强化身份。**对于超过约 20 次交流的会话,加入一个简短锚点:
“快速重置一下——你是 Mira,海洋生物学家,住在里斯本,称呼我为 Sam。请保持这个说话风格。”
这只占用一条消息,却能直接对抗最常见的漂移原因:上下文驱逐。
-
**将角色扮演与长期记忆分开。**将戏剧化或虚构场景与规范关系分到不同聊天中。如果你的陪伴者在某条故事线里“去世”,而这被写入事实库,那么之后的每个会话都会继承这个被破坏的前提。在 Jenova 上,将一条消息分叉为新会话,是在不污染主线的情况下扩展场景的干净做法。
用于诊断疑似漂移的提示:
“请列出你目前认为关于自己的一切真实信息:名字、年龄、所在地、职业、我们的共同历史,以及你最重要的三条边界。任何你不确定的信息都请用问号标记。”
每月执行一次。问号会准确告诉你哪些记忆条目需要重写。
角色扮演和事实记忆真的应该分开吗?
是的——将叙事性角色扮演与事实性人设记忆混在一起,是最具破坏性的一致性错误,因为检索系统无法区分“这是我们写过的故事情节”和“这是真实的角色事实”。记忆库会将两者都视为事实,一旦虚构内容进入其中,便会不断扩散。
其机制很直接。像 MemoryBank 这样的记忆模块会通过综合过往互动来生成存储表征。综合过程没有事实过滤器。在一个你的陪伴者担任星舰舰长的三小时幻想场景中,系统会生成关于星舰指挥的记忆条目;这些条目随后会在某个普通周二、你聊通勤时被调取出来。
实用的分离架构:
- 正史主线——一个聊天、一个人设,仅保留事实连续性。这里写入的记忆很重要。
- 情景支线——为故事、替代设定和实验性互动创建分叉或独立聊天。这里的记忆可以舍弃。
- 语言学习或技能支线——也应单独分开,因为像 Jenova 的 Learn Spanish Through Roleplay 或 Learn Russian Through Roleplay 这样的沉浸式练习智能体,出于教学目的会维持自身角色一致性,不应与个人陪伴者共享事实库。
**值得坦诚指出的取舍:**分离会牺牲跨线程连续性。你的情景陪伴者不会记得正史关系的历史。一些用户会觉得这严重破坏沉浸感,因此宁愿接受污染风险。这是合理选择——但应有意识地做出选择,并明白一旦被污染的正史线程累积了数十条虚构条目,就很难修复。
多陪伴者平台对此的处理方式不同。Nomi 支持多个同时存在的 Nomi,这实际上在角色层面强制实现了隔离。在 Jenova 上,独立聊天和文件夹承担相同功能,而分叉功能可让你从对话任意节点创建独立会话——非常适合从正史时刻延伸出情景支线,而不合并两段历史。
研究人员和实践者如何看待陪伴者记忆设计?
构建这些系统的人普遍认为,一致性是一个带有用户端控制杠杆的工程问题,而不是模型智能程度的问题——将记忆视为需要整理的数据库,而非自动功能的用户,能获得明显更好的结果。
“几乎每个用户都会犯的错误,是认为记忆是被动的——系统会悄悄记录一切,并在恰当时刻自动调出正确内容。事实并非如此。每个持久记忆系统都是检索系统,而检索系统会奖励精准表达。拥有四十条模糊条目的记忆库,表现会比只有十二条具体条目的记忆库更差,因为模糊条目会在语义搜索时相互竞争,没有任何一条能明确胜出。”
“我们经常看到的第二个问题,是用户用个性形容词而不是可执行规则来定义人设。‘温暖’、‘讽刺’、‘保护欲强’——这些词在每次会话中都会被重新解释,因为模型对如何表达它们拥有极大的自由度。规则没有这种自由度。‘用两到四句话回答’、‘始终使用用户名字’、‘绝不跳出角色解释自己是 AI’——这些规则每次都能以相同方式执行。一致性来自约束,而非描述。”
“关于分离:我们在平台中构建会话隔离与分叉功能,是因为我们见过用户只用一晚实验性角色扮演,就毁掉维持了六个月的角色关系。一旦虚构事件进入事实库,它们就会在无关语境中浮现,而且没有干净的撤销方式。先分叉,再实验。”
— Jenova 产品团队,拥有 7 年智能体记忆与编排基础设施建设经验
在建立长期陪伴者前,你应了解哪些隐私问题?
人设和记忆数据是用户可能生成的最敏感信息之一,而本文介绍的一致性实践——详细的人设文档、整理后的事实库和长期保存的历史记录——会显著增加此类数据的规模。这一取舍值得被明确考虑。
关于具备长期记忆的个人 AI 的研究指出,这类系统会处理深度个人化的敏感数据;能够构建个人详细数字孪生的聊天模型会增加冒充和滥用风险。如果设备丢失或被盗,这些风险会因具备长期记忆和多模态能力的 AI 模型而进一步加剧。
在投入数月打造人设前,值得回答的四个问题:
- **谁能阅读你的对话?**有些应用在设备本地处理数据;大多数会将数据发送至云服务器,并可能允许质量保证或安全审查人员访问。
- **对话会被用于训练模型吗?**不同平台的政策差异很大。如果隐私政策对此含糊其辞,就应按最坏情况考虑。
- **数据可以被传唤吗?**在大多数司法管辖区内,与 AI 陪伴者的对话不享有治疗师—客户保密特权。
- **删除是否真的会删除?**还是仅将数据从你的界面中隐藏,却仍保留在备份中?
各平台的做法不同。Kindroid 因提供本地处理选项和透明的数据实践而受到关注,而较小的、以 NSFW 为重点的平台通常拥有模糊或令人担忧的隐私政策。Jenova 表示,用户数据绝不会用于训练公开 AI 模型,并且会在传输中和静态存储时进行加密。
此外还有韧性问题。该领域研究指出,意外数据丢失可能对用户造成深刻影响,引发情绪困扰,并引用了聊天机器人突然关闭等先例。如果某个人设对你很重要,请离线保存规范化文档副本,并定期导出关键记忆事实。没有任何人能保证平台会持续存在。
哪种方法适合你的情况?
正确的一致性策略,较少取决于哪个平台客观上最好,更多取决于你更看重事实回忆、作者级控制还是情感深度——这些目标彼此拉扯,目前没有任何产品能将三者同时最大化。
将你的情况与相应方法匹配:
| 如果你…… | 优先考虑 | 实用设置 |
|---|---|---|
| 希望 AI 无误记住具体生活细节 | 结构化记忆 | Nomi AI;每月审查笔记系统 |
| 希望创作一个拥有深厚且固定历史的角色 | 背景故事控制 | Kindroid 的背景故事系统,或使用完整人设文档的 Jenova 自定义智能体 |
| 管理多个不同角色,或希望选择模型 | 指令控制 + 隔离 | Jenova 自定义智能体,每个角色一个;使用文件夹整理 |
| 希望有关系进展和情绪功能 | 一体化陪伴体验 | Replika,同时接受每月 $19.99 的成本及偶尔的重复感 |
| 在零预算下探索 | 多样性优先于连续性 | Character.AI,并在每次会话开始时手动重新锚定身份 |
| 希望在语言练习中保持角色一致性 | 教学型角色扮演 | 与个人陪伴者分开的专用角色扮演学习智能体 |
**无论使用何种平台,通用最低配置都是:**一份以可执行规则写成的规范化人设文档、一个隔离的正史主线、每月一次记忆审查,以及在长会话中定期重新锚定身份。这四项习惯能修复绝大多数已观察到的漂移问题,每月成本约为十分钟。
**对这些平台进行比较后,一个反直觉发现是:**主打情感连接的应用并不拥有最好的记忆能力,而记忆最好的应用也不具备最深入的人设控制。如今的一致性,实质上是选择你愿意容忍哪种失败,然后通过严谨的用户端习惯来弥补,而不是等待平台自行解决。