争吵后如何不靠操控性 AI 沟通策略,找到真正实用的表达?
2026-08-15
真诚的修复语言与套路化说服策略,差别在哪里?
区别可以归结为一个检验:修复语言会坦露你的内在状态,并邀请对方回应;操控性脚本则无论你的内在状态是什么,都试图设计出对方的特定反应。实用的争吵后表达可来自多种渠道——基于戈特曼理论的修复清单、非暴力沟通的四要素结构、像 ChatGPT 这样的通用聊天机器人,以及 Jenova 的专业 AI 顾问,例如 Personal Therapist 和 Etiquette Coach——但它们在优先优化真诚,还是优先控制结果方面,存在显著差异。
以下标志可帮助区分非操控性的修复表达与策略性脚本:
✅ 它陈述观察,而非下结论——“我注意到你迟到了”,而不是“你总是迟到”;这是非暴力沟通四要素的核心区别。
✅ 它允许伴侣证伪——对方可以告诉你“事情不是这样”,而这句话仍然是你对自身经历的诚实陈述。
✅ 它不会预先编排对方的回答——真诚的请求会为“不同意”留出空间。
✅ 它经得起朗读——如果这套说法只有在伴侣不知道你事先准备过时才有效,那它就是策略,而不是修复。
✅ 它反映真实的歉意——发表在 Scientific Reports 的实验证据显示,道歉通过传达关系价值来促进原谅;这意味着,不真诚的道歉其实无从传达任何东西。
要有意义地比较这些工具,首先需要界定在这个情境中“操控”到底是什么意思——因为这条界线比大多数建议所暗示的更窄,也更容易检验。
争吵后的表达,究竟怎样才算操控?
当一段表达被设计为引发伴侣的特定反应,同时又向对方隐瞒这种设计时,它就成了操控。其机制是隐瞒,而不是说服——你完全可以希望和好,也可以直接坦白地说出来。
大多数操控性的争吵后语言可归为三种模式:
- 抢先设定框架——以“我知道你会说我反应过度,但……”开头,会预先植入一种防御姿态,使分歧看起来像是伴侣身上一个早已被预测到的缺陷。
- 获取顺从的道歉——“我很抱歉你有这种感受,但你也……”会把修复变成记账。基于戈特曼理论的修复研究指出,伴侣必须共同商定哪些话语有效,恰恰因为单方面编写脚本并不起作用。
- 把过度袒露情绪当作施压手段——升级自己痛苦的程度,让伴侣的委屈显得不成比例。
每一种模式的诚实反面通常都更短。“我想把这件事修复好”胜过一整段精心设计的铺垫。篇幅过长往往是操控的信号——真诚的修复语言通常很简短,因为它无需建构什么。
**检验能揭示一个有用的经验法则:**如果你会因为让伴侣看到自己生成的草稿而感到尴尬,那么这份草稿就是策略。本文中的每一条表达建议都经得起朗读测试。
修复处于冲突过程的哪个位置?
修复位于五阶段冲突循环的第四阶段:情绪平复之后、重新建立连接之前。错序尝试修复,是再好的表达也会失败的最常见原因。
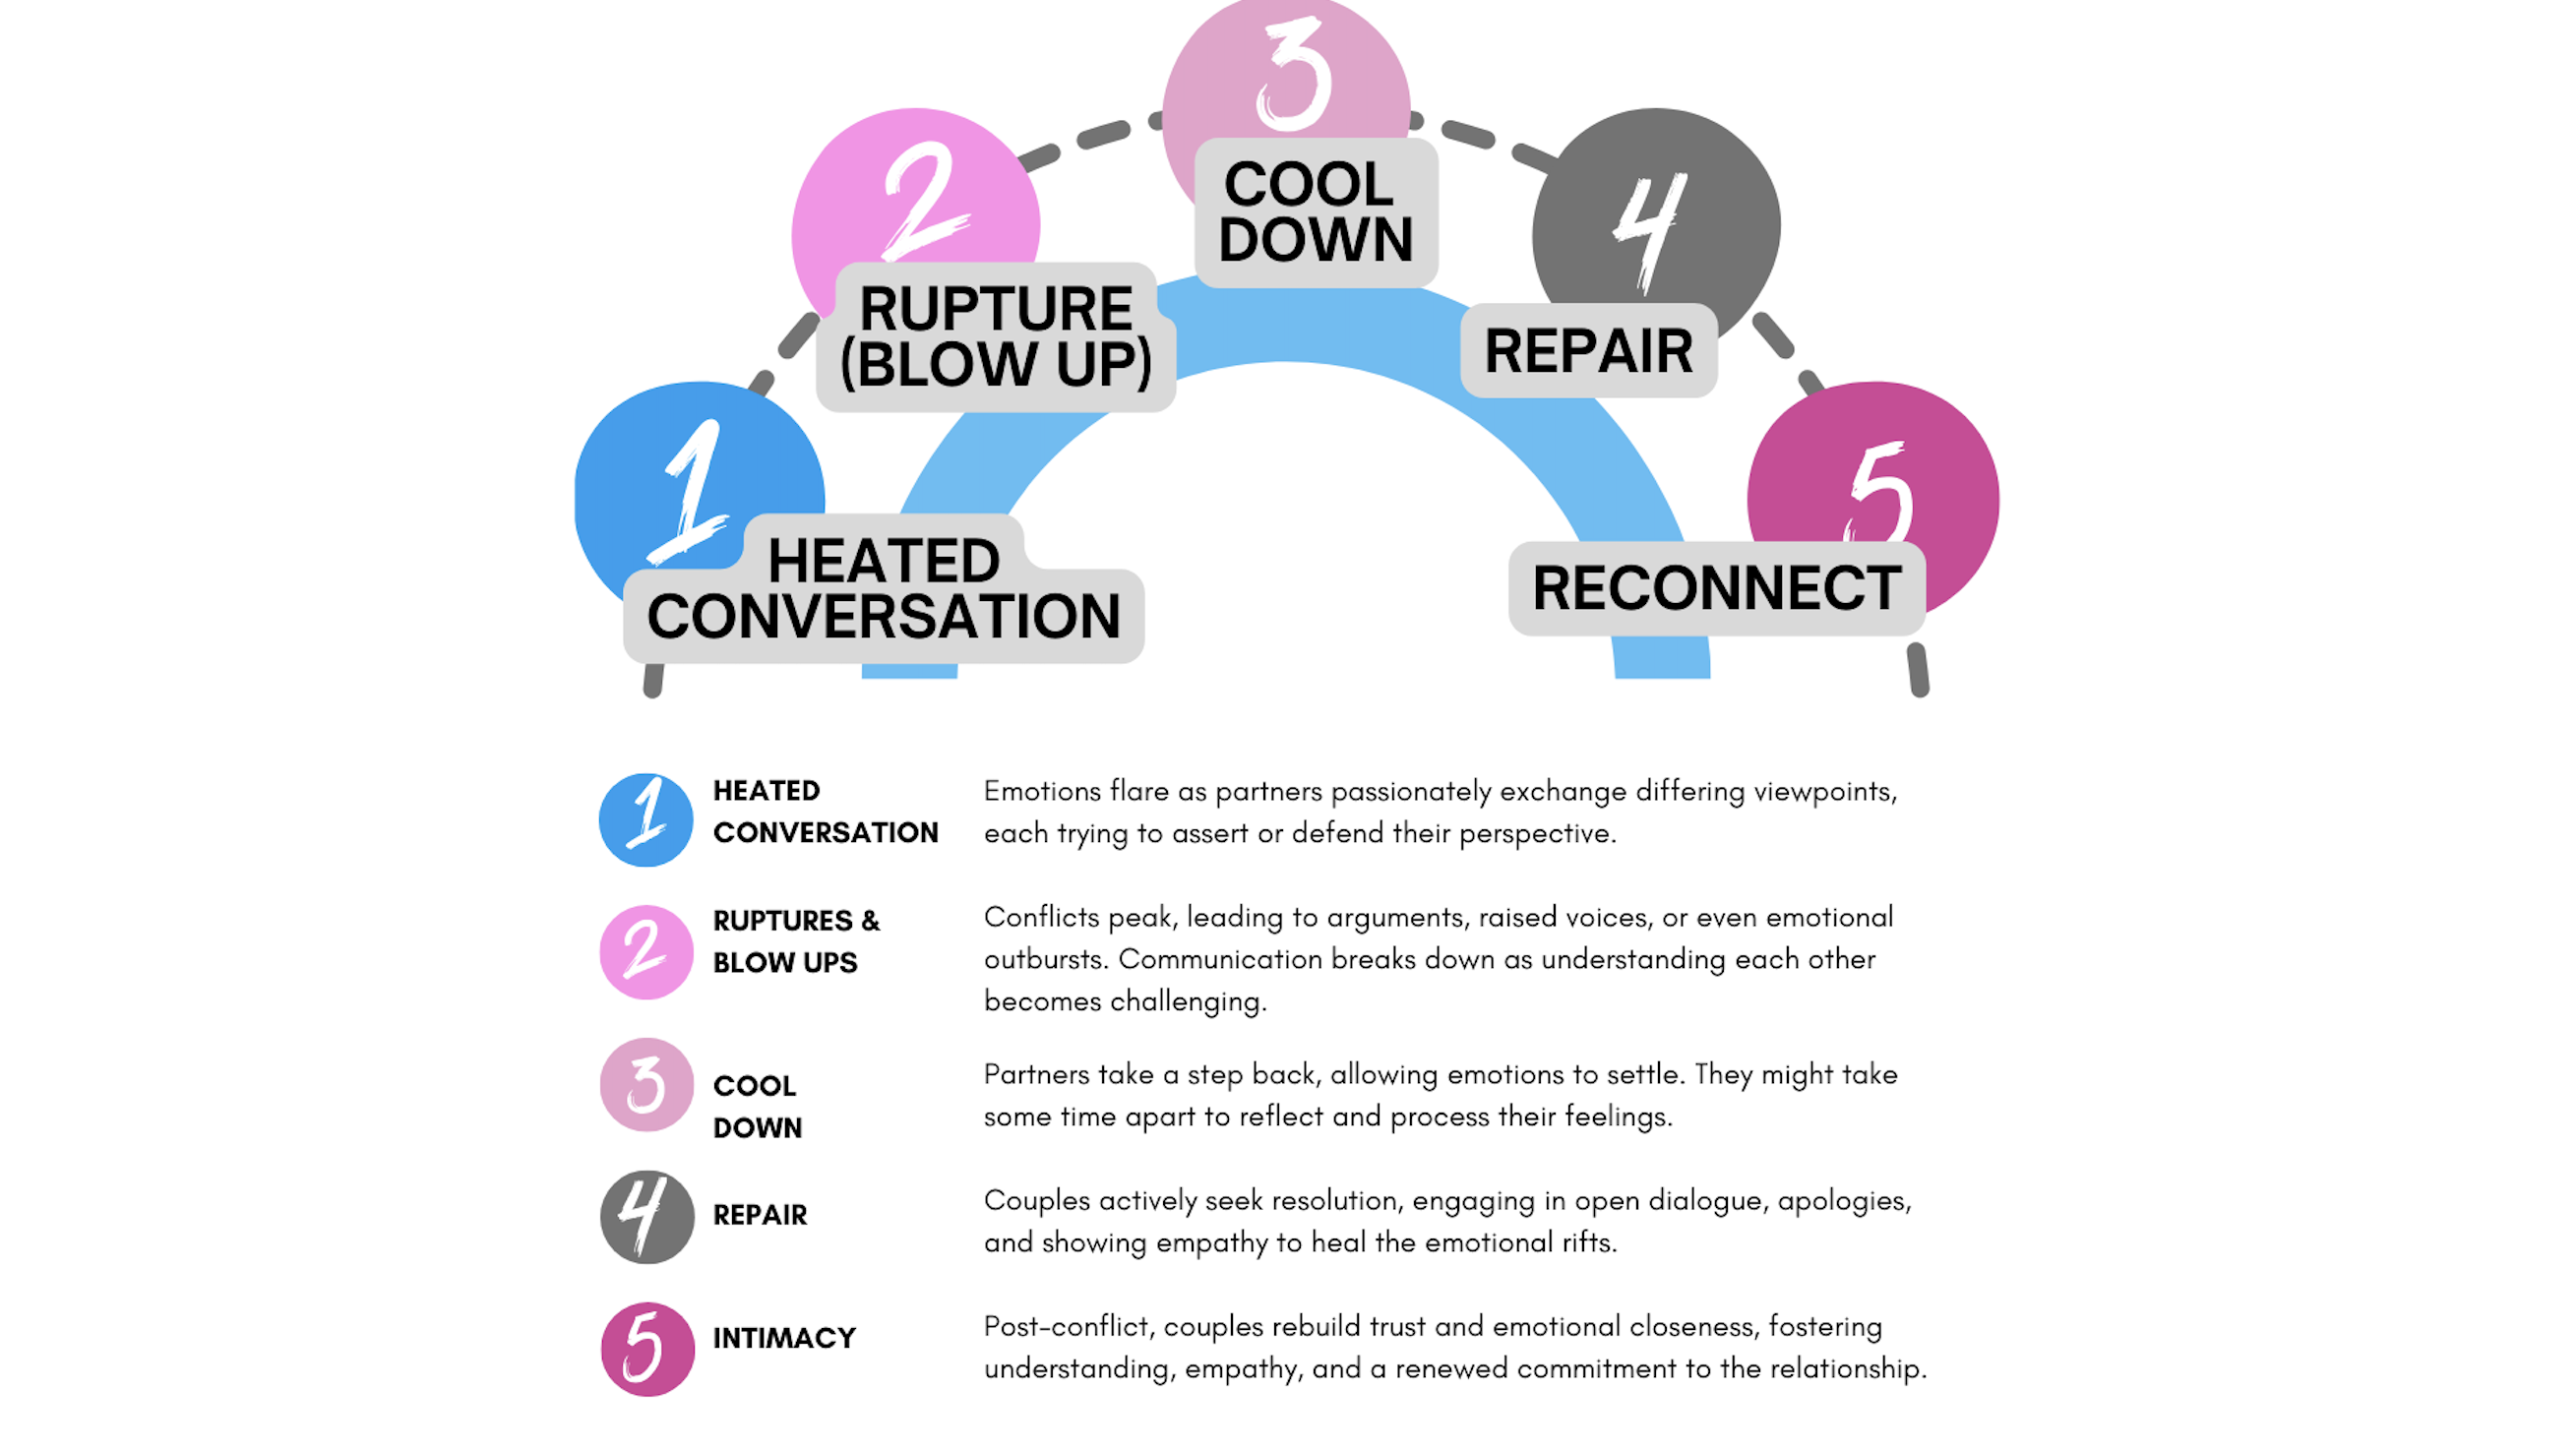
顺序很重要,因为每个阶段对语言的要求都不同:
| 阶段 | 正在发生什么 | 此时有效的表达 |
|---|---|---|
| 1. 激烈交谈 | 伴侣交换不同观点,各自表达立场或进行辩护 | 放慢节奏的表达:“你能再说一遍吗?我想确保自己理解对了。” |
| 2. 破裂 / 爆发 | 冲突达到顶点;音量升高,沟通中断 | 只说暂停行动的话:“我需要暂停一下。”不要谈内容,不要争辩。 |
| 3. 冷静下来 | 伴侣各自退一步,反思并处理感受 | 保持沉默,或只发一条事务性信息:“我九点去找你。” |
| 4. 修复 | 开放对话、道歉与共情,以疗愈裂痕 | 完整的修复语言——观察、感受、需要、请求 |
| 5. 重新连接 | 信任与情感亲密感得到重建,重新确认承诺 | 带着温度,但不重新争论:“我很高兴我们一起挺过来了。” |
最常见的错误,是在第二阶段使用第四阶段的话术。一句构思周全的“当……时,我感到受伤”如果在关系破裂的当下说出来,会显得像一种辩论动作,因为伴侣尚未处于能接收它的状态。戈特曼研究所将修复尝试定义为“任何能够防止负面情绪失控升级的陈述或行动——无论它是否有些傻气”,并指出,擅长经营关系的人会“及早且频繁地修复”。
第二个更微妙的错误,是跳过第三阶段。冷静期不是逃避;它是让你弄清楚自己是否真的为某件事感到后悔,还是仅仅想让不适感尽快结束的时间段。
一条非操控性修复信息包含哪四个层次?
一条非操控性的修复信息依次包含四个层次——观察、感受、需要、请求——而且每一层即使脱离其他层次,也必须独立为真。这个结构来自马歇尔·罗森伯格的非暴力沟通框架,该框架将观察、感受、需要与请求作为彼此不同的组成部分。
🎯 第一层:观察(仅陈述事实)
用中立的第三方也会认同的方式说明发生了什么。
- ✅ “当我提到旅行时,你离开了房间——”
- ❌ “当你因为无法接受任何批评而气冲冲地走开时——”
常见失败方式,是把评价偷偷塞进观察里。“气冲冲地走开”和“无法接受”都是评判。
💬 第二层:感受(属于你,不归因于对方)
说出你的情绪,但不要把它的成因归到伴侣的性格上。
- ✅ “——我感到被隔绝,也有点恐慌。”
- ❌ “——你让我觉得自己毫无价值。”
“你让我觉得”会把一种感受变成指责。感受本身依然有效;破坏沟通的是这种归因。
📊 第三层:需要(潜在的愿望)
说明哪项没有得到满足的需要。需要具有普遍性,例如安心、清晰、休息、尊重;策略则很具体,例如十分钟内回复一条消息。
- ✅ “我需要知道,即使对话变得困难,我们还是会把它谈完。”
- ❌ “我需要你别再一走了之。”
第二种说法点名的是一种策略,却把它伪装成需要。它也是一种要求。
📱 第四层:请求(可以拒绝)
提出一个伴侣确实可以拒绝且不会受惩罚的请求。
- ✅ “即使你仍然需要离开,你愿不愿意先告诉我你需要休息一下,而不是直接走开?”
- ❌ “下次你能不能成熟一点?”
一个有用的测试是:伴侣能否说“不能,我觉得自己做不到”,而你们的对话仍可继续富有成效?如果不能,这就是一个戴着问号的要求。
今晚就能使用的具体修复句子有哪些?
最可靠的争吵后表达通常简短、聚焦某一个具体时刻,并且不对伴侣的意图作任何断言。以下是按你实际需要完成的目标整理的实用表述。
在冲突中阻止升级(第二阶段):
- “我现在情绪太激动,没法做到公平。我们一小时后再谈,可以吗?”
- “我开始只是为了赢而争了。这不是我想要的。”
- “你能再说一遍吗?我想我刚才听错了。”
在冷静后重新开启对话(第三阶段 → 第四阶段):
- “我一直在想昨晚的事。现在方便谈吗?”
- “我还没有完全想清楚,但我想谈谈。”
- “在我说自己的看法之前,我想先听听你的说法。”
不附带隐藏条件地道歉:
- “我提高了嗓门。不管当时我为什么生气,那样做都不对。”
- “我说你家人的那句话是错的。”
- “我把这件事变成了输赢之争。对不起。”
注意,这些话里没有“但是”。斯坦福商学院指出,道歉“是研究显示确实能够促进原谅的少数做法之一”——但句子结构很重要。“但是”之后的任何内容,都会追溯性地抵消前面说过的话。
承认对方的观点,同时不放弃自己的观点:
- “你说得对,我没有提前告诉你。这部分是我的责任。”
- “我还是有不同看法,但我理解你为什么会那样感受。”
在你并不觉得自己有错时进行修复:
- “我不认为自己做错了,但比起在这件事上证明自己是对的,我更在意我们。”
- “我不想假装道歉。我们能谈谈什么会真正有帮助吗?”
最后这一类很重要,因为大多数建议都假设你心怀歉意。但有时你确实不同意对方——而假装不是这样,本身就是一种操控。
哪些 AI 工具真正有助于组织争吵后的表达?
最适合争吵后措辞的 AI 工具,取决于你是否需要先处理情绪、获得符合文化语境的表达,或进行面向伴侣关系的结构化练习——没有任何一种工具能同时把这三方面做好。
| 维度 | ChatGPT(通用) | Jenova Personal Therapist | Jenova Etiquette Coach | Maia | Talkspace(由真人主导) |
|---|---|---|---|---|---|
| 起草前的情绪处理 | 基础;高度依赖提示方式 | 专为此设计——提供共情支持与诚实问责 | 有限;侧重措辞 | 面向伴侣的文字与语音沟通 | 完整的临床处理 |
| 起草表达 | 强大的通用起草能力 | 强,侧重成长而非控制结果 | 强——明确提供措辞指导与社交修复建议 | 基于对话提出建议 | 并非主要功能 |
| 文化 / 关系语境校准 | 默认较为笼统 | 可跨会话适应 | 明确覆盖不同文化、场景和社会阶层 | 一般 | 取决于治疗师 |
| 跨会话记忆 | 受版本和设置限制 | 平台内可持续保留跨会话记忆 | 平台内可持续保留跨会话记忆 | 随着互动增多而改善 | 与你的治疗师持续进行 |
| 防操控护栏 | 取决于你的提问方式——被要求时会起草说服性脚本 | 面向问责的框架会进行提醒和纠偏 | 聚焦中性表达 | 尚未验证 | 临床医生的判断 |
| 定价 | 有免费版;也提供付费版 | 有免费版;Plus 每月 $20(免费用量的 30×) | 有免费版;Plus 每月 $20(免费用量的 30×) | 网站列示消费者应用定价 | 付费治疗课程 |
| 最适合 | 当你已知道想说什么时,快速起草 | 在写任何内容前先处理自己的反应 | 把一句话说对,尤其适用于跨文化情境 | 双方都愿意在应用中进行沟通的伴侣 | 冲突升级或高度冲突的情形 |
每种工具实际的不足之处
ChatGPT 能产出合格的修复草稿,但它会优化你所提出的要求。若你要求“写一条让伴侣意识到自己错了的信息”,它会照做。它没有内置机制来抵制操控性框架——这道护栏必须来自你自己的意图。NPR 曾报道有伴侣使用 ChatGPT 解决分歧并分析聊天记录,这既体现了它的易用性,也暴露了将判断力外包的风险。
Jenova 的 Personal Therapist 在其平台介绍中被描述为提供共情支持、诚实问责和循证指导的 24/7 心理健康伙伴。在实践中,这种问责导向正是它处理这一具体问题时最有用的特点——它更可能询问你在其中做了什么,而不是直接递给你一套脚本。它的局限也很真实:它不是持证临床医生,无法观察语气或肢体语言,在高度冲突或涉及安全的情境中,不应作为主要资源。
Jenova 的 Etiquette Coach 根据其平台介绍,涵盖跨文化、跨场景的社交修复、措辞指导和冲突应对。当措辞本身是障碍时,它是更强的选择——特别是在与姻亲的冲突、职场争议,或直接程度规范差异很大的跨文化关系中。它的局限是:它会将问题视为措辞问题,而这有时并不是正确的诊断。
Maia 将自己定位为一款关系应用:伴侣可以通过文字或语音开启对话,并根据这些对话获得建议;当双方互动增加时,建议也会改善。这种双人设计与单用户聊天工具确实不同——但它要求双方都愿意参与,而这往往恰恰是在争吵后没有发生的事。
由真人主导的治疗仍然是参照标准。Talkspace 发布由临床医生审核的 AI 伴侣关系指导,并直接指出其局限:AI“可能误读伴侣之间的情绪细微差别”,还会错过讽刺、肢体语言和关系历史。其临床医生 Minkyung Chung,MS,LMHC 精确地概括了实用方式——用 AI 起草中性的内容,然后加入你自己的声音。
如何使用 AI 工具组织修复表达,而不把真诚外包出去?
安全的工作流程是:用 AI 提供结构和词汇,绝不用它代替内容或意图——由你提供事实与感受,工具提供句子架构。
使用 Jenova 的 Personal Therapist 时,整个流程大约需要十分钟:
- 在 jenova.ai/a/personal-therapist 打开该智能体。
- 在起草之前先处理情绪。从你自己的反应开始,而不是直接写信息:
“昨晚我和伴侣因为钱的问题吵架了。我说了些关于她花钱方式的话,现在很后悔。在道歉之前,帮我弄清楚我当时真正的反应是什么。”
- 理清后,要求结构而不是脚本:
“请帮我按照观察、感受、需要、请求的结构组织一段道歉。我会提供事实——不要添加说服性铺垫,并标出任何看起来像是在设计对方反应的内容。”
- 用你自己的话重写输出内容。这一步不可协商。正如 Talkspace 的临床医生所指出的,AI 生成的表述会显得机械,因为它们确实是机械生成的。
当具体卡在措辞上时,可使用 Jenova 的 Etiquette Coach:
“我需要为晚餐时的一次分歧向岳母道歉。我们是菲律宾人,在我的家庭里,直接表达容易被视为不尊重。请给我三种正式程度不同的说法,并告诉我每种说法在社交上暗示什么。”
使用 ChatGPT 时,加入明确约束——因为它不会主动替你加入:
“请起草一条修复关系的信息。约束条件:每一句都必须是即使伴侣知道我提前写好也让我感到自在的话。不要使用说服性铺垫,不要抢先反驳对方可能的异议,也不要写‘很抱歉你有这种感受’。”
**使用 Maia 时,**流程有所不同,因为双方都参与其中——该应用的模式是先对话,再根据你们双方所说的话生成建议,而不是基于单人的提示词。
**通用护栏:**把最终信息朗读出来。如果你自己的声音无法自然地说出它,伴侣就会听出其中的拼接感。
临床医生和关系研究者如何看待 AI 辅助的修复语言?
临床界的共识是:AI 对起草和反思有帮助,但作为判断力的替代品则很危险——而风险恰恰集中在人们最想使用它的时刻。
“将 AI 作为协助伴侣治疗的工具可能是有益的。关键在于如何融合 AI 提供的信息,并使用你自己的声音。例如,你可能想沟通一个并非‘大问题’、但确实需要处理的问题。你可以使用 AI 帮助起草一个听起来中性、同时也能说明情况的模板。加入你自己的表达,会让它更具个人色彩。它不能取代交谈和使用自己声音的必要性。AI 生成的表述可能听起来机械、缺乏情感,因为它们确实如此。”
“当两位伴侣在关系中遇到困难时,伴侣治疗很重要。这不仅是针对情境提出建议,更在于咨询师能够看到情境中的细微之处,理解如何降低紧张局势,甚至基于观察提供洞见。像 ChatGPT 这样的 AI 做不到这一点。它无法观察现场情境。只依赖 AI 来处理关系问题,可能就像照着脚本念,然后希望它能够说得通。”
— Talkspace 治疗师 Minkyung Chung,MS,LMHC
Jenova 产品团队从构建对话式顾问的经验中提出了第二层观察:
“我们最常见的失败模式,并不是用户直接要求操控性语言——而是用户询问‘说这件事最有效的方法’,这会悄然把优化目标从真诚转向顺从。一旦你的目标从被理解变成被认同,有效性与真诚就开始分离。”
“设计上的应对方式,是在起草请求之前插入一个处理性问题。当智能体在问‘你想说什么?’之前先问‘你当时真正对什么产生了反应?’,最终信息通常会更短、更具体,也明显更少策略性。这是一种刻意设置的摩擦,也是我们发现的最有用护栏。”
— Jenova 产品团队,对话式智能体设计
这些观点的交汇值得注意:它们都指出了同一种风险,即流畅的输出会掩盖未经检视的意图。
什么时候应该停止使用 AI,转而与真人交谈?
只要冲突涉及安全问题、措辞从未解决过的重复模式,或每次修复尝试都让情况变得更糟的升级动态,你就应该停止使用 AI 工具,并寻求持证专业人士的帮助。
以下具体迹象表明,问题并不是措辞问题:
- 无论表达得多好,同一场争吵仍反复出现。戈特曼研究所的研究将修复尝试的一贯失败视为未来关系不幸福的预测因素——而不是提示你应该更努力地修改措辞。
- **修复尝试被视为操控。**如果伴侣把你的每一句谨慎表达都解读为策略,那么信任赤字在措辞之前就已存在。
- **存在安全或心理健康问题。**Talkspace 明确表示,AI 不适用于危机或高度冲突的关系,这些情境需要持证专业人士介入。
- **你正用 AI 逃避对话,而不是为对话做准备。**起草两小时却什么也不发送,是多了几个步骤的逃避。
隐私是一个真实但次要的考量。Talkspace 指出,大多数 AI 工具承诺保密,但“并不受与真人治疗师相同的伦理标准和法律约束”。Jenova 表示,用户数据绝不会被用于训练公开 AI 模型,并且在传输中和静态存储时均会加密——但一般原则依然成立:在向任何工具提供关系细节前,先阅读其隐私条款。