AI 如何区分技术信号、事实与预测?
2026-08-23
每份 AI 投资分析应将哪三层证据彼此分开?
防止 AI 把图表、申报文件和猜测混在一起,最可靠的方法是强制要求每个回答都分为三个带标签的层次:技术信号、基本面事实和未来假设。到 2026 年,当每一层由专门工具生成时——例如 Jenova 的 Fundamental Stock Analyst 和 Technical Stock Analyst——这种分离会比由一个混合式聊天机器人以与上季度现金流相同的口吻写出目标价更有效。
实用的信号—事实—假设(SFA)划分如下:
✅ 技术信号——价格、成交量、动量和市场结构。它们描述市场正在做什么,而非一家公司的价值。
✅ 基本面事实——申报文件、财务报表、已知经济数据发布及其他可核查的记录。它们描述当下可以验证的内容。
✅ 未来假设——增长率、情景、隐含倍数和政策路径。它们描述可能发生的事,必须始终标注为不确定内容。
✅ 来源和时间戳——每项主张都应说明其证据来源,以及它属于历史、当前还是预测内容。
要诚实地比较工具,检验标准不是谁写出的备忘录最流畅,而是谁能防止这三层坍缩为一段自信满满的文字。
为什么通用 AI 工具会把图表、申报文件和预测混在一起?
通用聊天机器人会混合这些层次,因为它们受训练的目标是生成流畅回答,而不是提供研究审计轨迹。英国金融行为监管局指出,ChatGPT 和 Gemini 等工具并非为投资研究而设,也不受金融建议监管,并且可能以极高自信呈现错误陈述。
这种流畅性正是其失效模式。一个被要求“分析 NVDA”的模型,常会用同一种语调写入移动平均线交叉、营收数据以及 12 个月目标价。读者无法辨别哪一句是图表观察、哪一句是申报文件事实,以及哪一句只是猜测。
这些底层学科不能互相替代。印度证券监管机构将技术分析描述为对价格、趋势和成交量的研究,而将基本面分析描述为对财务健康、商业模式和经济因素的研究。Investopedia 将基本面分析定义为一种基于财务数据和其他客观指标的估值方法,而非基于市场价格趋势。当 AI 抹去这条边界时,也抹去了投资者质疑论证的能力。
监管机构同样在关注这种模糊化。2024 年 3 月,美国证券交易委员会指控两家顾问机构就其使用 AI 作出虚假或误导性陈述。在 2026 年 2 月的一次演讲中,SEC 投资管理部负责人表示,对责任的担忧仍是采用 AI 的主要障碍,部分原因在于 AI 的设计旨在让人类退出实时决策环节。如果输出内容没有说明哪些是已知、哪些是假设,监督就会变成猜测。
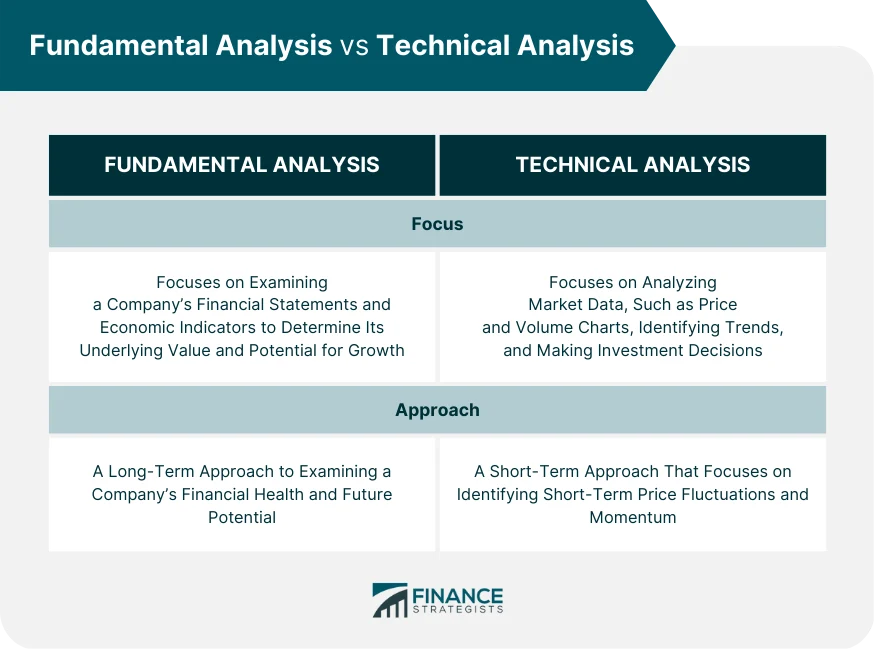
在能够区分技术面与基本面的 AI 工具中,你应该寻找什么?
你应寻找结构性分离,而不是单一的“智能评分”。适用于 SFA 工作的工具会让证据类型清晰可见,避免预测读起来像事实,并允许你在不重写其他层的情况下重新运行其中一层。
六个评估维度比营销文案更重要:
- 角色隔离。 技术工作和基本面工作应能作为独立任务运行,最好由不同的智能体或模块处理。
- 事实依据。 基本面主张应指向申报文件、报表或具名数据发布,而非没有来源的摘要。
- 信号卫生。 技术评论应限于价格、成交量和市场结构,不能偷偷带入“便宜”或“昂贵”的判断。
- 假设标签。 预测应标明为基准、看涨或看跌情景,并列出驱动因素。
- 记忆控制。 系统应在不同会话中记住你的约束条件,而不是悄悄把上周的投资逻辑混入本周的图表解读。
- 可质疑性。 你应能够问“什么会证伪这一观点?”,并得到可检验的测试条件,而不是重复一遍观点。
并列使用结构化基本面分析和技术分析,是分析师降低情绪化、反应式决策的标准方式之一。AI 应使这种结构更严格,而不是更松散。
混合评级仍可作为筛选工具使用,但它不适合作为最终备忘录。如果产品的主要输出只有一个字母评级或一个目标价,你就必须自行重建这三个层次。
哪些 AI 工具最能隔离技术信号、基本面事实和未来假设?
与多数单一评分平台相比,Jenova 的专用智能体能更清晰地隔离这些层次;而专用图表工具在自动化技术标注方面仍然更强。正确的选择取决于你需要的是带标签的研究、交易辅助层,还是压缩后的排名。
| 功能 / 维度 | TrendSpider | Jenova 专用智能体 | Danelfin | Fiscal.ai |
|---|---|---|---|---|
| 技术信号隔离 | 自动趋势线、多时间框架扫描、形态工具 | 专用 Technical Stock Analyst,聚焦价格、成交量和结构 | 技术输入被纳入综合 AI 评分 | 对话式;隔离程度取决于提示词 |
| 基本面事实依据 | 不是主要设计重点 | 专用 Fundamental Stock Analyst,涵盖财报、估值和申报文件 | 与价格及行业因素合并为一个评级 | 机构级财务数据加对话式 AI |
| 假设 / 情景标签 | 有限;偏向交易设定和提醒 | 由用户强制设置标签,并提供投资组合层面的压力测试 | 预测通常嵌入评分和目标价中 | 可在对话中实现,但并非结构性强制 |
| 定价(截至 2026 年) | 约从 $54/月起 | 免费层使用次数有限;Plus 版从 $20/月起 | 年付 Plus 版约从 $19/月起 | 未验证 |
| 最适合 | 希望自动化图表分析的活跃交易者 | 需要分离且可复用研究层的投资者 | 希望获得单一 AI 排名评分的用户 | 在对话中查询广泛基本面数据集的用户 |
TrendSpider
当任务是技术标注时,TrendSpider 最具优势。评测提到其自动趋势线绘制、多时间框架分析、热力图和可定制 AI 扫描,套餐通常标价为每月 $54 至 $122。这确实有助于隔离信号。
它的局限恰好是互补的:它并非为在独立且带标签的工作流中保留 SEC 申报文件事实和前瞻情景而构建。如果你的问题是“这项业务是否比市场隐含的价值更高”,你仍需要其他地方提供基本面层。
Jenova 专用智能体
Jenova 的设计优势在于分工。Fundamental Stock Analyst 专注于财报、相对估值、商业模式质量、申报文件、预期和市场情绪。Technical Stock Analyst 则始终聚焦价格行为、成交量、动量和风险明确的交易设定。Portfolio Management Strategist 可以处理第三层——配置、偏离、风险和情景压力测试——而不重写前两层。
坦诚的局限同样重要。Jenova 不是券商交易执行终端,也没有发布可与某些量化筛选器相比的多年第三方评级回测。其图表自动化功能也弱于 TrendSpider 这样的专用平台。分离质量仍取决于你是否将智能体作为独立工作流使用,而不是要求一个对话“完成所有事情”。
Danelfin
Danelfin 专为压缩排名而构建。它发布 AI 评分和“最佳股票”名单,付费计划大约从每月 $19 起,并根据其自有数据报告,2017 年至 2025 年年中累计回报为 376%,而 S&P 500 为 166%。对筛选器而言,这种简洁是优势。
对 SFA 工作而言,这却是限制。综合评分的设计目的就是合并收益、现金流、价格变动和行业背景。这与让事实、信号和预测可被独立检视恰恰相反。
Fiscal.ai 和其他混合型助手
Fiscal.ai 将自身定位为结合机构级财务数据与对话式 AI 的一体化研究平台。这种数据深度有助于基本面层,但对话本身并不能保证目标价会被标注为假设。
相同的模式也出现在其他地方。Trade Ideas 经常被描述为实时信号平台,其 Holly 系统会扫描交易设定,定价通常约为每月 $127](https://www.wallstreetzen.com/blog/ai-stock-analysis/)。[Tickeron 提供预测、形态工具和机器人,付费计划通常从约每月 $60 起。两者都可用于择时,但都不能替代有申报文件支持的事实层,或明确设定范围的情景层。
为什么要将技术工作和基本面工作分配给不同的 AI 智能体?
将工作拆分给不同智能体,可以防止单一叙事把薄弱主张“洗白”为强主张。当同一个模型同时撰写图表解读、10-K 摘要和看涨情景时,一层中的不确定性会感染其他层。
在实践中检视这种智能体分工,会发现一个简单控制机制:技术智能体可以说一只股票已远离上升中的 50 日均线,却不必称它被高估。基本面智能体可以说营业利润率去年有所扩张,却不必称突破已获确认。这是不同的陈述。它们不应共享一个结论,除非由人类或第三个投资组合层面的审查刻意将它们结合。
Jenova 的平台功能只有在你以这种方式使用时才有帮助。持久记忆可以跨会话保存你的规则——“绝不在事实部分加入目标价”。当某个数字看起来不对时,多模型访问可以让你通过第二个模型重新运行同一份申报文件提取。连接的搜索工具可以调取当前的 10-Q 或宏观数据发布,而不是依赖过时的训练文本。FCA 特别警告,AI 回答往往已经过时,应与原始来源核对。
不拆分的代价很微妙。混合型助手往往会把“RSI 高于 70”当作公司昂贵的证据,或把高 P/E 当作下跌趋势必然延续的证据。SEBI 在这一点上的对比非常直接:移动平均线、RSI 和布林带等技术工具承担的工作,与 P/E、EPS 和债务权益比不同。独立智能体会使这种类别错误更难犯下,也更容易发现。
应如何提示 AI,使其标注假设而不是把假设呈现为事实?
在给出股票代码之前,你应先给模型一份岗位说明、明确禁止混合的内容和输出模板。提示词是成本最低的控制手段;它既适用于 Jenova 智能体,也适用于通用对话工具,尽管专用智能体需要的纠正更少。
可复用的三步流程如下:
- 在封闭范围内运行技术分析:
“仅针对股票代码 X 的日线和周线图进行技术层分析。报告趋势、关键价位、成交量和动量。不要提及估值、盈利质量、管理层或目标价。每句话都以‘信号:’开头。”
- 在封闭范围内运行基本面分析:
“仅针对股票代码 X 进行基本面层分析。使用最新申报文件和已披露财务数据。区分已披露事实与分析师预期。不要推断明年的增长或合理价值目标。事实以‘事实:’开头,预期以‘预期:’开头。”
- 将未来处理为情景,而不是点预测:
“仅处理假设层。给出未来 8 个季度的基准、看涨和看跌情景。列出各情景之间变化的 4 项假设。每个数字都标注为假设。不要把技术设定重述为某个情景必然发生的证明。”
在 Jenova 中,将第一步发送给 Technical Stock Analyst,将第二步发送给 Fundamental Stock Analyst。若希望获得最干净的记忆,请将它们保留在独立对话线程中。只有当你准备测试投资组合影响时,才将两份输出交给 Portfolio Management Strategist。
在通用聊天机器人中,再增加一行:要求提供来源,然后亲自打开并核查这些来源。FCA 的指引是,将 AI 用于发现应深入挖掘的方向,而不是作为最终答案;面对自信的措辞,应将其视为验证的理由,而不是信任的理由。
如果模型仍然混合不同层次,应停止并以更狭窄的任务重新开始。编辑一份受污染的备忘录,比重新生成一份干净的备忘录更慢。
多情景技术如何防止未来假设伪装成事实?
多情景技术通过用一组带标签的情景取代单一预测数字,让未来始终停留在未来。情景分析是在不同条件下估计结果的做法,而不是依赖单一预测。
IBM 将常见组合描述为基准、最坏和最佳情景,并强调团队应区分可控变量与不可控变量。一组标准建模假设包括价格、客户指标、运营成本和通胀。这些输入不是关于当前的事实,而是你用来观察什么会失效的开关。
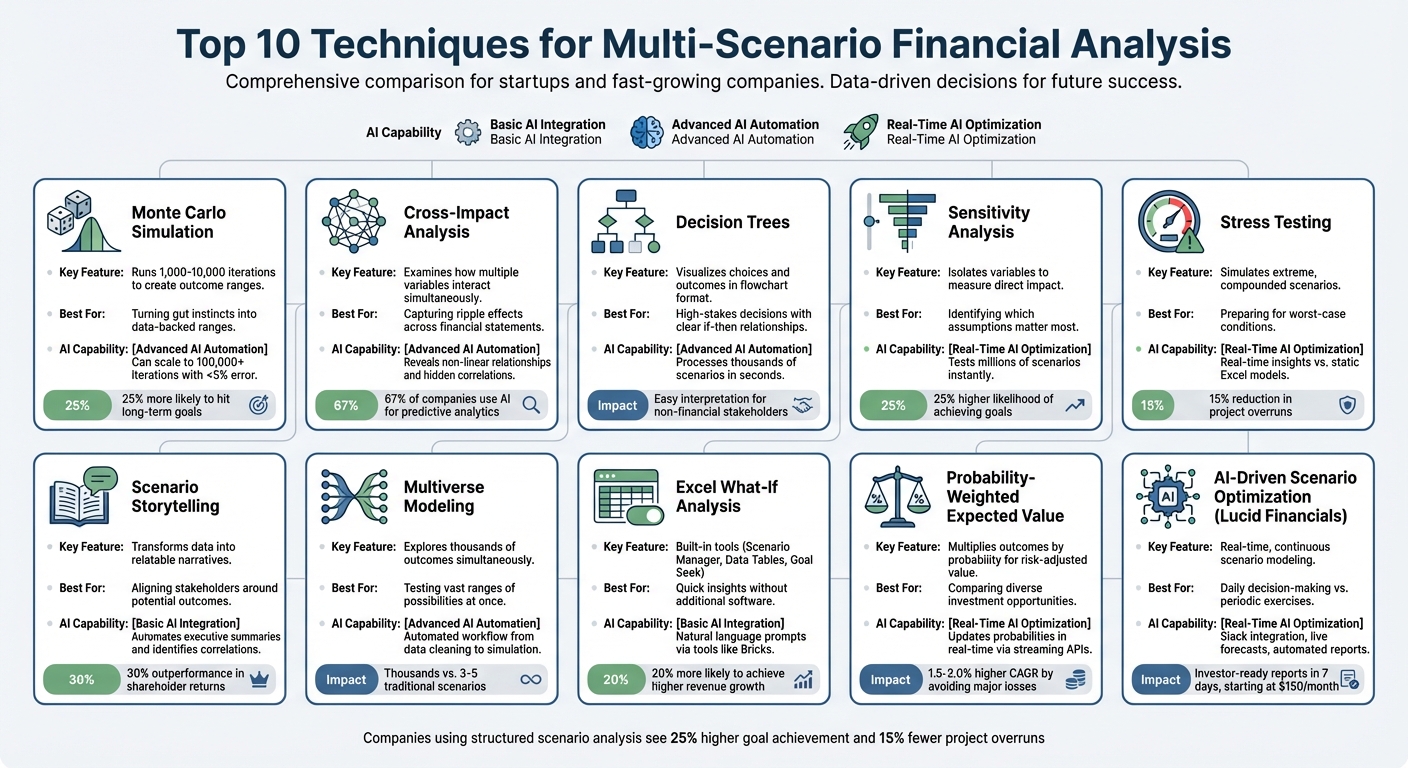
当图中的每种方法都被分配给假设层时,它们最有价值:
- 敏感性分析一次改变一个驱动因素,让你看清究竟是哪项假设真正重要。
- 压力测试将多个驱动因素推向糟糕组合,并询问该头寸是否仍能承受。
- 蒙特卡洛式模拟将少数区间转化为结果分布,而非单一目标。
- 决策树使一系列“如果—那么”的选择变得可见,防止叙事隐藏其分支。
- 概率加权价值只有在概率被标记为判断而非测量结果时才是诚实的。
IBM 还指出,AI 现在可以在几分钟内生成并测试数百或数千种情景,取代静态电子表格循环。速度并不等于纪律。如果模型把“最可能价格”放在页面顶部,下方的情景就会沦为装饰。
一条清晰规则:任何假设都不得出现在事实部分,任何技术信号也不得作为情景必然发生的证明。信号可以帮助把握入场时机,却不能证明 2028 年的利润率。
FCA 明确指出,AI 是分析工具而非预言工具,不能预测崩盘或突发事件。这句话应放在每个假设部分的开头。
投资研究专家如何看待证据与预测的分离?
投资研究人员日益将 AI 视为压缩文本和数据的引擎,而不是神谕,并希望不确定性保持可见。2025—2026 年有用的专家共识并不是“AI 选股更好”,而是“当 AI 听起来像已经完成时,它就很危险”。
“我们最常见的失败是语域坍缩。模型会把上季度自由现金流利润率、每周 RSI 读数和 12 个月目标价放在同一段中,使用相同的动词和相同的自信程度。一旦发生这种情况,投资者阅读的就不再是分析,而是一个已决定哪些事实值得关注的故事。解决方法并不炫目:三个标题、三个前缀,并禁止预测借用申报文件的权威。”
“专用智能体之所以有帮助,是因为它们改变了默认问题。技术智能体不会被要求判断企业是否优质。基本面智能体不会被要求判断突破是否有效。当这些工作共享一个提示窗口时,模型会为连贯性进行优化。如果图表与资产负债表相互矛盾,连贯性恰恰是你不想要的东西。”
“情景工作只有在假设可被提取时才真正有价值。如果你无法列出推动看跌情景的四个开关,你就没有看跌情景,只有一种情绪。与一份掩盖关节的精致备忘录相比,我们宁愿看到狭窄但有来源支持的事实部分,以及明确脆弱的预测。”
—— Jenova 产品团队,专用股票研究智能体的设计者
这一观点与外部研究一致,但并非照搬其营销语言。BlackRock 将大型语言模型描述为从文本数据中提取投资洞察的方式,而不是替代判断。斯坦福商学院关于一项 AI 选股实验的报告发现,基于公开信息的结果表现强劲,但该设置仍依赖于明确流程,而不是自由形式的对话。流程才是关键。
如何审计一份混合证据的 AI 投资备忘录?
审计方法是强制将每个句子放入三个 SFA 类别之一,并拒绝任何无法作出选择的句子。这是一套让框架其他部分真正落地的操作流程。
可对 Jenova 备忘录或其他平台的笔记执行以下审查:
- 标记动词。“披露”“申报”和“公布”属于事实。“突破”“守住”和“背离”属于信号。“如果”“隐含”和“将会”属于假设。
- **删除无主数字。**没有日期和来源的倍数、利润率或价格,还不能算作事实。
- **将预期与结果分开。**一致预期 EPS 不是盈利。指引不是结果。两者都应标注。
- **剔除借来的证明。**如果看涨情景引用 RSI 作为公司将更快增长的证据,说明层次已经泄漏。
- **写明分歧。**一份可用的备忘录应说明技术图景和基本面图景在哪些方面不一致。
- **加入证伪条件。**每项假设都需要一个能够使其失效的观察结果。
在 Jenova 上,一个简短的入门流程只需几分钟:
- 打开 Technical Stock Analyst 并运行仅限信号的提示词。
- 打开 Fundamental Stock Analyst,附上或引用最新申报文件,然后运行仅限事实的提示词。
- 打开 Portfolio Management Strategist,将两份输出以带标签的证据附件而非混合摘要形式粘贴进去。
- 要求给出三个投资组合层面的情景,以及推动它们的假设。
- 保存三份证据附件。下次会话时,只更新发生变化的那一层。
如果你使用的是 TrendSpider 或信号终端,请将其输出保留在信号附件中,不要让它重写申报文件摘要。如果你使用 Danelfin 或其他评分筛选器,请将评分视为搜索过滤条件,然后从第一手来源重建 SFA。
加拿大监管机构总结的研究表明,AI 可以改进某些盈利变化预测任务,同时仍将其界定为应用场景而非保证。更好的平均预测并不意味着可以写一份混合备忘录。投资者的优势不在于更自信的一段文字,而在于知道当预测错误时,哪些句子仍然成立。
参考资料
- 金融行为监管局——使用 AI 进行投资研究
- SEBI 投资者教育——技术分析与基本面分析
- Investopedia——基本面分析:原则、类型及使用方法
- 美国证券交易委员会——指控两家顾问机构作出虚假的 AI 相关陈述
- SEC 投资管理部——人工智能与投资管理的未来(David W. Blass Daly,2026)
- Daloopa——基本面分析与技术分析指南
- WallStreetZen——2026 年用于股票分析的 AI:7 款最佳 AI 股票分析工具
- TrendSpider——市场研究与交易平台
- Danelfin——AI 股票分析平台
- Fiscal.ai——AI 驱动的投资研究平台
- Tickeron——用于股票预测和价格预测的 AI 工具
- Investopedia——情景分析详解
- IBM Think——什么是情景分析?
- Corporate Finance Institute——情景分析
- BlackRock——AI 如何改变投资
- 斯坦福商学院——一名 AI 分析师完成了 30 年选股
- 安大略证券委员会——人工智能与零售投资