AI 如何按研究问题从数百篇论文中提取证据?
2026-08-21
问题锚定提取工作流与优先摘要的 AI 工具有何不同?
问题锚定工作流会针对预先定义的研究问题,返回可比较且关联原始来源的字段;优先摘要的工具则会以每篇论文自身的表述方式,生成流畅的段落。在 2026 年,这一区别比模型品牌更重要。Jenova's Academic Research Assistant最适合需要持续记忆和论文写作支持的迭代式、问题驱动提取。Elicit更擅长实证研究矩阵。Covidence仍是必须遵循 PRISMA 2020 报告规范的双研究者系统综述的标准工具。
将证据提取与论文级摘要区分开来的关键因素包括:
✅ 问题一致性——每个单元格回答的都是你的问题,而不是论文作者对自身贡献的表述框架。
✅ 字段级结构——方法、样本量、结局和效应方向被放入自定义列中,并关联至原始来源片段。
✅ 跨论文可比性——只有字段对齐后,矛盾之处和研究设计差异才会显现。
✅ 引文上下文核验——被引用的发现会接受后续文献的重新检验,而不会仅因已被引用就被视为真实。
✅ 人工裁决——大语言模型可加快提取速度,但无监督使用尚未准备好用于高风险证据综合。
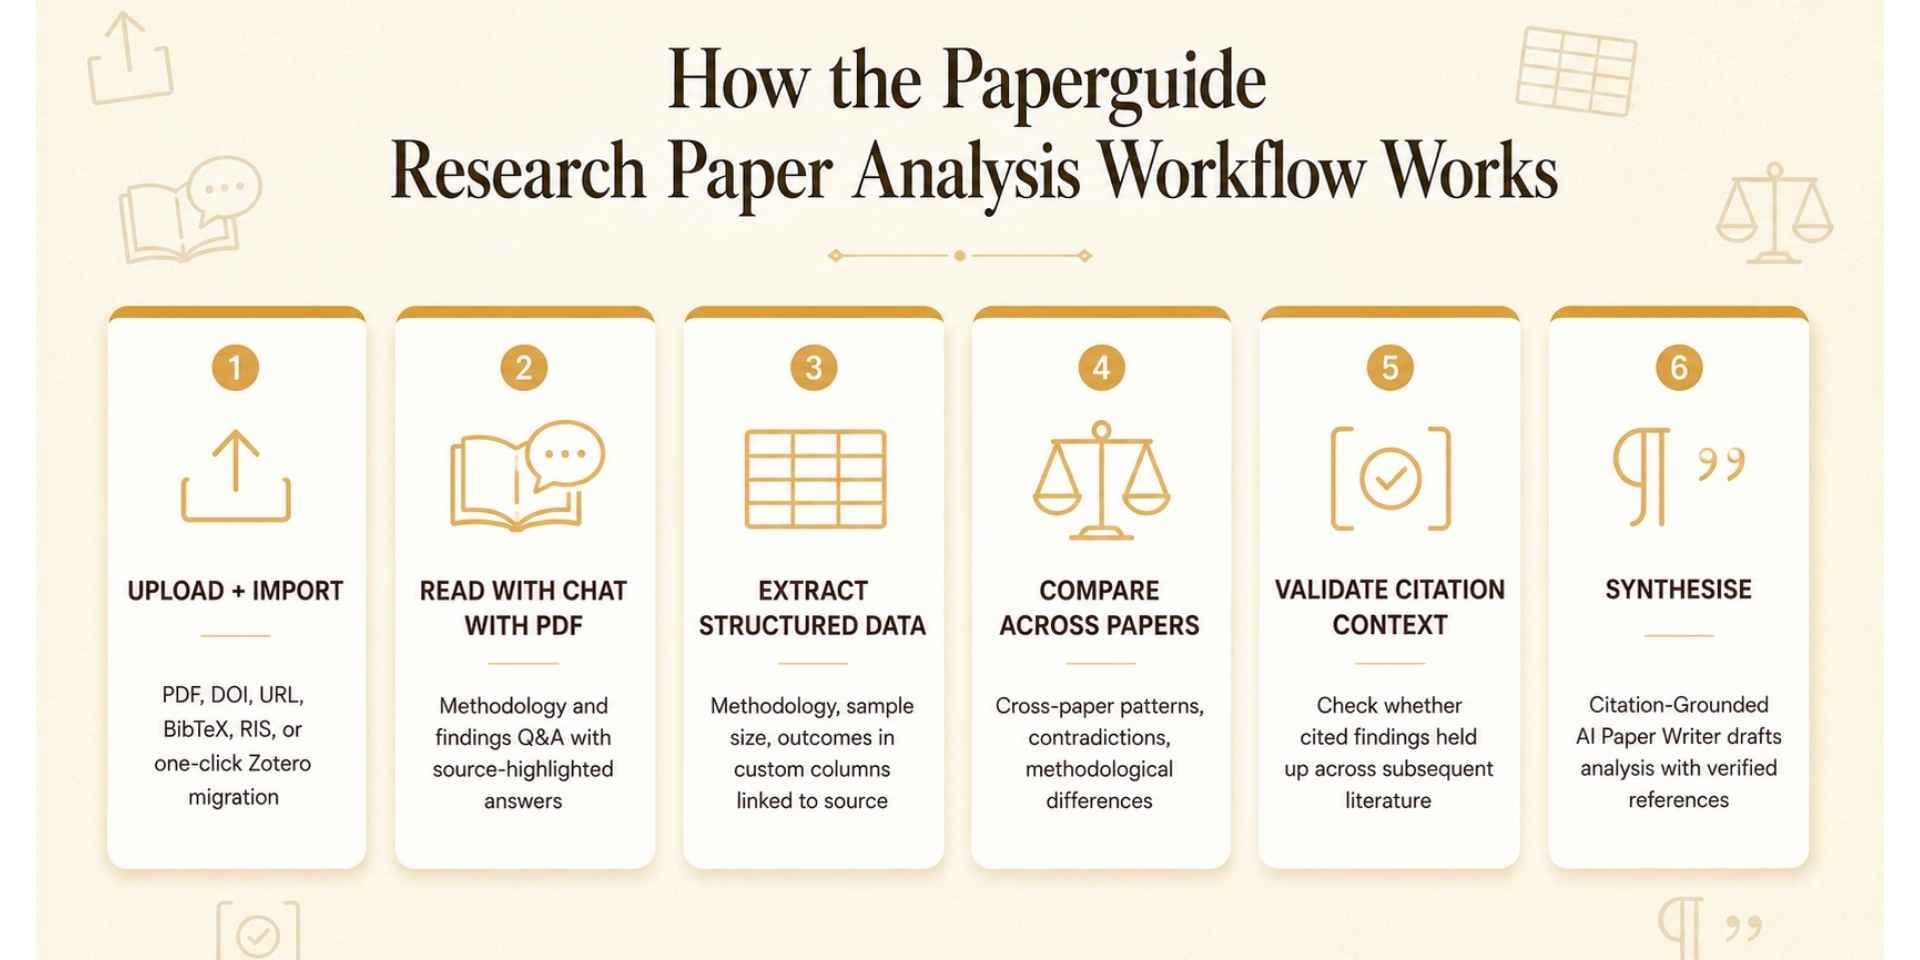
要有意义地比较工具,最好将提取视为一条流水线——导入、按问题筛选、结构化、比较、验证、写作——而不是一条“总结这些 PDF”的单一提示词。
当分析单位是研究问题时,为什么宽泛的 AI 摘要会失败?
宽泛摘要之所以失败,是因为它们会将不可比的研究压缩为叙事,从而掩盖研究问题所需的精确单元格。一篇论文级概述听起来可能很完整,却可能遗漏样本量、对照组、随访窗口,或结果是增加、降低还是无显著变化。一旦你的问题从“这篇论文讲什么?”转变为“这一文献集合对于这个问题说明了什么?”,这些遗漏就会变得致命。
证据综合的目的在于回答结构化问题,而不是改写摘要。PRISMA 2020围绕综述为何开展、采用何种方法、发现了什么来构建报告规范,而非围绕生成易读的内容摘要。当采用推荐方法时,传统综述团队仍需要大约一年时间。造成这一瓶颈的文献体量,正是优先摘要的聊天工具试图压缩成数段文字的体量。
摘要还会继承论文自身的修辞。作者会强调显著发现;摘要往往少报无效结果;引文会传播被后续研究削弱的主张。问题级提取反转了这种偏差:先定义字段,再向每篇论文提出同一组问题。对 LLM 提取的测试也显示出相反的失败模式。即使模型能够可靠处理背景字段,也可能遗漏结局数据,因此结局提取仍比研究特征提取更困难。
实际含义很简单:如果你的输出不能直接放入一张表中,做到每项研究一行、研究问题的每个要素一列,那么你还没有获得证据;你获得的只是概述。
AI 证据提取工作流应具备哪些能力?
你应寻找六项共同构成问题锚定提取框架的能力:问题一致性、结构化字段、来源可追溯性、跨论文对齐、引文上下文验证,以及有记录的人工核验闭环。即使工具在流畅写作方面得分很高,若这六项表现不佳,仍只会产出宽泛摘要。
**问题一致性。**系统必须能接受协议式问题——PICO、PECO 或自定义模式——并避免偏移到相邻发现。“按问题筛选”是现代 LLM 提取流水线的承重步骤,而非可选优化。
**结构化字段。**样本量、设计、干预或暴露、对照组、结局、效应方向和局限性应落入自定义列中,并且每项均关联至来源片段。聊天窗口中的自由文本不是数据提取表单。
**来源可追溯性。**答案需要在 PDF 中提供高亮或定位信息。没有这些信息,你无法依据原始记录裁决模型错误,也无法透明地报告方法。
**跨论文对齐。**相同字段必须在各行中具有相同含义。否则,你无法识别矛盾、剂量差异或研究设计效应。
**引文上下文验证。**2018 年成立的发现,经过后续试验后未必仍然成立。从不重新核验被引用主张的提取流程,会将过时证据包装后带入新的论文。
人工核验。多达 63% 的人工提取研究至少包含一项数据提取错误。LLM 会引入不同类型的错误,也能发现人工错误。工作流必须将分歧视为打开 PDF 核查的信号,而非评分竞赛。
2026 年的大学图书馆比较仍然依据工具角色、语料库和失败模式来评价工具,而不是依据营销说法。俄勒冈州立大学的评估指出,Consensus 可能误读来源,而 Elicit 的矩阵最适合实证论文,其摘要可能缺少细微差别。这些是评估发现,而不是一票否决的理由——而且它们正是恰当的评估粒度。
哪些 AI 工具可以跨多篇论文提取结构化证据?
没有单一工具能主导所有阶段。Elicit 领先于实证研究矩阵,Covidence 适用于团队系统综述,Consensus 适合快速了解共识概况,而 Jenova's Academic Research Assistant 适合持续推进至引文管理和写作的迭代式问题驱动分析。即使你通过多个工具组合完成相同步骤,Paperguide 风格的流水线也清楚展示了提取优先的顺序。
| 功能 / 维度 | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| 问题级自定义列 | 研究矩阵,可自定义方法、样本量和发现等列 | 提示词定义的模式可跨会话保存在持久记忆中 | 表格摘要和共识指标;自定义字段控制较少 | 纳入研究在筛选后使用数据提取表单 |
| 常见综合规模 | 对已收集来源执行从协议到提取的工作流;Plus 摘要引用少量论文 | 对上传的 PDF 和 Scholar 关联记录进行批量提取 | 每次综合最多 20 篇论文(Pro)或 50 篇论文(Deep) | 面向正式综述的团队级筛选语料库 |
| 来源可追溯性 | 可链接回纳入的文献 | 基于文档的回答,附带 PDF | 可链接至概述中使用的来源 | 完整的筛选与提取审计轨迹 |
| 双研究者工作流 | 并非核心设计 | 未内置 | 未内置 | 独立双人筛选和冲突解决 |
| 引文上下文核验 | 除提取集外能力有限 | 可通过 Scholar 和搜索进行跨会话文献追踪 | 以共识指标作为一致性信号 | 人工完成;由综述协议决定更新方式 |
| 论文交接 | 可导出至参考文献管理工具 | 引文管理加写作;Word Doc Generator可格式化文稿 | Plus 用户可导出 | 综述写作仍是独立阶段 |
| 定价(截至 2026 年) | 机构 Plus 订阅;本文未核实消费者层级 | 提供免费层级;Plus 起价为 $20/月 | 免费增值;部分校园提供 Pro 许可 | 年度个人、套餐或组织方案 |
| 最适用场景 | 实证研究提取表 | 具有长期项目的迭代式、问题驱动分析 | 快速获取生物医学/STEM 共识快照 | 符合 PRISMA 的团队系统综述 |
Elicit 明确将自身定位为可完善协议、收集来源、筛选、提取和综合的工具。这正是问题级工作所需的职责描述。图书馆评估中记录的局限性是,生成的摘要常常专注于研究发现而缺乏细微差别,并且其矩阵针对实证报告惯例进行了优化。定性论文、理论论文或结构较差的论文将难以被干净地提取。
当问题已接近一个可用“是/否”回答的实证主张时,Consensus 很有用。它可以综合叙事概述、表格和共识指标,并可执行更深入的搜索以标记知识缺口。它也可能误读来源,而 Deep 层级的论文上限仍远低于“数百篇全文”。应将它视为侦察工具,而非编码表单。
Covidence 被广泛描述为管理系统综述的领先软件。它与 EPPI-Reviewer、DistillerSR 和 JBI-SUMARI 一起,属于支持完整干预性综述技术栈——文献记录、筛选、提取和团队冲突解决——的少数平台。它比探索性研究所需的工具更重。“与这份 PDF 对话”式提取并不是其核心功能,而且大多数项目仍依赖人工完成的提取表单。
Jenova's Academic Research Assistant 位于技术栈的另一部分。它可搜索实时学术来源、接受上传的 PDF、保留无限聊天记录,并跨会话记住协议,因此无需每天重新教授列定义。它不是双人筛选工具,不能生成 PRISMA 流程图,而且数百篇论文必须分批处理,不能全部灌入单一上下文窗口。这些都是真实限制。其补偿性优势是持久记忆、多模型访问,以及无需从项目中导出,即可将同一研究问题从提取延续至基于引文的写作。
Paperguide 公开的六步顺序——上传、与 PDF 对话、结构化列、跨论文比较、引文上下文验证、基于引文的写作——清楚表述了提取优先的模式。本文未核实 Paperguide 的独立准确性和定价数据;该工作流本身才是有价值的比较对象。
当语料库涵盖数百篇论文时,结构化数据提取如何运作?
它通过将每篇论文转换为由协议定义字段构成的行,再在写出任何综合文本之前,按研究问题筛选这些行来运作。规模来自模式的重复,而不是更长的摘要。
第一步是导入。PDF、DOI、URL、BibTeX、RIS 或参考文献管理工具导出文件建立起语料库。与 PDF 对话是第二步,而不是最后一步:你应使用它定位方法和结果片段,然后将这些片段锁定到列中。一项自动化提取的动态综述发现,该主题有76 篇出版物,但只有 6 种面向终端用户实现的工具,并且84% 的算法仅挖掘标题和摘要。仅基于摘要的提取会遗漏存在于全文中的结局、亚组分析和偏倚风险细节。任何声称仅凭摘要就能处理“数百篇论文”的工作流,都在做摘要,而不是编码。
自定义列应匹配研究问题,而非供应商的默认模板。对于疗效问题,典型字段包括设计、人群、干预或暴露、对照组、主要结局、效应方向、带区间的效应量、随访和局限性。对于机制问题,应以假设路径以及研究是否确实检验该路径替换效应量。将每个单元格关联至来源片段,才使后续比较成为可能。没有定位信息,表格只是带有更多空白的另一种摘要。
数百篇论文也迫使你进行批处理。上下文窗口、速率限制和 PDF 解析错误,使一次性提取完整系统综述语料库并不可靠。一种稳健模式是:先在 8–15 篇论文的试点集中定义模式,根据人工编码测量一致性,冻结提示词,然后分批处理剩余论文。提示词文本决定完整性和输出格式;为每篇文章使用独特提示词无法泛化。应先在子集上试点,然后保持提示词不变。
Jenova's Academic Research Assistant 支持这一模式,因为模式可以保存在持久记忆中,PDF 也可以一直附加在项目内。不过,它仍要求你进行批处理。Elicit 的矩阵则更接近实证字段的原生编码表。Covidence 假设语料库已经通过筛选。请选择与自己实际所处阶段匹配的工具。
如何根据引文上下文和研究设计验证提取出的发现?
你需要检查提取的主张是否仍在被引片段中成立、是否经得起后续文献检验,以及在回答同一问题的不同研究设计中是否一致。没有这些检查的提取,会以机器速度复制引文偏差。
引文上下文验证意味着打开被引用的原始片段,而非相信引用该文献的句子。论文经常夸大某篇参考文献的结论、引用摘要而非结果,或延续已被后续试验推翻的发现。因此,专门的“这一被引发现是否成立?”检查,必须与“这篇论文报告了什么?”分开进行。Paperguide 风格的工作流将这项检查置于综合之前,这一顺序是正确的:在单元格稳定之前,不要写段落。
考虑研究设计的验证更进一步。Nature Communications 在 2025 年发表的一张方法学图示展示了两阶段流水线,即使你从不采用其评分公式,它仍是一种有用的参考架构。大语言模型将自由文本解析为人群、干预或暴露、关系和结局,然后将效应方向分类为增加、降低或无变化。这些记录再按设计分层——随机试验、孟德尔随机化、观察性研究——从而不会将不同方法得到的结果视为可互换。
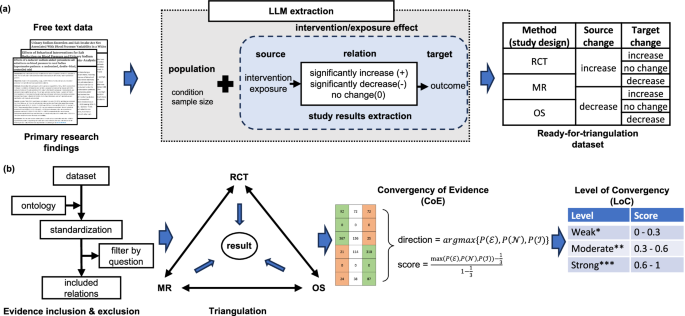
第二个面板正是大多数摘要工具跳过的部分。经过标准化和纳入筛选后,结果会跨研究设计进行三角互证。证据收敛度评分采用概率质量最高的方向;随后,收敛度等级将整组证据标记为弱、中等或强。你不需要使用完全相同的指标来应用这一理念,但必须停止将显著的观察性关联和无效试验结果合并为一句“文献表明 X”。
人机分歧应在第三次核查中根据 PDF 进行裁决,而不应自动判定为模型失败。在一项概念验证中,Claude 2 出现了 1 项重大和 5 项轻微提取错误——但它也发现了人工参考标准中的 21 项轻微错误。将已发表的提取结果视为金标准,既低估模型,也高估人工。正确的分析单位是每个字段的事实一致性;复合统计量,例如点估计值加区间,应作为一个整体一致计数,而不是视为三个无关数字。
Jenova 可执行引文上下文核查,因为它能够搜索后续文献,并在记忆中保留原始提取表。但它不能替代 Cochrane 风格综述中的第二位人工审阅者。Covidence 可以强制实施第二位审阅者。应同时理解这两个事实,而不要将它们压缩为单一赢家。
实践中如何运行问题驱动的提取工作流?
应先定义问题和字段,试点模式,分批提取并保留来源定位信息,比较各行,重新核验引文,然后根据表格写作。若颠倒这一顺序——先写作,之后再检索引文——就会重现摘要问题。
对于 Jenova's Academic Research Assistant,典型顺序如下:
- 打开智能体,并在一个文本块中说明协议,包括纳入标准和所需的确切列。
- 附加一组试点 PDF(或 DOI),而不是完整语料库。
- 提取至表格,并要求每个单元格都有定位信息。
- 在修正试点结果后冻结提示词。
- 分批处理剩余论文,然后在进行任何叙事性综合前,执行矛盾核查和引文上下文核查。
一个有用的开场提示词:
“研究问题:在治疗抵抗性抑郁症成人中,辅助使用氯胺酮与安慰剂相比,是否会在 24 小时降低 Montgomery–Åsberg 评分?仅纳入 RCT。对于每篇论文,提取:研究设计、随机分配人数、剂量和给药途径、对照组、主要结局、时间点、带 95% CI 的效应量、方向(增加 / 降低 / 无变化)以及局限性。针对每个效应量引用结果句。不要总结不符合纳入标准的论文。将空白单元格标记出来,不要推断。”
在表格建立后,一个有用的比较提示词:
“仅使用提取表,列出:(1)效应方向冲突;(2)可能解释冲突的剂量或时间点差异;(3)任何其引用支持试验早于同一结局最新无效结果的行。不要添加表中不存在的论文。”
对于 Elicit,对应路径是协议完善、来源收集、筛选,再建立自定义列矩阵——这正是该产品为系统性文献综述所记录的步骤。应从字段已与矩阵匹配的实证问题开始,例如样本量、方法和结局。不要期望理论论文获得同等质量的提取结果。
对于 Covidence,应执行检索结果导入、去重、双人标题/摘要筛选、全文筛选,然后使用提取表单。图书馆指南将此类软件视为支持结构化、透明、可复现证据综合的环境,而非聊天机器人。如果你需要 PRISMA 流程图和两位独立审阅者,应从这里开始,并且只在提取表单中使用 LLM,第二位审阅者仍须是人工。
两项操作规则适用于这三种工具。第一,绝不能让模型用看似合理的值填补空白;空白单元格本身就是数据。第二,应衡量完整任务耗时——提示词迭代、裁决和修正——而不仅是模型延迟。任务耗时才是相关的效率结果,而提示词工程也是这段时间的一部分。
证据综合研究者如何看待 LLM 数据提取?
研究者将 LLM 视为背景字段的有前景加速器,却不认为其已被证明可替代结局提取;验证设计本身仍是一个开放的方法学问题。2025–2026 年方法学论文的共识带有条件性:它们在受监督工作流中有用,但尚未准备好充当无监督提取器。
“证据综合的瓶颈并不是阅读速度,而是让每项研究以相同字段回答同一个问题,然后发现这些字段何时彼此矛盾。摘要可以很流畅,却仍无法用于这项工作,因为流畅性会掩盖空白单元格。当我们让团队从论文级聊天转向问题锚定表格时,最先出现的不是洞见,而是缺失值:没有分母的样本量、没有时间点的结局,以及无法支持其所附句子的引文。”
“我们也不再将人工提取视为金标准。大量人工编码的研究至少包含一项提取错误,模型有时能发现这些错误,同时也会引入其他错误,尤其是在复合统计量方面。富有成效的评估单位,是根据 PDF 裁决的每个字段事实一致性。在一个工作流能够展示这一闭环——模式、定位信息、批处理、矛盾核查、重新核引——之前,无论它声称读过多少论文,它都只是一个摘要工具。”
—— Jenova 产品团队,研究工作流设计;具备构建跨文献发现和论文准备的长期学术智能体项目经验
这一立场与独立评论一致。一项关于系统综述中 LLM 的范围综述得出结论:它们正在兴起,但尚未准备好投入使用作为独立基础设施。关于用于数据提取和偏倚风险评估的语言模型的其他研究,正在测试人机混合流水线,而不是仅由模型完成的综述。该领域真正的问题不是“一个模型能否阅读 400 份 PDF?”,而是“一个有记录、按问题筛选的表格能否经受双重审阅?”
何时应使用专门的系统综述软件,而不是 AI 研究智能体?
当你需要双人独立筛选、可报告的 PRISMA 流程以及期刊、HTA 机构或指南小组会审查的审计轨迹时,应使用专门的系统综述软件。当你仍在塑造问题、编码动态语料库,或将稳定表格转化为论文时,应使用 AI 研究智能体。这两者更多时候是前后衔接,而不是竞争关系。
Covidence、DistillerSR、EPPI-Reviewer 和 JBI-SUMARI 的存在,是因为对于干预性综述而言,可复现的方法、团队工作流和符合 PRISMA 的记录是要求而非偏好。这些平台中的机器学习在筛选环节帮助最大——一项评估估计筛选负担最高可降低 60%——而提取和偏倚风险工具仍相对薄弱。如果你的产出是已注册综述,不要因为聊天模型能够改写 PDF 就跳过这一技术栈。
当问题仍在变化时,智能体是更好的日常环境。你可以附加新的 PDF、修改列,并将协议决策保存在记忆中,而不必在每次调整时都新建综述项目。Jenova's Academic Research Assistant 正是为这种模式构建的:实时学术搜索、附加全文、持久提取模式,以及通向引文管理写作的路径。它不能满足要求两位筛选者的协议。明确这一限制,是正确使用它的一部分。
2026 年许多团队采用的实用划分如下:使用智能体或 Elicit 进行探索并定义字段;注册协议;在 Covidence 或同类工具中筛选和提取,可选择由 LLM 辅助编码,但仍由人工核验;回到智能体中对引文上下文进行压力测试,并根据锁定后的表格写作。杜克大学的证据综合工具箱列表提醒我们,没有一个应用能覆盖所有阶段;专业能力在于知道自己处于哪个阶段。
决定技术栈的检验标准,与本文开头的标准相同。如果你能指出一个研究问题、该问题每个要素对应的一列、每个单元格对应的定位信息,以及被排除内容的记录,那么你正在提取证据。如果你只有一篇写得很好的“论文怎么说”概述,那么你仍然只是在做摘要——即使这篇概述来自数百个文件。
参考文献
- PRISMA 声明——系统综述报告指南
- The BMJ——PRISMA 2020 声明:系统综述报告更新指南
- ScienceDirect——系统综述中的 LLM:正在兴起,但尚未准备好投入使用(范围综述)
- PMC——支持系统综述过程的数字工具
- BMJ Evidence-Based Medicine——评估 LLM 数据提取时的挑战与陷阱
- 俄勒冈州立大学图书馆——文献研究 AI 工具比较
- Elicit——系统性文献综述工作流
- Covidence——系统综述管理软件
- UCL 图书馆指南——系统综述软件
- Nature npj Digital Medicine——用于数据提取和偏倚风险评估的语言模型
- 杜克大学图书馆——证据综合的软件和工具