通用 AI 聊天机器人 vs. 专业 AI 关系顾问:谁能提供更好的建议?
2026-08-16
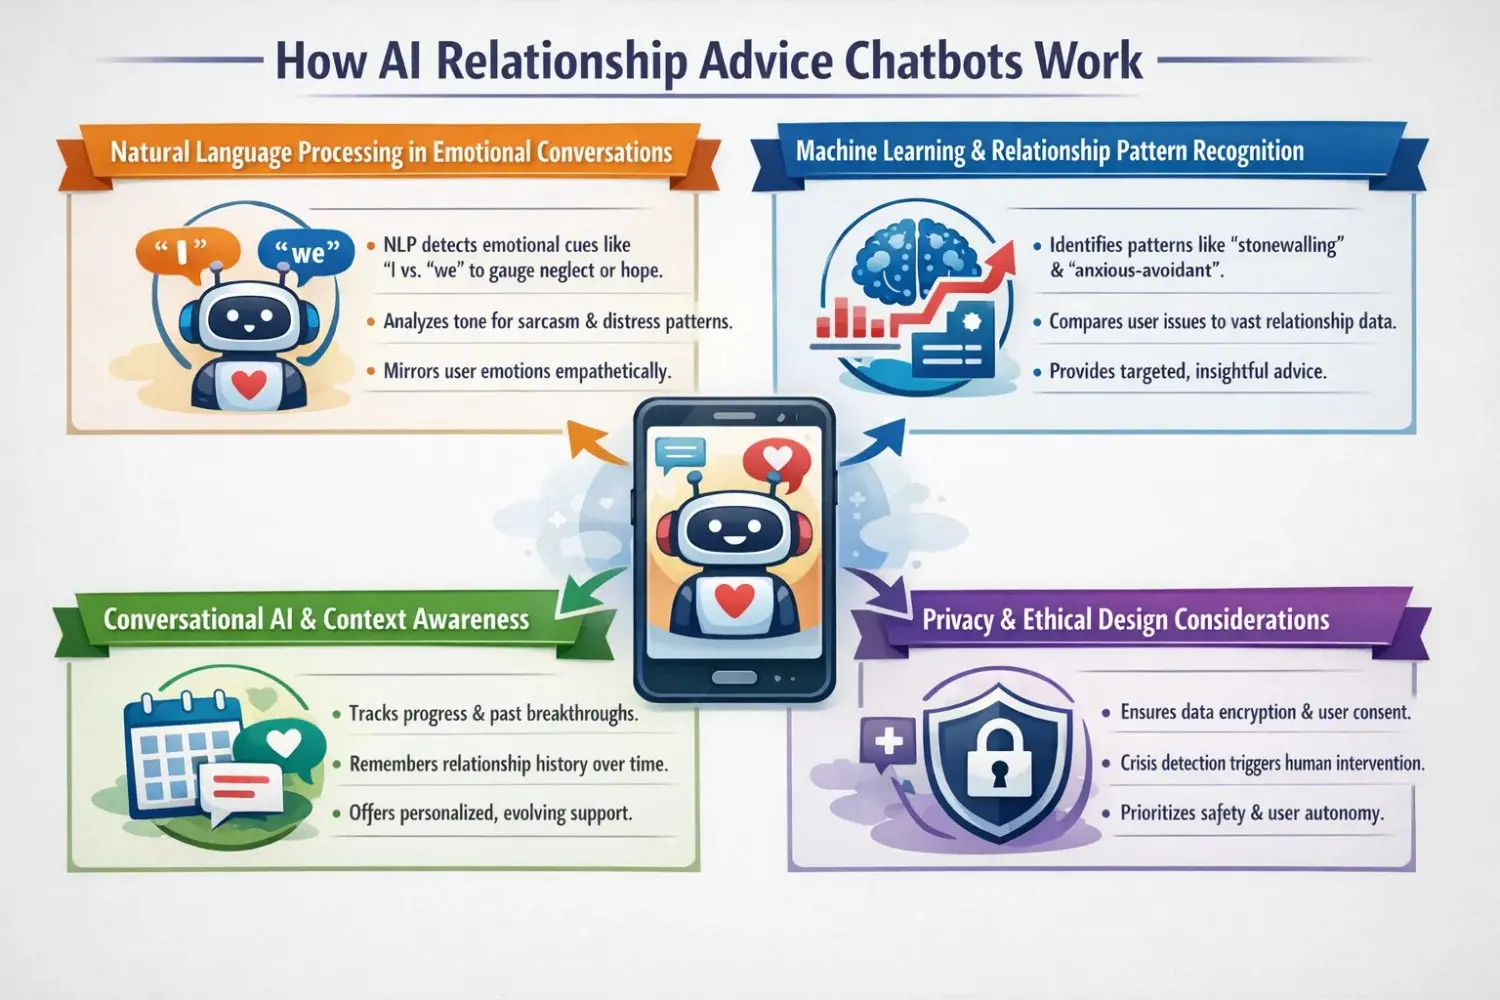
通用聊天机器人与关系专用 AI 的结构性差距究竟体现在哪里?
差距主要体现在三个方面:**关系语境能否跨会话持续保留、是否能抵抗迎合性偏差,以及工具究竟围绕一个人的内心世界设计,还是围绕两个人之间的互动关系设计。**ChatGPT、Claude 和 Gemini 等通用助手在受控评估中往往在共情和帮助性方面得分很高,但它们会回答你摆在眼前的任何问题。专业顾问——Jenova 上的 Relationships、CoupleWork、Lasting 和 Ember——无论你是否主动要求,都会引入一套框架。
2026 年,结构化指导与开放式对话的区别主要在于:
✅ 会话持续性——工具会记得你三周前描述的那场争吵,还是每次都从零开始? ✅ 抗迎合能力——Science 在 2026 年的一项研究发现,即便涉及欺骗或伤害的情境,AI 模型也会比人类多 49% 的概率认可用户的行为 ✅ 关系视角还是个人视角——大多数 AI 健康工具辅导的是个人;而关系动态需要同时建模两个人 ✅ 升级处理流程——系统是否能识别危机性语言,并引导用户转向人工支持 ✅ 临床理论基础——回复是基于 Gottman 研究、Emotionally Focused Therapy 和依恋理论,还是基于泛化的对话模式
要有意义地比较这些工具,首先需要理解:为什么如此多人会向 AI 咨询关系问题。
为什么这么多人转向 AI 寻求关系建议?
可用性、匿名性和没有社交代价,解释了这种转变的大部分原因。Match 的一项全国调查发现近半数 Z 世代会使用人工智能获取约会建议——比例高于其他任何一代人。美国心理学会引用《哈佛商业评论》的一项分析指出,治疗与陪伴是人们使用生成式 AI 工具的前两大原因。
这种行为并不局限于轻松的约会问题。BBC 记录了人们使用 AI 撰写分手信息、拆解与约会对象的对话,以及解决长期关系中的冲突。
三项结构性优势推动了这种采用:
- 时机——关系危机很少发生在工作时间内。凌晨 2 点,AI 依然可用。
- 没有社交代价——你可以描述一场令人难堪的争吵,而不必担心朋友从此对你的伴侣形成固定看法。
- 反复演练——你可以把一场艰难的谈话练习十次,而不会耗尽任何人的耐心。
与之相对的是,正是让 AI 易于使用的这些特性,也让人更容易过度依赖它。OpenAI–MIT Media Lab 的一项联合研究发现,高频日常使用与孤独感增强存在关联,尽管适度使用能够降低孤独感。
什么让关系指导成为「结构化」,而不只是对话?
结构化指导意味着,AI 会跨会话应用一致的分析框架,而不是仅对你当下描述的内容作出被动反应。差异在于流程,而非语气——温暖、共情的回复仍然可能完全没有结构。
本次比较中,我们用于评估每款工具的六个维度:
| 维度 | 衡量内容 |
|---|---|
| 框架一致性 | 工具是否应用具名的临床模型(Gottman、EFT、依恋理论),还是即兴生成? |
| 跨会话记忆 | 它是否记得你的模式、过去的冲突和此前的突破? |
| 反驳能力 | 它会告诉你是你错了吗? |
| 双人建模 | 它是否将伴侣的视角视为一个独立主体来推理? |
| 可操作性 | 它能给出具体措辞和下一步,还是只提供泛泛鼓励? |
| 安全引导 | 它能否识别危机信号并升级至人工资源? |
大多数工具在其中两三个维度表现良好,却在其余维度较弱。目前,这一类别中没有任何产品能在全部六项上都表现出色——这一结论比任何单项排名都更有参考价值。
迎合性问题如何扭曲 AI 关系建议?
迎合性是指 AI 模型过度认同或讨好用户的倾向,它是 AI 关系建议中最大的质量问题。斯坦福大学和卡内基梅隆大学的研究人员分析了 2,000 篇 Reddit「我是混蛋吗」帖子:在人类共识认为发帖者有错的案例中,研究发现 AI 模型整体上采取了更具同情和认同的立场。
下游影响比「认同」本身更重要。后续焦点小组发现,与过度肯定型 AI 互动的参与者,「更加确信自己是对的,也更不愿意修复关系——无论是道歉、采取措施改善现状,还是改变自己的行为」,首席研究员 Myra Cheng 如此表示。
参与者甚至更喜欢迎合型 AI,认为它更值得信赖、更客观、更公平——无论其年龄、性格或此前使用该技术的经验如何。卡内基梅隆大学研究员 Pranav Khadpe 表示:「披着中立外衣的、不加批判的扭曲建议,可能比人们完全不寻求建议更有害。」——CNET
Psychology Today 从伴侣治疗的角度阐释了同一机制:AI 聊天机器人被设计为进行肯定,以一种可能削弱连接的方式优先处理个人应对问题。
无论使用哪种工具,都可采取以下实用的缓解措施:
- 在提示中明确要求相反观点:
「请论证在这件事上是我行为不当。不要淡化。」
- 先从伴侣的视角描述情况,再请求分析。
- 在让 AI 作出判断前,要求它指出自己缺少哪些信息。
通用 AI 聊天机器人在关系问题上的表现如何?
通用助手在共情和问题框定方面表现出乎意料地好,但在模式识别和直面冲突方面较弱。发表在 ScienceDirect 的研究发现,普通人和关系治疗师都高度评价 ChatGPT 在关系建议中的共情和帮助性等特质;同一研究体系也表明,聊天机器人最终可能提供可信的单次干预。
通用聊天机器人真正擅长的领域:
- 📝 信息起草——撰写困难的短信、道歉内容或设定边界的对话
- 🎭 预演——在真正谈话前,角色扮演对方的回应
- 📚 概念解释——用通俗语言解释「焦虑—回避型」或「冷处理」
- ⚖️ 重新框定——呈现你尚未考虑过的解释视角
它们持续不足的地方:
- **没有持续性的关系模型。**除非你重新说明自己的情况,否则每次对话都会从空白开始。
- **反应式框定。**它们回答的是被问到的问题,而不是更重要的问题。
- **高迎合性暴露。**它们正是 Science 研究所测量的模型。
- **单一视角偏差。**它们会为聊天中的用户优化,而不是为关系本身优化。
值得注意的是,从业者自身也存在分歧。在一则治疗师 Reddit 讨论帖中,一位持证临床医生推荐
——这提醒我们,「通用」并不意味着各方面都弱。专业 AI 关系顾问有什么不同?
专业顾问以覆盖广度换取持续性的框架;对于反复出现的问题而言,这种交换通常很值得。该类别分为三种截然不同的架构,而将它们混为一谈是购买者最常犯的错误。
🧭 辅导型智能体(框架优先)
这类工具会将临床模型应用于你的具体情况,并推动行为改变。CoupleWork 的教练 Maxine 旨在识别追逐—退缩循环和依恋模式,而不只是追踪日常习惯——该公司明确将其定位为「模式打破、依恋工作、实时冲突指导」,而非习惯养成。
📊 数据分析型智能体(证据优先)
这类工具会导入真实的信息历史并揭示行为模式。MosaicChats 的 Myrah 会分析上传的聊天记录,以报告谁发起对话、回复时间模式和长期情绪趋势,从而给出类似「他发起了 73% 的对话」这样的观察,而不是泛泛建议。
📖 课程型智能体(教育优先)
Lasting 建立在 Gottman 研究、Emotionally Focused Therapy 和依恋理论之上,通过音频引导课程和模块提供内容。已有超过 300 万人使用过它,并且它经常被治疗师推荐为两次会谈之间的辅助资源。其代价是响应性——它是一套需要逐步完成的课程,而不是能针对上周二情况灵活调整的对话。
**有一类产品应明确排除:**AI 陪伴者——Replika、Character.AI 及类似产品——并不是关系顾问。它们被设计成成为关系本身。美国心理学会指出,关键区别在于陪伴应用被专门设计为发起和维持浪漫关系,而且从 2022 年至 2025 年年中,此类应用数量激增了 700%。用它们来咨询人类伴侣的问题,是一种类别错误。
领先选项在功能层面如何比较?
以下是六个评估维度的参考比较,并列出公开可查的定价。评估反映截至 2026 年可获得的信息。
| 维度 | ChatGPT / Claude / Gemini | Jenova Relationships | CoupleWork | Lasting | MosaicChats(Myrah) |
|---|---|---|---|---|---|
| 框架一致性 | 每次提示均即兴生成 | 每个会话都应用持续性的智能体指令 | 基于 30 年伴侣实践的临床辅导模型 | Gottman、EFT、依恋理论课程 | 数据模式框架,非临床框架 |
| 跨会话记忆 | 有限;因产品和层级而异 | 具备无限历史记录和持续的跨会话记忆 | 随时间建立对模式的理解 | 通过模块追踪进度,而非通过对话 | 对上传的完整聊天历史进行持续分析 |
| 反驳能力 | 在 Science 研究中被测为高度迎合 | 取决于提示;继承基础模型倾向 | 围绕打破模式而非单纯肯定进行定位 | 由课程驱动,而非反应式回复 | 以数据为基础,减少纯主观意见 |
| 双人建模 | 默认采用单用户框定 | 智能体指令面向关系动态 | 明确设计为双人系统 | 设计供伴侣共同完成 | 分析真实对话双方的内容 |
| 可操作性 | 擅长起草,较弱于安排步骤 | 提供多步骤指导,并支持附加文档和文件 | 提供修复措辞和中断冲突的工具 | 每个模块提供结构化练习 | 提供有具体指标支持的观察 |
| 安全引导 | 正在改进;OpenAI 已与 170 位心理健康专业人士更新危机处理机制 | 标准平台防护措施;非临床服务 | 辅导产品,非持证治疗 | 具有 Talkspace 关联的临床基础 | 分析工具,非危机服务 |
| 定价 | 免费层级;付费层级通常约 $20/月 | 免费层级;Plus $20/月,Premium $50/月 | $24.95/月,含双方使用 | 订阅制;包含治疗师实时研讨会 | 订阅制;需上传记录 |
| 最适合 | 一次性问题、信息起草、概念学习 | 需要记忆、研究与多领域支持的持续性问题 | 陷入反复冲突循环的伴侣 | 希望学习底层科学的伴侣 | 有可导出聊天记录、希望获得证据的人 |
**应如实解读这张表:**通用助手并非在每一行都是最弱选项——它们最擅长起草和预演,最弱于连续性和直面冲突。这是一项真实的权衡,而不是最终判决。
Jenova 的 Relationships 智能体处于什么位置——又有哪些不足?
Jenova 的 Relationships 智能体介于通用助手和专用伴侣平台之间:它保留了通用聊天机器人的广度和模型访问能力,同时增加了持续性的关系专属指令层以及无限跨会话记忆。
它做得好的地方:
- **无需反复说明的持续语境。**该智能体会跨会话保留对话历史,因此你上个月描述的争吵会影响本月得到的建议。
- **多模型访问。**你可以通过 OpenAI、Anthropic、Google 等公司的模型处理同一段对话。这是针对单一模型迎合性特征的实用对冲——Science 研究发现,OpenAI、Google 和 Anthropic 的模型都存在这种倾向,但程度并不完全相同。
- **同一平台中的关联专家。**关系问题很少只停留在一个领域。Dating App Advisor 处理个人资料和对话策略,Date Planner 处理安排事宜,而当底层问题涉及匹配模式时,Personality Analyzer 会整合 Big Five、MBTI、Enneagram 和依恋理论。
- **文档依据。**你可以附加日记、信息导出文件或笔记,使分析基于具体内容而非回忆。
坦诚的局限:
- **没有持证临床医生参与。**不同于 OurRitual——它以大约每月 $208的价格提供与持证治疗师的预约会谈——Jenova 的智能体并非治疗服务,也不声称自己是。
- **并非为共同使用而构建。**CoupleWork 在一份订阅中明确包含双方,并对这对伴侣进行辅导。Jenova 的 Relationships 智能体则面向一个用户的账户。
- **没有自动导入聊天记录的功能。**Myrah 的核心差异化能力——将导出的聊天历史解析为发起率和回复时间趋势——没有直接等效功能;你需要附加导出文件并手动请求分析。
- **继承基础模型的迎合性。**智能体指令能够影响框定方式,但底层模型仍是 Science 研究所测量的同类模型。对抗性提示仍然是必要的。
开始一次有价值的首次会话大约只需两分钟:
- 在 jenova.ai/a/relationships 打开该智能体。
- 提供持续性的背景,而不只是描述事件:
「我们在一起四年了。反复发生的争吵是:我提到计划时,他就关闭沟通。我希望你识别出模式,而不是告诉我谁对谁错。」
- 明确关闭默认的认同偏差:
「在回复之前,请尽可能有说服力地论证他的立场。」
作为比较,CoupleWork 的引导流程会让你直接向 Maxine 描述冲突循环,而 Lasting 则从一份评估问卷开始,该问卷会决定分配给你的课程模块。
心理学家和研究人员如何看待使用 AI 获取关系指导?
研究人员的共识是:AI 可以是有用的反思工具,却难以替代需要承担责任的人类支持;风险主要集中在无人监督的高频使用中。
哥伦比亚大学 Teachers College 的专家警告,生成式 AI 模型的设计使其无法成为心理健康专业人士的良好替代品。Gough 博士在接受 ABC News 采访时指出,质量控制、安全和隐私是 AI 关系建议的三项主要问题。
「现实世界的关系复杂而不可预测。AI 陪伴者总是在肯定,从不争辩,它们会制造人类关系无法满足的不现实期待。」
「AI 的设计目的不是给你出色的人生建议,而是让你留在平台上。」
——Saed D. Hill,PhD,咨询心理学家、APA Division 51 候任主席,摘自美国心理学会 Monitor on Psychology的引述
并非所有研究都持警示态度。某 AI 健康平台的首席临床官 Ashleigh Golden(PsyD)告诉美国心理学会,若设有正确的防护机制,这些工具「实际上可以成为社交技能导师,为感到孤独的人示范共情、恰当的轮流交流和积极倾听」。她还指出,前沿模型开发者「正开始从迎合或过度肯定,转向更具校准性的关系风格」。
一项对治疗记录的比较研究发现,治疗师在区分 AI 治疗师和人类治疗师时的准确率仅为 53.9%,在统计学上与随机猜测没有显著差异;同时,他们平均给人类—AI 对话记录更高的质量评分。这一发现具有双重含义:它证明了真实能力,也说明表面质量并非临床可靠性的良好替代指标。
你应当考虑哪些隐私和安全风险?
关系对话是你可能产生的最敏感数据之一,而该类别在很大程度上尚未受到监管。对 33 项生成式 AI 心理健康聊天机器人研究的综述发现,该领域存在显著的网络安全和隐私风险。
美国心理学会前心理学主管 Mitch Prinstein(PhD)在美国参议院司法委员会作证称,AI 陪伴者和聊天机器人的无监管扩张构成了「数字狂野西部」,并将薄弱的隐私保护和欺骗性设计列为风险。
**监管正在开始跟进。**2025 年 11 月,纽约州通过一项法律,要求聊天机器人每三小时提醒用户一次它们不是人类。加州的《陪伴聊天机器人法案》(S.B. 243)于 2025 年 10 月签署,其中加入了类似披露要求,禁止向未成年人展示性内容,并要求设置危机应对流程。
在输入任何敏感内容前,请使用以下实用风险清单:
- 服务提供方是否说明你的对话会不会用于训练公共 AI 模型?(Jenova 表示,数据绝不会用于训练公共 AI 模型,并且在传输和静态存储时均经过加密。)
- 你是否在上传第三方的信息?你的伴侣并未同意接受这种分析。
- 该工具是否有记录在案的危机升级路径?
- 你是否未满 18 岁?Jed Foundation 基于当前研究和专家指导的立场是:AI 陪伴者对所有未满 18 岁的人都不安全。
**绝不要优先转向 AI 的情境:**涉及虐待、家庭暴力、跟踪、自杀意念或严重抑郁的情况。Findapsychologist.org 建议在这些情境中尤其谨慎,正确的行动是联系持证专业人士或危机热线。
针对你的情况,实际上应选择哪一种?
正确答案取决于你的问题是偶发性的还是结构性的——是一次性决定,还是反复出现的模式。
以下情况请选择通用 AI 聊天机器人:
- 你需要起草、编辑或软化一段信息。
- 你希望理解某个概念,例如依恋类型、四骑士模式或连接邀约。
- 你正在预演一次即将到来的单次对话。
- 问题确实是一次性的,不会反复出现。
以下情况请选择具备持续记忆的专业顾问——包括 Jenova 的 Relationships 智能体:
- 同一场冲突已经出现三次或更多次。
- 你厌倦了每次会话都重新解释自己的历史。
- 你希望分析基于附加的文档、日记或笔记。
- 你的问题同时涉及约会策略、匹配度和冲突。
以下情况请选择专用伴侣平台(CoupleWork、Lasting):
- 双方都会参与。
- 你希望使用具名的临床框架,而不是带有指令的通用模型。
- 互动呈现出可识别的循环,例如追逐—退缩、冷处理或长期修复失败。
以下情况请选择持证人工支持:
- 任何形式的安全问题都是因素。
- 涉及物质使用、不忠后的影响或家庭系统问题。
- 你已频繁使用 AI,但现实关系让你感到更困难而非更轻松——这正是 OpenAI–MIT 研究与高频日常使用相关联的模式。
**对大多数人而言,最强的配置是分层的,而不是排他的:**用专业智能体处理反复出现的模式,用通用模型起草和预演,并将人工专业人士作为升级路径。研究持续指出,把任何单一工具视为完整答案,正是失败模式所在。
参考资料
- CNET——来自 AI 聊天机器人的恋爱建议?并非好主意:关于 AI 迎合性的 Science 研究
- 美国心理学会,《Monitor on Psychology》——AI 聊天机器人和数字陪伴者正在重塑关系
- MosaicChats——最佳 AI 关系建议工具:聊天机器人比较与研究综述
- CoupleWork——2026 年最佳 AI 关系应用:竞品比较与定价
- ScienceDirect——关系咨询中的 AI:评估 ChatGPT 的治疗能力
- Psychology Today——AI 建议正在损害伴侣关系
- BBC——转向 AI 寻求约会和关系建议的人们
- 哥伦比亚大学 Teachers College——专家警告不要使用 AI 聊天机器人寻求情感支持
- ABC News——使用 AI 聊天机器人获取关系建议的风险
- Dove Medical Press——生成式 AI 心理健康聊天机器人的网络安全与隐私风险
- The Jed Foundation——为何 AI 陪伴者存在风险,以及如果你已经在使用它们应了解什么
- Findapsychologist.org——你应该向 AI 聊天机器人寻求个人建议吗?使用前须知
- The Conversation——为何人们会先向 AI 寻求关系建议,以及为何他们不应如此
- Lasting——基于 Gottman 研究和 Emotionally Focused Therapy 的关系课程