通用聊天机器人还是专业 AI 塔罗解读工具,能给出更好的解读?
2026-08-12
听起来,这项比较应该聚焦于解读质量;但几乎所有有意义的差异,都可追溯到更朴素的问题:由谁提供抽牌结果、由谁追踪牌阵位置,以及由谁记住你上一次问了什么。
究竟是哪一层决定了解读质量——模型还是解读输入?
决定质量的更多是解读输入,而不是模型。这也是为什么专业 AI 塔罗解读工具通常能生成更有结构、更贴合上下文的诠释——并不是因为它们运行着更好的语言模型,而是因为它们将抽牌结果、牌阵位置、方向以及既有上下文作为产品状态保存下来,而非要求你每次会话都重新输入。
决定后续一切的关键区别是:
✅ 通用聊天机器人不知道你抽到了什么牌——正如 Chatarot 的评估框架直言:除非你提供,否则模型不知道实际的抽牌结果 ✅ 专业工具掌控随机化过程——洗牌、抽牌和正逆位均在产品内完成,因此牌是经由真实随机过程产生,而非由模型生成或用户自行挑选 ✅ 位置含义属于结构,而非文风——同一张牌处于“挑战”位置和“结果”位置时含义不同,只有感知牌阵的工具会自动追踪这一点 ✅ 上下文连续性是记忆问题——只有某个系统持续保存牌组,追问才能始终关联同一次解读 ✅ 模型质量趋同,输入处理却不会——获得完整输入的前沿聊天机器人,能够匹敌甚至胜过大多数专业应用
最后一点是大多数比较刻意跳过的诚实限定。拥有精心构造提示词的通用聊天机器人并不逊色——它只是以手动方式完成专业工具在结构上自动完成的事情,而大多数用户并不会构造这样的提示词。
为什么通用聊天机器人尤其难以处理塔罗结构?
因为塔罗是一种有状态的实践,而通用聊天会话默认是无状态的——赋予一次解读结构的每个元素,都必须由用户每次重新提供。
想想一条完整的塔罗提示词实际上需要包含什么:问题、实际抽到的具体牌、所使用的牌阵、每张牌所处的位置、每张牌是正位还是逆位,以及任何相关历史。漏掉其中一个元素,解读就会悄然退化为套着解读外衣的通用牌义说明。
随机化问题是其中最深层的问题。若你让聊天机器人“抽三张牌”,模型只是在生成牌名——它并没有洗一副牌。这是否重要,完全取决于你认为是什么让一次抽牌具有意义;但这与运行真正随机化程序的工具之间,确实存在方法论上的差异。
中有活跃讨论,用户报告 ChatGPT 的解读“准确得令人惊讶,居然说对了这么多事情”。这些报告是真实的——而且大多来自恰好提供了丰富上下文的用户,这正是本文所讨论的变量。**实际后果是:**用户从通用聊天机器人得到的结果不一致,并非因为模型在变化,而是因为他们的提示词在变化。同一个人在两个会话中问同一个问题时,提供的上下文量不同,得到的解读在结构上也会不同。
专业 AI 塔罗解读工具实际增加了什么?
它们增加的是产品状态——抽牌结果、牌阵、正逆位和解读历史,成为应用的属性,而不再是你必须用自然语言描述的内容。
Chatarot 的框架提出了七项具体评估标准,用于区分结构化工具与基于提示词的解读:
| 标准 | 实际含义 |
|---|---|
| 问题上下文 | 工具会在解读中使用你的准确问题,而不是返回通用牌义 |
| 随机抽牌处理 | 你在产品内抽牌,而非在聊天中编造牌或粘贴牌名 |
| 牌阵位置 | 每张牌处于明确的位置——当前、挑战、建议、环境、结果 |
| 正位/逆位方向 | 能够区分逆位,并且不会将其简化为固定的负面含义 |
| 牌与牌之间的关系 | 多张牌会被综合分析,而不是彼此孤立地逐张描述 |
| 追问连续性 | 在同一次解读中,问题始终关联同一组牌 |
| 隐私边界 | 在你分享任何内容前,账户、历史记录和敏感输入的处理方式都清晰明确 |
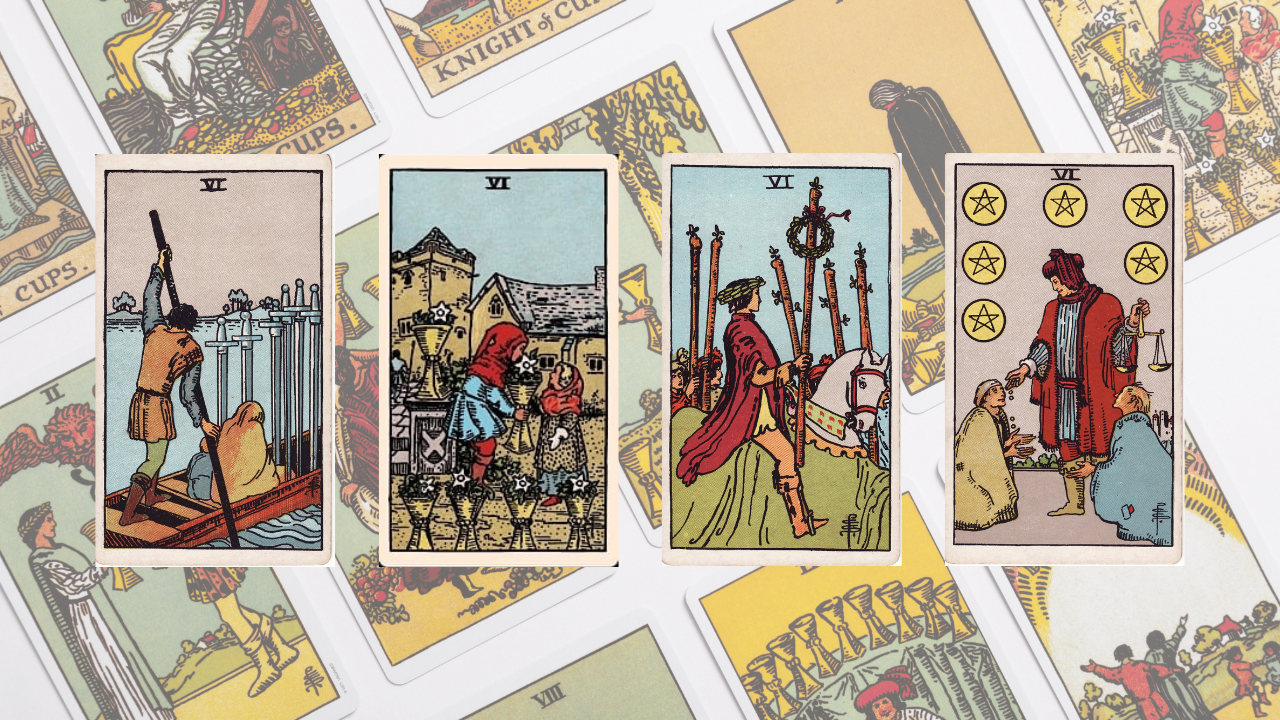
“牌与牌之间的关系”这一标准常被低估。较弱的解读会依次说明每张牌;结构化解读则会说明,宝剑六与星币六相邻时如何改变两张牌的含义。要完成这种综合,工具必须知道牌的位置;而要知道位置,位置就必须作为数据存在。
在信任任何 AI 塔罗工具的解读前,应如何评估它?
应从五个加权维度评估,并且应将权重更多放在输入处理而非文案质量上。现代模型之间的文案质量很快就会趋同,而输入架构却存在极大差异。
解读完整性框架:
- 抽牌来源可追溯性——这些牌来自哪里?产品随机化程序、你亲自洗过的实体牌组,还是模型自己的生成?
- 位置感知能力——工具是否追踪每张牌所在的位置,还是仅仅解读一个平铺的牌名列表?
- 方向处理——是否区分逆位?是否将逆位视为细微差别,而非自动的负面判定?
- 上下文持久性——追问是否仍关联同一组牌?六个月后的一次解读是否能了解这一次?
- 抗迎合性——你是否能要求工具提出挑战而不是表示认同?它是否会遵从?
**权重建议:**对于抽实体牌、只想获得解读协助的人而言,抽牌来源的权重会接近零,而位置感知和抗迎合性最重要——因此通用聊天机器人已经完全足够。对于希望将整个仪式集中在一个地方的人而言,抽牌来源和上下文持久性占据大部分权重,专业工具则更有优势。
**诊断测试:**把同样的三张牌提供给任意工具两次:第一次只给出牌名列表,第二次明确标出牌阵位置和正逆位。如果两次解读在实质上相同,该工具就没有使用位置数据——无论你提供什么,它都只是在输出牌义文案。
哪些工具最擅长处理结构和上下文?
没有任何产品在每个维度都领先。专为塔罗设计的应用擅长抽牌处理和牌阵界面;通用聊天机器人擅长灵活性和推理深度;智能体平台则擅长跨会话记忆,而这两类产品都未将其视为核心。
| 维度 | 通用聊天机器人(ChatGPT/Claude) | Chatarot | AI-Tarot: Reading Chat | Overchat AI | Tarotap | Jenova Mystic Tarot Reader |
|---|---|---|---|---|---|---|
| 抽牌来源 | 用户必须提供牌 | 产品内 3D 抽牌流程 | 应用内六张牌抽取 | 应用内拟真牌组 | 应用内抽牌 | 智能体内抽牌 |
| 牌阵位置 | 仅当用户自行说明时 | 四种牌阵,包括凯尔特十字 | 固定六张牌阵 | 是/否、三张牌、凯尔特十字、爱情、事业、每日 | 按问题类型自动选择 | 凯尔特十字、关系牌阵、可视化布局 |
| 逆位 | 仅当用户自行说明时 | 区分正位/逆位 | 未记录说明 | 与正位分别处理 | 未记录说明 | 完整 78 张牌组,支持逆位 |
| 追问上下文 | 仅限会话内 | 同一次解读中的追问 | 对已保存解读进行追问聊天 | 仅限会话内 | 追问时保留会话记忆 | 不限次数,可在会话内及跨会话使用 |
| 跨会话记忆 | 默认无 | 未记录说明 | 解读记忆会基于过去的问题积累 | 未记录说明 | 未记录说明 | 在所有会话中持续保存 |
| 定价 | 有免费档;付费约 $20/月 | 未公开 | 免费,含 IAP;$6.99/周或 $12.99 无限使用 | $14.99/月或 $49.99/年 | 免费档,每日 2 次解读、含广告;$5.99–$12.99/月 | 免费档;Plus $20/月,免费额度的 30× |
| 最适合 | 抽实体牌且需要深度解读的用户 | 希望在一款塔罗专用产品中完成抽牌到追问全流程的用户 | 希望保存解读并控制语气的 iOS 用户 | 希望在更广泛 AI 工具套件中使用塔罗的用户 | 希望系统替自己选择牌阵的用户 | 希望建立可在多年间持续积累的解读档案的用户 |
功能和定价截至 2026 年,可能发生变化;请向各提供商核实当前条款。
💬 通用聊天机器人(ChatGPT、Claude、Gemini)
这是本次比较中解读能力最强、结构性却最弱的一类。Chatarot 自己的竞品分析也直接承认了这一优势:当你想要灵活说明,并且能够自行提供牌、牌阵、正逆位和问题时,通用聊天机器人适合你。
**优势:**在含糊的多牌综合分析上拥有无与伦比的推理深度。牌阵设计完全自由——你可以发明一个九张牌布局,它也能进行解读。解读长度和追问次数没有付费墙限制。它们尤其擅长处理最重要的一条指令:“告诉我我不想听到的解读。” 对于使用实体牌组、只需要解读协助的读牌者而言尤其出色。
**局限:**没有抽牌随机化程序,因此牌的选择要么由你完成,要么由模型生成。没有持续的位置状态——你每次都必须重新说明牌阵。默认没有跨会话记忆,因此除非你在外部保存,否则三月的解读到了六月就不复存在。解读质量直接取决于提示词的完整度,而大多数休闲用户并不会提供完整信息。
也对 AI 进入灵性实践提出了大量反对意见;这一立场值得认真对待,而不是轻率否定。🔮 Chatarot
它最明确地将结构作为自身差异化优势,也最坦诚地说明了它不是什么。它将自己描述为“象征性解读工具”,并直接说明不应将其描述为有保证的预测者、医疗顾问、法律顾问、财务顾问,或专业支持的替代品。
**优势:**在一个连续流程中提供 3D 互动抽牌体验,涵盖提问、洗牌、抽牌、选择牌阵、阅读和追问。包含四种既定牌阵——灵魂之镜、时间流、选择和凯尔特十字。提供五种解读视角,让你从不同角度审视同一组牌,同时也诚实提醒:仅凭视角的多样性,不应被称为“更准确”。拥有本地化的 78 张 Rider-Waite-Smith 牌义库。同一次解读中的追问功能,让你不必在每一条提示词中重写“这些是我的牌,这些是位置”。
**局限:**比较页面未公布价格,因此无法事先评估成本。未记录跨会话记忆——其优势是单次解读内的连续性,而非跨解读历史。该评估框架本身由 Chatarot 发布,并以有利于 Chatarot 的方式定位,因此应将其竞品主张视为厂商叙事,而非独立测试结果。
🃏 AI-Tarot: Reading Chat
这是该组中最强调反思导向定位的产品。其 App Store 页面称,该应用“旨在支持反思、日记记录和个人洞见”,并且“不能替代专业建议”。
**优势:**提供五种语气的 Reading Style 控制——平衡、直接、温和、务实或深入——这是本次比较中最实用的一项抗迎合措施,因为选择“直接”会改变模型的优化目标。可对已保存的解读进行追问聊天,其理念是“一次解读不应在显示出来的那一刻结束”。会基于之前的问题建立解读记忆。支持分享解读链接。开发者称应用不会收集数据,但其服务隐私政策描述了对使用数据的收集,包括 IP 地址、设备标识符和诊断数据;并指出,分享的解读链接在你取消分享或删除前,任何持有链接的人都可公开查看。
**局限:**采用固定六张牌阵,没有布局选择,且未详细说明牌阵位置。功能描述中未提及逆位。仅支持 iOS。按每周 $6.99 计算,年化成本高于这里的大多数替代方案。评论者报告了反复出现的技术故障——一人描述持续两周收到“短路”消息,另一人称因错误无法获得解读。被评为 4+,内容属于用户生成内容类别,而非健康类别。
⚡ Overchat AI
这是专用工具中牌阵覆盖最广的一款,被整合在一个通用 AI 平台内。它的自有榜单记录了完整 78 张 Rider-Waite 牌组、可感知位置和方向的解读,以及与正位分开处理的逆位牌。
**优势:**提供六种牌阵——是/否、三张牌、凯尔特十字、爱情、事业、每日。支持可视化牌组渲染。解读可在 15–30 秒内完成。订阅还会解锁更广泛的 Overchat 平台,包括通用聊天机器人和 100 多种 AI 工具;如果你希望在一份订阅中同时获得塔罗和通用 AI,它具有最佳价值。
**局限:**该榜单由 Overchat 撰写,并将 Overchat 排在第一位;虽然这一点已披露,仍值得纳入权重考量。未记录跨会话记忆——仅有会话级上下文。价格为 $14.99/月,属于中等价位,而塔罗只是其功能组合中的一个组成部分,并非核心焦点。
🎴 Tarotap
这是这里唯一完全不让用户选择牌阵的工具。它会读取你的问题并自行选择布局,可在三张牌的过去/现在/未来时间线、七张牌详细布局、关系牌阵或单张是/否抽牌中作出选择。
**优势:**对于不知道哪种布局适合自己问题的用户,自动选择牌阵确实很有用——这也是初学者的真实障碍。相同会话内的追问会保留记忆。可用的免费档每天提供两次解读外加一次是/否抽牌。按年付费时,价格最低可至 $5.99/月。
**局限:**如果你想使用特定牌阵,控制权较少。免费档会显示广告。未记录逆位处理方式。仅有会话记忆——没有记录跨会话持续性。
智能体平台如何以不同于这两类产品的方式处理此事?
智能体平台在结构上位于两者之间:它保留了通用聊天机器人的推理灵活性,同时增加了专用应用部分提供的位置结构和跨会话记忆。
在 Jenova 上,Mystic Tarot Reader会进行抽牌、解读,并将解读呈现为一场可视化仪式。与 Jenova 直接竞争的 Overchat 独立榜单记录了其塔罗专属能力:完整 78 张牌组及逆位含义、基于牌在牌阵中落点的位置解读、包含凯尔特十字和关系布局的可视化牌阵,以及能够让后续解读引用早期解读的跨会话记忆。
该架构为结构和上下文带来的具体能力:
- 跨会话记忆——智能体会保留你在三月问过什么、它抽了什么牌阵,以及你在六月反馈了什么,从而让反复主题的识别成为可能,而不只是愿景
- 无限聊天历史——没有历史记录付费墙,这一点很重要,因为可检索性是获得上下文的前提
- 自由定义牌阵——你可以请求标准凯尔特十字,或自行发明布局;这与通用聊天机器人一样灵活,同时不丢失位置追踪
- 通过 @mention 组合智能体——当一次解读触及其他框架更适合处理的内容时,可将 Numerology Reader 或 Dream Interpreter带入同一对话
- 明确的语气指令——你可以用自然语言要求挑战而非认同,这是直接应对迎合问题的方法
**诚实的局限:**Jenova 没有动态 3D 翻牌仪式、每日推送通知节奏、内置日记模板或月相追踪器。Overchat 的榜单将其列为“昂贵”和“对于不需要其他 AI 智能体的许多用户而言功能过度”——这两项批评都公平,因为 $20/月的 Plus 档高于这里的每款塔罗专用应用,而且它覆盖的是完整智能体库而非单一垂直领域。想要精心设计的灵性界面而非对话的用户,会觉得专用应用更令人满意;偶尔才抽牌的用户,则会觉得这个价格难以合理化。
如何从任一类型的工具获得结构化解读?
结构来自你提供的内容,而非工具作出的承诺——无论使用通用聊天机器人还是专业应用,所需输入都完全相同。
从通用聊天机器人获得结构化解读:
如果你抽实体牌,这是能力更强的选择。请明确提供全部六项元素:
“我针对以下问题抽了一个凯尔特十字牌阵:我是否应该接受那份要求搬家的晋升机会?位置 1(当前):宝剑六,正位。位置 2(挑战):圣杯六,逆位。位置 3(意识目标):权杖六,正位。位置 4(基础):星币六,正位。[请继续列出全部十个位置。] 请按每张牌所在的位置进行解读,然后综合分析牌与牌之间的关系——尤其是重复出现的六。不要孤立地概述牌义。”
接着,强制展开解读分歧,而不是接受单一解读:
“请对同一牌阵给出两种真正相互对立的解读——一种支持搬家,一种反对搬家——在我对两种解读都作出回应前,不要告诉我你倾向哪一种。”
在 Jenova 上获得同样的解读:
- 在 jenova.ai/a/mystic-tarot-reader 打开 Mystic Tarot Reader
- 在第一条消息中建立上下文,让后续解读可以基于它延续:
“我想建立一项持续的练习。我已使用 Rider-Waite-Smith 牌组解读三年,目前正在处理一个因事业而搬迁的决定。请为今后的解读记住这些信息。”
- 请求带有位置解读的牌阵:
“请为搬迁问题抽一个凯尔特十字。按位置解读每张牌,注意任何逆位,并明确说明牌与牌之间如何关联,而不是按顺序逐张解读。”
- 在事情有结果后闭环:
“两个月前,你为我的搬迁问题抽牌时,在当前位抽到了宝剑六。我接受了这份工作。以下是实际发生的事——这次解读哪里错了?”
**在 AI-Tarot: Reading Chat 上获得结构化解读:**在第一次解读前将 Reading Style 设为“直接”——这是该应用内置的、用于对抗迎合性输出的控制方式。仅当你需要更多特异性时,才添加可选上下文,如姓名、星座、出生年份和地点;同时要认识到,这也会扩大生成听起来通用陈述的空间。请使用已保存解读中的追问聊天,而非重新开始,因为解读记忆会在那里启用。
**在 Chatarot 上获得结构化解读:**请有意识地选择牌阵,而不是使用默认选项——灵魂之镜、时间流、选择和凯尔特十字会以不同方式框定同一个问题。接着使用五种读牌视角,从多个角度审视同一牌阵;正如平台自己建议的那样,应把这种变化视为视角差异,而非准确度不断升级。
研究人员如何看待 AI 介导的塔罗解读?
对本次比较最重要的发现是:结构只有在提高解读投入时才有帮助——而 AI 的默认行为恰恰会起相反作用。
The Conversation记录的 2026 年 4 月研究,对 12 位塔罗从业者进行了调查,发现读牌者被拉向两个方向。有些人用 AI 绕过了将多张牌与问题相对照进行解读的挫败感——例如,针对职业变动抽到愚人和权杖十后,询问模型这究竟意味着“离开,前方有更好的机会”,还是“离开,但新工作同样会很辛苦”。研究人员将 AI 的“老好人能量”描述为让读牌者感到更自信,并指出社区担忧“这项技术的迎合性本质可能削弱人们的直觉和推理能力”。另一些人则有意用它挑战自己的盲点,要求提供替代视角以进行比较。
“专业工具的结构性优势是真实的,但比大多数人以为的更有限。它真正解决的是输入保真度——工具知道这张牌是逆位,而且位于挑战位置,因此解读会锚定于某些具体信息。它不能解决的则是解读捷径。一个工具可以拥有完美的位置感知能力,却仍然交给你一份自信的综合结论,剥夺了你原本为此而来的思考工作。”
“我们在使用通用聊天机器人进行解读的人群中看到一个一致模式:第一条提示词很丰富,第三条却不是。有人会仔细说明凯尔特十字的十个位置和正逆位,得到一次真正不错的解读,随后却提出三个完全不再提及牌阵的追问。到第四条消息时,模型已经在用塔罗词汇给出一般的人生建议。这种退化对用户而言是不可见的,也是支持使用能替你保存牌面状态的工具时最有力的实际理由。”
“真正能改善输出的建议很无聊,几乎没人会遵循:在请求解读前,先写下你自己的解读。哪怕只有两句话。然后问工具:你的解读哪里不够充分。这一个改变就能将 AI 从答案机器转化为论辩伙伴;它在通用聊天机器人和专业应用上同样有效。平台选择的重要性远低于步骤选择。”
— Jenova 产品团队,拥有 7 年构建具备持久记忆架构的对话式 AI 系统经验
应为自己的实践选择哪一类?
请根据你是否抽实体牌,以及你需要解读持续保存到何种程度来选择——这两个变量比任何功能比较都更快得出答案。
**选择通用聊天机器人,如果:**你抽实体牌并需要深度解读;你愿意在每条提示词中说明位置和正逆位;或你希望拥有最大的牌阵设计灵活性。对于将 AI 作为第二意见而非解读引擎的资深读牌者,这是最强选择。
**选择 Chatarot,如果:**你希望在一款塔罗专用产品中完成从抽牌到追问的完整流程,并获得明确的牌阵位置、方向处理以及牌间关系综合。由于比较页面未公布价格,请在决定前核实当前定价。
**选择 AI-Tarot: Reading Chat,如果:**你使用 iOS,希望保存解读并进行追问聊天,同时重视可用于抵制迎合性输出的语气控制。请权衡其按周定价及已报告的可靠性问题。
**选择 Overchat AI,如果:**你希望在更广泛的 AI 工具包中使用拥有最多牌阵选择的塔罗功能,并且原本会单独为通用 AI 服务付费。
**选择 Tarotap,如果:**你刚接触塔罗,希望系统为你选择牌阵;或者你希望获得真正可用的免费档,并能接受广告。
**选择 Jenova 的 Mystic Tarot Reader,如果:**你希望解读在数月乃至数年间持续保存并相互引用;你更重视跨会话记忆而非仪式化界面;并且会在同一账户中使用其他智能体。可在 jenova.ai 使用——免费档包含有限使用额度,Plus 为 $20/月,提供该额度的 30×。
**不要选择任何一种,如果:**你希望实践完全不受 AI 影响。r/tarot 社区持续讨论无 AI 的塔罗应用,而实体牌组加纸质日记,仍是兼具结构和上下文保真度的最佳选择。
在信任任何 AI 解读前,应验证什么?
以下四项检查可以发现该类别中的大多数失败模式。
**验证位置感知,而不是位置宣称。**把同样的三张牌输入工具两次——一次只给出牌名列表,一次标明位置和正逆位。若两次解读相同,那么无论营销宣传如何,位置并未被使用。
**直接测试抗迎合性。**要求它给出你的牌阵中最不讨喜的解读。若工具将其软化,或重新框定为安慰性表述,那么它优化的是你的舒适感而非反思;面对更重要的问题,这种行为也不会改善。
**理解“未收集数据”的含义。**开发者在 App Store 中声明的标签与服务隐私政策,可能描述的是不同范围。AI-Tarot: Reading Chat 标注“未收集数据”,而其服务隐私政策描述了对包括 IP 地址、设备标识符和诊断数据在内的使用数据的收集,也指出持有分享解读链接的任何人均可公开查看其内容。Jenova 表示,数据绝不会用于训练公开 AI 模型,会在传输中和静态存储时加密,也不会被出售或与广告商共享。在输入任何敏感内容前,请阅读当前政策。
**明确边界。**Chatarot 对自身限制的表述比大多数竞争者更好:AI 塔罗“无法验证事实、保证结果、诊断健康问题、决定法律或财务行动,或取代专业判断”。这同样适用于通用聊天机器人和专用应用,任何程度的结构复杂性都无法改变这一点。
真正有用的结论比问题本身暗示的更有限。专业工具之所以能更稳定地产生结构化解读,是因为它们捕捉了你原本可能忘记提供的输入。通用聊天机器人在你提供这些输入时,能生成更好的解读。真正预测输出质量的变量不是你选了哪一类——而是你是否在抽牌前写下了一个完整的问题。
参考资料
- Chatarot — 2026 年最佳 AI 塔罗解读工具:评估标准
- The Conversation — 塔罗读牌者如何使用 AI,以及这反映出我们对聊天机器人情感支持与建议日益增长的依赖
- Apple App Store — AI Tarot: Reading Chat
- AI-Tarot — 隐私政策
- Overchat AI — 2026 年 6 款最佳 AI 塔罗解读应用
- PBS NewsHour — 越来越多塔罗读牌者转向 AI 寻求建议:我们愈发依赖聊天机器人获得情感支持的又一迹象
- Vyas Astrology — AI 与塔罗读牌者:技术能取代直觉吗?
- Dazed — 走进诡异的 AI 塔罗解读世界