角色声音生成器:适用于游戏、故事与影视的 AI 语音
2026-09-06
Jenova 可帮助您设计独特的角色、撰写适合朗读的对白,并为任何角色声音生成器准备可直接用于制作的提示词。到 2026 年 9 月,AI 语音系统已能在几秒内复制音色,但大多数生成结果仍显得千篇一律,因为其背后的文案毫无个性。对于独立团队而言,录音棚配音依旧缓慢且成本高昂;而浅层的文本转语音处理,则会把每个角色压平成同一种节奏。
- ✅ 在长篇故事和游戏循环中保持角色人格一致
- ✅ 撰写为开口表达而生、而非仅供纸面阅读的对白
- ✅ 为现代语音模型与本地化量身组织提示词
- ✅ 在同一创作工作流中支持剧本、漫画、音乐与角色扮演
要理解这为何重要,不妨看看创作者真正需要从角色声音生成器获得什么:不是另一个标着“开心”的滑块,而是一把真正属于某个人的声音。瓶颈很少在渲染器,而在角色塑造、台词演绎,以及原创表演与未经授权模仿之间的伦理边界。
快速解答:什么是角色声音生成器?
角色声音生成器是一种 AI 系统,可生成具有鲜明个性、彼此不同的语音,让每个角色听起来都像不同的人。 创作者将其用于游戏、故事、视频和无障碍体验——但只有在角色本身足够清晰时,声音才能真正成立。
核心能力:
- 为每个角色提供独特的音色、节奏与情绪范围
- 让剧本和提示词在文本转语音后仍自然,不像 GPS 导航
- 在生成前,通过角色扮演并锁定角色一致性
- 采用避免未经同意克隆真人声音的原创角色工作流
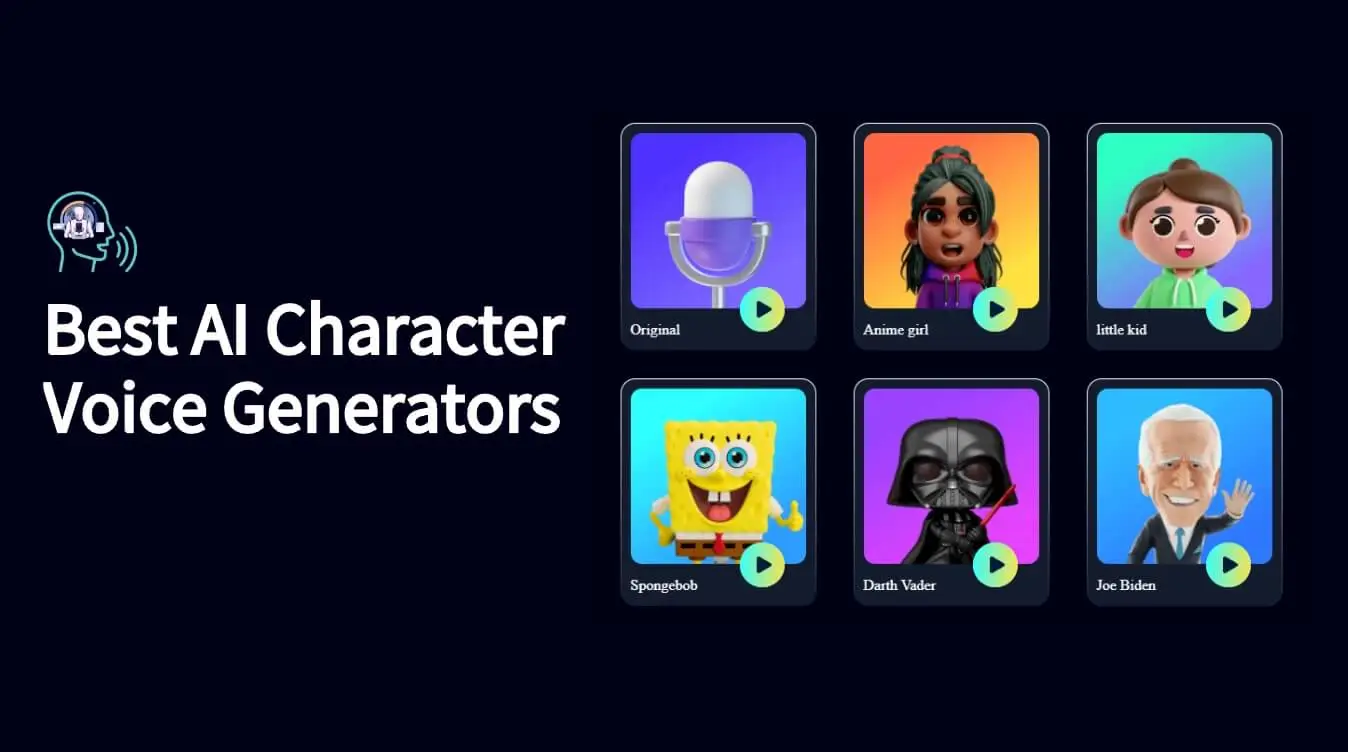
为什么大多数角色声音生成器听起来仍很普通
对合成语音的需求已不再停留在实验阶段。研究机构如今将 AI 语音生成视为独立市场,而非聊天机器人的附属功能。
USD 64 亿 —— 2025 年全球 AI 语音生成器市场规模;预计将从 2026 年的 USD 83.6 亿继续增长
USD 190.9 亿 —— 2025 年语音与语音识别市场规模;预计 2026 年将达 USD 237 亿
这笔投入正流向游戏、本地化、社交视频和客服语音。2025 年 Voice AI 的使用量增长了 9 倍,而84% 的受访组织计划增加语音技术预算。但购买渲染器并不等于购买一场表演。想获得让受众难忘的声音,依然困难重重:
- 每个角色都继承相同的节奏、呼吸模式和“乐于助人的助手”腔调
- 对于 NPC 长尾内容、YouTube 角色阵容和每周更新的网络条漫配音,录音棚流程太慢、太贵
- 为纸面而写的台词一旦说出口就会崩塌——从句堆叠、笑点失效、名字被念错
- 即使界面让它们一键可得,克隆名人和政治人物的声音仍会带来法律与信任风险
- 团队需要在写作者、提示词工程师、作曲者和语音工具之间来回切换,却没有共用的角色设定文档
同一把声音,不同的铭牌
角色声音生成器可以改变音高,却依然无法塑造身份。听众追踪的是态度,而不只是频率:反派如何拖长一个辅音,孩子如何抢着抖出笑点,疲惫的船长如何在汇报结尾压低音量。针对从漫画生成具备情绪感知和角色特异性的语音以及文本驱动的多角色语音生成的研究不断得出相同结论——模型需要的是角色语境,而不仅是波形目标。没有写明的人格,得到的只是装扮,而不是表演。
独立团队和中型团队的成本高墙
真人主演仍应承担情绪复杂的场景。制作难题在于长尾内容:数千条 NPC 问候语、本地化变体,以及玩家姓名的读音。关于游戏中合乎伦理的 AI 语音的行业分析提出了“人类加成”的分工模式——演员负责主角场景,合成语音负责规模化内容——并指出独立团队如今可在数周内完成数十种语言的本地化,而不必等待数月。但这只有在源台词适合朗读、角色设定稳定时才有帮助。否则,您只是花钱批量生产平庸音频。
从来不是为聆听而写的剧本
小说式散文和 UI 文案往往不适合用嘴说。嵌套从句、未解释的缩写和难以发音的奇幻名字,会迫使模型落入机械的重音模式。角色声音生成器会忠实地呈现一条糟糕台词。解决方案在上游:更短的节拍、音标式拼写、情绪舞台指示,以及演员能真正一口气说完的对白。
同意、克隆,以及诱发麻烦的平台
零样本系统可在约三秒内复刻一种音色。这一速度对获得同意的复刻和原创角色很有价值;但当素材库将公众人物或受版权保护的吉祥物作为预设呈现时,它也十分危险。FTC 已明确表示,AI 不享有现有消费者保护法的豁免权,并通过语音克隆挑战赛和冒充规则打击欺骗性音频。在游戏领域,2025 年 7 月的 Interactive Media Agreement 以 95.04% 的支持率通过,并规定声音复刻必须获得书面同意。如果您的流程无法证明已获得同意,就不要生成这把声音。
这正是 Jenova 的设计初衷:打造围绕生成器的角色智能,而不是提供规避法律的捷径。
Jenova 解决方案
角色声音生成器将文本变成音频。Jenova 让这些文本值得被配音。您先定义是谁在说话、他们如何思考、绝不会说什么,以及一条台词该如何落下——然后将清晰的提示词和剧本交给您使用的任意语音模型。专业音频平台负责渲染波形;本平台则负责塑造波形背后的那个人。
| 传统方法 | Jenova |
|---|---|
| 预订录音棚、等待录音、为每段补录反复重剪 | 在一次工作会话中完成角色设定文档和适合朗读的初稿 |
| 一把 TTS 声音配上一个新显示名称 | 为每个角色撰写人格、措辞和情绪节拍 |
| 克隆一把知名声音,然后祈祷没人发现 | 原创角色、已获同意的复刻,以及记录完善的使用方式 |
| 写作者在一个标签页、提示词笔记在另一个、作曲者在第三个 | 用于故事、提示词、漫画、音乐和交付的关联智能体 |
| 忽略幽默和节奏的生硬本地化 | 为音节适配和文化改写而组织的台词 |
在触碰音频之前先建立角色设定
从身份开始,而不是从预设开始。Name Generator 可生成在文化上自洽且易于发音的名字——许多语音流程直到模型被一串辅音难住时,才会意识到这一实用筛选的重要性。再配合 Writing Assistant 锁定措辞:词汇上限、禁忌词、固定笑料,以及某个角色总会使用的那一个比喻。当这些限制存在时,任何角色声音生成器都有了可供演绎的具体内容。
为嘴巴而写的对白
Film Screenwriter 将台词视为具有时长的行为:打断、沉默和潜台词。这项技艺可直接迁移到游戏短句、竖屏短剧和漫画配音中。您会得到语音模型能够遵循的括号指示,例如“压低声音,然后明亮起来”,而不是“悲伤”这类模糊标签。对于系列化移动端故事,Microdrama Screenwriter 会让悬念收尾足够短,不至于一口气读不完。
您可以将以下示例指示直接粘贴到生成器中:
“以伊利娅·沃斯船长的口吻朗读:50 多岁,低沉沙哑,声音来自胸腔。她生气时从不提高音量——她只会放慢语速。台词:‘你带来了地图,却没有带来天气。’ 在‘地图’后停顿。不要笑。”
经得起模型检验的提示词
大多数“糟糕的 AI 声音”源于糟糕的指令。Prompt Generator 可将角色设定文档转化为模型就绪的文案:口音说明、年龄、录音空间、情绪弧线和负面提示词,例如“不要播音腔,不要让元音带笑意”。这就是一张名为“动漫女孩”的素材卡,与一个恰好是动画角色的人之间的区别。
画面、配乐与场景的其余部分
声音只是其中一层。Graphic Designer 构建符合听觉预期的脸庞。Manga Creator、Comic Creator 和 Webtoon Creator 可创作连续画面,供您为口型和分镜节奏配乐。Music Composition Assistant 和 Lyric Writer 则为角色赋予主题动机和适合演唱的歌词,让说话声和歌曲都属于同一个世界。
专业语音 API 擅长渲染音频,而 Jenova 专注于决定人们是否愿意把音频听第二遍的写作、提示词和连续性。
面向角色声音创作的专业 AI 智能体
免费试用 Jenova,无需信用卡。以下智能体覆盖角色声音生成器上下游紧密相关的工作。
Roleplay Game Master
如果您需要在合成前先通过语言听见一个角色,这里就是您的排练室。无限记忆可让措辞、秘密和角色关系在多次会话中保持稳定,这相当于文本层面的锁定语音模型。
- 反复检验口头禅,直到它们听起来自然而然
- 在长篇战役中保持队伍角色与 NPC 声音彼此分明
- 生成可直接投入生成器的角色内台词
Film Screenwriter
当声音必须承载剧情、而不只是增添风味时,请使用它。结构、场景目标和对白技巧可避免表演沦为带着滑稽口音的说明文字。
- 为音频中情绪变化提供合理依据的节拍和冲突
- 适用于游戏和广告补录的简短台词
- 可经受十二集配音考验的角色发展
Prompt Generator
语音模型的质量取决于需求说明的质量。这个智能体可为文本、图像、音乐和视频系统撰写提示词——包括您已经付费使用的语音模型。
- 为每个角色提供一致的提示词模块,让各集保持统一
- 模型真正能遵循的情绪与空间描述
- 当一次试读显得太明亮或太缓慢时进行迭代优化
Writing Assistant
这是处理角色设定文档、旁白和“这应该听起来像他们”式改写的主力工具。它会适配格式与受众,因此背景设定倾倒和酒馆侮辱不会拥有同一种句子节奏。
- 针对可朗读性和阅读难度的编辑处理
- 在任务文本、预告片和更新说明之间匹配语调
- 当您已有一份接近可用的草稿时,提供协作支持
Music Composition Assistant
角色声音生成器负责语音;这个智能体负责其下方的铺底——主题动机、和声与编配说明,您可以交给 DAW 或另一个模型使用。
- 与特定角色绑定的主导动机
- 为对白留出空间的速度图
- 具备乐理意识的指导,避免反派主题与人声音域冲突
Public Speaking Coach
当您自己就是表演者——或需要指导一位表演者——这个智能体会处理表达、焦虑和受众。它是合成语音在人类侧的对应工具:呼吸、停顿和重音,之后您都可将其编码进提示词。
- 可迁移至 TTS 标签的语速和重音标记
- 用于混合直播的问答与现场朗读排练
- 关注台词对听众造成什么效果,而不只是它听起来如何
角色声音生成器工作流实际如何运行
您不需要先拥有录音棚。您需要的是纸面上鲜活的人物、一句说得出口的台词,以及一条不自相矛盾的提示词。
第 1 步:锁定人物,而不是预设
写下年龄、身份、体态,以及他们绝不打破的一条规则。生成一个易于发音的名字,然后写一份 150 字的角色设定文档。如果两个角色的台词可以互换而无人察觉,那么您还没有两种声音。
“为琳·考尔德创建角色设定文档:17 岁,河运信使,对货物总是礼貌,对船长总是无礼。使用短句。自从村庄被烧毁后,她不再使用流行俚语。给我三句她绝不会说的话。”
第 2 步:为呼吸而写,而不是为页面而写
将场景放入 Writing Assistant 或 Film Screenwriter。删去嵌套从句。在括号内为难读的人名标注音标式读法。补上一条模型能够执行的表演说明。
“将这段背景设定改写为琳的六句口语台词,每句最多十二个词,并在最后一句之前标出停顿。”
第 3 步:将设定文档转化为生成器提示词
把同一套限制交给 Prompt Generator。明确录音空间、麦克风距离、以 1–5 分表示的情绪强度,以及需要避免的内容。为每个角色保存一个提示词模块,避免第四集发生偏移。
“将琳的角色设定文档转化为语音模型提示词:少女女低音,干涩,室内仓库混响,1.05x 语速,不要笑意,不要播音腔收尾。包含负面提示词。”
第 4 步:匹配脸庞、分镜与配乐
将同一份角色设定文档交给视觉和音乐智能体,让画面与配乐和声音保持一致。明亮的卡通脸配上葬礼般的念白,会让受众判定音频是假的——即便模型本身非常准确。
第 5 步:先在手机上排练,再进行渲染
Jenova 在网页、iOS 和 Android 上提供完全一致的功能。通勤时大声读出台词,标记卡顿处,改写,然后才粘贴进您的角色声音生成器。最便宜的补录,是您根本不必录制的那一次。
成果与使用场景
🎮 无需录音棚预算的独立游戏 NPC
场景: 一款时长 12 小时的 RPG 需要 4,000 条非主角台词,外加玩家姓名的发音。
传统方法: 为主要角色安排工会录音,为其他人使用沉默或重复短句,本地化则被排到“以后再说”。
Jenova: 主角场景仍由真人完成。长尾内容则获得角色设定文档、适合朗读的台词和稳定提示词,让您的角色声音生成器可填充迎宾员、店主和传闻 NPC,而无需克隆名人。
- 防止铁匠听起来像巫师的角色设定表
- 已为本地化准备好的短台词
- 可像代码一样进行版本管理的提示词模块
🎬 网络条漫与漫画配音
场景: 一部每周更新的竖屏系列想制作音频剧集,却不愿等待完整演员阵容。
传统方法: 麦克风品质不一的粉丝配音,或由一位叙述者包办所有角色。
Jenova: Webtoon Creator 和 Comic Creator 保持视觉连续性,而编剧智能体则按分镜拆分角色声音。每个角色都有自己的提示词,因此生成器无需猜测。
- 按分镜计时的台词,而非大段散文倾倒
- 主角与群演各具辨识度的角色阵容
- 为语音留出空间的音乐提示
📱 听起来像真人的语言练习
场景: 您正在通勤,想要的是对话,而不是教科书式声音。
传统方法: 应用中的练习只有一位合成导师,也不会记住您的错误。
Jenova: Learn English Through Roleplay 会将您带入一段与一致角色展开的场景。之后,您可在生成器中为这些同样的台词配音以进行听力练习——仍然使用原创角色,而非模仿真人。
- 记忆功能使咖啡师不会在每次会话时重置
- 将习语置于您实际会重复使用的情境中
- 适合一段火车行程的移动端会话
🎙️ 品牌播客与社交媒体角色阵容
场景: 一个产品频道每周都需要一位主持人、一位怀疑派搭档,以及一段即兴念读的免责声明。
传统方法: 每一段都由同一位创始人发声,或依赖周四无法到场的自由职业者。
Jenova: Social Media Content Generator 会起草贴合平台的剧本;写作和提示词智能体则确保主持人与搭档不会混成一人。您将在已获许可的语音工具中渲染,而不是使用未经授权的公众人物克隆声音。
- 措辞稳定的固定栏目
- 为朗读而写、而非供快速扫读的免责声明
- 适配 Shorts、Reels 和完整剧集长度的开场钩子
常见问题
什么是角色声音生成器?
角色声音生成器是一种将文本转换为带有指定身份——年龄、音高、口音和情绪——的语音的软件,因此不同角色不会共享同一种节奏。音频模型提供音色;角色写作、舞台指示和提示词则赋予它人格。Jenova 上的工具位于写作这一侧:角色设定文档、对白和模型就绪指令,您可以粘贴到任何已获许可的语音系统中。
角色声音生成器可以免费使用吗?
许多语音应用提供有限的免费层级,并对较长音频、商业权利或克隆声音收费。Jenova 提供含核心功能的免费方案;如需更多使用量,也有付费层级。请为两类成本预留预算:创意工作,包括剧本、提示词和连续性;以及渲染器,包括音频时长和声音授权。克隆声音的同意和商业条款与订阅价格是两回事——发布前请仔细阅读两者。
如何让 AI 角色声音听起来独特?
为每个角色设定一条规则、一个词汇上限和一种身体习惯,然后写出他们无法互换的台词。每次都把这些限制写入提示词:空间、语速、情绪,以及用于避免播音腔的负面提示词。Prompt Generator 正是为这类需求说明而设计的。若在使用优质提示词后两个角色听起来仍然相同,问题在于角色设定文档,而不是滑块。
克隆真人声音是否合法?
不应将其视为默认做法,也不应把它当作玩笑预设。您需要针对实际用途获得明确、可记录的同意,并遵守您所在司法辖区适用的肖像权和版权规则。FTC 将具有欺骗性的 AI 语音克隆视为消费者保护问题,而非新奇玩具。游戏和娱乐协议日益要求书面同意和使用报告。请构建原创角色或使用获得授权的复刻声音。不要因为控制面板让操作变得简单,就抓取政治人物、演员或歌手的声音。
我可以在手机上运行这套工作流吗?
可以。Jenova 面向网页、iOS 和 Android 构建,并提供同样的核心能力;当您宁愿在通勤时口述笔记而非打字时,还可使用语音转文本。您可以在火车上起草一句台词、将其打磨、生成提示词,然后在桌面端语音工具中渲染——如果那正是您存放已获许可模型的地方。
这与普通文本转语音有什么不同?
普通 TTS 朗读文字。角色声音生成器尝试演绎一个角色。表演仍然依赖写作:身份、冲突和指导。Jenova 不会取代您已获许可的音频渲染器。它通过 Roleplay Game Master 和 Film Screenwriter 等智能体,产出渲染器所需的角色创作内容,因此您不必花钱听同一位乐于助人的实习生换上六套不同服装。
结论
角色声音生成器的质量,取决于您让它成为怎样的人。AI 语音市场正在快速增长,模型可在几秒内锁定一种音色,而监管机构已明确否定“是 AI 干的”可以作为辩解。实际可行的路径更聚焦,也更可靠:原创角色、获得同意的复刻、适合朗读的写作,以及可复现的提示词。
先设计角色,再写出呼吸,最后生成试读。先从 Jenova 开始——然后将这些台词带到您已经信任的语音工具中。
您还可以通过 Roleplay Game Master、Writing Assistant 和 Prompt Generator 探索更多同类工作流。当角色足够清晰,声音就有了归处。
面向开发者: 本文提到的每个智能体都可通过 Jenova API 以编程方式调用——只需一次集成,即可将角色设定文档、对白生成和语音模型提示词整合到您的应用中。完整文档 →