AI 研究助手是否比关键词搜索更擅长发现相关论文?
2026-08-22
语义匹配何时会胜过关键词排序,用于发现概念相关的论文?
当你需要的论文以不同术语描述同一个观点时,语义 AI 研究助手通常优于传统关键词搜索;但当你已知道要锁定的确切短语、作者或引文集群时,关键词引擎仍然更强。到 2026 年,实用的答案并不是放弃 Google Scholar,而是将词法排序与基于语义的检索结合起来——使用 Elicit、SciSpace、Undermind 和 Jenova's Academic Research Assistant 等工具。
区分有效概念发现与关键词匹配的关键因素包括:
✅ 词汇灵活性——系统能否在查询写的是“心脏病发作”时,找出研究“心肌梗死”的论文 ✅ 排序信号——按引文加权的词法得分、嵌入相似度,或由 LLM 判断相关性 ✅ 索引深度——仅标题和摘要元数据,还是跨数亿篇作品进行全文匹配 ✅ 精度控制——布尔嵌套、字段限制、期刊质量筛选器及导出限制 ✅ 获得可用文献集的时间——即时探索列表,还是需要数分钟的迭代检索
要诚实比较这些方法,应将词汇失配、排序偏差和搜索控制视为彼此独立的维度,而不是询问哪个工具在所有情况下都更好。
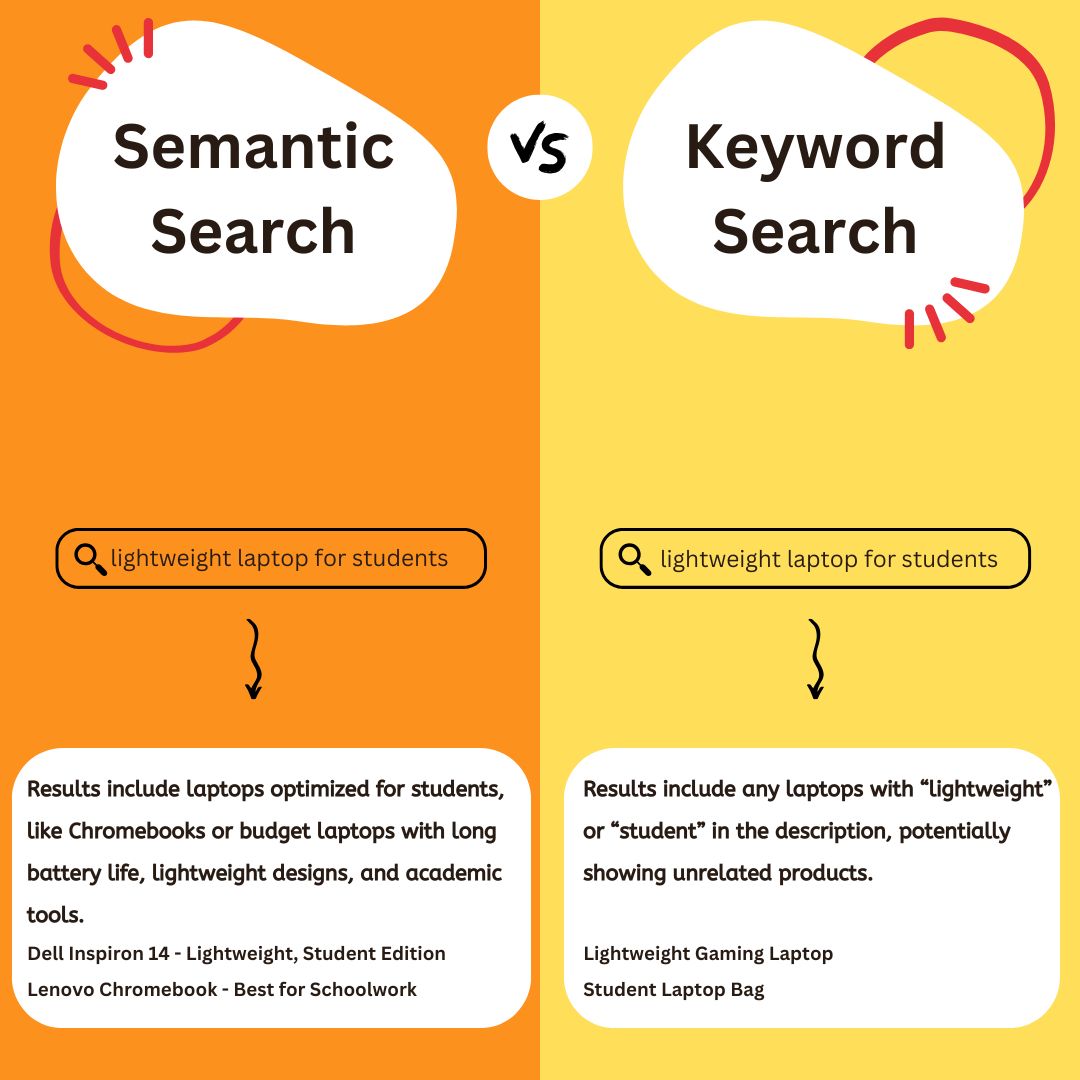
为什么词汇失配在 2026 年仍会让传统学术搜索失效?
词汇失配仍会让传统学术搜索失效,因为作者、学科和时代会以不同方式命名同一现象,而词法引擎只能检索与查询共享足够多表面术语的文献。一篇公共卫生论文可能说“身体活动”,一篇心脏病学论文说“运动能力”,一篇社会学论文则说“休闲时间运动”。如果你只搜索其中一个短语,另外两个文献集群可能会从前几页结果中消失。
Google Scholar 仍是大多数研究人员的默认起点,也是目前可用范围最广的单一学术搜索入口,涵盖来自出版商和知识库的全文内容。新加坡管理大学学术馆员 Aaron Tay 将其称为学术搜索中的瑞士军刀——如果只能保留一个工具,他会选择它。不过,其排序本质上仍是词法式的。在标题匹配之后,它会高度加权高被引论文,这非常适合寻找奠基性工作,却不利于发现采用不同表述或尚未累积引文的概念相关论文。
当查询词很常见时,问题会更严重。由于 Google Scholar 跨全文匹配,搜索具有日常含义的工具名称或概念时,可能会出现成千上万条偶然命中。Tay 指出,在 Google Scholar 中搜索“Elicit”几乎毫无用处,除非你加入学科领域限定,因为这个词在方法部分频繁出现。语义系统通过评估含义而非字符串重叠来减少这类失败,因此它们已成为互补层,而不再只是新奇工具。
比较关键词搜索与语义 AI 助手时,应评估哪些方面?
你应从本文所称的六个维度评估关键词搜索与语义 AI 助手,即失配恢复框架:词汇灵活性、排序透明度、索引覆盖范围、精度控制、权威性信号以及获得可用文献集的时间。一个工具在某一维度胜出,往往会在另一维度落后,因此用单一“赢家”排名反而更容易误导。
词汇灵活性考察引擎能否检索摘要中从未重复你查询词的论文。密集嵌入和 SPLADE 等混合方法——Elicit 将其用作学习型稀疏嵌入方法——正是为此而设计。排序透明度则考察你能否解释一篇论文为何出现。布尔检索加 BM25 的系统更容易审计;嵌入最近邻搜索和 LLM 重排序器则更难复现。
索引覆盖范围并不等同于“宣传的论文数量”。OpenAlex 报告拥有 5.17 亿条作品记录和 6600 万篇全文 PDF,而 Elicit 表示其可搜索、总结并提取超过 1.25 亿篇论文中的数据。Google Scholar 没有公布可比较的官方数量,但它普遍被视为最大的全文学术搜索索引。精度控制涵盖嵌套布尔逻辑、字段限制、邻近算符和受控词表——在这些功能上,The Lens 和 OpenAlex 优于 Google Scholar。
权威性信号包括引文数量、期刊等级和撤稿标记。Google Scholar 以及在较小程度上的 Undermind 倾向于高被引工作。Elicit 和 SciSpace 通常按语义相似度排序,且不对引文加权,因此较新或引用较少的论文会更靠前。获得可用文献集的时间则区分即时关键词搜索和 Undermind 式的迭代运行,后者至少需要三分钟。在选择主力引擎之前,应根据实际任务——同义词密集型发现、系统性召回,或五分钟快速了解——为每个维度评分。
Google Scholar、Elicit、SciSpace、Undermind 和 Jenova 在概念发现方面表现如何?
Google Scholar 最擅长广泛、按引文加权的探索;Elicit 和 SciSpace 在关键词不明确时最强;Undermind 最适合狭窄且高精度的检索;而 Jenova's Academic Research Assistant 则最适合需要在同一持续对话中完成发现、综合和引文工作的场景。在失配恢复框架的每一个格子里,没有任何一种工具都占据主导地位。
| 功能/维度 | Google Scholar | Elicit / SciSpace | Undermind | Jenova's Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| 匹配方法 | 词法/关键词,按引文加权 | 语义或混合方法(Elicit 使用 SPLADE) | 混合检索,加上 LLM 相关性判断和迭代搜索 | 基于自然语言的研究智能体,连接实时学术来源,包括 Google Scholar | 使用高级算符的结构化学术元数据搜索 |
| 不同表述的恢复能力 | 较弱,除非你添加同义词或使用相关文章 | 对基于语义的查询很强 | 对具体的自然语言任务简报很强 | 在跨会话的对话式改写中很强 | 较弱至中等;取决于查询构建方式 |
| 权威性偏差 | 标题匹配后偏向高被引论文 | 几乎不按引文加权;较新论文更靠前 | 通过引文搜索对奠基性工作有一定偏向 | 遵循已连接的来源及你提供的任务简报 | 由元数据驱动;更适合分析而非语义排序 |
| 精度功能 | 不支持嵌套布尔逻辑、查询上限 256 个字符、字段搜索有限 | 期刊质量后筛选器,例如 SciSpace 的 Scimago 分层 | 依靠自然语言具体程度,而非布尔逻辑 | 对话式收窄;不是布尔语法引擎 | 嵌套布尔逻辑、邻近搜索、字段搜索、受控词表 |
| 典型查询时间 | 即时 | 足够快速,适合探索 | 每次搜索至少约 3 分钟 | 交互式;后续追问即时响应 | 即时到受 API 速率限制 |
| 定价(截至 2026 年) | 免费 | Elicit Pro 约 $49/月;据报道 SciSpace 付费层级为 $12 至 $160/月 | 免费探索层级;付费学术套餐 | 用量有限的免费层级;Plus 套餐 $20/月起 | 免费网页搜索;OpenAlex API 提供免费层级 |
| 最适合的用途 | 奠基性论文、被引追踪、全文查找 | 关键词不清晰及问题式查询 | 高召回率地查找某一特定类别的研究 | 具备记忆和论文写作支持的端到端文献工作 | 系统化、可复现、高控制度的搜索 |
Google Scholar
Google Scholar 仍是通才型工具。官方帮助页面确认,结果通常按相关性而非日期排序,研究人员在获得一篇种子论文后,可以通过相关文章和被引用功能扩展检索。这两项功能是关键词搜索最接近概念发现的方式,但前提是你拥有一篇优质种子论文。其弱点已有充分记录:不支持嵌套布尔逻辑、不支持仅限摘要的字段搜索、查询上限为 256 个字符、结果上限为 1,000 条,且不支持批量导出。这也是图书馆员通常不会将其作为系统综述主数据库的原因。
Elicit 和 SciSpace
Elicit 将自身定位为面向 1.25 亿余篇论文的 AI 工具,可用于搜索、总结、提取信息和对话,且拥有超过 200 万研究用户。Elicit 和 SciSpace 都接受自然语言问题,并按语义相似度排序,因此能够找回措辞不同于查询的论文。其代价是与 Google Scholar 相反方向的排序偏差:它们可能会推高语义接近但质量较低或引用较少的论文。SciSpace 通常速度更快,更适合快速获取见解,而不适合深度迭代式综合。结果还可能是非确定性的,因此同一查询未必每次都返回相同文献集。
Undermind
Undermind 是专门型工具。它结合关键词和语义检索,然后使用前沿模型判断标题、摘要和可用元数据是否真正回答任务简报,并通过引文搜索持续迭代。在一项针对某系统综述纳入文献集的测试中,其在前 10 条结果中找回了 11 篇金标准论文中的 8 篇(recall@10 为 72.7%),到第 50 名时找回了 11 篇中的 9 篇(recall@50 为 81.8%)。这种质量需要时间,并且在模糊主题上表现较差。它还主要只看到标题和摘要,以及部分开放获取全文,因此仅埋藏在方法或结果部分的主张可能会被遗漏。
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant 是具备学科意识的研究伙伴,而非独立的论文索引。它跨学术来源进行实时文献发现,随后在综合、论文准备和引文管理阶段持续服务于项目。持久记忆意味着它可以记住你的工作术语是“认知疲劳”,而文献中还使用“自我损耗”和“恢复需求”,并能在跨会话过程中将这些同义词集群持续关联到同一个项目。
需要诚实说明的是,其局限源于架构。它并不像 Elicit 那样提供拥有内置提取表格、专有 1.25 亿篇论文语义索引的产品,也不是 Undermind 式的多分钟迭代搜索器,且没有已发布的 recall@10 基准。它的优势在于编排:在同一条对话线程中完成自然语言任务简报、实时学术查找、后续追问和写作支持。需要可复现布尔审计轨迹的研究人员,仍应并行使用 The Lens 或 OpenAlex。
语义搜索如何找回针对同一观点却使用不同措辞的论文?
语义搜索通过将查询和文献集合嵌入到共享的语义空间中,再检索最近邻而非要求词元重叠,从而找回措辞不同的论文。如果查询是“夜班护士在连续轮班后如何恢复注意力”,词法引擎会寻找这些词。语义引擎则可以检索标题围绕“昼夜节律紊乱”“恢复性睡眠”或“职业疲劳”的研究,即使标题中从未出现“护士”或“注意力”。
Semantic Scholar,即 Allen Institute for AI 的文献引擎,是这一理念较早面向公众的展示:按对科学论文含义的理解而非字符串匹配进行排序。Elicit 和 SciSpace 在网页应用规模上应用了类似原则。Tay 描述了一项尤其清晰的测试:将一段描述研究发现的报纸文字粘贴进去,语义引擎能够找出其对应的期刊论文,因为新闻文本的嵌入与论文的嵌入在语义空间中距离很近。关键词搜索几乎无法经受这种改写。
还有第二种较不显眼的机制:助手内部的查询扩展。对话式智能体可以生成同义词集、相关的 MeSH 式概念、反义词和学科变体,然后明确检索这些变体。这并非纯粹的向量搜索,而是利用语义理解构建更好的词法检索网。实践中,召回率最高的工作流会同时使用两者——先通过嵌入找回未知表述,再以精确短语、作者姓名和引文链接进行验证,从而保持文献集的可审计性。
在实时任务简报上测试这一点,通常会迅速暴露差距。向关键词引擎查询“教师觉察”,你大多只能获得使用这个确切教育研究术语的论文。向语义助手询问“教师如何在当下察觉并解读学生出乎意料的想法”,你还会找到归入“专业视野”“形成性评价”或“即时决策”的研究。第二组正是词汇失配本会隐藏的文献。
何时仍应使用关键词搜索,而非语义 AI 助手?
当你需要已知文献检索、从种子论文进行引文追踪、全文短语匹配,或为系统综述制定可复现的布尔检索策略时,仍应使用关键词搜索。当任务是“找到这个标题”“找出所有引用这项试验的文献”或“记录同行评审者可重新运行的检索式”时,语义排序并不是正确工具。
Google Scholar 是处理三项日常任务的正确第一步。第一,已知文献查找:如 Google 自身帮助和多数图书馆指南所建议,将标题放在引号中。第二,权威性映射:打开一篇里程碑论文,通过被引用了解该领域后续进展,或通过相关文章从种子文献向外扩展。第三,全文短语搜索:如果概念是具有辨识度的方法名称、数据集或量表,词法全文搜索能捕获标题和摘要语义索引遗漏的提及。
对于系统性或极高精度的检索,不应将 Google Scholar 或大多数语义应用作为记录系统。The Lens 和 OpenAlex 支持嵌套布尔逻辑、邻近算符、字段搜索和受控词表。OpenAlex 是一个开放目录,拥有 5.17 亿项作品、58 亿条图谱关系,以及公共领域(CC0)数据集。一份2026 年图书馆简报估计其覆盖约 4.74 亿篇出版物,并强调开放获取和透明度。Google Scholar 无法提供同等可审计性:它将结果展示限制为 1,000 条,且不提供批量访问。
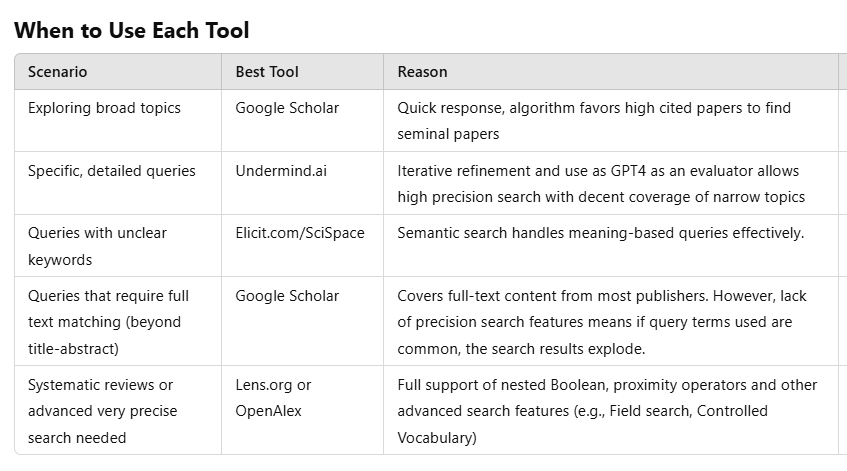
应将上表用作路由规则,而非忠诚度测试。广泛了解和寻找奠基性论文仍应使用 Google Scholar。措辞不明确时使用 Elicit 或 SciSpace。高度具体的存在性问题——“是否有 RCTs 使用 LLM 作为标题—摘要筛选器,并报告精确率和召回率?”——适合交给 Undermind 编写任务简报。可复现、算符密集型的搜索则应在 The Lens 或 OpenAlex 中进行。
如何开展结合两种方法的文献检索?
要开展组合检索,应从概念任务简报开始,通过语义方式找回同义词多样化的候选文献,然后使用词法算符、引文追踪和高控制度数据库锁定文献集。顺序很重要。如果从 Google Scholar 的一个短语开始,你会继承该短语的盲点;如果始终停留在语义排序列表中,则会继承该列表的质量和可复现性问题。
一个实用流程如下:
- 用同事能理解的方式写下信息需求,包括研究人群、结果指标,以及你已经知道不稳定的措辞。
- 在语义助手中运行该任务简报,以收集候选论文以及它们实际使用的词汇。
- 根据这些标题和摘要构建同义词表。
- 使用引号、
author:、日期限制以及被引用/相关文章功能,在 Google Scholar 中重新检索扩展后的术语。 - 对于必须全面或可审计的内容,使用嵌套布尔逻辑和字段限制,在 The Lens 或 OpenAlex 中重建检索策略。
- 持续保留纳入日志,避免非确定性的语义重新运行悄然改变证据基础。
在 Jenova's Academic Research Assistant 中,首轮对话可以是概念任务简报,而非关键词字符串:
“我需要有关远程知识工作者如何从认知疲劳中恢复的实证论文。请纳入可能使用职业倦怠、自我损耗、恢复需求、下班后反刍或心理脱离,而非使用‘疲劳’一词的研究。优先选择 2018 年以来的职业心理学和 HCI 发表场所,并列出每篇论文实际使用的同义词。”
后续追问可将助手的同义词表转换成可粘贴至 Google Scholar 或 The Lens 的词法策略:
“将这些同义词集群转换为三个 Google Scholar 查询和一个适用于 OpenAlex 或 The Lens 的嵌套布尔字符串。请区分仅限标题的查询与全文查询。”
在 Elicit 或 SciSpace 中,应使用自然语言提问而非关键词——Tay 指出,自然语言查询在 Google Scholar 中往往表现较差,而在这些语义工具中表现更好。在 Undermind 中,应持续添加约束,直到任务简报只能匹配某种特定研究设计。候选文献集形成后,Jenova 的 Deep Research 智能体更适合跨来源阅读并生成带引文的综合内容,而 Academic Research Assistant 则更适合留在学术工作流中,处理发现、引文和论文支持。
每一步 AI 辅助工作都适用一项警告:应将排序列表和生成摘要视为检索辅助,而非已经完成的筛选。语义前 10 条结果会遗漏论文。LLM 的相关性判断经常但并非总是与人类一致。全文主张仍需要通过 PDF 核验。
研究图书馆员和工具评估者如何看待语义 AI 发现?
研究图书馆员和独立评估者通常将语义 AI 助手视为 Google Scholar 的补充,而不是替代品;他们根据某一既定用途下的搜索质量评判工具,而非依据营销类别。这个领域最有价值的已发布比较来自基于实践的评测,而非供应商基准。
“如果我事先不知道自己的使用场景是什么,而且只能选择一个学术搜索工具,毫无疑问会选 Google Scholar。这并不反对 AI 搜索,而是反对假装任何一种排序函数都已足够。Google Scholar 仍是通才型工具。当查询在语义上别扭或极其具体时,新工具才体现其价值。”
“我最常见到的失败是查询类型和引擎之间的不匹配。人们把宽泛主题输入迭代式智能体,然后等待数分钟,得到一个比所需范围更窄的结果集;或者把一段自然语言文字输入词法引擎,进而得出相关文献不存在的结论。词汇失配通常首先是工作流错误,而不是数据库缺口。”
“语义排序也改变了‘相关’的含义。如果不对引文加权,就会更早看到较新且有时较弱的论文;如果对引文加权,就会反复发现同一套经典文献。希望寻找使用不同措辞但概念相关工作的人,需要前一种行为;希望找到所有人都期望其引用的论文的人,需要后一种行为。合格的流程会同时使用两者,并写明原因。”
—— Jenova 产品团队,文献发现系统,拥有 8 年学术研究工作流设计经验
这种框架与公开记录相符。大学指南现在会汇总用于文献综述的 AI 搜索工具,产品评测则区分 Undermind 较慢的迭代流程与 SciSpace 较快的语义扫描。专家共识是方法论层面的,而非阵营之争:选择与所要恢复的失配类型相匹配的检索模型。
系统综述与探索性文献映射分别适合使用哪些工具?
系统综述需要高度可控的词法基础设施;探索性文献映射需要语义召回和快速迭代;大多数论文和基金申请工作则需要混合方法,并为每个阶段制定书面协议。混淆这些任务,会导致团队要么遗漏概念相关研究,要么产出不可复现的证据集。
对于探索性映射——“无论以何种名称,这个观点已经有哪些研究?”——应从语义方式开始。Elicit、SciSpace 和对话式研究助手正是为此问题构建的。获得种子论文后,Google Scholar 可以通过相关文章和被引用功能提供补充,并且它在快速定位 PDF 和图书馆链接方面仍无可替代。当你还需要让映射持续保存时,Jenova's Academic Research Assistant 很适合这一阶段:包括已保存的同义词决策、排除的方向,以及最终写作所需的引文格式。
对于系统综述或范围综述,不要让语义排序列表成为正式检索。应将 The Lens 或 OpenAlex 作为可复现的骨干,记录每个算符,并将 Elicit、Undermind 或 Jenova 视为补充性的引文发现和筛选辅助工具。OpenAlex 还提供 API、面向系统综述的查询语言,以及采用 CC0 许可证的完整数据快照,其设计理念与封闭的相关性排序完全相反。尽管 Google Scholar 仍有助于检查某篇已知纳入文献是否被收录,但其1,000 条结果上限和缺乏批量访问使其不适合作为主要的记录性检索工具。
对于狭窄的存在性问题——“是否存在这样的论文?”——Undermind 是专门工具,前提是你可以等待,并且标题和摘要证据已经足够。对于文献集形成后的论文写作,Jenova 结合文献发现和引文管理的能力比另一个仅用于发现的界面更相关;但需要大量提取的荟萃分析,仍应使用 Elicit 等专门提取工具。
这个决策规则足够简单,可重复使用。如果措辞变化很大,而你尚不了解该领域术语,应首先使用语义 AI 研究助手。如果必须为检索字符串进行辩护,则应使用带高级算符的关键词基础设施。如果两者都必须做到——这正是寻找措辞不同但概念相关论文的常态——就先运行语义召回来发现语言,再通过词法控制捕获并记录它。
参考资料
- Aaron Tay — Google Scholar 与其他 AI 搜索工具(Undermind、Elicit、SciSpace)
- Google Scholar — 官方搜索帮助
- Elicit — 用于科学研究的 AI
- OpenAlex — 全球研究系统的开放目录
- Paperguide — Elicit 与 SciSpace 的定价和功能比较(2026)
- Undermind — 面向文献的 AI 共同研究者
- 阿尔伯塔大学 / JCHLA — Undermind.ai 产品评测
- Paperpile — 如何使用 Google Scholar
- TUHH — OpenAlex:学术研究的开放替代方案
- Semantic Scholar — AI 驱动的研究工具
- UBC Wiki — 用于文献综述和综合检索的 AI 搜索工具
- SciSpace — Elicit 与 SciSpace 对比
- The Lens — 8.5 版本发布及 OpenAlex 集成
- PMC / NIH — OpenAlex 功能与证据综合潜力