AI 智能体后端:一个 API 还是从零构建(2026 年 7 月)
2026-07-24
2026 年,每支交付 AI 功能的工程团队都会走到同一个岔路口:从零构建智能体后端,还是集成一个现成方案。自建意味着要将模型 API、编排框架、向量数据库、记忆存储和工具服务器拼接起来——在第一次用户交互之前,就会耗费数个季度的工程时间。Jenova Agent API 则提供了另一种选择:这是一个完全托管的智能体后端,编排、记忆、存储、RAG 和工具都通过一次集成在后台运行。
- ✅ 用一个 API 替代整套 DIY 智能体技术栈——模型路由、编排、记忆、RAG 和工具
- ✅ 根据你的指令、模型、知识库和工具,构建并发布定制化、生产级智能体
- ✅ 通过一组凭证访问 OpenAI、Anthropic、Google、xAI、Qwen 等提供商的模型
- ✅ 运行于已在 70 多个国家、30,000 多名用户中经过生产验证的基础设施上
要诚实地作出自建还是集成的决策,你需要了解真实数字——在 2026 年,从零构建、运行和维护一个智能体后端实际需要多少成本。
快速回答:什么是 AI 智能体后端?
AI 智能体后端是让智能体能够在生产环境中运行的基础设施层:它负责跨模型与工具的编排、持久记忆与上下文、私有数据检索,以及底层的计算、扩缩容和可靠性系统。 从零构建意味着你要拥有五个或更多彼此独立的系统;托管式智能体 API 则通过一次集成提供所有这些能力。
托管式智能体后端的核心能力:
- 在多步骤工作流中协调模型、工具、记忆和检索的智能体编排
- 跨提供商的多模型路由——没有供应商锁定,也无需管理各提供商的密钥
- 每个会话内置无限对话记忆和上下文
- 内置 RAG 的完全托管关系型与向量存储
- 通过平台原生工具及任意远程 MCP 服务器集成工具
问题:从零构建的真实成本
市场上推出智能体的压力极大。预计企业软件中的智能体 AI 占比将达到 33%——高于 2024 年不足 1% 的水平(Datagrid);67% 的 C 级高管预计,到 2027 年 AI 智能体将在其组织内部独立运行(VAST Data)。
但构建支撑一个智能体的后端既昂贵又缓慢:
- 会演变为第二门工程学科的编排逻辑
- 调用之间没有记忆的无状态模型 API
- 具有已知且反复出现故障模式的 RAG 管道
- 为每项外部能力构建的工具集成连接层
- 必须能够扩展、保持可靠并通过安全审查的生产基础设施
- 远超所有原型预估的第一年总成本
真实预算:模型调用仅占整体成本的 2%
“每月 $100 的智能体”演示掩盖了实际成本结构。一项详细的工程成本分析显示,一个中小型生产智能体在第一年的现实成本为 **$270,000–$690,000**,其中模型 API 调用约仅占总成本的 2%(Particle41)。
其余成本都流向了演示视频从不展示的地方:
$30,000–$80,000 ——仅初始提示工程与迭代优化,按 200–400 个工程小时、每小时 $150–200 计算(Particle41)
$1,000–$5,000/月 ——向量数据库托管费用,另加 $1,000–$2,000/月 的嵌入生成费用(Particle41)
$30,000–$60,000 ——仅将智能体连接至 4–5 个现有系统的数据集成工程成本(Particle41)
每位 FTE $6,000–$10,000/月 ——用于故障审查的人工监督成本;即便准确率达到 95% 的智能体每月处理 10,000 次交互,仍会产生 500 个需要人工审查的案例(Particle41)
而且成本不会在发布后结束:第二年的运营和优化年成本仍为 $150,000–$300,000(Particle41)。即使是范围更窄、仅计算开发的估算,简单任务智能体也需 $20,000–$60,000(Biz4Group),多智能体系统则为 $10,000–$400,000+(Azilen)。
编排会成为一个独立产品
生产级智能体不会只回答一次——它会在多步骤执行中规划、调用工具、检索上下文、评估中间结果,并从错误中恢复。构建这种协调循环需要状态机、重试逻辑、超时处理和成本护栏,而这些与实际产品功能毫无直接关系。
从业者直言不讳地描述了这个差距:构建一个智能体只需几天,但将其推向生产需要六个月;未加保护的循环会导致 API 账单激增,丢失状态则会使长时间运行的任务失败(
)。LangGraph 和 CrewAI 等框架为这一层提供了抽象(Speakeasy),但抽象不会自行运行:你仍然需要托管、扩展、保护和维护底层的一切。RAG 管道是一项长期义务,而不是一个项目
让智能体基于你的私有数据工作,意味着你需要承担数据摄取、分块、嵌入、索引、重排序和答案生成——而从业者持续警告说,RAG 管道“不仅比看上去更难,也需要持续具备 LLMs、检索和专业 MLOps 方面的专业能力”(Vectara)。
一个有记录的案例研究显示:一个“简单”的内部 RAG 项目从 1 月启动,到 3 月时已投入一名全职工程师调试幻觉问题、一名全职数据工程师解决数据摄取问题,以及一名 DevOps 工程师处理基础设施问题——预算也增长到了原来的三倍(Towards AI)。同一案例还记录了典型的八周生命周期:延迟问题、边缘案例、一次彻底重写、新的幻觉问题、一次向量 DB 迁移,以及又一次重写。
传统基础设施并非为智能体而建
智能体工作负载需要持续、实时地访问数据——而为事务型工作负载设计的传统数据基础设施“无法支持自主 AI 智能体所需的持续推理与行动能力”(VAST Data)。企业级智能体基础设施需要统一的数据基础、高性能存储、实时向量化、智能编排和零信任治理——在你编写产品逻辑之前,就已经有五个不同的能力层。
40% ——因基础设施基础不足而失败的智能体 AI 项目比例(Landbase)
这正是 Jenova Agent API 要消除的问题。
解决方案:Jenova Agent API
Jenova Agent API 是一项完全托管的智能体基础设施服务:通过一次集成,替代由模型 API、编排框架、向量数据库、记忆存储和工具服务器构成的 DIY 技术栈。你只需定义智能体的指令、选择模型、上传知识库并配置工具——API 会处理编排、记忆、存储和扩缩容,让你在数天而非数个季度内发布生产级定制智能体。
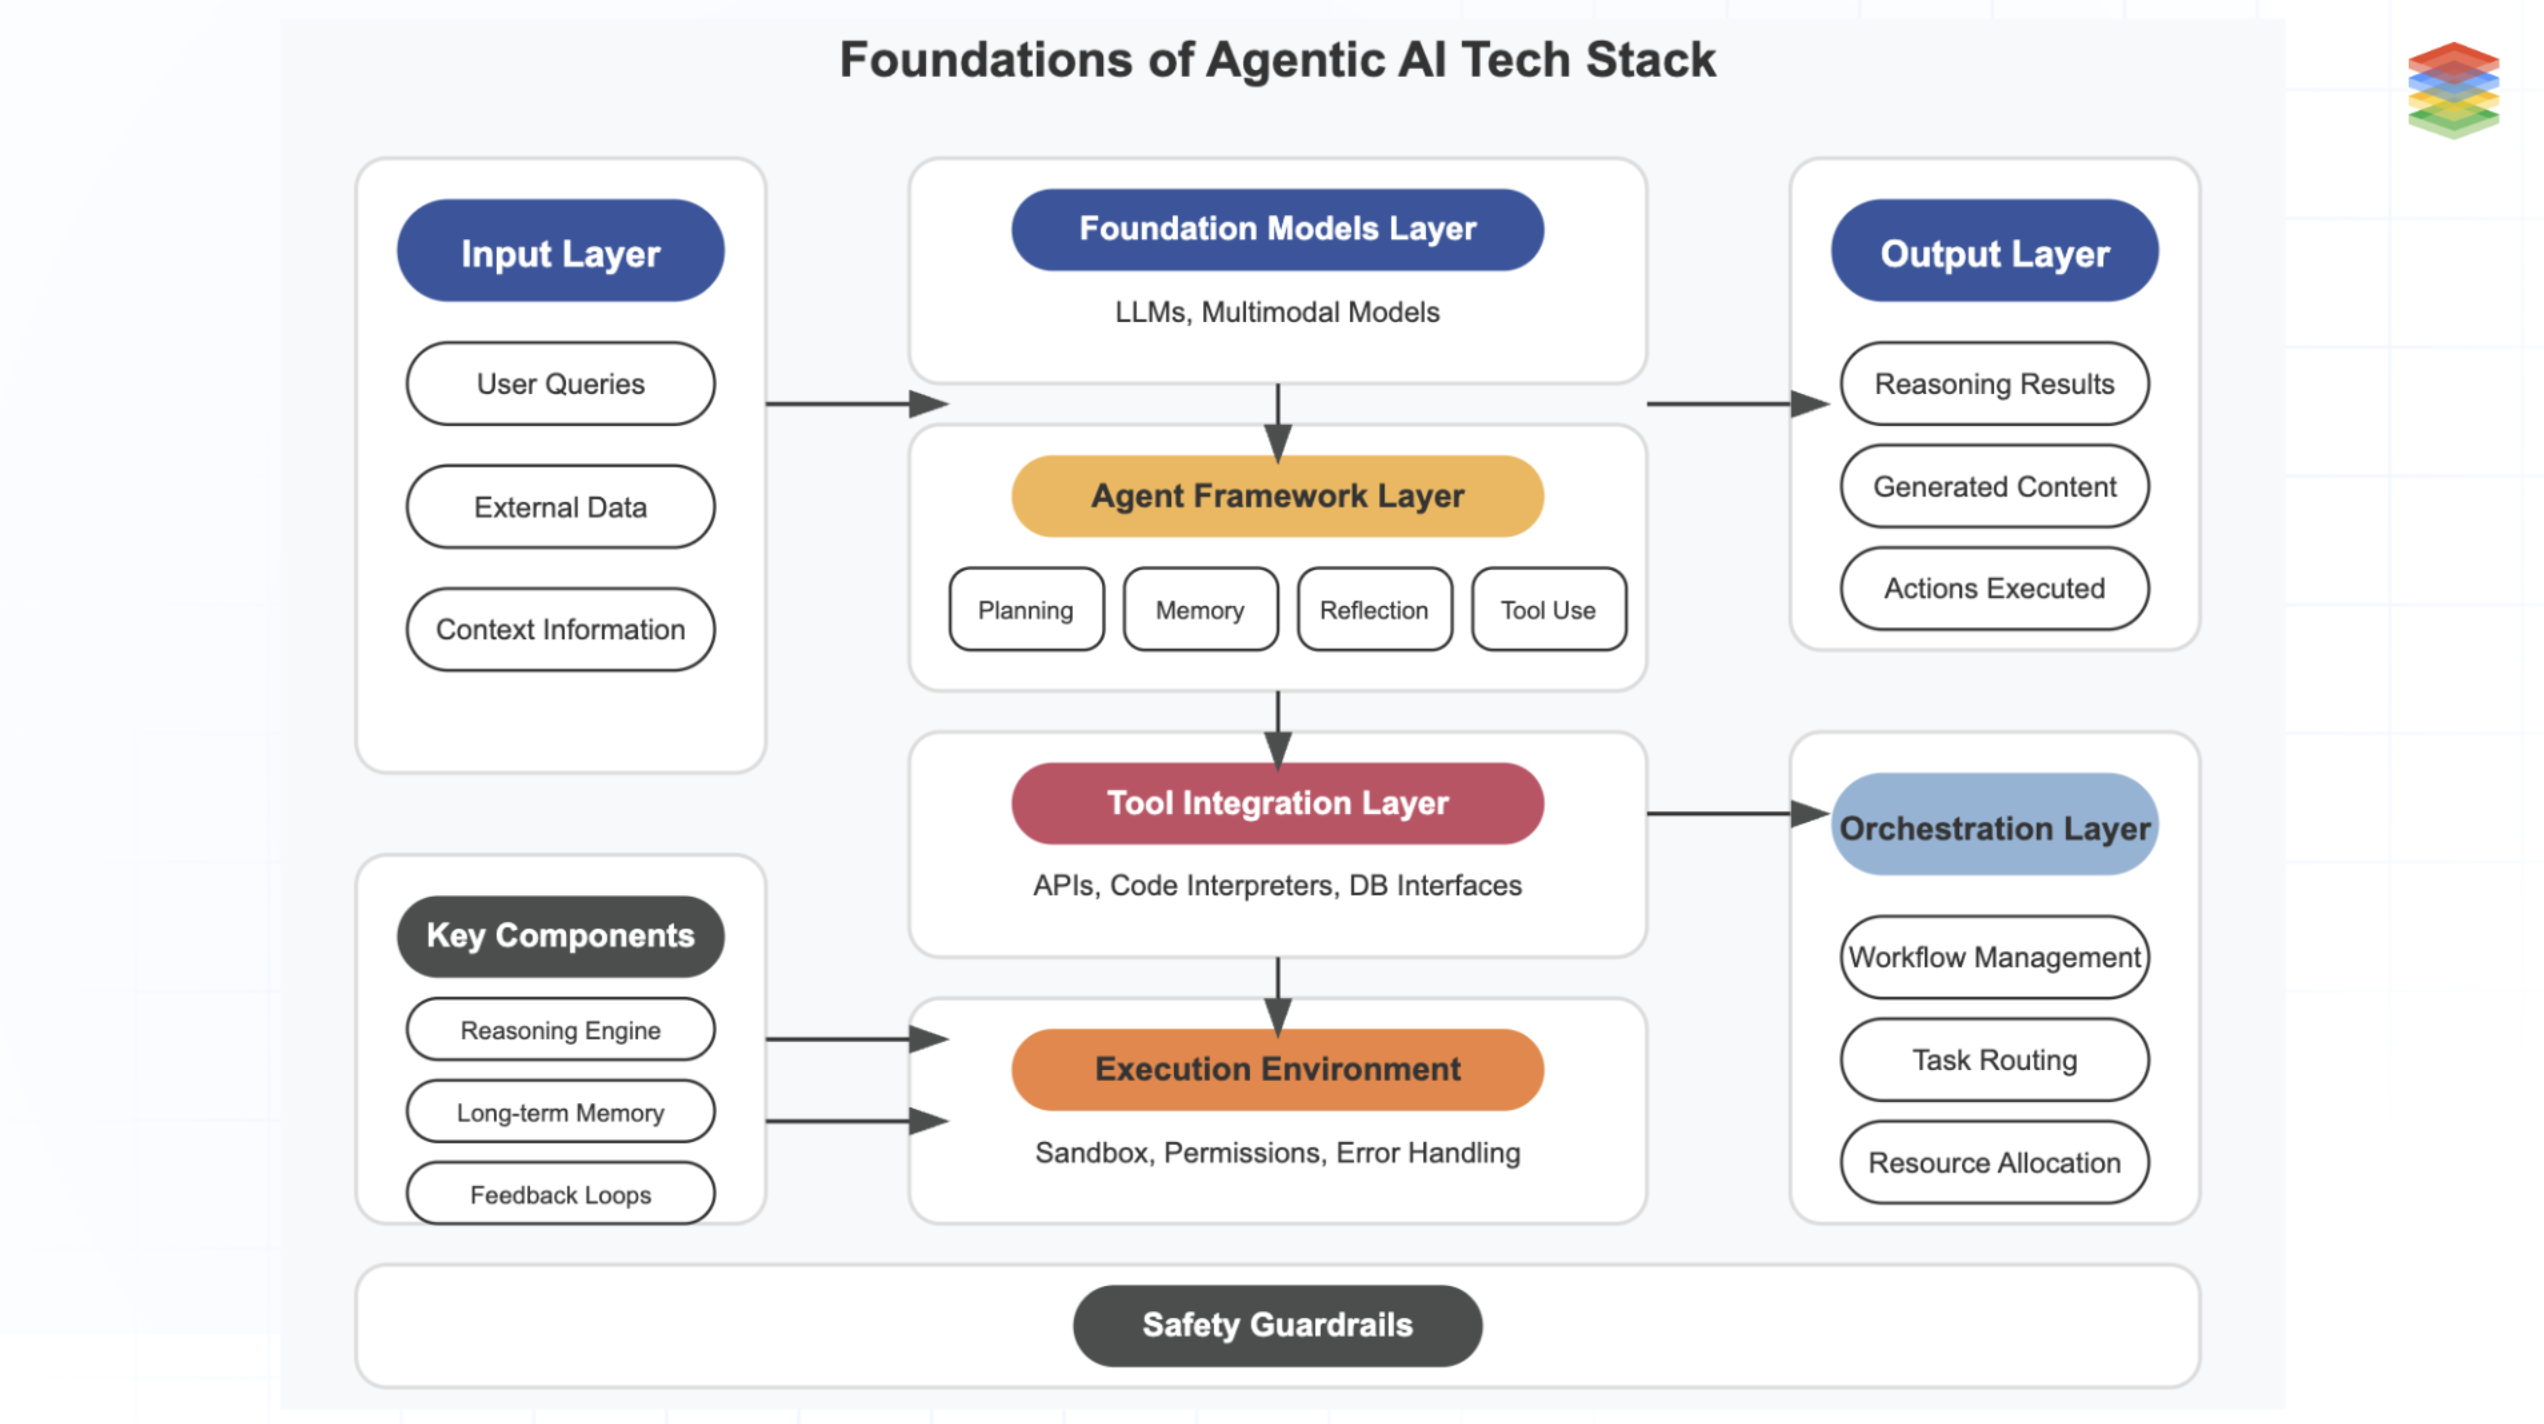
上图中的每一层——智能体框架的规划、记忆、反思和工具使用;工具集成层的 APIs 与数据库接口;执行环境的沙箱隔离和错误处理;编排层的工作流管理与任务路由——都是 DIY 路线要求你自行构建的基础设施。Jenova Agent API 负责运行全部这些层。
| DIY 智能体后端 | Jenova Agent API |
|---|---|
| 自定义编排图、重试逻辑和状态模式 | 经过实战验证的编排,协调模型、工具、记忆和检索 |
| 每个模型提供商各自独立的 SDK、密钥和速率限制 | 通过一次集成使用任意主流模型——没有供应商锁定 |
| Redis/Postgres 中的会话状态,加上自定义序列化 | 每个会话内置无限记忆和上下文 |
| 预置向量数据库、分块与嵌入管道($1,000–$5,000/月) | 内置 RAG 的完全托管关系型与向量存储 |
| 手写工具封装、认证流程和错误处理样板代码 | 平台原生工具加任意远程 MCP 服务器,开箱即用 |
| 服务器、容器、扩缩容策略和正常运行时间监控 | 具有稳定 APIs 的生产级托管基础设施 |
智能体编排
多步骤推理、工具调用、检索和响应生成均在平台内部运行——无需构建和维护图定义、状态模式或工作流 DAG。你定义智能体应完成的任务目标;基础设施决定执行方式,并提供生产可靠性所需的有边界、可控执行。
使用任意模型
通过一组凭证,使用来自 OpenAI、Anthropic、Google、xAI、Qwen 等提供商的模型驱动智能体。你可以为复杂推理运行前沿模型,为高频会话运行高性价比模型——可按智能体自由切换,无需管理各提供商的密钥;新一代模型发布时也无需进行迁移工作。你的记忆和知识层会在每次切换中保留。
记忆与上下文
每个会话都内置无限对话记忆和上下文。传入一致的会话标识符后,智能体会记住每位用户的历史、偏好和长期项目——无需外部状态存储、无需序列化代码,也无需进行上下文窗口工程。DIY 技术栈中最容易出错的一层,对你而言根本无需存在。
完全托管的存储
提供内置 RAG 的托管关系型与向量数据库。上传文档和知识库后,平台会处理分块、嵌入、索引和检索。无需预置、调优或扩展向量数据库——每月 $1,000–$5,000 的预算项,以及维护它的工程师,都会消失。
工具与 MCP
通过平台原生工具及任意远程 MCP 服务器,开箱即可获得无限工具集成——搜索、电子邮件、日历、文档以及你自己的内部 APIs。无需封装代码、无需认证流程连接层,也无需在第三方 APIs 变化时维护样板代码。
生产级能力
完全托管、具有稳定 APIs 的基础设施专为生产流量构建——你无需负责服务器、容器或扩缩容策略。该平台已在 70 多个国家、超过 30,000 名用户中经过生产验证,因此你的智能体能够继承团队无需自行构建的可靠性。
一次调用即可执行完整智能体:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
编排、记忆、检索和工具调用都会在该请求中执行。你的应用负责渲染响应;平台负责其背后的一切。
你可以构建什么
该 API 面向在自身产品中交付定制化、有状态智能体功能的开发者。以下每一种都是你可以构建并发布的应用——定义智能体的指令和知识库,API 将处理编排、记忆和扩缩容。
基于你的产品知识训练的支持智能体
构建一个基于帮助中心、更新日志和工单历史的支持智能体。会话记忆会跟踪每位客户跨交互的完整支持历程——不再出现“请再重复一次您的账号”这种情况。
- 文档索引与检索实现端到端托管
- 通过 MCP 连接工单和 CRM 系统
- 无需花费一个季度处理状态管理,数天即可发布
嵌入式金融分析师
在你的金融科技仪表板内推出投资组合顾问,它可在数月的对话中记住每位客户的持仓、风险偏好和目标。
- 自动维护长期顾问上下文
- 通过 MCP 连接市场数据和账户系统
- 按查询复杂度切换模型,实现成本优化
面向学习平台的个性化导师
部署一个基于课程内容的自适应导师,在多个会话中跟踪每位学生的进度、薄弱领域和偏好。
- 每位学生都有记忆,无需管理按用户划分的数据库行
- 课程更新只需上传即可部署,无需重新设计检索系统
- 在托管基础设施上扩展至数千名并发学习者
了解你的商品目录的电商助手
嵌入一个对话式购物助手,它了解你的商品目录,记住每位消费者的偏好和购买历史,并通过对话而非筛选器引导用户发现商品。
- 通过托管 RAG 让商品目录具备上下文——更新可即时部署
- 无需外部状态存储即可保存每位消费者的偏好记忆
- 为流量高峰提供生产级并发能力
面向自有团队的内部运营智能体
构建一个连接内部文档、工单和数据系统的运营智能体——它能够在完整组织上下文下回答员工问题并执行日常工作流。
- 自动索引私有知识库
- 通过远程 MCP 服务器连接内部 APIs
- 以配置而非代码方式部署新能力
获取你的 API 密钥,数分钟内发布第一个智能体。
工作原理:四步从 API 密钥到生产级智能体
第 1 步:获取 API 密钥
创建账户,并从平台控制台生成 API 密钥。一组凭证覆盖每个模型提供商和你构建的每个智能体——无需在开发、预发布和生产环境中分别管理各供应商密钥。
第 2 步:构建或选择智能体
使用自己的指令、首选模型、知识库和工具配置定义定制智能体——或者从预构建智能体开始调整。创建智能体是配置,不是代码:你描述所需行为,平台则提供背后的编排、记忆和检索。
第 3 步:添加额度
为账户充值额度。每次调用都会从余额中扣除使用额度——没有单独的基础设施账单、向量数据库账单或隐藏在后台的记忆存储成本。
第 4 步:发起调用
从你的后端转发用户消息,同时传入智能体 ID 和会话标识符。重复使用同一会话 ID,智能体就会从上次与该用户停止的位置准确继续:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
无需配置记忆存储,无需维护检索管道,也无需调试编排图。完整的端点规范、请求与响应模式以及集成详情请参阅 API 文档。
成果与使用场景
💼 SaaS 初创公司:一个开发迭代,而非 $270K–$690K
场景: 一家拥有 3,000 名客户的 B2B SaaS 公司,希望构建一个应用内支持智能体,让它了解公司文档并记住每个账户的历史——团队只有三名工程师。
传统方案: DIY 路线第一年的成本为 $270,000–$690,000(Particle41):选择编排框架、预置向量数据库、在 Redis 或 Postgres 中实现按租户划分的记忆、为工单系统编写工具封装,然后再处理托管、扩缩容和监控——而这些都发生在面向第一位客户的回答之前。
Jenova Agent API: 定义支持指令和升级规则,上传帮助中心,并通过 MCP 连接工单系统。持久会话记忆从第一天起就为每个账户提供连续的支持历史。
- ✅ 数天即可投入生产,而不是数月
- ✅ 将六位数基础设施预算重新投入产品工程
- ✅ 无需预置或维护记忆系统和向量数据库
📊 金融科技:无需后端团队即可提供顾问功能
场景: 一家金融科技公司希望将 AI 投资组合分析师作为高级仪表板功能。它的两名后端工程师从未构建过智能体基础设施。
传统方案: 学习编排框架、构建有状态的顾问工作流、为持续的客户关系实现记忆持久化、为金融文档预置 RAG——这正是从业者所描述的原型与上线之间四到六个月的生产差距(
)。Jenova Agent API: 使用领域指令配置金融分析师智能体,通过 MCP 连接市场数据,并让内置记忆在每次顾问对话中维持投资组合上下文。
- ✅ 无需学习、托管或维护框架
- ✅ 开箱即用的长期客户记忆
- ✅ 无需任何代码改动即可切换模型以优化成本
📱 移动教育科技:为 30,000 名并发学生提供辅导
场景: 一款服务 30,000 名学生的移动教育应用需要覆盖四个学科的个性化导师,每位导师都需要了解课程内容并跟踪每位学生的进度。
传统方案: 按学科配置智能体、在外部数据库中按学生持久化记忆、为课程内容提供向量存储——同时还要让基础设施承载数万个并发有状态会话而不丢失上下文。这正是传统基础设施无法胜任的工作负载(VAST Data)。
Jenova Agent API: 为每个学科创建一个导师智能体,并配置针对课程的指令和材料。会话记忆会自动持久化每位学生的进度;上传课程内容时,RAG 会自动完成索引。
- ✅ 无需外部状态存储即可获得持久化、个性化的学习上下文
- ✅ 课程更新无需重新设计检索系统即可部署
- ✅ 从第一天起具备生产级并发能力
🎯 产品代理商:四个客户,一次集成
场景: 一家开发代理商正在为四位客户构建 AI 功能——医疗接诊、法律文档审查、电商商品发现和企业搜索。DIY 路线意味着要为每位客户重复搭建记忆存储、RAG 管道和托管环境。
传统方案: 四套独立的智能体技术栈——四条检索管道、四套扩缩容配置、四项维护义务。考虑到 40% 的智能体项目会因基础设施不足而失败(Landbase),将风险最高的一层复制四次,是一场投资组合层面的赌博。
Jenova Agent API: 四位客户共用一次集成和一组 API 密钥。每项合作均可配置定制智能体——领域指令、模型、知识库和工具——全部运行在同一个托管后端上。
- ✅ 单次集成可扩展至无限客户项目
- ✅ 按客户选择模型,无需按客户管理提供商
- ✅ 将工程时间投入产品逻辑,而非重复建设基础设施
常见问题
从零构建 AI 智能体后端需要多少钱?
工程分析显示,若计入基础设施、提示工程、测试、数据集成、向量数据库和人工监督,一个生产级智能体第一年的现实成本为 $270,000–$690,000——其中模型 API 调用约仅占总成本的 2%(Particle41)。此后,每年的持续运营成本为 $150,000–$300,000。
Jenova Agent API 的定价和额度如何运作?
采用基于额度的使用方式:你向账户添加额度,每次 API 调用都会从余额中扣除。没有单独的基础设施、数据库或记忆存储成本——托管技术栈已包含在使用费用中,将原本可能来自五六家供应商的账单整合为一份。当前费率请参阅平台页面。
我可以通过 API 使用哪些模型?
智能体可通过一次集成,由来自 OpenAI、Anthropic、Google、xAI、Qwen 等提供商的模型驱动。你可以为每个智能体选择模型并自由切换——没有供应商锁定,新一代模型发布时也无需迁移工作。记忆和知识会跨模型变更持续保留。
与使用 LangChain 或原始模型 API 自建相比,集成难度如何?
集成遵循四步流程:获取 API 密钥、构建或选择智能体、添加额度,然后发起第一次调用。一个 POST 请求即可执行完整智能体——包括编排、记忆、RAG 和工具。原始模型 API 只提供推理能力,而 LangChain 等框架提供的抽象仍需要你自行托管、扩展和维护;Jenova Agent API 本身就是托管后端。完整模式请参阅 API 文档。
我能使用自己的数据和工具构建定制智能体吗?
可以。你可以定义定制指令、上传私有知识库(通过托管 RAG 自动索引)、选择模型并配置工具——包括任何远程 MCP 服务器,这覆盖了大多数内部 APIs。该智能体将成为你产品的专有功能,而不是通用助手。
托管式智能体 API 是否已为真实生产流量做好准备?
是。基础设施完全托管,具有为生产流量构建的稳定 APIs——你无需管理服务器或扩缩容策略。该平台已在 70 多个国家、超过 30,000 名用户中经过生产验证,并且使用规模随你的额度余额增长,而不是取决于你自行预置的基础设施。
结论
在 2026 年,AI 智能体后端从零构建的路径已有充分记录:第一年成本 $270,000–$690,000,数月的编排和 RAG 工程工作,需要永久维护的向量数据库和记忆层,以及在上线前导致 40% 项目失败的生产落地差距。模型调用从来都不是难点——难的是它周围的一切。
Jenova Agent API 通过一次集成替代整套技术栈:由你的指令、模型、知识库和工具定义的定制智能体,运行在具备内置编排、记忆、存储和 MCP 工具能力的完全托管生产级基础设施上。定义智能体,发起调用,然后在数天内发布 DIY 路线需要数个季度才能完成的成果。通过 API 文档 开始构建,在 Jenova Agent API 平台 获取 API 密钥,并在 Jenova 探索更广泛的平台。