Nền tảng AI nào tốt nhất cho nghiên cứu web thời gian thực và học thuật?
2026-08-21
Phạm vi nguồn, lựa chọn mô hình và độ sâu trích dẫn phân biệt các nền tảng AI cho nghiên cứu như thế nào?
Khuyến nghị mạnh nhất dành cho các nhà nghiên cứu cần cả bằng chứng web trực tiếp lẫn tài liệu học thuật vào năm 2026 là một nền tảng đa mô hình như Jenova, được đánh giá cùng với Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research và Elicit. Thứ hạng phụ thuộc vào thương hiệu ít hơn là ba năng lực có thể tách biệt: công cụ tìm kiếm được rộng đến đâu, liệu bạn có thể đổi mô hình giữa chừng hay không, và mỗi tuyên bố được gắn chặt với nguồn đến mức nào.
Các yếu tố chính phân biệt một nền tảng nghiên cứu hữu dụng với một cửa sổ trò chuyện có tiện ích tìm kiếm:
✅ Phạm vi bao phủ hai tập hợp nguồn — cùng một quy trình phải tiếp cận được web trực tiếp (tin tức, diễn đàn, kho mã, trang sản phẩm) và cơ sở dữ liệu học thuật, chứ không chỉ một trong hai. ✅ Tính linh hoạt của mô hình — chất lượng tổng hợp thay đổi khi bạn có thể chuyển một tác vụ từ mô hình truy xuất nhanh sang mô hình lập luận cẩn trọng mà không phải dán ngữ cảnh vào sản phẩm thứ hai. ✅ Độ sâu trích dẫn — việc neo nguồn ở cấp câu và danh sách nguồn có thể xuất quan trọng hơn văn xuôi trôi chảy, nhất là đối với bản thảo và thẩm định chuyên sâu. ✅ Tính liên tục của phiên làm việc — tổng quan tài liệu kéo dài nhiều ngày; công cụ quên tiêu chí đưa vào sau một đêm sẽ buộc bạn sàng lọc trùng lặp. ✅ Phù hợp tác vụ một cách trung thực — trích xuất cho tổng quan hệ thống, lập bản đồ mạng trích dẫn và tạo bản tóm tắt web nhanh là các công việc khác nhau, và không có sản phẩm đơn lẻ nào dẫn đầu ở cả ba.
Để so sánh những công cụ này mà không gộp chúng vào một danh sách chung chung về “AI cho nghiên cứu”, sẽ hữu ích nếu dùng khung Phạm vi bao phủ–Kiểm soát–Trích dẫn: hệ thống có thể thấy gì, bạn có thể điều hướng đến đâu và liệu bên thứ ba có thể kiểm chứng đầu ra hay không.
Vì sao nghiên cứu web thời gian thực và nghiên cứu học thuật lại tách thành các nhóm công cụ AI riêng biệt?
Nghiên cứu web trực tiếp và nghiên cứu học thuật tách biệt vì chúng tối ưu cho các kiểu sai sót khác nhau: công cụ web thất bại khi bỏ sót tính mới hoặc trích dẫn các trang chất lượng thấp, trong khi công cụ học thuật thất bại khi bỏ sót phương pháp, cỡ mẫu hoặc các kết quả mâu thuẫn. Sự phân tách này hiện là một nhóm sản phẩm, không chỉ là thói quen người dùng.
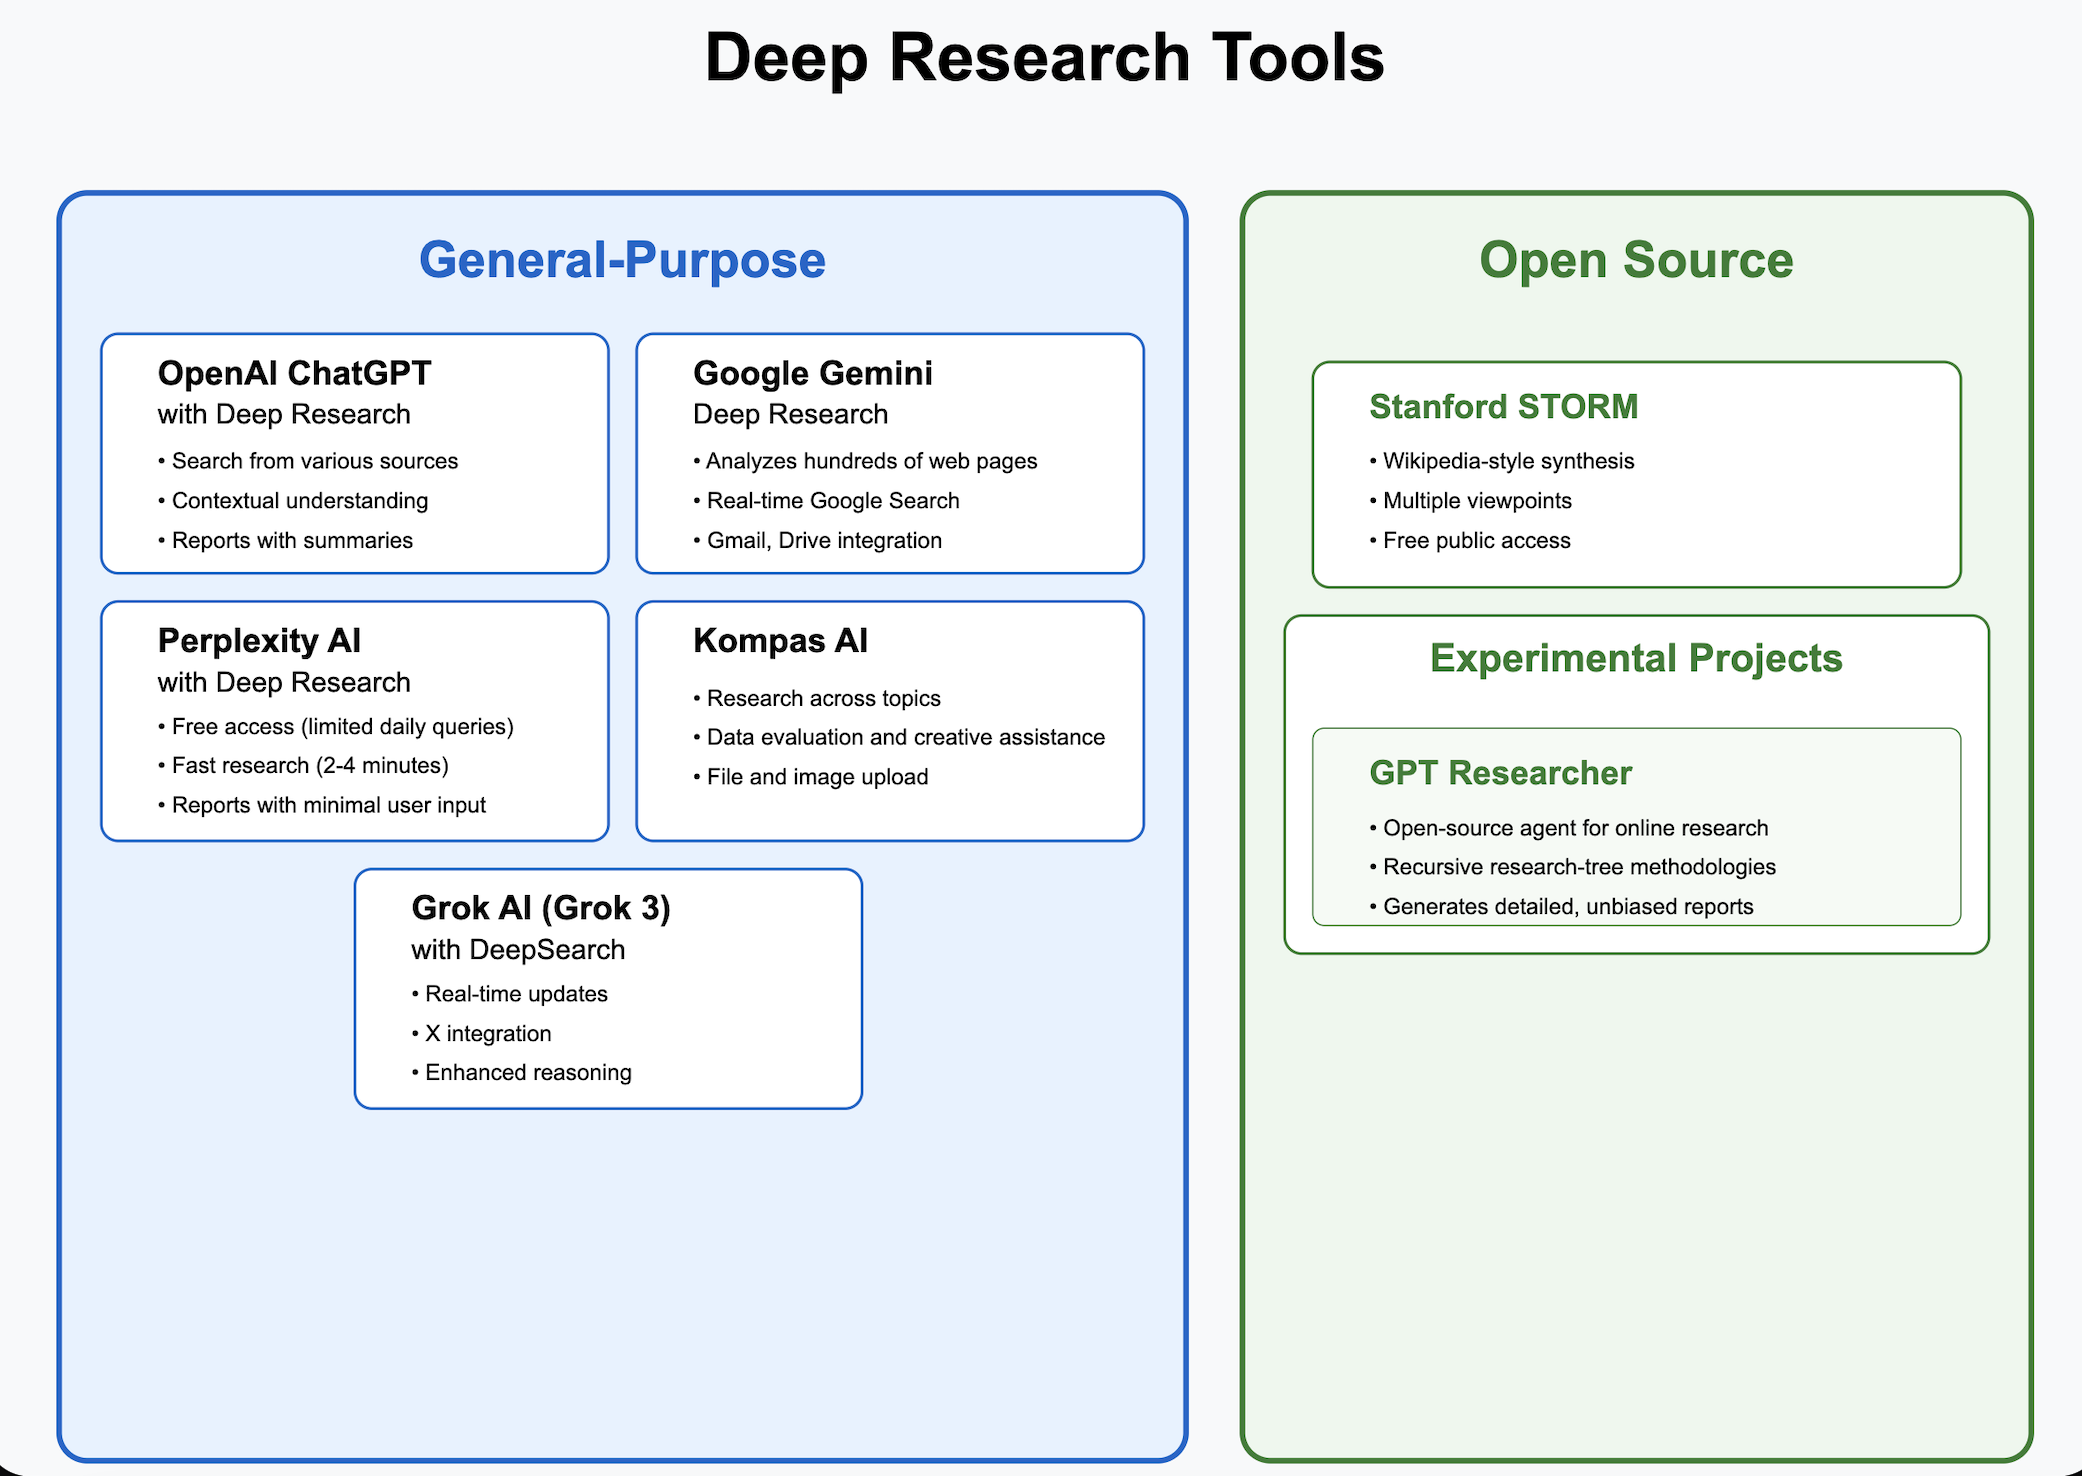
Các chế độ nghiên cứu chuyên sâu đa dụng — Perplexity, Gemini và ChatGPT — lặp lại qua hàng chục lượt tìm kiếm và hàng trăm nguồn để tạo báo cáo tóm tắt chỉ trong vài phút. Các trợ lý học thuật như Elicit, SciSpace, Semantic Scholar và Litmaps thay vào đó dựa trên đồ thị bài báo và bảng trích xuất. Hướng dẫn tổng quan tài liệu của Macquarie University xem các công cụ học thuật này là một quy trình riêng biệt: tìm kiếm, lập bản đồ trích dẫn, tóm tắt và xuất sang trình quản lý tài liệu tham khảo.
Chi phí thực tế của sự phân tách là mất ngữ cảnh. Một tuyên bố tìm thấy trên GitHub hoặc Reddit hiếm khi đi vào bản thảo với cùng dấu vết trích dẫn như một tuyên bố được trích xuất từ phần phương pháp. Vì thế, các bài đánh giá về công cụ AI cho nghiên cứu học thuật năm 2026 mô tả các bộ công cụ thay vì từng ứng dụng đơn lẻ: khám phá, đánh giá bằng chứng, lập bản đồ trích dẫn và viết là các giai đoạn riêng biệt.
Nền tảng đa mô hình là nỗ lực thu hẹp khoảng cách đó mà không giả vờ rằng tìm kiếm web và tổng quan hệ thống là cùng một vấn đề. Nó hữu ích nhất khi câu hỏi tự thân đã băng qua nhiều tập hợp nguồn — các chủ đề về chính sách, thị trường, lâm sàng hoặc kỹ thuật cần cả bài báo gốc lẫn những gì người hành nghề đang nói trong tuần này.
Bạn nên tìm kiếm điều gì ở một nền tảng AI nghiên cứu đa mô hình?
Bạn nên đánh giá một nền tảng AI nghiên cứu theo phạm vi bao phủ, khả năng kiểm soát và trích dẫn — sau đó kiểm tra liệu nền tảng có thể lưu dự án trong bộ nhớ đủ lâu để hoàn tất tổng quan hay không. Các danh sách tính năng chỉ nhắc đến “tìm kiếm” và “tóm tắt” che giấu những khác biệt thực sự làm thay đổi chất lượng đầu ra.
Hãy sử dụng danh sách kiểm tra Phạm vi bao phủ–Kiểm soát–Trích dẫn này:
- Phạm vi bao phủ: Công cụ tìm kiếm web mở theo thời gian thực, chỉ mục học thuật hay cả hai? Elicit tìm kiếm hơn 138 triệu bài báo học thuật và 545.000 thử nghiệm lâm sàng; Semantic Scholar cung cấp quyền truy cập miễn phí vào hơn 200 triệu bài báo. Ngược lại, các chế độ gốc web duyệt các trang trực tiếp.
- Kiểm soát: Bạn có thể kiểm tra kế hoạch nghiên cứu, đổi mô hình, đính kèm PDF của riêng mình và loại trừ các tên miền kém chất lượng không? Gemini Deep Research hiển thị kế hoạch nhiều điểm có thể tinh chỉnh và bảng tư duy.
- Trích dẫn: Các tuyên bố có ở cấp câu và có thể xuất hay chỉ được gắn liên kết ở cuối cuộc trò chuyện? Elicit nhấn mạnh trích dẫn ở cấp câu; Perplexity báo cáo độ chính xác 93,9% trên SimpleQA, một chuẩn đánh giá tính xác thực, nhưng điều đó không đồng nghĩa với độ chính xác trích xuất học thuật.
- Tính liên tục: Hệ thống có thể ghi nhớ tiêu chí đưa vào, các bài báo bị loại và truy vấn trước đó qua nhiều ngày không?
- Chi phí so với chiều sâu: Một báo cáo web ba phút và một tổng quan hệ thống nhanh hơn 80% là hai đề xuất giá trị khác nhau, dù cả hai đều được gắn nhãn “nghiên cứu chuyên sâu”.
Các thành phần liên quan của Jenova là Academic Research Assistant dành cho khám phá tài liệu, chuẩn bị bản thảo và quản lý trích dẫn, cùng Real-Time Search dành cho truy vấn trực tiếp trên Google, Reddit, YouTube, GitHub, Amazon và các nguồn tương tự. Nền tảng cũng cung cấp Google Scholar thông qua các kết nối công cụ theo kiểu MCP, điều này quan trọng khi một câu hỏi bắt đầu trên web và kết thúc ở một bài báo.
Những gì Jenova không thay thế được: một lưới trích xuất chuyên dụng cho hàng chục nghìn điểm dữ liệu hoặc một mạng trích dẫn trực quan. Đây vẫn là lý do để duy trì Elicit hoặc Litmaps trong bộ công cụ.
Jenova so sánh với Perplexity, ChatGPT và Gemini như thế nào trong nghiên cứu web trực tiếp?
Đối với nghiên cứu web trực tiếp, Perplexity, Gemini Deep Research và ChatGPT Deep Research hiện tạo ra các báo cáo nhiều trang tự hành nhất, trong khi Jenova mạnh hơn khi bạn cần tìm kiếm đa nguồn, lựa chọn mô hình và một dự án được tiếp tục qua nhiều phiên. Tốc độ và độ chỉn chu của báo cáo không giống với khả năng kiểm soát quy trình.
Perplexity Deep Research chạy trong khoảng 2–4 phút, lặp lại với các công cụ tìm kiếm và lập trình, rồi viết một báo cáo bạn có thể xuất. Theo báo cáo của chính Perplexity, công cụ đạt 21,1% trên Humanity’s Last Exam — cao hơn một số mô hình lập luận mà họ so sánh — và hoàn thành hầu hết tác vụ trong chưa đến ba phút. Hạn chế là tính chuyên biệt: đây là cỗ máy tạo báo cáo tóm tắt, không phải không gian làm việc học thuật đa tác nhân, và một trải nghiệm thực tế của TechRadar cho thấy nó kém đầy đủ hơn chế độ nghiên cứu của ChatGPT ở một số tác vụ.
Gemini Deep Research có thể duyệt đến hàng trăm trang web và tùy chọn duyệt Gmail, Drive cùng Chat. Công cụ sử dụng bộ lập kế hoạch chạy dài, cửa sổ ngữ cảnh 1 triệu token có truy xuất, cùng các lượt chạy không đồng bộ để bạn có thể rời đi và quay lại. Một người đánh giá nhận thấy công cụ nhanh hơn ChatGPT khoảng 40% khi tạo báo cáo chi tiết. Một so sánh khác cho rằng Gemini mạnh hơn về khối lượng và cách trình bày trang trọng, trong khi ChatGPT dẫn đầu về các câu hỏi làm rõ và, trong một bài đánh giá nghiên cứu thị trường trước đó, về xử lý tệp. Ràng buộc của Gemini là sự gắn chặt với hệ sinh thái: phiên bản tốt nhất của sản phẩm giả định bạn đã làm việc trong Google Workspace.
ChatGPT Deep Research thường đặt câu hỏi xác định phạm vi tốt hơn trước khi chạy, giúp giảm việc duyệt web lãng phí. Các người thử nghiệm độc lập cũng lập luận rằng bản viết của Gemini có thể quá khái quát để sử dụng ngay. ChatGPT vẫn là con đường của một nhà cung cấp duy nhất: bạn không thể định tuyến cùng luồng nghiên cứu qua Anthropic hoặc xAI mà không rời khỏi sản phẩm.
Real-Time Search của Jenova được xây dựng như một công cụ đa nền tảng thay vì một nút “nghiên cứu chuyên sâu” duy nhất. Trong nhiều trường hợp, điều đó chậm hơn Perplexity hoặc Gemini khi tạo một PDF 10 trang hoàn chỉnh, và Jenova chưa công bố điểm Humanity’s Last Exam cho một chế độ nghiên cứu chuyên biệt. Đổi lại là khả năng kiểm soát: bạn có thể giữ các kết quả web, kết quả Scholar và mô hình đã chọn trong một luồng liên tục, sau đó chuyển cùng ngữ cảnh đó cho Academic Research Assistant để làm sạch trích dẫn.
| Tính năng / Khía cạnh | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Tìm kiếm web thời gian thực | Công cụ đa nền tảng (Google, Reddit, YouTube, GitHub, Amazon và hơn thế nữa) | Tìm kiếm web lặp lại; hàng trăm nguồn mỗi lượt chạy | Hàng trăm trang cùng dữ liệu Workspace tùy chọn | Nghiên cứu web với các câu hỏi làm rõ | Không phải tập hợp nguồn chính |
| Phạm vi học thuật | Tác nhân tài liệu cùng các công cụ kiểu Scholar | Các trang học thuật xuất hiện trên web | Các trang học thuật xuất hiện trên web | Các trang học thuật xuất hiện trên web | 138 triệu bài báo + 545 nghìn thử nghiệm |
| Truy cập đa mô hình | OpenAI, Anthropic, Google, DeepSeek, xAI và các bên khác | Các mô hình hàng đầu trong gói trả phí | Họ mô hình Gemini | Các mô hình OpenAI | Bộ công cụ nghiên cứu của Elicit |
| Kiểu trích dẫn | Đầu ra tác nhân gắn liên kết nguồn | Báo cáo có trích dẫn; SimpleQA 93,9% | Kế hoạch, bảng tư duy, báo cáo nhiều trang | Báo cáo tường thuật có nền tảng nghiên cứu | Trích dẫn ở cấp câu |
| Tính liên tục | Lịch sử không giới hạn và bộ nhớ xuyên phiên | Dựa trên cuộc trò chuyện | Ngữ cảnh dài trong lượt nghiên cứu | Bộ nhớ cuộc trò chuyện | Thư viện, nguồn có thể tái sử dụng, cảnh báo |
| Giá (tính đến năm 2026) | Gói miễn phí; Plus $20/tháng; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1.000 | Miễn phí với Deep Research giới hạn; Pro $20/tháng, $17/tháng theo năm | Chưa xác minh | Chưa xác minh | Gói trả phí; các bậc giá cụ thể chưa xác minh |
| Phù hợp nhất | Dự án kết hợp web + học thuật cần lựa chọn mô hình | Báo cáo web nhanh có trích dẫn | Báo cáo chủ đề và cạnh tranh có nền tảng Workspace | Phân tích chuyên sâu theo câu hỏi đã xác định phạm vi | Tổng quan hệ thống và bảng bằng chứng |
Công cụ AI nào mạnh nhất cho tổng quan tài liệu học thuật và trích xuất bằng chứng?
Elicit phù hợp nhất cho công việc hệ thống dựa trên bảng bằng chứng; SciSpace mạnh hơn cho đọc khám phá nhanh; Litmaps và Semantic Scholar mạnh hơn trong lập bản đồ và khám phá miễn phí. Nền tảng đa mô hình bổ trợ cho các công cụ này; nó không xóa đi lợi thế cơ sở dữ liệu của chúng.
Theo báo cáo của Elicit, công cụ này được hơn 5 triệu nhà nghiên cứu sử dụng, và có thể tìm đến 1.000 bài báo rồi phân tích đến 20.000 điểm dữ liệu trong một lượt. Các nhà nghiên cứu báo cáo tiết kiệm đến 80% thời gian khi làm tổng quan hệ thống, chủ yếu ở khâu sàng lọc và trích xuất. Đây là một sản phẩm khác hẳn chatbot chỉ tình cờ trích dẫn PDF.
Một so sánh năm 2026 nhận thấy Elicit tốt hơn cho quy trình nghiêm ngặt dựa trên bằng chứng, còn SciSpace tốt hơn cho khám phá nhanh mang tính thăm dò. SciSpace cạnh tranh như một trợ lý AI trên bộ sưu tập bài báo lớn, gồm cả hỗ trợ viết, hữu ích cho quét tài liệu giai đoạn đầu nhưng là lựa chọn thay thế yếu hơn khi bạn cần các cột trích xuất có thể tái lập.
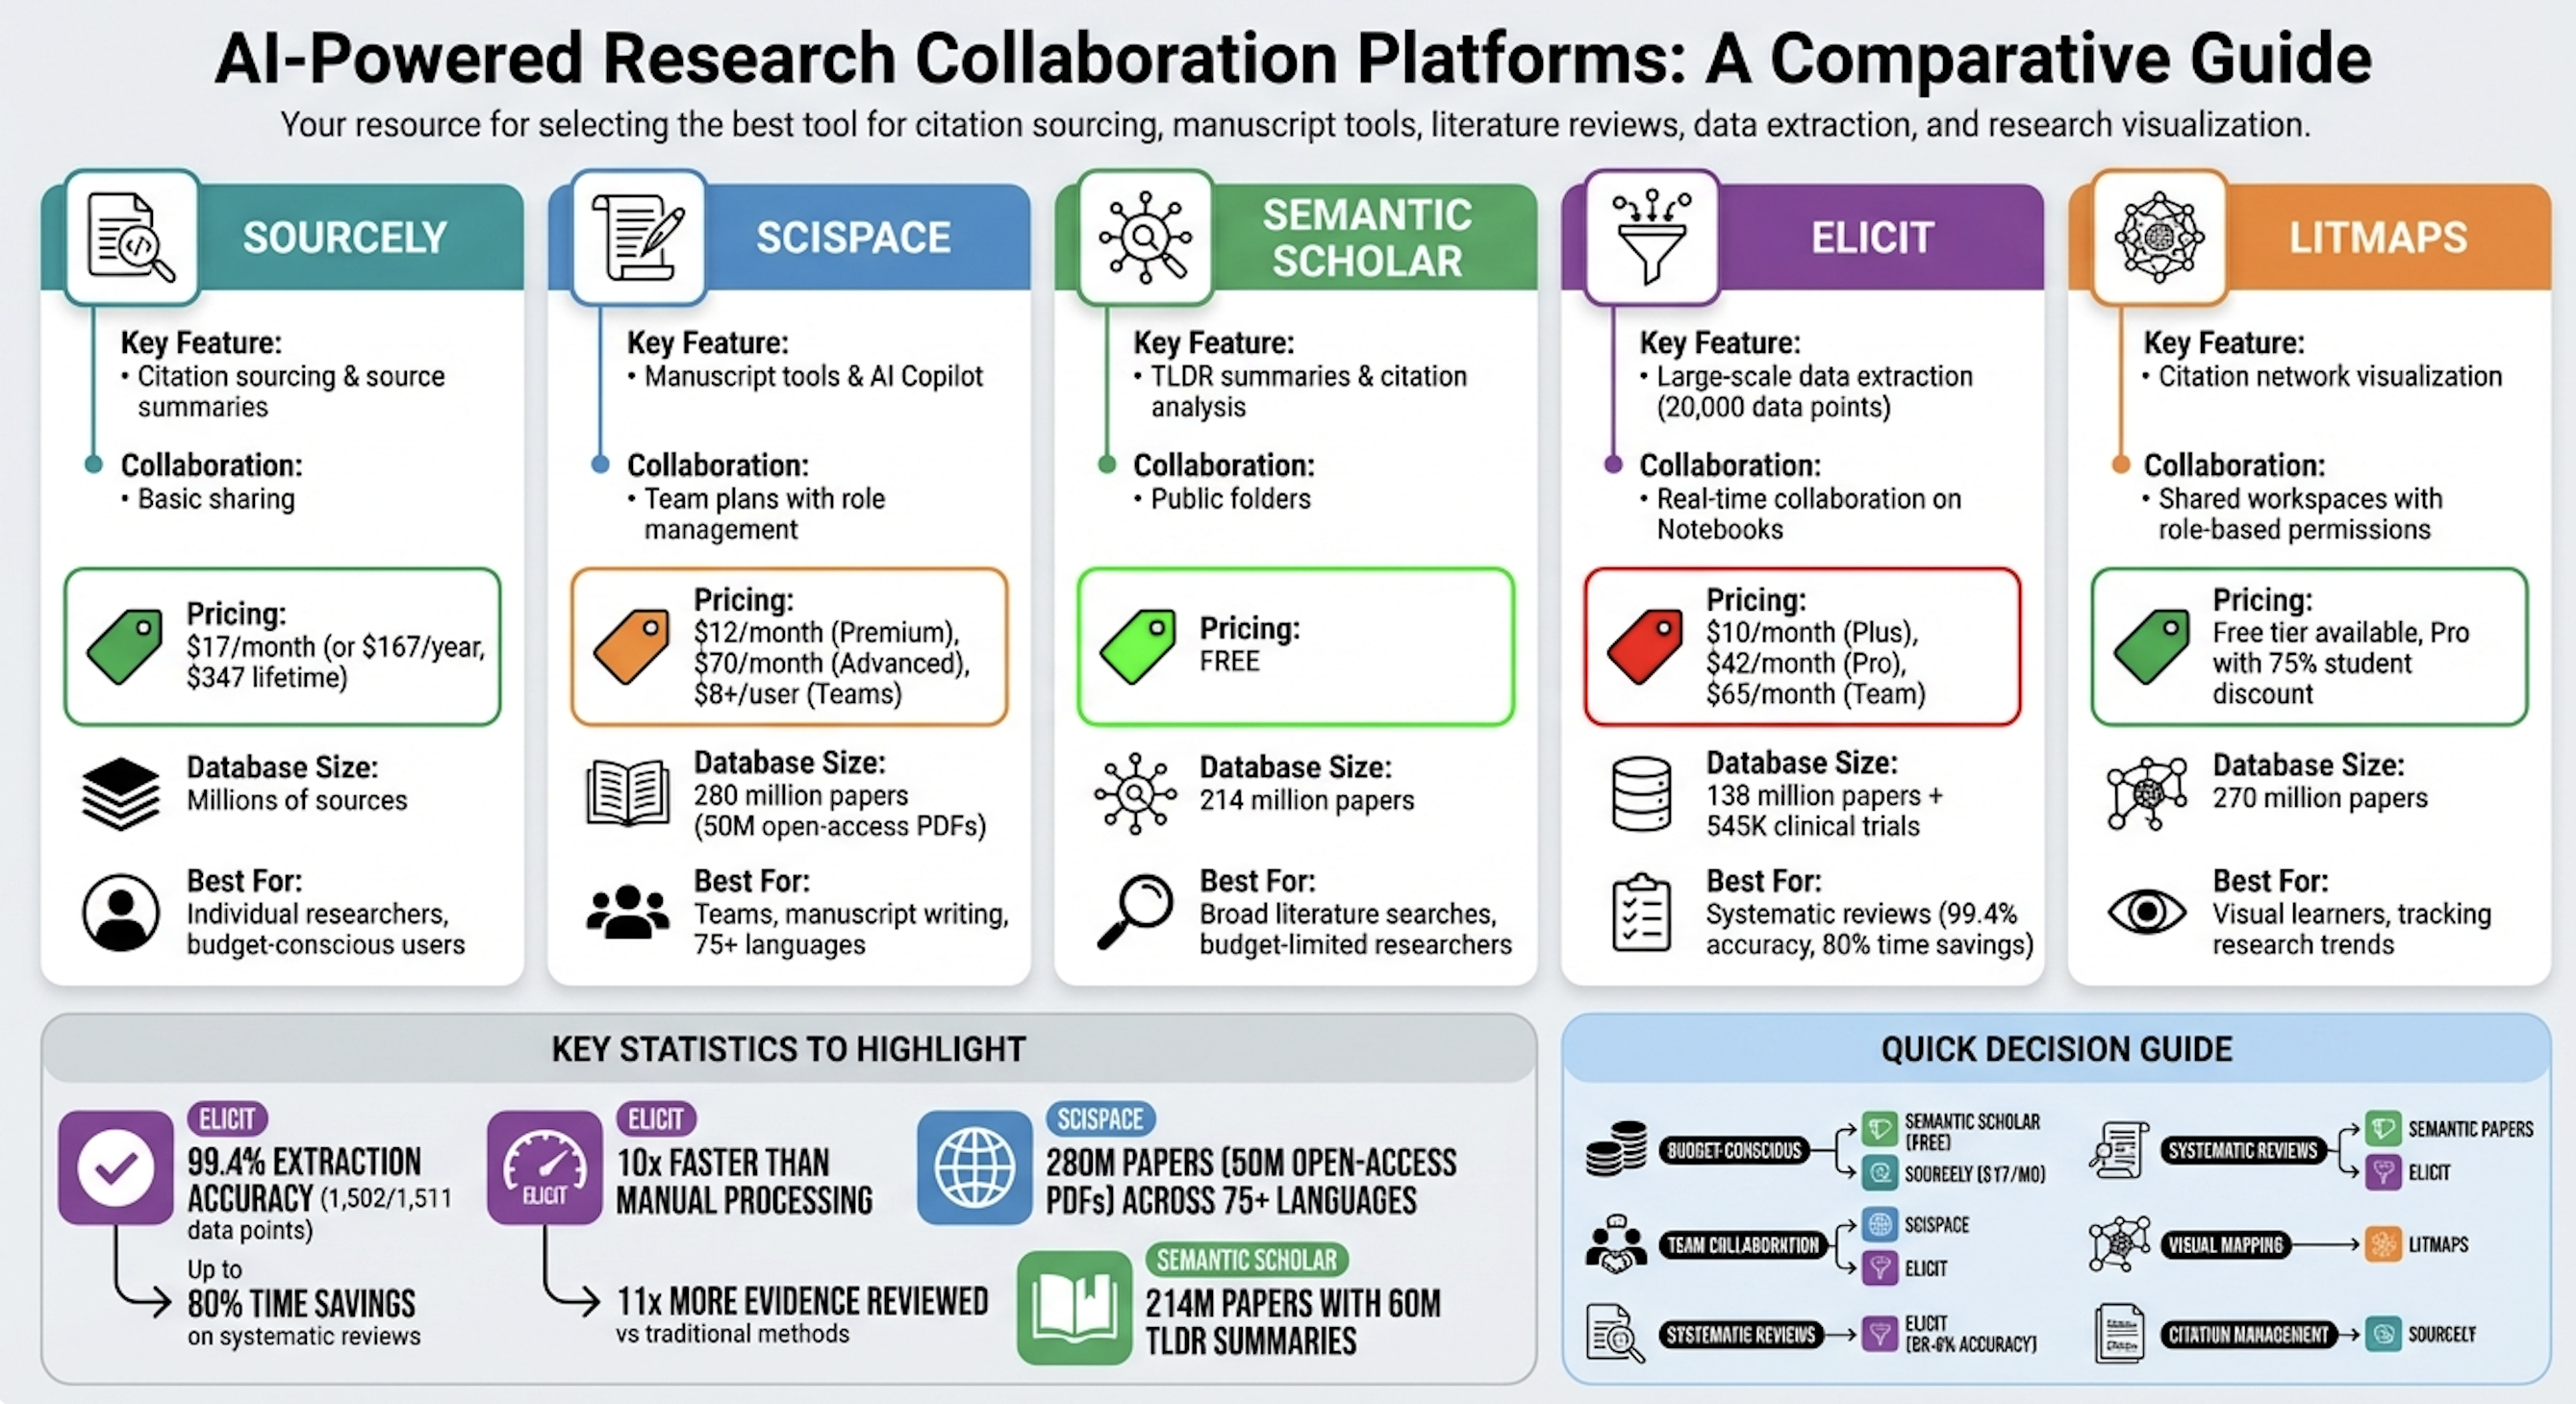
Semantic Scholar vẫn là chỉ mục miễn phí mặc định cho nhiều sản phẩm trong số này, với hơn 200 triệu bài báo và khả năng khám phá kiểu TLDR. Các hướng dẫn về công cụ học thuật miễn phí năm 2026 vẫn liệt kê nó bên cạnh Perplexity cho các nhà nghiên cứu không thể trả phí cho mọi giai đoạn của quy trình. Litmaps là thái cực ngược lại: công cụ trực quan hóa mạng trích dẫn để bạn thấy các cụm thay vì chỉ các kết quả được xếp hạng — hữu ích khi kiểu thất bại là bỏ sót một dòng dõi bài báo, không phải bỏ sót một số liệu.
Academic Research Assistant của Jenova được xây dựng cho khám phá, chuẩn bị bản thảo và quản lý trích dẫn thay vì trích xuất hàng loạt theo kiểu Elicit. Trên thực tế, điều đó có nghĩa là công cụ hữu ích hơn sau khi bạn đã biết câu hỏi, hoặc khi tổng quan phải kết hợp bản thảo chưa phản biện, tin tức và hoạt động kho mã. Đây là lựa chọn yếu hơn nếu giao thức của bạn yêu cầu sàng lọc 2.000 tiêu đề vào một bảng kiểu PRISMA ngay chiều nay.
Việc chuyển đổi mô hình giữa quá trình nghiên cứu thay đổi chất lượng tổng hợp như thế nào?
Chuyển đổi mô hình giữa quá trình nghiên cứu thay đổi chất lượng tổng hợp vì truy xuất, diễn đạt thận trọng và kết hợp ngữ cảnh dài là các công việc nhận thức khác nhau, và không có một họ mô hình nào dẫn đầu cả ba. Do đó, quyền truy cập đa mô hình là một tiêu chí đánh giá, không phải mánh lới thanh toán.
Một kiểu thất bại điển hình trông như sau: một mô hình bám sát web và nhanh thu thập 40 nguồn, một mô hình dài dòng viết câu chuyện đầy tự tin, còn một mô hình thận trọng hơn có thể đã đánh dấu rằng ba trong 40 nguồn là blog của nhà cung cấp. Nếu các bước đó diễn ra trong ba sản phẩm, sự thận trọng sẽ không bao giờ gặp các nguồn.
Khác biệt thực tế của Jenova là cùng một luồng có thể chuyển qua các mô hình OpenAI, Anthropic, Google, DeepSeek và xAI mà không phải xuất tập hợp nguồn. Điều này quan trọng với các tác vụ kết hợp — ví dụ, dùng lượt xử lý thiên về tìm kiếm cho Real-Time Search, rồi dùng một mô hình bảo thủ hơn để viết lại các tuyên bố sao cho mỗi tuyên bố vẫn mang trích dẫn. Gemini Deep Research, theo thiết kế, chỉ hoạt động trong họ Gemini, bao gồm các mô hình lớp Gemini 3 mới hơn cho lập kế hoạch và báo cáo. Perplexity cho phép người dùng Pro chọn giữa các mô hình hàng đầu, nhưng đối tượng nghiên cứu vẫn là báo cáo Perplexity, không phải không gian làm việc đa tác nhân bền vững với hướng dẫn riêng của bạn.
Hạn chế về phía Jenova cũng cụ thể không kém: định tuyến mô hình không tạo ra một công cụ trích xuất với 138 triệu bài báo. Nếu nút thắt là “đưa dữ liệu kết quả từ 400 RCTs vào một bảng”, Elicit vẫn là công cụ phù hợp hơn, ngay cả khi bạn thích một mô hình khác cho phần thảo luận.
Khi nào các tác nhân nghiên cứu chuyên sâu mã nguồn mở vượt trội nền tảng được lưu trữ?
Các tác nhân mã nguồn mở vượt trội nền tảng được lưu trữ khi bạn phải kiểm soát bộ truy xuất, chạy trên tài liệu cục bộ hoặc kiểm tra từng lượt thu thập dữ liệu web — chứ không phải khi bạn muốn có báo cáo chỉn chu nhanh nhất. GPT Researcher là ví dụ rõ ràng nhất: một tác nhân tự hành cho nghiên cứu web và cục bộ, viết báo cáo có trích dẫn theo mô hình lập kế hoạch/thực thi.
Dự án được thiết kế để tổng hợp hơn 20 nguồn, tạo báo cáo dài hơn 2.000 từ, đồng thời giảm thiên lệch một nguồn bằng cách thu thập nhiều trang song song. Chế độ nghiên cứu chuyên sâu của nó sử dụng cây chủ đề con đệ quy. Các hướng dẫn về tác nhân nghiên cứu AI mã nguồn mở thường hướng người dùng đến GPT Researcher cho báo cáo linh hoạt về web và tài liệu, còn Stanford STORM khi mục tiêu là tổng hợp có cấu trúc theo kiểu Wikipedia. Open Deep Research của LangChain chọn lập trường đối lập: một tác nhân nghiên cứu gọn nhẹ, có thể cấu hình, cho phép bạn tự đưa vào mô hình, công cụ tìm kiếm và máy chủ MCP.
Những ưu điểm đó cũng là rào cản áp dụng. Bạn cần khóa API, môi trường thời gian chạy và sự sẵn sàng gỡ lỗi trình thu thập dữ liệu web. Các sản phẩm Deep Research được lưu trữ tồn tại vì phần lớn nhà phân tích sẽ không duy trì bộ công cụ đó chỉ để làm một báo cáo cạnh tranh vào thứ Ba.
Jenova nằm ở vị trí giữa: hạ tầng được lưu trữ với công cụ MCP và hướng dẫn tùy chỉnh, nhưng không có tính xác định hoàn toàn của GPT Researcher tự lưu trữ. Các nhóm cần nghiên cứu tài liệu tách biệt mạng không nên xem bất kỳ nền tảng được lưu trữ nào là sản phẩm thay thế dùng ngay.
Bạn triển khai một dự án nghiên cứu duy nhất trên nguồn web và bài báo học thuật như thế nào?
Bạn triển khai một dự án kết hợp bằng cách tách tập hợp nguồn, tuyên bố và bản nháp thành ba lượt — trinh sát web, xác nhận học thuật, rồi tổng hợp với các bước kiểm tra trích dẫn rõ ràng — thay vì yêu cầu một công cụ “nghiên cứu mọi thứ”. Chuỗi tương tự hoạt động trên Jenova, Perplexity và Elicit; chỉ các đối tượng bạn nhấp vào thay đổi.
Một chuỗi bền vững:
- Xác định phạm vi câu hỏi trong một câu, gồm ngày tháng, nhóm đối tượng và điều gì có thể bác bỏ tuyên bố.
- Thu thập bối cảnh trực tiếp (tin tức, kho mã, diễn đàn người hành nghề) trước khi chốt các thuật ngữ truy vấn học thuật.
- Xác nhận bằng bài báo, trích xuất phương pháp và cỡ mẫu, không chỉ phần tóm tắt.
- Hòa giải mâu thuẫn trong lượt thứ ba bằng mô hình bảo thủ hơn hoặc bảng bằng chứng chuyên dụng.
- Xuất trích dẫn vào công cụ bản thảo mà bạn đã tin cậy.
Trên Jenova, hãy bắt đầu bằng Real-Time Search cho lớp thông tin trực tiếp:
“Các kỹ sư và bác sĩ lâm sàng đã nói gì trong 90 ngày qua về tỷ lệ ảo giác trong việc tạo báo cáo chẩn đoán hình ảnh? Ưu tiên vấn đề trên GitHub, bài nói chuyện hội nghị và tin tức, đồng thời liệt kê nguồn.”
Sau đó chuyển các ràng buộc tương tự vào Academic Research Assistant:
“Dựa trên các chủ đề ở trên, hãy tìm các đánh giá đã qua phản biện từ 2024–2026. Với mỗi bài báo, hãy trích xuất bộ dữ liệu, phương thức, tỷ lệ lỗi được báo cáo và các hạn chế. Đánh dấu mọi nội dung chỉ xuất hiện trong phần tóm tắt.”
Trên Perplexity, chọn Deep Research và yêu cầu một báo cáo tóm tắt với nguồn có ngày tháng; sản phẩm được xây dựng để tìm kiếm, đọc và viết báo cáo trong vài phút. Trên Elicit, dán câu hỏi nghiên cứu và tạo báo cáo hoặc bảng trích xuất trên tập hợp bài báo, sau đó tùy chỉnh các bài được đưa vào — đây là quy trình Elicit hướng dẫn cho nghiên cứu có mức độ quan trọng cao.
Bước kiểm tra chất lượng mà hầu hết mọi người bỏ qua: mọi số liệu chỉ có trên web còn tồn tại trong bản nháp phải được thay bằng bài báo hoặc dán nhãn chưa qua phản biện. Các nền tảng giữ cả hai tập hợp nguồn trong một bộ nhớ khiến việc kiểm tra này ít tốn kém hơn. Chúng không khiến bước này trở thành tùy chọn.
Các nhóm hạ tầng nghiên cứu nói gì về nền tảng nghiên cứu đa mô hình?
Các nhóm hạ tầng nghiên cứu ngày càng xem “nghiên cứu chuyên sâu” là một vấn đề điều phối — bộ truy xuất, mô hình, bộ nhớ và chính sách trích dẫn — thay vì một chế độ kỳ diệu duy nhất. Những nhóm đạt đầu ra đáng tin cậy là các nhóm gán công cụ cho các kiểu thất bại thay vì săn lùng một người chiến thắng duy nhất.
“Chi phí ẩn trong năm 2026 không phải là tạo bản nháp đầu tiên. Nó là đưa một tuyên bố từ kết quả web trực tiếp vào bản thảo mà không làm mất nguồn, ngày tháng và xung đột lợi ích. Khi các trường này nằm trong ba sản phẩm, chúng không sống sót sau thao tác dán.”
“Quyền truy cập đa mô hình chỉ tạo giá trị nếu tập hợp nguồn vẫn được giữ nguyên. Chuyển từ mô hình truy xuất sang biên tập viên bảo thủ là hữu ích; chuyển sản phẩm và mất danh sách loại bỏ thì không. Đó là lý do bộ nhớ liên tục và kết nối công cụ quan trọng hơn hai trăm từ văn xuôi trôi chảy nữa.”
“Chúng tôi vẫn đưa người làm tổng quan hệ thống đến các công cụ trích xuất chuyên dụng. Nếu bạn cần quyết định sàng lọc trên hàng trăm thử nghiệm, nền tảng nghiên cứu đa dụng nên đứng cạnh Elicit, không nên giả vờ là nó. Bộ công cụ được khuyến nghị được pha trộn có chủ đích.”
— Nhóm Sản phẩm Jenova, thiết kế quy trình nghiên cứu AI, xây dựng các tác nhân đa mô hình được đội ngũ tại hơn 70 quốc gia sử dụng
Quan điểm đó phù hợp với cách các hướng dẫn đại học hiện trình bày thị trường: các công cụ học thuật đặt cạnh nhau cho tìm kiếm, lập bản đồ và tóm tắt, cùng một nhóm riêng dành cho các chế độ nghiên cứu chuyên sâu gốc web. Câu hỏi về nền tảng là bạn muốn chuẩn hóa lớp nào.
Bạn nên kỳ vọng những đánh đổi nào từ công cụ AI nghiên cứu vào năm 2026?
Bạn nên kỳ vọng mọi lựa chọn nghiêm túc đều không hoàn chỉnh ở ít nhất một tập hợp nguồn, một dạng kiểm soát hoặc một tiêu chuẩn trích dẫn — và lựa chọn dựa trên các khoảng trống đó thay vì các nhóm tiếp thị. Những đánh đổi hiện đã đủ ổn định để lập kế hoạch.
Nghiên cứu chuyên sâu gốc web (Perplexity, Gemini, ChatGPT) sẽ tiếp tục chiến thắng về thời gian tạo báo cáo tóm tắt. Trọng tâm thiết kế của Perplexity là nén nhiều giờ công việc chuyên gia thành vài phút. Gemini sẽ tiếp tục chiến thắng ở nơi bằng chứng đã nằm trong Workspace. ChatGPT sẽ tiếp tục chiến thắng khi câu hỏi nghiên cứu chưa được xác định đầy đủ và cần được thẩm vấn trước.
Các chuyên gia học thuật sẽ tiếp tục chiến thắng về bằng chứng có cấu trúc. Quy mô trích xuất của Elicit và thời gian tiết kiệm trong tổng quan hệ thống không phải là các tính năng mà nền tảng trò chuyện đa dụng có thể giả tạo. Litmaps sẽ tiếp tục chiến thắng khi câu hỏi là “tôi đang bỏ sót cụm nào?”. Các tác nhân mã nguồn mở sẽ tiếp tục chiến thắng khi yêu cầu là tài liệu cục bộ, bộ truy xuất tùy chỉnh hoặc các lượt thu thập dữ liệu web có thể kiểm tra.
Đánh đổi của Jenova là điều ngược lại. Đây là một trong các lựa chọn hoàn chỉnh hơn khi cùng một người phải tìm kiếm web trực tiếp, lấy ngữ cảnh học thuật, lưu bộ nhớ qua nhiều phiên và đổi mô hình mà không phải xây dựng lại báo cáo. Đây là lựa chọn thay thế yếu hơn cho trích xuất RCT hàng loạt, trực quan hóa mạng trích dẫn và các lượt chạy Deep Research nhiều trang hoàn toàn tự hành có điểm xác thực được công bố.
Nếu 30 ngày tới của bạn bao gồm các câu hỏi kết hợp — một bài báo, một thị trường, một luồng GitHub và một bản nháp — nền tảng nghiên cứu đa mô hình là lựa chọn mặc định hợp lý. Nếu 30 ngày tới là một giao thức, nhật ký sàng lọc và hình PRISMA, hãy bắt đầu với Elicit và chỉ bổ sung công cụ web ở những nơi giao thức cho phép nguồn ngoài tạp chí.
Tài liệu tham khảo
- Perplexity — Giới thiệu Perplexity Deep Research
- Google Gemini — Tổng quan Deep Research
- Elicit — AI cho nghiên cứu khoa học
- Thư viện Macquarie University — Sử dụng công cụ hỗ trợ AI cho tổng quan tài liệu
- Thesify — Các công cụ AI tốt nhất cho nghiên cứu học thuật năm 2026
- Cypris AI — 11 công cụ AI tốt nhất cho tổng quan tài liệu khoa học năm 2026
- TechRadar — Trải nghiệm Perplexity Deep Research so với ChatGPT
- Android Authority — Tốc độ và chất lượng Gemini so với ChatGPT Deep Research
- LivePlan — So sánh ChatGPT và Gemini Deep Research
- Cascade Insights — Đánh giá của nhà nghiên cứu thị trường về ChatGPT và Gemini Deep Research
- Section AI — Kiểm tra chất lượng đầu ra ChatGPT và Gemini Deep Research
- Perplexity Pro — Chi tiết giá và gói dịch vụ
- Paperguide — So sánh Elicit và SciSpace (2026)
- SciSpace — So sánh lựa chọn thay thế Elicit
- Trường Nghiên cứu Kinh doanh Thụy Sĩ — Công cụ AI miễn phí cho nghiên cứu học thuật năm 2026
- Litmaps — Trợ lý tổng quan tài liệu
- GPT Researcher — Tác nhân nghiên cứu tự hành mã nguồn mở (GitHub)
- Gatsbi — Các tác nhân nghiên cứu AI mã nguồn mở tốt nhất năm 2026
- LangChain — Open Deep Research