Trò chuyện AI với bộ nhớ vector: Khả năng nhớ ngữ nghĩa bền vững cho tác nhân
2026-09-15
Jenova mang đến cho bạn khả năng trò chuyện AI với bộ nhớ vector — những cuộc hội thoại ghi nhớ ý nghĩa, không chỉ vài tin nhắn gần nhất. Tính đến tháng 9 năm 2026, phần lớn trợ lý vẫn quên sở thích, đánh mất ngữ cảnh dự án và buộc bạn phải giải thích lại cùng một tệp nhiều lần. Nền tảng này lưu trữ hội thoại, tài liệu và sở thích để các tác nhân chuyên biệt có thể truy xuất đúng ngữ cảnh khi bạn cần.
✅ Bộ nhớ bền vững xuyên suốt các phiên, không phải cửa sổ trượt tự xóa ✅ Truy xuất ngữ nghĩa thay vì từ khóa — tìm điều bạn muốn nói, không chỉ điều bạn đã gõ ✅ Cơ sở tri thức chỉ cần đính kèm một lần rồi tái sử dụng cho nghiên cứu, lập trình và viết lách ✅ Cùng một mô hình bộ nhớ trên web, iOS và Android
Trò chuyện không trạng thái rẻ để vận hành nhưng tốn kém khi sử dụng. Để hiểu vì sao bộ nhớ vector hiện nằm ở trung tâm của trải nghiệm trò chuyện AI hữu ích, cần xem cách biểu diễn nhúng, truy xuất và ngữ cảnh dài hạn thực sự thất bại trong công việc hằng ngày.
Trả lời nhanh: Trò chuyện AI với bộ nhớ vector là gì?
Trò chuyện AI với bộ nhớ vector là một hệ thống truy xuất lưu trữ ý nghĩa hội thoại dưới dạng biểu diễn nhúng, để AI có thể nhớ ngữ cảnh, tài liệu và sở thích liên quan xuyên suốt các phiên. Đây là điểm khác biệt giữa chatbot khởi động lại ở mỗi luồng trò chuyện và tác nhân tiếp tục công việc.
Các năng lực chính:
- Nhúng tin nhắn, tệp và dữ kiện thành vector để tìm kiếm độ tương đồng
- Chỉ đưa các ký ức liên quan nhất vào cửa sổ ngữ cảnh của mô hình
- Lưu lịch sử trò chuyện không giới hạn và sở thích xuyên phiên trên một nền tảng
- Neo câu trả lời vào các cơ sở tri thức đính kèm thay vì phỏng đoán từ tham số mô hình
- Mang cùng bộ nhớ từ phiên làm việc tại bàn sang điện thoại mà không cần giải thích lại cho tác nhân
Vì sao phần lớn trò chuyện AI vẫn hay quên
Các mô hình ngôn ngữ lớn suy luận tốt nhưng lưu trữ kém. Trọng số của chúng chứa tri thức tổng quát; chúng không chứa danh sách công việc tồn đọng, lược đồ hay quyết định gần nhất của bạn. Sinh nội dung tăng cường truy xuất tồn tại chính vì bộ nhớ tham số thiếu nhất quán và khó cập nhật cho một miền riêng tư — điểm được tổng hợp trong khảo sát năm 2025 về các kiến trúc RAG.
Nhu cầu của ngành đối với tầng truy xuất này không còn mang tính thử nghiệm:
2.652,1 triệu USD → 8.945,7 triệu USD — Quy mô thị trường cơ sở dữ liệu vector toàn cầu dự kiến từ năm 2025 đến năm 2030, với CAGR 27,5%
Khoản chi này là một triệu chứng. Các đội ngũ mua hạ tầng vector vì trò chuyện không có bộ nhớ liên tục thất bại theo những cách giống nhau:
- Cửa sổ ngữ cảnh bị tràn, khiến các quyết định cũ biến mất giữa chừng dự án
- Tìm kiếm từ khóa bỏ lỡ cách diễn đạt lại, từ đồng nghĩa và ý định hàm ẩn
- Các hệ thống RAG tự xây dựng (chia đoạn, chỉ mục, đánh giá, xác thực) đình trệ trước khi lên môi trường vận hành
- Cá nhân hóa bị mắc kẹt trong lịch sử trò chuyện của một nhà cung cấp duy nhất
- Câu trả lời trôi lệch khi mô hình không thể neo vào các tệp của bạn
Nhưng việc đưa bộ nhớ bền vững, riêng tư và có thể tìm kiếm theo ngữ nghĩa vào trò chuyện hằng ngày vẫn khó đến mức gây bực bội:
Cửa sổ ngữ cảnh không phải là bộ nhớ
Cửa sổ ngữ cảnh là bộ đệm, không phải kho lưu trữ. Lịch sử hội thoại, câu hỏi của người dùng và một vài “dữ kiện đã lưu” được nối vào một prompt; mọi thứ không vừa sẽ bị loại bỏ. Đó là lý do một tác nhân lập trình quên lỗi bạn đã dán hôm qua, và gia sư lại hỏi mục tiêu điểm số của bạn. Bộ nhớ vector nằm bên ngoài cửa sổ: nó truy xuất một phần nhỏ có liên quan tại thời điểm suy luận, thay vì hy vọng toàn bộ bản ghi hội thoại vẫn còn vừa.
Tìm kiếm từ khóa không thể biểu đạt ý nghĩa
Tìm kiếm cổ điển ưu tiên các token trùng khớp chính xác. Tìm kiếm vector so sánh biểu diễn nhúng — các biểu diễn số nhiều chiều của ý nghĩa — bằng những thước đo như độ tương đồng cosine hoặc khoảng cách Euclid. Biểu diễn nhúng cùng chỉ mục vector là tầng truy xuất giúp các ứng dụng LLM hiện đại trở nên khả thi. Không có tầng này, “kế hoạch tuyển dụng Q3” sẽ không truy xuất được ghi chú mà bạn đặt tiêu đề “nhân sự cho mùa thu”.
RAG tự xây dựng là một dự án hạ tầng
Một quy trình truy xuất đạt mức vận hành cần chiến lược chia đoạn, lựa chọn biểu diễn nhúng, chỉ mục ANN, bộ lọc siêu dữ liệu, đánh giá và các tác vụ làm mới. Các điểm chuẩn ANN được công bố cho thấy vì sao các đội ngũ quan tâm: các công cụ được so sánh đồng thời về độ trễ, thông lượng và độ chính xác, vì tốc độ mà không có khả năng truy hồi là một sản phẩm khác. Phần lớn cá nhân chỉ muốn một cuộc trò chuyện có thể ghi nhớ không nên phải vận hành cả hệ thống đó.
Cá nhân hóa không có bộ nhớ có thể di chuyển thì rất mong manh
Digital Economy Lab của Stanford lập luận rằng lợi thế bền vững trong AI sẽ đến từ ngữ cảnh cá nhân liên tục, do người dùng kiểm soát — chứ không phải từ một chatbot biệt lập khác. Hiện nay, bộ nhớ thường chỉ là một tính năng của nhà cung cấp: nó không đi theo bạn và có thể âm thầm định hình nội dung bạn được xem. Bài viết của Columbia Journalism Review về bộ nhớ chatbot lưu ý rằng việc ghi nhớ người dùng có thể thay đổi thông tin mọi người nhận được.
Đó chính xác là điều Jenova được xây dựng để giải quyết.
Giải pháp của Jenova
Jenova xem trò chuyện AI với bộ nhớ vector là mặc định, không phải tiện ích bổ sung bạn phải tự kết nối sau này. Lịch sử trò chuyện không giới hạn, bộ nhớ bền vững xuyên phiên và cơ sở tri thức có thể đính kèm đều nằm dưới mọi tác nhân chuyên biệt. Bạn trò chuyện bằng ngôn ngữ tự nhiên; nền tảng truy xuất đúng biểu diễn nhúng, công cụ và tệp trước khi mô hình trả lời.
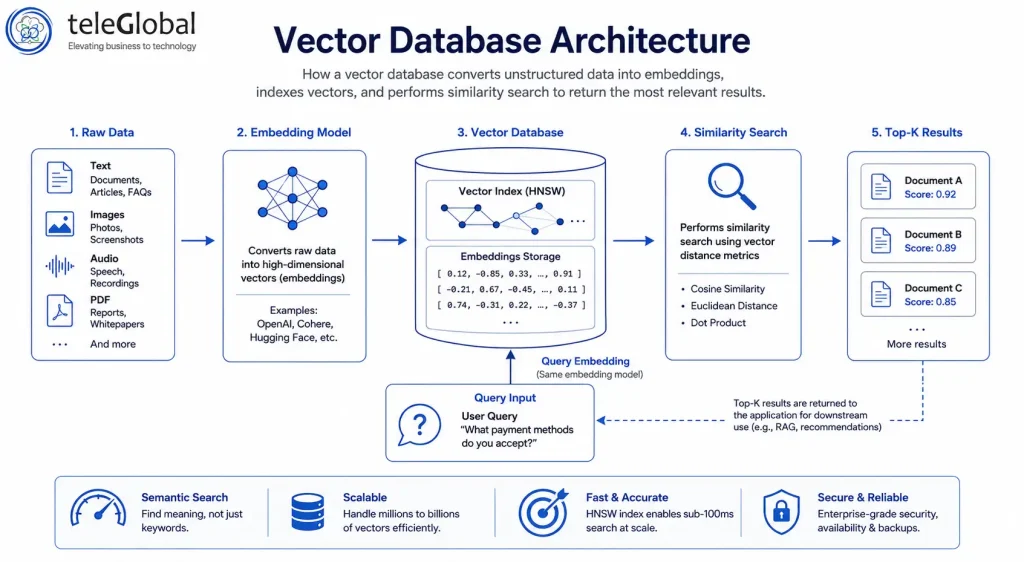
Sơ đồ trên cho thấy cơ chế đằng sau trải nghiệm đó: văn bản, hình ảnh và tài liệu phi cấu trúc trở thành biểu diễn nhúng, đi vào chỉ mục vector và trả về các kết quả khớp top-k cho một truy vấn. Bạn không bao giờ phải cấu hình tham số HNSW hay chọn thước đo khoảng cách. Bạn chỉ cần bắt đầu một luồng trò chuyện.
| Cách tiếp cận truyền thống | Jenova |
|---|---|
| Dán lại cùng một bản tóm tắt vào mọi cuộc trò chuyện mới | Bộ nhớ bền vững xuyên các phiên và tác nhân |
| Tìm kiếm từ khóa trong ghi chú và PDFs | Truy xuất ngữ nghĩa trên biểu diễn nhúng |
| Tự lưu trữ cơ sở dữ liệu vector, công cụ nhúng và đánh giá RAG | Lưu trữ và truy xuất được quản lý hoàn toàn |
| Một nhà cung cấp mô hình, một kho bộ nhớ tách biệt | Truy cập đa mô hình với ngữ cảnh dùng chung |
| Lịch sử chỉ trên máy tính, biến mất khi dùng di động | Đồng nhất hoàn toàn trên web, iOS và Android |
Nghiên cứu tích lũy thay vì khởi động lại
Tổng quan tài liệu và quét thị trường thất bại khi trợ lý không nhớ những bài báo bạn đã loại. Real-Time Search lấy kết quả trực tiếp từ Google, Reddit, YouTube, GitHub và nhiều nguồn khác, trong khi bộ nhớ vector duy trì các tiêu chí đưa vào, trích dẫn trước đó và quy tắc “không sử dụng nguồn này” của bạn. Bạn không bắt đầu một truy vấn Boolean mới mỗi sáng; bạn đang tiếp tục một cuộc điều tra dựa trên truy xuất.
Cơ sở mã mà tác nhân thực sự hiểu
Python Coding Assistant hữu ích ngay ngày đầu tiên cho một script. Nó trở nên bền vững vào ngày thứ mười hai, khi vẫn biết bố cục đóng gói, bài kiểm thử không ổn định mà bạn quyết định bỏ qua và hợp đồng API bạn đã cố định tuần trước. Hãy đính kèm ghi chú về kho mã hoặc tài liệu thiết kế một lần. Các prompt sau đó sẽ truy xuất ngữ cảnh này thay vì bịa ra một kiến trúc song song.
Nội dung viết giữ được giọng văn và dữ kiện của bạn
Bản nháp thất bại trong trò chuyện không trạng thái vì giọng điệu, các cụm từ bị cấm và URL nguồn chuẩn bị trôi khỏi cửa sổ. Một tác nhân tập trung vào viết lách trên nền tảng có thể lưu các mẫu phong cách và quyết định dàn ý của bạn làm bộ nhớ, rồi truy xuất chúng khi bạn nói “cùng giọng với bài ra mắt”. Kết hợp với tệp tài liệu đính kèm, đó là bộ nhớ vector tạo ra tính liên tục biên tập — không phải một prompt lớn hơn.
Cuộc sống và việc học không nên bị đặt lại
Huấn luyện và thực hành ngôn ngữ chỉ hiệu quả khi tác nhân nhớ các ràng buộc: chấn thương, ngày thi, từ vựng bạn đã biết. Bộ nhớ bền vững biến một gia sư chung chung thành người không còn lặp lại các bài tập tuần đầu. Cùng kho lưu trữ truy xuất một traceback Python cũng có thể truy xuất thực tế rằng bạn học tốt hơn qua nhập vai thay vì bảng ngữ pháp.
Dùng thử nền tảng miễn phí — không cần thẻ tín dụng.
Các tác nhân AI chuyên biệt cho trò chuyện AI với bộ nhớ vector
Bộ nhớ chỉ hữu ích tương ứng với quy trình công việc mà nó phục vụ. Các tác nhân này được xây dựng cho những nhiệm vụ mà việc quên lãng gây tốn kém — hành trình nghiên cứu dài, hậu cần lặp lại, thực hành nhập vai và lối chơi nhất quán về nhân vật.
Deep Research
Nghiên cứu kéo dài nhiều giờ là trường hợp kinh điển cho trò chuyện AI với bộ nhớ vector. Tác nhân này tìm kiếm hàng trăm nguồn, tổng hợp phát hiện với trích dẫn nội dòng và cung cấp báo cáo mà bạn có thể tiếp tục vào ngày mai mà không phải xác định lại phạm vi câu hỏi.
- Lưu câu hỏi nghiên cứu, nguồn bị loại và luận điểm đang phát triển
- Truy xuất các phát hiện trước đó để các phần sau không mâu thuẫn với phần trước
- Neo các tuyên bố vào tài liệu đã trích dẫn thay vì chỉ dựa vào khả năng nhớ của mô hình
Academic Research Assistant
Quy trình của nghiên cứu sinh tiến sĩ và giảng viên kéo dài hàng tháng với tài liệu, phong cách trích dẫn và các phiên bản bản thảo. Trợ lý khám phá bài báo qua các cơ sở dữ liệu lớn và hỗ trợ chuẩn bị bản thảo, trong khi bộ nhớ giữ nguyên địa điểm xuất bản, phương pháp luận và tập tài liệu bạn đã đọc.
- Khám phá tài liệu theo thời gian thực trên các kho học thuật
- Hỗ trợ trích dẫn và bản thảo gắn với bản nháp đang thực hiện
- Tính liên tục xuyên các bài báo liên quan, không phải các câu trả lời trò chuyện đơn lẻ
Personal Secretary
Hậu cần là một vấn đề bộ nhớ: nhà cung cấp định kỳ, sở thích đi lại, ai nhận cập nhật vào thứ Sáu. Tác nhân này điều phối lịch, email và hoạt động hằng ngày với ngữ cảnh cá nhân sâu, để bạn không phải dạy lại lịch trình của mình vào mỗi thứ Hai.
- Ghi nhớ sở thích cố định và những người bạn làm việc cùng
- Kết nối việc lập kế hoạch với các công cụ bạn đang dùng
- Mang ngữ cảnh từ buổi tóm tắt buổi sáng đến bước theo dõi buổi chiều
Roleplay Game Master
Tính nhất quán của câu chuyện là không thể nếu không có bộ nhớ dài hạn. Tác nhân này được xây dựng cho nhập vai sống động với bộ nhớ không giới hạn và nhân vật ổn định — các lời hứa cốt truyện, tên phe phái và giọng điệu không bị đặt lại khi cửa sổ ngữ cảnh lẽ ra đã tràn.
- Bộ nhớ không giới hạn cho trạng thái câu chuyện và giọng nhân vật
- Truy xuất các cảnh trước đó khi một chương sau cần đến chúng
- Phạm vi sáng tạo rộng mà không mất tính liên tục
Learn Russian Through Roleplay
Việc tiếp thu ngôn ngữ phụ thuộc vào ngữ cảnh cá nhân có nhịp giãn cách: những từ bạn bỏ lỡ, mức độ trang trọng, các câu chuyện bạn từng trải qua. Người hướng dẫn này sử dụng tình huống không giới hạn và bộ nhớ không giới hạn để việc luyện tập tích lũy thay vì lặp lại các kịch bản cho người mới bắt đầu.
- Ghi nhớ các khoảng trống từ vựng và loại tình huống bạn ưa thích
- Giữ nhân vật và bối cảnh nhất quán xuyên các phiên
- Biến mỗi cuộc hội thoại thành thực hành dựa trên truy xuất
Trò chuyện AI với bộ nhớ vector hoạt động như thế nào
Bạn không cần triển khai một cơ sở dữ liệu vector. Bạn bắt đầu cuộc hội thoại; nền tảng xử lý biểu diễn nhúng, truy xuất và cửa sổ ngữ cảnh.
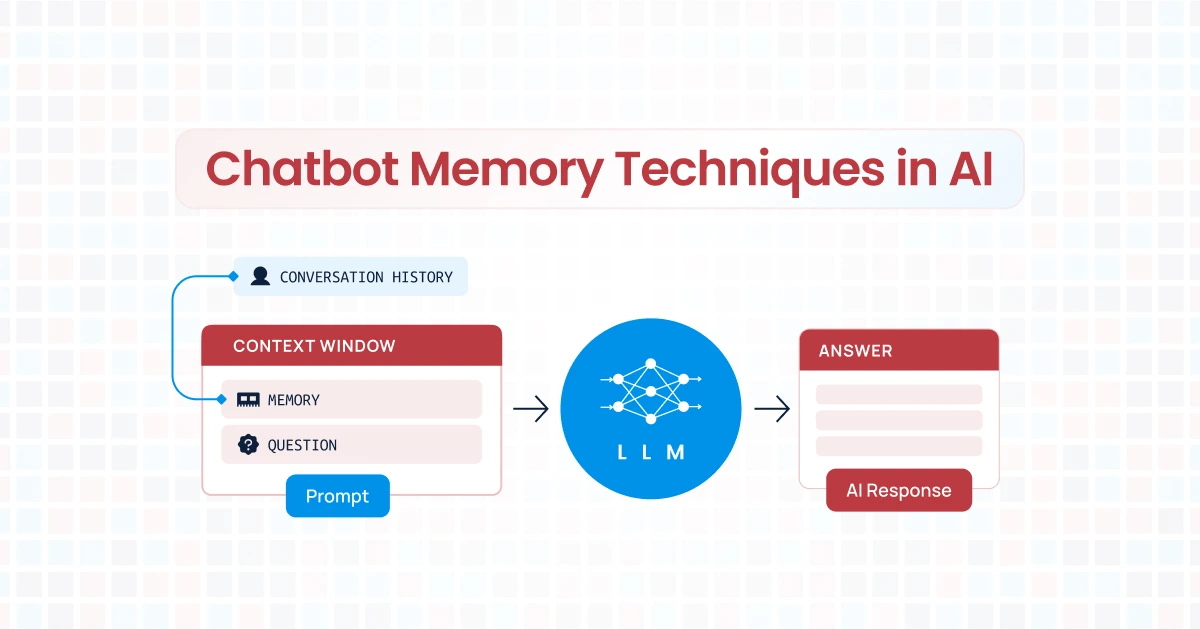
Sơ đồ thứ hai đó là vòng lặp người dùng nhìn thấy. Lịch sử, bộ nhớ đã lưu và câu hỏi mới được tập hợp thành một prompt; mô hình trả lời. Truy xuất vector quyết định những ký ức nào thuộc về prompt đó để cửa sổ luôn tập trung.
Bước 1: Mở một tác nhân và nêu rõ kết quả Chọn chuyên gia cho công việc — nghiên cứu, lập trình, du lịch, gia sư — rồi cho biết “hoàn thành” trông như thế nào. Tin nhắn đầu tiên trở thành một biểu diễn nhúng như mọi tin nhắn sau đó.
"Tôi đang viết một tổng quan hệ thống về sinh nội dung tăng cường truy xuất. Ưu tiên các bài khảo sát từ năm 2024 trở đi, loại trừ blog của nhà cung cấp và giữ phong cách trích dẫn IEEE."
Bước 2: Đính kèm tri thức mà mô hình nên tin cậy Tải lên bản tóm tắt, PDFs, ghi chú hoặc thông số kỹ thuật. Các tài liệu này được lập chỉ mục để tìm kiếm ngữ nghĩa, giúp câu hỏi sau này truy xuất các đoạn theo ý nghĩa. Đây là cùng mô hình mà các doanh nghiệp hiện đầu tư như hạ tầng RAG, nhưng bạn không phải vận hành chỉ mục.
"Hãy dùng ma trận tài liệu đính kèm. Nếu một bài báo được đánh dấu loại, đừng trích dẫn lại."
Bước 3: Tiếp tục làm việc xuyên các phiên Đóng máy tính xách tay. Ngày hôm sau, hãy đặt một câu hỏi tiếp nối. Bộ nhớ bền vững và lịch sử không giới hạn nghĩa là tác nhân truy xuất phạm vi tổng quan, danh sách loại và tiêu đề dàn ý gần nhất, thay vì chào bạn như một người xa lạ.
"Tiếp tục từ phần hạn chế và lấy ba bài báo chúng ta đã đánh dấu cho phần thảo luận."
Bước 4: Chuyển thiết bị mà không cần giải thích lại Mở cùng luồng trò chuyện trên iOS hoặc Android. Cài đặt và lịch sử được đồng bộ. Một prompt khi đang di chuyển có thể truy xuất các vector giống phiên làm việc tại bàn, và đó là mục đích của trò chuyện AI với bộ nhớ vector: tính liên tục, không phải một kho trò chuyện mới cho mỗi thiết bị.
"Tôi đang trên đường đến trường — hãy kiểm tra tôi về ba chế độ lỗi RAG mà chúng ta đã liệt kê hôm qua."
Kết quả và trường hợp sử dụng
Bộ nhớ vector thể hiện qua số giờ không phải lặp lại, chứ không phải qua biểu đồ điểm chuẩn. Các kịch bản này là ví dụ điển hình về những gì thay đổi khi trò chuyện truy xuất ý nghĩa.
📊 Tổng hợp tài liệu kéo dài nhiều tuần
Tình huống: Một học viên cao học cần bức tranh tổng quan có trích dẫn về các bài báo liên quan đến độ bền vững của RAG, được cập nhật vài ngày một lần khi có bản in trước mới.
Cách tiếp cận truyền thống: Một thư mục PDFs, bảng tính ghi chú và chatbot quên danh sách loại trừ. Phải dán lại bản tóm tắt ở mỗi phiên. Dễ trích dẫn trùng hoặc bỏ lỡ mâu thuẫn.
Deep Research: Câu hỏi, các mục loại trừ và dàn ý đang phát triển được duy trì. Các lần chạy mới truy xuất bản tổng hợp trước đó để báo cáo mở rộng thay vì phân nhánh.
- Trích dẫn luôn nhất quán với các phần trước
- Nguồn đã loại vẫn được loại
- Các câu hỏi tiếp nối ít tốn công hơn tìm kiếm lần đầu
💼 Một dịch vụ Python kéo dài qua nhiều sprint
Tình huống: Bạn đang xây dựng dịch vụ FastAPI với thông số OpenAPI đã cố định, một bài kiểm thử không ổn định đã biết và ràng buộc triển khai trên Python 3.11.
Cách tiếp cận truyền thống: Mỗi cuộc trò chuyện mới lại bịa ra một cấu trúc thư mục khác. Bạn dành mười phút đầu để giải thích lại các quyết định mà mô hình không thể thấy.
Python Coding Assistant: Ghi chú kiến trúc và thông số nằm trong bộ nhớ và tệp đính kèm. Báo cáo lỗi vào thứ Năm truy xuất danh sách ràng buộc của thứ Tư.
- Ít tái cấu trúc mâu thuẫn hơn
- Gỡ lỗi bắt đầu từ hệ thống thực tế
- Việc hướng dẫn phiên bản tương lai của bạn (hoặc đồng đội đọc luồng trò chuyện) nhanh hơn
🎭 Một chiến dịch không được tự mâu thuẫn
Tình huống: Một trò chơi hằng tuần có các NPC được đặt tên, bí mật mà nhóm người chơi chưa biết và giọng điệu bạn đã thiết lập từ phiên một.
Cách tiếp cận truyền thống: Ghi chú phiên nằm trong một ứng dụng khác; chatbot gượng ép thêm một phản diện mới vì không thể truy xuất lời hứa cũ.
Roleplay Game Master: Trạng thái câu chuyện là bộ nhớ. Khi người chơi nhắc một chi tiết thoáng qua từ ba phiên trước, truy xuất có thể đưa nó trở lại cảnh hiện tại.
- Giọng nhân vật duy trì ổn định
- Lời hứa cốt truyện luôn có thể truy vấn
- Các mạch truyện dài vẫn mạch lạc
📱 Lập kế hoạch chuyến đi từ hàng chờ ở sân bay
Tình huống: Bạn đã lên kế hoạch chuyến đi ba thành phố tại bàn làm việc — giới hạn ngân sách, ngày ưu tiên đi bộ, không bay đêm. Ở cổng lên máy bay, bạn chỉ cần viết lại kế hoạch ngày mai có tính đến thời tiết.
Cách tiếp cận truyền thống: Chụp màn hình ghi chú của chính bạn. Hy vọng chatbot trên di động suy ra được các ràng buộc mà nó chưa từng thấy.
Travel Planning Advisor: Sở thích và lịch trình đã nằm trong bộ nhớ. Một prompt trên điện thoại truy xuất chúng và thay đổi một ngày mà không cần xây dựng lại chuyến đi.
- Ràng buộc vẫn tồn tại khi chuyển thiết bị
- Các câu hỏi tiếp nối tại địa phương vẫn trong ngân sách
- Bạn không phải gõ lại bản tóm tắt ở cầu lên máy bay
Xem xét việc sử dụng thực tế cho thấy cùng mô hình mà người mua cơ sở dữ liệu vector doanh nghiệp đang chi trả: truy xuất ngữ nghĩa độ trễ thấp cho các câu hỏi trực tiếp, không phải một hộp trò chuyện lớn hơn.
Câu hỏi thường gặp
Trò chuyện AI với bộ nhớ vector là gì?
Trò chuyện AI với bộ nhớ vector lưu tin nhắn, tệp và dữ kiện dưới dạng biểu diễn nhúng, sau đó truy xuất các kết quả khớp gần nhất khi bạn đặt câu hỏi. Những kết quả khớp đó được đưa vào cửa sổ ngữ cảnh của mô hình để phản hồi có thể dùng lịch sử và tài liệu của bạn. Trên Jenova, khả năng truy xuất này được tích hợp trong các tác nhân chuyên biệt thay vì được cung cấp như một cơ sở dữ liệu riêng biệt mà bạn phải duy trì.
Jenova có miễn phí để dùng cho trò chuyện AI với bộ nhớ vector không?
Có. Gói miễn phí bao gồm các tính năng cốt lõi với mức sử dụng hằng tháng giới hạn. Các gói trả phí tăng dung lượng sử dụng và thêm các tùy chọn như lựa chọn mô hình tùy chỉnh. Mức sử dụng được đặt lại vào ngày thanh toán, với toàn bộ hạn mức khả dụng ngay từ ngày đầu thay vì được cấp nhỏ giọt mỗi ngày.
Điều này khác gì so với chatbot “lưu ký ức”?
Nhiều sản phẩm lưu một danh sách ngắn các dữ kiện hoặc bản ghi hội thoại luân phiên. Bộ nhớ vector truy xuất theo độ tương đồng ngữ nghĩa trên lịch sử không giới hạn và tri thức đính kèm, gần với RAG hơn là một tờ giấy ghi chú. Nghiên cứu độc lập về bộ nhớ dài hạn cho tác nhân trong môi trường vận hành xem bộ nhớ có khả năng mở rộng là một vấn đề hệ thống độc lập — không phải nút bật tắt trong cài đặt. OpenAI cũng đã mở rộng khả năng ChatGPT tham chiếu ngữ cảnh trò chuyện trước đó; câu hỏi về kiến trúc là liệu bộ nhớ có phải kho tách biệt của nhà cung cấp hay là hạ tầng nằm dưới mọi quy trình công việc bạn vận hành.
Tôi có thể neo cuộc trò chuyện vào tài liệu của riêng mình không?
Có. Hãy đính kèm các tệp cần được ưu tiên hơn kiến thức sẵn có của mô hình — thông số kỹ thuật, đề cương môn học, bản ghi, hướng dẫn thương hiệu. Truy xuất ưu tiên kho dữ liệu đó khi bạn hỏi các câu liên quan, giúp giảm ảo giác trên tài liệu riêng tư. Writing Assistant có thể tiếp tục sử dụng các mẫu đó cho giọng văn; một tác nhân nghiên cứu có thể tiếp tục sử dụng chúng cho các tuyên bố.
Trò chuyện AI với bộ nhớ vector có hoạt động trên di động không?
Có. Web, iOS và Android chia sẻ lịch sử, cài đặt và bộ nhớ. Tính năng chuyển giọng nói thành văn bản có sẵn khi bạn không thể gõ. Kịch bản du lịch ở trên là thiết kế hướng đến: truy xuất các vector giống nhau từ điện thoại mà bạn đã xây dựng tại bàn làm việc.
Tác nhân có bộ nhớ có đủ chính xác cho các chủ đề nhạy cảm không?
Bộ nhớ cải thiện tính nhất quán; nó không khiến mô hình không thể sai. Các khảo sát RAG vẫn chỉ ra chất lượng truy xuất, ngữ cảnh nhiễu và tính trung thực là những vấn đề còn bỏ ngỏ (Sharma, 2025). Với quyết định về sức khỏe, pháp lý hoặc tài chính, hãy xem tác nhân là công cụ hỗ trợ và kiểm chứng bằng nguồn gốc. Personal Therapist có thể ghi nhớ những chủ đề bạn yêu cầu lưu giữ, điều này hữu ích cho tính liên tục — không phải sự thay thế cho dịch vụ chăm sóc có chuyên môn được cấp phép.
Bộ nhớ vector là giao diện trò chuyện cuối cùng cũng có thể tích lũy
Trò chuyện AI không trạng thái lãng phí đầu vào khan hiếm duy nhất của bạn: thời gian dành để giải thích bản thân. Trò chuyện AI với bộ nhớ vector lưu ý nghĩa dưới dạng biểu diễn nhúng, truy xuất khi cần và cho phép các tác nhân chuyên biệt tiếp tục công việc. Thị trường cho tầng truy xuất này đang tăng trưởng vì nỗi đau là phổ quát — từ tìm kiếm ngữ nghĩa trong các hệ thống vận hành đến ngữ cảnh cá nhân nên thuộc về người dùng.
Jenova đặt bộ nhớ đó dưới các quy trình nghiên cứu, lập trình, tường thuật và lập kế hoạch mà không yêu cầu bạn vận hành cơ sở dữ liệu vector. Hãy tiếp tục một báo cáo Deep Research, một dịch vụ Python hoặc một chiến dịch nhập vai như thể tác nhân đã luôn ở cùng phòng với bạn.
Khám phá toàn bộ thư viện tác nhân tại Jenova.
Dành cho nhà phát triển: Mọi tác nhân trong bài viết này đều có thể sử dụng theo lập trình thông qua Jenova API — tích hợp bộ nhớ vector, truy xuất và các tác nhân đa mô hình vào ứng dụng của bạn chỉ với một lần tích hợp. Tài liệu đầy đủ →