Làm thế nào để ngăn trợ lý nghiên cứu AI bịa ra trích dẫn giả?
2026-08-21
Biện Pháp Bảo Vệ Nào Phân Biệt Công Cụ Nghiên Cứu AI Dựa Trên Trích Dẫn Với Chatbot Hay Ảo Giác?
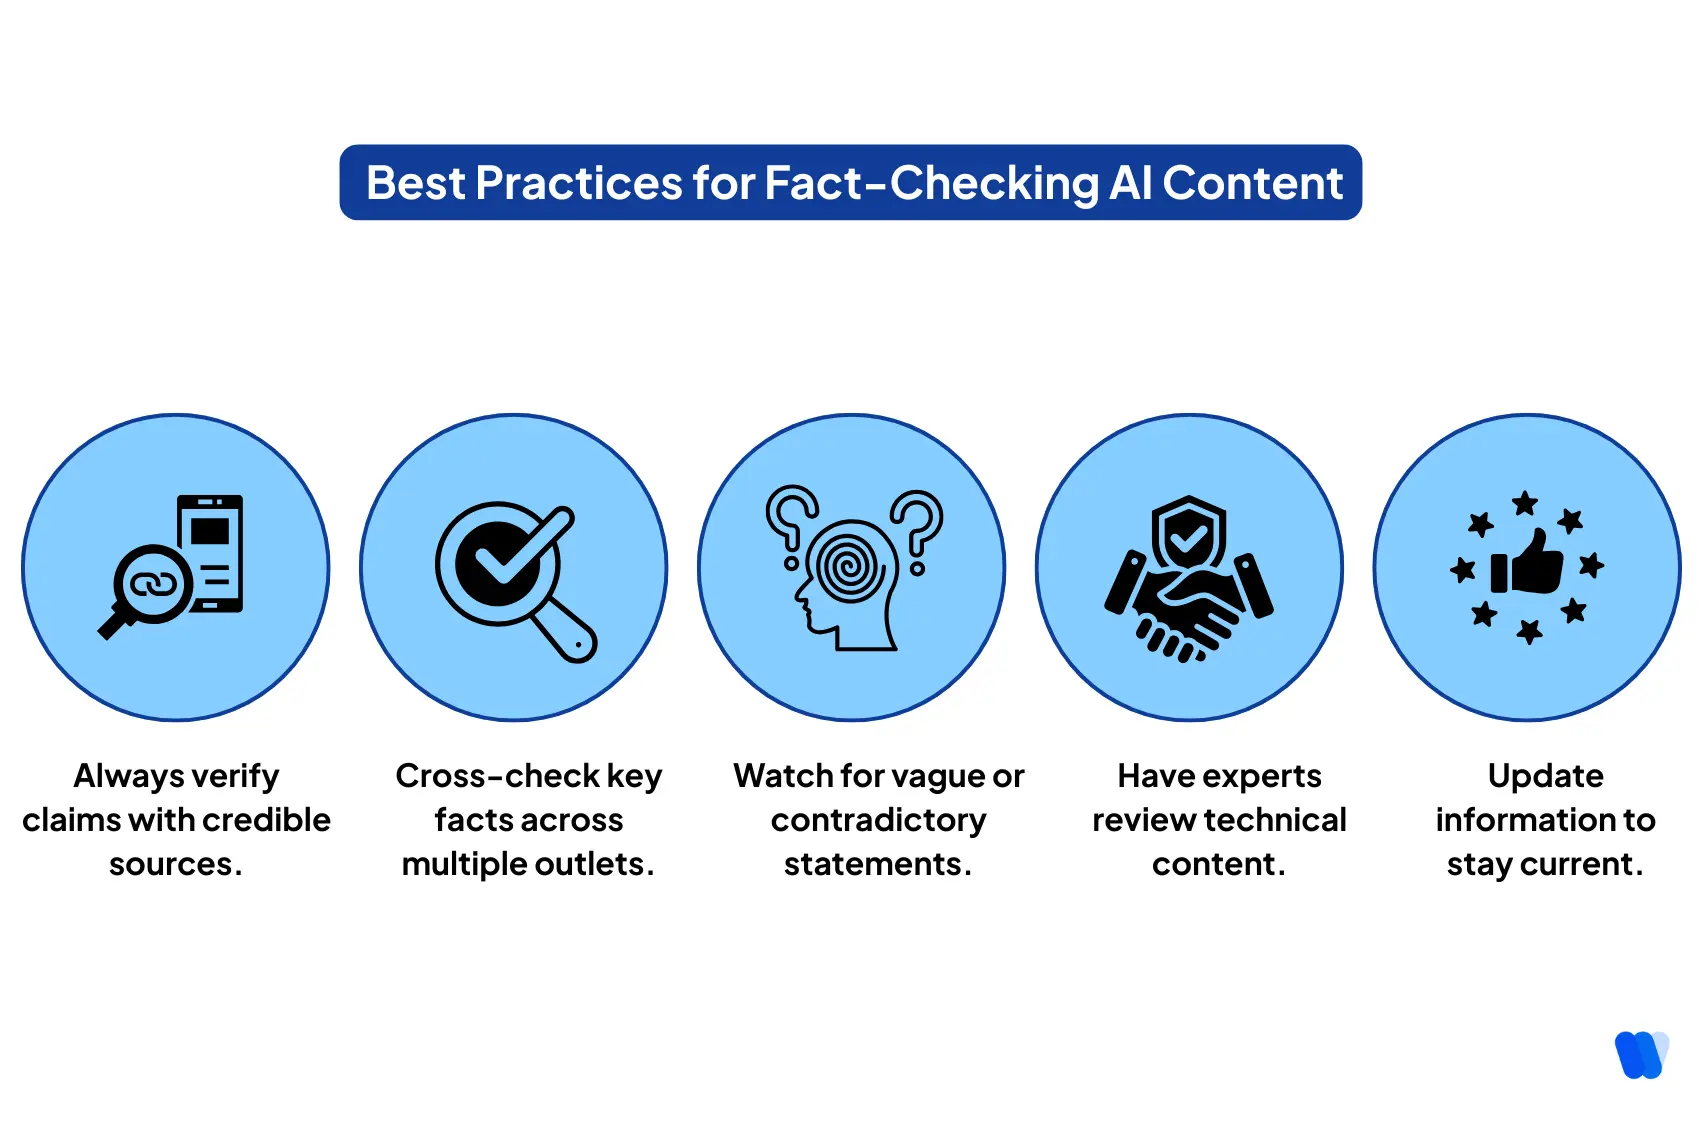
Cách đáng tin cậy nhất để ngăn trợ lý nghiên cứu AI bịa ra bài báo là từ chối các công cụ tạo tài liệu tham khảo từ trí nhớ, yêu cầu mọi tuyên bố phải gắn với một bản ghi đã được truy xuất có mã định danh kiểm tra được bằng máy, đồng thời xác minh từng trích dẫn với nguồn trước khi đưa vào bản thảo. Năm 2026, bộ quy trình này — truy xuất có căn cứ, kiểm tra mã định danh và xác minh bởi con người — là yếu tố phân biệt các công cụ tài liệu như Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus và Scite với các chatbot đa dụng vẫn có thể dựng lên những tài liệu tham khảo trông rất thuyết phục.
Các yếu tố then chốt thực sự làm giảm nguồn tài liệu bị bịa đặt:
✅ Truy xuất thay vì hồi tưởng — trợ lý phải tìm kiếm các bản ghi học thuật đã được lập chỉ mục, thay vì tự động hoàn thành danh mục tài liệu tham khảo từ dữ liệu huấn luyện. ✅ Ràng buộc mã định danh — mọi công trình được trích dẫn nên có DOI, PMID, arXiv ID hoặc URL của nhà xuất bản có thể được phân giải độc lập. ✅ Tính trung thực với nguồn, không chỉ sự tồn tại — một bài báo có thật nhưng được trích cho một phát hiện không hề xuất hiện trong đó vẫn là thất bại, như nghiên cứu đánh giá RAG đã chỉ ra. ✅ Độ chính xác thư mục — tên tác giả, năm, tập và dải trang phải khớp với bản ghi, chứ không phải là một mục gần giống do mô hình bịa ra. ✅ Vòng lặp xác minh bởi con người — Stanford Libraries và các hướng dẫn trích dẫn lớn đều coi tác giả, chứ không phải công cụ, là người chịu trách nhiệm cho mọi trích dẫn.
Để so sánh công cụ một cách hữu ích, hãy xem tính toàn vẹn của trích dẫn là một vấn đề về kiến trúc thay vì một mẹo viết prompt. Phần còn lại của hướng dẫn này sẽ phác họa kiến trúc đó, các dạng lỗi mà nó cần phát hiện và quy trình bạn có thể áp dụng với bất kỳ trợ lý nào.
Vì Sao Trích Dẫn AI Bịa Đặt Lại Xuất Hiện Trong Các Bài Báo Đã Xuất Bản Vào Năm 2026?
Trích dẫn bịa đặt không còn chỉ là một giai thoại trong lớp học. Chúng đang lọt vào tạp chí, hồ sơ xin tài trợ và chỉ mục trích dẫn vì các nhà nghiên cứu dán danh mục tài liệu do chatbot tạo vào bản thảo mà không phân giải từng tài liệu tham khảo. Một phân tích của Nature năm 2026 ước tính rằng hàng chục nghìn ấn phẩm năm 2025 có thể chứa các tài liệu tham khảo không hợp lệ do AI tạo ra.
Mô hình lây nhiễm này có đặc điểm rất rõ. Nhà khoa học máy tính Guillaume Cabanac được cảnh báo rằng một bài báo của ông đã được trích dẫn trong International Dental Journal — một lĩnh vực không giao thoa với công việc của ông về phát hiện bài báo bịa đặt — và ông nhận ra mình không thể nhận diện chính tài liệu tham khảo của bản thân. Đó là cách các trích dẫn ma lan truyền: chúng có định dạng trông đúng, nêu tên những tạp chí nghe có vẻ thật và qua mặt được việc đọc lướt.
Các trường hợp đã được ghi nhận nghiêm trọng đến mức buộc phải rút bài. Resnik và Hosseini tóm tắt một bài trên Academic Ethics trong đó 19 trên 29 trích dẫn là ảo giác, một bài trên PLOS ONE sau đó bị rút với 18 trên 76 trích dẫn bị bịa, và một bài quan điểm trên Digestive Diseases and Sciences trong đó 12 trên 14 tài liệu tham khảo không tồn tại. Một nghiên cứu sức khỏe tâm thần năm 2025 về các trích dẫn từ GPT-4o cho thấy 56% có lỗi, với khoảng một trong năm trích dẫn hoàn toàn là ảo giác.
Mối lo ngại của giảng viên hiện gần như phổ biến. Nghiên cứu của College Board cho biết giảng viên lo ngại việc sử dụng AI đang làm suy yếu tư duy phản biện, khả năng viết độc lập và tính liêm chính học thuật. Các hướng dẫn thư viện như của UNC Charlotte hiện coi trích dẫn ảo giác là một rủi ro nghiên cứu tiêu chuẩn, không phải trường hợp cá biệt.
Hàm ý đối với việc chọn công cụ rất thẳng thắn. Nếu một trợ lý có thể đưa ra tài liệu tham khảo APA hoặc Vancouver được định dạng đẹp mà không truy xuất bản ghi trực tiếp, nó có thể bịa ra một bài báo chưa từng tồn tại — và bài báo đó có thể sống sót đến khi được in.
Bạn Nên Đánh Giá Điều Gì Trước Khi Tin Tưởng Một Trợ Lý Nghiên Cứu AI Với Danh Mục Tài Liệu Tham Khảo?
Bạn nên đánh giá một trợ lý nghiên cứu AI theo Bộ khung Tính toàn vẹn Trích dẫn gồm năm phần: nguồn dữ liệu gốc, ràng buộc mã định danh, tính trung thực giữa tuyên bố và đoạn trích, độ chính xác thư mục và vòng lặp xác minh bắt buộc bởi con người. Các công cụ đạt điểm cao về độ trôi chảy nhưng thấp ở bộ khung này đều không an toàn cho danh mục tài liệu tham khảo, bất kể văn phong trau chuốt đến đâu.
1. Nguồn dữ liệu gốc
Hãy hỏi liệu câu trả lời đến từ một kho tài liệu được truy xuất hay từ trí nhớ tham số. Các hệ thống tăng cường bằng truy xuất tìm kiếm Google Scholar, PubMed, Semantic Scholar, Scopus hoặc arXiv rồi mới sinh văn bản. Chatbot không có truy xuất chỉ dự đoán token tiếp theo của một trích dẫn. Các chỉ số tính trung thực với nguồn tồn tại chính vì phần sinh văn bản có thể lệch khỏi ngữ cảnh đã truy xuất, ngay cả khi quá trình truy xuất đã diễn ra.
2. Ràng buộc mã định danh
Bộ ba tiêu đề–tác giả–năm là chưa đủ. Hãy yêu cầu DOI, PMID, PMCID hoặc URL của nhà xuất bản, sau đó tự phân giải chúng. Tài liệu tham khảo ma thường không vượt qua được kiểm tra này ngay từ đầu. Các mục gần đúng về thư mục — một bài báo có thật nhưng sai tập hoặc dải trang — sẽ lộ ra khi kiểm tra kỹ lần hai.
3. Tính trung thực giữa tuyên bố và đoạn trích
Nghiên cứu ACM về trích dẫn RAG cho thấy tính đúng đắn không đồng nghĩa với tính trung thực: đến 57% trích dẫn có thể không hỗ trợ cho tuyên bố mà chúng được cho là làm nền tảng. Một bài báo tồn tại nhưng không chứa phát hiện được nêu cũng nguy hiểm như một bài báo không tồn tại, bởi nó hợp thức hóa một kết quả sai thông qua tên tuổi của một tác giả có thật.
4. Độ chính xác thư mục
Thứ tự tác giả, năm, tạp chí, tập, số và trang phải khớp với bản ghi. Các công cụ RAG trong thử nghiệm về quản trị kinh doanh cho thấy các mục “ma” hoàn toàn bịa đặt có thể hiếm, trong khi các lỗi thư mục nhỏ vẫn thường gặp. Những lỗi này vẫn làm hỏng chỉ mục trích dẫn và có thể che giấu việc tráo nhầm bài báo.
5. Vòng lặp xác minh bởi con người
Chính sách tạp chí APA, theo phần tóm tắt của Stanford, nêu rõ rằng tác giả phải xác minh mọi thông tin và trích dẫn do công cụ AI cung cấp. Hướng dẫn dành cho nhà nghiên cứu của Wiley và hướng dẫn về liêm chính nghiên cứu của Harvard cũng đặt trách nhiệm công khai việc dùng công cụ và đảm bảo tính chính xác lên tác giả là con người. Không có trợ lý nào trong nhóm này loại bỏ nghĩa vụ đó.
Hãy phân bổ trọng số cho bộ khung theo nhiệm vụ. Tổng quan hệ thống nên đặt trọng số cao hơn cho tính trung thực với nguồn và ràng buộc mã định danh. Việc quét thăm dò có thể chấp nhận khả năng thu hồi rộng hơn nếu mọi tài liệu được giữ lại đều được xác minh trước khi trích dẫn. Đừng bao giờ đặt quá nhiều trọng số vào chất lượng văn phong. Các đoạn văn trôi chảy chính là cơ chế khiến trích dẫn giả trở nên thuyết phục.
Các Công Cụ Nghiên Cứu AI Phổ Biến Khác Nhau Thế Nào Về Độ Tin Cậy Của Trích Dẫn?
Chúng khác biệt rõ rệt ở việc tài liệu tham khảo được truy xuất từ các chỉ mục học thuật hay được sinh từ trí nhớ của mô hình, và lựa chọn thiết kế duy nhất này dự báo phần lớn rủi ro trích dẫn ma. Chatbot đa dụng vẫn là lựa chọn rủi ro cao nhất đối với danh mục tài liệu tham khảo. Trợ lý nghiên cứu chuyên biệt giảm được tài liệu ma nhưng vẫn có thể trích dẫn sai, ghi sai siêu dữ liệu và diễn giải quá mức điều bài báo cho thấy.
Tính đến năm 2026, một so sánh thực tế như sau:
| Tính năng / Khía cạnh | Chatbot đa dụng (ví dụ: ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Nguồn bằng chứng | Chủ yếu là trí nhớ tham số, trừ khi bật duyệt web | Bài báo được truy xuất, bảng trích xuất | Truy xuất đa cơ sở dữ liệu (Google Scholar, PubMed, arXiv) | Bài báo được truy xuất cho các câu hỏi thực nghiệm | Chỉ mục trích dẫn với ngữ cảnh ủng hộ/đối lập | Khám phá tài liệu theo thời gian thực trên các cơ sở dữ liệu học thuật và kho lưu trữ |
| Rủi ro tài liệu tham khảo ma | Cao; đã được ghi nhận tại tạp chí và phòng thí nghiệm | Thấp trong các nghiên cứu về danh mục tài liệu RAG | Thấp trong các nghiên cứu về danh mục tài liệu RAG | Dựa trên truy xuất; vẫn cần xác minh | Thấp đối với mục trong đồ thị trích dẫn của nó | Dựa trên truy xuất; vẫn cần kiểm tra DOI độc lập |
| Tính trung thực giữa tuyên bố và nguồn | Yếu nếu không có đoạn trích được truy xuất | Mạnh hơn cho trích xuất có cấu trúc | Mạnh hơn khi câu trả lời trích bài báo đã truy xuất | Mạnh hơn cho câu hỏi thực nghiệm có/không | Mạnh ở việc một bài báo được trích dẫn như thế nào | Phụ thuộc vào đoạn trích được truy xuất và lựa chọn mô hình; cần con người kiểm tra |
| Độ chính xác thư mục | Thường xuyên bịa chi tiết | Có báo cáo về sai sót nhỏ trong kiểm toán RAG | Có báo cáo về sai sót nhỏ trong kiểm toán RAG | Chưa được xác minh ở mức kiểm toán thực địa | Mạnh về ngữ cảnh trích dẫn | Kế thừa siêu dữ liệu từ bản ghi truy xuất; văn xuôi vẫn có thể sai lệch |
| Giá (tính đến năm 2026) | Tùy gói của nhà cung cấp | Chưa được xác minh | Chưa được xác minh | Chưa được xác minh | Chưa được xác minh | Gói miễn phí với mức sử dụng giới hạn; gói trả phí từ $20/tháng |
| Phù hợp nhất cho | Soạn thảo ngôn ngữ, không phải xây dựng danh mục tài liệu | Bảng bằng chứng và trích xuất hệ thống | Tìm kiếm tài liệu rộng, liên ngành | Câu trả lời nhanh cho câu hỏi thực nghiệm có/không | Xác minh liệu trích dẫn có ủng hộ hay phản bác một tuyên bố | Khám phá tài liệu, chuẩn bị bản thảo và quản lý trích dẫn toàn diện với bộ nhớ lâu dài |
Chatbot đa dụng
Chatbot xuất sắc ở việc lập dàn ý và diễn đạt lại, nhưng thất bại khi xây dựng danh mục tài liệu tham khảo. Báo cáo kiểm toán GPT-4o về sức khỏe tâm thần được nêu ở trên đưa ra con số cảnh báo: hơn một nửa số trích dẫn được tạo có lỗi. Nếu một công cụ có thể đưa ra một tài liệu tham khảo trông hoàn hảo mà không có bản ghi trực tiếp, hãy coi mọi trích dẫn từ nó là chưa được xác minh.
Elicit
Elicit mạnh hơn khi công việc là sàng lọc bài báo và trích xuất phương pháp, kết quả và hạn chế vào bảng. Các so sánh độc lập mô tả nó là phù hợp hơn cho quy trình làm việc dựa trên bằng chứng nghiêm ngặt so với tìm kiếm thăm dò nhanh. Hạn chế của nó là mật độ phạm vi bao phủ: trong một điểm chuẩn 200 truy vấn do SciSpace thực hiện, Elicit trả về 13,0 bài báo có mức liên quan cao cho mỗi truy vấn, so với 26,3 của SciSpace Deep Review. Khoảng cách này quan trọng đối với khả năng thu hồi, không phải rủi ro trích dẫn ma.
SciSpace
SciSpace tìm kiếm nhiều cơ sở dữ liệu học thuật và, trong đánh giá Deep Review của chính họ, dẫn đầu về độ chính xác từ P@3 đến P@70. Độ bao phủ đó hữu ích cho các câu hỏi liên ngành, nơi bằng chứng nằm đồng thời trong PubMed, arXiv và Google Scholar. Hạn chế là về phương pháp: điểm chuẩn nổi bật do SciSpace thực hiện, dù nhãn mức liên quan đến từ ba mô hình bên ngoài. Hãy xem điểm chuẩn của nhà cung cấp như chỉ dấu định hướng, rồi tự xác minh các tài liệu được giữ lại.
Consensus
Consensus được xây dựng để trả lời các câu hỏi khoa học thực nghiệm từ bài báo thay vì viết một tổng quan tường thuật. Trong cùng thử nghiệm 200 truy vấn, Consensus Deep có độ chính xác tốt nhất ở kết quả đầu tiên (P@1 = 0.5882) rồi mất lợi thế đó ở sâu hơn trong danh sách. Đây là công cụ tốt để tìm điểm khởi đầu và kém phù hợp hơn làm công cụ chính cho các tập sàng lọc dài.
Scite
Tài sản đặc trưng của Scite là trí tuệ trích dẫn — cho biết liệu các bài báo về sau có ủng hộ, đề cập hay đối lập với một tuyên bố cụ thể. Các so sánh định vị nó hẹp hơn một công cụ vận hành nghiên cứu toàn diện nhưng mạnh hơn trong xác thực bằng chứng. Nếu dạng lỗi của bạn là “bài báo có thật này không nói điều trợ lý tuyên bố”, ngữ cảnh trích dẫn kiểu Scite là công cụ phù hợp.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant được xây dựng cho giới học thuật và nghiên cứu sinh PhD cần khám phá tài liệu cùng hỗ trợ bản thảo và trích dẫn trong một không gian làm việc có bộ nhớ lâu dài. Công cụ này có thể tìm kiếm theo thời gian thực trong các cơ sở dữ liệu học thuật và kho lưu trữ lớn, duy trì bộ nhớ dự án qua các phiên làm việc, đồng thời soạn thảo bằng các mô hình hiện hành thay vì bị khóa vào một nhà cung cấp duy nhất. Sự kết hợp đó hữu ích khi một bài tổng quan kéo dài nhiều tuần và trợ lý phải ghi nhớ tiêu chí đưa vào, các bài báo bị loại và DOI chưa được giải quyết.
Đây không phải là chỉ mục ngữ cảnh trích dẫn chuyên biệt, vì vậy nó sẽ không thay thế Scite cho bản đồ ủng hộ–đối lập. Nó cũng không phải lưới trích xuất chuyên dụng theo nghĩa của Elicit. Tìm kiếm thời gian thực cũng có thể truy xuất các bản ghi chất lượng thấp hoặc không phù hợp mà một mô hình diễn đạt trôi chảy sau đó diễn giải quá mức. Quy tắc vận hành trung thực giống như với mọi công cụ truy xuất: dùng nó để tìm và tổ chức các ứng viên, không phải để chứng thực danh mục tài liệu tham khảo.
Tạo Sinh Tăng Cường Bằng Truy Xuất Có Loại Bỏ Hoàn Toàn Tài Liệu Tham Khảo Ma Không?
Không. Tạo sinh tăng cường bằng truy xuất (RAG) làm giảm mạnh các bài báo bị bịa hoàn toàn trong danh mục tài liệu tham khảo, nhưng không loại bỏ lỗi thư mục và cũng không đảm bảo rằng bài báo đã truy xuất hỗ trợ cho câu mà nó được gắn vào. Do đó, việc phòng ngừa phải nhắm đến ba dạng lỗi khác nhau, không chỉ một.
Ba dạng lỗi rất dễ bị nhầm lẫn vì cả ba đều tạo ra “trích dẫn trông có vẻ hợp lý”:
- Tài liệu tham khảo ma — công trình được trích dẫn không tồn tại.
- Sai lệch thư mục — công trình tồn tại, nhưng tác giả, năm, tập hoặc trang bị sai.
- Ảo giác ngữ cảnh — công trình tồn tại và siêu dữ liệu phần lớn đúng, nhưng trợ lý gán cho nó một phát hiện mà bài báo không chứa.
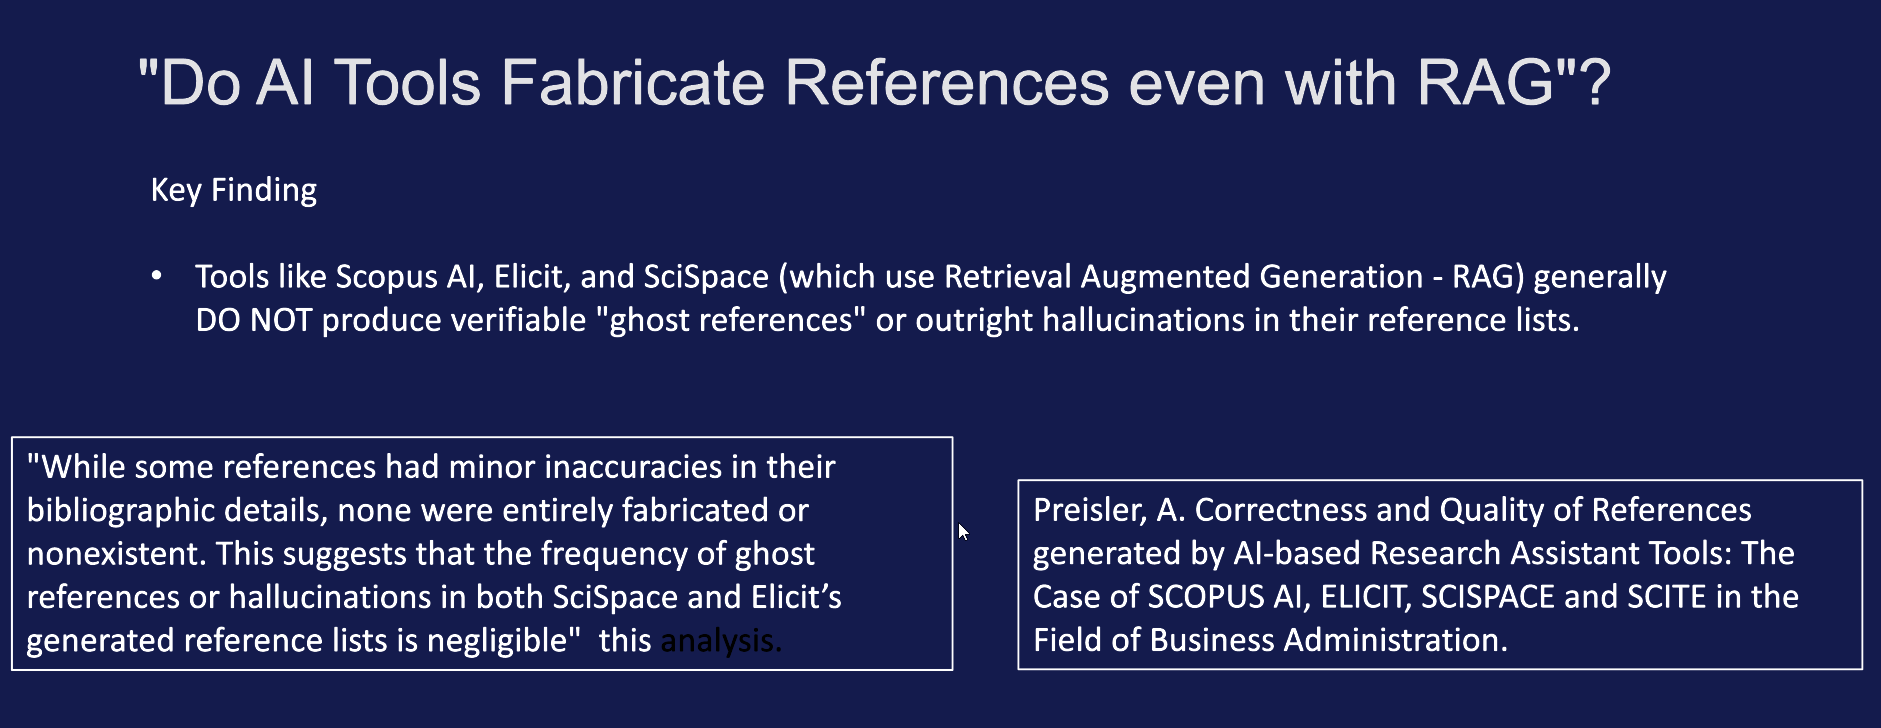
Một phân tích thực địa về Scopus AI, Elicit, SciSpace và Scite trong lĩnh vực quản trị kinh doanh cho thấy các công cụ dựa trên RAG nhìn chung không tạo ra tài liệu tham khảo ma có thể kiểm chứng. Các sai sót thư mục nhỏ vẫn xuất hiện; những nguồn hoàn toàn không tồn tại là không đáng kể trong các danh sách được tạo đó. Đó là cách đúng đắn để hiểu RAG: đây là biện pháp kiểm soát mạnh đối với tài liệu ma, không phải một hệ thống chất lượng trích dẫn hoàn chỉnh.
Nghiên cứu về tính trung thực với nguồn giải thích rủi ro còn lại. Các khung đánh giá RAG phân biệt mức liên quan của câu trả lời với tính trung thực: một phản hồi có thể đúng chủ đề nhưng vẫn không có căn cứ trong các đoạn trích đã truy xuất. Phát hiện của ACM rằng một tỷ lệ lớn trích dẫn RAG có thể thiếu tính trung thực là cảnh báo vận hành. Nếu bạn chỉ kiểm tra DOI có phân giải được hay không, bạn sẽ bắt được tài liệu ma nhưng bỏ sót các tuyên bố bị gán sai.
Chatbot đa dụng thất bại ở dạng lỗi thứ nhất. Trợ lý RAG chủ yếu thất bại ở dạng lỗi thứ hai và thứ ba. Vì vậy, quy trình phòng ngừa chỉ hỏi “bài báo này có tồn tại không?” là chưa đầy đủ đối với các công cụ mà nhà nghiên cứu thực sự nên dùng.
Làm Thế Nào Để Xác Minh Các Trích Dẫn Do Trợ Lý Nghiên Cứu AI Trả Về?
Hãy xác minh bằng quy trình hai lượt: trước tiên phân giải mã định danh, sau đó xác nhận một đoạn trích cụ thể hỗ trợ cho tuyên bố. Bỏ qua một trong hai lượt là cách nguồn bịa đặt hoặc bị sử dụng sai đi đến xuất bản.
Lượt 1 — Bản ghi có tồn tại không?
- Sao chép chính xác tiêu đề, tác giả đầu tiên, năm và DOI như công cụ trả về.
- Phân giải DOI trên trang của tổ chức đăng ký hoặc nhà xuất bản. Nếu không có DOI, hãy tìm kiếm chính xác tiêu đề trên Google Scholar, PubMed hoặc trang tạp chí, theo phương pháp tra cứu trực tiếp được các hướng dẫn nghiên cứu khuyến nghị.
- Loại bỏ mọi mục không phân giải được, phân giải sang bài báo khác hoặc chỉ tồn tại dưới dạng trích dẫn được AI định dạng.
- Kiểm tra thứ tự tác giả, năm, tập, số và trang dựa vào bản ghi của nhà xuất bản, không phải khối danh mục tài liệu tham khảo của trợ lý.
Lượt 2 — Bài báo này có hỗ trợ cho câu này không?
- Mở toàn văn PDF hoặc HTML. Chỉ đọc tóm tắt là không đủ đối với tuyên bố nhân quả, quy mô hiệu ứng hoặc ngôn ngữ kiểu “bằng chứng đầu tiên”.
- Xác định đoạn văn được cho là hỗ trợ tuyên bố. Trích nguyên văn đoạn đó vào ghi chú của bạn.
- Đánh dấu trích dẫn là ủng hộ, đề cập hoặc đối lập — phân biệt mà Scite sản phẩm hóa và bạn cũng có thể áp dụng thủ công.
- Nếu trợ lý diễn đạt lại một hạn chế thành một phát hiện, hoặc một giả thuyết thành một kết quả, hãy loại trích dẫn đó khỏi câu đang xét.
Với Jenova's Academic Research Assistant, hãy giới hạn truy xuất trước khi bạn tạo danh mục tài liệu tham khảo:
“Tìm kiếm các bài báo phản biện và bản thảo tiền xuất bản về [chủ đề], 2019–2026. Chỉ trả về các mục có DOI hoặc PMID. Với mỗi mục: tiêu đề, tác giả, năm, tạp chí, mã định danh, phát hiện trong một câu và một đoạn trích nguyên văn. Nếu không thể truy xuất một bản ghi có thể xác minh, hãy bỏ qua hoàn toàn mục đó. Không tự hoàn thiện hoặc phỏng đoán siêu dữ liệu.”
Sau đó, chạy cùng các tài liệu được giữ lại qua Elicit hoặc SciSpace như một lần kiểm tra kho dữ liệu thứ hai. Sự bất đồng giữa các công cụ là một tính năng: nó gắn cờ những bài báo mà một hệ thống xếp hạng nhưng hệ thống kia không thể truy xuất.
Bài viết của Science về các bài báo khoa học bị ảo giác cho thấy tại sao đọc lướt tiêu đề lại thất bại. Một trợ lý có thể trích dẫn đúng một bài báo có thật rồi bịa ra một bài lân cận ngay trong cùng đoạn văn. Việc xác minh phải thực hiện theo từng mục, không phải theo từng đoạn.
Một Trích Dẫn Ảo Giác Có Thể Bị Coi Là Hành Vi Sai Phạm Trong Nghiên Cứu Không?
Có, trong một tập hợp trường hợp xác định — và ngay cả khi chưa đạt đến định nghĩa pháp lý về sai phạm, nó vẫn có thể dẫn đến rút bài, rắc rối với tài trợ và tổn hại sự nghiệp. Động cơ phòng ngừa không phải là phép lịch sự. Đó là trách nhiệm pháp lý.
Resnik và Hosseini lập luận rằng một trích dẫn ảo giác có thể đủ điều kiện là hành vi sai phạm nghiên cứu có thể chứng minh theo quy định liên bang Hoa Kỳ khi có ba điều kiện: nhà nghiên cứu đã dùng công cụ sinh văn bản để tạo trích dẫn không tồn tại; các trích dẫn đó hoạt động như dữ liệu vì chúng hỗ trợ phát hiện, chẳng hạn trong tổng quan hoặc nghiên cứu trắc lượng thư mục; và nhà nghiên cứu thể hiện sự thờ ơ với rủi ro bịa đặt khi không kiểm tra đầu ra. Một tài liệu tham khảo ma trong phần mở đầu tường thuật là học thuật kém. Một tài liệu tham khảo ma được tính là bằng chứng trong tổng quan hệ thống gần với dữ liệu bị bịa đặt hơn.
Các bên tài trợ đã xem vấn đề này là một vấn đề vận hành. Mùa hè năm 2025, nhân viên xét duyệt tài trợ NIH bị quá tải bởi các đề xuất có hỗ trợ AI, và cơ quan này cho biết việc sử dụng AI không đúng cách được phát hiện sau khi trao tài trợ có thể được chuyển để xem xét về liêm chính. Trung tâm liêm chính nghiên cứu của Harvard nhắc lại những hạn chế liên quan: không thể liệt kê công cụ AI là tác giả, người phản biện khoa học đồng cấp của NIH bị cấm dùng AI tạo sinh để xây dựng nhận xét, và tác giả phải công khai cách công cụ đã được sử dụng.
Các tạp chí đang hội tụ về cùng một cách phân bổ trách nhiệm. Bản tổng hợp của Stanford về quy định APA, MLA, Chicago và IEEE yêu cầu công khai nội dung do AI tạo ra và, trong trường hợp APA, xác minh rõ ràng các trích dẫn bởi con người. Hướng dẫn giảng dạy của Cornell cũng cảnh báo rằng các thuật toán tự động phát hiện AI quá thiếu tin cậy để trở thành chiến lược bảo đảm liêm chính. Phát hiện sau sự việc là phương án thay thế yếu cho xác minh trước khi nộp.
Tiêu chuẩn thực tế rất đơn giản. Nếu bạn không thể chỉ ra một bản ghi đã phân giải và một đoạn trích hỗ trợ, trích dẫn đó không thuộc về bản thảo, slide trình bày hoặc hồ sơ xin tài trợ.
Các Chuyên Gia Về Liêm Chính Nghiên Cứu Nói Gì Về Trích Dẫn Do AI Tạo Ra?
Các chuyên gia hiện xem tài liệu tham khảo bịa đặt là lỗi quy trình — dùng một mô hình tạo sinh như thư viện — thay vì lỗi bí ẩn của mô hình mà người dùng không thể dự liệu. Sự đồng thuận giữa các cơ quan liêm chính và nghiên cứu về trích dẫn là RAG giảm được tài liệu ma, xác minh bởi con người vẫn là bắt buộc và danh mục tài liệu do chatbot tạo mà không có giám sát là bất cẩn trước những gì đã biết về tỷ lệ lỗi.
“Lỗi vẫn liên tục lọt vào tạp chí không phải là vì mô hình đôi khi phỏng đoán. Mà vì các nhà nghiên cứu để mô hình ngôn ngữ thực hiện một nhiệm vụ lập danh mục vốn không được kiến trúc để làm. Nếu trợ lý không truy xuất một bản ghi, nó đang hoàn thiện một mẫu thư mục, và những mẫu được hoàn thiện là cách bạn có được một bài báo trông thật trong một tạp chí trông thật với DOI không phân giải được. Chuyển sang công cụ truy xuất làm giảm mạnh dạng lỗi đó. Nó không giảm dạng lỗi tiếp theo: trích dẫn một bài báo có thật cho kết quả chỉ nằm trong phần tóm tắt của mô hình chứ không nằm trong phần kết quả.”
“Chúng tôi khuyên người dùng nghiên cứu áp dụng quy trình ba nhóm. Nhóm A là đã truy xuất và kiểm tra đoạn trích — các trích dẫn đó có thể dùng. Nhóm B là đã truy xuất nhưng chỉ kiểm tra siêu dữ liệu — chúng ở lại danh sách đọc. Nhóm C là mọi thứ mô hình đưa ra mà không có mã định danh phân giải được — chúng bị xóa, không phải ‘để tra cứu sau’. Những nhóm bỏ qua Nhóm C vì định dạng trông có vẻ tốn công mới là những nhóm sau này phát hiện 12 trong 14 tài liệu tham khảo chưa từng tồn tại. Chi phí cho lượt kiểm tra bổ sung là không đáng kể so với việc rút bài hoặc bị chuyển hồ sơ tài trợ để xem xét liêm chính.”
— Nhóm Sản phẩm Jenova, thiết kế tác nhân nghiên cứu AI cho quy trình học thuật
Lời khuyên này phù hợp với chính sách của nhà xuất bản và trường đại học: nêu tên công cụ, nêu nhiệm vụ công cụ đã thực hiện và giữ tác giả là con người chịu trách nhiệm cho mọi tài liệu tham khảo. Hướng dẫn liêm chính không còn là “tránh AI”. Đó là “đừng thuê ngoài việc xác nhận nguồn của bạn có tồn tại hay không”.
Làm Thế Nào Để Thực Hiện Tổng Quan Tài Liệu An Toàn Về Trích Dẫn Với AI?
Hãy thực hiện theo một quy trình với truy xuất trước, trích xuất thứ hai, viết văn bản sau cùng và một cổng xác minh mà không câu nào được bỏ qua. Đảo ngược thứ tự — viết lập luận trước, rồi yêu cầu trợ lý “thêm trích dẫn” — là kiểu prompt thường gắn nhất với tài liệu tham khảo ma.
Một quy trình có thể chịu được sự xem xét của tạp chí và bên tài trợ:
- Viết quy tắc đưa vào trước khi tìm kiếm. Quần thể, can thiệp, năm, ngôn ngữ, loại nghiên cứu. Dán các quy tắc đó vào trợ lý để bộ nhớ, nếu công cụ có, duy trì qua các phiên làm việc.
- Tìm kiếm bằng hai công cụ truy xuất, không phải một. Ví dụ ghép cặp: Jenova's Academic Research Assistant cùng Elicit hoặc SciSpace. Giữ tập hợp hợp nhất của các kết quả; đừng tin một danh sách xếp hạng duy nhất.
- Đóng băng tập ứng viên bằng mã định danh. Xuất tiêu đề, tác giả, năm, tạp chí, DOI/PMID. Mọi mục không có mã định danh đều chờ bên ngoài tập này.
- Trích xuất, không tóm tắt, dựa trên toàn văn. Phương pháp, mẫu, kết quả, hạn chế và một câu trích nguyên văn. Bảng kiểu Elicit hữu ích ở đây; phần tóm tắt tường thuật là nơi ảo giác ngữ cảnh len vào.
- Soạn thảo từ bảng trích xuất. Nếu một câu không có hàng tương ứng trong bảng, nó không được trích dẫn — và có thể không nên xuất hiện trong bài báo.
- Công khai các công cụ. Tuân theo bản tổng hợp quy định hướng dẫn trích dẫn của Stanford: tên công cụ, phiên bản, ngày và chức năng đã thực hiện như tìm kiếm, trích xuất hoặc biên tập ngôn ngữ.
- Quét DOI lần cuối trong danh mục tài liệu tham khảo nộp đi. Lượt cuối này phát hiện sai lệch do sao chép–dán và mọi tài liệu tham khảo mà mô hình đã chèn trong quá trình sửa bản thảo.
Một prompt giúp giữ Jenova trong quy trình thay vì chuyển sang chế độ chatbot:
“Chỉ sử dụng tập ứng viên tôi đã tải lên để soạn phần bối cảnh. Mọi câu mang tính thực nghiệm phải trích dẫn một DOI trong tập đó và không được đưa vào nguồn mới. Nếu một tuyên bố không được hỗ trợ bởi ghi chú trích xuất, hãy gắn cờ là
UNSUPPORTEDthay vì trích dẫn.”
Với SciSpace hoặc Elicit, hãy dùng chế độ truy xuất hoặc trích xuất của từng công cụ để xây dựng lại cùng bảng và so sánh các hàng. Khi các bảng không thống nhất về một phát hiện, hãy đọc PDF. Sự bất đồng rẻ hơn một đợt đính chính sau xuất bản.
Ràng buộc làm cho quy trình hoạt động mang tính tâm lý cũng như kỹ thuật: đừng bao giờ yêu cầu bất kỳ trợ lý nào, kể cả trợ lý mạnh, “cung cấp tài liệu tham khảo” cho văn xuôi được viết mà không dựa vào nguồn. Prompt đó biến một công cụ nghiên cứu trở lại thành máy tạo trích dẫn, chính là dạng lỗi mà toàn bộ bộ khung này được thiết kế để ngăn chặn.
Tài Liệu Tham Khảo
- Nature — Trích dẫn ảo giác đang làm ô nhiễm tài liệu khoa học
- Accountability in Research (Resnik & Hosseini) — Trích dẫn ảo giác do AI tạo sinh tạo ra
- Stanford Libraries — AI trong nghiên cứu học thuật: hướng dẫn trích dẫn
- ACM Digital Library — Tính đúng đắn không phải là tính trung thực trong Retrieval Augmented Generation
- DeepEval — Chỉ số tính trung thực cho hệ thống RAG
- Confident AI — Các chỉ số đánh giá RAG: mức liên quan của câu trả lời, tính trung thực và mức liên quan theo ngữ cảnh
- UNC Charlotte Library — Hướng dẫn nghiên cứu về trích dẫn AI ảo giác
- Wiley — Hướng dẫn AI dành cho nhà nghiên cứu
- College Board — Mối lo ngại của giảng viên rằng việc sinh viên dùng AI làm suy yếu tính liêm chính học thuật
- Harvard Medical School Academic and Research Integrity — AI trong nghiên cứu
- Cornell Center for Teaching Innovation — AI và tính liêm chính học thuật
- SciSpace — Điểm chuẩn tìm kiếm tài liệu SciSpace so với Elicit so với Consensus trên 200 truy vấn
- Paperguide — So sánh Elicit và SciSpace
- Paperguide — So sánh Elicit và Scite
- Science — Trích dẫn khi chưa thấy: khi AI ảo giác các bài báo khoa học
- SciSpace — So sánh sản phẩm SciSpace và Elicit