AI đa mô hình có giảm điểm mù trong phân tích cổ phiếu hiệu quả hơn không?
2026-08-24
Bất đồng giữa các mô hình và kiểm tra tổ hợp phơi lộ rủi ro luận điểm ẩn như thế nào?
Đối chiếu chéo nhiều mô hình giúp giảm điểm mù và sự tự tin quá mức đáng tin cậy hơn phân tích cổ phiếu bằng một mô hình duy nhất, bởi bất đồng giữa các mô hình tự nó là một tín hiệu rủi ro chứ không phải phiền nhiễu cần lấy trung bình để loại bỏ. Năm 2026, một câu trả lời trôi chảy từ ChatGPT, Claude hoặc Gemini có thể tạo cảm giác như nghiên cứu đã hoàn tất. Chính sự trôi chảy đó là vấn đề. Một mô hình, một cửa sổ ngữ cảnh và một phân phối huấn luyện tạo ra một câu chuyện mạch lạc ngay cả khi số liệu đã cũ, hồ sơ bị đọc sai hoặc kịch bản giảm giá bị bỏ sót.
Điều thực sự phân biệt nghiên cứu cổ phiếu bằng AI cẩn trọng với phỏng đoán đầy tự tin:
✅ Neo vào nguồn — hồ sơ, dự báo và giá thị trường trực tiếp so với mốc cắt dữ liệu huấn luyện
✅ Đa dạng mô hình — nhiều hơn một nhà cung cấp, để dễ nhận ra thiên lệch từ tập dữ liệu chung
✅ Đa dạng vai trò — góc nhìn cơ bản, kỹ thuật, vĩ mô và danh mục thay vì một người tổng quát
✅ Hiển thị bất định — khoảng giá trị, xung đột và cờ “không thể xác minh” thay vì độ chính xác giả tạo
✅ Chi phí của lần xem xét thứ hai — đủ thấp để việc đối chiếu thực sự diễn ra trước khi tăng quy mô vị thế
Một quy tắc thực hành hữu ích là bài kiểm tra Bất đồng là Tín hiệu: coi đồng thuận giữa các mô hình là một giả thuyết, và coi xung đột giữa các mô hình là chương trình nghiên cứu. Phần còn lại của bài viết áp dụng bài kiểm tra này cho chatbot một mô hình, các công cụ chấm điểm chuyên dụng như Danelfin, công cụ nghiên cứu đặt trích dẫn lên trước như Perplexity, và các tác nhân cổ phiếu chuyên biệt của Jenova.
Vì sao sự tự tin quá mức vẫn tồn tại khi nhà đầu tư dùng một mô hình AI duy nhất?
Sự tự tin quá mức tồn tại vì một mô hình duy nhất trả về một câu chuyện được trau chuốt, còn những câu chuyện trau chuốt lại làm giảm ma sát vốn thường buộc người ta phải xem xét lần thứ hai. Tài chính hành vi xem sự tự tin quá mức là một thiên lệch có hệ thống, không phải khiếm khuyết tính cách. Trên thị trường, nó biểu hiện qua giao dịch quá mức, đặt cược tập trung và bỏ qua bằng chứng trái chiều.
Mô thức đó không biến mất khi nhà phân tích là AI. Nghiên cứu về sự tự tin quá mức và thiên lệch xác nhận trong giao dịch liên hệ thiên lệch này với vòng quay cao hơn, đa dạng hóa mỏng hơn và lợi nhuận yếu hơn. Một đánh giá năm 2025 về hành vi nhà đầu tư trong kỷ nguyên AI cho thấy các quyết định ghi đè tùy ý có thể xóa bỏ hiệu quả mà thuật toán mang lại, làm biến động tăng lên thay vì giảm xuống. Các công trình mới hơn mô tả “sự tự tin quá mức của thuật toán”: khi phân tích được giao cho một mô hình, người dùng coi đầu ra là khách quan hơn thực tế.
Một phiên làm việc với mô hình duy nhất khiến điều này trầm trọng hơn theo ba cách cơ học. Thứ nhất, mô hình được thưởng vì tính mạch lạc, nên nó lấp đầy khoảng trống thay vì công bố chúng. Thứ hai, người dùng không thấy bất đồng từ các bên ngang hàng, vốn là tín hiệu mà các tổ chức dùng để mở rộng khoảng tin cậy. Thứ ba, giao diện mang tính hội thoại, nên một con số sai vẫn xuất hiện trong văn xuôi đầy tự tin. Cảnh báo nhà đầu tư của SEC Hoa Kỳ về AI nêu rất thẳng: AI có thể tạo ra và lan truyền thông tin sai hoặc không chính xác, và nhà đầu tư nên xác minh các tuyên bố với chuyên gia đã đăng ký.
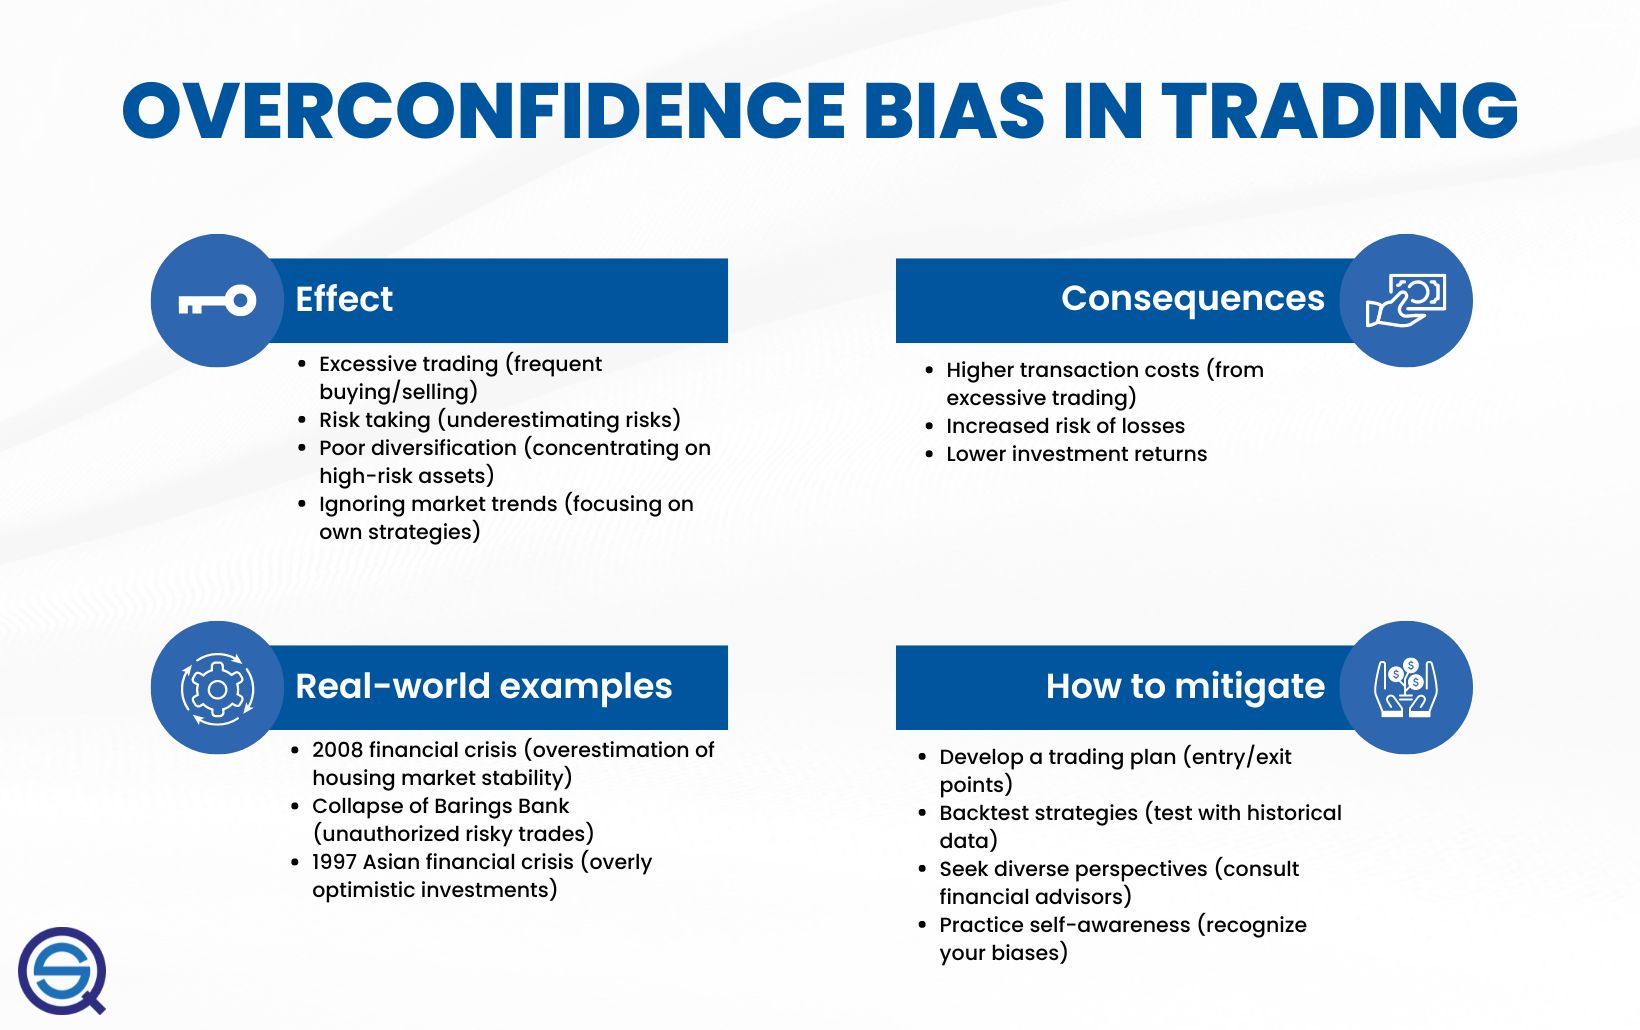
Các biện pháp giảm thiểu kinh điển — kế hoạch bằng văn bản, kiểm tra lịch sử và các góc nhìn đa dạng — ánh xạ trực tiếp vào kiến trúc nghiên cứu. Một mô hình duy nhất có thể giúp viết kế hoạch. Nhưng tự nó không thể là góc nhìn đa dạng.
Bạn nên đánh giá điều gì khi so sánh phân tích cổ phiếu một mô hình và đa mô hình?
Bạn nên đánh giá sáu lớp bao phủ, thay vì đánh giá giao diện nào nghe thông minh hơn. Hãy gọi đây là Kiểm toán Điểm mù Sáu Lớp. Đây là danh sách kiểm tra thực tế cho bất kỳ mã cổ phiếu, công cụ và khung thời gian nào.
1. Neo vào nguồn. Hệ thống có lấy hồ sơ SEC, ước tính và giá hiện tại hay chỉ hoàn thiện văn bản từ một ngày cắt dữ liệu? Openbook Analytics lưu ý rằng chatbot tổng quát không có dữ liệu thị trường trực tiếp và không thể xác minh các số liệu mà chúng tạo ra, đồng thời CEO của Perplexity đã thừa nhận dữ liệu thị trường cũ trên nền tảng này.
2. Đa dạng mô hình. Một nhà cung cấp đồng nghĩa với một kiểu lỗi. Đối chiếu đầu ra kiểu GPT với Claude, Gemini hoặc DeepSeek chỉ hữu ích nếu lời nhắc, dữ liệu và vai trò thực sự thay đổi. Đổi thương hiệu trên cùng một lời nhắc đã cũ không phải là đa dạng.
3. Đa dạng vai trò. Phân tích cơ bản, phân tích diễn biến giá và cấu trúc, cùng lớp phủ vĩ mô phát hiện các lỗi khác nhau. Điều này gần với một cuộc họp nghiên cứu hơn là một chuỗi chatbot.
4. Biểu diễn bất định. Ưu tiên khoảng giá trị, các kịch bản cạnh tranh và cờ “chưa xác minh” rõ ràng hơn một giá mục tiêu duy nhất.
5. Tính duy trì. Công việc về luận điểm kéo dài nhiều tuần. Những công cụ quên góc nhìn thay thế của thứ Ba tuần trước sẽ lại thổi phồng sự tự tin trong phiên kế tiếp.
6. Chi phí mỗi lần kiểm tra. Nếu lần chạy mô hình thứ hai đắt hoặc bất tiện, nó sẽ bị bỏ qua đúng vào lúc vị thế lớn nhất.
Đánh giá của FINRA về AI trong ngành chứng khoán diễn đạt các vấn đề này bằng ngôn ngữ quản lý: quản trị rủi ro mô hình, khả năng giải thích, tính toàn vẹn dữ liệu và biện pháp giám sát. Các công ty được kỳ vọng phải hiểu cách mô hình tạo ra một kết quả trước khi dựa vào nó cho quy trình tư vấn đầu tư theo Quy định Lợi ích Tốt nhất và Quy tắc FINRA 2111. Nhà đầu tư cá nhân không có chương trình Quy tắc 3110. Nhưng họ vẫn cần một thói quen tương đương: biết mô hình không thể thấy gì.
Một bài nghiên cứu năm 2025 của Harvard Business School về thiên lệch nước ngoài trong LLM tài chính bổ sung một kiểu thất bại tinh vi hơn. Thông tin có thể không có trong dữ liệu huấn luyện, hoặc có mặt nhưng bị đánh trọng số quá thấp. Hai mô hình tập trung vào Hoa Kỳ có thể “đồng ý” về một doanh nghiệp ở thị trường mới nổi mà vẫn cùng chia sẻ một khoảng trống.
ChatGPT, Danelfin, Perplexity và Jenova khác nhau thế nào về mức độ bao phủ điểm mù?
Trước hết, chúng khác nhau ở việc tạo ra một điểm số, một bản tóm tắt có trích dẫn hay một hồ sơ nghiên cứu có thể phản biện. ChatGPT mạnh nhất với vai trò đối tác tư duy và yếu nhất với vai trò động cơ số liệu. Danelfin mạnh nhất với vai trò bộ lọc minh bạch và yếu hơn ở tranh luận đa vai trò. Perplexity mạnh nhất trong việc truy xuất các đoạn trích dẫn và yếu hơn khi các đoạn đó đã cũ. Nhà Phân tích Cổ phiếu Cơ bản của Jenova mạnh nhất khi một luận điểm cần tổng hợp lợi nhuận, định giá và tâm lý, sau đó được thách thức bởi các mô hình khác hoặc tác nhân chuyên biệt.
Openbook Analytics, khi tóm tắt các thử nghiệm trước đó, báo cáo rằng ChatGPT trả lời sai khoảng 35% truy vấn tài chính và đầu tư, và Gemini tạo ảo giác thông tin tài chính với tỷ lệ cao đến 88–91% trong một số đánh giá. Những con số đó không phải lý do để từ bỏ mô hình ngôn ngữ. Chúng là lý do để không cho phép một mô hình duy nhất khép lại luận điểm.
| Tính năng / Khía cạnh | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Đầu ra chính | Giải thích bằng văn xuôi | AI Score có thể giải thích và các đặc tính | Câu trả lời web có trích dẫn | Bản ghi nhớ cơ bản dựa trên hồ sơ |
| Dữ liệu thị trường trực tiếp / đã xác minh | Yếu; bị giới hạn bởi mốc cắt | Được xây dựng cho các tập cổ phiếu được chấm điểm | Có trích dẫn, nhưng có thể cũ | Hồ sơ SEC, ước tính, tâm lý |
| Đối chiếu đa mô hình | Thủ công, nhiều tài khoản | Một hệ thống độc quyền | Tìm kiếm đa mô hình, một bản tóm tắt | Đa nhà cung cấp tích hợp cùng tác nhân chuyên biệt |
| Xử lý bất định | Văn xuôi tự tin theo mặc định | Điểm số cùng phân bổ đặc tính | Trích dẫn, ít rủi ro còn lại hơn | Kịch bản cạnh tranh, bất đồng mô hình, bộ nhớ |
| Giá (tính đến 2026) | Khoảng $20/tháng trả phí | Chưa được xác minh trong đánh giá này | $20/tháng Pro; gói miễn phí | Gói miễn phí; trả phí từ $20/tháng |
| Phù hợp nhất cho | Xem xét khái niệm, soạn kịch bản giảm giá | Sàng lọc và chọn thời điểm cho danh sách đã biết | Thông tin có nguồn nhanh | Nghiên cứu cổ phiếu được đối chiếu |
ChatGPT
ChatGPT vẫn hữu ích để diễn giải một phần 10-K, liệt kê cấu trúc ngành hoặc buộc phải trình bày kịch bản giảm giá bằng ngôn ngữ rõ ràng. Một so sánh bốn mô hình năm 2026 xếp nó vào nhóm tổng quát thay vì một terminal dữ liệu trực tiếp. Hạn chế của nó mang tính cấu trúc: nó vẫn sẽ viết một cầu nối biên lợi nhuận sạch từ trí nhớ. Đó chính xác là cách sự tự tin quá mức đi vào một ghi chú nghiên cứu.
Danelfin
Danelfin là một sản phẩm khác. Nó công bố AI Score thay vì một cuộc trò chuyện. Công ty cho biết cổ phiếu Hoa Kỳ đạt điểm 10/10 vượt thị trường với alpha thường niên 21,05% sau ba tháng kể từ năm 2017, trong khi các mã 1/10 kém hơn 33,28%, và chiến lược AI Score đạt lợi nhuận 376% từ ngày 3 tháng 1 năm 2017 đến ngày 9 tháng 6 năm 2025 so với 166% của S&P 500. Các đặc tính có thể giải thích là một biện pháp đối trọng thực sự với chấm điểm hộp đen. Hạn chế mang tính bổ sung: một điểm số có thể xếp hạng cả tập cổ phiếu mà không kiểm tra áp lực đối với rủi ro kế toán, phân khúc hoặc chính sách cụ thể có thể phá vỡ vị thế này.
Perplexity
Perplexity xứng đáng có vị trí như một lớp trích dẫn. So sánh năm 2026 của Helm Terminal cho biết nó dẫn đầu về thông tin trực tiếp có trích dẫn và các tính năng tài chính, trong khi Claude dẫn đầu về tổng hợp hồ sơ sâu. Hạn chế chính là điều CEO của nó đã nêu: một trích dẫn chỉ mới bằng trang mà nó trỏ đến. Đối chiếu Perplexity với một quy trình dựa trực tiếp vào hồ sơ có giá trị hơn việc xem số lượng trích dẫn là bằng chứng.
Jenova Fundamental Stock Analyst
Jenova Fundamental Stock Analyst được xây dựng như một chuyên gia cổ phiếu: lợi nhuận, định giá tương đối, phân tích mô hình kinh doanh và dữ liệu thời gian thực từ hồ sơ, ước tính và tâm lý. Trên nền tảng Jenova, nó có thể được chạy lại qua các mô hình OpenAI, Anthropic, Google, DeepSeek và xAI, đồng thời có thể hoạt động bên cạnh các chuyên gia khác thay vì giả vờ là tất cả họ. Bộ nhớ duy trì giúp giữ bất đồng gần nhất trong cuộc thảo luận.
Giới hạn minh bạch cũng quan trọng tại đây. Jenova không công bố điểm tổng hợp dài hạn có thể so sánh với thành tích 2017–2025 của Danelfin. Các lần chạy đa mô hình dùng nhiều mức sử dụng hơn một lần chạy duy nhất. Câu trả lời xung đột làm tăng tải nhận thức, và người dùng vẫn phải mở 10-K. Đây là những chi phí thật. Chúng cũng là cái giá của việc không nhầm lẫn sự trôi chảy với thẩm định.
Điều phối đa tác nhân thay đổi nghiên cứu cổ phiếu cơ bản như thế nào?
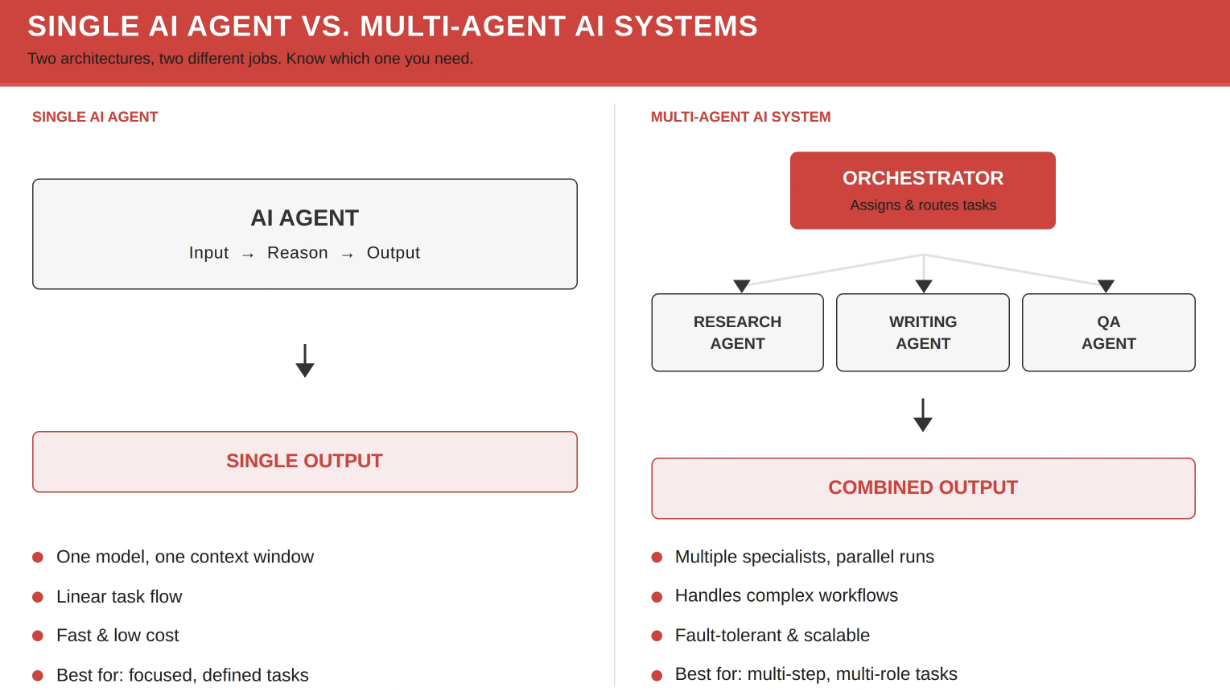
Điều phối thay đổi công việc từ “hỏi một nhà phân tích” thành “bố trí một bàn làm việc nhỏ và đối chiếu hồ sơ.” Một tác nhân đơn lẻ đi theo đường tuyến tính: đầu vào, lập luận, đầu ra. Cách đó nhanh, rẻ và phù hợp khi câu hỏi hẹp. Cấu trúc đa tác nhân bổ sung một bộ điều phối giao việc cho các chuyên gia — nghiên cứu, viết, rà soát chất lượng — rồi trả về một sản phẩm kết hợp. Kiến trúc này chậm hơn và đắt hơn. Nhưng đó cũng là cách ngăn một lỗi hùng biện trở thành toàn bộ bản ghi nhớ.
Trong công việc cổ phiếu, sự phân chia tương ứng không phải là “nghiên cứu / viết / QA” theo nghĩa trừu tượng. Nó là:
- Cơ bản: chất lượng lợi nhuận, kinh tế học đơn vị, định giá, phân bổ vốn
- Kỹ thuật: cấu trúc, khối lượng, động lượng, các mức vô hiệu hóa
- Vĩ mô: chính sách, lãi suất, chế độ liên tài sản
- Danh mục: quy mô, tương quan, mức sụt giảm, liệu ý tưởng có thuộc về danh mục này hay không
Jenova Fundamental Stock Analyst đảm nhiệm ghế đầu tiên. Ghép nó với Technical Stock Analyst và Macro Strategist là phiên bản thực tế của QA đa tác nhân. Một mô hình thích câu chuyện, một mô hình nói diễn biến giá đã gãy, và một mô hình nói lộ trình lãi suất sẽ hủy bội số định giá, không phải là một truy vấn thất bại. Đó là một cuộc họp rủi ro hoàn chỉnh.
Bằng chứng về tổ hợp bên ngoài chatbot cổ phiếu cũng chỉ ra cùng một hướng. Một nghiên cứu arXiv năm 2025 về tổ hợp LLM trên dữ liệu Khảo sát Dự báo Chuyên nghiệp nhận thấy sự kết hợp LLM vượt trung bình đơn giản trên một số chỉ báo ngắn hạn và vẫn hữu ích hơn khi bất đồng chuyên gia cao. Cơ chế không phải phép màu. Tổ hợp giảm trọng số các chuyên gia gần đây dự báo không chính xác, điều chỉnh cho các lần sửa đổi trễ và từ chối xem mọi tiếng nói là ngang nhau. Đó là điều ngược lại với việc hỏi một chatbot về giá mục tiêu rồi dừng lại.
Ngôn ngữ của FINRA về mô hình hộp đen và khả năng giải thích cũng phù hợp ngay cả với quy trình bán lẻ. Nếu bạn không thể giải thích vì sao kịch bản tăng giá vẫn tồn tại sau khi tiếp xúc với mô hình thứ hai và vai trò thứ hai, bạn không có một quy trình đầu tư. Bạn có một bản chép lại.
Các tác nhân kỹ thuật, vĩ mô và danh mục có thể phát hiện điều mà một mô hình đơn lẻ bỏ sót không?
Có. Chúng phát hiện các lỗi phân loại — những sai lầm mà mô hình chỉ phân tích cơ bản khó có thể nhận ra về mặt cấu trúc. Một mô hình ngôn ngữ vừa viết xong câu chuyện doanh nghiệp tăng trưởng bền vững sạch sẽ hiếm khi tự nêu rằng cổ phiếu đã tăng quá đà, ngành này là một khoản cược thuần túy vào duration, hoặc vị thế này nhân đôi một nhân tố bạn đã sở hữu.
Các lỗi bỏ sót điển hình theo từng ghế:
- Ghế kỹ thuật. Mô hình cơ bản có thể đúng về giá trị nhưng đi trước một năm. Cấu trúc giá, các cú phá vỡ thất bại và phân kỳ khối lượng không phải chú thích. Chúng là thời điểm và sự vô hiệu hóa. Technical Stock Analyst được xây dựng xoay quanh những câu hỏi đó: cấu trúc thị trường, động lượng và rủi ro xác định.
- Ghế vĩ mô. DCF ở cấp cổ phiếu bỏ qua chế độ chính sách là bảng tính có giả định lãi suất ẩn. Macro Strategist được thiết kế cho tổng hợp liên tài sản và phân tích chính sách, nơi nhiều câu chuyện “đặc thù doanh nghiệp” thực tế bị phá vỡ.
- Ghế danh mục. Một ý tưởng tuyệt vời khi đứng riêng lẻ có thể là một khoản bổ sung tệ cho danh mục. Trôi dạt, kiểm tra căng thẳng và tương quan tồn tại ở lớp danh mục, vốn là nhiệm vụ của Portfolio Management Strategist của Jenova.
Đây cũng là nơi nền tảng một điểm số và mô hình chat đơn lẻ cùng chia sẻ một điểm mù. Điểm số của Danelfin có thể minh bạch về các đặc tính đằng sau xếp hạng mà vẫn không nói gì về việc danh mục của bạn đã mua cùng nhân tố hay chưa. ChatGPT có thể liệt kê rủi ro một cách trừu tượng mà vẫn không biết bạn đã sở hữu ba mã phần mềm có cùng độ nhạy lãi suất. Rà soát đa vai trò là cách những lỗi này lộ diện.
Hạn chế nằm ở sự tương quan của thế giới quan. Nếu mọi tác nhân đều được nhắc theo hướng tăng giá, hoặc mọi mô hình đều được đưa cùng một bài blog thứ cấp, bạn đang dựng kịch. Đa dạng vai trò chỉ hiệu quả khi tác nhân kỹ thuật được phép bác bỏ giao dịch, tác nhân vĩ mô được phép định giá lại bội số và tác nhân danh mục được phép giảm quy mô xuống mức tượng trưng.
Bạn vận hành đối chiếu đa mô hình cho một luận điểm cổ phiếu như thế nào?
Bạn vận hành nó như một hồ sơ bốn lượt, không phải như một cuộc chat dài hơn. Mục tiêu là chủ động tạo ra bất đồng, rồi quyết định bằng chứng nào sẽ giải quyết chúng.
Lượt 1 — Neo các dữ kiện. Yêu cầu Fundamental Stock Analyst chỉ lập ảnh chụp có nguồn: hai kỳ báo cáo gần nhất, hướng dẫn, cơ cấu phân khúc, nợ ròng, mua lại cổ phiếu và các bội số định giá thực sự phù hợp với doanh nghiệp. Cấm giá mục tiêu trong lượt này.
“Sử dụng 10-K, 10-Q mới nhất và hai cuộc gọi công bố lợi nhuận gần đây nhất của [TICKER], hãy trích xuất doanh thu theo phân khúc, biên gộp và biên hoạt động, FCF, nợ ròng và số lượng cổ phiếu pha loãng. Trích dẫn hồ sơ hoặc cuộc gọi cho mọi số liệu. Nếu không thể tìm nguồn cho một con số, hãy viết Unverified.”
Lượt 2 — Thay đổi mô hình, không thay đổi câu hỏi. Chạy lại cùng phần trích xuất trên nhà cung cấp thứ hai. Khác biệt trọng yếu trong một số liệu đã báo cáo không phải là “phong cách.” Đó là một sự kiện về tính toàn vẹn dữ liệu. Tự kiểm tra hồ sơ trước Lượt 3.
Lượt 3 — Bố trí các ghế còn lại. Gửi cùng mã cổ phiếu cho Technical Stock Analyst để xác định mức vô hiệu hóa và cho Macro Strategist để tìm giả định về lãi suất, FX hoặc hàng hóa đang ẩn trong bội số.
“Bỏ qua bản ghi nhớ cơ bản theo hướng tăng giá. Hãy xác định mức giá và chế độ vĩ mô khiến thiết lập này không đáng sở hữu, ngay cả khi luận điểm cuối cùng vẫn đúng.”
Lượt 4 — Buộc phải có phản biện bằng văn bản. Yêu cầu bất kỳ mô hình nào lập luận cho phía đối diện với độ dài và mức độ trích dẫn tương đương. Ghi chú về tài chính hành vi của Lucid.now nêu mô thức con người thường thấy: đánh giá quá cao năng lực dự báo, giao dịch quá thường xuyên và tập trung vào một câu chuyện ưa thích. Phản biện bắt buộc là cách ngắt mô thức đó khi “nhà phân tích” cũng là một mô hình.
Chỉ với ChatGPT hoặc Claude, bạn có thể xấp xỉ Lượt 2 và 4 bằng cách mở sản phẩm thứ hai rồi dán cùng phần trích xuất có nguồn. Bạn không thể xấp xỉ việc truy xuất hồ sơ trực tiếp hoặc bộ nhớ duy trì qua nhiều tuần nếu công cụ không thực sự có chúng. Với Danelfin, Lượt 1 được tự động hóa một phần bởi điểm số và danh sách đặc tính; Lượt 3 và 4 vẫn cần một bề mặt nghiên cứu riêng.
Giá Jenova dựa trên mức sử dụng theo các gói: gói miễn phí với mức sử dụng giới hạn, sau đó là $20, $50, $100, $200, $500 và $1.000 mỗi tháng khi hạn mức tăng lên. Một kiểm tra bốn lượt tốn hơn một cuộc chat. Với bất kỳ vị thế nào đủ lớn để quan trọng, đó là sai lầm rẻ hơn.
Những người thực hành thị trường nói gì về sự tự tin quá mức do AI trong nghiên cứu?
Những người làm việc với các công cụ này mỗi ngày thường xem sự chắc chắn của một mô hình đơn lẻ là thất bại của quy trình, không phải là một đặc tính của các mô hình “tốt hơn”.
“Sai lầm đắt giá nhất chúng tôi thấy không phải là một con số sai. Đó là một con số nghe có vẻ đúng nhưng chưa từng gặp mô hình thứ hai. Khi ba nhà cung cấp đồng ý về một cầu nối biên lợi nhuận mà không nhà nào có thể đối chiếu với 10-Q, chính sự đồng ý ấy là cờ đỏ. Chúng tôi thà gửi một bản ghi nhớ có hai khoảng giá trị xung đột và danh sách mục Unverified còn hơn một giá mục tiêu duy nhất không có phần dư để kiểm tra.”
“Đa mô hình không tự động an toàn hơn. Nếu bạn hỏi GPT, Claude và Gemini cùng một câu hỏi cẩu thả, bạn thường nhận được cùng một câu trả lời cẩu thả với các tính từ khác nhau. Đa dạng phải được thiết kế: các vai trò khác nhau, các lần kéo dữ liệu khác nhau và chỉ thị phản biện thường trực. Nếu không, bạn đã mua sự tự tin quá mức có tương quan với chi phí token gấp ba lần.”
“Tại bàn làm việc, bất đồng là cách chúng tôi quyết định đọc gì tiếp theo. Nếu cơ bản và vĩ mô xung đột, chúng tôi xem giả định lãi suất. Nếu cơ bản và kỹ thuật xung đột, chúng tôi xem thời điểm và quy mô. Nếu mọi ghế đồng ý quá nhanh, chúng tôi cho rằng hồ sơ còn mỏng. Thói quen đó có trước LLM. Các mô hình chỉ khiến việc bỏ qua nó dễ hơn.”
— Nhóm Sản phẩm Jenova, thiết kế và đánh giá tác nhân cổ phiếu, nhiều năm làm việc về quy trình nghiên cứu đa mô hình
Quan điểm đó phù hợp với sự nhấn mạnh của FINRA về kiểm thử, kế hoạch dự phòng và giám sát liên chức năng trước khi công cụ AI ảnh hưởng đến tư vấn đầu tư. Nó cũng phù hợp với kết quả dự báo tổ hợp: sự kết hợp hữu ích nhất khi đầu vào bất đồng và có người đặt ra quy tắc để đánh trọng số cho chúng.
Khi nào phân tích một mô hình vẫn là lựa chọn tốt hơn?
Phân tích một mô hình vẫn là lựa chọn tốt hơn khi nhiệm vụ có giới hạn, chi phí của sai lầm thấp và tốc độ quan trọng hơn rủi ro còn lại. Đối chiếu đa mô hình là một hệ thống kiểm soát. Bạn không cần hệ thống kiểm soát để định nghĩa ROIC hoặc tóm tắt một doanh nghiệp trong hai đoạn.
Một mô hình thường là đủ khi:
- Bạn đang học một khái niệm, chưa xác định quy mô vị thế
- Bạn đã mở hồ sơ và chỉ cần một người đồng hành để đọc
- Bạn đang sàng lọc ngôn ngữ, không tính định giá
- Bạn cần dàn ý lượt đầu trước một quy trình chậm hơn, có nguồn
- Các lần gọi mô hình bổ sung sẽ không thay đổi quyết định
Hướng dẫn năm 2026 của Openbook đưa ra cùng cách phân loại: chatbot tổng quát là điểm khởi đầu, không phải động cơ nghiên cứu chính. Điểm số của Danelfin là một hệ thống đơn lẻ, nhưng chuyên biệt; dùng nó làm bộ lọc rồi dừng lại vẫn là quyết định một mô hình nếu không ai thách thức mã cổ phiếu đó. Perplexity là một lượt chạy đơn phù hợp khi bạn cần dấu vết trích dẫn trong vài phút và sẽ tự xác minh nguồn chính.
Kiểu thất bại là dùng lượt chạy rẻ cho quyết định đắt. Sự tự tin quá mức không do AI gây ra. Nó do việc kết thúc quy trình ở câu trả lời mạch lạc đầu tiên gây ra. Bản tóm tắt năm 2025 của Sidley về hướng dẫn từ cơ quan quản lý tài chính Hoa Kỳ nhấn mạnh rằng các công ty đã phải xem AI là hoạt động được giám sát, không phải một nhà tiên tri. Nhà đầu tư cá nhân nên làm theo tinh thần của quy tắc đó ngay cả khi không có thanh tra nào hỏi.
Một quy tắc quyết định ngắn gọn: nếu sai lầm sẽ thay đổi quy mô vị thế, hãy dùng ít nhất hai mô hình và hai vai trò. Nếu sai lầm chỉ thay đổi một câu trong ghi chú, một mô hình tốt là đủ.
Quy định và rủi ro mô hình nên định hình quy trình nghiên cứu AI của bạn như thế nào?
Chúng nên buộc bạn ghi lại những gì mô hình không thấy, chứ không chỉ những gì nó nói. Thảo luận AI của FINRA viết cho các công ty môi giới-chứng khoán, nhưng các chủ đề kiểm soát có thể chuyển giao. Quản trị rủi ro mô hình, quản trị dữ liệu, khả năng giải thích và giám sát tồn tại vì các công cụ có vẻ tự chủ thất bại theo những cách có tương quan.
Đối với quy trình nghiên cứu cá nhân, các biện pháp kiểm soát có thể chuyển giao là nhỏ:
- Giữ nguồn chính trong hồ sơ. Nếu mô hình không thể chỉ đến 10-K, 10-Q, 8-K hoặc bản ghi cuộc gọi, tuyên bố đó chỉ là bản nháp.
- Ghi lại bất đồng. Một dòng nhật ký — “Claude thấy co hẹp, Gemini không thấy, trang 37 của 10-Q chưa giải quyết” — hữu ích hơn một kịch bản tăng giá được tạo lại.
- Tách lời khuyên khỏi lời giải thích. Chatbot không phải động cơ đánh giá tính phù hợp. FINRA lưu ý rằng các công cụ AI tạo khuyến nghị thuộc phạm vi Quy định BI và Quy tắc 2111 đối với công ty thành viên. Người dùng bán lẻ nên coi đầu ra mô hình là phân tích, không phải khuyến nghị cá nhân hóa.
- Giả định thiên lệch chung cho đến khi chứng minh ngược lại. Kết quả về thiên lệch nước ngoài của HBS là một ví dụ. Hai mô hình có thể bỏ lỡ cùng một dữ kiện ngoài Hoa Kỳ. Một hồ sơ địa phương, nguồn ở ngôn ngữ thứ hai hoặc chuyên gia con người mới là sự đa dạng hóa thực sự.
- Ưu tiên công cụ có thể nói Unverified. Độ chính xác giả tạo là dấu hiệu nhận biết. Một hệ thống luôn hoàn thành đoạn văn không “phân tích tốt hơn.” Nó được giám sát kém hơn.
Không điều nào trong số này cần ngân sách tổ chức. Các terminal đẳng cấp Bloomberg vẫn ở một thế giới chi phí khác — Openbook dẫn mức giá Bloomberg điển hình trên $25.000 mỗi năm. Biện pháp kiểm soát thực sự giảm tự tin quá mức rẻ hơn: mô hình thứ hai, ghế thứ hai và quy tắc rằng đồng thuận không có nguồn không làm tăng quy mô.
Phân tích cổ phiếu một mô hình là công cụ soạn thảo. Đối chiếu đa mô hình, đa vai trò là công cụ phát hiện điểm mù. Hãy dùng công cụ đầu tiên để bắt đầu hồ sơ. Hãy dùng công cụ thứ hai để quyết định liệu hồ sơ đã hoàn tất hay chưa.
Tài liệu tham khảo
- Openbook Analytics — Các công cụ phân tích cổ phiếu AI tốt nhất năm 2026
- Investopedia — Tài chính hành vi: Thiên lệch, cảm xúc và hành vi nhà đầu tư
- Preprints.org — Sự tự tin quá mức và thiên lệch xác nhận trong giao dịch
- ResearchGate — Sự tự tin quá mức của nhà đầu tư trong kỷ nguyên AI: Ra quyết định của con người so với thuật toán
- SSRN — Hành vi nhà đầu tư trên thị trường chứng khoán: Sự xuất hiện của AI và tự tin quá mức của thuật toán
- Investor.gov — Trí tuệ nhân tạo (AI) và gian lận đầu tư: Cảnh báo nhà đầu tư
- FINRA — Trí tuệ nhân tạo trong ngành chứng khoán: Thách thức chính và cân nhắc quản lý
- Harvard Business School — Khi LLM ra nước ngoài: Thiên lệch nước ngoài trong phân tích tài chính AI
- Danelfin — Công cụ chọn cổ phiếu AI và phương pháp AI Score
- AI Business Weekly — Hướng dẫn giá AI năm 2026: ChatGPT, Claude và Gemini
- Perplexity — Giá cho cá nhân và doanh nghiệp
- Helm Terminal — ChatGPT so với Claude so với Gemini so với Perplexity cho nghiên cứu cổ phiếu
- arXiv — LLM có thể cải thiện việc kết hợp dự báo chuyên gia không?
- Lucid.now — AI trong quyết định tài chính: Góc nhìn hành vi
- Sidley Austin — Trí tuệ nhân tạo: Hướng dẫn của cơ quan quản lý chứng khoán và hàng hóa Hoa Kỳ