Trình tạo giọng nói nhân vật: Giọng AI cho trò chơi, truyện và phim
2026-09-06
Jenova giúp bạn thiết kế những nhân vật khác biệt, viết lời thoại dễ nói và chuẩn bị prompt sẵn sàng sản xuất cho bất kỳ trình tạo giọng nói nhân vật nào. Vào tháng 9 năm 2026, các hệ thống giọng nói AI có thể sao chép một âm sắc chỉ trong vài giây, nhưng phần lớn đầu ra vẫn nghe rất đại trà vì phần viết đằng sau không có cá tính. Lồng tiếng phòng thu vẫn chậm và tốn kém với các nhóm indie, trong khi một lượt chuyển văn bản thành giọng nói sơ sài lại làm mọi vai diễn có cùng nhịp điệu.
- ✅ Cá tính nhất quán của nhân vật xuyên suốt các câu chuyện dài và vòng lặp trò chơi
- ✅ Lời thoại được viết để nói thành tiếng, không chỉ để đọc trên trang
- ✅ Prompt được cấu trúc cho các mô hình giọng nói hiện đại và bản địa hóa
- ✅ Hỗ trợ kịch bản, truyện tranh, âm nhạc và nhập vai trong một quy trình sáng tạo
Để hiểu vì sao điều này quan trọng, hãy nhìn vào thứ mà các nhà sáng tạo thực sự cần từ một trình tạo giọng nói nhân vật: không phải thêm một thanh trượt có nhãn “vui vẻ”, mà là một giọng nói thuộc về một ai đó. Nút thắt hiếm khi nằm ở bộ dựng âm thanh. Nó nằm ở khâu xây dựng nhân vật, cách đọc câu thoại và ranh giới đạo đức giữa màn thể hiện nguyên bản với hành vi bắt chước không được cho phép.
Trả lời nhanh: Trình tạo giọng nói nhân vật là gì?
Trình tạo giọng nói nhân vật là một hệ thống AI tạo ra lời nói riêng biệt, phù hợp với cá tính để mỗi vai diễn nghe như một con người khác nhau. Nhà sáng tạo dùng nó cho trò chơi, truyện, video và khả năng tiếp cận — nhưng giọng nói chỉ hiệu quả khi nhân vật đã được xác định rõ ràng.
Khả năng chính:
- Âm sắc, nhịp độ và biên độ cảm xúc riêng cho từng nhân vật
- Kịch bản và prompt hoạt động tốt khi chuyển văn bản thành giọng nói mà không nghe như GPS
- Nhập vai với tính nhất quán nhân vật được khóa trước cả khi bạn nhấn tạo
- Quy trình nhân vật nguyên bản tránh sao chép người thật khi chưa có sự đồng ý
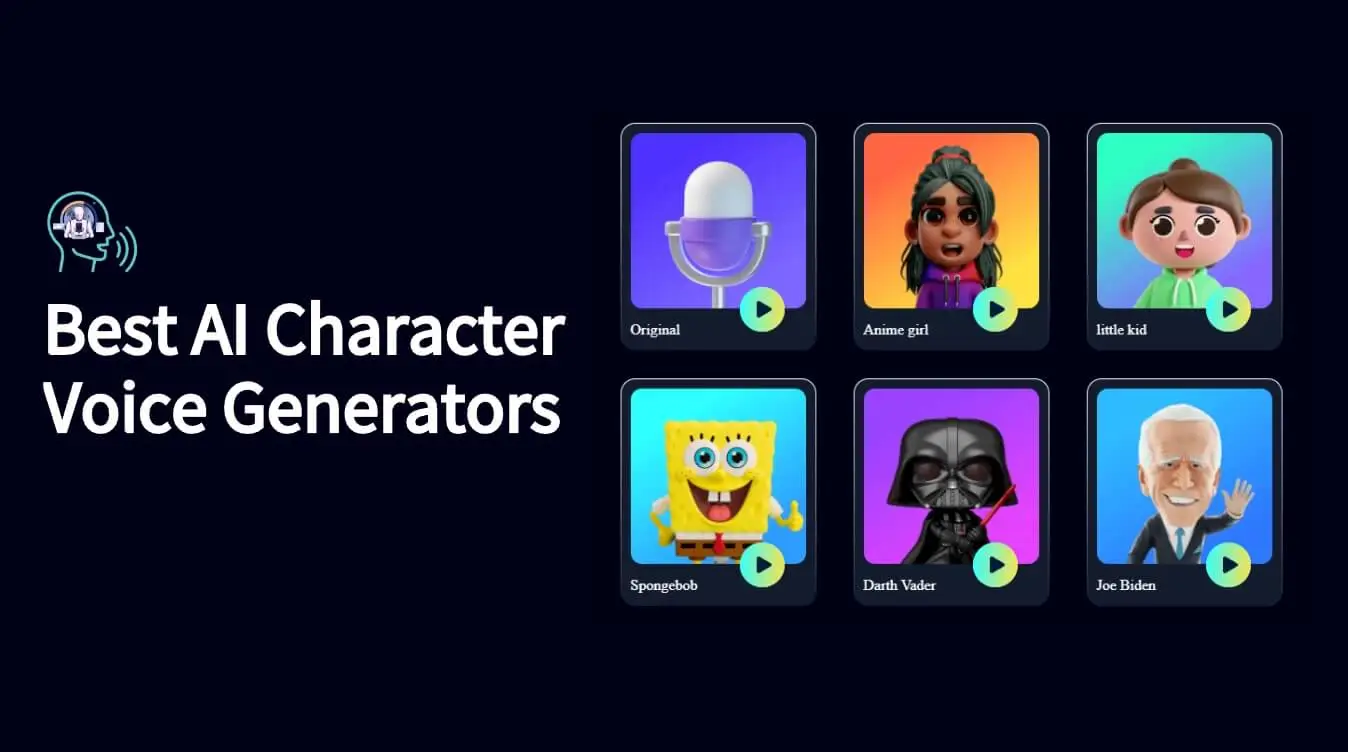
Vì sao đa số trình tạo giọng nói nhân vật vẫn nghe đại trà
Nhu cầu về giọng nói tổng hợp không còn là thử nghiệm. Các công ty nghiên cứu hiện theo dõi việc tạo giọng nói AI như một thị trường riêng, chứ không phải tính năng phụ của chatbot.
6,4 tỷ USD — Quy mô thị trường trình tạo giọng nói AI toàn cầu năm 2025, dự kiến tăng từ 8,36 tỷ USD vào năm 2026
19,09 tỷ USD — Thị trường nhận dạng giọng nói và tiếng nói năm 2025, dự kiến đạt 23,70 tỷ USD vào năm 2026
Khoản chi này đang đổ vào trò chơi, bản địa hóa, video mạng xã hội và âm thanh cho khách hàng. Mức sử dụng Voice AI tăng gấp 9 lần trong năm 2025, và 84% tổ chức được khảo sát dự định tăng ngân sách công nghệ giọng nói. Nhưng mua một bộ dựng âm thanh không đồng nghĩa với mua được một màn thể hiện. Việc có được giọng nói mà khán giả nhớ đến vẫn khó đến mức đáng thất vọng:
- Mọi nhân vật đều thừa hưởng cùng nhịp điệu, kiểu lấy hơi và giọng điệu “trợ lý hữu ích”
- Các buổi thu phòng thu quá chậm và đắt đỏ cho lượng lớn NPC, dàn diễn viên YouTube và các bản lồng tiếng webtoon hằng tuần
- Những câu thoại được viết cho trang giấy sụp đổ khi đọc lên — mệnh đề chồng chất, câu đùa mất tác dụng, tên riêng bị phát âm sai
- Bản sao giọng người nổi tiếng và chính trị gia tạo ra rủi ro pháp lý, niềm tin ngay cả khi giao diện chỉ cần một cú nhấp
- Các nhóm phải xoay xở giữa một biên kịch, kỹ sư prompt, nhà soạn nhạc và công cụ giọng nói mà không có hồ sơ nhân vật chung
Cùng một giọng, khác bảng tên
Một trình tạo giọng nói nhân vật có thể đổi cao độ mà vẫn thất bại về bản sắc. Người nghe theo dõi thái độ chứ không chỉ tần số: cách một kẻ phản diện kéo dài phụ âm, cách một đứa trẻ vội vàng kể một câu đùa, cách một thuyền trưởng mệt mỏi hạ âm lượng ở cuối báo cáo. Nghiên cứu về giọng nói nhận biết cảm xúc, riêng cho nhân vật từ truyện tranh và tạo giọng nói nhiều nhân vật dựa trên văn bản liên tục quay lại cùng một kết luận — mô hình cần ngữ cảnh nhân vật, không chỉ một mục tiêu dạng sóng. Không có cá tính được viết ra, bạn chỉ có phục trang chứ không có màn thể hiện.
Bức tường chi phí cho nhóm indie và quy mô vừa
Con người vẫn đảm nhận các vai chính trong những cảnh phức tạp về cảm xúc. Vấn đề sản xuất nằm ở phần đuôi dài: hàng nghìn lời chào NPC, biến thể bản địa hóa và cách phát âm tên người chơi. Phân tích ngành về giọng nói AI có đạo đức trong trò chơi mô tả sự phân chia “con người cộng thêm” — diễn viên cho các cảnh chủ đạo, tổng hợp cho số lượng lớn — đồng thời lưu ý rằng các nhóm indie nay có thể bản địa hóa sang hàng chục ngôn ngữ trong vài tuần thay vì vài tháng. Điều đó chỉ hữu ích nếu câu thoại nguồn có thể nói tự nhiên và hồ sơ nhân vật ổn định. Nếu không, bạn chỉ đang trả tiền để nhân bản âm thanh tầm thường.
Kịch bản vốn không được viết để nghe
Văn xuôi tiểu thuyết và nội dung giao diện thường chống lại việc nói thành tiếng. Mệnh đề lồng nhau, từ viết tắt không giải thích và tên giả tưởng khó phát âm đẩy mô hình vào các kiểu nhấn trọng âm máy móc. Trình tạo giọng nói nhân vật sẽ dựng chính xác một câu thoại dở. Cách khắc phục nằm ở phía thượng nguồn: nhịp câu ngắn hơn, cách viết phiên âm, chỉ dẫn cảm xúc và lời thoại mà một diễn viên thực sự có thể nói trong một hơi.
Sự đồng ý, sao chép và những nền tảng mời gọi rắc rối
Các hệ thống zero-shot có thể tái tạo âm sắc trong khoảng ba giây. Tốc độ đó hữu ích cho các bản sao có sự đồng ý và nhân vật nguyên bản. Nó nguy hiểm khi thư viện hiển thị nhân vật công chúng hoặc linh vật có bản quyền dưới dạng thiết lập sẵn. FTC đã khẳng định rõ không có ngoại lệ AI đối với luật bảo vệ người tiêu dùng hiện hành, đồng thời đã sử dụng Voice Cloning Challenge và Impersonation Rule để xử lý âm thanh lừa đảo. Trong trò chơi, Interactive Media Agreement tháng 7 năm 2025 đã được thông qua với tỷ lệ ủng hộ 95,04% và coi văn bản đồng ý là điều không thể thương lượng đối với việc sao chép giọng nói. Nếu quy trình của bạn không thể chứng minh sự đồng ý, đừng tạo giọng nói đó.
Đây chính là điều Jenova được xây dựng để làm: cung cấp trí tuệ nhân vật xoay quanh bộ tạo giọng nói, không phải một lối tắt để lách luật.
Giải pháp Jenova
Trình tạo giọng nói nhân vật biến văn bản thành âm thanh. Jenova khiến văn bản đó đáng để cất lời. Bạn xác định ai đang nói, họ suy nghĩ thế nào, điều gì họ sẽ không bao giờ nói và một câu thoại cần được thể hiện ra sao — sau đó đưa prompt cùng kịch bản rõ ràng cho bất cứ mô hình giọng nói nào bạn sử dụng. Các nền tảng âm thanh chuyên dụng dựng dạng sóng; nền tảng này xây dựng con người đứng sau dạng sóng.
| Cách tiếp cận truyền thống | Jenova |
|---|---|
| Đặt phòng thu, chờ buổi thu, cắt dựng lại mọi đoạn thu bổ sung | Hồ sơ nhân vật và bản nháp dễ nói trong một phiên làm việc duy nhất |
| Một giọng TTS với tên hiển thị mới | Cá tính, cách dùng từ và nhịp cảm xúc được viết riêng cho từng vai |
| Sao chép giọng người nổi tiếng và hy vọng không ai nhận ra | Nhân vật nguyên bản, bản sao được đồng ý và mục đích sử dụng có tài liệu |
| Biên kịch ở một tab, ghi chú prompt ở tab khác, nhà soạn nhạc ở tab thứ ba | Các tác nhân liên kết cho truyện, prompt, truyện tranh, âm nhạc và bàn giao |
| Bản địa hóa phẳng lặng, bỏ qua yếu tố hài hước và nhịp thời gian | Câu thoại được cấu trúc phù hợp với âm tiết và chuyển thể văn hóa |
Hồ sơ nhân vật trước khi chạm vào âm thanh
Hãy bắt đầu bằng bản sắc, không phải thiết lập sẵn. Name Generator tạo ra những cái tên nhất quán về văn hóa và dễ nói — một bộ lọc thực tế mà nhiều quy trình giọng nói bỏ qua cho tới khi mô hình vấp phải một cụm phụ âm. Kết hợp với Writing Assistant để khóa cách dùng từ: giới hạn vốn từ, từ cấm, câu đùa lặp lại và một phép ẩn dụ mà nhân vật luôn tìm đến. Khi những ràng buộc này tồn tại, bất kỳ trình tạo giọng nói nhân vật nào cũng có điều cụ thể để thể hiện.
Lời thoại được xây dựng cho miệng nói
Film Screenwriter xem mỗi câu thoại là hành vi có nhịp thời gian: ngắt lời, im lặng và hàm ý. Kỹ năng đó chuyển trực tiếp sang câu thoại ngắn trong trò chơi, phim dọc và truyện tranh lồng tiếng. Bạn có được các chỉ dẫn trong ngoặc mà mô hình giọng nói có thể làm theo như “nói nhỏ, rồi sáng giọng hơn”, thay vì các nhãn mơ hồ như “buồn”. Với truyện kể nối tiếp trên thiết bị di động, Microdrama Screenwriter giữ các đoạn cao trào đủ ngắn để lồng tiếng mà không phải hụt hơi.
Ví dụ chỉ dẫn bạn có thể dán vào một trình tạo giọng nói:
“Đọc với vai Đại úy Ilya Voss, ngoài 50, giọng khàn trầm từ lồng ngực. Cô ấy không bao giờ lớn tiếng khi giận — cô ấy nói chậm lại. Câu thoại: ‘Bạn đã mang bản đồ. Bạn không mang thời tiết.’ Ngắt sau từ bản đồ. Không mỉm cười.”
Prompt hoạt động tốt khi tiếp xúc với mô hình
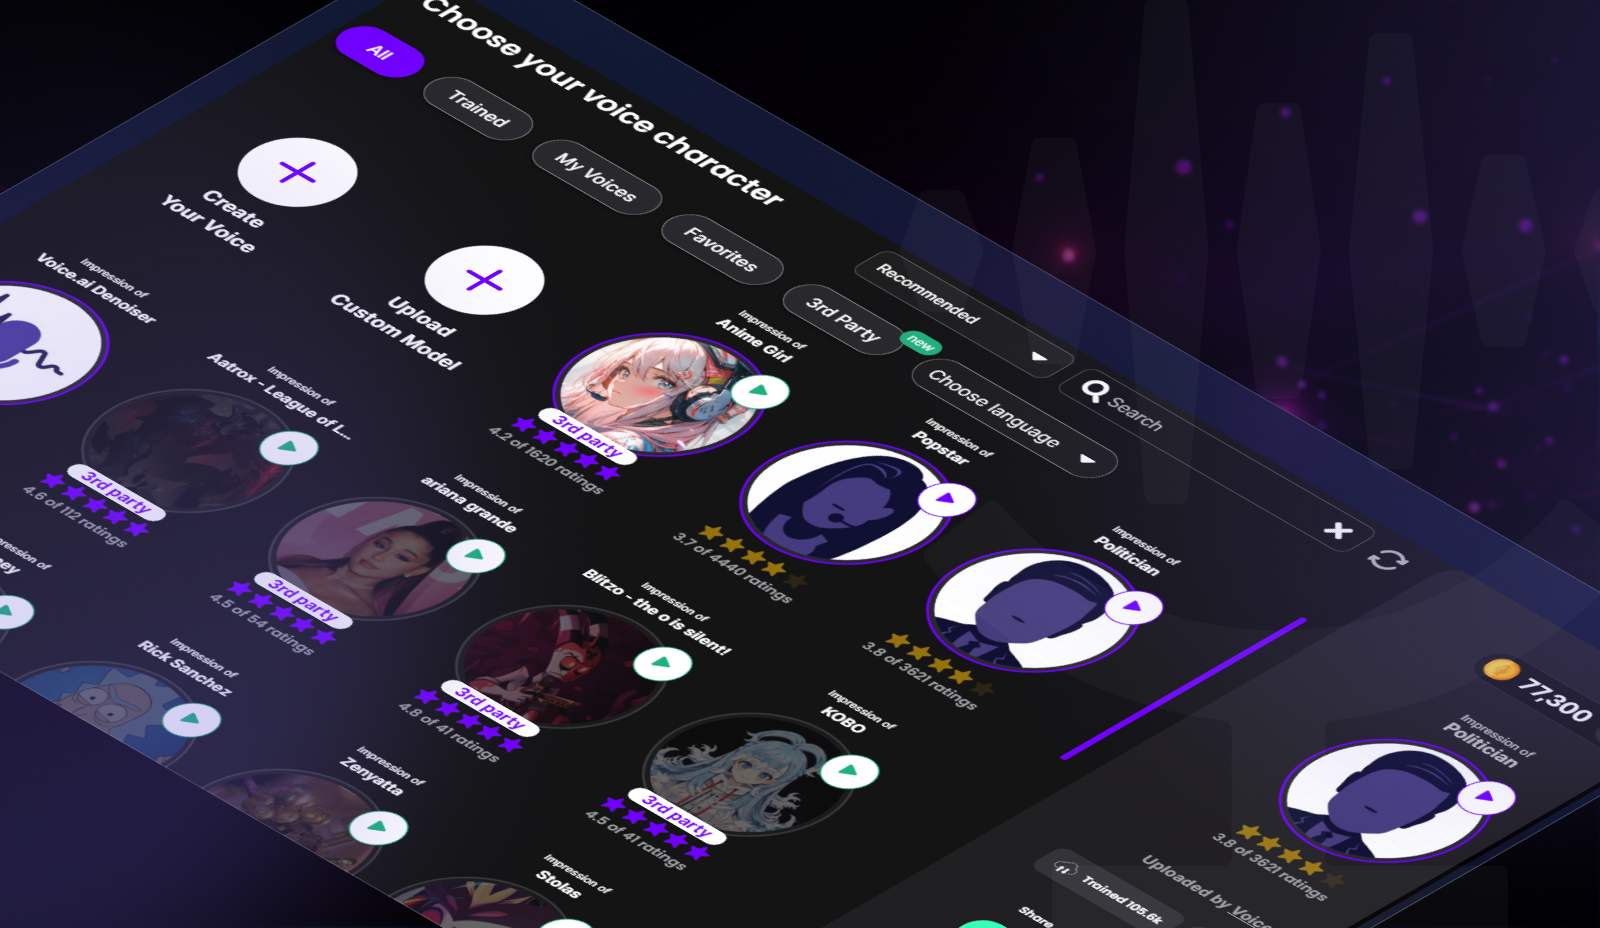
Phần lớn “giọng AI dở” bắt nguồn từ chỉ dẫn dở. Prompt Generator biến hồ sơ nhân vật thành nội dung sẵn sàng cho mô hình: ghi chú giọng vùng miền, tuổi, không gian thu âm, diễn biến cảm xúc và prompt phủ định như “không nhịp điệu phát thanh viên, không mỉm cười ở nguyên âm”. Đó là khác biệt giữa một thẻ thư viện mang tên “Anime Girl” với một con người tình cờ là nhân vật hoạt hình.
Hình ảnh, nhạc nền và phần còn lại của cảnh
Giọng nói chỉ là một lớp. Graphic Designer xây dựng gương mặt mà thính giác mong đợi. Manga Creator, Comic Creator và Webtoon Creator tạo tranh tuần tự có khẩu hình và nhịp khung truyện để bạn phối nhạc. Music Composition Assistant và Lyric Writer mang đến cho nhân vật các chủ đề âm nhạc và lời hát dễ ngân, để giọng nói và bài hát cùng thuộc về một thế giới.
Trong khi các API giọng nói chuyên dụng tập trung dựng âm thanh, Jenova tập trung vào phần viết, prompt và tính liên tục quyết định liệu có ai muốn nghe lại âm thanh đó lần thứ hai hay không.
Các tác nhân AI chuyên biệt cho công việc giọng nói nhân vật
Dùng thử Jenova miễn phí — không cần thẻ tín dụng. Các tác nhân dưới đây đảm nhiệm những công việc nằm ngay trước và sau một trình tạo giọng nói nhân vật.
Roleplay Game Master
Nếu bạn cần nghe một nhân vật qua ngôn ngữ trước khi tổng hợp giọng nói cho họ, đây là phòng diễn tập. Bộ nhớ không giới hạn giữ cách dùng từ, bí mật và quan hệ ổn định qua các phiên, tương đương văn bản của một mô hình giọng nói đã được khóa.
- Thử nghiệm câu cửa miệng cho tới khi chúng nghe như điều tất yếu
- Giữ giọng của tổ đội và NPC tách biệt trong các chiến dịch dài
- Tạo lời thoại đúng nhân vật để bạn đưa thẳng vào trình tạo giọng nói
Film Screenwriter
Dùng khi giọng nói phải gánh cốt truyện, không chỉ tạo hương vị. Cấu trúc, mục tiêu cảnh và kỹ năng viết thoại giúp màn thể hiện không biến thành phần thuyết minh bằng một giọng vùng miền hài hước.
- Nhịp cảnh và xung đột lý giải được thay đổi cảm xúc trong âm thanh
- Câu thoại ngắn, dễ thu bổ sung cho trò chơi và quảng cáo
- Phát triển nhân vật vẫn vững vàng qua bản lồng tiếng mười hai tập
Prompt Generator
Mô hình giọng nói chỉ tốt bằng bản mô tả đầu bài. Tác nhân này viết prompt cho hệ thống văn bản, hình ảnh, âm nhạc và video — bao gồm cả các mô hình giọng nói mà bạn đã trả phí.
- Khối prompt nhất quán cho từng nhân vật để các tập khớp với nhau
- Mô tả cảm xúc và không gian mà mô hình thực sự làm theo
- Tinh chỉnh lặp lại khi một bản thu nghe quá sáng hoặc quá chậm
Writing Assistant
Công cụ chủ lực cho hồ sơ nhân vật, lời dẫn và các bản viết lại kiểu “điều này phải nghe giống họ”. Nó thích ứng với định dạng và khán giả để một đoạn giải thích thế giới truyện và một câu xúc phạm trong quán rượu không dùng chung nhịp câu.
- Biên tập để tăng độ dễ nói và mức độ dễ đọc
- Đồng bộ giọng điệu giữa văn bản nhiệm vụ, trailer và ghi chú bản vá
- Cộng tác khi bạn đã có bản nháp gần như đạt yêu cầu
Music Composition Assistant
Trình tạo giọng nói nhân vật xử lý lời nói. Tác nhân này xử lý phần nền bên dưới — mô-típ, hòa âm và ghi chú phối khí mà bạn có thể đưa cho DAW hoặc một mô hình khác.
- Chủ đề âm nhạc gắn với từng vai cụ thể
- Bản đồ nhịp độ chừa khoảng trống cho lời thoại
- Hướng dẫn am hiểu lý thuyết để chủ đề phản diện không xung đột với quãng giọng hát
Public Speaking Coach
Khi bạn là người biểu diễn — hoặc khi cần chỉ đạo một người — tác nhân này xử lý cách truyền đạt, sự lo lắng và khán giả. Đây là đối tác phía con người của giọng nói tổng hợp: hơi thở, khoảng dừng và điểm nhấn để bạn có thể mã hóa lại trong một prompt.
- Đánh dấu nhịp độ và trọng âm có thể chuyển sang thẻ TTS
- Diễn tập hỏi đáp và đọc trực tiếp cho các buổi phát kết hợp
- Ghi chú về tác động của một câu thoại với người nghe, không chỉ âm thanh của nó
Quy trình trình tạo giọng nói nhân vật thực sự vận hành thế nào
Bạn không cần phòng thu ngay từ đầu. Bạn cần một con người trên trang giấy, một câu thoại có thể nói được và một prompt không tự mâu thuẫn.
Bước 1: Khóa con người, không phải thiết lập sẵn
Viết tuổi, địa vị, thể chất và một quy tắc họ không bao giờ phá vỡ. Tạo một cái tên dễ nói, sau đó viết hồ sơ 150 từ. Nếu hai nhân vật có thể đổi câu thoại cho nhau mà không ai nhận ra, bạn vẫn chưa có hai giọng nói.
“Hãy tạo hồ sơ nhân vật cho Ryn Calder, 17 tuổi, người đưa hàng đường sông, luôn lịch sự với hàng hóa và thô lỗ với thuyền trưởng. Câu ngắn. Không dùng tiếng lóng xuất hiện sau khi ngôi làng của cô bị thiêu rụi. Hãy cho tôi ba câu cô ấy sẽ không bao giờ nói.”
Bước 2: Viết câu thoại cho hơi thở, không phải trang giấy
Đưa cảnh vào Writing Assistant hoặc Film Screenwriter. Cắt các mệnh đề lồng nhau. Viết phiên âm tên khó trong ngoặc vuông. Thêm một ghi chú diễn xuất mà mô hình có thể thực hiện.
“Hãy viết lại đoạn truyền thuyết này thành sáu câu thoại cho Ryn, mỗi câu tối đa mười hai từ, có đánh dấu khoảng dừng trước câu cuối.”
Bước 3: Biến hồ sơ thành prompt cho trình tạo giọng nói
Đưa cùng các ràng buộc đó cho Prompt Generator. Chỉ định không gian thu, khoảng cách micro, cảm xúc theo thang 1–5 và điều cần tránh. Lưu một khối prompt cho mỗi nhân vật để tập bốn không bị lệch.
“Chuyển hồ sơ của Ryn thành prompt cho mô hình giọng nói: alto tuổi teen, khô, vang nhẹ trong kho hàng, nhịp 1.05x, không mỉm cười, không kết câu kiểu phát thanh viên. Bao gồm prompt phủ định.”
Bước 4: Đồng bộ gương mặt, khung truyện và nhạc nền
Đưa cùng hồ sơ đó vào các tác nhân hình ảnh và âm nhạc để hình ảnh cùng nhạc nền hòa hợp với giọng nói. Một khuôn mặt hoạt hình tươi sáng đi kèm cách đọc tang thương là cách khiến khán giả kết luận âm thanh giả tạo — ngay cả khi mô hình chính xác.
Bước 5: Diễn tập trên điện thoại, rồi mới dựng âm thanh
Jenova có đầy đủ tính năng tương đương trên web, iOS và Android. Đọc to câu thoại khi đang đi lại, đánh dấu chỗ vấp, viết lại rồi mới dán vào trình tạo giọng nói nhân vật. Đoạn thu bổ sung rẻ nhất là đoạn bạn không bao giờ phải thu.
Kết quả và trường hợp sử dụng
🎮 NPC trò chơi indie không cần ngân sách phòng thu
Tình huống: Một RPG 12 giờ cần 4.000 câu thoại không phải vai chính, cùng cách phát âm tên người chơi.
Cách tiếp cận truyền thống: Buổi thu với diễn viên công đoàn cho vai chính, im lặng hoặc tái sử dụng câu thoại ngắn cho những người còn lại, bản địa hóa được xếp hàng cho “một ngày nào đó”.
Jenova: Các cảnh nhân vật chính vẫn do người thật đảm nhiệm. Phần đuôi dài có hồ sơ, câu thoại dễ nói và prompt ổn định để trình tạo giọng nói nhân vật của bạn có thể lấp đầy vai người chào khách, chủ cửa hàng và NPC tung tin đồn mà không sao chép giọng người nổi tiếng.
- Hồ sơ nhân vật giúp thợ rèn không nghe như pháp sư
- Câu thoại ngắn sẵn sàng cho bản địa hóa
- Khối prompt có thể quản lý phiên bản như mã nguồn
🎬 Lồng tiếng webtoon và truyện tranh
Tình huống: Một series dọc hằng tuần muốn có tập âm thanh mà không chờ đủ dàn diễn viên.
Cách tiếp cận truyền thống: Lồng tiếng người hâm mộ với micro không đồng nhất, hoặc một người kể chuyện thể hiện mọi vai.
Jenova: Webtoon Creator và Comic Creator duy trì tính liên tục hình ảnh, trong khi biên kịch tách giọng theo từng khung truyện. Mỗi vai có prompt riêng để trình tạo giọng nói không phải đoán.
- Câu thoại căn theo khung truyện thay vì khối văn xuôi dài
- Dàn vai khác biệt cho nhân vật chính và đám đông
- Tín hiệu âm nhạc chừa không gian cho lời nói
📱 Luyện ngôn ngữ nghe như đang nói với một người
Tình huống: Bạn đang di chuyển và muốn hội thoại, không phải giọng sách giáo khoa.
Cách tiếp cận truyền thống: Bài luyện trong ứng dụng với một gia sư tổng hợp duy nhất, không nhớ lỗi của bạn.
Jenova: Learn English Through Roleplay đặt bạn vào một cảnh với nhân vật nhất quán. Sau đó, bạn có thể lồng tiếng các câu ấy trong một trình tạo giọng nói để luyện nghe — vẫn bằng nhân vật nguyên bản, không phải giả mạo.
- Bộ nhớ giúp người pha cà phê không thiết lập lại sau mỗi phiên
- Thành ngữ trong các tình huống bạn thực sự sẽ dùng lại
- Phiên di động vừa vặn với một chuyến tàu
🎙️ Podcast có thương hiệu và dàn nhân vật mạng xã hội
Tình huống: Một kênh sản phẩm cần người dẫn, trợ thủ hoài nghi và lời tuyên bố miễn trừ đọc lạnh mỗi tuần.
Cách tiếp cận truyền thống: Cùng một giọng nhà sáng lập cho mọi phân đoạn, hoặc một freelancer không thể làm việc vào thứ Năm.
Jenova: Social Media Content Generator soạn kịch bản phù hợp từng nền tảng; các tác nhân viết và prompt giữ người dẫn cùng trợ thủ không hòa thành một giọng. Bạn dựng âm thanh bằng công cụ giọng nói được cấp phép, không dùng bản sao trái phép của nhân vật công chúng.
- Mảng nội dung lặp lại với cách dùng từ ổn định
- Tuyên bố miễn trừ được viết để nói, không phải để lướt qua
- Mở đầu có kích thước phù hợp cho Shorts, Reels và tập đầy đủ
Câu hỏi thường gặp
Trình tạo giọng nói nhân vật là gì?
Trình tạo giọng nói nhân vật là phần mềm biến văn bản thành lời nói với một bản sắc được chọn — tuổi, cao độ, giọng vùng miền và cảm xúc — để các vai khác nhau không dùng chung một nhịp điệu. Mô hình âm thanh cung cấp âm sắc. Phần viết nhân vật, chỉ dẫn diễn xuất và prompt cung cấp con người. Các công cụ trên Jenova hoạt động ở phía viết đó: hồ sơ, lời thoại và chỉ dẫn sẵn sàng cho mô hình mà bạn có thể dán vào bất cứ hệ thống giọng nói được cấp phép nào.
Trình tạo giọng nói nhân vật có dùng miễn phí không?
Nhiều ứng dụng giọng nói có gói miễn phí giới hạn và tính phí cho clip dài hơn, quyền thương mại hoặc giọng sao chép. Jenova có gói miễn phí với các tính năng cốt lõi và các gói trả phí nếu bạn cần sử dụng nhiều hơn. Hãy dự trù hai loại chi phí: công việc sáng tạo gồm kịch bản, prompt và tính liên tục; cùng bộ dựng âm thanh gồm số phút âm thanh và giấy phép giọng nói. Điều khoản đồng ý và thương mại cho giọng sao chép tách biệt với giá thuê bao — hãy đọc cả hai trước khi xuất bản.
Làm thế nào để giọng nhân vật AI trở nên độc đáo?
Hãy trao cho mỗi vai một quy tắc, giới hạn vốn từ và một thói quen thể chất, rồi viết những câu họ không thể hoán đổi cho nhau. Đưa các ràng buộc đó vào prompt mỗi lần: không gian, nhịp độ, cảm xúc và prompt phủ định chống lại nhịp điệu phát thanh viên. Prompt Generator được xây dựng cho bản mô tả này. Nếu hai nhân vật vẫn nghe y hệt nhau sau một prompt tốt, vấn đề nằm ở hồ sơ nhân vật, không phải thanh trượt.
Sao chép giọng của người thật có hợp pháp không?
Không phải theo mặc định, và cũng không nên là một thiết lập đùa vui. Bạn cần sự đồng ý rõ ràng, có lưu lại cho đúng mục đích sử dụng thực tế, cùng mọi quy định về quyền hình ảnh và bản quyền áp dụng tại khu vực của mình. FTC xem việc sao chép giọng AI mang tính lừa đảo là vấn đề bảo vệ người tiêu dùng, không phải một điều mới lạ. Các thỏa thuận trong trò chơi và giải trí ngày càng yêu cầu sự đồng ý bằng văn bản cùng báo cáo sử dụng. Hãy xây dựng nhân vật nguyên bản hoặc bản sao được cấp phép. Đừng thu thập giọng của chính trị gia, diễn viên hay ca sĩ chỉ vì bảng điều khiển khiến việc đó trở nên dễ dàng.
Tôi có thể thực hiện quy trình này trên điện thoại không?
Có. Jenova được xây dựng cho web, iOS và Android với cùng năng lực cốt lõi, bao gồm chuyển giọng nói thành văn bản khi bạn muốn ghi chú bằng lời thay vì gõ lúc đang di chuyển. Soạn một câu thoại trên tàu, chỉnh gọn nó, tạo prompt, rồi dựng âm thanh trong công cụ giọng nói trên máy tính nếu đó là nơi các mô hình được cấp phép của bạn hoạt động.
Điều này khác gì với chuyển văn bản thành giọng nói thông thường?
TTS thông thường đọc từ. Trình tạo giọng nói nhân vật cố gắng thể hiện một vai diễn. Màn thể hiện vẫn phụ thuộc vào phần viết: bản sắc, xung đột và chỉ dẫn. Jenova không thay thế bộ dựng âm thanh được cấp phép của bạn. Nó tạo ra phần xây dựng nhân vật mà bộ dựng đó cần thông qua các tác nhân như Roleplay Game Master và Film Screenwriter, để bạn không phải trả tiền chỉ để nghe cùng một thực tập sinh hữu ích trong sáu bộ trang phục.
Kết luận
Trình tạo giọng nói nhân vật chỉ tốt bằng con người mà bạn yêu cầu nó thể hiện. Thị trường giọng nói AI đang tăng trưởng nhanh, các mô hình có thể khóa âm sắc trong vài giây và cơ quan quản lý đã bác bỏ ý tưởng cho rằng “AI đã làm điều đó” là một lời bào chữa. Con đường thực tế hẹp hơn nhưng tốt hơn: nhân vật nguyên bản, bản sao có sự đồng ý, nội dung dễ nói và prompt có thể tái tạo.
Hãy thiết kế vai diễn, viết cho hơi thở, rồi mới tạo bản thu. Bắt đầu với Jenova — sau đó mang những câu thoại đó đến công cụ giọng nói mà bạn đã tin tưởng.
Khám phá thêm quy trình tương tự với Roleplay Game Master, Writing Assistant và Prompt Generator. Khi nhân vật rõ ràng, giọng nói sẽ có nơi để đi.
Dành cho nhà phát triển: Mọi tác nhân trong bài viết này đều có thể dùng theo lập trình thông qua Jenova API — tích hợp hồ sơ nhân vật, tạo lời thoại và prompt cho mô hình giọng nói vào ứng dụng của bạn chỉ với một lần tích hợp. Tài liệu đầy đủ →