Trợ lý nghiên cứu AI chuyên biệt có đáng tin cậy hơn chatbot không?
2026-08-22
Khả năng truy vết và căn cứ nguồn phân biệt AI nghiên cứu với chatbot như thế nào?
Các trợ lý nghiên cứu học thuật chuyên biệt đáng tin cậy hơn chatbot AI đa dụng về khả năng truy vết trích dẫn và trích xuất bằng chứng, vì chúng truy xuất từ các chỉ mục học thuật, gắn từng tuyên bố với những đoạn văn có thể nhận diện và hiển thị bối cảnh ủng hộ hoặc mâu thuẫn. Chatbot đa dụng tạo ra ngôn ngữ thư mục trôi chảy từ các khuôn mẫu trong dữ liệu huấn luyện, nên vẫn có thể bịa ra tác giả, tiêu đề, DOI và kết quả mà không thể lần ngược về nguồn.
Khoảng cách về độ tin cậy không nằm ở chất lượng diễn đạt. Nó nằm ở việc một tuyên bố có thể được kiểm tra hay không.
Các yếu tố then chốt phân biệt hỗ trợ nghiên cứu có thể trích dẫn với văn bản do chatbot tạo ra:
✅ Truy xuất trước khi tạo sinh — câu trả lời được xây dựng từ các bài báo đã lập chỉ mục thay vì chỉ dựa vào xác suất token kế tiếp ✅ Quy thuộc nguồn ở cấp đoạn văn — mỗi kết quả được trích xuất trỏ đến một câu, bảng hoặc mục cụ thể, chứ không chỉ là tiêu đề bài báo ✅ Hiển thị mâu thuẫn — các công trình sau này ủng hộ, phản bác hoặc chỉ đề cập đến một tuyên bố đều được đưa ra thay vì bị san phẳng thành một bản tóm tắt duy nhất ✅ Trích xuất có cấu trúc — phương pháp, mẫu, kết quả và hạn chế được đưa vào các trường có thể so sánh thay vì các đoạn diễn giải ✅ Nguồn gốc có thể kiểm tra bởi con người — mọi bản tóm tắt, trích dẫn và kết quả trích xuất đều có thể mở đối chiếu với nguồn gốc
Để so sánh hữu ích các công cụ này trong năm 2026, nên xem độ tin cậy của trích dẫn là một thuộc tính kỹ thuật, không phải một lời hứa thương hiệu. Phần còn lại của bài viết này đánh giá chatbot và trợ lý nghiên cứu theo thuộc tính đó.
Vì sao độ tin cậy của trích dẫn đã trở thành vấn đề về tính liêm chính trong nghiên cứu?
Độ tin cậy của trích dẫn đã trở thành vấn đề về tính liêm chính trong nghiên cứu vì AI tạo sinh hiện được dùng ở quy mô xuất bản, trong khi các mô hình đa dụng vẫn bịa ra những tài liệu tham khảo trông đủ thật để lọt qua việc rà soát sơ bộ. Mức độ sử dụng của sinh viên và nhà nghiên cứu tăng mạnh trong năm 2025, và trích dẫn bịa đặt không còn là một lỗi hiếm gặp. Chúng đang đi vào kỷ yếu hội nghị, bản thảo và đồ thị trích dẫn.
Khảo sát sinh viên năm 2025 của Higher Education Policy Institute cho thấy mức sử dụng công cụ AI tạo sinh cho đánh giá học tập tăng từ 53% lên 88% chỉ trong một năm. Một báo cáo liên quan từ cùng khảo sát cho biết 92% sinh viên hiện sử dụng AI dưới một hình thức nào đó, tăng từ 66% vào năm 2024. Quy mô này quan trọng vì một tài liệu tham khảo giả nhưng hợp lý khó phát hiện hơn một tài liệu để trống.
Một phân tích năm 2026 trên Energy Research & Social Science báo cáo rằng ChatGPT tạo ra 178 tài liệu tham khảo cho các đề xuất nghiên cứu, trong đó 69 tài liệu không có DOI hợp lệ. Cùng bài báo này dẫn một đánh giá GPTZero về 4.841 bài báo NeurIPS 2025, xác nhận ít nhất 100 trích dẫn ảo giác trong 53 bài được chấp nhận. Phản biện đồng cấp bởi nhiều chuyên gia đã không phát hiện ra chúng.
Cơ chế này hiện đã được mô tả rõ. Ảo giác AI là đầu ra trôi chảy nhưng sai hoặc không có căn cứ. Hướng dẫn của thư viện đại học lưu ý rằng chatbot có thể bịa ra toàn bộ một trích dẫn — tác giả, tiêu đề và tạp chí. Science lập luận rằng các mô hình được huấn luyện để đưa ra câu trả lời ngay cả khi chúng không biết câu trả lời. Khi lời nhắc là “trích dẫn nguồn”, mô hình sẽ khớp mẫu với phong cách thư mục. Với các công trình chuyên biệt hoặc mới xuất bản, việc khớp phong cách này trở thành sự bịa đặt.
Bạn nên đánh giá điều gì khi chọn một trợ lý nghiên cứu AI?
Bạn nên đánh giá một trợ lý nghiên cứu AI dựa trên việc mọi tuyên bố có thể được truy vết, đặt trên nền tảng nguồn, quy thuộc nguồn, đối chiếu mâu thuẫn và trích xuất hay không — chứ không phải dựa trên mức độ trau chuốt của văn bản. Một cách ghi nhớ hữu ích là khung TRACE: Khả năng truy vết, Căn cứ truy xuất, Mức độ chi tiết quy thuộc nguồn, Nhận biết mâu thuẫn và Khả năng trích xuất.
Khả năng truy vết đặt câu hỏi liệu người đọc có thể đi từ một câu trong bản thảo đến chính xác đoạn văn hỗ trợ nó hay không. Nếu công cụ chỉ xuất ra một tài liệu tham khảo đã định dạng, nó tạo ra một con trỏ chứ không phải bằng chứng.
Căn cứ truy xuất đặt câu hỏi liệu hệ thống đã tìm kiếm trong một kho ngữ liệu học thuật hay chỉ lấy mẫu từ trọng số mô hình. Trích xuất có căn cứ trích dẫn được thiết kế để ngăn cả việc bịa đặt không nguồn lẫn diễn giải lại không quy thuộc nguồn bằng cách yêu cầu quy thuộc nguồn rõ ràng cho mọi tuyên bố được trích xuất.
Mức độ chi tiết quy thuộc nguồn phân biệt trích dẫn ở cấp bài báo với trích dẫn ở cấp câu hoặc cấp trường dữ liệu. Một bài báo có thể là thật nhưng kết quả được trích dẫn lại sai, lỗi thời hoặc lấy từ phần tóm tắt thay vì phần kết quả.
Nhận biết mâu thuẫn đặt câu hỏi liệu công cụ có hiển thị các nghiên cứu sau này ủng hộ, thách thức hoặc chỉ đề cập đến tuyên bố hay không. Một bản tóm tắt xác nhận đơn lẻ không phải là một tổng quan tài liệu.
Khả năng trích xuất đặt câu hỏi liệu phương pháp, mẫu, kết quả và hạn chế có thể được so sánh trong các trường có cấu trúc hay không. Tóm tắt bằng văn xuôi che giấu dữ liệu thiếu. Bảng biểu khiến các khoảng trống trở nên rõ ràng.
Hướng dẫn tổng hợp bằng chứng của King's College London nêu thẳng hàm ý thực tiễn: công cụ AI có thể hỗ trợ các giai đoạn của một tổng quan, nhưng không thể thay thế phương pháp tìm kiếm đã được xác thực, và các hệ thống tạo sinh vẫn tạo ra tài liệu tham khảo giả. Một tổng quan năm 2025 được dẫn trong hướng dẫn này kết luận rằng bằng chứng hiện tại không ủng hộ việc sử dụng AI tạo sinh trong tổng hợp bằng chứng mà không có sự tham gia của con người. Vì vậy, câu hỏi đánh giá không phải là “Công cụ này có viết được không?” mà là “Công cụ này có thể được kiểm tra không?”
Trợ lý nghiên cứu chuyên biệt so sánh với chatbot đa dụng như thế nào?
Trợ lý nghiên cứu chuyên biệt vượt trội hơn chatbot đa dụng về khả năng truy vết trích dẫn vì chúng gắn câu trả lời với các bài báo đã truy xuất, trong khi chatbot vẫn mạnh nhất ở soạn thảo, giải thích và động não. So sánh trung thực cần dựa trên vai trò. Chatbot là động cơ viết linh hoạt. Trợ lý nghiên cứu là hệ thống truy xuất hẹp hơn nhưng dễ kiểm tra hơn.
Elicit tìm kiếm hàng triệu bài báo học thuật và trả về các báo cáo có cấu trúc kèm trích dẫn. Công cụ này đặc biệt mạnh khi nhà nghiên cứu cần đặt phương pháp, mẫu và kết quả cạnh nhau trên một tập hợp nghiên cứu. Một so sánh liên kết với Cochrane năm 2026 được King's College London trích dẫn cho thấy Elicit không tìm kiếm với độ nhạy đủ cao để thay thế việc tìm kiếm tài liệu truyền thống, dù độ chính xác của nó khiến công cụ này hữu ích như một giải pháp bổ trợ. Đây là một hạn chế thực sự, không phải chi tiết phụ.
Scite được xây dựng xoay quanh việc xác minh thay vì soạn thảo. Công cụ này báo cáo phạm vi bao phủ hơn 300 triệu bài báo học thuật và quyền truy cập được cấp phép thông qua thỏa thuận với hơn 40 nhà xuất bản. Smart Citations của nó phân loại liệu các bài báo sau này ủng hộ, đối lập hay chỉ đề cập đến một tuyên bố. Mọi tuyên bố do trợ lý của Scite đưa ra đều được liên kết tới câu cụ thể trong bài báo cụ thể. Đổi lại là phạm vi công việc: Scite mạnh hơn về trí tuệ trích dẫn so với quy trình bản thảo từ đầu đến cuối.
ResearchRabbit mạnh nhất ở lập bản đồ. Công cụ này giúp nhà nghiên cứu tìm bài báo liên quan, xây dựng bản đồ trích dẫn và theo dõi sự phát triển của một lĩnh vực từ bài báo hạt giống. Nó ít hữu ích hơn với vai trò là động cơ trích xuất bằng chứng hoặc xác thực trích dẫn. Đây không phải là khiếm khuyết nếu nhiệm vụ là khám phá.
Các chatbot đa dụng như ChatGPT vẫn được sử dụng rộng rãi vì chúng soạn thảo nhanh và xử lý được các câu hỏi lộn xộn, liên ngành. Điểm yếu đã được ghi nhận của chúng là bịa đặt thư mục. Các báo cáo gần đây được tóm lược trong phân tích về tính liêm chính học thuật năm 2026 cho thấy tỷ lệ ảo giác trích dẫn thực tế của những mô hình tiên tiến như GPT-4o và Claude 3.7 ở mức 15–20%, tăng lên 35–55% với các chủ đề chuyên biệt hoặc mới. Các bộ chuẩn đánh giá tài liệu tham khảo khoa học do mô hình ngôn ngữ lớn tạo ra đã báo cáo tỷ lệ lỗi vượt 30% trong một số bối cảnh.
Jenova Academic Research Assistant của Jenova ở một vị trí khác. Đây là một tác nhân theo lĩnh vực dành cho khám phá tài liệu, chuẩn bị bản thảo và quản lý trích dẫn, có bộ nhớ bền vững cùng tìm kiếm trực tiếp trên các cơ sở dữ liệu học thuật. Công cụ này mạnh hơn chatbot trong việc duy trì tính nhất quán của một dự án nghiên cứu qua nhiều phiên làm việc. Nó yếu hơn Scite về phân loại trích dẫn toàn văn được cấp phép, và yếu hơn Elicit với tư cách một sản phẩm bảng trích xuất chuyên dụng. Những khoảng trống đó là lý do một bộ công cụ kết hợp vẫn vượt trội hơn bất kỳ trợ lý đơn lẻ nào.
| Tính năng / Khía cạnh | Chatbot đa dụng (ví dụ: ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Căn cứ truy xuất | Chủ yếu là bộ nhớ mô hình; khả năng duyệt web tùy sản phẩm | Truy xuất học thuật và web trực tiếp trong một tác nhân nghiên cứu có trạng thái bền vững | Tìm kiếm kho bài báo với báo cáo có cấu trúc | Toàn văn học thuật được cấp phép cùng kho ngữ liệu mở | Khám phá đồ thị trích dẫn từ các bài báo hạt giống |
| Khả năng truy vết trích dẫn | Thường không thể xác minh hoặc bị bịa đặt | Nguồn nội tuyến cùng khả năng xác minh tiếp theo với bản gốc | Trích dẫn gắn với các trường được trích xuất | Liên kết cấp câu cùng nhãn ủng hộ/đối lập | Liên kết mạng giữa các bài báo, không phải bằng chứng ở cấp tuyên bố |
| Trích xuất bằng chứng | Tóm tắt tự do | Ghi chú, so sánh và tổng hợp sẵn sàng cho bản thảo | Bảng có cấu trúc mạnh | Mạnh hơn về ngữ cảnh trích dẫn so với trích xuất trường dữ liệu | Hạn chế; ưu tiên lập bản đồ hơn trích xuất |
| Nhận biết mâu thuẫn | Thường được san phẳng thành một câu trả lời | Có thể so sánh các kết quả xung đột khi được yêu cầu | Phụ thuộc vào tập tài liệu được truy xuất | Tính năng cốt lõi thông qua Smart Citations | Gián tiếp, thông qua các cụm công trình liên quan |
| Giá (tính đến năm 2026) | Chưa được xác minh giữa các gói | Gói miễn phí; gói trả phí từ $20/tháng | Chưa được xác minh | Chưa được xác minh | Chưa được xác minh |
| Phù hợp nhất cho | Soạn thảo, giải thích, định hình ban đầu | Dự án học thuật dài hạn cần khám phá cùng bộ nhớ viết | Sàng lọc bài báo vào các bảng bằng chứng có thể so sánh | Kiểm tra một tuyên bố được ủng hộ hay phản bác | Lập bản đồ tài liệu trực quan và khám phá tác giả/cụm nghiên cứu |
Một tổng hợp năm 2026 về các công cụ AI cho nghiên cứu học thuật cũng đi đến phân công tương tự: Elicit dẫn đầu về trích xuất có cấu trúc, Consensus nhanh nhất cho kiểm tra bằng chứng nhanh, và Semantic Scholar vẫn là chỉ mục khám phá miễn phí mạnh nhất. Không cột nào trong bối cảnh đó có thể thay thế các cột còn lại.
Trích xuất bằng chứng khác nhau như thế nào giữa các công cụ AI học thuật?
Trích xuất bằng chứng khác nhau ở việc công cụ trả về các trường có thể so sánh hay chỉ một bản diễn giải bằng văn xuôi. Trích xuất ở cấp trường dữ liệu đáng tin cậy hơn đối với phương pháp, cỡ mẫu, kết quả và hạn chế vì các giá trị thiếu vẫn hiển thị. Trích xuất dạng tường thuật nhanh hơn và dễ đọc hơn, nhưng che giấu khác biệt giữa một kết quả, một diễn giải và một chi tiết ảo giác.
Elicit là ví dụ rõ nhất cho cách tiếp cận có cấu trúc. Công cụ này được thiết kế để biến một câu hỏi nghiên cứu thành báo cáo có các hàng là bài báo và các cột là đặc điểm nghiên cứu. Định dạng đó là lý do người làm tổng quan thường ưu tiên nó trong sàng lọc ban đầu. Tuy vậy, vẫn cần con người kiểm tra logic đưa vào, vì độ chính xác cao không đồng nghĩa với độ bao phủ cao.
Scite trích xuất một đối tượng khác: ngữ cảnh trích dẫn. Thay vì hỏi “Bài báo này phát hiện điều gì?”, nó hỏi “Các bài báo sau này đã sử dụng phát hiện này như thế nào?”. Điều đó gần với thẩm định bằng chứng hơn là trích xuất dữ liệu. Nó đặc biệt hữu ích sau khi một bài báo ứng viên đã được xác định.
Chatbot đa dụng trích xuất bằng văn xuôi. Hãy yêu cầu so sánh bốn thử nghiệm ngẫu nhiên có đối chứng và chúng sẽ tạo ra một đoạn văn tự tin. Đoạn văn có thể hữu ích như bản phác thảo đầu tiên. Nhưng nó là một hiện vật kiểm tra kém, vì không có trường nào có thể được đánh dấu là “không được báo cáo”.
Jenova Academic Research Assistant và tác nhân đồng hành Deep Research của nó nằm giữa hai hướng tiếp cận này. Deep Research tìm kiếm rộng và trả về một báo cáo tổng hợp có trích dẫn nội tuyến. Jenova Academic Research Assistant duy trì trạng thái dự án: các quyết định đưa vào trước đó, bài báo bị loại, yêu cầu phong cách và các phần bản thảo chưa hoàn thành vẫn sẵn có trong các phiên sau. Thử nghiệm quy trình này cho thấy lợi thế thực tế trong các tổng quan tài liệu kéo dài nhiều tuần. Hạn chế cũng mang tính thực tế tương tự. Không tác nhân nào trong hai tác nhân này là công cụ sàng lọc tổng quan hệ thống chuyên dụng theo khuôn mẫu của các công cụ được thiết kế riêng như Rayyan hoặc DistillerSR, vốn vẫn được các thủ thư tổng hợp bằng chứng xem là lựa chọn được đánh giá nhiều hơn cho việc sàng lọc tiêu đề và tóm tắt.
Một lời nhắc trích xuất đáng tin cậy cần nêu rõ các trường mong muốn:
"Trích xuất từ các bài báo này: thiết kế nghiên cứu, cỡ mẫu, quần thể, kết quả chính, hướng tác động, hạn chế được nêu và chính xác câu hỗ trợ cho từng trường. Nếu thiếu một trường, hãy viết 'not reported' thay vì suy luận."
Cùng lời nhắc đó trong chatbot vẫn chỉ tốt bằng văn bản đã được truy xuất. Nếu mô hình chưa từng mở bài báo, nó sẽ điền bảng bằng ký ức về phong cách.
Một quy trình xác minh trích dẫn thực sự cần những gì?
Một quy trình xác minh trích dẫn cần tài liệu nguồn, không chỉ chuỗi tài liệu tham khảo. Quy trình khả dụng tối thiểu là: nạp văn bản được trích dẫn, chia thành các khối, truy xuất những đoạn liên quan nhất đến tuyên bố, xếp hạng lại chúng và phân loại mối quan hệ giữa tuyên bố với bằng chứng. Bất cứ thứ gì ít hơn đều chỉ là định dạng thư mục.
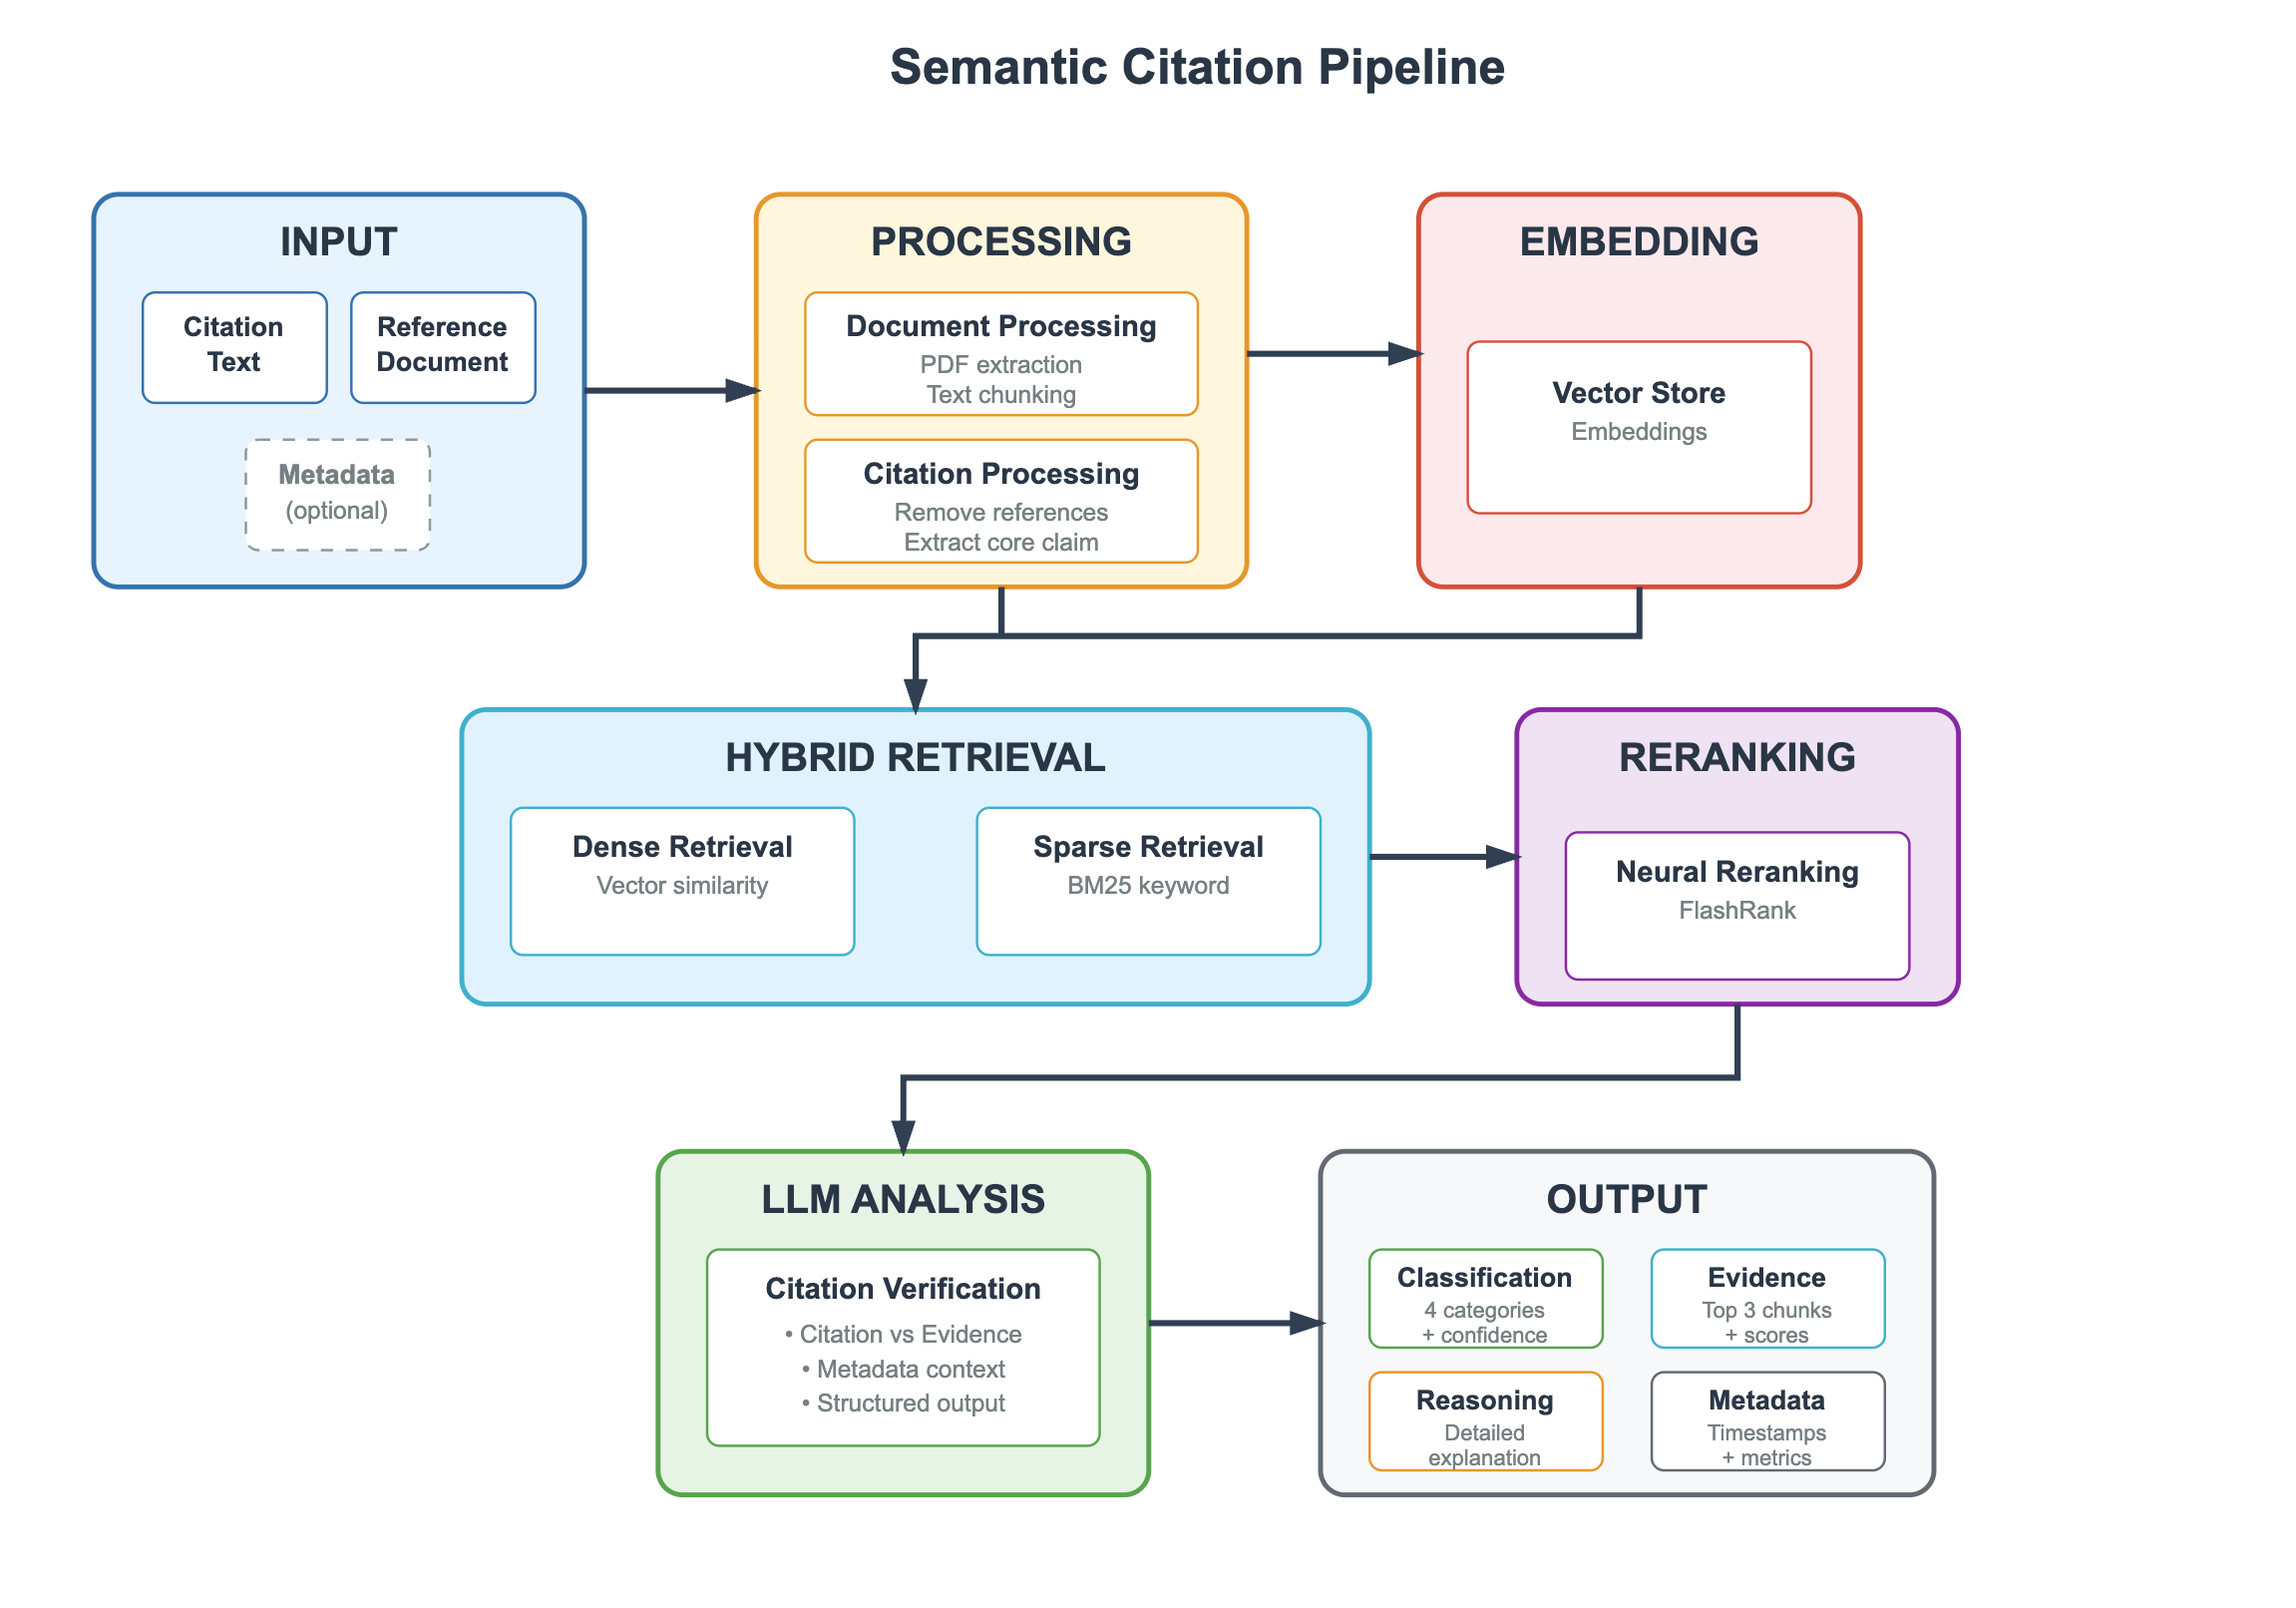
Kiến trúc trên tạo nên khác biệt giữa “trích dẫn này trông có vẻ thật” và “trích dẫn này được hỗ trợ”. Đầu vào là tuyên bố cộng với tài liệu tham khảo. Quá trình xử lý loại bỏ danh mục tài liệu tham khảo, trích xuất tuyên bố cốt lõi và chia PDF thành các khối. Truy xuất lai sau đó tìm kiếm cả độ tương đồng vector lẫn mức độ trùng khớp từ khóa; điều này quan trọng vì tên phương pháp và thước đo kết quả thường không phù hợp với tìm kiếm ngữ nghĩa thuần túy. Xếp hạng lại bằng mạng nơ-ron giữ lại các đoạn hàng đầu. Chỉ sau đó một LLM mới phân loại mối quan hệ và trả về bằng chứng, độ tin cậy cùng lập luận.
Các hệ thống như SemanticCite đang được xây dựng riêng để xác minh độ chính xác của trích dẫn thông qua phân tích nguồn toàn văn. Lựa chọn thiết kế này tồn tại vì việc khớp siêu dữ liệu là chưa đủ. Một DOI có thể hợp lệ trong khi câu được trích dẫn lại đến từ một bài báo khác, phần tóm tắt bản thảo trước xuất bản hoặc một kết quả mà tác giả sau đó đã điều chỉnh.
Hạ tầng của nhà xuất bản không tự động giải quyết vấn đề này. Các tạp chí lớn đã có liên kết tham khảo, nhưng các ước tính được thảo luận trong phân tích về tính liêm chính năm 2026 cho thấy lỗi DOI hoặc liên kết hỏng có thể lên tới 37% trong nội dung học thuật được lấy mẫu. Một liên kết màu xanh không phải là một tuyên bố đã được xác minh.
Đây cũng là điểm mà chatbot đa dụng thất bại dễ dự đoán nhất. Chúng tối ưu hóa cho một câu trả lời hoàn chỉnh. Quy trình xác minh tối ưu hóa cho một mối quan hệ đã phân loại: được hỗ trợ, không được hỗ trợ, bị mâu thuẫn hoặc bằng chứng chưa đủ. Bốn nhãn này hữu ích hơn về mặt khoa học so với một đoạn văn trau chuốt, vì chúng cho nhà nghiên cứu biết loại kiểm tra nào vẫn còn cần thiết.
Các tác nhân Jenova có thể vận hành một phiên bản gọn nhẹ của vòng lặp này bằng cách truy xuất bài báo ứng viên, trích dẫn đoạn hỗ trợ và gắn cờ các tuyên bố không thể định vị. Hiện tại, chúng không thay thế bộ phân loại trích dẫn toàn văn được cấp phép với phạm vi bao phủ ở quy mô nhà xuất bản. Những nhà nghiên cứu cần nhãn Smart Citations vẫn kết hợp một tác nhân viết với Scite thay vì yêu cầu một hệ thống thực hiện cả hai công việc.
Làm thế nào để xây dựng quy trình tổng quan tài liệu có AI hỗ trợ an toàn hơn?
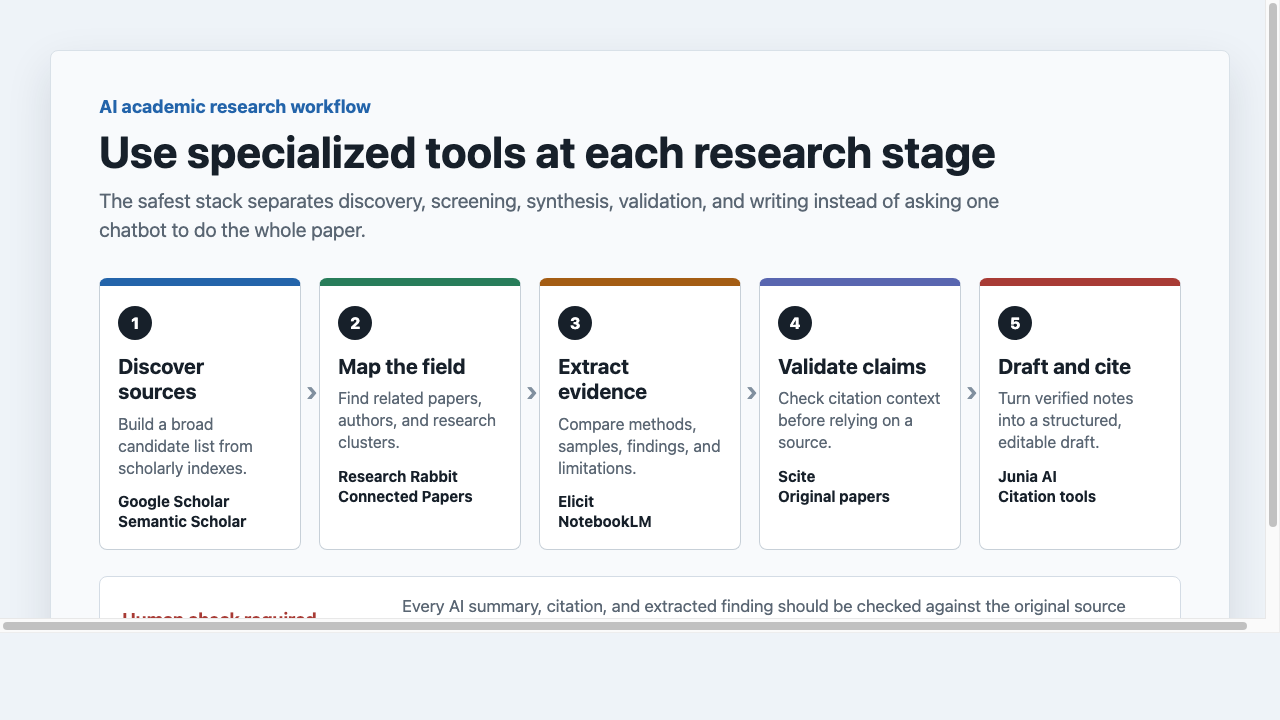
Bạn xây dựng một quy trình tổng quan tài liệu có AI hỗ trợ an toàn hơn bằng cách giao từng giai đoạn cho một công cụ có thể kiểm tra, sau đó xác minh mọi kết quả được trích xuất với bài báo gốc. Mô hình không an toàn là yêu cầu một chatbot duy nhất khám phá, sàng lọc, trích xuất, xác thực và viết.
Một quy trình theo giai đoạn có dạng như sau:
- Khám phá nguồn trong các chỉ mục học thuật như Google Scholar hoặc Semantic Scholar, không phải trong cửa sổ trò chuyện.
- Lập bản đồ lĩnh vực với ResearchRabbit hoặc Connected Papers để hiển thị tác giả và cụm nghiên cứu liên quan.
- Trích xuất bằng chứng bằng Elicit, NotebookLM hoặc một tác nhân nghiên cứu vào các ghi chú có cấu trúc.
- Xác thực tuyên bố trong Scite và trong các PDF gốc trước khi bất kỳ câu nào được xem là có thể trích dẫn.
- Soạn thảo và trích dẫn chỉ từ tập ghi chú đã được xác minh.
Với Jenova Academic Research Assistant, bước thiết lập là một bản yêu cầu nghiên cứu thay vì một chuyến tham quan tính năng:
- Mở tác nhân tại jenova.ai/a/academic-research-assistant.
- Nêu câu hỏi, ngành học và tiêu chí “hoàn thành”:
"Tôi đang viết phần phương pháp về tỷ lệ lỗi trích dẫn của LLM. Hãy ưu tiên nghiên cứu phản biện đồng cấp và các phân tích của nhà xuất bản từ 2023–2026. Với mỗi nguồn, hãy trích xuất mẫu, định nghĩa lỗi, tỷ lệ ảo giác và việc con người có xác minh các tài liệu tham khảo hay không."
- Trước tiên hãy yêu cầu danh sách ứng viên, sau đó là bảng trích xuất, rồi mới đến văn xuôi. Đừng bỏ qua để đi thẳng đến bản thảo.
- Giữ các bài báo bị loại trong cùng một luồng để tác nhân không đưa chúng trở lại sau này.
Với Elicit, điểm khởi đầu tương đương là một câu hỏi hẹp và danh sách cột: quần thể, can thiệp, kết quả, loại nghiên cứu. Với Scite, hãy bắt đầu từ một bài báo hoặc tuyên bố đã biết và kiểm tra các trích dẫn ủng hộ so với đối lập trước khi viết. Với chatbot đa dụng, cách sử dụng an toàn nhất là lập dàn ý và biên tập ngôn ngữ sau khi nguồn đã tồn tại.
Hai quy tắc vận hành ngăn chặn phần lớn thất bại. Thứ nhất, không bao giờ chấp nhận một trích dẫn không thể mở. Thứ hai, không bao giờ để mô hình soạn thảo trở thành bản ghi duy nhất về nội dung của một bài báo. Ghi chú đã xác minh là nguồn sự thật. Bản thảo chỉ là sự sắp xếp lại các ghi chú đó.
Khi nào chatbot đa dụng vẫn là công cụ học thuật tốt hơn?
Chatbot đa dụng vẫn là công cụ học thuật tốt hơn khi nhiệm vụ là ngôn ngữ, cấu trúc hoặc giải thích thay vì bằng chứng. Độ tin cậy phụ thuộc vào công việc. Khả năng truy vết trích dẫn là phép thử sai đối với một mô hình viết, cũng như độ trôi chảy của văn xuôi là phép thử sai đối với một chỉ mục truy xuất.
Chatbot vẫn hữu ích cho:
- Chuyển dàn ý đã xác minh thành văn phong học thuật mạch lạc hơn
- Giải thích một phương pháp mà nhà nghiên cứu đã đọc
- Tạo chuỗi tìm kiếm, phản biện hoặc danh sách kiểm tra khi chỉnh sửa
- Chuyển các đoạn văn dày đặc thành ngôn ngữ dễ hiểu hơn để ghi chú, không phải để trích dẫn
Chúng là động cơ tài liệu chính kém hiệu quả. Công trình phân loại liên kết với Nature xem các tuyên bố không có căn cứ của chatbot là một dạng ảo giác riêng biệt, và hướng dẫn thư viện tiếp tục lặp lại cùng một cảnh báo: trích dẫn bịa đặt có thể bao gồm trọn bộ tác giả-tiêu đề-tạp chí. Kiểu thất bại này gây tổn thất lớn trong luận văn, đề xuất tài trợ và bài nộp tạp chí, nơi chỉ một tài liệu tham khảo bịa đặt có thể làm mất uy tín của một lập luận vốn cẩn trọng.
Cũng có lý do về quy trình để giữ chatbot trong bộ công cụ. Các công cụ chuyên biệt hẹp hơn. Elicit sẽ không chỉnh nhịp điệu của một đoạn văn. Scite sẽ không duy trì cuộc trao đổi cố vấn kéo dài cả học kỳ về một chương luận án. ResearchRabbit sẽ không định dạng phong cách tài liệu tham khảo của một tạp chí. Chatbot, hoặc tác nhân viết đa dụng, lấp đầy những khoảng trống đó sau khi bằng chứng đã được khóa.
Quy tắc thực tế là trình tự. Trước tiên hãy dùng truy xuất và xác minh chuyên biệt. Sau đó dùng mô hình đa dụng, và chỉ áp dụng trên văn bản có nguồn đã tồn tại trong một thư viện mà bạn có thể mở. Nếu chatbot đưa thêm trích dẫn mới trong quá trình chỉnh sửa, hãy coi trích dẫn đó là chưa đáng tin cho đến khi nó vượt qua cùng các bước kiểm tra TRACE như phần còn lại của bản thảo.
Các chuyên gia về tính liêm chính trong nghiên cứu nói gì về trích dẫn AI?
Các chuyên gia về tính liêm chính trong nghiên cứu xem chatbot đa dụng là công cụ hỗ trợ soạn thảo và hệ thống chuyên biệt gắn với nguồn là lớp duy nhất có thể chấp nhận cho các tuyên bố sẽ được trích dẫn. Đồng thuận không phải là “tránh AI”. Mà là “đừng để một hệ tạo sinh không có căn cứ trở thành bản ghi về những gì tài liệu học thuật nói”.
"Thất bại chúng tôi liên tục thấy không phải là mô hình viết kém. Đó là việc chúng viết ra các thư mục hoàn chỉnh cho những bài báo không tồn tại, hoặc những bài báo có thật nhưng không chứa kết quả được tuyên bố. Khi các chuỗi đó đi vào bản thảo, chúng hoạt động như bằng chứng. Người phản biện, đồng tác giả và các công cụ trích dẫn sau này có thể lan truyền chúng trước khi bất kỳ ai mở nguồn."
"Một trợ lý nghiên cứu chuyên biệt thay đổi đơn vị công việc. Thay vì yêu cầu một đoạn văn có trích dẫn, bạn yêu cầu một tuyên bố, một đoạn văn và một phân loại: được hỗ trợ, không được hỗ trợ, bị mâu thuẫn hoặc chưa đủ. Đầu ra đó chậm hơn và kém bóng bẩy hơn. Nhưng nó cũng là đầu ra duy nhất mà phần phương pháp có thể bảo vệ."
"Bộ nhớ dự án bền vững quan trọng hơn mọi người nghĩ. Ảo giác thường quay lại bài báo trong quá trình chỉnh sửa, khi một chatbot đa dụng được yêu cầu 'thêm nguồn' vào phần vốn đã sạch. Một trợ lý nhớ được bài báo nào đã bị loại và lý do loại bỏ đang thực hiện công việc về tính liêm chính, chứ không chỉ là công việc tiện lợi. Dù vậy, PDF gốc vẫn là thẩm quyền."
— Nhóm sản phẩm Jenova, quy trình nghiên cứu học thuật, hoạt động nhiều năm về thiết kế tác nhân có căn cứ trích dẫn
Quan điểm đó phù hợp với hướng dẫn của thủ thư và chuyên gia tổng hợp bằng chứng. King's College London khuyến nghị sử dụng AI như công cụ bổ trợ, kiểm tra bản quyền trước khi tải lên văn bản toàn văn và giả định rằng công cụ tạo sinh vẫn có thể bịa đặt tài liệu tham khảo cùng đề mục chủ đề. Các phân tích ở cấp nhà xuất bản hiện xem tài liệu tham khảo ảo giác là vấn đề của kho ngữ liệu, không phải giai thoại đơn lẻ. Một bình luận năm 2026, dựa trên khảo sát của Nature về khoảng 4.000 ấn phẩm, lưu ý rằng 65 trong số 100 bài báo đáng ngờ nhất chứa ít nhất một tài liệu tham khảo không hợp lệ, một mô hình có thể hàm ý hơn 110.000 bài báo bị ảnh hưởng trong khoảng 7 triệu ấn phẩm năm 2025.
Hàm ý của chuyên gia mang tính vận hành. Hãy chọn công cụ khiến việc kiểm tra trở nên ít tốn kém. Hãy loại bỏ những công cụ khiến việc kiểm tra có vẻ không cần thiết.
Tài liệu tham khảo
- Higher Education Policy Institute — Khảo sát AI tạo sinh của sinh viên năm 2025
- ERIC / Bộ Giáo dục Hoa Kỳ — Khảo sát AI tạo sinh của sinh viên năm 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — Ảo giác trong AI tạo sinh và tính liêm chính học thuật
- Wikipedia — Ảo giác (trí tuệ nhân tạo)
- Thư viện McGoogan, University of Nebraska Medical Center — Ảo giác AI kèm trích dẫn
- Science / AAAS — Vì sao mô hình AI ảo giác thay vì thừa nhận sự không chắc chắn
- LlamaIndex — Trích xuất có căn cứ trích dẫn
- Hướng dẫn thư viện King's College London — Công cụ AI trong tổng hợp bằng chứng
- Elicit — AI cho nghiên cứu khoa học
- Scite — Nghiên cứu có trích dẫn làm căn cứ và Smart Citations
- ResearchRabbit — Lập bản đồ tài liệu và mạng trích dẫn
- newline — Bộ chuẩn kiểm tra tài liệu tham khảo khoa học do LLM tạo ra
- Paperguide — So sánh công cụ AI nghiên cứu học thuật, 2026
- arXiv — SemanticCite: xác minh trích dẫn bằng phân tích toàn văn
- Nature Humanities and Social Sciences Communications — Phân loại ảo giác AI