Không gian làm việc nghiên cứu AI có tốt hơn cho lập bản đồ bằng chứng có hệ thống không?
2026-08-22
Trạng Thái Dự Án Bền Vững Và Truy Xuất Đoạn Nội Dung Theo Yêu Cầu Khác Nhau Ra Sao?
Đối với lập bản đồ bằng chứng có hệ thống, một không gian làm việc nghiên cứu tải lại các quyết định, trạng thái và hiện vật ngay từ đầu mỗi phiên là môi trường chính tốt hơn so với công cụ tóm tắt một bài báo hoặc chatbot RAG chỉ truy xuất các “đoạn nội dung liên quan” khi có yêu cầu. Lập bản đồ là một dự án mã hóa kéo dài: tiêu chí đưa vào thay đổi dần, các nghiên cứu ở ranh giới được mã hóa lại và tổng hợp phụ thuộc vào việc ghi nhớ vì sao một nguồn bị chặn vào tuần trước. Các công cụ cấp độ bài báo như Elicit, Consensus và NotebookLM vẫn rất mạnh cho khám phá, trích xuất và hỏi đáp trong kho tư liệu khép kín. Một không gian làm việc bền vững — bao gồm Academic Research Assistant của Jenova — mạnh hơn khi bản đồ phải tồn tại qua nhiều tuần thay đổi giao thức mà không âm thầm viết lại các quyết định của ngày hôm qua.
Điểm khác biệt quan trọng vào năm 2026 không phải là “mô hình nào viết tóm tắt hay hơn”. Đó là kiến trúc bộ nhớ nào có thể duy trì một bản đồ bằng chứng đang phát triển.
Các yếu tố then chốt phân biệt hạ tầng lập bản đồ hữu dụng với trò chuyện bài báo dùng một lần:
✅ Bộ nhớ vận hành so với bộ nhớ tham chiếu — bản đồ cần trạng thái dự án (tiêu chí, mã, loại trừ), chứ không chỉ các đoạn văn được truy xuất ✅ Nguồn gốc quyết định — mọi quyết định đưa vào/loại trừ phải vẫn có thể kiểm tra qua nhiều phiên ✅ Trích xuất có cấu trúc — các trường có thể so sánh tốt hơn các bản tóm tắt tường thuật đơn lẻ ✅ Tuân thủ giao thức có giám sát của con người — các nhóm tổng hợp bằng chứng vẫn xem AI là công cụ bổ trợ, không phải người phản biện thay thế ✅ Tổng hợp có thể lập phiên bản — báo cáo, hình minh họa và danh sách nguồn cần được tích lũy thay vì tạo lại từ đầu
Để so sánh công bằng các công cụ này, hãy xem lập bản đồ bằng chứng là vấn đề liên tục gồm bốn lớp thay vì một cuộc thi tóm tắt.
Vì Sao Lập Bản Đồ Bằng Chứng Có Hệ Thống Gây Áp Lực Cho Các Công Cụ AI Một Bài Báo?
Lập bản đồ bằng chứng có hệ thống gây áp lực cho các công cụ tóm tắt một bài báo vì bản đồ là một danh mục tài liệu được mã hóa, chứ không phải chuỗi ghi chú đọc riêng lẻ. Bản đồ bằng chứng có hệ thống (SEM) là một dạng tổng hợp bằng chứng, trong đó các phát hiện khoa học được phân loại và tổ chức theo các chiều xác định trước — quần thể, phơi nhiễm, kết quả, phương pháp, địa lý hoặc khoảng trống bằng chứng — để người phản biện thấy được những gì tồn tại, nơi chúng tập trung và những gì còn thiếu.
Quy trình đó xung đột với cách phần lớn sản phẩm nghiên cứu LLM vận hành. Một công cụ RAG hoặc “trò chuyện với PDF này” trả lời truy vấn hiện tại bằng cách lấy các đoạn có độ tương đồng cục bộ. Nó không tự động tải lại khung mã hóa của thứ Ba tuần trước, ba nghiên cứu đang để ở mục “có thể”, hay quyết định rằng mô hình động vật nằm ngoài phạm vi sau khi giao thức được siết chặt. Các tổng quan lập bản đồ cũng đòi hỏi một quy trình sàng lọc được ghi chép theo các tiêu chí đưa vào và loại trừ; đây là nhiệm vụ khác với việc tạo một đoạn văn trôi chảy về một bài báo (phương pháp cho tổng quan lập bản đồ).
Đánh giá thủ công vẫn đủ chậm để khiến lối tắt trở nên hấp dẫn. Một khảo sát năm 2026 về công cụ tài liệu ước tính chu kỳ tổng quan thông thường mất bốn đến sáu tuần cho sàng lọc, trích xuất và dọn dẹp trích dẫn. Các công cụ sàng lọc AI chuyên dụng có thể giảm gánh nặng này — hệ thống AIM Review báo cáo mức giảm khối lượng công việc từ 20% đến 95% trong sáu tổng quan thực tế — nhưng tốc độ không tự tạo ra bản đồ. Nếu không có trạng thái dự án bền vững, sàng lọc nhanh hơn chỉ tạo ra một đống tóm tắt rời rạc lớn hơn.
Các tổ chức thư viện và phương pháp luận nêu rõ khoảng cách còn lại. Hướng dẫn tổng hợp bằng chứng của King’s College London cho biết công cụ AI không thể thay thế các phương pháp tìm kiếm, sàng lọc và trích xuất truyền thống, đồng thời chỉ nên được sử dụng với nhận thức rõ ràng về thiên lệch, giới hạn bản quyền và rủi ro ảo giác. Một tổng quan hệ thống năm 2025 về AI tạo sinh trong tổng hợp bằng chứng đi đến cùng kết luận vận hành: bằng chứng hiện tại không ủng hộ việc dùng GenAI mà không có sự tham gia hoặc giám sát của con người.
Bạn Nên Tìm Kiếm Điều Gì Trong Quy Trình Lập Bản Đồ Bằng Chứng Bằng AI?
Bạn nên đánh giá công cụ lập bản đồ AI bằng bài kiểm tra tính liên tục, không phải bài kiểm tra chất lượng viết. Chúng tôi sử dụng một ngăn xếp bốn lớp — gọi là ngăn xếp CODE — vì mỗi lớp thất bại theo một cách khác nhau và có thể dự đoán được khi các nhóm cố biến trò chuyện bài báo thành một bản đồ hệ thống.
C — Phạm vi bao phủ. Công cụ có thể tìm kiếm một kho học thuật thực sự, hay chỉ các tệp bạn đã tải lên? Elicit tìm kiếm hơn 138 triệu bài báo và 545.000 thử nghiệm lâm sàng. NotebookLM, theo thiết kế, trả lời từ các nguồn trong sổ tay. Lỗi bao phủ ở lớp này trở thành các hàng thiếu trong bản đồ, chứ không chỉ là các đoạn văn mỏng.
O — Chuẩn hóa vận hành. Tiêu chí đưa vào, các chiều mã hóa và trường trích xuất có thể được nêu một lần rồi áp dụng lại không? Một công cụ tóm tắt diễn giải lại “liên quan” ở mỗi lời nhắc sẽ mã hóa cùng một thử nghiệm cận biên khác nhau vào ngày thứ ba. Hướng dẫn lập bản đồ xem tiêu chí xác định trước là bắt buộc (phương pháp tổng quan lập bản đồ).
D — Nguồn gốc quyết định. Bạn có thể khôi phục lý do một nghiên cứu được đưa vào, loại trừ, tạm giữ hoặc chặn không? Các nhóm phù hợp với Cochrane, bao gồm sáng kiến Responsible AI in Evidence Synthesis (RAISE) cùng Cochrane, Campbell và JBI, xem tính minh bạch là yêu cầu chất lượng chứ không phải điều phụ thêm.
E — Khả năng trích xuất. Các phát hiện có thể đi vào những ô so sánh được — mẫu, thiết kế, chiều hướng tác động, hạn chế — thay vì văn xuôi không thể đối chiếu không? Thiết kế sản phẩm của Elicit được xây dựng xoay quanh bảng tương tác và trích xuất nhiều bước. Consensus nhanh hơn với chiều hướng bằng chứng ở cấp giả thuyết nhưng không được xây dựng cho việc viết tổng quan có cấu trúc.
Hãy đặt trọng số cho các lớp theo mục đích. Một lượt khảo sát phạm vi có thể chấp nhận nguồn gốc quyết định yếu hơn. Một bản đồ bằng chứng đang phát triển sẽ được trích dẫn, cập nhật hoặc bàn giao cho đồng tác giả thì không thể. Các công cụ xuất sắc về Phạm vi bao phủ và Khả năng trích xuất vẫn làm bản đồ thất bại nếu Chuẩn hóa vận hành và Nguồn gốc quyết định bị đặt lại sau mỗi phiên.
Elicit, Consensus, NotebookLM Và Không Gian Làm Việc Nghiên Cứu Khác Nhau Thế Nào?
Elicit và Consensus là lớp khám phá bài báo và trích xuất mạnh nhất trong nhóm này, NotebookLM là sổ tay kho tư liệu khép kín mạnh nhất, còn không gian làm việc nghiên cứu bền vững là môi trường mạnh nhất để giữ bản đồ kéo dài nhiều tuần nhất quán. Không sản phẩm đơn lẻ nào thắng ở mọi lớp CODE; vì vậy, các nhóm lập bản đồ nghiêm túc thường ghép công cụ kho tư liệu với môi trường bộ nhớ dự án thay vì kỳ vọng một chatbot sở hữu toàn bộ quy trình tổng quan.
Tính đến năm 2026, các bản tổng hợp tính năng và giá công bố trông như sau:
| Tính năng / Chiều so sánh | Elicit | NotebookLM | Consensus | Không gian làm việc nghiên cứu Jenova |
|---|---|---|---|---|
| Mô hình bộ nhớ | Thư viện nguồn đã lưu cùng khả năng tùy chỉnh theo báo cáo; không phải kho chứa trạng thái dự án đầy đủ | Tập nguồn theo phạm vi sổ tay; câu trả lời nằm trong tài liệu đã tải lên | Bộ nhớ câu hỏi/danh sách xoay quanh truy vấn giả thuyết | Bộ nhớ bền vững xuyên phiên; bối cảnh dự án có thể được tải lại thay vì truy xuất lại |
| Phạm vi bao phủ | 138M+ bài báo, 545k thử nghiệm | Chỉ kho tư liệu đã tải lên; 50 nguồn miễn phí, 300 nguồn trên Plus | 200M+ bài báo, nhãn chiều hướng bằng chứng | Tìm kiếm web trực tiếp và học thuật cùng cơ sở tri thức đính kèm; không phải chỉ mục nhà xuất bản cố định |
| Trích xuất có cấu trúc | Bảng, sàng lọc, điểm dữ liệu ở quy mô lớn (tối đa 1.000 bài báo / 20.000 điểm dữ liệu) | Hỏi đáp và dàn ý liên kết nguồn, không phải lưới trích xuất SR | Consensus Meter và câu trả lời bằng chứng ngắn | Báo cáo tổng hợp và bản tóm lược có trích dẫn qua Deep Research; yếu hơn ở vai trò công cụ sàng lọc kép chuyên dụng |
| Lưu giữ quyết định | Nguồn có thể lưu trong thư viện; trạng thái giao thức không phải chức năng hạng nhất | Lưu tệp của sổ tay, không phải logic đưa vào/loại trừ đã mã hóa | Dấu trang và danh sách ở các gói trả phí | Lịch sử trò chuyện, bộ nhớ và tệp dự án đính kèm tồn tại xuyên các phiên |
| Giá (tính đến 2026) | Plus từ khoảng $12/tháng | Miễn phí; Plus qua Google AI Pro khoảng $19.99/tháng | Premium khoảng $10/tháng | Gói miễn phí với mức sử dụng giới hạn; Plus $20/tháng cho mức sử dụng gấp 30× |
| Phù hợp nhất với | Sàng lọc khối lượng lớn và bảng trích xuất | Bộ tài liệu giảng dạy và PDF đã thu thập | Kiểm tra nhanh “tài liệu có ủng hộ X không?” | Bản đồ đang phát triển, mã hóa đa phiên và tích hợp bản thảo |
Elicit là công cụ chuyên biệt rõ ràng cho sàng lọc theo kiểu hệ thống. Nó có thể tự động hóa sàng lọc và trích xuất, đồng thời tuyên bố tiết kiệm đến 80% thời gian ở các giai đoạn này. Một so sánh phương pháp của Cochrane vẫn cho thấy độ nhạy tìm kiếm của Elicit chưa đủ cao để thay thế tìm kiếm tài liệu truyền thống, nên nó hoạt động tốt nhất như một công cụ bổ trợ có độ chính xác cao. Elicit cũng thường dừng ở báo cáo và bảng; công việc viết, lập phiên bản và bản thảo đang phát triển thường được chuyển sang nơi khác.
NotebookLM là công cụ chuyên biệt rõ ràng cho việc đọc có căn cứ trong một tập hợp cố định. Mỗi câu trả lời đều có thể kiểm tra dựa trên đoạn trích dẫn, và Google đã bổ sung Deep Research cùng nhiều loại tệp hơn. Nó không thể khám phá các bài báo bạn chưa thu thập và cũng không mã hóa nhật ký quyết định theo kiểu PRISMA.
Consensus là công cụ chuyên biệt rõ ràng cho chiều hướng giả thuyết. Đồng hồ đo và tính năng gắn nhãn ủng hộ/đối lập của nó nhanh hơn việc tạo lưới trích xuất khi bạn chỉ cần biết tài liệu nghiêng về hướng nào (so sánh công cụ). Đây là hệ thống chính không phù hợp cho một bản đồ được mã hóa.
Academic Research Assistant của Jenova mạnh nhất khi đơn vị công việc là dự án, không phải PDF. Nó có thể tìm kiếm nguồn học thuật, lưu bối cảnh bản thảo và trích dẫn, đồng thời — vì nền tảng cơ bản lưu trữ lịch sử trò chuyện không giới hạn và bộ nhớ xuyên phiên — tiếp tục khung mã hóa mà không cần dán lại giao thức. Đây không phải nền tảng sàng lọc đánh giá kép đã được xác thực theo nghĩa Covidence hoặc Rayyan, và cũng không công bố chỉ số độ chính xác trích xuất kiểu Elicit. Các nhóm cần dấu vết kiểm toán đạt chuẩn quy định vẫn nên giữ một công cụ sàng lọc chuyên dụng trong bộ công cụ.
SciSpace và Scite đảm nhiệm các công việc liền kề hẹp hơn. SciSpace thường được mô tả là môi trường tốt hơn cho phân tích sâu từng bài báo, với kho tư liệu rất lớn nhưng quy trình tổng quan kém thống nhất hơn. 1,6 tỷ Smart Citations của Scite được phân loại là ủng hộ, đối lập hoặc đề cập đến một tuyên bố, là năng lực vượt trội để kiểm toán bối cảnh trích dẫn nhưng gần như vô dụng nếu tự đứng một mình như cơ sở dữ liệu khám phá hoặc lập bản đồ.
Bộ Nhớ Vận Hành Thay Đổi Việc Tổng Hợp Tài Liệu Đa Phiên Như Thế Nào?
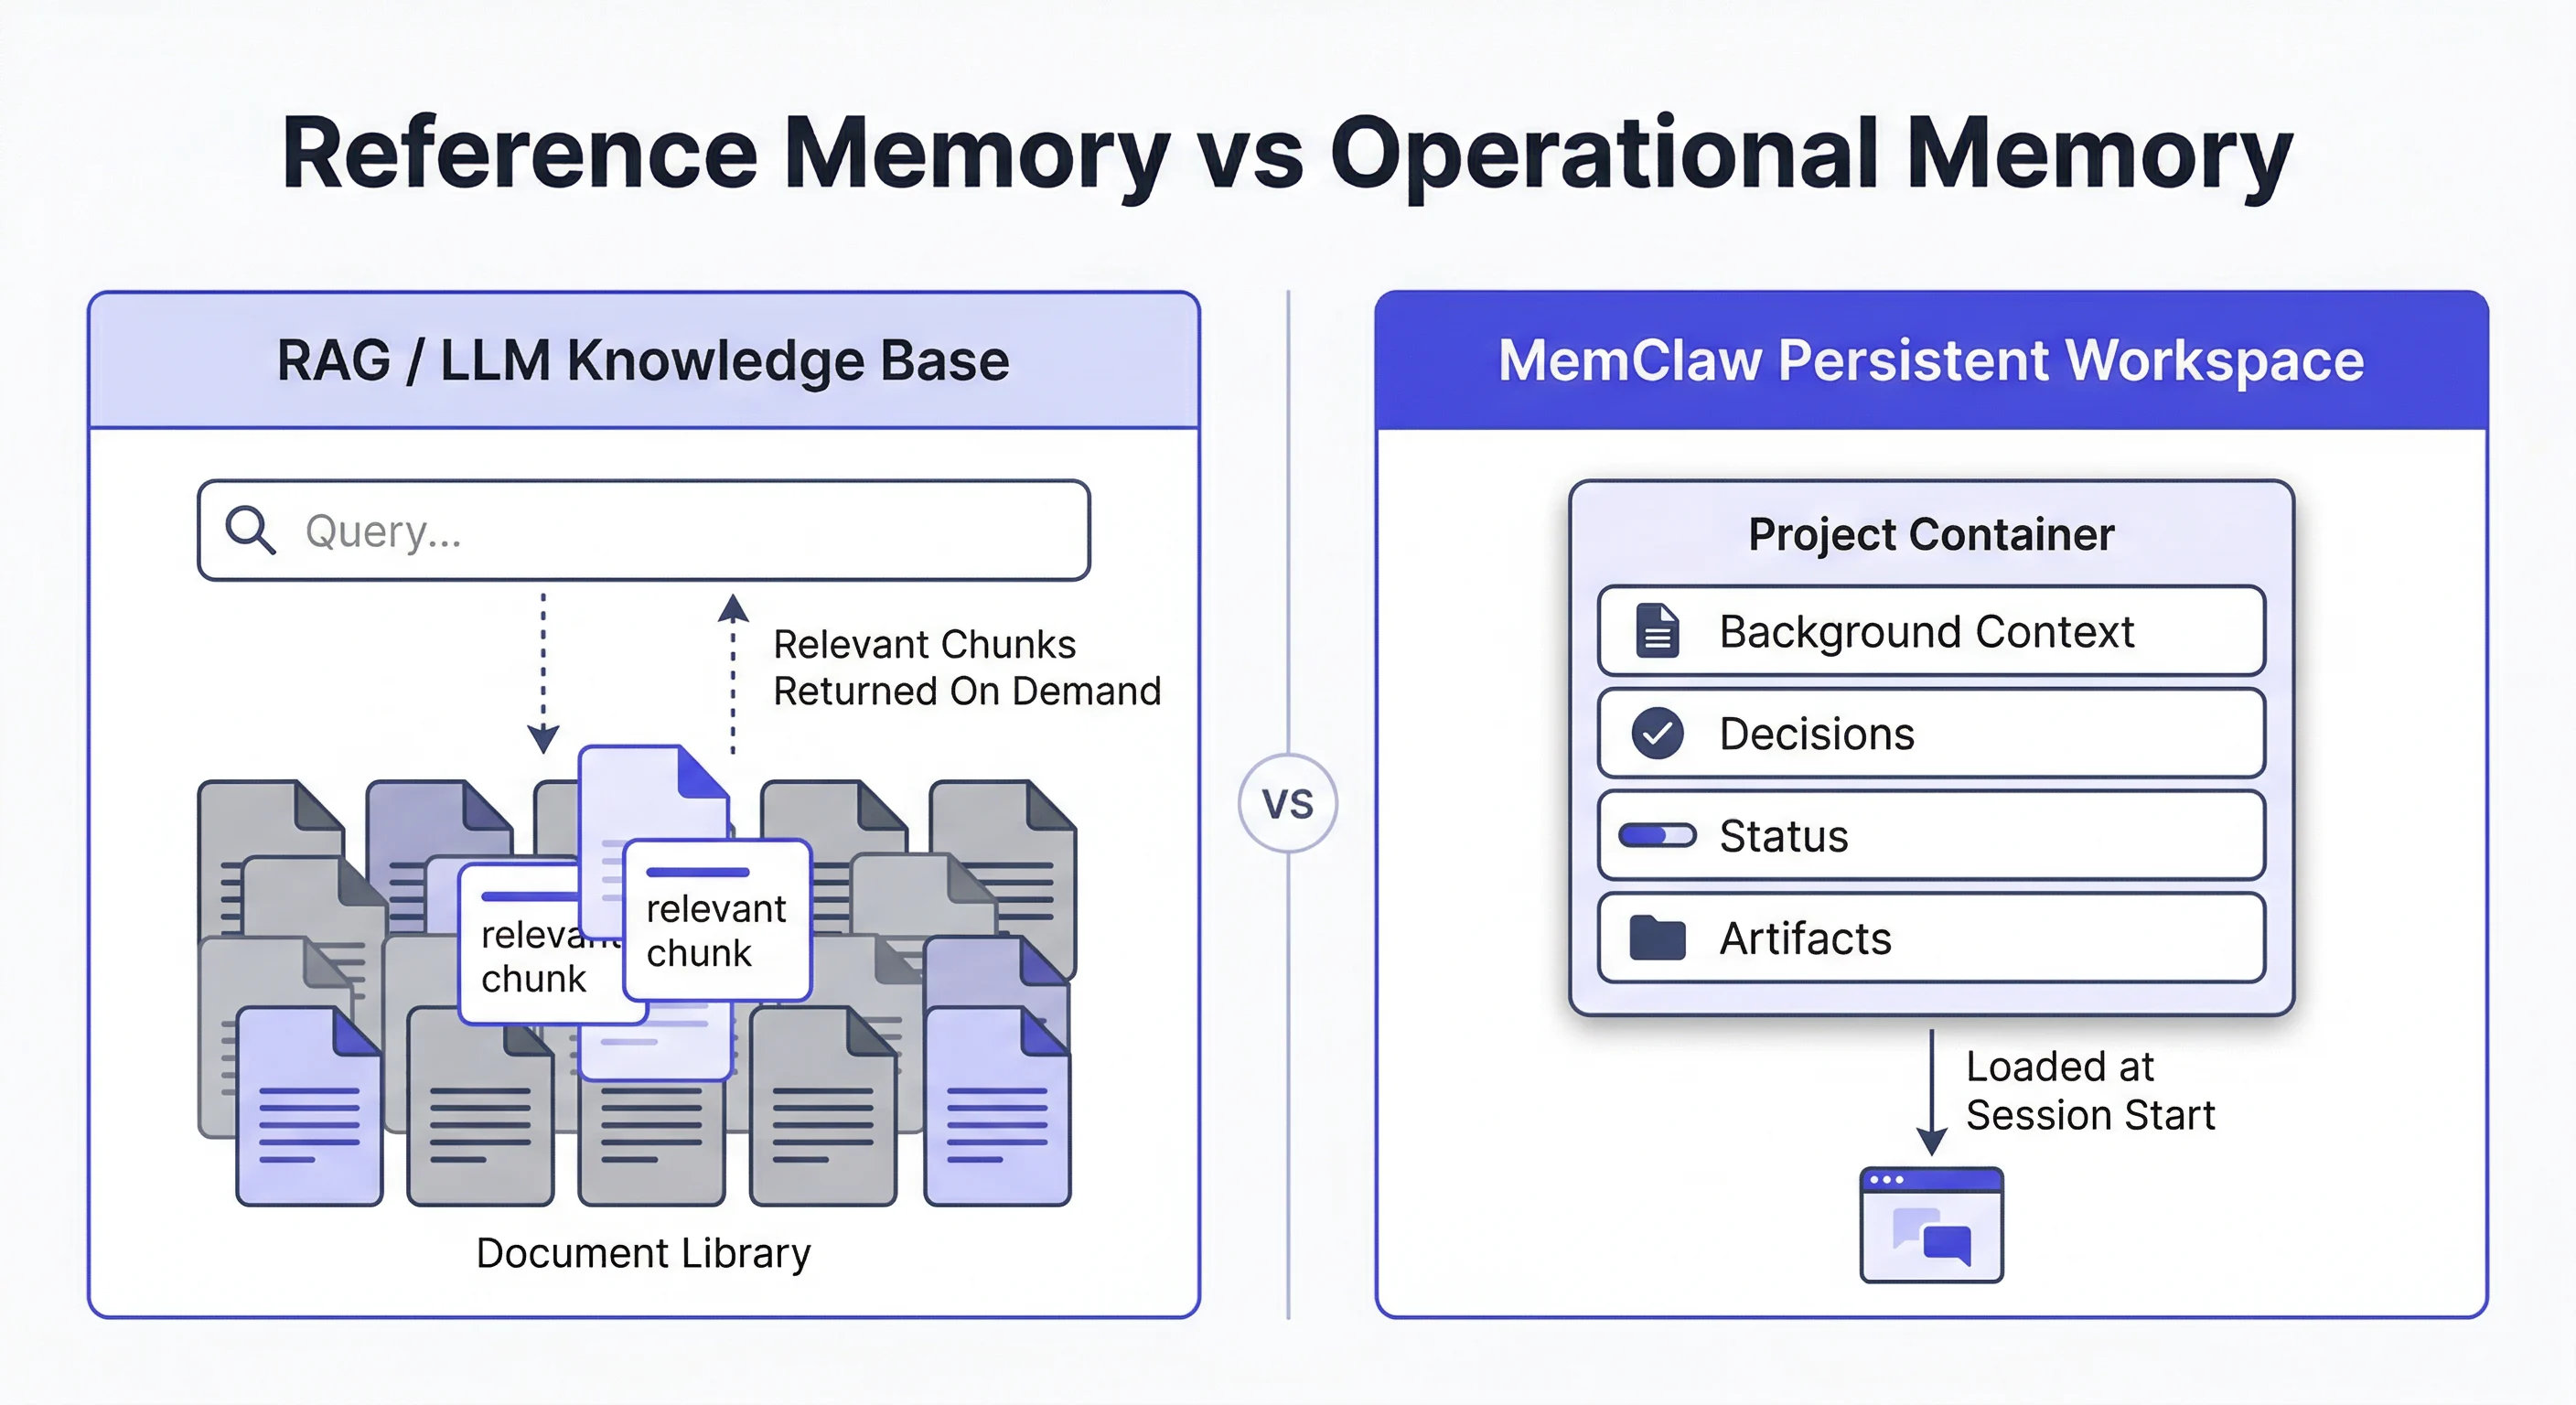
Bộ nhớ vận hành thay đổi việc tổng hợp vì nó xem vùng chứa dự án — bối cảnh nền, quyết định, trạng thái, hiện vật — là đối tượng được tải khi bắt đầu phiên, thay vì xem tài liệu là đống cỏ cần được truy vấn lại. Bộ nhớ tham chiếu hỏi: “Đoạn nào trông giống câu hỏi này?” Bộ nhớ vận hành hỏi: “Điều gì đã đúng về dự án này, và điều gì vẫn cần bằng chứng?”
Sự khác biệt đó xuất hiện trong ba kiểu thất bại mà công cụ tóm tắt che giấu khá tốt:
- Trôi dạt tiêu chí. Nếu “chỉ RCT ở người trưởng thành” nằm trong lời nhắc thay vì trạng thái dự án, một phiên sau đặt câu hỏi rộng hơn đôi chút sẽ âm thầm đưa lại các nghiên cứu nhi khoa bạn đã loại.
- Các mục có thể bị bỏ rơi. Những bài báo cận biên được tạm giữ để thảo luận với đồng tác giả sẽ biến mất trừ khi trạng thái là một trường hạng nhất.
- Tổng hợp được tạo lại. Một câu trả lời RAG có thể trung thực cục bộ với các đoạn được truy xuất hôm nay nhưng vẫn mâu thuẫn với bảng khoảng trống tuần trước, vì không có gì buộc câu trả lời mới kế thừa mã hóa cũ.
Không gian làm việc bền vững đảo ngược thứ tự tải. Bối cảnh nền, quyết định, trạng thái và hiện vật được đưa vào trước truy vấn tiếp theo. Nền tảng Jenova triển khai mô thức này bằng bộ nhớ xuyên phiên kết hợp cơ sở tri thức có thể đính kèm: trợ lý có thể ghi nhớ các chiều lập bản đồ, định nghĩa làm việc về khoảng trống bằng chứng và những tuyên bố đã có đủ hỗ trợ. Thử nghiệm điều này với các công cụ kiểu sổ tay cho thấy một đánh đổi rõ ràng. Kho tư liệu khép kín của NotebookLM an toàn hơn trước việc bịa thêm nội dung ngoài nguồn (câu trả lời liên kết nguồn). Không gian làm việc mở bền vững hữu ích hơn khi kho tư liệu vẫn đang phát triển và khung mã hóa là tài sản khan hiếm.
Hàm ý thực tế cho SEM rất đơn giản. Nếu sản phẩm bàn giao của bạn là một bản tóm lược trong một lần ngồi về 15 PDF, bộ nhớ vận hành là tùy chọn. Nếu sản phẩm bàn giao là một bản đồ khoảng trống sẽ được cập nhật sau chu kỳ hội nghị tiếp theo, bộ nhớ vận hành chính là sản phẩm.
Một Quy Trình Bằng Chứng Tác Nhân Đầu Cuối Thực Sự Trông Như Thế Nào?
Một quy trình lập bản đồ đầu cuối trông giống một đợt nghiên cứu theo giai đoạn có các cổng kiểm soát, chứ không phải một lời nhắc duy nhất “hãy tóm tắt các bài báo này”. Hình minh họa dưới đây là kiến trúc tham chiếu hữu ích: hình thành câu hỏi, phân loại tài liệu, xác định ứng viên, chính thức hóa giả thuyết, xác thực đa nguồn, báo cáo có phiên bản và gói được Git theo dõi.
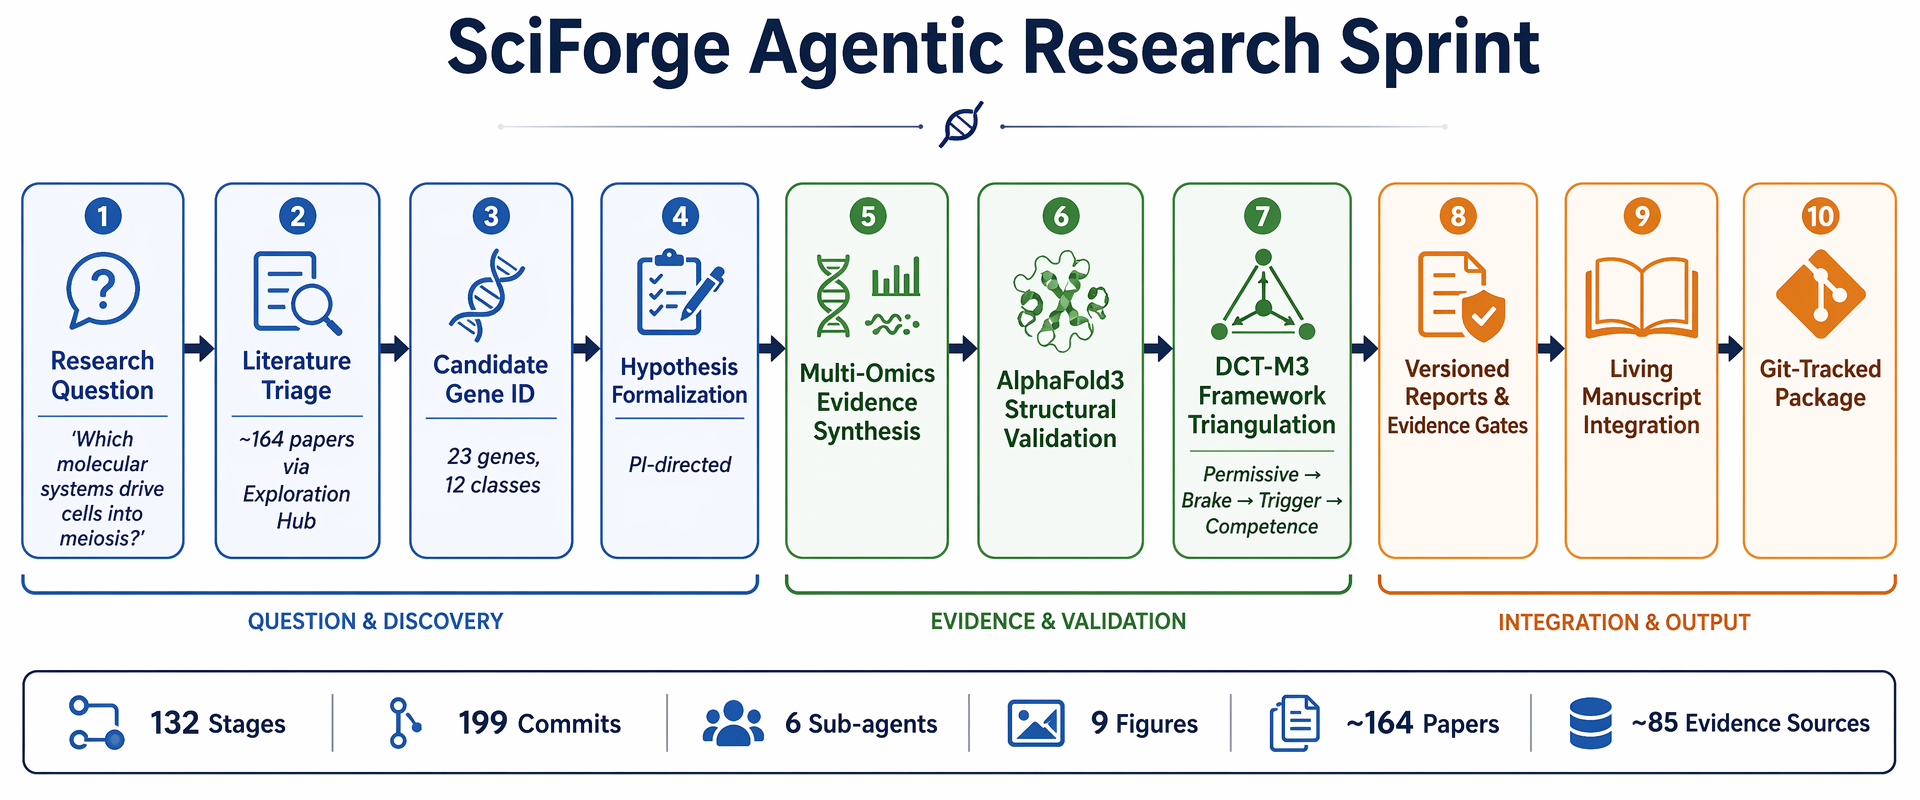
Đợt ví dụ này được thiết kế có chủ ý ở quy mô lớn — khoảng 164 bài báo được phân loại, 132 giai đoạn, 199 lượt cam kết, sáu tác nhân phụ và xấp xỉ 85 nguồn bằng chứng — vì đây là quy mô khiến trò chuyện bài báo sụp đổ. Một công cụ tóm tắt có thể mô tả bài báo số 17. Nó không thể giữ nhất quán một chuỗi 10 giai đoạn khi giai đoạn 4 thay đổi quy tắc đưa vào mà giai đoạn 2 đã áp dụng.
Ba lựa chọn thiết kế trong quy trình đó quan trọng hơn các chi tiết lĩnh vực:
- Khám phá là một giai đoạn, không phải sản phẩm. Phân loại tài liệu cung cấp mã định danh ứng viên và giả thuyết chính thức. Dừng ở tóm tắt đồng nghĩa bản đồ vẫn chưa được xây dựng.
- Xác thực có nhiều phương thức. Tổng hợp bằng chứng, kiểm tra cấu trúc hoặc định lượng và logic rõ ràng “cho phép → phanh → kích hoạt” buộc các tuyên bố đi qua cổng thay vì bị trung bình hóa thành một đoạn văn.
- Đầu ra được lập phiên bản. Tích hợp bản thảo đang phát triển và gói được Git theo dõi biến bản đồ thành hiện vật có lịch sử. Đây là đối lập với bản ghi trò chuyện mà bạn không thể phát lại.
Jenova có thể xấp xỉ mô thức này bằng cách phân tách vai trò giữa các tác nhân thay vì buộc một cuộc trò chuyện vừa làm thủ thư, vừa làm người mã hóa, vừa làm người viết. Academic Research Assistant xử lý khám phá học thuật và bối cảnh bản thảo. Deep Research tạo tổng hợp có trích dẫn dựa trên nhiều nguồn. Real-Time Search hữu ích khi bản đồ cũng phải bao gồm bản thảo sơ bộ, kho lưu trữ hoặc tài liệu xám không phải tạp chí. Hạn chế nằm ở kỷ luật điều phối: con người vẫn sở hữu giao thức, các cổng và quyết định đưa một tuyên bố vào bản thảo đang phát triển. Các nhóm phương pháp vẫn xem vai trò của con người là không thể thay thế (hướng dẫn KCL / RAISE).
Các nền tảng tổng quan tất cả trong một kiểu Paperguide cố gắng gộp lập kế hoạch–tìm kiếm–sàng lọc–trích xuất–tạo nội dung vào quy trình của một nhà cung cấp, bao gồm các chế độ Extended sàng lọc 200 ứng viên và viết từ 50 ứng viên hàng đầu. Cách này gần với một không gian làm việc hơn Elicit cộng Word, nhưng vẫn cần nhật ký quyết định bên ngoài nếu bạn quan tâm đến nguồn gốc sau khi tổng quan được tạo ra đã xuất đi.
Làm Thế Nào Để Khai Thác Tối Đa Bản Đồ Bằng Chứng AI?
Bạn khai thác tối đa bản đồ bằng chứng AI bằng cách viết giao thức vào không gian làm việc trước khi yêu cầu văn xuôi, sau đó buộc mọi phiên sau kế thừa giao thức đó. Thiết lập tương tự giữa các công cụ; điểm khác biệt là liệu công cụ có thể nhớ thiết lập hay không.
Với bản đồ lấy Jenova làm trung tâm, một trình tự khả thi là:
- Mở Academic Research Assistant và nêu tên dự án, quần thể cùng các chiều lập bản đồ trong tin nhắn đầu tiên.
- Ghim giao thức bằng ngôn ngữ trợ lý có thể tái sử dụng:
“Xây dựng bản đồ bằng chứng có hệ thống về các nghiên cứu trên người trưởng thành liên quan đến X. Chỉ đưa vào RCT và đoàn hệ tiến cứu. Mã hóa mỗi nghiên cứu theo thiết kế, mẫu, can thiệp, kết quả chính, chiều hướng tác động và hạn chế. Đưa các bài báo về động vật và in-vitro vào nhật ký loại trừ cùng lý do một dòng. Không tạo lại các mã đã được quyết định.”
- Chạy Deep Research cho lượt quét kho tư liệu đầu tiên, sau đó dán hoặc đính kèm bảng làm việc trở lại cùng luồng dự án để phần trích xuất và phần tường thuật dùng chung một bộ nhớ.
- Sau mỗi phiên, yêu cầu ba hiện vật thay vì một bài luận: bảng nghiên cứu được cập nhật, nhật ký loại trừ và danh sách khoảng trống. Ba tệp này chính là bản đồ.
Với Elicit, hãy bắt đầu bằng câu hỏi nghiên cứu, tạo bảng sàng lọc và xem thư viện là nguồn chân thực duy nhất (quy trình tổng quan hệ thống của Elicit). Đừng bỏ qua tìm kiếm cơ sở dữ liệu thông thường. Các nghiên cứu tình huống Cochrane cho thấy Elicit hữu ích cho tìm kiếm sơ bộ độ chính xác cao và tìm thêm các nghiên cứu độc nhất, chứ không phải công cụ tìm kiếm duy nhất.
Với NotebookLM, hãy thu thập PDF trước, duy trì trong một sổ tay và đặt câu hỏi theo từng chiều (“Liệt kê mọi nghiên cứu báo cáo kết quả Y cùng cỡ mẫu và thời gian theo dõi”) để kho tư liệu khép kín không đi lạc. Giới hạn tải lên — 50 nguồn ở gói miễn phí, 300 nguồn trên Plus — khiến đây không phải công cụ phù hợp cho bản đồ 400 hồ sơ nếu bạn không sàng lọc trước ở nơi khác.
Hai quy tắc quy trình áp dụng cho mọi bộ công cụ. Thứ nhất, không tải toàn văn PDF vào mô hình tiêu dùng nếu điều khoản bản quyền cấm điều đó; chủ sở hữu quyền nói chung cấm cách sử dụng này. Thứ hai, hãy giữ con người ở vị trí quyết định đưa vào/loại trừ. Hỗ trợ sàng lọc là nhiệm vụ AI có nhiều bằng chứng hỗ trợ nhất; tổng hợp không giám sát là nhiệm vụ có ít nhất (tổng quan các tổng quan về mức độ sẵn sàng của AI).
Các Chuyên Gia Tổng Hợp Bằng Chứng Nói Gì Về Lập Bản Đồ Có Hỗ Trợ AI?
Các chuyên gia ngày càng chấp nhận AI cho sàng lọc và trích xuất có giám sát, nhưng vẫn bác bỏ AI như một người lập bản đồ tự giám sát của cả lĩnh vực. Đồng thuận chuyên môn hữu ích vào năm 2026 hẹp hơn nội dung tiếp thị của nhà cung cấp: tự động hóa lớp lặp lại, duy trì lớp quyết định và giữ con người chịu trách nhiệm về bản đồ.
“Kiểu thất bại chúng tôi thấy không phải là mô hình không thể tóm tắt một bài báo. Vấn đề là các nhóm lập bản đồ coi một bản tóm tắt tốt như thể đó là một hồ sơ đã mã hóa. Bản đồ bằng chứng có hệ thống là tập hợp các quyết định có thể đảo ngược — đưa vào, loại, tạm giữ, chặn — gắn với các trường ổn định. Nếu các quyết định đó chỉ nằm trong lời nhắc tuần trước, bản đồ đã bị hỏng, ngay cả khi mọi đoạn văn vẫn có vẻ cẩn trọng.”
“Truy xuất tham chiếu và bộ nhớ vận hành giải quyết các vấn đề khác nhau. Truy xuất là cách tìm bằng chứng ứng viên. Bộ nhớ vận hành là cách tránh mã hóa lại cùng một nghiên cứu ba lần. Các công cụ xuất sắc ở công việc đầu tiên thường được triển khai như thể chúng cũng làm công việc thứ hai. Đó là cách bạn có một phân tích khoảng trống trôi chảy nhưng không thể giải thích vì sao 12 thử nghiệm cận biên biến mất.”
“Quy tắc làm việc của chúng tôi rất đơn giản. Dùng một công cụ kho tư liệu để điền các hàng. Dùng một không gian làm việc bền vững để duy trì sổ mã, nhật ký loại trừ và bảng khoảng trống. Dùng người phản biện ở mọi cổng làm thay đổi ý nghĩa của bản đồ. Bất cứ sản phẩm nào được bán như một bản đồ hệ thống chỉ cần một cú nhấp đang yêu cầu bạn bỏ qua lớp duy nhất mà các nhóm phương pháp vẫn xem là không thể thay thế.”
— Đội ngũ sản phẩm Jenova, thiết kế quy trình nghiên cứu, 8 năm xây dựng hệ thống tri thức cho công việc phân tích đa phiên
Quan điểm này phù hợp với hướng dẫn chính thức. NICE, các khuyến nghị RAISE liên kết với Cochrane và các dịch vụ thư viện đại học đều mô tả AI là công cụ bổ trợ trong các phương pháp hiện có đã được xác thực. Một hướng dẫn cập nhật về AI trong tìm kiếm và sàng lọc tài liệu cũng đưa ra lập luận hiệu quả tương tự — sàng lọc tốn kém; tự động hóa giúp ích — nhưng không khẳng định việc tạo nội dung có thể thay thế giao thức.
Khi Nào Công Cụ Tóm Tắt Một Bài Báo Vẫn Là Lựa Chọn Phù Hợp?
Công cụ tóm tắt một bài báo vẫn là lựa chọn phù hợp khi kho tư liệu nhỏ, đã được thu thập và không được mã hóa thành bản đồ có thể tái sử dụng. Nếu bạn có 12 PDF, câu lạc bộ tạp chí vào ngày mai và không cần cập nhật danh mục trong ba tháng, trò chuyện bài báo kiểu NotebookLM hoặc SciSpace sẽ hoàn thành công việc với ít thủ tục hơn một vùng chứa dự án.
Chúng cũng phù hợp hơn cho ba công việc khác thường bị gắn nhãn sai là lập bản đồ:
- Giải thích cơ chế. “Hãy giải thích Hình 3” là một nhiệm vụ đọc. Một sổ tay kho tư liệu khép kín có trích dẫn có thể nhấp an toàn hơn không gian làm việc mở vốn có thể trộn lẫn các bài báo.
- Kiểm tra bối cảnh trích dẫn. Nếu câu hỏi là liệu công trình sau này có ủng hộ hay đối lập với một tuyên bố, trích dẫn được phân loại của Scite là lớp được xây dựng chuyên biệt cho mục đích đó (1,6B+ Smart Citations).
- Kiểm tra nhanh giả thuyết. Consensus vẫn là cách nhanh nhất để xem một mệnh đề có phân tách ủng hộ/đối lập rõ ràng hay không trước khi bạn đầu tư vào bản đồ (tổng quan Elicit so với Consensus).
Sai lầm là dùng các thế mạnh đó thay cho hạ tầng SEM. Một công cụ tóm tắt có thể xuất sắc ở cấp độ cục bộ mà vẫn là hệ thống ghi nhận không phù hợp. Ngược lại, một không gian làm việc bền vững có thể duy trì một sổ mã lộn xộn mà vẫn là công cụ sai cho sàng lọc kép 5.000 hồ sơ nếu bạn cần phần mềm SR chuyên dụng. Các hướng dẫn tổ chức vẫn hướng các nhóm đến những nền tảng sàng lọc như Rayyan, Covidence và DistillerSR cho giai đoạn đó (hướng dẫn AI cho SR của CASRAI; hướng dẫn tổng quan hệ thống của Stony Brook).
Do đó, quy tắc quyết định có thể đứng vững trong các tổng quan thực tế là quy tắc kiến trúc, không dựa trên thương hiệu. Nếu sản phẩm công việc là tập hợp các quyết định mã hóa có thể so sánh, cập nhật và giải thích, hãy chọn không gian làm việc nghiên cứu có bộ nhớ dự án và đặt một công cụ kho tư liệu bên cạnh. Nếu sản phẩm công việc là hiểu các bài báo đã có trên bàn, công cụ tóm tắt một bài báo không phải sự thỏa hiệp. Nó là công cụ có phạm vi phù hợp.
Tài Liệu Tham Khảo
- ScienceDirect — Hướng dẫn thực hiện bản đồ bằng chứng có hệ thống
- PubMed Central — Phương pháp cho tổng quan lập bản đồ, bản đồ bằng chứng và bản đồ khoảng trống
- Paperguide — 7 công cụ AI tốt nhất cho tổng quan tài liệu năm 2026
- King’s College London — Công cụ AI trong tổng hợp bằng chứng
- Elicit — AI cho nghiên cứu khoa học
- NotebookLM — Công cụ nghiên cứu AI và đối tác tư duy
- Google Blog — NotebookLM bổ sung Deep Research, Docx, Sheets và nhiều tính năng khác
- The Drive AI — Elicit so với Consensus so với Semantic Scholar
- Omid Saffari — Công cụ nghiên cứu AI tốt nhất năm 2026: Elicit so với Consensus
- Hướng dẫn sử dụng AI trong tìm kiếm và sàng lọc tài liệu
- CASRAI — Công cụ AI cho tổng quan tài liệu có hệ thống
- Thư viện Đại học Stony Brook — Hướng dẫn tổng quan hệ thống: Trí tuệ nhân tạo