Trợ lý nghiên cứu AI có tốt hơn tìm kiếm từ khóa để tìm bài báo liên quan không?
2026-08-22
Khi nào đối sánh ngữ nghĩa vượt xếp hạng từ khóa đối với các bài báo liên quan về mặt khái niệm?
Trợ lý nghiên cứu AI ngữ nghĩa vượt tìm kiếm từ khóa truyền thống khi các bài báo bạn cần mô tả cùng một ý tưởng bằng thuật ngữ khác nhau, trong khi công cụ từ khóa vẫn mạnh hơn khi bạn đã biết chính xác cụm từ, tác giả hoặc cụm trích dẫn cần nhắm đến. Vào năm 2026, câu trả lời thực tế không phải là từ bỏ Google Scholar, mà là kết hợp xếp hạng từ vựng với truy hồi dựa trên ý nghĩa — bằng các công cụ như Elicit, SciSpace, Undermind và Trợ lý Nghiên cứu Học thuật của Jenova.
Các yếu tố then chốt phân biệt việc khám phá khái niệm hiệu quả với đối sánh từ khóa:
✅ Tính linh hoạt về từ vựng — liệu hệ thống có thể tìm ra bài báo về "nhồi máu cơ tim" khi truy vấn dùng cụm "đau tim" hay không ✅ Tín hiệu xếp hạng — điểm từ vựng có trọng số trích dẫn so với độ tương đồng embedding so với việc LLM đánh giá mức độ liên quan ✅ Độ sâu chỉ mục — metadata tiêu đề-tóm tắt so với đối sánh toàn văn trên hàng trăm triệu công trình ✅ Kiểm soát độ chính xác — Boolean lồng nhau, giới hạn trường, bộ lọc chất lượng tạp chí và giới hạn xuất dữ liệu ✅ Thời gian để có tập kết quả hữu ích — danh sách khám phá tức thì so với các lượt tìm kiếm lặp kéo dài nhiều phút
Để so sánh các phương pháp này một cách trung thực, nên xem lệch từ vựng, thiên lệch xếp hạng và khả năng kiểm soát tìm kiếm là các chiều riêng biệt, thay vì hỏi công cụ nào tốt hơn trong mọi trường hợp.
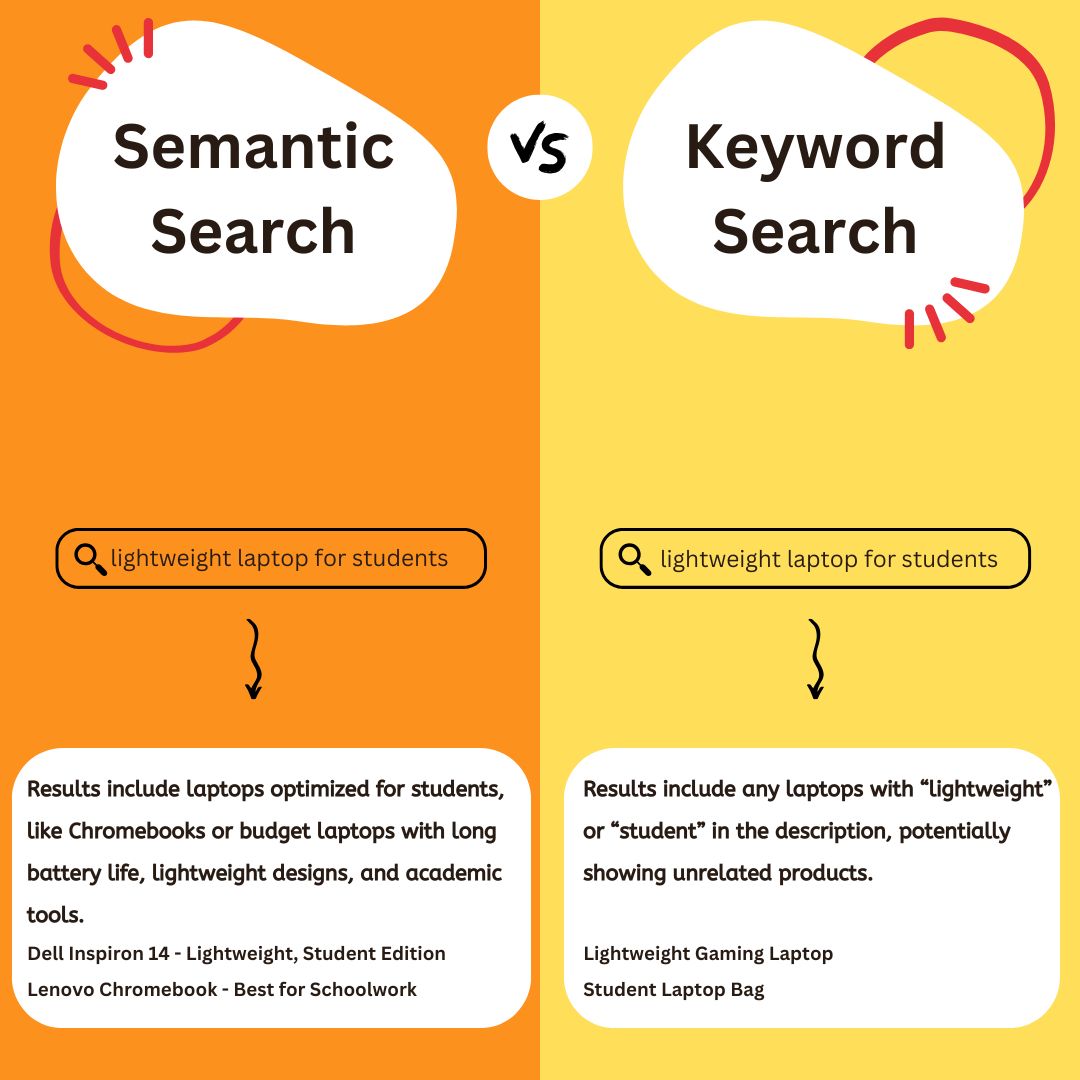
Vì sao sự lệch từ vựng vẫn làm hỏng tìm kiếm học thuật truyền thống vào năm 2026?
Sự lệch từ vựng vẫn làm hỏng tìm kiếm học thuật truyền thống vì tác giả, lĩnh vực và giai đoạn thời gian gọi cùng một hiện tượng bằng những tên khác nhau, còn công cụ từ vựng chỉ truy hồi được tài liệu có đủ các từ bề mặt trùng với truy vấn. Một bài báo y tế công cộng có thể dùng "hoạt động thể chất", một bài báo tim mạch dùng "khả năng vận động", còn một bài báo xã hội học dùng "vận động trong thời gian rảnh". Nếu chỉ tìm một cụm từ, hai cụm còn lại có thể biến mất khỏi vài trang kết quả đầu tiên.
Google Scholar vẫn là điểm bắt đầu mặc định của phần lớn nhà nghiên cứu và vẫn là bề mặt tìm kiếm học thuật đơn lẻ rộng nhất hiện có, bao gồm toàn văn từ nhà xuất bản và kho lưu trữ. Aaron Tay, thủ thư học thuật tại Singapore Management University, mô tả nó là con dao đa năng Thụy Sĩ của tìm kiếm học thuật — công cụ ông sẽ giữ lại nếu chỉ được chọn một. Tuy nhiên, xếp hạng của nó vẫn dựa trên từ vựng. Sau các kết quả khớp tiêu đề, nó đặt trọng số lớn lên các bài báo được trích dẫn nhiều, điều này rất tốt để tìm công trình nền tảng nhưng yếu khi cần tìm các bài báo liên quan về mặt khái niệm sử dụng cách diễn đạt khác hoặc chưa tích lũy trích dẫn.
Vấn đề trở nên tệ hơn khi thuật ngữ truy vấn quá phổ biến. Do Google Scholar khớp trên toàn văn, tìm kiếm một công cụ hoặc khái niệm có tên gọi thông dụng có thể bùng nổ thành hàng nghìn kết quả trùng khớp ngẫu nhiên. Tay lưu ý rằng tìm kiếm "Elicit" gần như vô ích trên Google Scholar trừ khi bạn thêm cách xử lý theo lĩnh vực, vì từ này xuất hiện liên tục trong các phần phương pháp. Hệ thống ngữ nghĩa giảm kiểu thất bại này bằng cách chấm điểm ý nghĩa thay vì độ chồng lấp chuỗi ký tự; đó là lý do chúng đã trở thành lớp bổ sung thay vì chỉ là một điều mới lạ.
Bạn nên đánh giá điều gì khi so sánh tìm kiếm từ khóa và trợ lý AI ngữ nghĩa?
Bạn nên đánh giá tìm kiếm từ khóa và trợ lý AI ngữ nghĩa trên sáu chiều mà bài viết này gọi là Khung khôi phục bất tương hợp: tính linh hoạt về từ vựng, tính minh bạch của xếp hạng, phạm vi chỉ mục, khả năng kiểm soát độ chính xác, tín hiệu uy tín và thời gian để có tập kết quả hữu ích. Một công cụ thắng ở một chiều thường thua ở chiều khác, vì vậy một bảng xếp hạng "người chiến thắng" duy nhất gây hiểu lầm nhiều hơn là hữu ích.
Tính linh hoạt về từ vựng hỏi liệu công cụ có thể truy hồi một bài báo mà phần tóm tắt không lặp lại thuật ngữ truy vấn của bạn hay không. Embedding dày đặc và các phương pháp lai như SPLADE, mà Elicit sử dụng như một phương pháp embedding thưa đã được học, được xây dựng cho mục đích này. Tính minh bạch của xếp hạng hỏi liệu bạn có thể giải thích vì sao một bài báo xuất hiện hay không. Các hệ thống Boolean cộng BM25 dễ kiểm toán hơn; tìm kiếm láng giềng gần nhất bằng embedding và bộ xếp hạng lại LLM khó tái lập hơn.
Phạm vi chỉ mục không giống với "số bài báo được quảng cáo". OpenAlex báo cáo 517 triệu bản ghi công trình và 66 triệu PDF toàn văn, trong khi Elicit cho biết họ tìm kiếm, tóm tắt và trích xuất dữ liệu từ hơn 125 triệu bài báo. Google Scholar không công bố số liệu chính thức tương đương, nhưng được xem rộng rãi là chỉ mục tìm kiếm học thuật toàn văn lớn nhất. Kiểm soát độ chính xác bao gồm Boolean lồng nhau, giới hạn trường, toán tử gần nhau và từ vựng được kiểm soát — những tính năng mà The Lens và OpenAlex vượt trội hơn Google Scholar.
Tín hiệu uy tín gồm số lượt trích dẫn, hạng tạp chí và cờ rút bài. Google Scholar và, ở mức độ thấp hơn, Undermind có xu hướng ưu tiên các công trình được trích dẫn nhiều. Elicit và SciSpace thường xếp hạng theo độ tương đồng ngữ nghĩa và không đặt trọng số cho trích dẫn, do đó các bài mới hơn hoặc ít được trích dẫn hơn sẽ nổi lên. Thời gian để có tập kết quả hữu ích phân biệt tìm kiếm từ khóa tức thì với các lượt chạy lặp kiểu Undermind vốn mất ít nhất ba phút. Hãy chấm điểm từng chiều theo nhiệm vụ thực tế của bạn — khám phá nhiều từ đồng nghĩa, độ bao phủ hệ thống hoặc định hướng trong năm phút — trước khi chọn công cụ chính.
Google Scholar, Elicit, SciSpace, Undermind và Jenova khác nhau thế nào trong khám phá khái niệm?
Google Scholar mạnh nhất cho khám phá rộng có trọng số trích dẫn; Elicit và SciSpace mạnh nhất khi từ khóa chưa rõ; Undermind mạnh nhất cho các cuộc tìm kiếm hẹp, độ chính xác cao; còn Trợ lý Nghiên cứu Học thuật của Jenova mạnh nhất khi việc khám phá, tổng hợp và xử lý trích dẫn cần diễn ra trong một cuộc trò chuyện liên tục. Không công cụ nào thống trị mọi ô trong Khung khôi phục bất tương hợp.
| Tính năng / Chiều đánh giá | Google Scholar | Elicit / SciSpace | Undermind | Trợ lý Nghiên cứu Học thuật Jenova | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Phương pháp đối sánh | Từ vựng / từ khóa, có trọng số trích dẫn | Ngữ nghĩa hoặc lai (Elicit dùng SPLADE) | Truy hồi lai kết hợp đánh giá mức độ liên quan bằng LLM và tìm kiếm lặp | Tác nhân nghiên cứu ngôn ngữ tự nhiên trên các nguồn học thuật trực tiếp, gồm Google Scholar | Tìm kiếm metadata học thuật có cấu trúc bằng toán tử nâng cao |
| Khôi phục cách diễn đạt khác | Yếu nếu không thêm từ đồng nghĩa hoặc dùng Bài viết liên quan | Mạnh đối với truy vấn dựa trên ý nghĩa | Mạnh đối với bản mô tả bằng ngôn ngữ tự nhiên cụ thể | Mạnh trong việc tái diễn đạt hội thoại qua nhiều phiên | Yếu đến trung bình; tùy thuộc vào cách xây dựng truy vấn |
| Thiên lệch uy tín | Ưu tiên bài báo được trích dẫn nhiều sau các kết quả khớp tiêu đề | Ít trọng số trích dẫn; các bài mới hơn nổi lên | Có một phần thiên lệch về công trình nền tảng thông qua tìm kiếm trích dẫn | Dựa theo các nguồn được kết nối và bản mô tả bạn cung cấp | Do metadata chi phối; được thiết kế cho phân tích hơn là xếp hạng ngữ nghĩa |
| Tính năng độ chính xác | Không có Boolean lồng nhau, giới hạn 256 ký tự, tìm kiếm trường hạn chế | Bộ lọc hậu kỳ về chất lượng tạp chí, ví dụ hạng Scimago trên SciSpace | Độ cụ thể bằng ngôn ngữ tự nhiên thay vì Boolean | Thu hẹp qua hội thoại; không phải công cụ cú pháp Boolean | Boolean lồng nhau, tìm kiếm gần nhau, tìm kiếm theo trường, từ vựng được kiểm soát |
| Thời gian truy vấn điển hình | Tức thì | Đủ nhanh để khám phá | Ít nhất khoảng 3 phút cho mỗi lượt tìm kiếm | Tương tác; các lượt theo sau diễn ra ngay | Tức thì đến phụ thuộc nhịp API |
| Giá (tính đến năm 2026) | Miễn phí | Elicit Pro khoảng $49/tháng; các gói trả phí của SciSpace được báo cáo từ $12 đến $160/tháng | Gói khám phá miễn phí; gói học thuật trả phí | Gói miễn phí với mức sử dụng giới hạn; Plus từ $20/tháng | Tìm kiếm web miễn phí; OpenAlex API có gói miễn phí |
| Phù hợp nhất với | Bài báo nền tảng, lần theo Cited by, tra cứu toàn văn | Từ khóa chưa rõ và truy vấn dạng câu hỏi | Tìm một loại nghiên cứu cụ thể với độ bao phủ cao | Công việc tài liệu đầu-cuối với bộ nhớ và hỗ trợ bản thảo | Tìm kiếm có hệ thống, tái lập được và kiểm soát cao |
Google Scholar
Google Scholar vẫn là công cụ tổng quát. Các trang trợ giúp chính thức xác nhận rằng kết quả thường được sắp xếp theo mức độ liên quan, không phải theo ngày, và nhà nghiên cứu có thể chuyển hướng qua Bài viết liên quan và Được trích dẫn bởi khi đã có một bài báo hạt giống. Hai tính năng này là điều gần nhất mà tìm kiếm từ khóa đạt được với khám phá khái niệm, nhưng chúng đòi hỏi một hạt giống tốt. Các điểm yếu đã được ghi nhận rõ: không có Boolean lồng nhau, không tìm kiếm trường chỉ-tóm-tắt, giới hạn truy vấn 256 ký tự, trần 1.000 kết quả và không xuất hàng loạt. Sự kết hợp này là lý do các thủ thư thường loại nó khỏi vai trò cơ sở dữ liệu chính cho tổng quan hệ thống.
Elicit và SciSpace
Elicit tự định vị là AI để tìm kiếm, tóm tắt, trích xuất và trò chuyện với hơn 125 triệu bài báo, phục vụ hơn 2 triệu người dùng nghiên cứu. Cả Elicit lẫn SciSpace đều chấp nhận câu hỏi bằng ngôn ngữ tự nhiên và xếp hạng theo độ tương đồng ngữ nghĩa, nên có thể tìm ra các bài báo có cách diễn đạt khác với truy vấn. Sự đánh đổi là thiên lệch xếp hạng theo hướng ngược lại với Google Scholar: chúng có thể đẩy lên các bài báo gần về ngữ nghĩa nhưng chất lượng thấp hoặc ít được trích dẫn. SciSpace thường nhanh hơn và phù hợp hơn để lấy hiểu biết nhanh hơn là tổng hợp lặp chuyên sâu. Kết quả cũng có thể không tất định, vì vậy cùng một truy vấn có thể không trả về cùng một tập kết quả hai lần.
Undermind
Undermind là công cụ chuyên biệt. Nó kết hợp truy hồi từ khóa và ngữ nghĩa, sau đó dùng một mô hình tiên tiến để đánh giá liệu tiêu đề, tóm tắt và metadata sẵn có có thực sự đáp ứng bản mô tả hay không, đồng thời lặp lại với tìm kiếm trích dẫn. Trong một thử nghiệm so với tập bài báo được đưa vào của một tổng quan hệ thống, nó truy hồi được 8 trong 11 bài báo chuẩn vàng trong 10 kết quả đầu (recall@10 là 72,7%) và 9 trong 11 bài ở vị trí 50 trở xuống (recall@50 là 81,8%). Chất lượng đó đánh đổi bằng thời gian và hoạt động kém với các chủ đề mơ hồ. Nó cũng chủ yếu xem tiêu đề và tóm tắt, cùng một phần toàn văn truy cập mở, nên các tuyên bố chỉ nằm trong phần phương pháp hoặc kết quả có thể bị bỏ sót.
Trợ lý Nghiên cứu Học thuật của Jenova
Trợ lý Nghiên cứu Học thuật của Jenova là đối tác nghiên cứu nhận biết theo ngành, thay vì một chỉ mục bài báo độc lập. Công cụ thực hiện khám phá tài liệu trực tiếp trên các nguồn học thuật, sau đó đồng hành cùng dự án qua tổng hợp, chuẩn bị bản thảo và quản lý trích dẫn. Bộ nhớ liên tục cho phép công cụ ghi nhớ rằng thuật ngữ đang dùng của bạn là "mệt mỏi nhận thức", trong khi tài liệu cũng dùng "cạn kiệt bản ngã" và "nhu cầu phục hồi", đồng thời giữ các cụm từ đồng nghĩa đó gắn với cùng một dự án qua nhiều phiên.
Giới hạn cần nhìn nhận trung thực nằm ở kiến trúc. Nó không cung cấp một chỉ mục ngữ nghĩa độc quyền 125 triệu bài báo kèm bảng trích xuất tích hợp theo cách của Elicit, và cũng không phải công cụ tìm kiếm lặp nhiều phút kiểu Undermind có chuẩn benchmark recall@10 được công bố. Điểm mạnh của nó là điều phối: bản mô tả bằng ngôn ngữ tự nhiên, tra cứu học thuật trực tiếp, đặt câu hỏi theo sau và hỗ trợ viết trong một luồng. Nhà nghiên cứu cần dấu vết kiểm toán Boolean có thể tái lập vẫn nên chạy The Lens hoặc OpenAlex song song.
Tìm kiếm ngữ nghĩa khôi phục các bài báo dùng cách diễn đạt khác cho cùng một ý tưởng như thế nào?
Tìm kiếm ngữ nghĩa khôi phục các bài báo diễn đạt khác nhau bằng cách embedding truy vấn và bộ sưu tập tài liệu vào một không gian ý nghĩa chung, rồi truy hồi các láng giềng gần nhất thay vì yêu cầu các từ trùng lặp. Nếu truy vấn là "y tá ca đêm phục hồi sự tập trung như thế nào sau các ca trực liên tiếp", một công cụ từ vựng sẽ tìm những từ đó. Công cụ ngữ nghĩa có thể truy hồi các nghiên cứu có tiêu đề xoay quanh "rối loạn nhịp sinh học", "giấc ngủ phục hồi" hoặc "mệt mỏi nghề nghiệp", ngay cả khi "y tá" hoặc "sự tập trung" không xuất hiện trong tiêu đề.
Semantic Scholar, công cụ tài liệu của Allen Institute for AI, là một minh chứng công khai sớm cho ý tưởng này: xếp hạng bài báo khoa học theo ý nghĩa được hiểu thay vì đối sánh chuỗi ký tự. Elicit và SciSpace áp dụng nguyên tắc tương tự ở quy mô ứng dụng web. Tay mô tả một thử nghiệm đặc biệt rõ ràng: dán một đoạn báo chí mô tả phát hiện của nghiên cứu, và một công cụ ngữ nghĩa có thể tìm ra bài báo tạp chí gốc, vì embedding của văn xuôi báo chí nằm gần embedding của bài báo. Tìm kiếm từ khóa gần như không bao giờ vượt qua được kiểu diễn đạt lại đó.
Có một cơ chế thứ hai, kín đáo hơn: mở rộng truy vấn bên trong trợ lý. Một tác nhân hội thoại có thể tạo tập từ đồng nghĩa, khái niệm kiểu MeSH liên quan, từ trái nghĩa và các biến thể theo ngành, sau đó tìm kiếm rõ ràng các biến thể đó. Đây không phải tìm kiếm vector thuần túy. Đó là dùng hiểu biết ngữ nghĩa để dựng một lưới từ vựng tốt hơn. Trên thực tế, quy trình có độ bao phủ cao nhất làm cả hai — embedding để truy hồi các cách diễn đạt chưa từng thấy, rồi xác minh bằng cụm từ chính xác, tên tác giả và liên kết trích dẫn để tập kết quả vẫn có thể kiểm toán.
Thử điều này trên một bản mô tả thực tế thường nhanh chóng phơi bày khoảng cách. Hỏi một công cụ từ khóa về "sự nhận biết của giáo viên", bạn chủ yếu sẽ nhận được các bài báo dùng đúng thuật ngữ nghiên cứu giáo dục đó. Hỏi một trợ lý ngữ nghĩa "giáo viên phát hiện và diễn giải tư duy bất ngờ của học sinh ngay tại thời điểm đó như thế nào", bạn cũng sẽ tìm được các công trình được xếp dưới "thị giác chuyên môn", "đánh giá quá trình" hoặc "ra quyết định tức thời". Tập thứ hai chính là những gì sự lệch từ vựng có thể che giấu.
Khi nào bạn vẫn nên dùng tìm kiếm từ khóa thay vì trợ lý AI ngữ nghĩa?
Bạn vẫn nên dùng tìm kiếm từ khóa khi cần truy hồi một mục đã biết, lần theo trích dẫn từ bài báo hạt giống, đối sánh cụm từ toàn văn hoặc một chiến lược Boolean có thể tái lập cho tổng quan hệ thống. Xếp hạng ngữ nghĩa là công cụ không phù hợp khi nhiệm vụ là "tìm tiêu đề này", "tìm mọi tài liệu trích dẫn thử nghiệm này" hoặc "ghi lại một chuỗi tìm kiếm mà phản biện có thể chạy lại".
Google Scholar là bước đầu phù hợp cho ba công việc thường nhật. Thứ nhất, tra cứu mục đã biết: đặt tiêu đề trong dấu ngoặc kép, như trợ giúp của Google và phần lớn hướng dẫn thư viện khuyến nghị. Thứ hai, lập bản đồ uy tín: mở một bài báo cột mốc và đi qua Được trích dẫn bởi để xem lĩnh vực đã làm gì tiếp theo, hoặc Bài viết liên quan để mở rộng từ một hạt giống. Thứ ba, săn cụm từ toàn văn: nếu khái niệm là tên phương pháp, bộ dữ liệu hoặc thang đo đặc trưng, tìm kiếm từ vựng toàn văn sẽ bắt được các đề cập mà chỉ mục ngữ nghĩa tiêu đề-tóm tắt bỏ lỡ.
Đối với tìm kiếm có hệ thống hoặc cực kỳ chính xác, hãy bỏ qua cả Google Scholar lẫn phần lớn ứng dụng ngữ nghĩa như hệ thống hồ sơ chính. The Lens và OpenAlex hỗ trợ Boolean lồng nhau, toán tử gần nhau, tìm kiếm theo trường và từ vựng được kiểm soát. OpenAlex là danh mục mở với 517 triệu công trình, 5,8 tỷ quan hệ đồ thị và bộ dữ liệu phạm vi công cộng (CC0). Một bản tin thư viện năm 2026 ước tính phạm vi của nó vào khoảng 474 triệu ấn phẩm với trọng tâm là truy cập mở và tính minh bạch. Google Scholar không thể sánh về khả năng kiểm toán này: nó giới hạn hiển thị ở 1.000 kết quả và không cung cấp truy cập hàng loạt.
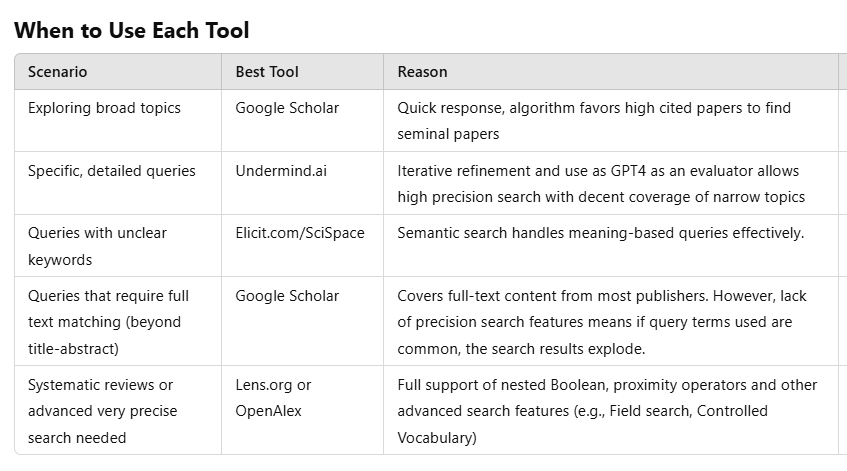
Hãy dùng bảng trên như một quy tắc định tuyến, không phải bài kiểm tra lòng trung thành. Định hướng rộng và tìm bài báo nền tảng nên ở lại với Google Scholar. Cách diễn đạt chưa rõ nên chuyển sang Elicit hoặc SciSpace. Một câu hỏi tồn tại cực kỳ cụ thể — "có RCTs nào dùng LLM làm bộ sàng lọc tiêu đề-tóm tắt và báo cáo precision cùng recall không?" — là bản mô tả dành cho Undermind. Các tìm kiếm có thể tái lập và nặng về toán tử thuộc về The Lens hoặc OpenAlex.
Làm thế nào để thực hiện tìm kiếm tài liệu kết hợp cả hai cách tiếp cận?
Bạn thực hiện tìm kiếm kết hợp bằng cách bắt đầu với một bản mô tả khái niệm, khôi phục các ứng viên đa dạng từ đồng nghĩa bằng ngữ nghĩa, sau đó cố định tập kết quả bằng toán tử từ vựng, lần theo trích dẫn và cơ sở dữ liệu có khả năng kiểm soát cao. Trình tự rất quan trọng. Nếu bắt đầu trong Google Scholar với một cụm từ, bạn kế thừa các điểm mù của cụm từ đó. Nếu không bao giờ rời danh sách xếp hạng ngữ nghĩa, bạn kế thừa vấn đề chất lượng và khả năng tái lập của danh sách đó.
Một quy trình thực tế có thể như sau:
- Viết nhu cầu thông tin theo cách một đồng nghiệp có thể hiểu, bao gồm quần thể, kết quả và những cách diễn đạt bạn đã biết là không ổn định.
- Chạy bản mô tả đó trong một trợ lý ngữ nghĩa để thu thập các bài báo ứng viên và từ vựng mà chúng thực sự sử dụng.
- Xây dựng bảng từ đồng nghĩa từ các tiêu đề và tóm tắt đó.
- Chạy lại các thuật ngữ đã mở rộng trên Google Scholar bằng dấu ngoặc kép,
author:, giới hạn ngày và Được trích dẫn bởi / Bài viết liên quan. - Với mọi nội dung cần toàn diện hoặc có thể kiểm toán, hãy xây dựng lại chiến lược trong The Lens hoặc OpenAlex bằng Boolean lồng nhau và giới hạn trường.
- Duy trì nhật ký đưa vào liên tục để các lần chạy ngữ nghĩa không tất định không âm thầm thay đổi cơ sở bằng chứng.
Trong Trợ lý Nghiên cứu Học thuật của Jenova, lượt mở đầu có thể là bản mô tả khái niệm thay vì chuỗi từ khóa:
"Tôi cần các bài báo thực nghiệm về cách nhân viên tri thức làm việc từ xa phục hồi sau mệt mỏi nhận thức. Hãy bao gồm các nghiên cứu có thể dùng kiệt sức, cạn kiệt bản ngã, nhu cầu phục hồi, suy nghĩ miên man ngoài giờ hoặc tách rời tâm lý thay vì từ mệt mỏi. Ưu tiên các tạp chí tâm lý học nghề nghiệp và HCI từ năm 2018 trở đi, đồng thời liệt kê từ đồng nghĩa mà mỗi bài báo thực sự sử dụng."
Một lượt theo sau sau đó chuyển bảng từ đồng nghĩa của trợ lý thành chiến lược từ vựng mà bạn có thể dán vào Google Scholar hoặc The Lens:
"Hãy chuyển các cụm từ đồng nghĩa thành ba truy vấn Google Scholar và một chuỗi Boolean lồng nhau phù hợp với OpenAlex hoặc The Lens. Hãy tách truy vấn giới hạn theo tiêu đề khỏi truy vấn toàn văn."
Trên Elicit hoặc SciSpace, hãy đặt câu hỏi bằng ngôn ngữ tự nhiên thay vì từ khóa — Tay lưu ý rằng truy vấn ngôn ngữ tự nhiên thường hoạt động kém hơn trong Google Scholar và tốt hơn trong các công cụ ngữ nghĩa này. Trên Undermind, hãy thêm ràng buộc cho đến khi bản mô tả chỉ có thể khớp với một thiết kế nghiên cứu cụ thể. Sau khi tập ứng viên đã tồn tại, tác nhân Deep Research của Jenova là công cụ phù hợp hơn để đọc chéo các nguồn và tạo bản tổng hợp có trích dẫn, trong khi Trợ lý Nghiên cứu Học thuật vẫn phù hợp hơn để duy trì bên trong quy trình học thuật gồm khám phá, trích dẫn và hỗ trợ bản thảo.
Một lưu ý áp dụng cho mọi bước có AI hỗ trợ. Hãy coi danh sách xếp hạng và bản tóm tắt được tạo là công cụ hỗ trợ truy hồi, không phải sàng lọc đã hoàn tất. Các tập 10 kết quả đầu ngữ nghĩa vẫn bỏ sót bài báo. Đánh giá mức độ liên quan của LLM thường nhưng không phải lúc nào cũng đồng thuận với con người. Các tuyên bố trong toàn văn vẫn cần PDF.
Thủ thư nghiên cứu và người đánh giá công cụ nói gì về khám phá AI ngữ nghĩa?
Các thủ thư nghiên cứu và nhà đánh giá độc lập nhìn chung xem trợ lý AI ngữ nghĩa là phần bổ sung cho Google Scholar, không phải sự thay thế, và đánh giá công cụ dựa trên chất lượng tìm kiếm cho một trường hợp sử dụng đã nêu thay vì theo các hạng mục tiếp thị. So sánh công bố hữu ích nhất trong lĩnh vực này đến từ đánh giá dựa trên thực hành, không phải benchmark của nhà cung cấp.
"Nếu tôi không biết trước trường hợp sử dụng của mình là gì và chỉ có thể chọn một công cụ tìm kiếm học thuật, chọn Google Scholar là điều hiển nhiên. Đây không phải lập luận chống lại tìm kiếm AI. Đây là lập luận chống lại việc giả vờ rằng một hàm xếp hạng duy nhất là đủ. Scholar vẫn là công cụ tổng quát. Các công cụ mới xứng đáng có vị trí khi truy vấn vụng về về ngữ nghĩa hoặc cực kỳ cụ thể."
"Thất bại tôi thường thấy nhất là sự không tương thích giữa loại truy vấn và công cụ. Mọi người nhập một chủ đề rộng vào tác nhân lặp và chờ vài phút để nhận một tập hẹp hơn mức cần thiết. Hoặc họ nhập một đoạn văn ngôn ngữ tự nhiên vào công cụ từ vựng rồi kết luận rằng tài liệu không tồn tại. Sự lệch từ vựng thường là lỗi quy trình trước khi là lỗ hổng cơ sở dữ liệu."
"Xếp hạng ngữ nghĩa cũng thay đổi ý nghĩa của 'liên quan'. Nếu không đặt trọng số cho trích dẫn, bạn sẽ thấy các bài mới hơn và đôi khi yếu hơn sớm hơn. Nếu có đặt trọng số cho trích dẫn, bạn sẽ tiếp tục phát hiện lại cùng một nhóm kinh điển. Nhà nghiên cứu muốn công trình liên quan về mặt khái niệm với cách diễn đạt khác cần hành vi thứ nhất. Nhà nghiên cứu muốn các bài mà mọi người khác mong đợi họ trích dẫn cần hành vi thứ hai. Một quy trình có năng lực sử dụng cả hai và ghi rõ lý do."
— Nhóm Sản phẩm Jenova, hệ thống khám phá tài liệu, 8 năm thiết kế quy trình nghiên cứu học thuật
Cách đóng khung đó phù hợp với hồ sơ công khai. Hướng dẫn đại học hiện nay đã liệt kê các công cụ tìm kiếm AI dùng trong tổng quan tài liệu, và các đánh giá sản phẩm phân biệt lượt xử lý lặp chậm hơn của Undermind với lượt quét ngữ nghĩa nhanh hơn của SciSpace. Đồng thuận của chuyên gia mang tính phương pháp, không mang tính phe phái: hãy chọn mô hình truy hồi phù hợp với loại bất tương hợp mà bạn muốn khắc phục.
Công cụ nào phù hợp với tổng quan hệ thống so với lập bản đồ tài liệu khám phá?
Tổng quan hệ thống cần hạ tầng từ vựng có khả năng kiểm soát cao; lập bản đồ tài liệu khám phá cần độ bao phủ ngữ nghĩa và lặp nhanh; phần lớn công việc luận văn và đề xuất tài trợ cần cách lai với quy trình được viết rõ cho từng giai đoạn. Đánh đồng các công việc đó là cách các nhóm hoặc bỏ lỡ nghiên cứu liên quan về mặt khái niệm, hoặc tạo ra tập bằng chứng không thể tái lập.
Đối với lập bản đồ khám phá — "đã có những gì được viết về ý tưởng này, dưới bất kỳ tên gọi nào?" — hãy bắt đầu bằng ngữ nghĩa. Elicit, SciSpace và trợ lý nghiên cứu hội thoại được xây dựng cho câu hỏi đó. Google Scholar có thể đóng góp khi bạn đã có bài báo hạt giống, thông qua Bài viết liên quan và Được trích dẫn bởi, và vẫn không có đối thủ trong việc nhanh chóng định vị PDF cùng liên kết thư viện. Trợ lý Nghiên cứu Học thuật của Jenova phù hợp với giai đoạn này khi bạn cũng cần bản đồ được duy trì: quyết định từ đồng nghĩa đã lưu, hướng nghiên cứu bị loại và định dạng trích dẫn cho bản thảo cuối cùng.
Đối với tổng quan hệ thống hoặc tổng quan phạm vi, không để danh sách xếp hạng ngữ nghĩa trở thành tìm kiếm chính thức. Hãy dùng The Lens hoặc OpenAlex làm xương sống có thể tái lập, ghi lại mọi toán tử và coi Elicit, Undermind hoặc Jenova là công cụ bổ trợ để khám phá trích dẫn và sàng lọc. OpenAlex còn cung cấp API, ngôn ngữ truy vấn hướng tới tổng quan hệ thống và ảnh chụp toàn bộ dữ liệu theo giấy phép CC0, một thiết kế trái ngược với việc sắp xếp mức độ liên quan trong hệ thống đóng. Giới hạn 1.000 kết quả và việc thiếu truy cập hàng loạt của Google Scholar khiến nó không đủ điều kiện cho tìm kiếm chính được ghi chép, dù nó vẫn hữu ích để kiểm tra xem một mục đã biết có được lập chỉ mục hay không.
Đối với câu hỏi tồn tại hẹp — "có bài báo nào như thế này không?" — Undermind là công cụ chuyên biệt, miễn là bạn có thể chờ và bằng chứng tiêu đề-tóm tắt là đủ. Đối với soạn thảo bản thảo sau khi tập kết quả đã có, sự kết hợp giữa khám phá tài liệu và quản lý trích dẫn của Jenova phù hợp hơn một giao diện chỉ khám phá khác, với lưu ý rằng phân tích gộp nặng về trích xuất vẫn nên thực hiện trong công cụ trích xuất chuyên dụng như Elicit.
Quy tắc quyết định đủ đơn giản để tái sử dụng. Nếu cách diễn đạt thay đổi và bạn chưa biết thuật ngữ chuyên ngành của lĩnh vực, hãy dùng trợ lý nghiên cứu AI ngữ nghĩa trước. Nếu phải bảo vệ chuỗi tìm kiếm, hãy dùng hạ tầng từ khóa có toán tử nâng cao. Nếu phải làm cả hai — vốn là điều kiện bình thường khi tìm bài báo liên quan về mặt khái niệm nhưng dùng cách diễn đạt khác — hãy chạy truy hồi ngữ nghĩa để khám phá ngôn ngữ, sau đó dùng kiểm soát từ vựng để thu thập và ghi chép ngôn ngữ đó.
Tài liệu tham khảo
- Aaron Tay — Google Scholar so với các công cụ tìm kiếm AI khác (Undermind, Elicit, SciSpace)
- Google Scholar — Trợ giúp Tìm kiếm Chính thức
- Elicit — AI cho nghiên cứu khoa học
- OpenAlex — Danh mục mở của hệ thống nghiên cứu toàn cầu
- Paperguide — So sánh giá và tính năng Elicit với SciSpace (2026)
- Undermind — Đồng nghiên cứu viên AI cho tài liệu
- University of Alberta / JCHLA — Đánh giá sản phẩm Undermind.ai
- Paperpile — Cách sử dụng Google Scholar
- TUHH — OpenAlex như một lựa chọn mở cho nghiên cứu học thuật
- Semantic Scholar — Công cụ nghiên cứu được AI hỗ trợ
- UBC Wiki — Các công cụ tìm kiếm AI được dùng trong tổng quan tài liệu và tìm kiếm toàn diện
- SciSpace — So sánh Elicit với SciSpace
- The Lens — Bản phát hành 8.5 và tích hợp OpenAlex
- PMC / NIH — Tính năng OpenAlex và tiềm năng tổng hợp bằng chứng