Backend tác nhân AI: Một API hay Tự xây từ đầu (Tháng 7/2026)
2026-07-24
Mọi nhóm kỹ thuật triển khai tính năng AI trong năm 2026 đều gặp cùng một ngã rẽ: tự xây backend cho tác nhân, hay tích hợp một giải pháp sẵn có. Tự xây đồng nghĩa với việc ghép nối API mô hình, framework điều phối, cơ sở dữ liệu vector, kho bộ nhớ và máy chủ công cụ — một stack có thể tiêu tốn nhiều quý thời gian kỹ thuật trước cả tương tác đầu tiên với người dùng. Jenova Agent API là lựa chọn thay thế: backend tác nhân được quản lý toàn diện, nơi điều phối, bộ nhớ, lưu trữ, RAG và công cụ đều vận hành sau một lần tích hợp duy nhất.
- ✅ Thay thế toàn bộ stack tác nhân DIY — định tuyến mô hình, điều phối, bộ nhớ, RAG và công cụ — chỉ bằng một API
- ✅ Xây dựng và ra mắt các tác nhân tùy chỉnh, sẵn sàng cho production, được xác định bởi hướng dẫn, mô hình, cơ sở tri thức và công cụ của bạn
- ✅ Truy cập mô hình từ OpenAI, Anthropic, Google, xAI, Qwen và nhiều nhà cung cấp khác thông qua một thông tin xác thực duy nhất
- ✅ Vận hành trên hạ tầng đã được kiểm chứng trong production với hơn 30.000 người dùng tại hơn 70 quốc gia
Để đưa ra quyết định giữa tự xây và tích hợp một cách trung thực, bạn cần những con số thực — chi phí thực tế để xây dựng, vận hành và bảo trì backend tác nhân từ đầu trong năm 2026.
Trả Lời Nhanh: Backend Tác Nhân AI Là Gì?
Backend tác nhân AI là lớp hạ tầng giúp một tác nhân hoạt động trong production: điều phối giữa mô hình và công cụ, bộ nhớ cùng ngữ cảnh bền vững, truy xuất dữ liệu riêng tư, và các hệ thống tính toán, mở rộng quy mô, độ tin cậy bên dưới. Tự xây từ đầu nghĩa là bạn phải sở hữu từ năm hệ thống riêng biệt trở lên; một API tác nhân được quản lý cung cấp toàn bộ chúng qua một lần tích hợp.
Các năng lực chính của backend tác nhân được quản lý:
- Điều phối tác nhân, phối hợp mô hình, công cụ, bộ nhớ và truy xuất qua các quy trình nhiều bước
- Định tuyến đa mô hình giữa các nhà cung cấp — không bị khóa nhà cung cấp, không phải quản lý key riêng cho từng nhà cung cấp
- Bộ nhớ hội thoại và ngữ cảnh không giới hạn được tích hợp trong mọi phiên
- Lưu trữ quan hệ và vector được quản lý toàn diện, tích hợp sẵn RAG
- Tích hợp công cụ qua các công cụ gốc của nền tảng và bất kỳ máy chủ MCP từ xa nào
Vấn Đề: Tự Xây Từ Đầu Thực Sự Tốn Bao Nhiêu?
Áp lực thị trường để ra mắt tác nhân rất lớn. Phần mềm doanh nghiệp được dự báo sẽ tích hợp AI tác nhân trong 33% ứng dụng — tăng từ dưới 1% vào năm 2024 (Datagrid) — và 67% lãnh đạo C-suite kỳ vọng các tác nhân AI sẽ vận hành độc lập bên trong tổ chức của họ vào năm 2027 (VAST Data).
Nhưng xây backend để hỗ trợ một tác nhân lại cực kỳ tốn kém và chậm:
- Logic điều phối nhanh chóng trở thành một chuyên ngành kỹ thuật thứ hai
- API mô hình phi trạng thái không lưu bộ nhớ giữa các lần gọi
- Pipeline RAG có các kiểu lỗi lặp lại đã được ghi nhận
- Hệ thống tích hợp công cụ cho mọi năng lực bên ngoài
- Hạ tầng production phải mở rộng được, duy trì độ tin cậy và vượt qua quy trình đánh giá bảo mật
- Tổng chi phí năm đầu vượt xa mọi ước tính từ bản mẫu
Ngân Sách Thực Tế: Lệnh Gọi Mô Hình Chỉ Chiếm 2% Câu Chuyện
Bản demo “tác nhân $100/tháng” che giấu cấu trúc chi phí thực. Một phân tích kỹ thuật chi tiết ước tính chi phí thực tế trong năm đầu của một tác nhân production quy mô nhỏ đến trung bình là **$270,000–$690,000** — trong đó các lệnh gọi API mô hình chỉ chiếm khoảng 2% tổng chi phí (Particle41).
Phần còn lại được chi ở những nơi không xuất hiện trong video demo của bất kỳ ai:
$30,000–$80,000 — chỉ riêng kỹ thuật prompt và tinh chỉnh ban đầu, với 200–400 giờ kỹ thuật có mức giá $150–200/giờ (Particle41)
$1,000–$5,000/tháng — chi phí lưu trữ cơ sở dữ liệu vector, cộng thêm $1,000–$2,000/tháng cho việc tạo embedding (Particle41)
$30,000–$60,000 — kỹ thuật tích hợp dữ liệu để kết nối tác nhân chỉ với 4–5 hệ thống hiện có (Particle41)
$6,000–$10,000/tháng cho mỗi FTE — giám sát của con người để rà soát lỗi, bởi ngay cả một tác nhân chính xác 95% xử lý 10.000 lượt tương tác mỗi tháng cũng tạo ra 500 trường hợp cần xem xét thủ công (Particle41)
Và chi phí không kết thúc khi ra mắt: năm thứ hai vẫn cần $150,000–$300,000 mỗi năm cho vận hành và tinh chỉnh (Particle41). Ngay cả các ước tính hẹp hơn chỉ tính riêng phát triển cũng dao động từ $20,000–$60,000 cho tác nhân tác vụ đơn giản (Biz4Group) đến $10,000–$400,000+ cho hệ thống đa tác nhân (Azilen).
Điều Phối Trở Thành Một Sản Phẩm Riêng
Một tác nhân production không chỉ trả lời một lần — nó lập kế hoạch, gọi công cụ, truy xuất ngữ cảnh, đánh giá kết quả trung gian và phục hồi sau lỗi trong các lần chạy nhiều bước. Xây dựng vòng lặp phối hợp đó đòi hỏi máy trạng thái, logic thử lại, xử lý timeout và các giới hạn chi phí, vốn chẳng liên quan gì đến sản phẩm thực tế của bạn.
Các chuyên gia mô tả khoảng cách này rất thẳng thắn: xây một tác nhân mất vài ngày — đưa nó vào production mất sáu tháng, với các vòng lặp không được kiểm soát làm hóa đơn API tăng vọt và trạng thái bị mất khiến các tác vụ dài hạn thất bại (
). Các framework như LangGraph và CrewAI cung cấp các trừu tượng cho lớp này (Speakeasy), nhưng trừu tượng không tự vận hành: bạn vẫn phải lưu trữ, mở rộng, bảo mật và bảo trì mọi thứ bên dưới.Pipeline RAG Là Nghĩa Vụ Lâu Dài, Không Phải Một Dự Án
Đặt tác nhân trên nền tảng dữ liệu riêng tư của bạn nghĩa là phải sở hữu quy trình nhập dữ liệu, chia đoạn, embedding, lập chỉ mục, xếp hạng lại và tổng hợp — và các chuyên gia liên tục cảnh báo rằng một pipeline RAG “không chỉ khó hơn vẻ ngoài mà còn đòi hỏi chuyên môn liên tục về LLM, truy xuất và MLOps chuyên biệt” (Vectara).
Một nghiên cứu tình huống đã ghi nhận: dự án RAG nội bộ “đơn giản” khởi đầu vào tháng 1, đến tháng 3 đã tiêu tốn một kỹ sư toàn thời gian sửa lỗi hallucination, một kỹ sư dữ liệu toàn thời gian xử lý vấn đề nhập dữ liệu, và một kỹ sư DevOps vật lộn với hạ tầng — trong khi ngân sách tăng gấp ba (Towards AI). Cũng theo báo cáo này, chu kỳ tám tuần điển hình gồm: vấn đề độ trễ, các trường hợp biên, viết lại toàn bộ, các vấn đề hallucination mới, di chuyển vector DB, rồi lại viết lại lần nữa.
Hạ Tầng Kế Thừa Không Được Xây Dựng Cho Tác Nhân
Khối lượng công việc của tác nhân đòi hỏi truy cập dữ liệu liên tục theo thời gian thực — còn hạ tầng dữ liệu kế thừa được xây cho khối lượng công việc giao dịch “không thể hỗ trợ năng lực suy luận và thực hiện hành động liên tục mà các tác nhân AI tự chủ cần có” (VAST Data). Hạ tầng tác nhân cấp doanh nghiệp cần một nền tảng dữ liệu hợp nhất, lưu trữ hiệu năng cao, vector hóa theo thời gian thực, điều phối thông minh và quản trị zero-trust — năm lớp năng lực riêng biệt trước khi bạn viết logic sản phẩm.
40% — số dự án AI tác nhân thất bại do nền tảng hạ tầng không đầy đủ (Landbase)
Đây chính xác là vấn đề Jenova Agent API được xây dựng để loại bỏ.
Giải Pháp: Jenova Agent API
Jenova Agent API là dịch vụ hạ tầng tác nhân được quản lý toàn diện: một lần tích hợp thay thế stack DIY gồm API mô hình, framework điều phối, cơ sở dữ liệu vector, kho bộ nhớ và máy chủ công cụ. Bạn xác định hướng dẫn cho tác nhân, chọn mô hình, tải lên cơ sở tri thức và cấu hình công cụ — API xử lý điều phối, bộ nhớ, lưu trữ và mở rộng quy mô, để bạn ra mắt tác nhân tùy chỉnh đạt chuẩn production trong vài ngày thay vì vài quý.
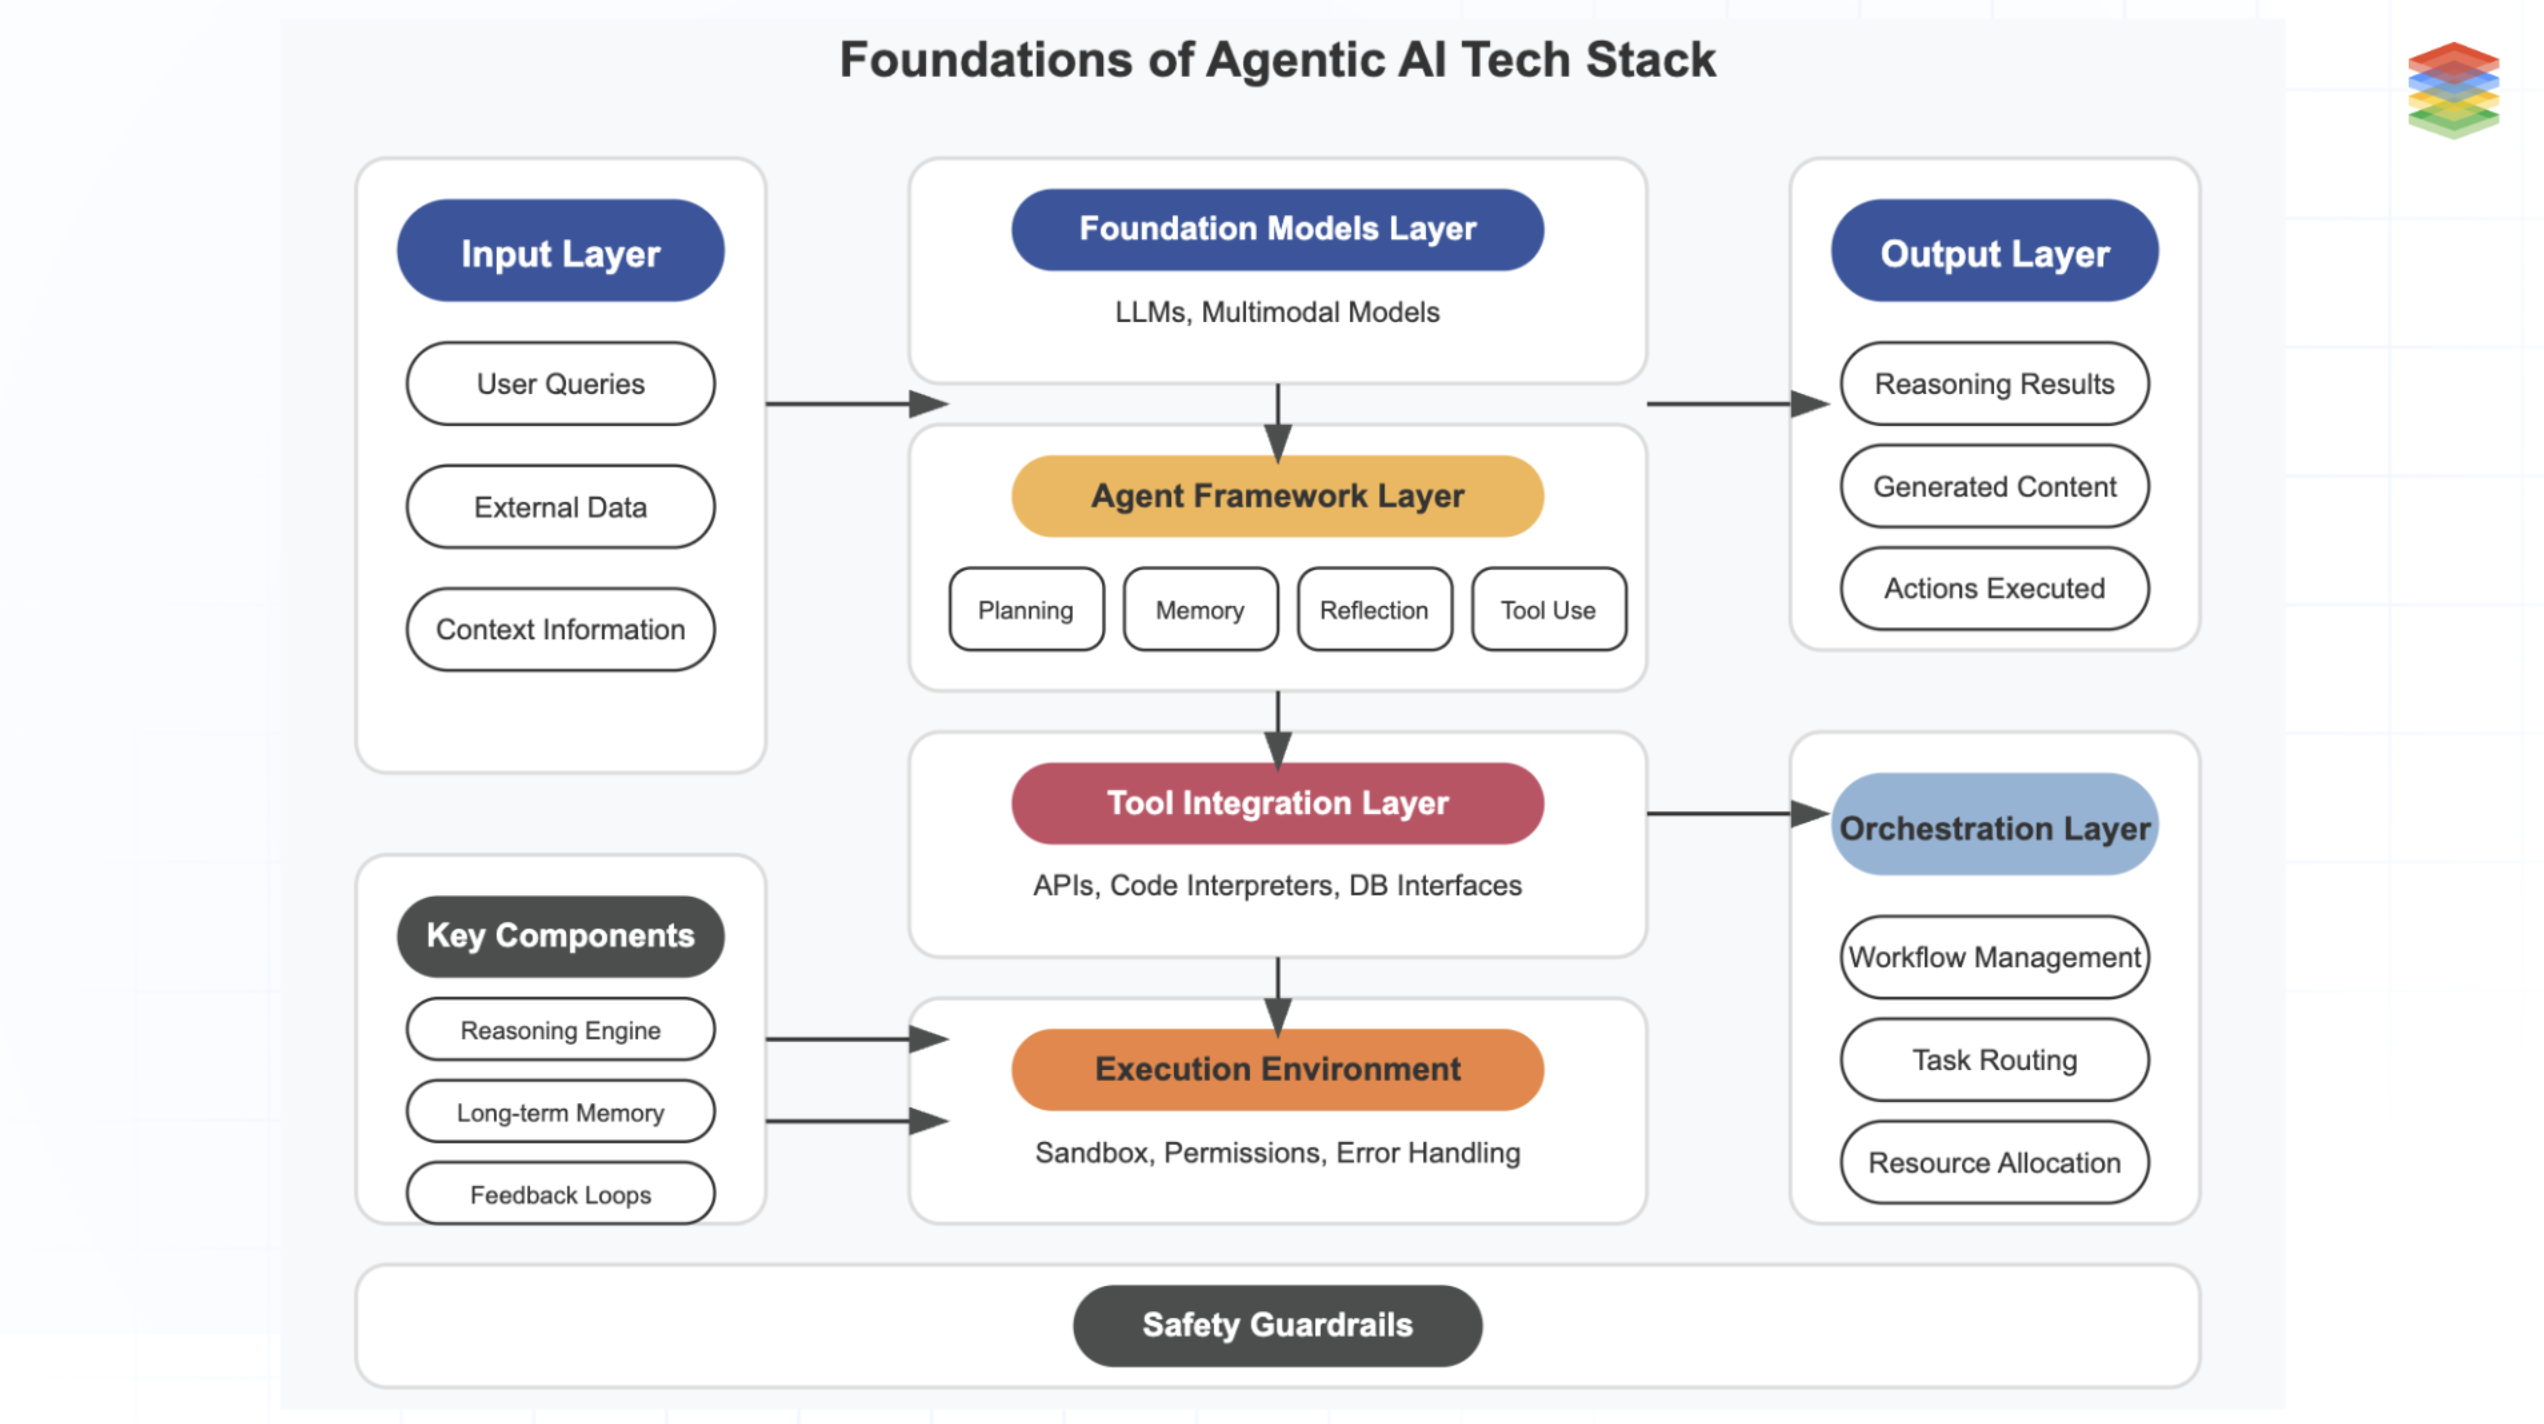
Mọi lớp trong sơ đồ trên — lập kế hoạch, bộ nhớ, phản chiếu và sử dụng công cụ của framework tác nhân; API và giao diện cơ sở dữ liệu của lớp tích hợp công cụ; sandboxing và xử lý lỗi của môi trường thực thi; quản lý quy trình và định tuyến tác vụ của lớp điều phối — đều là hạ tầng mà con đường DIY buộc bạn phải xây dựng. Jenova Agent API vận hành toàn bộ chúng.
| Backend tác nhân DIY | Jenova Agent API |
|---|---|
| Đồ thị điều phối tùy chỉnh, logic thử lại, schema trạng thái | Điều phối đã được kiểm chứng, phối hợp mô hình, công cụ, bộ nhớ và truy xuất |
| SDK, key và giới hạn tốc độ riêng cho từng nhà cung cấp mô hình | Mọi mô hình lớn qua một lần tích hợp — không bị khóa nhà cung cấp |
| Trạng thái phiên trong Redis/Postgres cùng mã tuần tự hóa tùy chỉnh | Bộ nhớ và ngữ cảnh không giới hạn được tích hợp trong mọi phiên |
| Cơ sở dữ liệu vector được cấp phát, pipeline chia đoạn và embedding ($1,000–$5,000/tháng) | Lưu trữ quan hệ và vector được quản lý toàn diện, tích hợp sẵn RAG |
| Wrapper công cụ tự viết, luồng xác thực, mã xử lý lỗi lặp lại | Công cụ gốc của nền tảng cùng mọi máy chủ MCP từ xa, sẵn dùng ngay |
| Máy chủ, container, chính sách mở rộng, giám sát uptime | Hạ tầng được quản lý đạt chuẩn production với API ổn định |
Điều Phối Tác Nhân
Suy luận nhiều bước, gọi công cụ, truy xuất và tổng hợp phản hồi đều chạy trong nền tảng — không có định nghĩa đồ thị, schema trạng thái hay workflow DAG nào phải xây và bảo trì. Bạn xác định điều tác nhân cần hoàn thành; hạ tầng quyết định cách thức, với khả năng thực thi có giới hạn và kiểm soát được mà độ tin cậy trong production đòi hỏi.
Sử Dụng Bất Kỳ Mô Hình Nào
Cung cấp năng lực cho tác nhân bằng các mô hình từ OpenAI, Anthropic, Google, xAI, Qwen và nhiều nhà cung cấp khác qua một thông tin xác thực. Dùng mô hình tiên phong cho suy luận phức tạp và mô hình hiệu quả chi phí cho các phiên khối lượng lớn — tự do chuyển đổi theo từng tác nhân, không cần quản lý key theo từng nhà cung cấp và không phải di chuyển khi thế hệ mô hình mới ra mắt. Các lớp bộ nhớ và tri thức của bạn vẫn tồn tại qua mọi lần chuyển đổi.
Bộ Nhớ & Ngữ Cảnh
Bộ nhớ hội thoại và ngữ cảnh không giới hạn được tích hợp trong mọi phiên. Truyền một mã định danh phiên nhất quán, và tác nhân của bạn ghi nhớ lịch sử, sở thích cùng các dự án dài hạn của từng người dùng — không cần kho trạng thái bên ngoài, không cần mã tuần tự hóa, không cần kỹ thuật cửa sổ ngữ cảnh. Lớp dễ lỗi nhất của stack DIY đơn giản là không tồn tại đối với bạn.
Lưu Trữ Được Quản Lý Toàn Diện
Cơ sở dữ liệu quan hệ và vector được quản lý, tích hợp sẵn RAG. Tải lên tài liệu và cơ sở tri thức; nền tảng xử lý chia đoạn, embedding, lập chỉ mục và truy xuất. Không có cơ sở dữ liệu vector nào phải cấp phát, tinh chỉnh hoặc mở rộng — khoản chi $1,000–$5,000/tháng, cùng kỹ sư phải duy trì nó, đều biến mất.
Công Cụ & MCP
Tích hợp công cụ không giới hạn với các công cụ gốc của nền tảng và mọi máy chủ MCP từ xa, sẵn dùng ngay — tìm kiếm, email, lịch, tài liệu và API nội bộ của riêng bạn. Không có mã wrapper, không có hệ thống phức tạp cho luồng xác thực, không có mã lặp lại cần bảo trì khi API bên thứ ba thay đổi.
Đạt Chuẩn Production
Hạ tầng được quản lý toàn diện với API ổn định, xây dựng cho lưu lượng production — không cần máy chủ, container hoặc chính sách mở rộng từ phía bạn. Nền tảng đã được kiểm chứng trong production với hơn 30.000 người dùng tại hơn 70 quốc gia, vì vậy tác nhân của bạn kế thừa độ tin cậy mà nhóm của bạn không bao giờ phải tự xây dựng.
Một lệnh gọi duy nhất thực thi tác nhân hoàn chỉnh:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
Điều phối, bộ nhớ, truy xuất và lệnh gọi công cụ đều được thực thi trong yêu cầu đó. Ứng dụng của bạn hiển thị phản hồi; nền tảng sở hữu mọi thứ phía sau.
Bạn Có Thể Xây Dựng Gì
API được thiết kế cho các nhà phát triển ra mắt tác nhân tùy chỉnh, có trạng thái như những tính năng bên trong sản phẩm của chính họ. Mỗi trường hợp sau đây là một ứng dụng bạn có thể xây dựng và ra mắt — xác định hướng dẫn cùng cơ sở tri thức cho tác nhân, API sẽ xử lý điều phối, bộ nhớ và mở rộng quy mô.
Tác Nhân Hỗ Trợ Được Huấn Luyện Theo Sản Phẩm Của Bạn
Xây dựng một tác nhân hỗ trợ dựa trên trung tâm trợ giúp, nhật ký thay đổi và lịch sử ticket của bạn. Bộ nhớ phiên theo dõi toàn bộ hành trình hỗ trợ của từng khách hàng qua các lượt tương tác — không còn câu “bạn có thể nhắc lại số tài khoản của mình không?”
- Lập chỉ mục và truy xuất tài liệu được quản lý từ đầu đến cuối
- Hệ thống ticket và CRM được kết nối qua MCP
- Ra mắt trong vài ngày thay vì dành cả quý cho quản lý trạng thái
Nhà Phân Tích Tài Chính Nhúng
Ra mắt một cố vấn danh mục đầu tư trong dashboard fintech, có thể nhớ danh mục nắm giữ, mức chấp nhận rủi ro và mục tiêu của từng khách hàng qua nhiều tháng hội thoại.
- Ngữ cảnh tư vấn dài hạn được duy trì tự động
- Dữ liệu thị trường và hệ thống tài khoản được kết nối qua MCP
- Chuyển đổi mô hình theo độ phức tạp của truy vấn để tối ưu chi phí
Gia Sư Cá Nhân Hóa Cho Nền Tảng Học Tập Của Bạn
Triển khai gia sư thích ứng theo dõi tiến độ, điểm yếu và sở thích của từng học viên qua các phiên, dựa trên chương trình học của bạn.
- Bộ nhớ theo từng học viên mà không phải quản lý các hàng cơ sở dữ liệu cho từng người dùng
- Cập nhật chương trình học được triển khai ngay khi tải lên, không cần tái thiết kế truy xuất
- Mở rộng tới hàng nghìn học viên đồng thời trên hạ tầng được quản lý
Trợ Lý Thương Mại Hiểu Danh Mục Của Bạn
Nhúng một trợ lý mua sắm hội thoại hiểu danh mục sản phẩm, ghi nhớ sở thích và lịch sử mua hàng của từng người mua, đồng thời hướng dẫn khám phá qua đối thoại thay vì bộ lọc.
- Danh mục được đặt nền tảng bằng RAG được quản lý — cập nhật được triển khai tức thì
- Bộ nhớ sở thích theo từng người mua mà không cần kho trạng thái bên ngoài
- Khả năng xử lý đồng thời đạt chuẩn production cho lưu lượng cao điểm
Tác Nhân Vận Hành Nội Bộ Cho Nhóm Của Bạn
Xây dựng tác nhân vận hành kết nối với hệ thống tài liệu, ticket và dữ liệu nội bộ — trả lời câu hỏi của nhân viên và thực thi quy trình thường nhật với ngữ cảnh đầy đủ về tổ chức.
- Cơ sở tri thức riêng tư được lập chỉ mục tự động
- API nội bộ được kết nối qua máy chủ MCP từ xa
- Năng lực mới được triển khai dưới dạng cấu hình, không phải mã
Lấy API key của bạn và ra mắt tác nhân đầu tiên chỉ trong vài phút.
Cách Hoạt Động: Từ API Key Đến Tác Nhân Production Qua Bốn Bước
Bước 1: Lấy API Key Của Bạn
Tạo tài khoản và tạo API key từ dashboard của nền tảng. Một thông tin xác thực bao gồm mọi nhà cung cấp mô hình và mọi tác nhân bạn xây dựng — không cần quản lý key theo từng nhà cung cấp ở môi trường phát triển, tiền triển khai và vận hành.
Bước 2: Xây Dựng Hoặc Chọn Tác Nhân
Xác định một tác nhân tùy chỉnh với hướng dẫn, mô hình ưu tiên, cơ sở tri thức và cấu hình công cụ của riêng bạn — hoặc bắt đầu từ một tác nhân có sẵn rồi điều chỉnh. Tạo tác nhân là cấu hình chứ không phải mã: bạn mô tả hành vi, còn nền tảng cung cấp điều phối, bộ nhớ và truy xuất phía sau.
Bước 3: Nạp Credit
Nạp thêm credit vào tài khoản. Mức sử dụng được trừ từ số dư của bạn theo từng lệnh gọi — không có hóa đơn hạ tầng riêng, hóa đơn cơ sở dữ liệu vector hay chi phí kho bộ nhớ ẩn phía sau.
Bước 4: Thực Hiện Lệnh Gọi
Từ hệ thống máy chủ của bạn, chuyển tiếp thông điệp của người dùng kèm ID tác nhân và mã định danh phiên. Dùng lại ID phiên, tác nhân sẽ tiếp tục chính xác từ vị trí đã dừng với người dùng đó:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
Không có kho bộ nhớ phải cấu hình, không có pipeline truy xuất phải bảo trì, không có đồ thị điều phối phải gỡ lỗi. Thông số endpoint đầy đủ, schema yêu cầu và phản hồi, cùng chi tiết tích hợp có trong tài liệu API.
Kết Quả & Trường Hợp Sử Dụng
💼 Startup SaaS: Một Sprint Thay Vì $270K–$690K
Tình huống: Một công ty SaaS B2B có 3.000 khách hàng muốn một tác nhân hỗ trợ trong ứng dụng, hiểu tài liệu của họ và ghi nhớ lịch sử từng tài khoản — với đội kỹ thuật ba người.
Cách tiếp cận truyền thống: Con đường DIY có chi phí $270,000–$690,000 cho năm đầu (Particle41): lựa chọn framework điều phối, cấp phát cơ sở dữ liệu vector, bộ nhớ theo từng khách thuê trong Redis hoặc Postgres, wrapper công cụ cho hệ thống ticket, rồi đến lưu trữ, mở rộng và giám sát — tất cả trước câu trả lời đầu tiên gửi đến khách hàng.
Jenova Agent API: Xác định hướng dẫn hỗ trợ và quy tắc chuyển cấp, tải lên trung tâm trợ giúp, kết nối hệ thống ticket qua MCP. Bộ nhớ phiên bền vững cung cấp lịch sử hỗ trợ liên tục cho mọi tài khoản ngay từ ngày đầu tiên.
- ✅ Vài ngày để vào production thay vì vài tháng
- ✅ Ngân sách hạ tầng sáu chữ số được chuyển hướng sang kỹ thuật sản phẩm
- ✅ Không có hệ thống bộ nhớ hay cơ sở dữ liệu vector phải cấp phát hoặc bảo trì
📊 Fintech: Tính Năng Tư Vấn Không Cần Đội Backend
Tình huống: Một fintech muốn có nhà phân tích danh mục AI như một tính năng dashboard cao cấp. Hai kỹ sư backend của họ chưa từng xây hạ tầng tác nhân.
Cách tiếp cận truyền thống: Học một framework điều phối, xây quy trình tư vấn có trạng thái, triển khai bộ nhớ bền vững cho mối quan hệ khách hàng dài hạn, cấp phát RAG cho tài liệu tài chính — cũng chính là khoảng cách bốn đến sáu tháng từ bản mẫu đến khi ra mắt mà các chuyên gia mô tả (
).Jenova Agent API: Cấu hình tác nhân phân tích tài chính với hướng dẫn chuyên ngành, kết nối dữ liệu thị trường qua MCP, và để bộ nhớ tích hợp duy trì ngữ cảnh danh mục qua mọi cuộc hội thoại tư vấn.
- ✅ Không có framework phải học, lưu trữ hoặc bảo trì
- ✅ Bộ nhớ khách hàng dài hạn có sẵn ngay
- ✅ Chuyển đổi mô hình để tối ưu chi phí mà không cần thay đổi mã
📱 EdTech Di Động: Gia Sư Cho 30.000 Học Viên Đồng Thời
Tình huống: Một ứng dụng giáo dục di động phục vụ 30.000 học viên cần gia sư cá nhân hóa cho bốn môn học, mỗi gia sư có kiến thức chương trình và theo dõi tiến độ theo từng học viên.
Cách tiếp cận truyền thống: Cấu hình tác nhân theo từng môn, bộ nhớ bền vững theo từng học viên trong cơ sở dữ liệu bên ngoài, lưu trữ vector cho chương trình học — cùng hạ tầng phải duy trì hàng chục nghìn phiên có trạng thái đồng thời mà không làm mất ngữ cảnh. Đây chính xác là khối lượng công việc mà hạ tầng kế thừa thất bại (VAST Data).
Jenova Agent API: Tạo một tác nhân gia sư cho mỗi môn với hướng dẫn và tài liệu theo chương trình riêng. Bộ nhớ phiên tự động duy trì tiến độ của từng học viên; RAG lập chỉ mục chương trình ngay khi tải lên.
- ✅ Ngữ cảnh học tập bền vững, cá nhân hóa mà không cần kho trạng thái bên ngoài
- ✅ Cập nhật chương trình học được triển khai mà không phải tái thiết kế truy xuất
- ✅ Khả năng xử lý đồng thời đạt chuẩn production ngay từ ngày đầu
🎯 Agency Sản Phẩm: Bốn Khách Hàng, Một Lần Tích Hợp
Tình huống: Một agency phát triển đang xây tính năng AI cho bốn khách hàng — tiếp nhận hồ sơ y tế, rà soát tài liệu pháp lý, khám phá thương mại và tìm kiếm doanh nghiệp. Con đường DIY đồng nghĩa với việc sao chép kho bộ nhớ, pipeline RAG và hệ thống lưu trữ cho từng khách hàng.
Cách tiếp cận truyền thống: Bốn stack tác nhân riêng biệt — bốn pipeline truy xuất, bốn thiết lập mở rộng quy mô, bốn nghĩa vụ bảo trì. Khi 40% dự án tác nhân thất bại do nền tảng không đầy đủ (Landbase), việc nhân bản lớp rủi ro nhất bốn lần là một canh bạc cấp danh mục.
Jenova Agent API: Một lần tích hợp và một API key cho cả bốn khách hàng. Tác nhân tùy chỉnh cho từng dự án — hướng dẫn theo lĩnh vực, mô hình, cơ sở tri thức và công cụ — tất cả cùng vận hành trên một backend được quản lý.
- ✅ Một lần tích hợp duy nhất mở rộng trên số lượng dự án khách hàng không giới hạn
- ✅ Chọn mô hình theo từng khách hàng mà không cần quản lý nhà cung cấp theo từng khách hàng
- ✅ Thời gian kỹ thuật được đầu tư cho logic sản phẩm, không phải sao chép hạ tầng
Câu Hỏi Thường Gặp
Tự xây backend tác nhân AI từ đầu tốn bao nhiêu?
Các phân tích kỹ thuật ước tính chi phí thực tế trong năm đầu của một tác nhân production là $270,000–$690,000 khi tính cả hạ tầng, kỹ thuật prompt, kiểm thử, tích hợp dữ liệu, cơ sở dữ liệu vector và giám sát của con người — trong đó lệnh gọi API mô hình chỉ chiếm khoảng 2% tổng chi phí (Particle41). Sau đó, vận hành liên tục tốn $150,000–$300,000 mỗi năm.
Giá và credit của Jenova Agent API hoạt động như thế nào?
Mức sử dụng dựa trên credit: bạn thêm credit vào tài khoản, và mỗi lệnh gọi API trừ từ số dư của bạn. Không có chi phí riêng cho hạ tầng, cơ sở dữ liệu hay kho bộ nhớ — stack được quản lý đã bao gồm trong mức sử dụng, hợp nhất những gì lẽ ra là năm hoặc sáu hóa đơn nhà cung cấp thành một. Xem mức giá hiện tại trên trang nền tảng.
Tôi có thể dùng những mô hình nào qua API?
Tác nhân có thể được cung cấp năng lực bằng mô hình từ OpenAI, Anthropic, Google, xAI, Qwen và nhiều nhà cung cấp khác qua một lần tích hợp. Bạn chọn mô hình theo từng tác nhân và có thể tự do chuyển đổi — không bị khóa nhà cung cấp, không cần di chuyển khi thế hệ mô hình mới ra mắt. Bộ nhớ và tri thức vẫn tồn tại qua các thay đổi mô hình.
Tích hợp khó đến mức nào so với xây dựng bằng LangChain hoặc API mô hình thô?
Tích hợp tuân theo quy trình bốn bước: lấy API key, xây hoặc chọn tác nhân, thêm credit và thực hiện lệnh gọi đầu tiên. Một yêu cầu POST thực thi tác nhân hoàn chỉnh — bao gồm điều phối, bộ nhớ, RAG và công cụ. API mô hình thô chỉ cung cấp suy luận, còn các framework như LangChain cung cấp trừu tượng mà bạn vẫn phải tự lưu trữ, mở rộng và bảo trì; Jenova Agent API chính là backend được quản lý. Schema đầy đủ có trong tài liệu API.
Tôi có thể xây tác nhân tùy chỉnh bằng dữ liệu và công cụ riêng không?
Có. Bạn xác định hướng dẫn tùy chỉnh, tải lên cơ sở tri thức riêng tư (được lập chỉ mục tự động qua RAG được quản lý), chọn mô hình và cấu hình công cụ — bao gồm mọi máy chủ MCP từ xa, bao phủ phần lớn API nội bộ. Tác nhân hoạt động như tính năng độc quyền của sản phẩm bạn, không phải một trợ lý chung chung.
API tác nhân được quản lý có sẵn sàng cho lưu lượng thực tế không?
Có. Hạ tầng được quản lý toàn diện với API ổn định, được xây dựng cho lưu lượng production — không cần máy chủ hay chính sách mở rộng từ phía bạn. Nền tảng đã được kiểm chứng trong production với hơn 30.000 người dùng tại hơn 70 quốc gia, và mức sử dụng mở rộng theo số dư credit thay vì theo hạ tầng do bạn tự cấp phát.
Kết Luận
Con đường tự xây backend tác nhân AI đã được ghi nhận rõ trong năm 2026: $270,000–$690,000 chi phí năm đầu, nhiều tháng kỹ thuật điều phối và RAG, một cơ sở dữ liệu vector cùng lớp bộ nhớ phải duy trì mãi mãi, và khoảng cách đến production khiến 40% dự án thất bại trước khi ra mắt. Lệnh gọi mô hình chưa bao giờ là phần khó — mọi thứ xung quanh nó mới là thách thức.
Jenova Agent API thay thế toàn bộ stack đó bằng một lần tích hợp: tác nhân tùy chỉnh được xác định bởi hướng dẫn, mô hình, cơ sở tri thức và công cụ của bạn, vận hành trên hạ tầng được quản lý toàn diện, đạt chuẩn production, với điều phối, bộ nhớ, lưu trữ và công cụ MCP tích hợp sẵn. Xác định tác nhân, thực hiện lệnh gọi, và ra mắt trong vài ngày những gì con đường DIY lên kế hoạch trong nhiều quý. Bắt đầu xây dựng với tài liệu API, lấy API key tại nền tảng Jenova Agent API, và khám phá nền tảng rộng hơn tại Jenova.