วิธีใดรักษาความสม่ำเสมอของตัวละคร AI ได้ดีกว่า: สร้างพาเนลใหม่หรือใช้ชีตอ้างอิง?
2026-08-14
เวิร์กโฟลว์ที่ยึดโยงด้วยภาพอ้างอิงและเวิร์กโฟลว์สร้างใหม่ทั้งหมด ต่างกันอย่างไรในด้านการสะสมของความคลาดเคลื่อน?
ชีตอ้างอิงตัวละครแบบถาวรช่วยรักษาความสม่ำเสมอได้ดีกว่าการสร้างแต่ละพาเนลใหม่จากข้อความพรอมป์ต์อย่างมาก เพราะการสร้างที่มีภาพอ้างอิงเป็นเงื่อนไขจะยึดอัตลักษณ์ไว้กับเวกเตอร์เชิงภาพที่คงที่ แทนที่จะสุ่มใหม่จากภาษาในทุกครั้ง การสร้างใหม่ทำให้ความคลาดเคลื่อนสะสมจากพาเนลหนึ่งสู่อีกพาเนลหนึ่ง — การสร้างแต่ละครั้งคือการสุ่มอย่างอิสระจากการแจกแจงของโมเดล ดังนั้นโครงหน้า รายละเอียดเครื่องแต่งกาย และสัดส่วนจึงเปลี่ยนไปโดยไม่มีกลไกแก้ไข ขณะที่เวิร์กโฟลว์แบบอ้างอิงช่วยลดความแปรปรวนนี้ด้วยการป้อนภาพต้นทางเดิมกลับเข้าไปในทุกการสร้าง
ช่องว่างที่วัดผลได้นี้ได้รับการบันทึกไว้ในการทดสอบเชิงวิชาการ ในงานวิจัย Character-Adapter บน arXiv วิธีที่ใช้ภาพอ้างอิงเป็นเงื่อนไขได้คะแนน 84.8% CLIP-I และ 68.1% DINO-I สำหรับความสม่ำเสมอของตัวละครเดี่ยว ขณะที่แนวทางที่ไม่ต้องฝึกเพิ่มและไม่มีการดึงคุณลักษณะตามภูมิภาคอย่างเหมาะสมได้ต่ำสุดเพียง 63.8% CLIP-I ส่วนพรอมป์ต์ข้อความเพียงอย่างเดียวไม่มีคะแนนความสม่ำเสมอให้รายงาน เพราะไม่มีจุดยึดอัตลักษณ์ให้นำมาเทียบวัด
ปัจจัยสำคัญที่แยกความต่อเนื่องของตัวละครที่เชื่อถือได้ออกจากความคลาดเคลื่อนระหว่างพาเนล:
✅ การยึดอัตลักษณ์ — ภาพอ้างอิงมอบเวกเตอร์เชิงภาพที่คงอยู่ ส่วนพรอมป์ต์ข้อความไม่สามารถทำได้ ✅ การสะสมของความคลาดเคลื่อน — ข้อผิดพลาดจากการสร้างใหม่เป็นอิสระต่อพาเนล ทำให้ความแปรปรวนเพิ่มขึ้นตลอดทั้งลำดับ ✅ ความละเอียดของรายละเอียด — เอกสารของ Midjourney เตือนอย่างชัดเจนว่ารายละเอียดซับซ้อน เช่น กระบนใบหน้าหรือโลโก้บนเสื้อผ้า “อาจออกมาไม่ตรงเป๊ะ” แม้จะมีภาพอ้างอิง ✅ ความไม่สมมาตรของต้นทุน — การใช้ภาพอ้างอิงเป็นเงื่อนไขมีต้นทุนการประมวลผลเพิ่มขึ้น โดย Midjourney ระบุว่า Omni Reference ใช้เวลา GPU 2× เมื่อเทียบกับภาพ V7 มาตรฐาน ✅ การพึ่งพาคุณภาพอินพุต — เวิร์กโฟลว์แบบอ้างอิงจะเสถียรได้เพียงเท่ากับชีตต้นทาง ซึ่งทำให้จุดเสี่ยงย้ายไปอยู่ในขั้นตอนต้นน้ำ
สิ่งที่ต้องแลกไม่ใช่ความสม่ำเสมอกับความไม่สม่ำเสมอ แต่เป็นการลงทุนล่วงหน้าและต้นทุนต่อภาพ เทียบกับงานแก้ไขสะสมภายหลัง — และคำตอบที่ถูกต้องขึ้นอยู่กับความยาวของลำดับภาพ สไตล์งานศิลป์ และระดับความแม่นยำด้านอัตลักษณ์ที่โปรเจกต์ต้องการจริง ๆ
ทำไมการสร้างใหม่จากพรอมป์ต์ข้อความจึงทำให้ตัวละครคลาดเคลื่อน?
พรอมป์ต์ข้อความระบุอัตลักษณ์ได้ไม่ละเอียดพอ พรอมป์ต์อย่าง “ผู้หญิงผมสั้นสีดำสวมแว่นตานักบินสตีมพังก์” บรรยายกลุ่มประเภทของใบหน้า ไม่ใช่ใบหน้าเฉพาะบุคคล — และการสร้างแต่ละครั้งจะสุ่มสมาชิกคนละคนจากกลุ่มนั้น แม้ใช้พรอมป์ต์และการตั้งค่าเหมือนเดิม การเปลี่ยน seed ก็ทำให้ได้คนละคนที่บังเอิญตรงตามคำบรรยายเดียวกัน
ปัญหานี้เป็นเรื่องของโครงสร้าง ไม่ใช่ปัญหาที่แก้ได้ด้วยการปรับจูน โมเดล diffusion สร้างภาพจากสัญญาณรบกวนโดยมีเวกเตอร์ข้อความเป็นเงื่อนไข และภาษาธรรมชาติไม่สามารถเข้ารหัสความสัมพันธ์เชิงเรขาคณิตอันละเอียดนับพันอย่างที่ทำให้ใบหน้าเป็นที่จดจำได้ เช่น ระยะห่างระหว่างดวงตา ความเรียวของกราม รูปทรงรูจมูก หรือเส้นโค้งที่แน่นอนของริมฝีปากบน
ความคลาดเคลื่อนสามรูปแบบที่พบในเวิร์กโฟลว์การสร้างคอมิกใหม่ทั้งหมด:
- ความคลาดเคลื่อนของอัตลักษณ์บนใบหน้า — เป็นความล้มเหลวที่เห็นชัดที่สุด ผู้อ่านสังเกตการเปลี่ยนแปลงของใบหน้าได้ทันที แม้จะบอกไม่ได้ว่ามีอะไรเปลี่ยนไป
- ความคลาดเคลื่อนของเครื่องแต่งกาย — จำนวนหัวเข็มขัด ความยาวเสื้อแจ็กเก็ต ตำแหน่งอาวุธ และรายละเอียดเครื่องประดับเปลี่ยนแปลง เพราะพรอมป์ต์แทบไม่เคยระบุทุกองค์ประกอบ
- ความคลาดเคลื่อนของสไตล์ — น้ำหนักเส้น ความหนาแน่นของการเรนเดอร์ และอุณหภูมิสีเปลี่ยนไปตามพาเนล ทำลายความเป็นเอกภาพทางภาพของหน้า
หลักฐานจากชุมชนสะท้อนเรื่องนี้อย่างชัดเจน มี
ขึ้นมาโดยเฉพาะ เพราะการสร้างจากพรอมป์ต์อย่างเดียวไม่เพียงพอสำหรับคอมิก สตอรีบอร์ด และหนังสือ — ทุกวิธีที่บันทึกไว้เพิ่มการกำหนดเงื่อนไขด้วยภาพบางรูปแบบไว้เหนือข้อความการทดสอบความคลาดเคลื่อนที่ใช้งานได้จริง: สร้างพรอมป์ต์ตัวละครเดียวกันแปดครั้งด้วย seed ที่ต่างกัน แล้ววางผลลัพธ์เป็นตาราง หากผู้อ่านไม่สามารถบอกได้ว่าเป็นคนเดียวกันโดยไม่มีใครบอก การสร้างใหม่จากพรอมป์ต์อย่างเดียวจะไม่รอดในลำดับหลายพาเนล
ชีตอ้างอิงตัวละครแบบถาวรคืออะไร และ AI ใช้มันอย่างไร?
ชีตอ้างอิงตัวละครแบบถาวรคือชิ้นงานภาพที่กำหนดคงที่ — โดยทั่วไปเป็นภาพหมุนตัวที่มีมุมมองด้านหน้า ด้านข้าง และด้านหลัง พร้อมการระบุรายละเอียด — ซึ่งจะถูกป้อนกลับเข้าสู่ทุกการสร้างในฐานะอินพุตเงื่อนไข แอนิเมชันดั้งเดิมใช้model sheet มาหลายทศวรรษเพื่อให้ตัวละครมีรูปแบบตรงกันตลอดภาพวาดหลายร้อยชิ้นจากศิลปินคนละคน เวิร์กโฟลว์ AI นำชิ้นงานเดียวกันนี้มาใช้ใหม่ในฐานะจุดยึดอัตลักษณ์ที่เครื่องอ่านได้
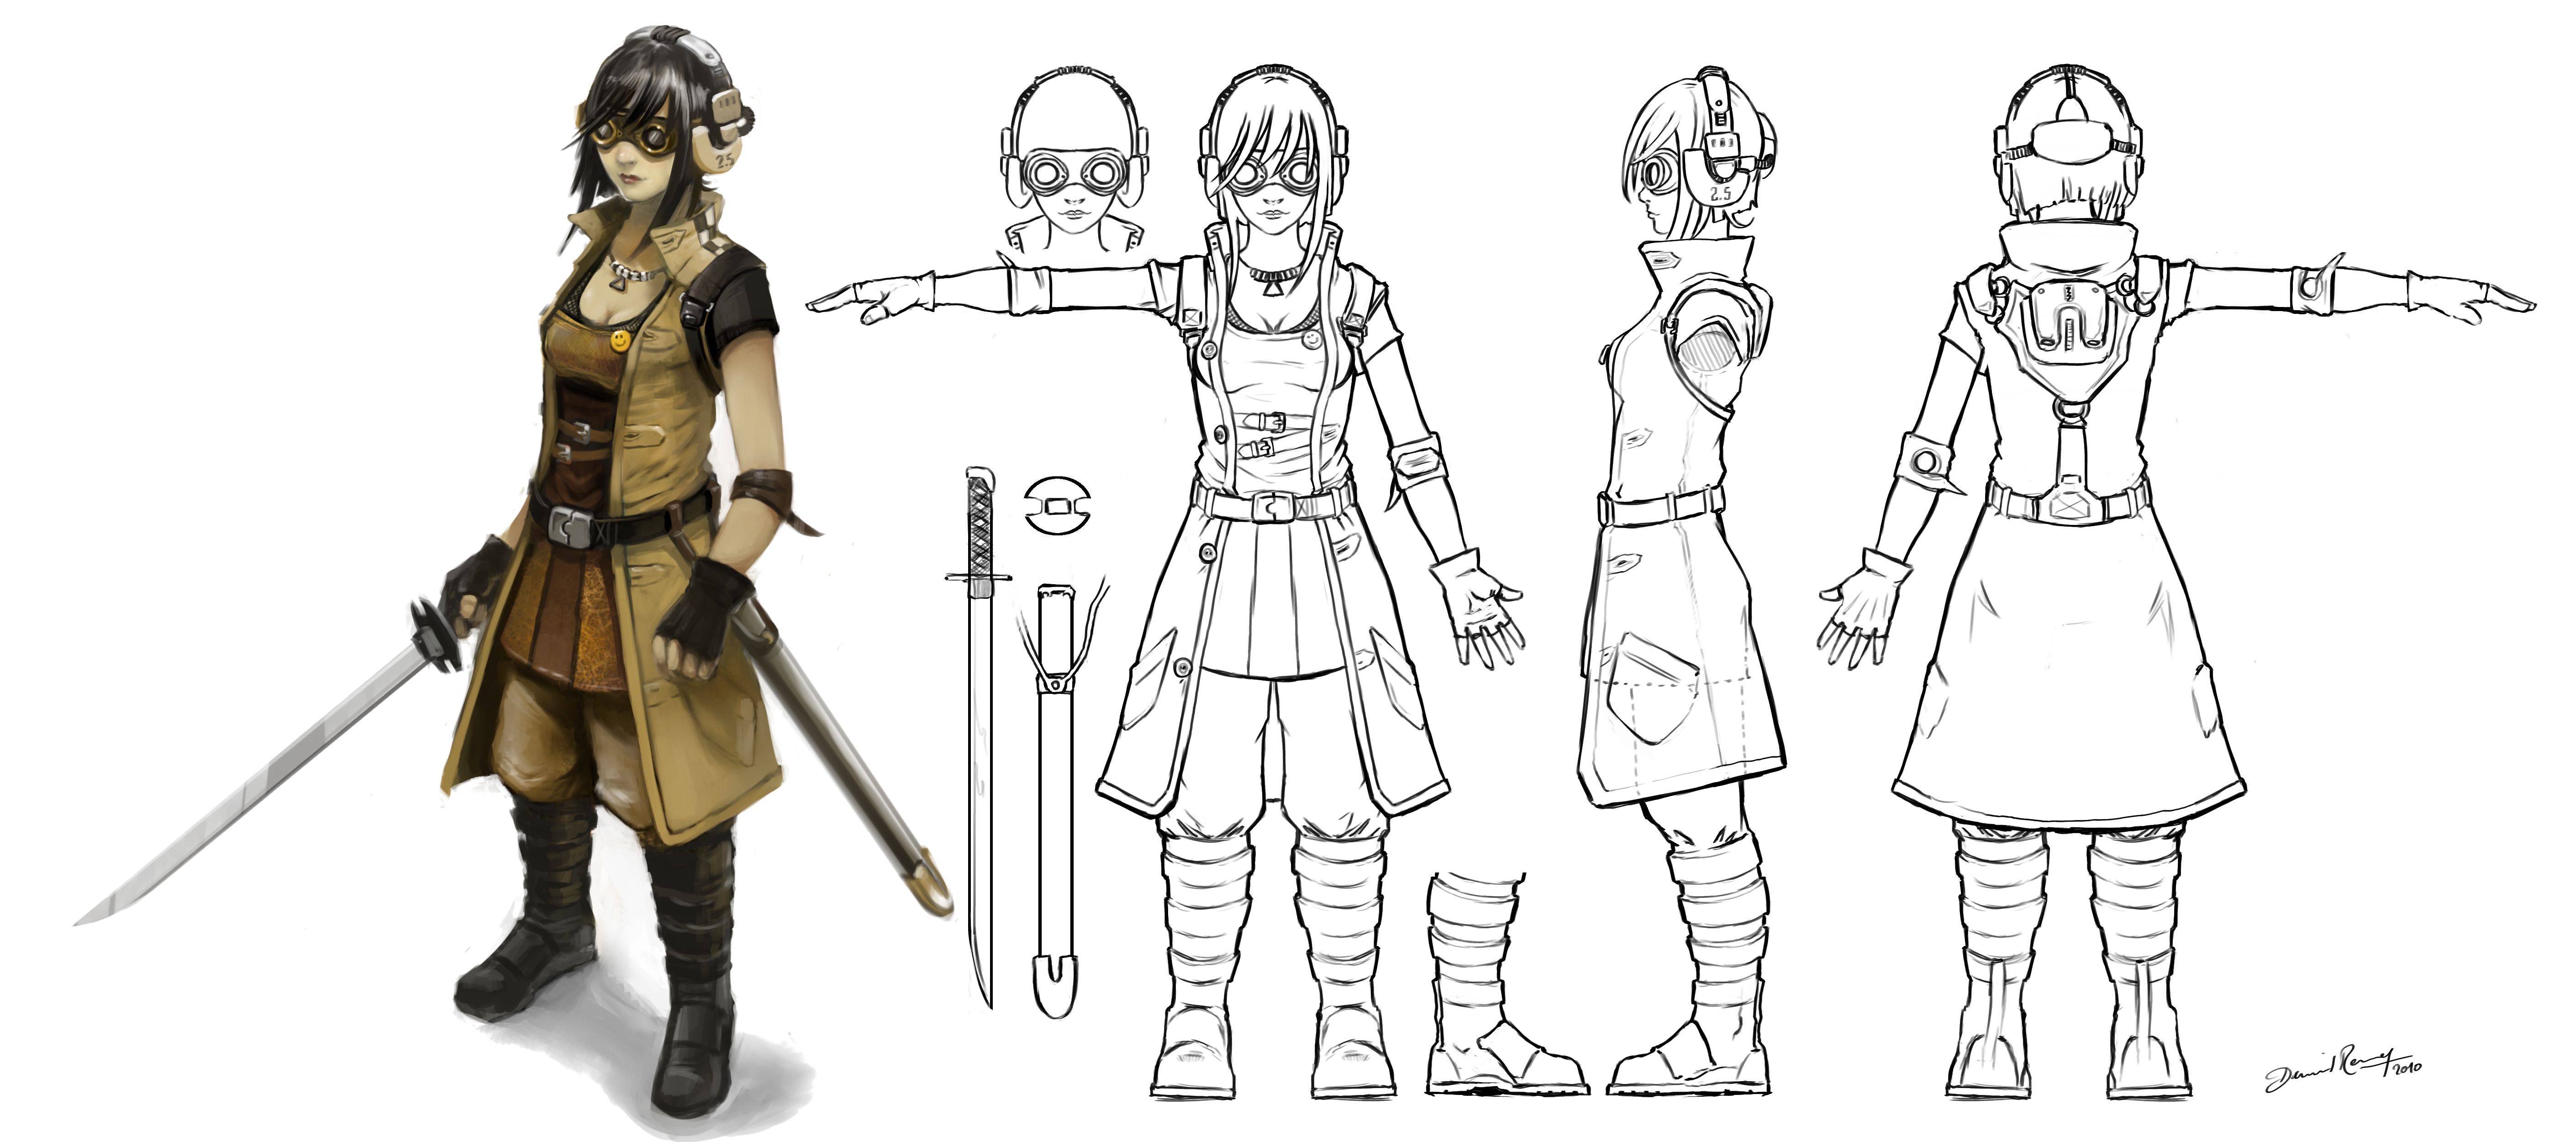
กลไกทางเทคนิคแตกต่างกันไปตามแพลตฟอร์ม แต่รูปแบบหลักเหมือนกัน:
- การฉีดเวกเตอร์ภาพ — ภาพอ้างอิงถูกเข้ารหัสและฉีดเข้าไปในกระบวนการ diffusion ควบคู่กับเวกเตอร์ข้อความ IP-Adapter ของ Tencent วางรากฐานวิธีนี้ไว้ในฐานะ “adapter ที่มีประสิทธิภาพและน้ำหนักเบา เพื่อเพิ่มความสามารถด้าน image prompt ให้แก่โมเดล diffusion แบบ text-to-image ที่ฝึกไว้ล่วงหน้า”
- การดึงคุณลักษณะตามภูมิภาค — แนวทางที่ก้าวหน้ากว่าจะแบ่งภาพอ้างอิงเป็นภูมิภาค เช่น ใบหน้า เครื่องแต่งกาย และเครื่องประดับ แล้วกำหนดเงื่อนไขแต่ละส่วนแยกกัน Character-Adapter ใช้การแบ่งส่วนที่นำทางด้วยพรอมป์ต์พร้อม adapter แบบไดนามิกระดับภูมิภาค เพื่อป้องกัน “ความสับสนของแนวคิด” โดยเฉพาะ ซึ่งเป็นกรณีที่โมเดลผสมคุณลักษณะข้ามตัวละครหรือวัตถุ
- การติดแท็กภาพอ้างอิงด้วยชื่อ — แพลตฟอร์มเชิงพาณิชย์ให้คุณบันทึกและเรียกคืนภาพอ้างอิงด้วยชื่อ Gen-4 References ของ Runway รองรับภาพอ้างอิงที่ใช้งานพร้อมกันได้สูงสุดสามรายการต่อการสร้างหนึ่งครั้ง และให้เรียกใช้ในพรอมป์ต์ด้วยสัญลักษณ์
@
📋 สิ่งที่ควรอยู่บนชีตอ้างอิงสำหรับการใช้งานกับ AI
ชีตอ้างอิงที่ออกแบบสำหรับ AI แตกต่างจาก model sheet สำหรับศิลปินมนุษย์ เอกสารของ Runway แนะนำให้ใช้ แสงธรรมชาติที่สม่ำเสมอ คุณภาพระดับปานกลาง และสีหน้ากลาง ๆ ของตัวแบบ เพื่อสร้าง “ผืนผ้าใบว่าง” ที่แปลงต่อได้ง่ายขึ้น แสงที่ดราม่าหรือสีหน้าที่สุดโต่งซึ่งฝังอยู่ในภาพอ้างอิงจะถูกส่งต่อไปยังทุกภาพที่สร้างตามมา
องค์ประกอบที่แนะนำ:
- ภาพด้านหน้าพร้อมสีหน้ากลาง ๆ — แสงสม่ำเสมอ สีหน้ากลาง ๆ และเป็นจุดยึดอัตลักษณ์หลัก
- มุมสามส่วนสี่และมุมด้านข้าง — รองรับพาเนลที่มองจากมุมอื่น
- ภาพเต็มตัว — Runway ระบุว่าการบรรยายรองเท้าหรือกางเกงในพรอมป์ต์จะกระตุ้นให้จัดเฟรมเต็มตัวได้อย่างน่าเชื่อถือ
- ภาพขยายรายละเอียดเครื่องแต่งกาย — ครอปแยกของเครื่องประดับ อาวุธ และตราสัญลักษณ์
- การเรนเดอร์ที่ล็อกสไตล์ — ภาพอ้างอิงควรมีสไตล์ศิลปะเดียวกับเป้าหมาย ไม่ใช่ฐานภาพเสมือนจริง
เครื่องมือหลักด้านความสม่ำเสมอของตัวละครแตกต่างกันจริงอย่างไร?
ไม่มีเครื่องมือใดชนะในทุกมิติ — ตัวเลือกที่เหมาะสมขึ้นอยู่กับว่าคุณให้ความสำคัญกับความเที่ยงตรงของสไตล์ ความแม่นยำของภาพอ้างอิง หรือการควบคุมเวิร์กโฟลว์ Midjourney ให้ความกลมกลืนด้านสไตล์ที่แข็งแกร่งที่สุด แต่จัดการภาพอ้างอิงภายนอกได้อ่อนที่สุด Runway ให้การประกอบภาพอ้างอิงหลายรายการที่ยืดหยุ่นที่สุด ส่วนชุดเครื่องมือโอเพนซอร์สให้การควบคุมสูงสุดแลกกับต้นทุนการตั้งค่าที่สูงที่สุด
| มิติ | Midjourney | Runway Gen-4 References | Leonardo.Ai | โอเพนซอร์ส (ComfyUI + IP-Adapter) |
|---|---|---|---|---|
| กลไกภาพอ้างอิง | Character Reference (--cref) ใน V6/Niji 6; Omni Reference ใน V7+ | ภาพอ้างอิงติดแท็กสูงสุด 3 รายการต่อการสร้าง เรียกด้วย @name | ตัวเลือก Character Reference และ Image Guidance | IP-Adapter, FaceID, ControlNet, LoRA — ประกอบใช้ร่วมกันได้ |
| ตัวปรับความแข็งแรงของความสม่ำเสมอ | --cw 0 (เฉพาะใบหน้า) ถึง --cw 100 (ใบหน้า ผม เสื้อผ้า) | เส้นทางภาพอ้างอิงแบบวนซ้ำ; ผลลัพธ์กลายเป็นภาพอ้างอิงใหม่ | ปรับน้ำหนัก guidance ได้ต่อภาพอ้างอิง | ควบคุมน้ำหนักและเลเยอร์เต็มรูปแบบต่อ adapter |
| การจัดการภาพถ่ายภายนอก | อ่อน — ระบุว่า “ทำงานได้ยอดเยี่ยมกับตัวละครที่สร้างโดย MJ” แต่ทำได้ไม่ดีกับภาพอ้างอิงจากภายนอก | แข็งแกร่ง — ออกแบบมาสำหรับภาพถ่ายที่อัปโหลดและมีแสงสม่ำเสมอ | ปานกลาง | แข็งแกร่งที่สุดเมื่อใช้รุ่น FaceID |
| ต้นทุนการประมวลผลเพิ่ม | Omni Reference ใช้เวลา GPU 2× เทียบกับภาพ V7 มาตรฐาน | ใช้เครดิตต่อการสร้าง | Image Guidance ใช้ 2 tokens ต่อหนึ่งตัวเลือก จากฐาน 12 tokens ตามศูนย์ช่วยเหลือของ Leonardo | ใช้เวลา GPU ภายในเครื่องเท่านั้น |
| ฉากหลายตัวละคร | จำกัด — ความสับสนของแนวคิดพบได้บ่อย | รองรับผ่านภาพอ้างอิงหลายรายการ | จำกัด | แข็งแกร่งเมื่อใช้การกำหนดเงื่อนไขตามภูมิภาค |
| ราคา | แผนสมาชิก | แผน Standard เริ่มต้นที่ $15/เดือน พร้อม 625 เครดิต ตามการวิเคราะห์จากภายนอก | แผนชำระเงินเริ่มต้นที่ $12/เดือน พร้อม 8,500 tokens (~340 ภาพ) ตามรีวิวของ Sonary | ซอฟต์แวร์ฟรี; มีต้นทุนฮาร์ดแวร์ |
| เวลาในการตั้งค่าจนได้พาเนลที่สม่ำเสมอครั้งแรก | ไม่กี่นาที | ไม่กี่นาที | ไม่กี่นาที | หลายชั่วโมงถึงหลายวัน |
| เหมาะที่สุดสำหรับ | คอมิกสไตล์จัดที่ทิศทางศิลป์สำคัญกว่าความเหมือนเป๊ะ | ลำดับภาพแบบภาพยนตร์และ b-roll ที่สม่ำเสมอตามฉาก | งานปริมาณมากที่คำนึงถึงงบประมาณ | ครีเอเตอร์เชิงเทคนิคที่ต้องการการควบคุมแม่นยำและทำซ้ำได้ |
รายละเอียดราคาและฟีเจอร์สะท้อนข้อมูลที่เปิดเผยต่อสาธารณะ ณ เวลาที่เขียน และเปลี่ยนแปลงบ่อยครั้ง
ข้อจำกัดที่ควรยอมรับอย่างตรงไปตรงมาของเครื่องมือที่ใช้ภาพอ้างอิงทุกประเภท:
- เอกสารของ Midjourney ระบุชัดว่าโมเดล “ใช้ Image Prompts และภาพอ้างอิงเป็นแรงบันดาลใจเพื่อนำทางการสร้างใหม่ ไม่ใช่เพื่อคัดลอกอย่างแม่นยำ” การกำหนดเงื่อนไขด้วยภาพอ้างอิงช่วยลดความคลาดเคลื่อน แต่ไม่ได้กำจัดมันหมดสิ้น
- IP-Adapter มักถูกใช้งานผิด ระบุอย่างตรงไปตรงมาว่า IP-Adapter “ไม่ได้มีไว้สร้างตัวละครให้สม่ำเสมอ” หากใช้เพียงลำพัง เพราะมันถ่ายโอนสไตล์ภาพ และต้องใช้รุ่นเฉพาะตัวละคร เช่น FaceID เพื่อล็อกอัตลักษณ์
- งานวิจัยของ Character-Adapter เองยอมรับว่า “ในสถานการณ์ที่เกี่ยวข้องกับลวดลายเสื้อผ้าซับซ้อนอย่างยิ่ง โมเดลของเราอาจไม่สามารถรักษารายละเอียดต้นฉบับไว้ได้ครบถ้วน”
เมื่อใดที่การสร้างใหม่ทั้งหมดเป็นทางเลือกที่ดีกว่า?
การสร้างใหม่ทั้งหมดเหมาะกับงานสำรวจ งานที่ต้องการภาพเดียว และทุกโปรเจกต์ที่คุณยังไม่ได้ล็อกการออกแบบตัวละคร การกำหนดเงื่อนไขด้วยภาพอ้างอิงจำกัดพื้นที่ของผลลัพธ์โดยเจตนา — นั่นคือจุดประสงค์ของมัน — จึงอาจให้ผลตรงกันข้ามอย่างชัดเจนในระหว่างการสร้างแนวคิด
การสร้างใหม่ชนะในสี่สถานการณ์เฉพาะ:
- การสำรวจการออกแบบ คุณกำลังค้นหาตัวละคร ไม่ได้กำลังทำซ้ำตัวละครเดิม การลอง seed ยี่สิบแบบกับพรอมป์ต์กว้าง ๆ ช่วยเผยตัวเลือกที่ชีตอ้างอิงจะกดทับไว้
- พาเนลเดียวหรือภาพประกอบเดี่ยว เมื่อไม่มีลำดับภาพ ก็ไม่มีสิ่งใดให้คลาดเคลื่อนไป ต้นทุนการประมวลผลเพิ่มของการกำหนดเงื่อนไขด้วยภาพอ้างอิงจึงไม่ได้ให้อะไรตอบแทน
- ตัวละครฝูงชนและฉากหลัง ความหลากหลายคือเป้าหมาย การล็อกคนประกอบฉากทุกคนเข้ากับภาพอ้างอิงจะสร้างความรู้สึกประหลาดเหมือนโคลน
- งานศิลป์ที่มีการลดทอนสไตล์อย่างมากและยอมรับความเหมือนได้กว้าง สไตล์ chibi มินิมัล หรือเชิงนามธรรมสูง มีคุณลักษณะที่บ่งชี้อัตลักษณ์น้อยกว่า ดังนั้นการสร้างจากพรอมป์ต์อย่างเดียวจึงคลาดเคลื่อนอยู่ในช่วงที่ผู้อ่านยอมรับได้
รูปแบบผสมที่เวิร์กโฟลว์ระดับมืออาชีพใช้จริง
ในทางปฏิบัติ ครีเอเตอร์ที่มีประสบการณ์แทบไม่เลือกวิธีใดวิธีหนึ่งเพียงอย่างเดียว เวิร์กโฟลว์หลักคือรูปแบบสองช่วง:
- ช่วงที่หนึ่ง — สร้างใหม่อย่างอิสระ เพื่อค้นหาตัวละคร ไม่มีภาพอ้างอิง มีความหลากหลายของ seed สูง และเปิดกว้างสำหรับพรอมป์ต์
- ช่วงที่สอง — ล็อกและยึดโยง เลือกผลลัพธ์ที่แข็งแรงที่สุด สร้างภาพหมุนตัวจากผลลัพธ์นั้น บันทึกเป็นภาพอ้างอิงที่ตั้งชื่อไว้ แล้วเปลี่ยนไปใช้การสร้างที่กำหนดเงื่อนไขด้วยภาพอ้างอิงทั้งหมดสำหรับลำดับงานผลิต
เอกสารของ Runway อธิบายรูปแบบวนซ้ำนี้โดยตรง: วางเมาส์เหนือผลลัพธ์ใดก็ได้ เลือก “Reference for image” แล้วผลลัพธ์ที่สร้างจะกลายเป็นจุดยึดใหม่ คู่มือของพวกเขาสาธิตการบันทึกผลลัพธ์ระหว่างทางเป็น fullbodyelfbryan แล้วทำงานต่อจากจุดนั้น — ชีตอ้างอิงจึงไม่ใช่อินพุตนิ่ง ๆ แต่เป็นชิ้นงานที่มีชีวิตและได้รับการปรับปรุงระหว่างลำดับงาน
รายละเอียดปรับแต่งที่คู่มือส่วนใหญ่มองข้าม: เมื่อภาพอ้างอิงของคุณมีตัวแบบอยู่แล้ว แต่ต้องการนำตัวละครอื่นมาจัดองค์ประกอบในฉากนั้น Runway แนะนำให้ปิดหน้าของตัวแบบเดิมด้วยกล่องสีดำในโปรแกรมตกแต่งภาพก่อนอัปโหลด วิธีนี้ป้องกันไม่ให้โมเดลสับสนระหว่างตัวแบบต้นฉบับกับตัวละครที่ต้องการ — เป็นขั้นตอนเตรียมเล็ก ๆ ที่กำจัดรูปแบบความล้มเหลวซึ่งพบได้บ่อยและทำให้สับสน
ต้นทุนและเวลาที่ต้องแลกจริงระหว่างสองแนวทางคืออะไร?
ชีตอ้างอิงมีต้นทุนล่วงหน้าสูงกว่าและมีต้นทุนต่อการสร้างสูงกว่า แต่ใช้งานแก้ไขซ้ำน้อยกว่ามาก — และจุดที่ต้นทุนเริ่มคุ้มกว่ามาถึงเร็วกว่าที่ครีเอเตอร์ส่วนใหญ่คาด โดยทั่วไปอยู่ระหว่าง 5 ถึง 10 พาเนล
เปรียบเทียบโครงสร้างต้นทุน:
| องค์ประกอบต้นทุน | สร้างใหม่ทั้งหมด | ชีตอ้างอิงแบบถาวร |
|---|---|---|
| การลงทุนในการตั้งค่า | แทบไม่มี | 1-3 ชั่วโมงเพื่อสร้างและตรวจสอบชีต |
| การประมวลผลต่อการสร้าง | อัตราพื้นฐาน | 2× สำหรับ Midjourney Omni Reference; +2 tokens ต่อหนึ่งตัวเลือก guidance บน Leonardo |
| อัตราการคัดทิ้ง | สูง — ผลลัพธ์ส่วนใหญ่ไม่ตรงอัตลักษณ์ | ต่ำ — ผลลัพธ์ส่วนใหญ่ใช้ได้หรือใกล้ใช้ได้ |
| ต้นทุนงานแก้ไขซ้ำ | เพิ่มตามความยาวของลำดับ | ค่อนข้างคงที่ |
| รูปแบบความล้มเหลว | ความคลาดเคลื่อนเงียบ ๆ ที่พบเมื่อนำมาประกอบ | ความไม่ตรงกันที่เห็นได้ในเวลาสร้าง |
อัตราการคัดทิ้งคือตัวแปรหลัก และเป็นสิ่งที่ครีเอเตอร์มักคำนวณผิดมากที่สุด หากการสร้างใหม่จากพรอมป์ต์เพียงอย่างเดียวให้พาเนลที่ตรงแบบเพียงหนึ่งในแปด คุณกำลังจ่ายค่าการสร้างแปดครั้งในอัตราพื้นฐานต่อพาเนลที่ใช้ได้หนึ่งชิ้น การกำหนดเงื่อนไขด้วยภาพอ้างอิงที่ต้นทุน 2× แต่มีอัตราสำเร็จหนึ่งในสอง จะถูกกว่าต่อผลลัพธ์ที่ใช้ได้ — ก่อนนับแรงงานในการตรวจสอบและทิ้งงานที่ไม่ผ่าน
ต้นทุนลำดับที่สองคือจังหวะเวลาที่ค้นพบปัญหา ความคลาดเคลื่อนจากพรอมป์ต์อย่างเดียวมักมองไม่เห็นเมื่อดูทีละพาเนล และจะชัดเจนก็ต่อเมื่อวางพาเนลไว้เคียงกันบนหน้าที่เสร็จแล้ว เมื่อถึงจุดนั้น การแก้ไขต้องสร้างพาเนลที่ผ่านการตรวจรายชิ้นไปแล้วใหม่ รวมถึงต้องจับคู่แสงและองค์ประกอบกับพาเนลข้างเคียงอีกครั้ง เวิร์กโฟลว์ภาพอ้างอิงทำให้ความไม่ตรงกันของอัตลักษณ์ปรากฏตั้งแต่เวลาสร้าง ซึ่งเป็นช่วงที่แก้ไขได้ถูกที่สุด
มีข้อโต้แย้งที่สมเหตุสมผลจริง งานทดสอบของ Character-Adapter พบว่าแนวทาง fine-tuning เช่น LoRA ต้องใช้การประมวลผลตั้งค่า 1,050 วินาที เทียบกับ 7.2 วินาที สำหรับการกำหนดเงื่อนไขด้วยภาพอ้างอิงแบบไม่ต้องฝึกเพิ่ม — ต่างกันด้านประสิทธิภาพถึง 70× โครงสร้างพื้นฐานภาพอ้างอิงแบบหนักมีต้นทุนจริง และสำหรับลำดับสั้น การตั้งค่าอาจไม่มีวันคืนทุน
จะสร้างและนำชีตอ้างอิงไปใช้ให้คงตัวได้จริงอย่างไร?
สร้างชีตในสไตล์ศิลปะเดียวกับพาเนลสุดท้ายของคุณ สร้างจากผลลัพธ์เดียวที่ล็อกไว้แทนการนำมุมมองจากหลายการสร้างมาประกอบ แล้วตรวจสอบมันด้วยลำดับทดสอบที่เข้มงวดก่อนเริ่มงานผลิต
ทีละขั้นตอน: การสร้างชีตอ้างอิง
- ล็อกภาพหลัก สำรวจด้วยพรอมป์ต์อย่างเดียวจนได้ผลลัพธ์ที่ทำให้ตัวละครสมบูรณ์แบบ ภาพนี้จะเป็น seed สำหรับทุกอย่างในขั้นต่อไป
- สร้างภาพหมุนตัวจากภาพหลัก ไม่ใช่จากพรอมป์ต์ ป้อนภาพหลักกลับเข้าไปเป็นภาพอ้างอิง แล้วพรอมป์ต์สำหรับมุมด้านข้าง มุมสามส่วนสี่ และมุมด้านหลัง การสร้างมุมมองอย่างอิสระจากข้อความจะทำให้ได้ตัวละครสามคนที่ต่างกัน
- ปรับแสงและสีหน้าให้เป็นมาตรฐาน ทำตามแนวทางผืนผ้าใบว่างของ Runway: แสงสม่ำเสมอ สีหน้ากลาง ๆ คุณภาพปานกลาง อย่าฝังสิ่งใดลงไปหากคุณไม่ต้องการให้ปรากฏในทุกพาเนล
- เพิ่มภาพครอปรายละเอียดเครื่องแต่งกาย ภาพระยะใกล้แยกของเครื่องประดับ การออกแบบอาวุธ และตราสัญลักษณ์ ช่วยให้โมเดลมีเป้าหมายที่ชัดเจนสำหรับรายละเอียดที่คลาดเคลื่อนก่อนเสมอ
- บันทึกและตั้งชื่อภาพอ้างอิง ใน Runway ให้วางเมาส์เหนือภาพ คลิกแท็กเพื่อบันทึก แล้วใส่ชื่อ มิฉะนั้นภาพอ้างอิงจะเป็นเพียงข้อมูลชั่วคราวของเซสชันและหายไปเมื่อรีเฟรชเบราว์เซอร์
- ทดสอบอย่างเข้มงวด สร้างตัวละครในห้าเงื่อนไขที่ท้าทายโดยตั้งใจ: ภาพระยะใกล้สุดขีด ภาพเต็มตัวมุมกว้าง มุมสามส่วนสี่ด้านหลัง แสงด้านข้างแบบดราม่า และท่าแอ็กชันหนัก หากอัตลักษณ์ยังคงอยู่ครบทั้งห้าแบบ ชีตก็พร้อมสำหรับงานผลิต
การนำชีตไปใช้ในเวิร์กโฟลว์พาเนล
เมื่อชีตผ่านการตรวจสอบแล้ว การสร้างพาเนลจะเป็นรูปแบบที่ทำซ้ำได้ บนแพลตฟอร์มที่มีภาพอ้างอิงแบบตั้งชื่อ ให้เรียกตัวละครแบบอินไลน์และบรรยายเฉพาะฉาก:
"@marisa ยืนอยู่ริมดาดฟ้าที่เปียกฝนในเวลากลางคืน มีแสงเมืองอยู่เบื้องล่าง มุมสามส่วนสี่จากด้านหลัง พร้อมแสงย้อนแบบดราม่า"
กฎการเขียนพรอมป์ต์สองข้อสำคัญกว่าสิ่งอื่นใด:
- อย่าบรรยายตัวละครซ้ำ เอกสารของ Midjourney ยกตัวอย่างความต่างไว้อย่างชัดเจน: พรอมป์ต์ที่ไม่ดีระบุใหม่ว่า “ผู้ชายผมสีน้ำเงินสวมแว่นสีทองนั่งอยู่ในคาเฟ่” ขณะที่พรอมป์ต์ที่ดีคือ “ภาพประกอบของผู้ชายนั่งคนเดียวในคาเฟ่” การบรรยายลักษณะทางกายภาพซ้ำจะสร้างความขัดแย้งระหว่างเงื่อนไขจากข้อความและภาพ
- ให้บรรยายทุกสิ่งอื่นอย่างละเอียด แนวทางของ Midjourney ระบุชัดว่าข้อความ “สำคัญไม่แพ้กันสำหรับการสื่อสารฉากทั้งหมดและรายละเอียดเพิ่มเติมนอกเหนือจากสิ่งที่ภาพอ้างอิงแสดง”
🎯 การปรับตัวควบคุมความสม่ำเสมอ
พารามิเตอร์ character weight ของ Midjourney เป็นตัวอย่างที่ชัดเจนที่สุดของตัวควบคุมที่ครีเอเตอร์ส่วนใหญ่ปล่อยไว้เป็นค่าเริ่มต้น ที่ --cw 100 โมเดลจะดึงใบหน้า ผม และเสื้อผ้าจากภาพอ้างอิง ที่ --cw 0 โมเดลจะเน้นเกือบทั้งหมดไปที่ใบหน้า
การใช้งานจริง:
--cw 100— พาเนลที่ตัวละครสวมชุดเดียวกับภาพอ้างอิง--cw 0ถึง--cw 30— การเปลี่ยนชุด การข้ามเวลา หรือชุดทางเลือกที่ต้องให้คงอยู่เฉพาะใบหน้า
ครีเอเตอร์ที่รายงานว่าการกำหนดเงื่อนไขด้วยภาพอ้างอิง “ต้าน” การเปลี่ยนชุด มักใช้ค่าน้ำหนักเริ่มต้นอยู่ ทั้งที่ควรใช้น้ำหนักต่ำ
สำหรับครีเอเตอร์ที่ทำงานในแพลตฟอร์ม AI แบบสนทนา แทนเครื่องมือสร้างภาพเฉพาะทาง เอเจนต์อย่าง Comic Creator, Manga Creator และ Webtoon Creator บน Jenova จัดการงานภาพต่อเนื่องด้วยหน่วยความจำข้ามเซสชันแบบถาวร ซึ่งทำให้คำบรรยายตัวละครและการตัดสินใจด้านการออกแบบที่กำหนดไว้ยังใช้งานได้ตลอดโปรเจกต์ยาว โดยไม่ต้องระบุซ้ำทุกเซสชัน สิ่งที่ต้องแลกคือการควบคุมพารามิเตอร์ที่ละเอียดน้อยกว่าแพลตฟอร์มสร้างภาพเฉพาะทาง — คุณไม่สามารถกำหนดค่า character weight ได้โดยตรง ใช้งานได้ที่ jenova.ai โดยแผนฟรีมีการใช้งานรายวันแบบจำกัด และแผนชำระเงินเริ่มต้นที่ $20/เดือน
ผู้ปฏิบัติงานจริงพูดถึงชีตอ้างอิงในกระบวนการผลิตอย่างไร?
ผู้ปฏิบัติงานรายงานตรงกันอย่างต่อเนื่องว่าการถกเถียงระหว่างภาพอ้างอิงกับการสร้างใหม่ได้ข้อสรุปแล้วว่าภาพอ้างอิงเหนือกว่าสำหรับงานที่เป็นลำดับ แต่ทักษะสำคัญได้เปลี่ยนจากการเขียนพรอมป์ต์ไปเป็นการคัดสรรภาพอ้างอิง
“กรอบความคิดที่คนส่วนใหญ่นำมาใช้กับคำถามนี้กลับด้าน พวกเขาถามว่าวิธีใดให้ความสม่ำเสมอดีกว่า ทั้งที่ตัวแปรจริงคือคุณต้องส่งมอบกี่พาเนล หากน้อยกว่าสามพาเนล การสร้างใหม่ก็เพียงพอ และภาพอ้างอิงเป็นภาระส่วนเกิน แต่เมื่อเกินสิบพาเนล เวิร์กโฟลว์จากพรอมป์ต์อย่างเดียวจะมีอัตราการคัดทิ้งที่ไม่อาจปกป้องเชิงเศรษฐศาสตร์ได้ — คุณจ่ายค่าการสร้างแปดครั้งเพื่อให้ได้พาเนลที่ใช้ได้หนึ่งชิ้น และคุณจะไม่พบความล้มเหลวจนกว่าจะประกอบเป็นหน้า”
“ความล้มเหลวที่เราพบบ่อยที่สุดไม่ใช่การเลือกเครื่องมือ แต่คือคุณภาพของภาพอ้างอิง ครีเอเตอร์สร้างชีตจากภาพหลักที่มีแสงดราม่าและสีหน้าชัดมาก แล้วสงสัยว่าทำไมทุกพาเนลจึงมีแสงแบบเดียวกันและรอยยิ้มครึ่งหนึ่งเหมือนกัน ภาพอ้างอิงคือพื้นผิวของข้อจำกัด — ทุกสิ่งที่ฝังอยู่ในนั้นจะถูกส่งต่อ แสงกลาง ๆ และสีหน้ากลาง ๆ ไม่ใช่ความชอบด้านสุนทรียะ แต่เป็นข้อกำหนดทางเทคนิค”
“ตัวควบคุมอีกอย่างที่ถูกใช้น้อยคือค่าน้ำหนักความสม่ำเสมอ Midjourney ให้ตัวปรับตั้งแต่ 0 ถึง 100 แต่แทบไม่มีใครแตะมัน หากตัวละครของคุณเปลี่ยนชุดในองก์สอง การใช้ character weight เต็มหมายถึงคุณกำลังต่อสู้กับภาพอ้างอิงในการสร้างทุกครั้ง ลดมันให้เหลือเฉพาะใบหน้า แล้วความขัดแย้งจะหายไป เครื่องมือแก้ปัญหานี้ไว้แล้ว — ช่องว่างอยู่ที่ความรู้ของครีเอเตอร์”
— ทีมผลิตภัณฑ์ Jenova, มีประสบการณ์ 6 ปีในการสร้างเวิร์กโฟลว์เอเจนต์ AI สำหรับงานสร้างสรรค์
คุณควรเลือกแนวทางใดสำหรับโปรเจกต์ของคุณโดยเฉพาะ?
จับคู่วิธีการกับความยาวของลำดับและระดับการยอมรับความคลาดเคลื่อนด้านอัตลักษณ์ — ตัวแปรสองอย่างนี้กำหนดคำตอบมากกว่าความชอบเครื่องมือหรืองบประมาณ
เลือกสร้างใหม่ทั้งหมดเมื่อ:
- ผลิตภาพรวมเพียง 1-3 ภาพ
- กำลังสำรวจการออกแบบตัวละครก่อนล็อกแบบ
- สร้างตัวละครฉากหลังหรือฝูงชนที่ต้องการความหลากหลาย
- ทำงานในสไตล์ที่ลดทอนอย่างมากและมีความละเอียดด้านอัตลักษณ์ต่ำ
- มีงบต่อการสร้างที่เข้มงวด แต่ยอมรับความคลาดเคลื่อนของสไตล์ได้สูง
เลือกชีตอ้างอิงแบบถาวรเมื่อ:
- ผลิตพาเนลต่อเนื่อง 5+ พาเนล
- ใบหน้าตัวละครปรากฏในภาพระยะใกล้
- โปรเจกต์ดำเนินข้ามหลายเซสชันหรือมีผู้ร่วมงานหลายคน
- รายละเอียดเครื่องแต่งกายและเครื่องประดับมีน้ำหนักต่อเรื่องราว
- ผลงานเป็นงานลูกค้าที่คาดหวังการแก้ไข
เลือกรูปแบบผสมเมื่อ:
- ตัวละครยังไม่ได้รับการออกแบบ แต่ลำดับงานยาว — ซึ่งเป็นกรณีของโปรเจกต์คอมิก สตอรีบอร์ด หรือหนังสือภาพประกอบที่จริงจังเกือบทุกงาน
หลักตัดสินใจที่ใช้ได้จริง: หากคุณจะสังเกตเห็นว่าตัวละครเปลี่ยนไปเมื่อเทียบภาพสองภาพใด ๆ ในชุด ให้ใช้ภาพอ้างอิง หากไม่สังเกตเห็น ก็ไม่จำเป็นต้องจ่ายต้นทุนเพิ่ม
มีจุดยืนที่สวนกระแสอยู่หนึ่งข้อที่ควรกล่าวอย่างจริงจัง: ชีตอ้างอิงมักถูกนำไปใช้มากเกินไปกับโปรเจกต์ที่ไม่ต้องการมัน แถบคอนเทนต์โซเชียลมีเดียสี่พาเนลในสไตล์แบนและมินิมัลจะดูสม่ำเสมอได้จากการสร้างด้วยพรอมป์ต์อย่างเดียว และเวลาหลายชั่วโมงที่ใช้สร้างภาพหมุนตัวผ่านการตรวจสอบก็ไม่ทำให้ผลลัพธ์ดีขึ้นอย่างเห็นได้ชัด ความสม่ำเสมอเป็นวิธีสร้างการมีส่วนร่วมของผู้อ่าน ไม่ใช่เป้าหมายในตัวมันเอง — และเมื่อเกินระดับหนึ่งไปแล้ว ความสม่ำเสมอที่เพิ่มขึ้นจะมองไม่เห็น
แหล่งอ้างอิง
- Character-Adapter: Prompt-Guided Region Control for High-Fidelity Character Customization — งานวิจัย arXiv พร้อมเกณฑ์เปรียบเทียบ CLIP-I, DINO-I และประสิทธิภาพ
- เอกสาร Midjourney — พารามิเตอร์ Character Reference, character weight และแนวทางปฏิบัติที่ดี
- เอกสาร Midjourney — ต้นทุน GPU ของ Omni Reference
- ศูนย์ช่วยเหลือ Runway — การสร้างด้วย Gen-4 Image References, การติดแท็กภาพอ้างอิง และเวิร์กโฟลว์แบบวนซ้ำ
- ศูนย์ช่วยเหลือ Leonardo.Ai — ต้นทุน tokens ของ Image Guidance
- Tencent AI Lab — คลัง IP-Adapter และคำอธิบายทางเทคนิค
- Wikipedia — Model sheet และมาตรฐานภาพอ้างอิงตัวละครในแอนิเมชันดั้งเดิม
- Kie.ai — การวิเคราะห์ระดับแผนและการจัดสรรเครดิตของ Runway Gen-4
- Sonary — รีวิว Leonardo.AI Image Generator, ราคาแผน และการจัดสรร tokens