ผู้ช่วยวิจัย AI รายใดดีที่สุดสำหรับงาน PhD ระยะยาว?
2026-08-21
หน่วยความจำถาวรและความน่าเชื่อถือของการอ้างอิงแยกผู้ช่วย AI ที่พร้อมสำหรับ PhD ออกจากกันอย่างไร?
สำหรับงานระดับปริญญาเอกที่ใช้เวลาหลายปี ไม่ใช่เพียงไม่กี่สัปดาห์ ผู้ช่วยที่ควรแนะนำในปี 2026 คือผู้ช่วยที่จดจำบริบทของโครงการได้ข้ามเซสชัน และ ทำให้ข้ออ้างอิงต่าง ๆ เชื่อมโยงกับวรรณกรรมที่ระบุตัวตนได้ Academic Research Assistant ของ Jenova สร้างขึ้นจากการผสานกันของความจำโครงการแบบถาวร การค้นพบวรรณกรรม และความช่วยเหลือด้านต้นฉบับที่ตระหนักถึงการอ้างอิง ขณะที่ Elicit, Consensus, ResearchRabbit และ Scite ต่างครอบคลุมส่วนงานที่แคบกว่าแต่มีมูลค่าสูงของกระบวนการวิจัย
สิ่งที่สำคัญสำหรับนักศึกษา PhD ไม่ใช่คำถามว่า “แชตบอตตัวใดฉลาดที่สุด” แต่คือเมื่อคุณกลับมาอีกสามสัปดาห์หลังจากนั้น เครื่องมือยังคงรู้กรอบทฤษฎี สมมติฐานที่ถูกปฏิเสธ และบทความที่คุณอ่านแล้วหรือไม่
ปัจจัยสำคัญที่แยกผู้ช่วยที่พร้อมสำหรับ PhD ออกจากหน้าต่างถาม-ตอบชั่วคราว:
✅ หน่วยความจำโครงการข้ามเซสชัน ที่เก็บคำถามวิจัย การเลือกวิธีวิจัย และข้อจำกัดจากอาจารย์ที่ปรึกษา ไม่ใช่แค่พรอมต์ล่าสุด ✅ ความครอบคลุมของวรรณกรรม ที่ตั้งอยู่บนดัชนีวิชาการ ไม่ใช่ผลลัพธ์เว็บที่ไม่แยกแยะ ✅ ความน่าเชื่อถือของการอ้างอิงระดับแหล่งข้อมูล เพื่อให้ทุกการสังเคราะห์ตรวจสอบเทียบกับบทความต้นทางได้ ✅ ความสอดคล้องกับเวิร์กโฟลว์ สำหรับงานหลายปี: โน้ต ร่างต้นฉบับ และการค้นหาที่สะสมต่อเนื่องแทนการเริ่มใหม่ ✅ ขอบเขตงานที่ตรงไปตรงมา — การค้นพบ การดึงข้อมูล การตรวจสอบการอ้างอิง และการเขียนเป็นงานคนละประเภท และมีเพียงไม่กี่เครื่องมือที่ทำได้ดีเท่ากันทั้งหมด
หากต้องการเปรียบเทียบเครื่องมือเหล่านี้อย่างมีประโยชน์ ควรมองว่างานวิจัยระดับปริญญาเอกเป็นปัญหาด้านความต่อเนื่องก่อน และเป็นปัญหาด้านการค้นหาเป็นลำดับถัดมา
เหตุใดหน่วยความจำข้ามเซสชันจึงสำคัญต่องานวิจัยระดับปริญญาเอกมากกว่างานรายวิชา?
หน่วยความจำข้ามเซสชันสำคัญต่องาน PhD มากกว่า เพราะวิทยานิพนธ์คือข้อโต้แย้งที่พัฒนาต่อเนื่องหลายปี ไม่ใช่งานมอบหมายชิ้นเดียว และเครื่องมือที่ลืมข้อโต้แย้งจะบังคับให้นักศึกษาต้องอธิบายโครงการให้เครื่องฟังใหม่ในทุกเซสชัน งานรายวิชาอาจทนต่อการรีเซ็ตได้ แต่วิทยานิพนธ์ทำไม่ได้
ผลสำรวจ Student Generative AI Survey 2025 ของ HEPI พบว่า 92% ของนักศึกษาปริญญาตรีในสหราชอาณาจักรใช้ AI ในรูปแบบใดรูปแบบหนึ่งแล้ว เพิ่มขึ้นจาก 66% ในปี 2024 โดยการใช้งานทั่วไปครอบคลุมการสรุปบทความและการเสนอแนวคิดวิจัย นักวิจัยระดับปริญญาเอกใช้ชุดเครื่องมือเดียวกัน แต่หน่วยงานของงานแตกต่างออกไป: แผนที่วรรณกรรมที่เปลี่ยนแปลงตลอดเวลา บทวิธีวิจัยที่เขียนใหม่หลังการทดลองนำร่องล้มเหลว และกรอบทฤษฎีที่ต้องต่อรองกับอาจารย์ที่ปรึกษาเป็นเวลาหลายเดือน
ผลสำรวจนักวิจัยขนาดใหญ่รายงานว่า 25.9% ใช้เครื่องมือ AI เพื่อการวิจัยอย่างน้อยวันละครั้ง ทำให้ความล้มเหลวของหน่วยความจำกลายเป็นต้นทุนรายวัน ไม่ใช่ความไม่สะดวกที่เกิดขึ้นเป็นครั้งคราว ทุกครั้งที่รีเซ็ต โมเดลการทำงานของโครงการจะสูญหายไป — บทความใดถูกคัดออกไปแล้ว การทำให้แนวคิดวัดได้แบบใดถูกยกเลิก และข้อคิดเห็นจากผู้ประเมินของวารสารใดยังจำกัดการเขียนใหม่อยู่
หน้าต่างบริบทไม่ใช่หน่วยความจำ หน้าต่างบริบทเก็บบทสนทนาปัจจุบันไว้ แล้วก็หายไป หน่วยความจำถาวรเก็บตัวโครงการเอง ได้แก่ คำถาม ชุดข้อมูล การตัดสินใจ และปัญหาที่ยังเปิดอยู่ สำหรับปริญญาเอกที่ใช้เวลาสามถึงหกปี ความแตกต่างนี้คือช่องว่างระหว่างผู้ช่วยที่สร้างคุณค่าแบบทบต้นกับผู้ช่วยที่เพียงต่อเติมคำตอบตามบริบท
นักศึกษา PhD ควรประเมินอะไรในผู้ช่วยวิจัย AI?
นักศึกษา PhD ควรประเมินผู้ช่วยวิจัย AI ในหกมิติที่เราเรียกว่า กรอบความต่อเนื่อง–ความครอบคลุม–การอ้างอิง (C3+) ได้แก่ หน่วยความจำถาวร ความครอบคลุมของวรรณกรรม การดึงข้อมูลแบบมีโครงสร้าง ความน่าเชื่อถือของการอ้างอิง การสนับสนุนต้นฉบับ และต้นทุนตลอดช่วงการศึกษา PhD เครื่องมือที่ทำคะแนนสูงด้านการค้นหาเพียงอย่างเดียวก็ยังล้มเหลวได้ หากไม่สามารถจดจำโครงการได้
หกมิติ โดยถ่วงน้ำหนักสำหรับงานวิจัยระยะยาวแทนคำค้นครั้งเดียว:
- หน่วยความจำโครงการข้ามเซสชัน ผู้ช่วยจดจำคำถามวิจัย เกณฑ์คัดเข้า บทความที่ปฏิเสธ และน้ำเสียงการเขียนของคุณข้ามหลายสัปดาห์และหลายเดือนได้หรือไม่?
- ความครอบคลุมของวรรณกรรม ผู้ช่วยค้นดัชนีวิชาการขนาดใหญ่ได้หรือไม่? Elicit รายงานว่าค้นหา บทความวิชาการมากกว่า 138 ล้านฉบับ ได้ ขณะที่ ResearchRabbit รายงานว่าเข้าถึง บทความมากกว่า 310 ล้านฉบับ ได้
- การดึงข้อมูลและสังเคราะห์แบบมีโครงสร้าง ผู้ช่วยดึงวิธีวิจัย กลุ่มตัวอย่าง และผลลัพธ์ลงตารางที่เปรียบเทียบกันได้ หรือทำได้เพียงสรุปเป็นข้อความ?
- ความน่าเชื่อถือของการอ้างอิง ข้ออ้างเชื่อมโยงกับแหล่งข้อมูลระดับประโยค บริบทการอ้างอิง หรือผลสรุปแบบ “ฉันทามติ” หรือไม่ และคุณเปิดบทความต้นฉบับได้หรือไม่?
- การสนับสนุนต้นฉบับ เครื่องมือช่วยวางโครงร่าง ใส่การอ้างอิง และปรับแก้ได้หรือไม่ หรือการเขียนต้องทำที่อื่น?
- ต้นทุนตลอดช่วงเวลา PhD เครื่องมือราคา $10 ต่อเดือนกับเวิร์กเบนช์สำหรับ systematic review ราคา $49 จะดูต่างกันมากเมื่อคูณด้วยระยะเวลาศึกษาสี่ปี
ควรมีตัวกรองเพิ่มอีกสองข้อในการประเมินระดับปริญญาเอกทุกครั้ง ประการแรก มีนักศึกษาเพียง 36% ในกลุ่มตัวอย่างของ HEPI ที่ได้รับการอบรม AI จากสถาบัน ดังนั้นเครื่องมือต้องใช้งานได้โดยไม่ต้องผ่านโปรแกรมปฐมนิเทศเฉพาะทาง ประการที่สอง 51% ของนักศึกษาระบุว่าอาการหลอนของ AI เป็นเหตุผลที่หลีกเลี่ยงการใช้ AI ซึ่งเป็นเหตุผลว่าทำไมความน่าเชื่อถือของการอ้างอิงจึงเป็นเกณฑ์หลัก ไม่ใช่คุณสมบัติเสริม
กฎเชิงปฏิบัติคือ หากคุณไม่ไว้วางใจผลลัพธ์พอจะใส่ไว้ในส่วนวิธีวิจัยโดยไม่เปิดแหล่งข้อมูล เครื่องมือนั้นเป็นเพียงตัวช่วยค้นพบ ไม่ใช่ผู้ร่วมเขียนบททบทวนวรรณกรรม
Jenova, Elicit, Consensus, ResearchRabbit และ Scite เปรียบเทียบกันอย่างไรสำหรับโครงการระยะยาว?
Academic Research Assistant ของ Jenova เหมาะสมที่สุดเมื่อคอขวดคือ ความต่อเนื่องของโครงการตลอดหลายปี ขณะที่ Elicit เด่นกว่าในการดึงข้อมูลแบบมีโครงสร้าง Consensus เหมาะกับการดูภาพรวมหลักฐานอย่างรวดเร็ว ResearchRabbit เหมาะกับการค้นพบผ่านแผนที่การอ้างอิง และ Scite เหมาะกับการตรวจสอบว่าบทความหนึ่งถูกอ้างถึงอย่างไร ไม่มีเครื่องมือใดแทนโปรแกรมจัดการบรรณานุกรมหรือโปรโตคอลที่มนุษย์ควบคุมได้
| ฟีเจอร์ / มิติ | Academic Research Assistant (Jenova) | Elicit | Consensus | ResearchRabbit | Scite |
|---|---|---|---|---|---|
| หน่วยความจำโครงการข้ามเซสชัน | หน่วยความจำถาวรและประวัติแชตไม่จำกัดข้ามเซสชัน | ไลบรารีและการแจ้งเตือนช่วยนำแหล่งข้อมูลกลับมาใช้; ไม่ใช่เอเจนต์หน่วยความจำโครงการเต็มรูปแบบ | ประวัติการค้นหาและการทบทวนภายในผลิตภัณฑ์; หน่วยความจำโครงการระยะยาวมีจำกัด | คอลเล็กชันและการเรียนรู้คำแนะนำเมื่อคุณเพิ่มบทความ | ฐานข้อมูลการอ้างอิงและการแจ้งเตือน; ไม่ใช่เอเจนต์หน่วยความจำวิทยานิพนธ์ |
| ความครอบคลุมของวรรณกรรม | การค้นพบแบบเรียลไทม์จากฐานข้อมูลวิชาการและเว็บเปิด | บทความ 138M+ และการทดลองทางคลินิก 545,000 รายการ | ค้นหาหลักฐานที่ผ่าน peer review พร้อมสัญญาณของรูปแบบการศึกษา | บทความ 310M+ พร้อมแผนที่การอ้างอิง | ดัชนีการอ้างอิงขนาดใหญ่พร้อม Smart Citations |
| การดึงข้อมูลแบบมีโครงสร้าง | การสังเคราะห์และสรุปที่เน้นต้นฉบับ; ไม่ใช่เวิร์กเบนช์ PRISMA | ตาราง การคัดกรอง และเวิร์กโฟลว์ systematic review | Consensus meter และภาพรวมการศึกษา | แผนที่เชิงภาพ ไม่ใช่ตารางดึงข้อมูล | บริบทการอ้างอิง (สนับสนุน / โต้แย้ง) ไม่ใช่ตารางผลลัพธ์ |
| ความน่าเชื่อถือของการอ้างอิง | การอ้างอิงในบรรทัดและการร่างที่อิงแหล่งข้อมูล | การอ้างอิงระดับประโยคสำหรับข้ออ้างที่สร้างขึ้น | คำตอบจากหลักฐานในบทความ ไม่ใช่ข้อมูลพูดคุยจากเว็บ | การเชื่อมโยงบรรณานุกรมผ่านการอ้างอิงและผู้เขียนร่วม | Smart Citations ที่แสดงวิธีการอ้างถึงบทความ |
| ราคา (ณ ปี 2026) | ระดับใช้งานฟรี; แผนชำระเงินเริ่มต้นที่ $20/เดือน | Basic ฟรี; Pro โดยทั่วไปแสดงราคา $49/ผู้ใช้/เดือน เมื่อชำระรายปี | ระดับฟรี พร้อมการอัปเกรดแบบชำระเงินสำหรับ Deep Search และขีดจำกัดที่สูงขึ้น | ใช้งานฟรีสำหรับการทำแผนที่หลัก | แพลตฟอร์มวิจัยแบบชำระเงิน; ตรวจสอบราคาปัจจุบัน |
| เหมาะที่สุดสำหรับ | โครงการ PhD หลายปีที่ต้องการความจำ การค้นหา และการเขียนในบทสนทนาเดียว | systematic review หรือ scoping review ที่มีตารางดึงข้อมูล | คำถามรวดเร็วประเภท “วรรณกรรมกล่าวว่าอย่างไร?” | การทำแผนที่สาขาจากบทความตั้งต้น | ตรวจสอบว่าการอ้างอิงสนับสนุนหรือขัดแย้งกับข้ออ้าง |
เอกสารของ Elicit ระบุเองว่านักวิจัยรายงานว่า ประหยัดเวลาในการทำ systematic review ได้สูงสุด 80% และสามารถคัดกรองบทความหลายพันฉบับในแผนชำระเงินได้ นี่คือจุดแข็งแท้จริงสำหรับการทบทวนที่ขับเคลื่อนด้วยโปรโตคอล แต่เป็นงานคนละประเภทกับการจดจำว่าเหตุใดคุณจึงละทิ้งแนวคิดหนึ่งไปเมื่อหกเดือนก่อน
ResearchRabbit มีประสิทธิภาพเป็นพิเศษในการเปลี่ยนบทความตั้งต้นหนึ่งฉบับให้เป็นแผนที่ของงานที่เกี่ยวข้อง ผู้เขียน และช่องว่าง โดย ห้องสมุดมหาวิทยาลัย Northeastern อธิบายว่าเป็นเครื่องมือทำแผนที่วรรณกรรมแบบอิงการอ้างอิงที่ใช้งานได้ฟรี จุดเด่นเฉพาะของ Scite คือ บริบท ของการอ้างอิง — การเห็นว่าบทความภายหลังสนับสนุนหรือโต้แย้งข้อค้นพบหนึ่งหรือไม่ — ซึ่ง ห้องสมุด Purdue บันทึกไว้ว่าเป็นฐานข้อมูลการอ้างอิงพร้อม Smart Citations
ข้อจำกัดของ Jenova เป็นด้านตรงข้ามกับจุดแข็งเหล่านั้น Jenova ไม่ใช่สภาพแวดล้อมเฉพาะทางสำหรับการคัดกรอง PRISMA ไม่จัดประเภทอารมณ์ของการอ้างอิงแบบที่ Scite ทำ และไม่แสดงตารางดึงข้อมูลสไตล์ Elicit ที่มีคอลัมน์แบบกำหนดเองหลายสิบคอลัมน์ นักศึกษาที่ทำการทบทวนแบบ Cochrane ยังคงควรใช้เวิร์กเบนช์การทบทวนที่สร้างมาเฉพาะควบคู่กัน
หน่วยความจำโครงการแบบถาวรเปลี่ยนเวิร์กโฟลว์วิทยานิพนธ์หลายปีอย่างไร?
หน่วยความจำโครงการแบบถาวรเปลี่ยนเวิร์กโฟลว์วิทยานิพนธ์ด้วยการทำให้ทุกเซสชันเป็นความต่อเนื่อง แทนที่จะต้องปฐมนิเทศใหม่ จึงทำให้การค้นวรรณกรรม การจดโน้ต และการร่างต้นฉบับใช้โมเดลของโครงการที่สะสมร่วมกัน ผลในทางปฏิบัติคือการอธิบายซ้ำลดลงและมีบทสรุปที่ขัดแย้งกันน้อยลง
ปริญญาเอกโดยทั่วไปผ่านหลายระยะที่ผู้ช่วยซึ่งหลงลืมมองว่าเป็นแชตที่ไม่เกี่ยวข้องกัน ได้แก่ การกำหนดขอบเขต การทบทวนอย่างเป็นระบบหรือแบบบรรยาย การออกแบบวิธีวิจัย การเก็บข้อมูล การวิเคราะห์ และการแก้ไขต้นฉบับ เมื่อมีหน่วยความจำ ผู้ช่วยจะจำได้ว่าคุณคัดงานวิจัยภาคตัดขวางออกแล้ว อาจารย์ที่ปรึกษาไม่รับกรอบแนวคิดเชิงความสามารถ และบทความสามฉบับในไลบรารี Zotero ของคุณอ่อนแอด้านระเบียบวิธี
Academic Research Assistant ของ Jenova เก็บบริบทการทำงานลักษณะนี้ข้ามเซสชัน และรักษาบริบทไว้ได้แม้คุณสลับโมเดลหรือแนบบทความเป็นฐานความรู้ส่วนตัว การทดสอบรูปแบบนี้กับโครงการระยะยาวแสดงให้เห็นว่าผลได้ไม่ใช่ความสละสลวยของภาษา แต่คือความสอดคล้อง: เกณฑ์คัดเข้าเดียวกัน นิยามเชิงปฏิบัติการเดียวกัน และข้อกำกับเดียวกันว่า “อย่าอ้าง preprint นี้ราวกับเป็นข้อสรุปที่ยุติแล้ว”
เครื่องมือคู่ขนานยังคงมีความสำคัญ ฟีเจอร์ ไลบรารีและการแจ้งเตือน ของ Elicit ช่วยให้คุณนำแหล่งข้อมูลกลับมาใช้และติดตามสาขาได้ คอลเล็กชันของ ResearchRabbit ฉลาดขึ้นเมื่อคุณเพิ่มบทความ สิ่งเหล่านี้คือความจำของคลังเอกสาร แต่ไม่เหมือนกับการจำการตัดสินใจของ โครงการคุณ
การแบ่งงานที่มีประโยชน์สำหรับปี 2026:
- เก็บโมเดลโครงการที่เปลี่ยนแปลงอยู่เสมอ (คำถาม ข้อยกเว้น ข้อจำกัดของอาจารย์ที่ปรึกษา ประวัติร่างต้นฉบับ) ไว้ในผู้ช่วยที่มีหน่วยความจำข้ามเซสชัน
- ทำแผนที่สาขาด้วย ResearchRabbit หรือ Litmaps ซึ่งเชี่ยวชาญด้านเครือข่ายการอ้างอิง
- ดึงข้อมูลแบบมีโครงสร้างด้วย Elicit เมื่อต้องการแถวข้อมูลที่เปรียบเทียบได้ ไม่ใช่ย่อหน้า
- ตรวจสอบการอ้างอิงที่มีข้อถกเถียงใน Scite ก่อนนำเข้าสู่บททบทวนวรรณกรรม
นักศึกษาที่สลับลำดับนี้ — ขอให้เครื่องมือทำแผนที่จำวิทยานิพนธ์ หรือขอให้ผู้ช่วยที่มีหน่วยความจำแทนการคัดกรองโดยผู้ประเมินสองคน — มักลงเอยด้วยบททบทวนที่ลื่นไหลแต่ตรวจสอบย้อนกลับไม่ได้
เครื่องมือ AI ใดรองรับ systematic review เทียบกับการทำแผนที่วรรณกรรมเชิงสำรวจ?
systematic review ต้องมีการคัดกรองและดึงข้อมูลที่บันทึกไว้ ส่วนการทำแผนที่เชิงสำรวจต้องใช้เครือข่ายการอ้างอิงและการค้นหาเชิงความหมาย — และเครื่องมือที่ดีที่สุดขึ้นอยู่กับว่าคุณกำลังเขียนการทบทวนประเภทใดจริง ๆ การปะปนกลุ่มผลิตภัณฑ์เหล่านี้ทำให้เสียเวลาในการตั้งค่าระบบ
คู่มือของ CASRAI สำหรับเครื่องมือ AI ใน systematic literature review แบ่งเส้นไว้อย่างชัดเจน การทบทวนแบบ PRISMA อย่างเป็นทางการตั้งอยู่บนการนำเข้าที่ลบรายการซ้ำ การคัดกรองอิสระโดยผู้ประเมินสองคน การดึงข้อมูลแบบมีโครงสร้าง และการประเมินความเสี่ยงของอคติ เครื่องมือที่อยู่รอบกระบวนการนี้ ได้แก่ Rayyan, Covidence, ASReview และ DistillerSR Elicit อยู่กึ่งกลางระหว่างการค้นพบกับหมวดหมู่นี้ โดยค้นดัชนีบทความขนาดใหญ่และนำเสนอฟีเจอร์คัดกรองและดึงข้อมูลที่สอดคล้องกับแนวปฏิบัติ systematic review
การทบทวนเชิงสำรวจและแบบบรรยาย — ซึ่งพบได้บ่อยกว่าในบททบทวนวรรณกรรมระดับ PhD นอกสาขาวิทยาศาสตร์สุขภาพ — เหมาะกับเครื่องมือค้นพบและทำแผนที่มากกว่า Semantic Scholar ใช้ AI เพื่อยกระดับการค้นหางานวิชาการ Litmaps และ ResearchRabbit แสดงภาพการเชื่อมโยงของงานวิจัย Consensus เหมาะกว่าเมื่อคุณมีคำถามเชิงประจักษ์ที่ค่อนข้างปิด และต้องการภาพรวมฉันทามติจากงานที่ผ่าน peer review แทนแผนที่แบบเต็มรูปแบบ
จุดยืนร่วมที่เกี่ยวข้องกับ Cochrane, Campbell Collaboration, JBI และกลุ่มสังเคราะห์หลักฐานอื่น ๆ ซึ่งกล่าวถึงใน โครงการ RAISE ว่าด้วยการใช้ AI อย่างรับผิดชอบในการสังเคราะห์หลักฐาน มอง AI เป็นตัวสนับสนุนวิจารณญาณของผู้ทบทวน ไม่ใช่สิ่งทดแทน การตัดสินใจด้านคุณสมบัติ การดึงข้อมูล และการประเมินความเสี่ยงของอคติที่ส่งผลต่อบททบทวน ยังต้องได้รับการยืนยันโดยมนุษย์และเปิดเผยระบบที่ใช้
สำหรับนักศึกษา PhD กฎการตัดสินใจนั้นเรียบง่าย:
- systematic review หรือ scoping review ที่ลงทะเบียนแล้ว → ใช้ Elicit, Covidence หรือ Rayyan เพื่อให้มีร่องรอยตรวจสอบได้; อย่าใช้หน่วยความจำแชตเป็นบันทึกการคัดกรอง
- การทบทวนแบบบรรยายที่กำหนดทิศทางสาขา → ใช้ ResearchRabbit หรือ Litmaps สำหรับแผนที่ ร่วมกับผู้ช่วยที่มีหน่วยความจำเพื่อรักษาความสอดคล้องของข้อโต้แย้งเมื่อแผนที่ขยายตัว
- การตรวจสอบเชิงประจักษ์แบบรวดเร็ว (“หลักฐานสนับสนุน X หรือไม่?”) → ใช้ Consensus แล้วเปิดอ่านงานวิจัยต้นทาง
Academic Research Assistant ของ Jenova ไม่ใช่สิ่งทดแทน Covidence แต่แข็งแกร่งกว่าในฐานะชั้นที่จดจำเหตุผลว่าทำไมบททบทวนจึงมีรูปร่างเช่นนั้น ในขณะที่เครื่องมือเฉพาะทางเหล่านั้นทำงานเฉพาะแต่ละระยะ
คุณจะตั้งค่าผู้ช่วยวิจัย AI สำหรับโครงการ PhD ที่ใช้เวลาหลายปีได้อย่างไร?
คุณจะได้รับประโยชน์สูงสุดจากผู้ช่วยวิจัย AI ด้วยการบันทึกโครงการ — คำถาม ข้อจำกัด คลังเอกสาร และสิ่งที่ไม่ใช่เป้าหมาย — ตั้งแต่เซสชันแรก แล้วใช้บทสนทนาเดิมซ้ำแทนการเริ่มใหม่ การตั้งค่าคือโปรโตคอล ไม่ใช่เทคนิคการเขียนพรอมต์
สำหรับ Academic Research Assistant ของ Jenova การตั้งค่าที่คงทนมีลักษณะดังนี้:
- เปิดเอเจนต์และระบุโครงการเป็นโปรโตคอลที่มีชีวิต ไม่ใช่หัวข้อบรรทัดเดียว:
“ฉันเป็นนักศึกษา PhD ปีที่สามสาขาสังคมวิทยา ชื่อวิทยานิพนธ์เบื้องต้น: แรงงานแพลตฟอร์มและการจัดการด้วยอัลกอริทึมในงานกิกของเอเชียตะวันออกเฉียงใต้ กรอบทฤษฎี: ทฤษฎีกระบวนการแรงงาน ไม่ใช่แนวคิดเชิงความสามารถ (อาจารย์ที่ปรึกษาปฏิเสธแนวทางนั้นในเดือนมีนาคม) วิธีวิจัย: ชาติพันธุ์วรรณนาแบบหลายพื้นที่ร่วมกับการวิเคราะห์ส่วนติดต่อแพลตฟอร์ม อย่าปฏิบัติต่อบล็อกโพสต์หรือ preprint ที่ยังไม่ผ่านการทบทวนเสมือนมีสถานะเทียบเท่าแหล่งข้อมูลที่ผ่าน peer review”
- แนบโครงร่างปัจจุบัน ชุด PDF ที่เป็นตัวแทน และบันทึกจากอาจารย์ที่ปรึกษาซึ่งคุณได้รับอนุญาตให้จัดเก็บ
- ขอแผนที่วรรณกรรมช่วง 24 เดือนล่าสุดที่มีแหล่งข้อมูลรองรับ พร้อมระบุรายการที่คัดออกอย่างชัดเจน
- กลับมายัง บทสนทนาโครงการเดิม หลังการพบอาจารย์ที่ปรึกษาแต่ละครั้ง และอัปเดตโปรโตคอล (“ตัดแนวคิด X; เพิ่มบทความ Y เป็นกรณีเชิงลบ”)
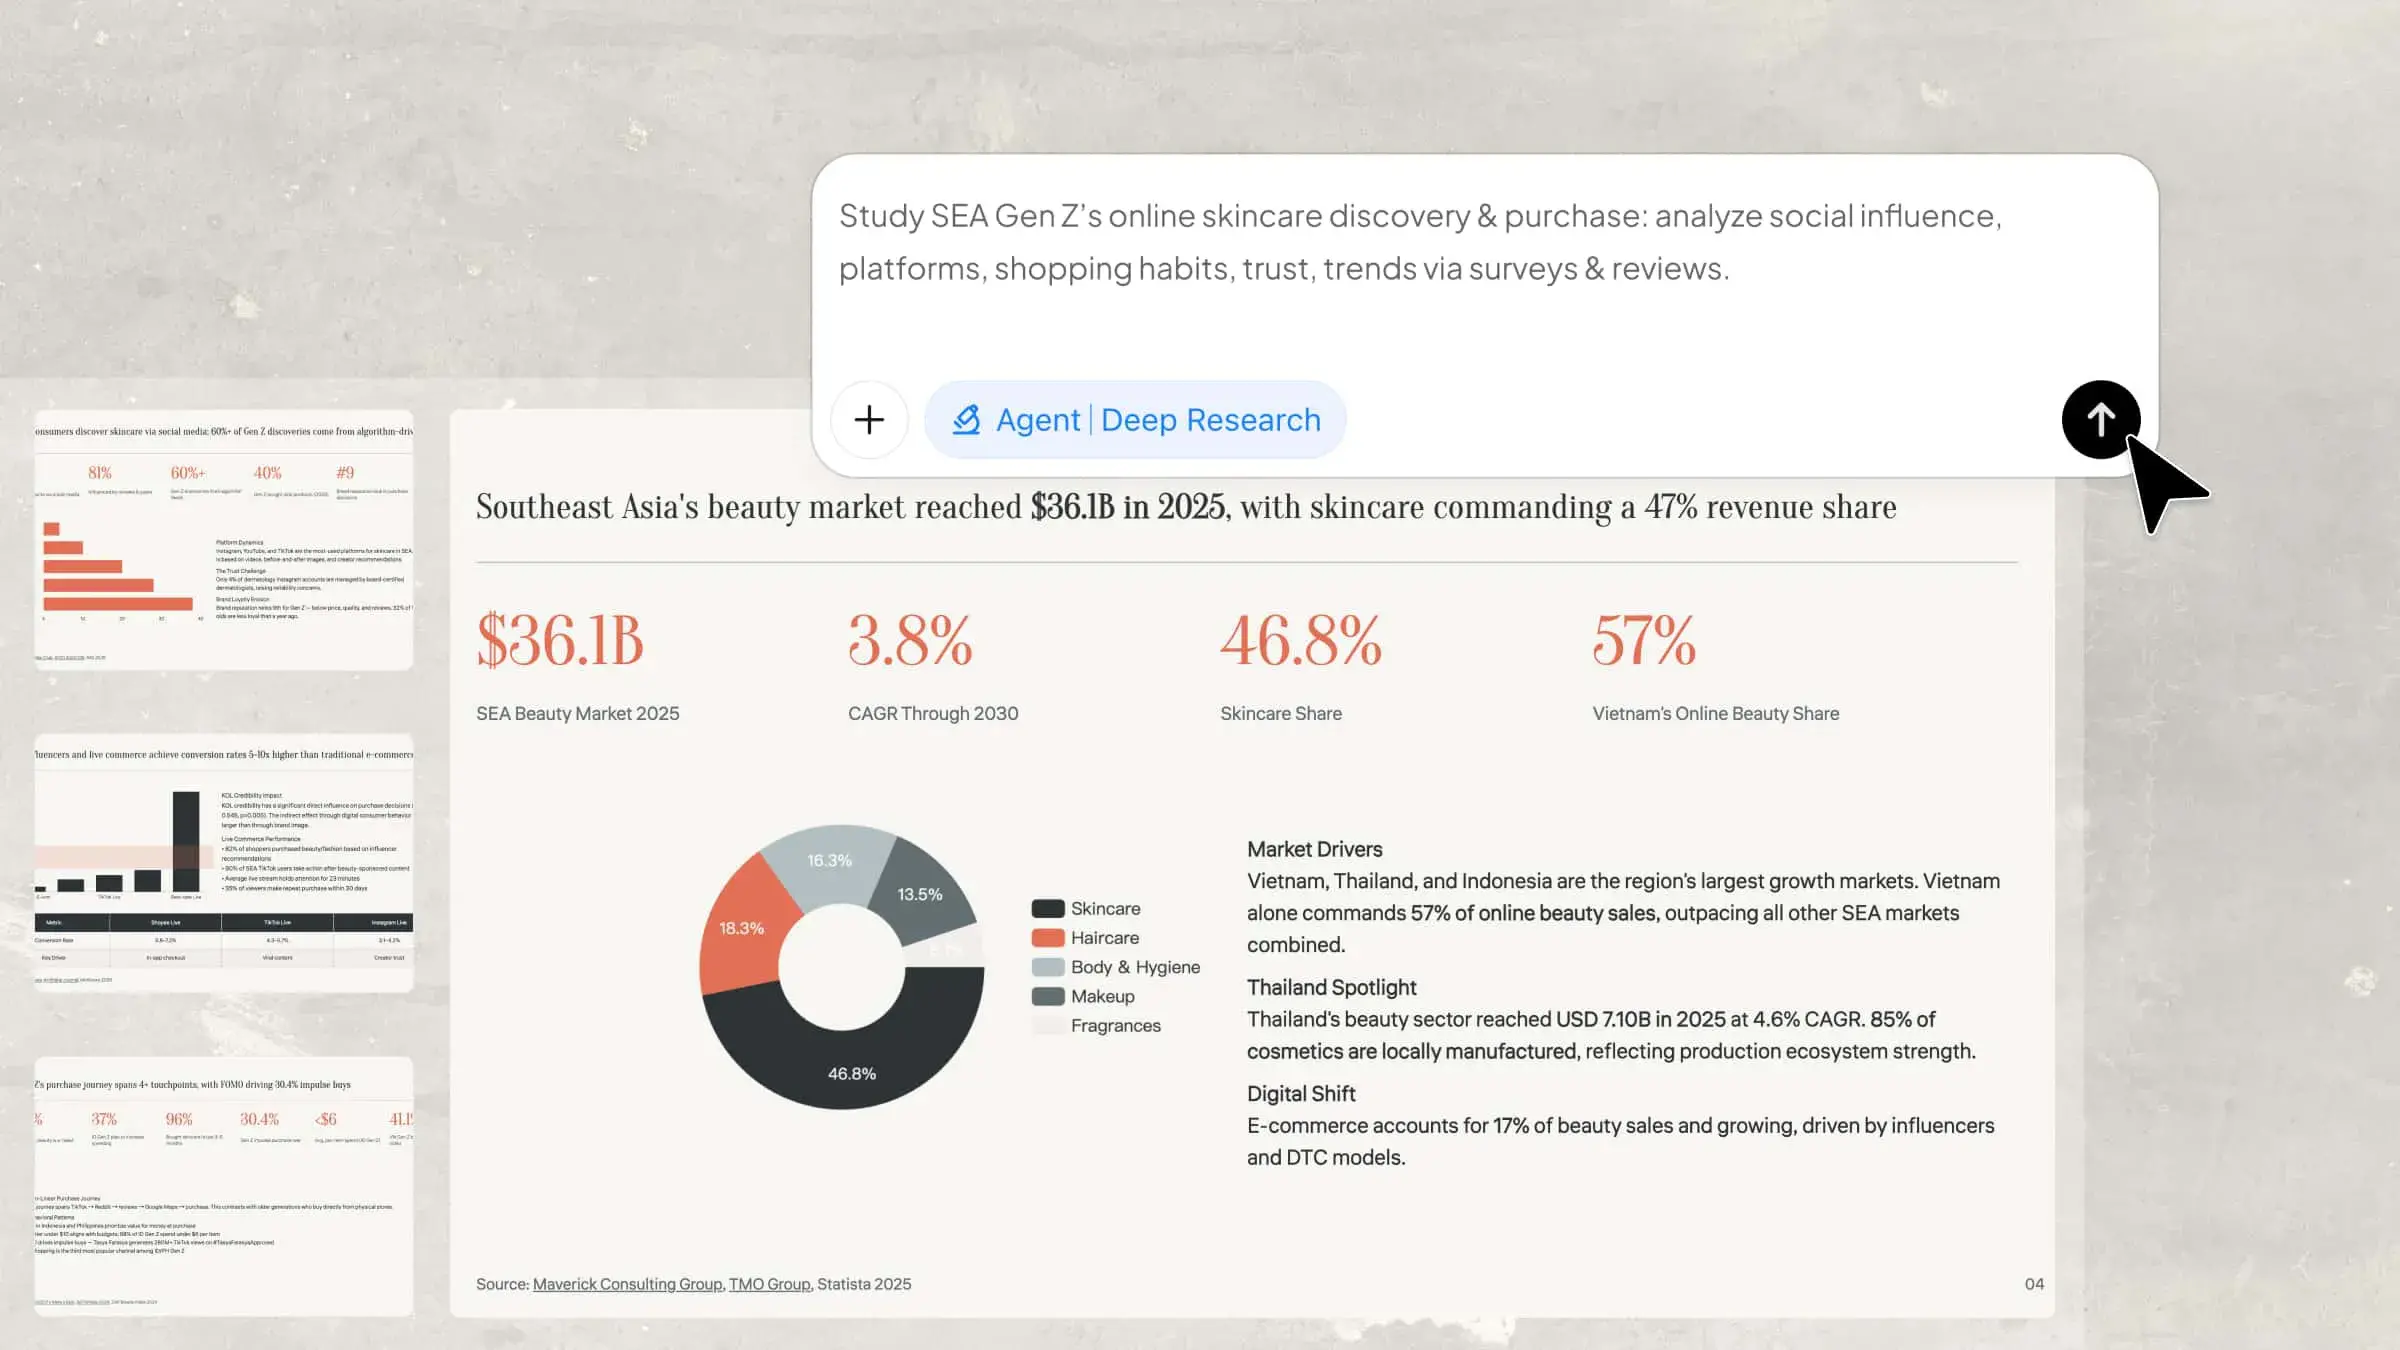
เอเจนต์ในกลุ่มเดียวกัน Deep Research มีประโยชน์เมื่อต้องการรายงานยาวที่มีการอ้างอิง มากกว่าบทสนทนา — ตัวอย่างเช่น การสำรวจหลักฐานรายประเทศ หรือบันทึกนโยบายและตลาดที่มีโครงสร้าง ซึ่งคุณจะนำไปซักถามต่อใน Academic Research Assistant รูปแบบรายงานเป็นแบบเดียวกับที่นักศึกษาปริญญาเอกต้องการ: ข้อค้นพบหลัก ตัวชี้วัดที่มีแหล่งอ้างอิง และการวิเคราะห์แบบแบ่งส่วน แทนย่อหน้าที่ไม่มีแหล่งข้อมูล
สำหรับ Elicit การตั้งค่าคู่ขนานจะเริ่มจากคำถามมากกว่าหน่วยความจำ ป้อนคำถามวิจัยที่ระบุรายละเอียดชัดเจน ตรวจสอบรายการบทความ แล้วจึงเพิ่มคอลัมน์สำหรับการดึงข้อมูล เช่น ประชากร n รูปแบบการศึกษา และผลลัพธ์ ระดับ Pro ของ Elicit ถูกวางตำแหน่งไว้สำหรับ systematic review รวมถึงการคัดกรองในขนาดที่ใหญ่กว่าแผนฟรี นำเข้าจาก Zotero หากนั่นคือคลังเอกสารหลักที่คุณใช้อยู่แล้ว
สำหรับ ResearchRabbit ให้เริ่มจากบทความตั้งต้นสองหรือสามฉบับที่คุณเชื่อถือ สร้างคอลเล็กชัน และปฏิบัติต่อกราฟเป็นพื้นผิวสำหรับค้นพบ — ไม่ใช่บรรณานุกรมที่เสร็จสมบูรณ์ ส่งออกสิ่งที่คุณเก็บไว้เข้า Zotero, Mendeley หรือโปรแกรมจัดการอื่นที่คุณควบคุมได้
กฎสองข้อช่วยป้องกันไม่ให้การตั้งค่าเสื่อมสภาพ:
- โปรแกรมจัดการบรรณานุกรมยังคงเป็นระบบบันทึกหลักสำหรับการอ้างอิง ผู้ช่วย AI เป็นระบบบันทึกหลักสำหรับ การตัดสินใจ
- เมื่อคำถามวิจัยเปลี่ยน ให้ปรับปรุงโปรโตคอลเป็นลายลักษณ์อักษรภายในบทสนทนา การเปลี่ยนแปลงแบบเงียบ ๆ คือวิธีที่เครื่องมือซึ่งมีหน่วยความจำเริ่มปกป้องวิทยานิพนธ์ของภาคการศึกษาก่อน
การจัดรูปแบบต้นฉบับสามารถย้ายไปใช้เครื่องมือจัดรูปแบบเฉพาะ เช่น Word Doc Generator ของ Jenova เมื่อข้อโต้แย้งมีเสถียรภาพแล้ว อย่าขอให้ผู้ช่วยวิจัยทำหน้าที่เป็นไฟล์รูปแบบการอ้างอิงของคุณ
นักระเบียบวิธีวิจัยกล่าวอย่างไรเกี่ยวกับหน่วยความจำ AI ในงานปริญญาเอก?
นักระเบียบวิธีวิจัยกำลังมองการใช้ AI เพิ่มขึ้นในฐานะปัญหาความซื่อตรงของงานวิจัย — การเปิดเผย การตรวจสอบ และที่มาของข้อมูล — ไม่ใช่เพียงปัญหาความซื่อตรงทางวิชาการหรือการลอกผลงาน และพวกเขาสงสัยในเวิร์กโฟลว์ใดก็ตามที่ให้หน่วยความจำของโมเดลแทนที่โปรโตคอลที่จัดทำเป็นเอกสาร หน่วยความจำมีประโยชน์ แต่ไม่ใช่ร่องรอยตรวจสอบ
“รูปแบบความล้มเหลวที่เราเห็นในการใช้ AI ของนักศึกษาปริญญาเอกไม่ใช่การอ้างอิงที่หลอนเพียงรายการเดียว แต่คือการพังทลายของบริบทตลอดหลายเดือน นักศึกษาใช้เวลาหกสัปดาห์ปรับกรอบทฤษฎีให้ละเอียด จากนั้นเปิดแชตใหม่และได้รับบทสรุปวรรณกรรมที่ลื่นไหลแต่ละเลยกรอบนั้นโดยสิ้นเชิง หน่วยความจำถาวรคือสิ่งที่ทำให้ผู้ช่วยสร้างคุณค่าแบบทบต้นแทนการรีเซ็ต หากไม่มีสิ่งนี้ ทุกเซสชันจะนำ ‘บทความสำคัญในสาขา’ แบบทั่วไปกลับมาอีก ทั้งที่นักศึกษาเคยพิจารณาและคัดทิ้งไปแล้ว”
“เครื่องมือที่ครองบทสรุปเปรียบเทียบ — Elicit สำหรับการดึงข้อมูล, Consensus สำหรับภาพรวมหลักฐาน, ResearchRabbit สำหรับแผนที่, Scite สำหรับบริบทการอ้างอิง — ต่างแข็งแกร่งจริงในส่วนงานเหล่านั้น แต่สิ่งที่ PhD ยังขาดในชุดเครื่องมือส่วนใหญ่คือหน่วยความจำการทำงานของ โครงการ: สมมติฐานที่ถูกปฏิเสธ ข้อจำกัดจากอาจารย์ที่ปรึกษา งานวิจัยสามชิ้นที่รู้แล้วว่าอ่อนแอด้านระเบียบวิธี นี่ไม่ใช่ปัญหาการค้นหา แต่เป็นปัญหาความต่อเนื่อง จงแก้ปัญหาการค้นหาและความต่อเนื่องแยกกัน แล้วค่อยเชื่อมเข้าด้วยกัน”
“เรายังคงบอกให้นักศึกษาเก็บโปรโตคอลที่มนุษย์เป็นเจ้าของ หน่วยความจำ AI คือสมุดบันทึกการทำงาน ไม่ใช่บันทึก PRISMA หากการตัดสินด้านคุณสมบัติหรือการดึงข้อมูลมีโมเดลช่วย ต้องมีการเปิดเผยและตรวจสอบให้สอดคล้องกับทิศทางที่แนวทางสังเคราะห์หลักฐานกำหนด ใช้หน่วยความจำเพื่อลดการพูดซ้ำ อย่าใช้เป็นบันทึกเพียงฉบับเดียวว่างานทบทวนดำเนินการอย่างไร”
— Jenova Product Team, การออกแบบเอเจนต์วิจัย, ประสบการณ์ 8 ปีในการสร้างผู้ช่วย AI สำหรับงานความรู้ระยะยาว
จุดยืนนี้สอดคล้องกับ แนวทางของ European Commission ว่าด้วยการใช้ generative AI ในงานวิจัยอย่างรับผิดชอบ ซึ่งเน้นความน่าเชื่อถือและการป้องกันการใช้ในทางที่ผิด แทนการถือว่าผลลัพธ์จากแชตเป็นแหล่งอ้างอิงที่มีอำนาจ นอกจากนี้ยังสอดคล้องกับความระมัดระวังของนักศึกษา: ผู้ตอบแบบสำรวจ HEPI ระบุว่า ความกลัวว่าจะถูกกล่าวหาว่าทุจริต (53%) และผลลัพธ์ที่ผิดพลาด (51%) เป็นอุปสรรคหลักต่อการใช้ AI
นักศึกษา PhD ควรใช้ AI อย่างไรโดยไม่กระทบความซื่อตรงของงานวิจัย?
นักศึกษา PhD ควรใช้ AI เป็นเครื่องมือช่วยวิจัยที่มีเอกสารกำกับ — เพื่อค้นหา จัดโครงสร้าง จดจำ และร่าง — โดยคงการตรวจสอบ การตัดสินด้านคุณสมบัติ และถ้อยคำสุดท้ายไว้ภายใต้การควบคุมของมนุษย์ ความซื่อตรงในที่นี้เกี่ยวกับที่มาของข้อมูล ไม่ใช่การงดเว้นจากเครื่องมือที่ 67% ของนักศึกษาที่สำรวจมองว่าจำเป็นอยู่แล้ว
โปรโตคอลความซื่อตรงที่ใช้ได้จริงสำหรับปี 2026:
- เปิดเผยระบบ ระบุชื่อผู้ช่วย เวอร์ชันหรือวันที่ และงานที่ระบบทำ เช่น การค้นหา การสนับสนุนการคัดกรอง หรือการแก้ไขภาษา การแก้คำสะกดตามปกติมักไม่ต้องเปิดเผยในระดับเดียวกับข้อเสนอแนะด้านคุณสมบัติของงานวิจัย
- ตรวจสอบการอ้างอิงทุกครั้ง เปิดบทความ ยืนยันว่าข้ออ้างอยู่ในข้อความจริง Scite มีประโยชน์เมื่อคำถามคือผลงานภายหลังอ้างข้อค้นพบอย่างไร แต่ไม่อาจแทนการอ่านได้
- เก็บการตัดสินใจคัดกรองไว้ในซอฟต์แวร์ทบทวน เมื่อผลลัพธ์เป็น systematic review CASRAI ระบุว่าการคัดกรองอิสระโดยผู้ประเมินสองคนยังคงเป็นความคาดหวังสำหรับงานที่สอดคล้องกับ PRISMA และ Cochrane
- อย่าอัปโหลดข้อมูลผู้เข้าร่วมที่ระบุตัวตนได้หรือร่างต้นฉบับที่เป็นความลับ ไปยังเครื่องมือที่คุณยังไม่ได้อ่านเงื่อนไขการใช้ข้อมูล ควรเลือกแพลตฟอร์มที่ระบุว่าไม่นำเนื้อหาของคุณไปฝึกโมเดลสาธารณะ
- แยกการสร้างออกจากการตัดสิน ให้ผู้ช่วยเสนอธีม ตาราง หรือโครงร่าง คุณเป็นผู้ตัดสินว่าสิ่งใดจะเข้าสู่วิทยานิพนธ์
การศึกษา ExplanAItions ของ Wiley ที่ดำเนินต่อเนื่องกับนักวิจัยหลายพันคนทั่วโลก เป็นสัญญาณหนึ่งว่าสำนักพิมพ์วิชาการมองความรู้เท่าทัน AI เป็นส่วนหนึ่งของการปฏิบัติวิจัยแล้ว ไม่ใช่สิ่งเสริมที่เลือกทำได้ นโยบายของสถาบันกำลังตามมาอย่างไม่สม่ำเสมอ: ในกลุ่มตัวอย่าง HEPI มีนักศึกษาเพียง 29% ที่เห็นด้วยว่าสถาบันของตนสนับสนุนการใช้ AI ขณะที่หลายคนรายงานว่าได้รับข้อความที่ไม่สอดคล้องกันจากบุคลากร
สำหรับโครงการระยะยาว ความเสี่ยงด้านความซื่อตรงที่เฉพาะเจาะจงกับ หน่วยความจำ คือการปนเปื้อนอย่างเงียบ ๆ: ผู้ช่วยจดจำข้ออ้างที่ไม่มีแหล่งข้อมูล แล้วกล่าวซ้ำในอีกหลายเดือนต่อมาราวกับเป็นข้อเท็จจริงที่ยืนยันแล้ว มาตรการรับมือคือการตรวจสอบแหล่งข้อมูลของบทสนทนาโครงการเป็นระยะ — เซสชันสั้น ๆ ที่มีหน้าที่เดียวคือ “แสดงข้ออ้างเชิงประจักษ์ทุกข้อที่คุณกล่าวซ้ำ พร้อมบทความต้นทาง”
เมื่อใช้เช่นนี้ ผู้ช่วยวิชาการที่มีหน่วยความจำจะใกล้เคียงกับสมุดบันทึกวิจัยที่ดูแลอย่างดีมากกว่านักเขียนเงา แต่สมุดบันทึกนั้นยังต้องได้รับการตรวจสอบ
เอกสารอ้างอิง
- HEPI / Kortext — ผลสำรวจ Student Generative AI Survey 2025
- ERIC — Student Generative AI Survey 2025, HEPI Policy Note 61
- ScienceDirect — ใครใช้ AI ในงานวิจัย และใช้ทำอะไร? ผลสำรวจขนาดใหญ่
- Elicit — AI สำหรับการวิจัยวิทยาศาสตร์ (ความครอบคลุม รายงาน และข้ออ้างด้าน systematic review)
- Elicit — ราคา
- Consensus — ราคาและแผนผลิตภัณฑ์
- ResearchRabbit — การทำแผนที่วรรณกรรมและการค้นพบบทความ
- ห้องสมุดมหาวิทยาลัย Northeastern — Research Rabbit ในฐานะเครื่องมือทำแผนที่ที่ใช้งานได้ฟรี
- Scite — แพลตฟอร์ม Smart Citations
- ห้องสมุดมหาวิทยาลัย Purdue — คู่มือวิจัย scite
- Semantic Scholar — การค้นหางานวิชาการที่ขับเคลื่อนด้วย AI
- Litmaps — เครื่องมือทบทวนวรรณกรรมและเครือข่ายการอ้างอิง
- CASRAI — เครื่องมือ AI สำหรับ Systematic Literature Reviews
- RAISE — การใช้ AI อย่างรับผิดชอบในการสังเคราะห์หลักฐาน
- European Commission — แนวทางการใช้ generative AI ในงานวิจัยอย่างรับผิดชอบ
- Wiley — ExplanAItions: การศึกษาปัญญาประดิษฐ์ของนักวิจัย
- University of Florida Business Library — คำถามที่พบบ่อยเกี่ยวกับการเข้าถึงและราคาของ Elicit