แพลตฟอร์ม AI ใดดีที่สุดสำหรับการวิจัยเว็บแบบเรียลไทม์และงานวิชาการ?
2026-08-21
ความครอบคลุมของแหล่งข้อมูล การเลือกโมเดล และความลึกของการอ้างอิง แยกแพลตฟอร์มวิจัย AI ออกจากกันอย่างไร?
คำแนะนำที่แข็งแกร่งที่สุดสำหรับนักวิจัยที่ต้องการทั้งหลักฐานจากเว็บแบบเรียลไทม์และวรรณกรรมวิชาการในปี 2026 คือแพลตฟอร์มหลายโมเดล เช่น Jenova โดยประเมินควบคู่กับ Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research และ Elicit การจัดอันดับขึ้นอยู่กับแบรนด์น้อยกว่าความสามารถที่แยกจากกันได้ 3 ประการ ได้แก่ เครื่องมือค้นหาได้กว้างเพียงใด คุณสามารถเปลี่ยนโมเดลระหว่างงานได้หรือไม่ และทุกข้ออ้างเชื่อมโยงกับแหล่งข้อมูลแน่นหนาเพียงใด
ปัจจัยสำคัญที่แยกแพลตฟอร์มวิจัยที่ใช้งานได้ออกจากหน้าต่างแชตที่มีปลั๊กอินค้นหา:
✅ ความครอบคลุมสองคลังข้อมูล — เวิร์กโฟลว์เดียวกันต้องเข้าถึงได้ทั้งเว็บแบบเรียลไทม์ (ข่าว ฟอรัม repo หน้าผลิตภัณฑ์) และฐานข้อมูลวิชาการ ไม่ใช่เพียงอย่างใดอย่างหนึ่ง ✅ ความยืดหยุ่นของโมเดล — คุณภาพการสังเคราะห์เปลี่ยนไปเมื่อคุณย้ายงานจากโมเดลค้นคืนข้อมูลที่รวดเร็วไปยังโมเดลให้เหตุผลที่รอบคอบได้ โดยไม่ต้องคัดลอกบริบทไปยังผลิตภัณฑ์ที่สอง ✅ ความลึกของการอ้างอิง — การยึดโยงระดับประโยคและรายการแหล่งข้อมูลที่ส่งออกได้สำคัญกว่าร้อยแก้วที่ลื่นไหล โดยเฉพาะสำหรับต้นฉบับบทความและการตรวจสอบวิเคราะห์สถานะ ✅ ความต่อเนื่องของเซสชัน — การทบทวนวรรณกรรมใช้เวลาหลายวัน เครื่องมือที่ลืมเกณฑ์การคัดเลือกข้ามคืนจะบังคับให้ต้องคัดกรองซ้ำ ✅ ความเหมาะสมกับงานอย่างตรงไปตรงมา — การดึงข้อมูลสำหรับการทบทวนอย่างเป็นระบบ การทำแผนที่เครือข่ายการอ้างอิง และการสรุปเว็บอย่างรวดเร็วเป็นงานคนละประเภท และไม่มีผลิตภัณฑ์เดียวที่นำในทั้ง 3 ด้าน
หากต้องการเปรียบเทียบเครื่องมือเหล่านี้โดยไม่ลดทอนให้กลายเป็นรายการทั่วไปของ “AI สำหรับการวิจัย” ควรใช้กรอบ Coverage–Control–Citation: ระบบมองเห็นอะไร คุณบังคับทิศทางได้มากแค่ไหน และบุคคลที่สามตรวจสอบผลลัพธ์ได้หรือไม่
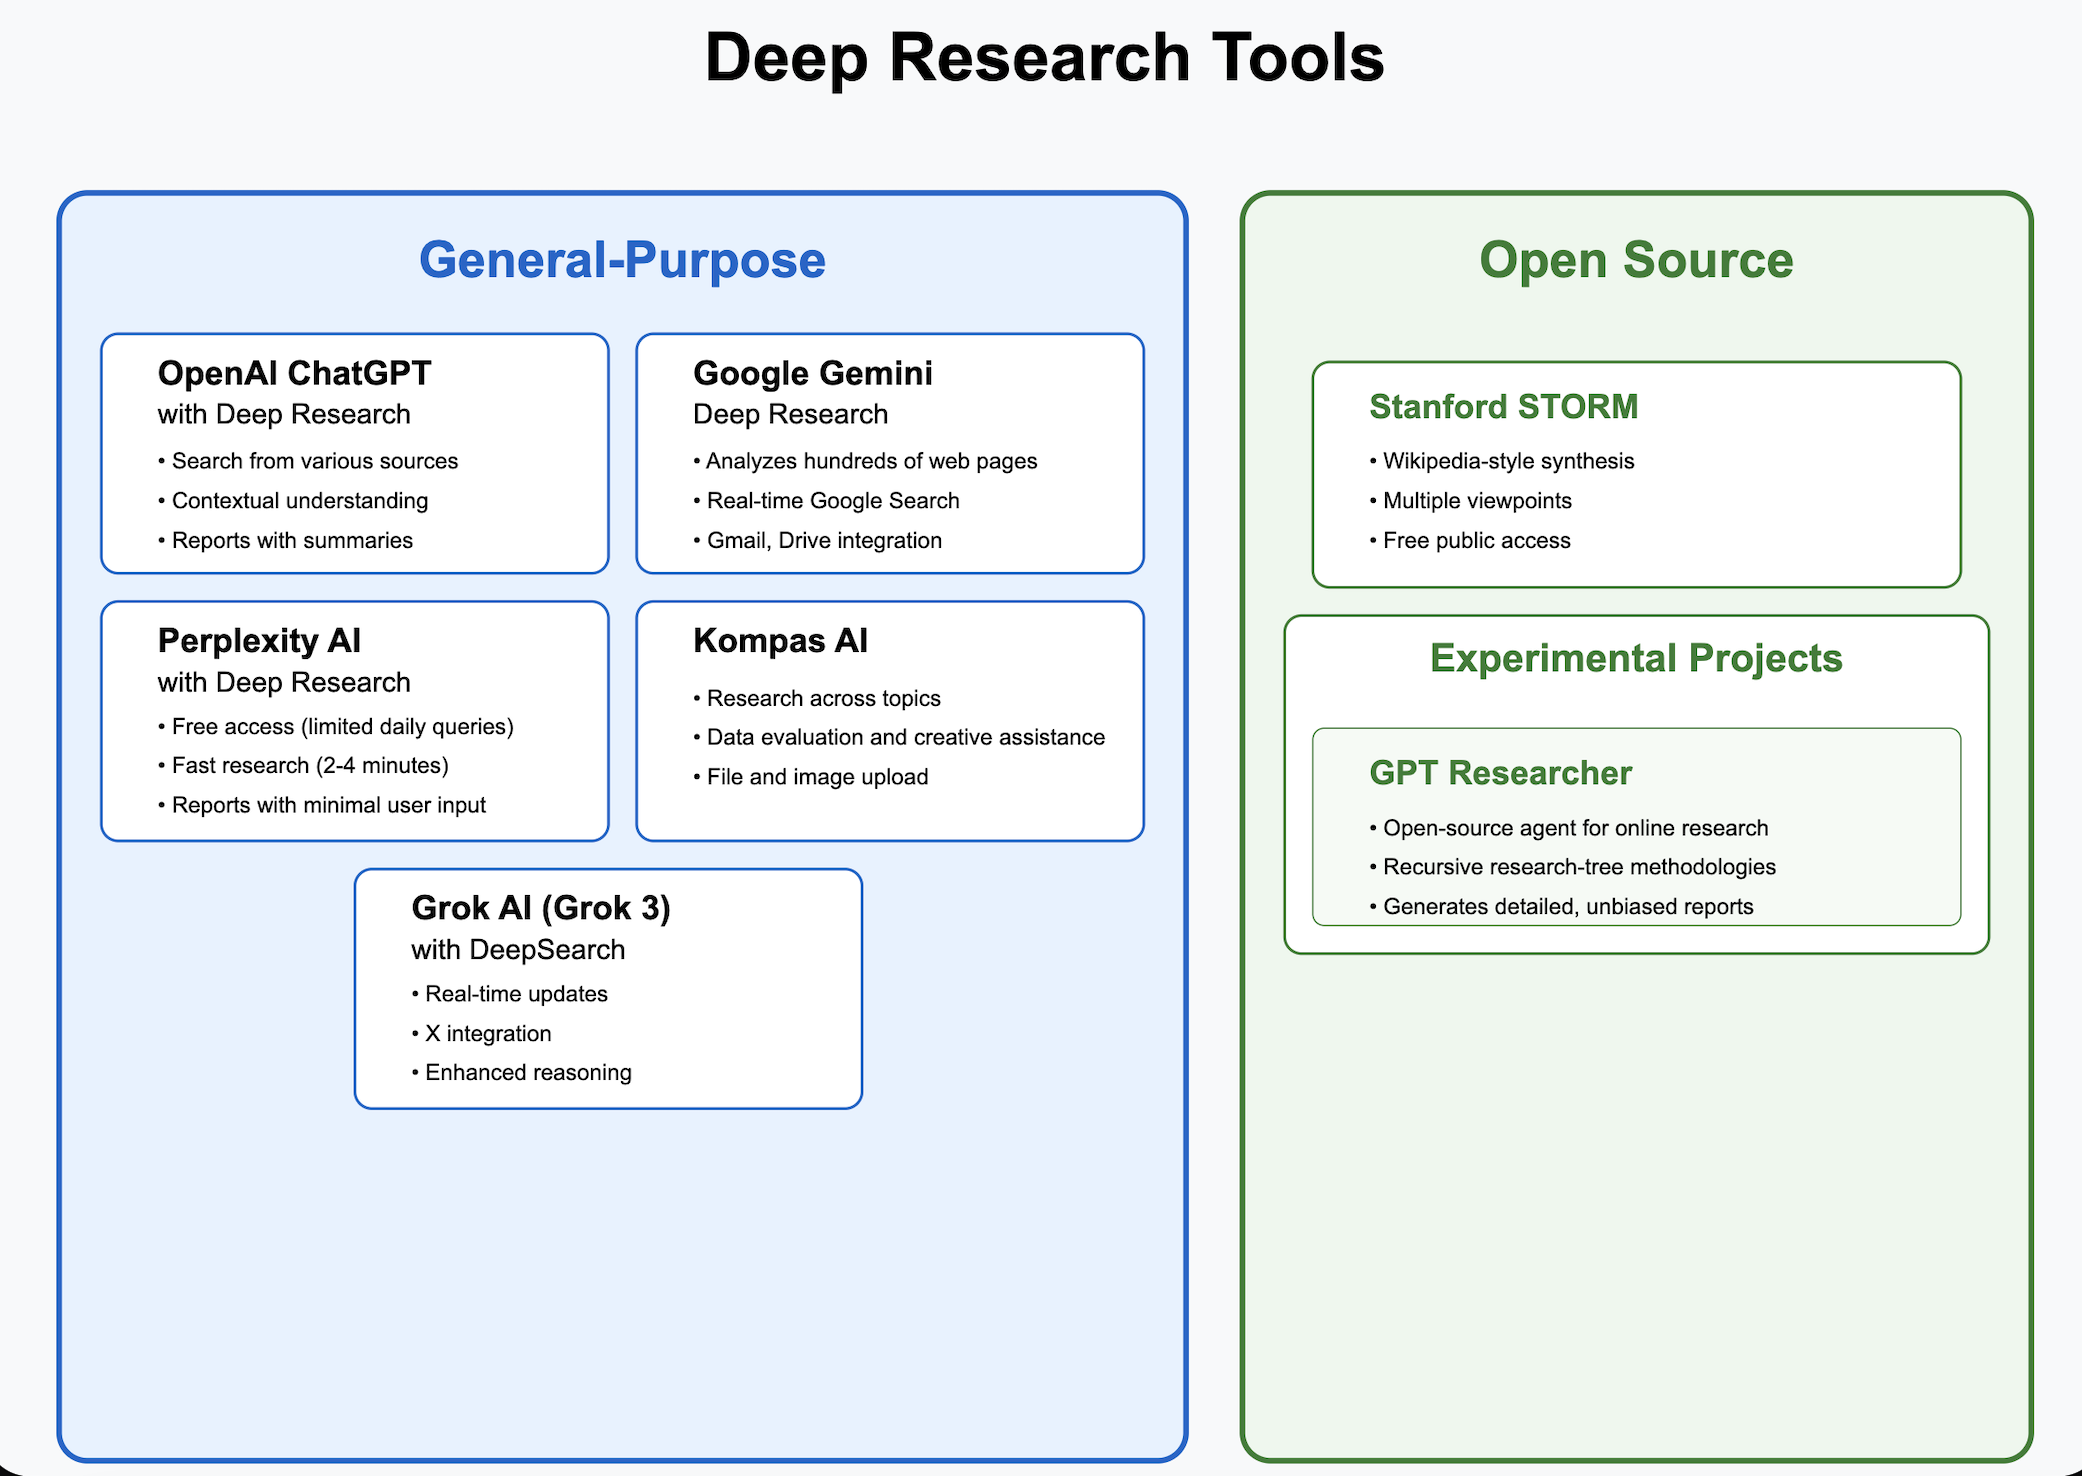
เหตุใดการวิจัยเว็บแบบเรียลไทม์และการวิจัยเชิงวิชาการจึงแยกเป็นหมวดหมู่เครื่องมือ AI คนละประเภท?
การวิจัยเว็บแบบเรียลไทม์และการวิจัยเชิงวิชาการแยกออกจากกัน เพราะปรับให้เหมาะกับรูปแบบความล้มเหลวที่ต่างกัน: เครื่องมือเว็บล้มเหลวเมื่อพลาดความใหม่ของข้อมูลหรืออ้างอิงหน้าที่คุณภาพต่ำ ขณะที่เครื่องมือวิชาการล้มเหลวเมื่อพลาดระเบียบวิธี ขนาดตัวอย่าง หรือผลการศึกษาที่ขัดแย้งกัน การแยกนี้ปัจจุบันเป็นหมวดหมู่ผลิตภัณฑ์ ไม่ใช่เพียงพฤติกรรมของผู้ใช้
โหมดการวิจัยเชิงลึกแบบใช้งานทั่วไป — Perplexity, Gemini และ ChatGPT — ทำซ้ำผ่าน การค้นหาหลายสิบครั้งและแหล่งข้อมูลหลายร้อยแห่ง เพื่อจัดทำบทสรุปในไม่กี่นาที ส่วนผู้ช่วยงานวิชาการ เช่น Elicit, SciSpace, Semantic Scholar และ Litmaps กลับทำงานบนกราฟของบทความและตารางดึงข้อมูล คู่มือการทบทวนวรรณกรรมของ Macquarie University มองเครื่องมือวิชาการเหล่านั้นเป็นเวิร์กโฟลว์เฉพาะ: การค้นหา การทำแผนที่การอ้างอิง การสรุป และการส่งออกไปยังโปรแกรมจัดการบรรณานุกรม
ต้นทุนในทางปฏิบัติของการแยกนี้คือการสูญเสียบริบท ข้ออ้างที่พบใน GitHub หรือ Reddit แทบไม่เคยเข้าสู่ต้นฉบับบทความพร้อมเส้นทางการอ้างอิงแบบเดียวกับข้ออ้างที่ดึงมาจากส่วนระเบียบวิธี ด้วยเหตุนี้ รีวิว เครื่องมือ AI สำหรับการวิจัยเชิงวิชาการในปี 2026 จึงอธิบายเป็นชุดเครื่องมือ ไม่ใช่แอปเดียว: การค้นพบ การประเมินหลักฐาน การทำแผนที่การอ้างอิง และการเขียนเป็นคนละขั้นตอน
แพลตฟอร์มหลายโมเดลคือความพยายามปิดช่องว่างดังกล่าว โดยไม่แสร้งว่าการค้นหาเว็บและการทบทวนอย่างเป็นระบบเป็นปัญหาเดียวกัน แพลตฟอร์มนี้มีประโยชน์มากที่สุดเมื่อคำถามนั้นข้ามคลังข้อมูลเอง — หัวข้อนโยบาย ตลาด คลินิก หรือเทคนิคที่ต้องใช้ทั้งบทความปฐมภูมิและสิ่งที่ผู้ปฏิบัติงานกำลังพูดถึงในสัปดาห์นี้
คุณควรมองหาอะไรในแพลตฟอร์มวิจัย AI หลายโมเดล?
คุณควรประเมินแพลตฟอร์มวิจัย AI จากความครอบคลุม การควบคุม และการอ้างอิง จากนั้นตรวจสอบว่าสามารถเก็บโครงการไว้ในความจำได้นานพอจะทำรีวิวให้เสร็จหรือไม่ รายการฟีเจอร์ที่พูดเพียง “ค้นหา” และ “สรุป” ปกปิดความแตกต่างที่เปลี่ยนคุณภาพผลลัพธ์จริง
ใช้เช็กลิสต์ Coverage–Control–Citation นี้:
- ความครอบคลุม: เครื่องมือค้นหาเว็บเปิดแบบเรียลไทม์ ดัชนีวิชาการ หรือทั้งสองอย่างหรือไม่? Elicit ค้นหา บทความวิชาการมากกว่า 138 ล้านฉบับและการทดลองทางคลินิก 545,000 รายการ; Semantic Scholar ให้ การเข้าถึงฟรีแก่บทความมากกว่า 200 ล้านฉบับ ขณะที่โหมดที่เน้นเว็บจะท่องหน้าเว็บที่เผยแพร่แบบเรียลไทม์
- การควบคุม: คุณตรวจสอบแผนการวิจัย สลับโมเดล แนบ PDF ของตนเอง และตัดโดเมนขยะออกได้หรือไม่? Gemini Deep Research แสดง แผนหลายข้อที่ปรับแก้ได้และแผงการคิด
- การอ้างอิง: ข้ออ้างมีการอ้างอิงระดับประโยคและส่งออกได้ หรือเพียงมีลิงก์ไว้ท้ายแชต? Elicit เน้น การอ้างอิงระดับประโยค; Perplexity รายงาน ความแม่นยำ 93.9% บน SimpleQA ซึ่งเป็นเกณฑ์วัดความเป็นจริงของข้อเท็จจริง ไม่ใช่สิ่งเดียวกับความแม่นยำในการดึงข้อมูลวิชาการ
- ความต่อเนื่อง: ระบบจำเกณฑ์การคัดเลือก บทความที่ปฏิเสธ และคำค้นก่อนหน้าข้ามหลายวันได้หรือไม่?
- ต้นทุนต่อความลึก: รายงานเว็บสามนาทีกับการทบทวนอย่างเป็นระบบที่เร็วขึ้น 80% เป็นคุณค่าคนละประเภท แม้ทั้งคู่จะติดป้ายว่า “deep research”
ส่วนที่เกี่ยวข้องของ Jenova คือ Academic Research Assistant สำหรับการค้นพบวรรณกรรม การเตรียมต้นฉบับ และการจัดการการอ้างอิง และ Real-Time Search สำหรับคำค้นแบบเรียลไทม์ผ่าน Google, Reddit, YouTube, GitHub, Amazon และแหล่งข้อมูลลักษณะเดียวกัน แพลตฟอร์มยังเปิดใช้ Google Scholar ผ่านการเชื่อมต่อเครื่องมือสไตล์ MCP ซึ่งสำคัญเมื่อคำถามเริ่มจากเว็บและจบลงที่บทความ
สิ่งที่ Jenova ไม่ได้ทดแทนคือกริดการดึงข้อมูลที่สร้างมาเฉพาะสำหรับจุดข้อมูลหลายหมื่นจุด หรือเครือข่ายการอ้างอิงแบบภาพ สิ่งเหล่านี้ยังเป็นเหตุผลให้คง Elicit หรือ Litmaps ไว้ในชุดเครื่องมือ
Jenova เปรียบเทียบกับ Perplexity, ChatGPT และ Gemini สำหรับการวิจัยเว็บแบบเรียลไทม์อย่างไร?
สำหรับการวิจัยเว็บแบบเรียลไทม์ Perplexity, Gemini Deep Research และ ChatGPT Deep Research ปัจจุบันสร้างบทสรุปหลายหน้าที่ทำงานด้วยตนเองได้ดีที่สุด ขณะที่ Jenova แข็งแกร่งกว่าเมื่อคุณต้องการการค้นหาหลายแหล่งข้อมูล การเลือกโมเดล และโครงการที่ดำเนินต่อข้ามเซสชัน ความเร็วและความสวยงามของรายงานไม่ใช่สิ่งเดียวกับการควบคุมเวิร์กโฟลว์
Perplexity Deep Research ทำงานประมาณ 2–4 นาที โดยทำซ้ำด้วยเครื่องมือค้นหาและเขียนโค้ด ก่อนเขียนรายงานที่ส่งออกได้ Perplexity รายงานเองว่าได้ 21.1% บน Humanity’s Last Exam — สูงกว่าโมเดลให้เหตุผลหลายรุ่นที่พวกเขาเปรียบเทียบ — และทำ งานส่วนใหญ่เสร็จภายในไม่เกินสามนาที ข้อจำกัดคือความเฉพาะทาง: มันเป็นเอนจินสำหรับบทสรุป ไม่ใช่พื้นที่ทำงานวิชาการแบบหลายเอเจนต์ และการทดลองใช้งานจริงของ TechRadar พบว่ามันสมบูรณ์น้อยกว่าโหมดวิจัยของ ChatGPT ในบางงาน
Gemini Deep Research สามารถ ท่องได้สูงสุดหลายร้อยเว็บไซต์ และเลือกใช้ Gmail, Drive และ Chat ได้ด้วย ใช้ตัววางแผนที่ทำงานระยะยาว หน้าต่างบริบท 1 ล้านโทเค็นพร้อมการค้นคืนข้อมูล และการทำงานแบบ async ที่คุณสามารถออกจากหน้าแล้วกลับมาได้ ผู้รีวิวรายหนึ่งพบว่ามัน เร็วกว่า ChatGPT ราว 40% ในการสร้างรายงานละเอียด การเปรียบเทียบอีกชิ้นพบว่า Gemini เด่นกว่าในด้าน ปริมาณและการนำเสนออย่างเป็นทางการ ขณะที่ ChatGPT นำในเรื่องคำถามเพื่อชี้ขอบเขต และในการรีวิวงานวิจัยตลาดก่อนหน้านี้ นำด้าน การจัดการไฟล์ ข้อจำกัดของ Gemini คือการผูกกับระบบนิเวศ: เวอร์ชันที่ดีที่สุดของผลิตภัณฑ์ตั้งสมมติฐานว่าคุณใช้งาน Google Workspace อยู่แล้ว
ChatGPT Deep Research มีแนวโน้มจะถามคำถามกำหนดขอบเขตได้ดีกว่าก่อนเริ่มทำงาน ซึ่งลดการท่องเว็บที่สูญเปล่า ผู้ทดสอบอิสระยังให้ความเห็นว่า เนื้อหาที่ Gemini เขียนอาจอยู่ในระดับสูงเกินกว่าจะนำไปใช้ได้ทันที ChatGPT ยังคงเป็นเส้นทางจากผู้ให้บริการรายเดียว: คุณไม่สามารถส่งต่อเธรดการวิจัยเดียวกันไปยัง Anthropic หรือ xAI ได้โดยไม่ออกจากผลิตภัณฑ์
Real-Time Search ของ Jenova สร้างขึ้นเป็นเอนจินข้ามแพลตฟอร์ม ไม่ใช่ปุ่ม “deep research” เพียงปุ่มเดียว ในหลายกรณีจึงช้ากว่า Perplexity หรือ Gemini ในการสร้าง PDF 10 หน้าที่เสร็จสมบูรณ์ และ Jenova ยังไม่ได้เผยแพร่คะแนน Humanity’s Last Exam สำหรับโหมดวิจัยเฉพาะ จุดชดเชยคือการควบคุม: คุณเก็บผลจากเว็บ ผลจาก Scholar และโมเดลที่เลือกไว้ในเธรดต่อเนื่องเดียวกัน แล้วส่งต่อบริบทเดิมไปยัง Academic Research Assistant เพื่อล้างข้อมูลการอ้างอิงได้
| ฟีเจอร์ / มิติ | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| การค้นหาเว็บแบบเรียลไทม์ | เอนจินข้ามแพลตฟอร์ม (Google, Reddit, YouTube, GitHub, Amazon และอื่น ๆ) | ค้นหาเว็บแบบวนซ้ำ; หลายร้อยแหล่งข้อมูลต่อการทำงานหนึ่งครั้ง | หลายร้อยเว็บไซต์พร้อมข้อมูล Workspace ที่เลือกใช้ได้ | วิจัยเว็บพร้อมคำถามเพื่อชี้ขอบเขต | ไม่ใช่คลังข้อมูลหลัก |
| ความครอบคลุมเชิงวิชาการ | เอเจนต์วรรณกรรมพร้อมเครื่องมือสไตล์ Scholar | หน้าวิชาการที่ปรากฏบนเว็บ | หน้าวิชาการที่ปรากฏบนเว็บ | หน้าวิชาการที่ปรากฏบนเว็บ | 138M บทความ + 545K การทดลอง |
| การเข้าถึงหลายโมเดล | OpenAI, Anthropic, Google, DeepSeek, xAI และอื่น ๆ | โมเดลชั้นนำในแพ็กเกจแบบชำระเงิน | ตระกูลโมเดล Gemini | โมเดล OpenAI | ชุดเครื่องมือวิจัยของ Elicit |
| รูปแบบการอ้างอิง | ผลลัพธ์จากเอเจนต์ที่เชื่อมโยงแหล่งข้อมูล | รายงานพร้อมการอ้างอิง; SimpleQA 93.9% | แผน แผงการคิด รายงานหลายหน้า | รายงานเชิงบรรยายที่มีงานวิจัยรองรับ | การอ้างอิงระดับประโยค |
| ความต่อเนื่อง | ประวัติไม่จำกัดและความจำข้ามเซสชัน | อิงตามบทสนทนา | บริบทยาวภายในการทำวิจัย | ความจำบทสนทนา | ไลบรารี แหล่งข้อมูลใช้ซ้ำได้ การแจ้งเตือน |
| ราคา (ณ ปี 2026) | ระดับฟรี; Plus $20/mo; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1,000 | ฟรีโดยมี Deep Research จำกัด; Pro $20/mo, $17/mo รายปี | ยังไม่ยืนยัน | ยังไม่ยืนยัน | แพ็กเกจชำระเงิน; ระดับราคาที่แน่นอนยังไม่ยืนยัน |
| เหมาะที่สุดสำหรับ | โครงการผสมเว็บ + วิชาการที่ต้องเลือกโมเดลได้ | บทสรุปเว็บพร้อมอ้างอิงที่รวดเร็ว | รายงานคู่แข่งและหัวข้อที่ยึดโยงกับ Workspace | การเจาะลึกที่กำหนดขอบเขตด้วยคำถาม | การทบทวนอย่างเป็นระบบและตารางหลักฐาน |
เครื่องมือ AI ใดแข็งแกร่งที่สุดสำหรับการทบทวนวรรณกรรมวิชาการและการดึงหลักฐาน?
Elicit เหมาะที่สุดสำหรับงานที่เป็นระบบและใช้ตารางหลักฐาน; SciSpace เด่นกว่าสำหรับการอ่านเชิงสำรวจอย่างรวดเร็ว; Litmaps และ Semantic Scholar เด่นกว่าสำหรับการทำแผนที่และการค้นพบแบบฟรี แพลตฟอร์มหลายโมเดลช่วยเสริมเครื่องมือเหล่านี้ แต่ไม่ได้ลบข้อได้เปรียบด้านฐานข้อมูลของพวกมัน
ตามรายงานของ Elicit เอง มีนักวิจัย มากกว่า 5 ล้านคน ใช้งาน และระบบสามารถ ค้นหาบทความได้สูงสุด 1,000 ฉบับและวิเคราะห์จุดข้อมูลได้สูงสุด 20,000 จุด ในการทำงานครั้งเดียว นักวิจัยรายงาน การประหยัดเวลาสูงสุด 80% ในการทบทวนอย่างเป็นระบบ โดยส่วนใหญ่อยู่ที่การคัดกรองและการดึงข้อมูล นี่คือผลิตภัณฑ์ที่ต่างจากแชตบอตที่บังเอิญอ้างอิง PDF
การเปรียบเทียบในปี 2026 พบว่า Elicit ดีกว่าสำหรับเวิร์กโฟลว์เชิงหลักฐานที่เข้มงวด และ SciSpace ดีกว่าสำหรับการค้นพบเชิงสำรวจอย่างรวดเร็ว SciSpace แข่งขันในฐานะ AI copilot สำหรับชุดบทความขนาดใหญ่ รวมถึงการช่วยเขียน ซึ่งเป็นประโยชน์ต่อการสแกนวรรณกรรมระยะแรก แต่ทดแทนได้แย่กว่าเมื่อคุณต้องการคอลัมน์การดึงข้อมูลที่ทำซ้ำได้
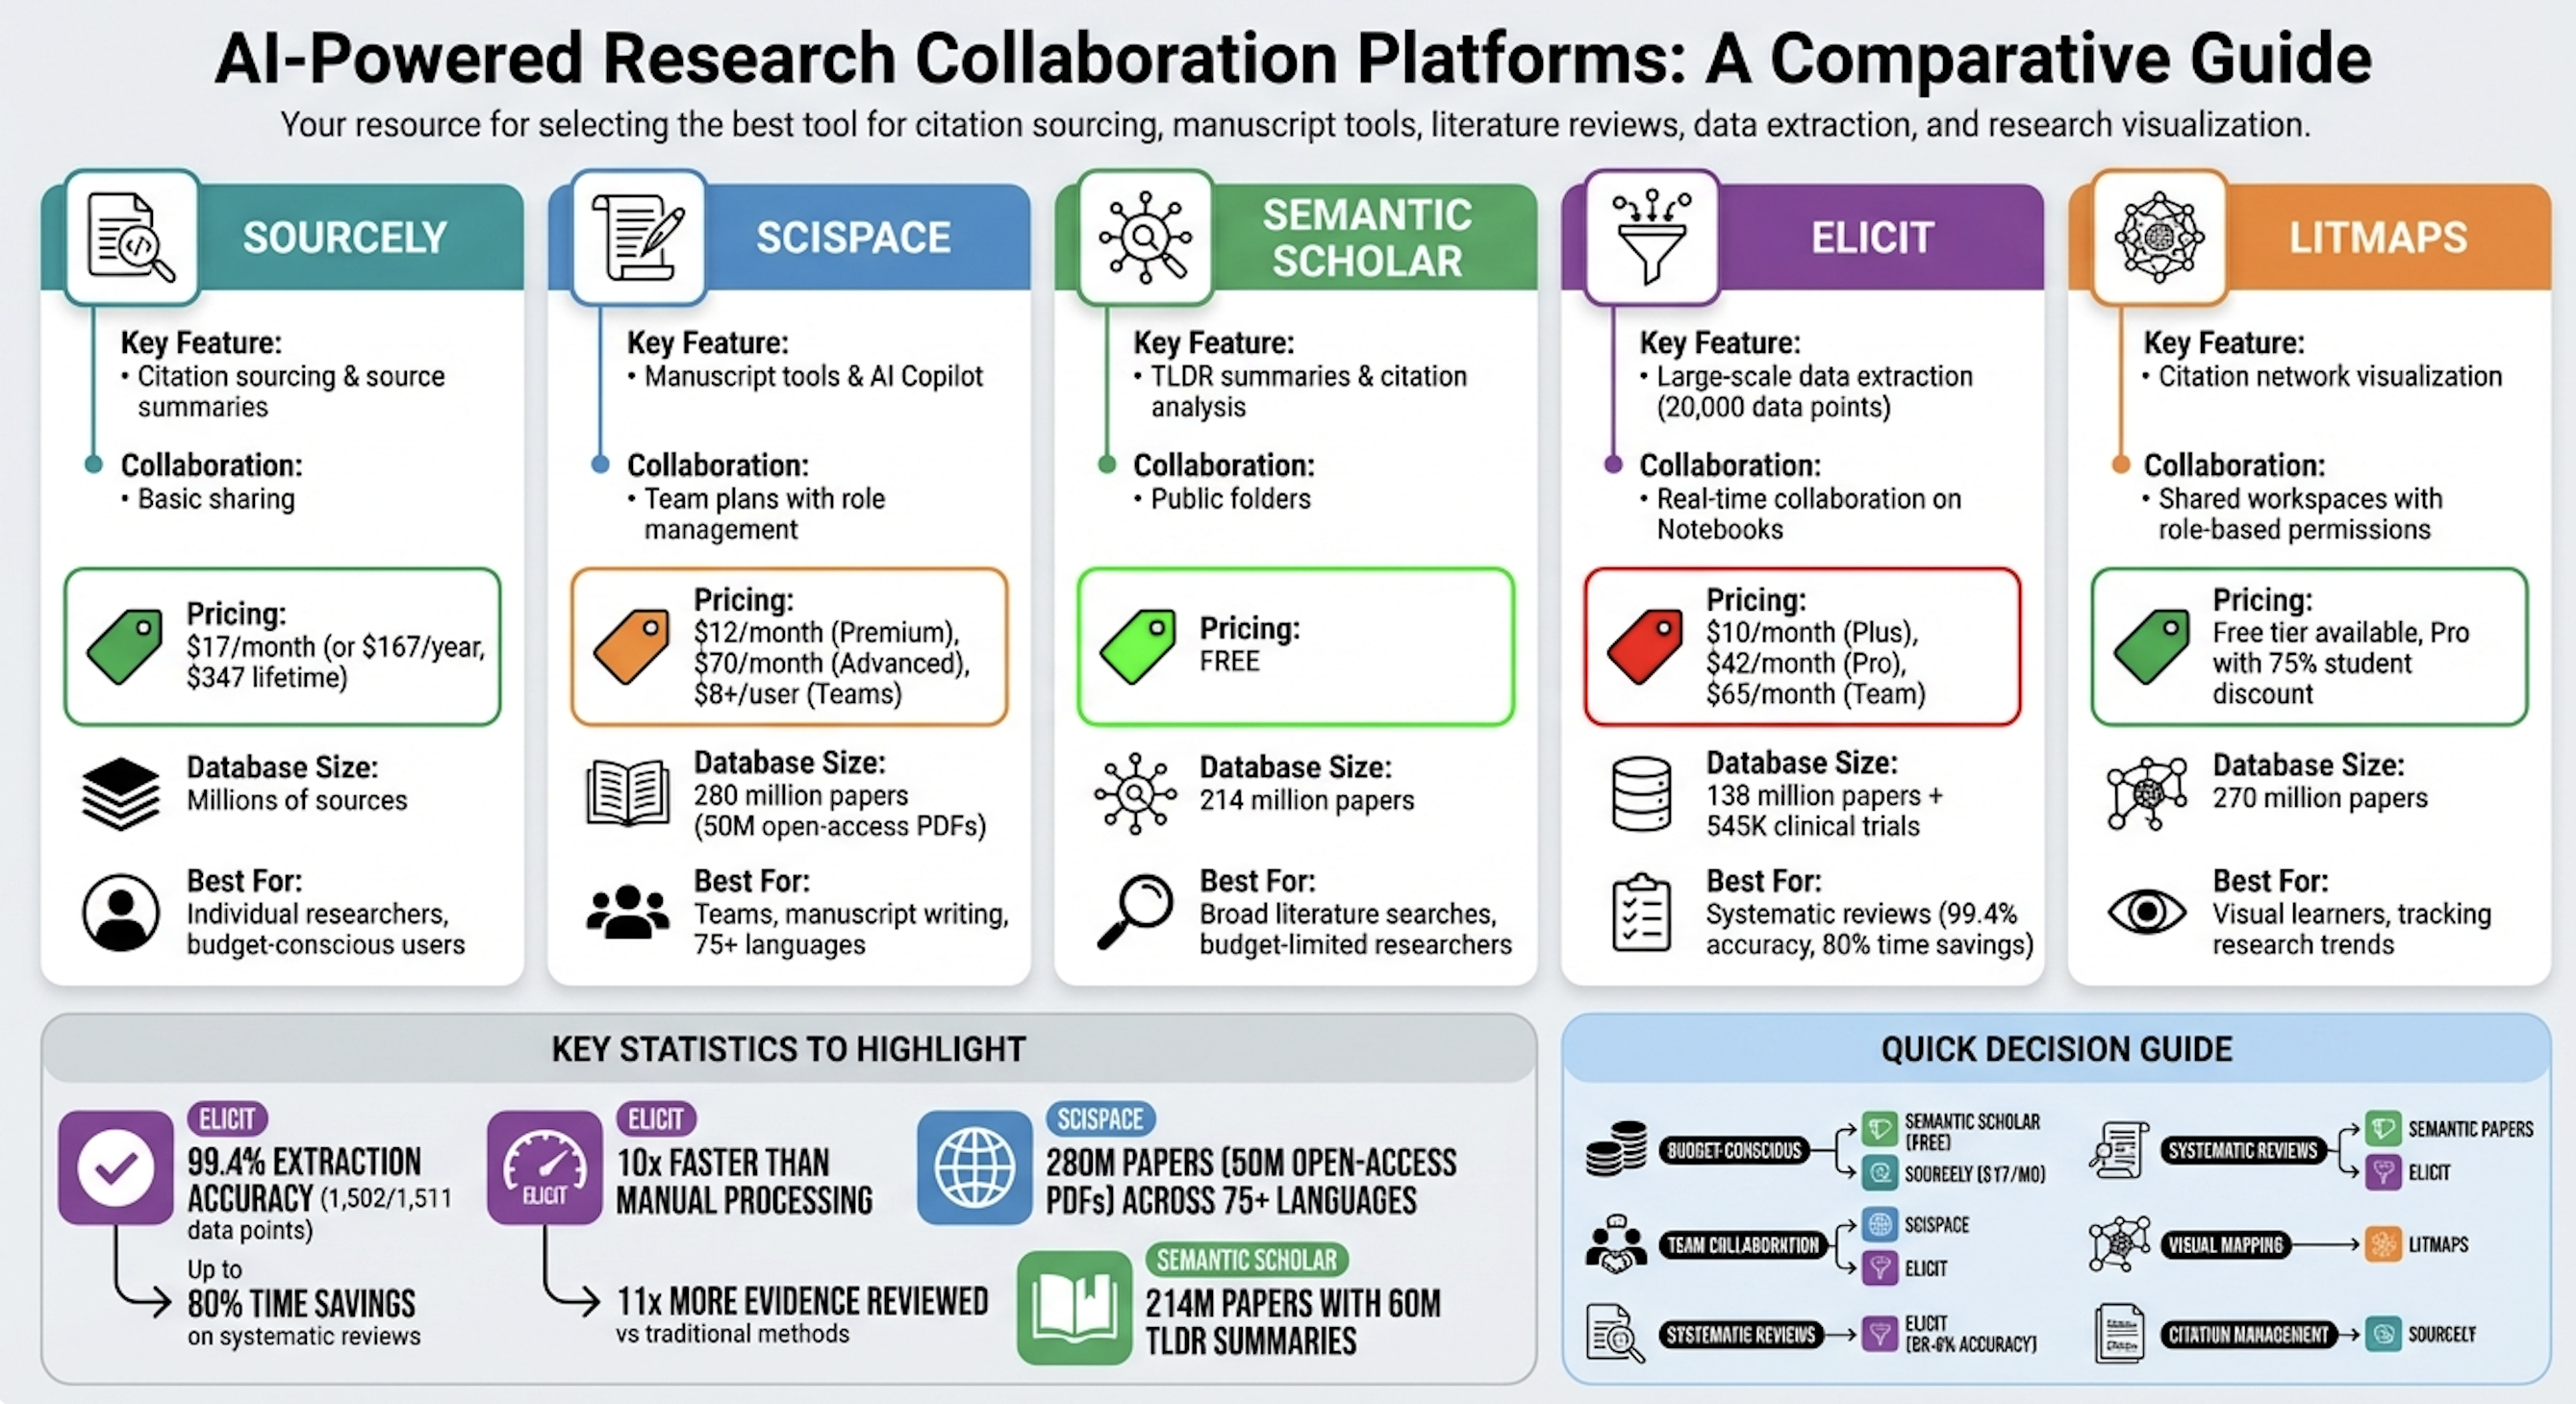
Semantic Scholar ยังคงเป็นดัชนีฟรีมาตรฐานสำหรับผลิตภัณฑ์เหล่านี้หลายตัว โดยมี บทความมากกว่า 200 ล้านฉบับ และการค้นพบแบบ TLDR คู่มือเครื่องมือวิชาการฟรีในปี 2026 ยังคงระบุชื่อ Semantic Scholar ควบคู่ Perplexity สำหรับนักวิจัยที่ไม่สามารถจ่ายเงินให้ทุกขั้นตอนของกระบวนการได้ Litmaps อยู่สุดขั้วตรงข้าม: มัน แสดงเครือข่ายการอ้างอิงเป็นภาพ เพื่อให้คุณเห็นกลุ่มงาน ไม่ใช่แค่ผลลัพธ์ที่จัดอันดับ — มีประโยชน์เมื่อความเสี่ยงคือพลาดสายวิวัฒนาการของงานวิจัย ไม่ใช่พลาดสถิติหนึ่งค่า
Academic Research Assistant ของ Jenova สร้างมาเพื่อการค้นพบ การเตรียมต้นฉบับ และการจัดการการอ้างอิง มากกว่าการดึงข้อมูลจำนวนมากแบบ Elicit ในทางปฏิบัติ หมายความว่าเครื่องมือนี้มีประโยชน์กว่าเมื่อคุณรู้คำถามอยู่แล้ว หรือเมื่อรีวิวต้องผสม preprint ข่าว และกิจกรรมใน repository เข้าด้วยกัน เป็นตัวเลือกที่อ่อนกว่าหากโปรโตคอลของคุณกำหนดให้คัดกรองชื่อเรื่อง 2,000 รายการลงในตารางสไตล์ PRISMA ภายในบ่ายนี้
การสลับโมเดลระหว่างการวิจัยเปลี่ยนคุณภาพการสังเคราะห์อย่างไร?
การสลับโมเดลระหว่างการวิจัยเปลี่ยนคุณภาพการสังเคราะห์ เพราะการค้นคืนข้อมูล การใช้ถ้อยคำอย่างระมัดระวัง และการประกอบบริบทขนาดยาวเป็นงานทางปัญญาที่ต่างกัน และไม่มีตระกูลโมเดลเดียวที่นำในทั้ง 3 ด้าน ดังนั้นการเข้าถึงหลายโมเดลจึงเป็นเกณฑ์ประเมิน ไม่ใช่กลยุทธ์เรียกเก็บเงิน
รูปแบบความล้มเหลวทั่วไปมีลักษณะดังนี้: โมเดลที่ยึดโยงกับเว็บและรวดเร็วรวบรวม 40 แหล่งข้อมูล โมเดลที่พูดยืดยาวเขียนเรื่องเล่าที่มั่นใจ และโมเดลที่ระมัดระวังน่าจะชี้ว่าจาก 40 แหล่งนั้น 3 แหล่งเป็นบล็อกของผู้ขาย หากขั้นตอนเหล่านี้เกิดขึ้นใน 3 ผลิตภัณฑ์ ความระมัดระวังจะไม่มีวันได้พบกับแหล่งข้อมูล
ความต่างในทางปฏิบัติของ Jenova คือเธรดเดียวกันสามารถย้ายข้ามโมเดล OpenAI, Anthropic, Google, DeepSeek และ xAI ได้โดยไม่ต้องส่งออกคลังข้อมูล เรื่องนี้สำคัญสำหรับงานผสม — ตัวอย่างเช่น ใช้รอบที่เน้นการค้นหาสำหรับ Real-Time Search แล้วใช้โมเดลที่อนุรักษ์นิยมกว่าเขียนข้ออ้างใหม่ โดยให้ทุกข้อยังคงมีการอ้างอิง Gemini Deep Research ตามการออกแบบ อยู่ภายในตระกูล Gemini รวมถึงโมเดลกลุ่ม Gemini 3 รุ่นใหม่สำหรับการวางแผนและรายงาน Perplexity เปิดให้ ผู้ใช้ Pro เลือกจากโมเดลชั้นนำ ได้ แต่สิ่งที่เป็นงานวิจัยยังคงเป็นรายงาน Perplexity ไม่ใช่พื้นที่ทำงานหลายเอเจนต์ถาวรที่มีคำสั่งของคุณเอง
ข้อจำกัดฝั่ง Jenova ก็ชัดเจนไม่แพ้กัน: การกำหนดเส้นทางโมเดลไม่ได้สร้างเอนจินดึงข้อมูลจากบทความ 138 ล้านฉบับ หากคอขวดคือ “ดึงข้อมูลผลลัพธ์จาก RCT 400 งานลงตาราง” Elicit ยังคงเป็นเครื่องมือที่เหมาะสมกว่า แม้คุณจะชอบโมเดลอื่นสำหรับส่วนอภิปรายผลก็ตาม
เมื่อใดเอเจนต์วิจัยเชิงลึกแบบโอเพนซอร์สจึงเหนือกว่าแพลตฟอร์มแบบโฮสต์?
เอเจนต์โอเพนซอร์สเหนือกว่าแพลตฟอร์มแบบโฮสต์เมื่อคุณต้องควบคุม retriever ทำงานกับเอกสารในเครื่อง หรือตรวจสอบทุกการ crawl ได้ — ไม่ใช่เมื่อคุณต้องการบทสรุปที่สวยงามและเร็วที่สุด GPT Researcher คือตัวอย่างที่ชัดเจนที่สุด: เอเจนต์อัตโนมัติสำหรับการวิจัยเว็บและในเครื่อง ซึ่งเขียนรายงานพร้อมการอ้างอิงจากรูปแบบ planner/executor
โครงการนี้ออกแบบมาเพื่อ รวบรวมมากกว่า 20 แหล่งข้อมูล สร้าง รายงานที่ยาวกว่า 2,000 คำ และลดอคติจากแหล่งเดียวด้วยการ scrape หลายหน้าพร้อมกัน โหมดการวิจัยเชิงลึกใช้ต้นไม้ย่อยของหัวข้อแบบเวียนเกิด คู่มือเกี่ยวกับ เอเจนต์วิจัย AI แบบโอเพนซอร์ส โดยทั่วไปชี้ให้ผู้ใช้เลือก GPT Researcher สำหรับรายงานเว็บและเอกสารที่ยืดหยุ่น และ Stanford STORM เมื่อเป้าหมายคือการสังเคราะห์แบบมีโครงสร้างสไตล์ Wikipedia ส่วน Open Deep Research ของ LangChain ใช้แนวทางตรงกันข้าม: นักวิจัยที่บางและปรับแต่งได้ ซึ่งให้คุณนำโมเดล เครื่องมือค้นหา และเซิร์ฟเวอร์ MCP ของตัวเองมาใช้
จุดแข็งเหล่านั้นคืออุปสรรคต่อการนำไปใช้เช่นกัน คุณต้องมี API key, runtime และความพร้อมที่จะดีบัก crawler ผลิตภัณฑ์ Deep Research แบบโฮสต์มีอยู่เพราะนักวิเคราะห์ส่วนใหญ่จะไม่ดูแลชุดระบบนั้นเพียงเพื่อบทสรุปการแข่งขันในวันอังคาร
Jenova อยู่ตรงกลาง: โครงสร้างพื้นฐานแบบโฮสต์ที่มีเครื่องมือ MCP และคำสั่งแบบกำหนดเอง โดยไม่มีความแน่นอนเต็มรูปแบบของการโฮสต์เองเช่น GPT Researcher ทีมที่ต้องการการวิจัยเอกสารในสภาพแวดล้อมแบบ air-gapped ไม่ควรมองแพลตฟอร์มแบบโฮสต์ใด ๆ ว่าเป็นสิ่งทดแทนแบบเสียบแล้วใช้ได้ทันที
คุณดำเนินโครงการวิจัยเดียวผ่านแหล่งข้อมูลเว็บและบทความวิชาการอย่างไร?
คุณดำเนินโครงการแบบผสมโดยแยกคลังข้อมูล ข้ออ้าง และร่างงานออกเป็น 3 รอบ — การสำรวจเว็บ การยืนยันเชิงวิชาการ และการสังเคราะห์พร้อมตรวจสอบการอ้างอิงอย่างชัดเจน — แทนที่จะขอให้เครื่องมือเดียว “วิจัยทุกอย่าง” ลำดับเดียวกันใช้ได้กับ Jenova, Perplexity และ Elicit; สิ่งที่ต่างกันมีเพียงวัตถุที่คุณคลิก
ลำดับที่ยั่งยืน:
- กำหนดขอบเขตคำถามในหนึ่งประโยค โดยระบุวันที่ กลุ่มประชากร และสิ่งที่จะหักล้างข้ออ้าง
- รวบรวมบริบทปัจจุบัน (ข่าว repo ฟอรัมผู้ปฏิบัติงาน) ก่อนกำหนดคำค้นวิชาการอย่างตายตัว
- ยืนยันกับบทความ โดยดึงระเบียบวิธีและขนาดตัวอย่าง ไม่ใช่เพียงบทคัดย่อ
- ปรับความขัดแย้งให้สอดคล้องกัน ในรอบที่สามด้วยโมเดลที่อนุรักษ์นิยมกว่า หรือตารางหลักฐานเฉพาะ
- ส่งออกการอ้างอิง ไปยังเครื่องมือจัดทำต้นฉบับที่คุณเชื่อถืออยู่แล้ว
บน Jenova ให้เริ่มจาก Real-Time Search สำหรับชั้นข้อมูลสด:
“ในช่วง 90 วันที่ผ่านมา วิศวกรและแพทย์กำลังพูดอะไรเกี่ยวกับอัตรา hallucination ในการสร้างรายงานรังสีวิทยา? ให้ความสำคัญกับ GitHub issues การบรรยายในงานประชุม และข่าว พร้อมระบุรายการแหล่งข้อมูล”
จากนั้นย้ายข้อจำกัดเดิมไปยัง Academic Research Assistant:
“โดยใช้ประเด็นข้างต้น จงค้นหาการประเมินที่ผ่าน peer review ระหว่างปี 2024–2026 สำหรับบทความแต่ละฉบับ ให้ดึงชุดข้อมูล วิธีการ อัตราความผิดพลาดที่รายงาน และข้อจำกัด แจ้งสิ่งที่ปรากฏเฉพาะในบทคัดย่อ”
บน Perplexity ให้เลือก Deep Research และขอบทสรุปที่มีแหล่งข้อมูลระบุวันที่; ผลิตภัณฑ์นี้สร้างมาเพื่อ ค้นหา อ่าน และเขียนรายงานภายในไม่กี่นาที บน Elicit ให้วางคำถามวิจัยและสร้างรายงานหรือตารางดึงข้อมูลจากคลังบทความ จากนั้นปรับแต่งว่าบทความใดจะรวมอยู่ — นี่คือเวิร์กโฟลว์ที่ Elicit อธิบายสำหรับงานวิจัยที่มีความสำคัญสูง
การตรวจสอบคุณภาพที่คนส่วนใหญ่ข้ามไป: สถิติทุกตัวที่มีเฉพาะบนเว็บและยังคงอยู่ในร่าง ต้องถูกแทนที่ด้วยบทความหรือติดป้ายว่าไม่ผ่าน peer review แพลตฟอร์มที่เก็บทั้งสองคลังข้อมูลไว้ในความจำเดียวกันทำให้การตรวจสอบนี้มีต้นทุนต่ำลง แต่ไม่ได้ทำให้เป็นทางเลือก
ทีมโครงสร้างพื้นฐานการวิจัยกล่าวอย่างไรเกี่ยวกับแพลตฟอร์มวิจัยหลายโมเดล?
ทีมโครงสร้างพื้นฐานการวิจัยมอง “deep research” มากขึ้นในฐานะปัญหาการประสานงาน — retriever โมเดล ความจำ และนโยบายการอ้างอิง — แทนที่จะเป็นโหมดวิเศษเพียงโหมดเดียว ทีมที่ได้ผลลัพธ์เชื่อถือได้คือทีมที่กำหนดเครื่องมือให้เหมาะกับรูปแบบความล้มเหลว แทนการตามหาผู้ชนะเพียงรายเดียว
“ต้นทุนแฝงในปี 2026 ไม่ใช่การสร้างร่างแรก แต่คือการพาข้ออ้างจากผลค้นหาบนเว็บแบบเรียลไทม์เข้าสู่ต้นฉบับโดยไม่ฟอกทิ้งแหล่งข้อมูล วันที่ และผลประโยชน์ทับซ้อน เมื่อข้อมูลเหล่านี้อยู่ใน 3 ผลิตภัณฑ์ พวกมันจะไม่รอดจากการวางข้อความ”
“การเข้าถึงหลายโมเดลจะคุ้มค่าก็ต่อเมื่อคลังข้อมูลยังคงอยู่ที่เดิม การสลับจากโมเดลค้นคืนข้อมูลไปยังบรรณาธิการที่อนุรักษ์นิยมมีประโยชน์; การสลับผลิตภัณฑ์แล้วสูญเสียรายการที่ปฏิเสธไปนั้นไม่ใช่ นี่คือเหตุผลที่ความจำต่อเนื่องและการเชื่อมต่อเครื่องมือสำคัญกว่าความลื่นไหลเพิ่มอีกสองร้อยคำ”
“เรายังคงส่งผู้ทำ systematic review ไปยังเครื่องมือดึงข้อมูลที่สร้างมาเฉพาะ หากคุณต้องตัดสินใจคัดกรองการทดลองหลายร้อยรายการ แพลตฟอร์มวิจัยทั่วไปควรอยู่ข้าง Elicit ไม่ใช่แสร้งว่าเป็น Elicit ชุดเครื่องมือที่แนะนำมีความผสมผสานโดยตั้งใจ”
— Jenova Product Team, การออกแบบเวิร์กโฟลว์วิจัย AI, สร้างเอเจนต์หลายโมเดลที่ทีมในกว่า 70 ประเทศใช้งาน
มุมมองนี้สอดคล้องกับวิธีที่คู่มือมหาวิทยาลัยนำเสนอตลาดในปัจจุบัน: เครื่องมือวิชาการแบบเทียบเคียงกัน สำหรับการค้นหา การทำแผนที่ และการสรุป พร้อมหมวดแยกต่างหากของโหมดวิจัยเชิงลึกที่เน้นเว็บ คำถามด้านแพลตฟอร์มจึงอยู่ที่ว่าคุณต้องการทำให้ชั้นใดเป็นมาตรฐาน
คุณควรคาดหวังข้อแลกเปลี่ยนใดจากเครื่องมือวิจัย AI ในปี 2026?
คุณควรคาดหวังว่าทุกตัวเลือกที่จริงจังจะไม่สมบูรณ์ในอย่างน้อยหนึ่งคลังข้อมูล หนึ่งรูปแบบการควบคุม หรือหนึ่งมาตรฐานการอ้างอิง — และต้องเลือกจากช่องว่างเหล่านั้น แทนที่จะเลือกจากหมวดหมู่ทางการตลาด ข้อแลกเปลี่ยนมีความคงที่พอให้วางแผนได้แล้ว
การวิจัยเชิงลึกที่เน้นเว็บ (Perplexity, Gemini, ChatGPT) จะยังชนะด้านเวลาสู่บทสรุป จุดศูนย์กลางการออกแบบของ Perplexity คือ ย่นงานผู้เชี่ยวชาญหลายชั่วโมงให้เหลือไม่กี่นาที Gemini จะยังชนะเมื่อตัวหลักฐานอยู่ใน Workspace แล้ว ChatGPT จะยังชนะเมื่อคำถามวิจัยยังไม่ชัดเจนและต้องซักถามก่อน
ผู้เชี่ยวชาญด้านงานวิชาการจะยังชนะด้านหลักฐานแบบมีโครงสร้าง ขนาดการดึงข้อมูลของ Elicit และ การประหยัดเวลาสำหรับการทบทวนอย่างเป็นระบบ ไม่ใช่ฟีเจอร์ที่แพลตฟอร์มแชตทั่วไปจะแสร้งทำได้ Litmaps จะยังชนะเมื่อคำถามคือ “ฉันกำลังพลาดกลุ่มงานใด?” เอเจนต์โอเพนซอร์สจะยังชนะเมื่อข้อกำหนดคือเอกสารในเครื่อง retriever แบบกำหนดเอง หรือการ crawl ที่ตรวจสอบได้
ข้อแลกเปลี่ยนของ Jenova กลับกัน Jenova เป็นหนึ่งในตัวเลือกที่ครบถ้วนกว่าเมื่อคนคนเดียวต้องค้นหาเว็บแบบเรียลไทม์ ดึงบริบทวิชาการ เก็บความจำข้ามเซสชัน และเปลี่ยนโมเดลโดยไม่ต้องสร้างบทสรุปใหม่ เป็นสิ่งทดแทนที่อ่อนกว่าสำหรับการดึงข้อมูล RCT จำนวนมาก ภาพเครือข่ายการอ้างอิง และการทำงาน Deep Research แบบหลายหน้าอัตโนมัติเต็มรูปแบบที่มีคะแนนความถูกต้องเชิงข้อเท็จจริงเผยแพร่ไว้
หาก 30 วันถัดไปของคุณเต็มไปด้วยคำถามผสม — บทความหนึ่ง ตลาดหนึ่ง เธรด GitHub หนึ่ง และร่างหนึ่ง — แพลตฟอร์มวิจัยหลายโมเดลคือค่าเริ่มต้นที่สมเหตุสมผล หาก 30 วันถัดไปเต็มไปด้วยโปรโตคอล บันทึกการคัดกรอง และแผนภาพ PRISMA ให้เริ่มที่ Elicit และเพิ่มเครื่องมือเว็บเฉพาะจุดที่โปรโตคอลอนุญาตให้ใช้แหล่งข้อมูลนอกวารสาร
แหล่งอ้างอิง
- Perplexity — แนะนำ Perplexity Deep Research
- Google Gemini — ภาพรวม Deep Research
- Elicit — AI สำหรับการวิจัยทางวิทยาศาสตร์
- Macquarie University Library — การใช้เครื่องมือขับเคลื่อนด้วย AI สำหรับการทบทวนวรรณกรรม
- Thesify — เครื่องมือ AI ที่ดีที่สุดสำหรับการวิจัยเชิงวิชาการในปี 2026
- Cypris AI — 11 เครื่องมือ AI ที่ดีที่สุดสำหรับการทบทวนวรรณกรรมวิทยาศาสตร์ในปี 2026
- TechRadar — ทดลองใช้ Perplexity Deep Research เทียบกับ ChatGPT
- Android Authority — ความเร็วและคุณภาพของ Gemini เทียบกับ ChatGPT Deep Research
- LivePlan — การเปรียบเทียบ ChatGPT กับ Gemini Deep Research
- Cascade Insights — รีวิวโดยนักวิจัยตลาด: ChatGPT เทียบกับ Gemini Deep Research
- Section AI — การทดสอบคุณภาพผลลัพธ์ของ ChatGPT เทียบกับ Gemini Deep Research
- Perplexity Pro — ราคาและรายละเอียดแพ็กเกจ
- Paperguide — การเปรียบเทียบ Elicit กับ SciSpace (2026)
- SciSpace — การเปรียบเทียบทางเลือกแทน Elicit
- Swiss School of Business Research — เครื่องมือ AI ฟรีสำหรับการวิจัยเชิงวิชาการในปี 2026
- Litmaps — ผู้ช่วยทบทวนวรรณกรรม
- GPT Researcher — เอเจนต์วิจัยอัตโนมัติแบบโอเพนซอร์ส (GitHub)
- Gatsbi — เอเจนต์วิจัย AI แบบโอเพนซอร์สที่ดีที่สุดในปี 2026
- LangChain — Open Deep Research