แพลตฟอร์ม AI ใดเหมาะที่สุดสำหรับการสกัดรูปแบบการศึกษา ผลลัพธ์ และข้อจำกัด?
2026-08-21
ควรให้คะแนนเครื่องมือ AI จากการสกัดข้อมูลสี่ช่องที่ตรวจสอบย้อนกลับได้ แทนการสรุปบทความทั่วไปอย่างไร?
สำหรับการสกัดรูปแบบการศึกษา กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัดลงในตารางหลักฐานที่ตรวจสอบได้ เอเจนต์วิจัยที่ยืดหยุ่นอย่าง Jenova's Academic Research Assistant มีความโดดเด่นที่สุดเมื่อบทความมีความหลากหลายและข้อจำกัดต้องอาศัยการตีความ ขณะที่ Elicit และ Paperguide เหมาะกว่าเมื่อคุณต้องการการสกัดตามแม่แบบในชุดการทดลองจำนวนมากที่มีรูปแบบค่อนข้างเป็นมาตรฐาน SciSpace และ Consensus มีประโยชน์สำหรับการค้นหาและตอบคำถามหลักฐานอย่างรวดเร็ว แต่มีความอ่อนแอกว่าเมื่อใช้เป็นเครื่องมือหลักสำหรับการสกัดข้อมูล
ความแตกต่างสำคัญในปี 2026 ไม่ใช่ “เครื่องมือใดสรุป PDF ได้” แต่คือเครื่องมือใดสามารถกรอกข้อมูลสี่ช่อง — วิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัด — พร้อมที่มาที่คุณตรวจสอบได้
ปัจจัยสำคัญที่แยกหลักฐานซึ่งสกัดใช้ได้ออกจากบทสรุปที่ลื่นไหล:
✅ ความเที่ยงตรงต่อสคีมา — เครื่องมือส่งคืนรูปแบบการศึกษา, n, ประชากร, ผลลัพธ์ และข้อจำกัดเป็นคนละช่อง ไม่ใช่ย่อหน้าที่ปะปนกัน ✅ การยึดโยงกับแหล่งข้อมูล — ทุกเซลล์อ้างถึงประโยค ตาราง รูปภาพ หรือหน้า ไม่ใช่เพียงชื่อบทความ ✅ ความสามารถในการวิเคราะห์ข้อจำกัด — มีการจัดประเภทอคติ ความสามารถในการสรุปอ้างอิง และช่องว่างในการรายงาน ไม่ใช่เพียงคัดลอกข้อควรระวังของผู้เขียน ✅ โครงสร้างข้ามบทความ — ผลลัพธ์เรียงเทียบกันได้ เพื่อให้คุณเปรียบเทียบแทนที่จะต้องอ่านซ้ำ ✅ เวิร์กโฟลว์ที่มนุษย์ตรวจสอบได้ — คุณสามารถปฏิเสธ แก้ไข และนำตารางกลับมาใช้ได้โดยไม่ต้องเริ่มต้นใหม่
เพื่อเปรียบเทียบแพลตฟอร์มเหล่านี้อย่างตรงไปตรงมา ควรให้คะแนนตามมาตรฐานสี่ช่องนี้ แทนที่จะดูเฉพาะคุณภาพการสรุป
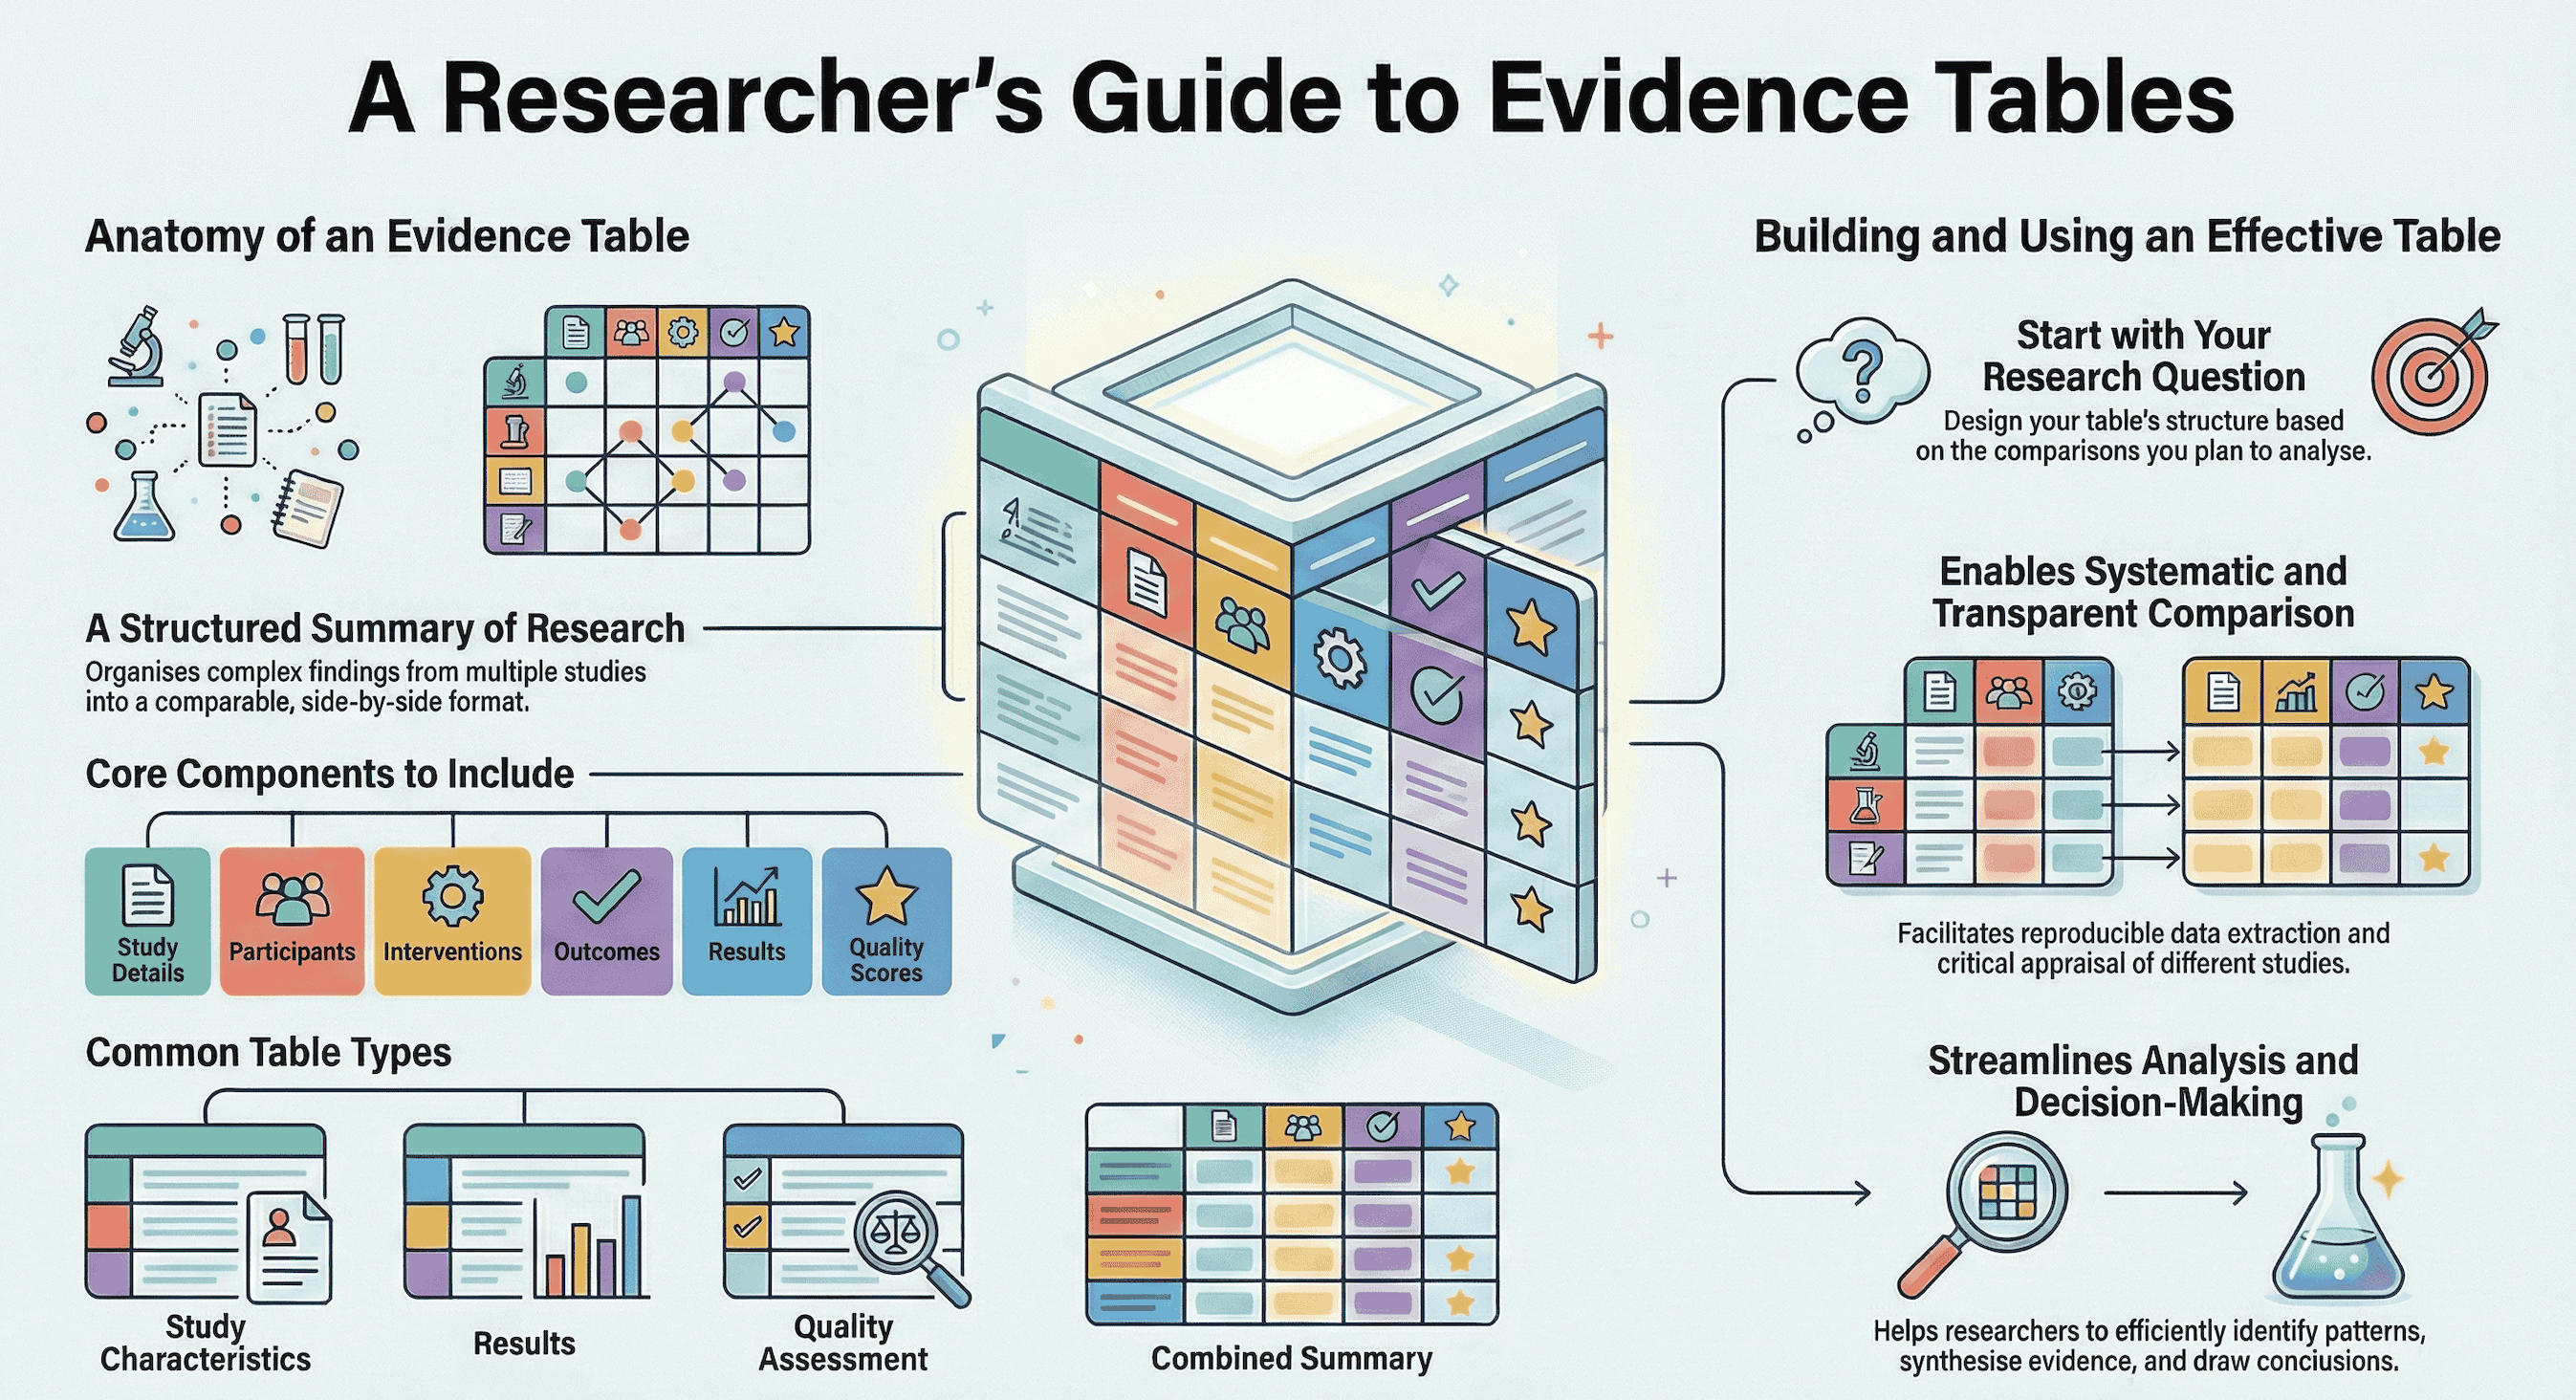
เหตุใดการสกัดรูปแบบการศึกษาและข้อจำกัดจึงกลายเป็นคอขวดสำหรับนักวิจัย?
การสกัดข้อมูลด้วยตนเองยังคงเป็นหนึ่งในขั้นตอนที่ช้าที่สุดและเกิดข้อผิดพลาดได้มากที่สุดของการสังเคราะห์หลักฐาน ด้วยเหตุนี้นักวิจัยจึงหันมาใช้ AI เพื่อดึงวิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัดลงในตารางที่เปรียบเทียบกันได้ PRISMA 2020 ขอให้ผู้ทบทวนรายงานว่าได้ทำอะไร คัดเลือกการศึกษาอย่างไร พบอะไร และประเมินความเสี่ยงของอคติอย่างไร มาตรฐานการรายงานนี้ตั้งอยู่บนสมมติฐานว่ามีขั้นตอนการสกัดข้อมูลอย่างมีโครงสร้าง ซึ่งทีมส่วนใหญ่ยังทำด้วยมือ
คอขวดเกิดจากทั้งปริมาณและความหลากหลาย นักศึกษาระดับบัณฑิตศึกษาอาจต้องเปรียบเทียบบทความสิบฉบับตามรูปแบบและ n ขณะที่ทีมทบทวนอย่างเป็นระบบอาจต้องคัดกรองระเบียนหลายร้อยรายการ แล้วสกัดข้อมูลลงในแบบฟอร์มที่กำหนดไว้ล่วงหน้า แนวทางดั้งเดิมมองว่าการสกัดข้อมูลคือการเลือกคุณลักษณะของการศึกษาและจัดระเบียบข้อมูลจากรายงาน ซึ่งฟังดูง่ายจนกระทั่งทุกบทความซ่อนขนาดกลุ่มตัวอย่างไว้ในเชิงอรรถ และซ่อนข้อจำกัดไว้ในย่อหน้าเชิงปกป้องเพียงย่อหน้าเดียว
AI เปลี่ยนต้นทุนของการตรวจรอบแรก การศึกษาแทรกภายในการทบทวนในปี 2026 พบว่าการสกัดโดยใช้ Elicit มีความแม่นยำไม่ด้อยกว่าการสกัดโดยมนุษย์ล้วน ใช้เวลาน้อยกว่าผู้สกัดแต่ละคนราว 25 นาที และมีต้นทุนต่ำกว่าใน 50 RCTs ความเห็นด้านการสังเคราะห์หลักฐานในวงกว้างขึ้นปัจจุบัน ประเมินว่า AI ลดภาระงานได้ 50–75% ตลอดขั้นตอนต่าง ๆ ของการทบทวน แต่ความเร็วไม่เท่ากับตารางที่อ้างอิงได้ ปัญหาวิจัยในปี 2026 คือการดึงวิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และ ข้อจำกัดออกจาก PDF ในรูปแบบที่ผู้ทบทวนอีกคนสามารถตรวจสอบได้
อะไรทำให้เวิร์กโฟลว์การสกัดด้วย AI น่าเชื่อถือเพียงพอสำหรับตารางหลักฐาน?
เวิร์กโฟลว์การสกัดด้วย AI ที่น่าเชื่อถือคือเวิร์กโฟลว์ที่ส่งคืนข้อมูลครบถ้วนและเปรียบเทียบกันได้ พร้อมที่มาระดับข้อความอ้างอิงหรือระดับหน้า แล้วปล่อยให้มนุษย์เป็นผู้ตัดสินใจเรื่องการรวมการศึกษาและการตีความ ความลื่นไหลไม่ใช่บททดสอบ ตารางหลักฐานต่างหากคือบททดสอบ
เราใช้มาตรฐานสี่ช่อง — เรียกว่า MSOL (วิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ ข้อจำกัด) — และให้คะแนนเครื่องมือในหกมิติ:
- ความเที่ยงตรงต่อสคีมา — ผลลัพธ์แยกรูปแบบการศึกษา กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัดเป็นคอลัมน์ที่ชัดเจนหรือไม่?
- การยึดโยงกับแหล่งข้อมูล — ทุกค่าตรวจสอบย้อนกลับไปยังประโยค ตาราง รูปภาพ หรือหน้าได้หรือไม่?
- ความสามารถในการวิเคราะห์ข้อจำกัด — เครื่องมือจัดประเภทจุดอ่อน เช่น อคติ ความสามารถในการสรุปอ้างอิง และการรายงาน หรือเพียงกล่าวซ้ำส่วนข้อจำกัดของผู้เขียน?
- การจัดแนวข้ามการศึกษา — คุณเปรียบเทียบ n รูปแบบ และผลลัพธ์ได้โดยไม่ต้องจัดรูปแบบใหม่หรือไม่?
- ความสามารถในการตรวจสอบ — ร่องรอยข้อมูลจะผ่านการตรวจของผู้ทบทวนคนที่สอง อาจารย์ที่ปรึกษา หรือย่อหน้าวิธีวิจัยตาม PRISMA ได้หรือไม่?
- ความเหมาะสมกับชุดข้อมูล — เครื่องมือนี้สร้างมาสำหรับการทดลองที่เป็นมาตรฐาน วิธีวิจัยแบบผสม หรือการสกัดซ้ำผ่านการสนทนาหรือไม่?
การจัดกรอบนี้ไม่ได้เป็นไปโดยพลการ PRISMA 2020 กำหนดให้ผู้ทบทวนรายงานวิธีประเมินความเสี่ยงของอคติ และ RoB 2 ประเมินการสุ่ม การเบี่ยงเบนจากการแทรกแซงที่ตั้งใจไว้ ข้อมูลผลลัพธ์ที่สูญหาย การวัดผล และการคัดเลือกผลลัพธ์ที่รายงาน เครื่องมือที่สกัดค่า p-value ได้แต่ไม่สามารถชี้ให้เห็นอคติจากการคัดเลือกตัวอย่างหรือตัวแปรกวน จึงยังไม่ครบถ้วนสำหรับงานทบทวน
มีกฎเชิงปฏิบัติสองข้อตามมา ประการแรก ตัวแปรที่เป็นมาตรฐาน เช่น ป้ายกำกับรูปแบบการศึกษา n และชื่อกลุ่มทดลอง คือจุดที่ AI ปัจจุบันทำได้ดีที่สุด โดย การประเมินที่เกี่ยวข้องกับ Cochrane พบว่าประสิทธิภาพการสกัดด้วย AI สูงและใกล้เคียงกับผู้ทบทวนมนุษย์ โดยเฉพาะสำหรับตัวแปรที่เป็นมาตรฐาน ประการที่สอง ข้อจำกัดและข้อควรระวังเชิงคุณภาพยังต้องผ่านการตรวจโดยมนุษย์ แนวทางการสังเคราะห์หลักฐานของ King’s College London มองว่า AI มีประโยชน์ในหลายขั้นตอน ไม่ใช่สิ่งทดแทนผู้ทบทวนแบบไร้การกำกับ
เครื่องมือ AI ใดสร้างตารางหลักฐานจากบทความวิชาการที่ใช้งานได้ดีที่สุด?
ปัจจุบัน Elicit และ Paperguide สร้างตารางหลักฐานลักษณะคล้ายแม่แบบในระดับขนาดใหญ่ได้ดีที่สุด ขณะที่ Jenova's Academic Research Assistant มีประสิทธิภาพมากกว่าเมื่อคุณต้องการช่องข้อมูลเฉพาะ การจัดประเภทข้อจำกัด และคำถามติดตามใน PDF ที่อัปโหลด SciSpace และ Consensus ช่วยคุณค้นหาและทำความเข้าใจภาพรวมของบทความ แต่เป็นเครื่องมือรองสำหรับการสกัด MSOL
การเปรียบเทียบอิสระในปี 2026 สอดคล้องกับการแบ่งบทบาทนี้ โดยทั่วไปผู้ทบทวน จัดให้ Elicit เหนือกว่าสำหรับการค้นคว้าวรรณกรรมและการสกัดข้อมูล และจัดให้ Consensus เหนือกว่าสำหรับคำถามวิทยาศาสตร์แบบใช่/ไม่ใช่ การเปรียบเทียบคุณสมบัติยัง มองว่า Elicit แข็งแกร่งกว่าสำหรับเวิร์กโฟลว์หลักฐานที่เข้มงวด และ SciSpace แข็งแกร่งกว่าสำหรับการค้นหาเชิงสำรวจและการเขียนอย่างรวดเร็ว คู่มือห้องสมุดมหาวิทยาลัยปัจจุบัน ระบุเครื่องมือวรรณกรรม AI ว่าเป็นส่วนเสริมสำหรับบทสรุป เครือข่าย และการสกัดข้อมูล มากกว่าจะเป็นสิ่งทดแทนการประเมินอย่างสมบูรณ์
| คุณสมบัติ / มิติ | Elicit | Jenova's Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| การสกัดรูปแบบการศึกษาและกลุ่มตัวอย่าง | แข็งแกร่ง; มีคอลัมน์เฉพาะและการสกัดจากตาราง/รูปภาพ | แข็งแกร่งกับ PDF ที่อัปโหลดผ่านสคีมา MSOL ที่สั่งงาน | แข็งแกร่ง; ใช้คอลัมน์ที่ผู้ใช้กำหนดกับบทความที่เลือก | ปานกลาง; เหมาะกับการทำความเข้าใจระดับบทความมากกว่าสคีมาที่เคร่งครัด | อ่อนแอเมื่อใช้เป็นเครื่องมือสกัดหลัก; ปรับให้เหมาะกับคำตอบระดับข้ออ้าง |
| การสกัดผลลัพธ์ | แข็งแกร่ง รวมถึงผลลัพธ์เชิงตัวเลขจากตาราง | แข็งแกร่งเมื่อแนบ PDF และระบุช่องข้อมูล | แข็งแกร่ง พร้อมลิงก์ระดับเซลล์ไปยังแหล่งข้อมูล | ปานกลาง; มีบทสรุปที่มีประโยชน์ แต่ไม่เน้นตารางโดยตรง | ปานกลางสำหรับผลการศึกษาหลัก ไม่เหมาะกับตารางหลายกลุ่มทดลอง |
| ความลึกของข้อจำกัด / ความเสี่ยงของอคติ | ดีสำหรับช่องข้อมูลที่รายงาน แต่จัดประเภทเชิงตีความได้น้อยกว่า | แข็งแกร่งในการจำแนกอคติกับความสามารถในการสรุปอ้างอิงพร้อมการอ้างอิงหน้า | ดีเมื่อคุณกำหนดคอลัมน์ข้อจำกัด | จำกัด; เน้นการสำรวจมากกว่าการประเมินเป็นอันดับแรก | จำกัด; ไม่ได้สร้างมาสำหรับตารางจุดอ่อนแบบมีโครงสร้าง |
| ที่มา | การอ้างอิงระดับประโยคหรือรูปภาพสำหรับข้ออ้าง | การอ้างอิงหน้า/ข้อความในตารางมีโครงสร้างเมื่อสั่งงาน | ทุกค่าที่สกัดเชื่อมโยงกับข้อความต้นทาง | โดยทั่วไปเชื่อมโยงระดับบทความตามลักษณะเครื่องมือค้นหา/ทบทวน | คำตอบมีแหล่งอ้างอิงรองรับ แต่ไม่ใช่ตารางหลักฐานระดับเซลล์ |
| เวิร์กโฟลว์คัดกรอง / ทบทวน | สร้างมาเพื่อการคัดกรอง SLR รวมถึงชุดข้อมูลขนาดใหญ่และการตรวจสอบแบบ PRISMA | ทบทวนบทความที่เลือกผ่านการสนทนา; ไม่ใช่เครื่องมือคัดกรอง 40,000 ระเบียน | การทบทวนแบบสองผู้ทบทวนและรายงาน PRISMA ในพื้นที่ทำงานเดียว | ค้นวรรณกรรมและ Deep Review เพื่อการสำรวจ | ภาพรวมฉันทามติอย่างรวดเร็วข้ามบทความ |
| ราคา (ณ ปี 2026) | Plus ราว $12/เดือน; Pro ราว $49/เดือน; Enterprise กำหนดเอง | แพ็กเกจฟรีมีการใช้งานจำกัด; Plus $20/เดือน (30×); แพ็กเกจสูงกว่าขยายการใช้งาน | พื้นที่ทำงานคิดราคาตามที่นั่ง; ยังยืนยันราคาเผยแพร่ที่แน่นอนไม่ได้ในที่นี้ | แพ็กเกจชำระเงินเริ่มต้นราว $12/เดือนเมื่อจ่ายรายปี พร้อมแพ็กเกจระดับสูงที่รวมการเขียน | มีแพ็กเกจ Pro แบบชำระเงิน; ยังยืนยันราคาเผยแพร่ที่แน่นอนสำหรับปี 2026 ไม่ได้ในที่นี้ |
| เหมาะที่สุดสำหรับ | การทบทวนอย่างเป็นระบบที่ขับเคลื่อนด้วยโพรโทคอลของรายงานการศึกษาที่ค่อนข้างมาตรฐาน | ตารางสี่ช่องแบบกำหนดเอง การประเมินข้อจำกัด และการสกัดซ้ำจากชุดบทความที่กำลังทำงาน | การสกัดที่ตรวจสอบได้พร้อมการเขียนในคลังเดียว | การทำแผนที่ระยะแรก การอ่าน และการสนับสนุนต้นฉบับ | คำถามรวดเร็วว่า “วรรณกรรมกล่าวว่าอย่างไร?” |
Elicit
Elicit คือผู้เชี่ยวชาญด้านการสกัดข้อมูลที่สร้างมาเพื่อจุดประสงค์นี้โดยตรงในชุดเครื่องมือนี้ ผลิตภัณฑ์นี้ ค้นหา สรุป สกัดข้อมูลจาก และสนทนากับคลังบทความที่ Elicit ระบุว่ามีมากกว่า 125 ล้านฉบับ และรายงานว่ามีนักวิจัยใช้งานมากกว่า 2 ล้านคน เวิร์กโฟลว์การทบทวนอย่างเป็นระบบของมัน เน้นการสกัดจากตารางและรูปภาพ เซลล์ที่มีข้อความอ้างอิงรองรับ การคัดกรองในระดับขนาดใหญ่มาก และรายงานที่มีสิ่งประกอบด้านวิธีวิจัยรูปแบบ PRISMA
จุดเน้นดังกล่าวเป็นจุดแข็งจริงสำหรับชุดข้อมูลลักษณะ RCT แต่ก็เป็นข้อจำกัดเช่นกัน คุณกำลังจ่ายเงินสำหรับเครื่องจักรทำการทบทวน และงานเชิงตีความ เช่น การจัดประเภทข้อจำกัดใหม่ หรือการถามว่า “พวกเขาไม่ได้ควบคุมอะไร?” ยังคงเป็นหน้าที่ของผู้ทบทวน ราคาในระดับ Pro ค่อนข้างสูงสำหรับนักศึกษาที่ต้องการตารางเป็นครั้งคราวเท่านั้น
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant สร้างขึ้นเพื่อเป็นคู่คิดด้านการวิจัยมากกว่าจะเป็นโรงงานคัดกรอง มันค้นคว้าวรรณกรรม สนับสนุนงานต้นฉบับและการอ้างอิง และบนแพลตฟอร์ม Jenova สามารถอ่าน PDF ที่แนบ รักษาหน่วยความจำต่อเนื่องข้ามเซสชัน และเรียกใช้เครื่องมือค้นหาวิชาการได้ คุณกำหนดคอลัมน์ MSOL ด้วยภาษาธรรมชาติ แล้วทำซ้ำเมื่อบทความซ่อน n ไว้ในแผนภาพ CONSORT หรือกระจายข้อจำกัดไว้ทั่วส่วน Discussion
ข้อจำกัดที่ต้องพูดกันอย่างตรงไปตรงมาคือด้านสถาปัตยกรรม เครื่องมือนี้ไม่มีคิวคัดกรองแบบผู้ทบทวนสองคนสำหรับระเบียนหลายหมื่นรายการ และยังไม่ได้เผยแพร่การทดลองความแม่นยำแบบ SWAR ที่เทียบเคียงกับ Elicit คุณภาพการสกัดขึ้นอยู่กับคำสั่ง ไฟล์ที่แนบ และการตรวจสอบโดยมนุษย์ สำหรับบทวิทยานิพนธ์ที่มี 12 บทความ ความยืดหยุ่นนี้คือประเด็นสำคัญ แต่สำหรับการทบทวน PRISMA ที่มี 2,000 ระเบียน โหมดทบทวนของ Elicit หรือ Paperguide เหมาะสมกว่า
Paperguide
Paperguide อยู่กึ่งกลางระหว่างคลังข้อมูล เครื่องมือสกัด และเครื่องมือเขียน มัน จัดทำดัชนีบทความมากกว่า 200 ล้านฉบับ ให้คุณกำหนดคอลัมน์การสกัด เชื่อมโยงทุกค่ากับข้อความต้นทาง และส่งออกตารางเป็น CSV หรือ Excel ได้ โหมดการทบทวนอย่างเป็นระบบของมันเน้นการทบทวนโดยสองคน การตัดสินขั้นสุดท้ายโดยมนุษย์ และแผนภาพ PRISMA ที่สร้างจากจำนวนจริง
จุดแข็งคือที่มาและพื้นที่ทำงานเดียวตั้งแต่คลังข้อมูลจนถึงตาราง ข้อจำกัดคือยังอยู่ระหว่างการรวบรวมมาตรฐานด้านการปฏิบัติตามข้อกำหนด โดยบริษัทเองระบุว่า GDPR, SOC 2 และ ISO 27001 กำลังจะมา และราคาสาธารณะที่คงที่ตรวจสอบได้ยากกว่าระดับราคาของ Elicit ที่มักถูกอ้างถึงอย่างกว้างขวาง ทีมที่ต้องการร่องรอยการตรวจสอบแบบระบุชื่อภายในผลิตภัณฑ์เดียวจะให้ความสำคัญกับพื้นที่ทำงานนี้มากกว่าความยืดหยุ่นของการสนทนา
SciSpace
SciSpace คือพื้นที่ทำงานวิจัยแบบกว้าง ครอบคลุมการค้นหา การอ่าน การเขียน และเครื่องมืออ้างอิง โดยมีแพ็กเกจชำระเงินเริ่มต้นที่ถูกกว่า Elicit Pro การเปรียบเทียบต่าง ๆ วางกรอบให้เป็นคู่มือสำหรับการสำรวจและการเขียนที่ดีกว่า ไม่ใช่เครื่องมือสกัดที่เคร่งครัดกว่า ใช้เพื่อทำแผนที่สาขาวิชาอย่างรวดเร็ว แต่อย่าคาดหวังให้เป็นระบบบันทึกข้อมูลหลักสำหรับคอลัมน์ MSOL ตลอดการทบทวน
Consensus
Consensus ได้รับการปรับให้เหมาะกับคำถามคนละแบบ: วรรณกรรมเห็นพ้องกันเรื่องใด? สิ่งนี้มีคุณค่าสำหรับการทำความเข้าใจเบื้องต้นและคำตอบระดับข้ออ้าง แต่ไม่ใช่เครื่องมือหลักที่ถูกต้องหากสิ่งส่งมอบของคุณคือตารางรูปแบบการศึกษา ขนาดกลุ่มตัวอย่าง ค่าประมาณผล และข้อจำกัดที่จัดประเภทแล้ว ควรจับคู่กับเครื่องมือสกัด แทนที่จะใช้แทนเครื่องมือสกัด
AI สามารถสกัดรูปแบบการศึกษาและลักษณะกลุ่มตัวอย่างได้แม่นยำเพียงใด?
หลักฐานปัจจุบันระบุว่า AI สามารถทำได้เทียบเท่าผู้สกัดข้อมูลมนุษย์ในข้อมูลวิธีวิจัยและกลุ่มตัวอย่างที่เป็นมาตรฐานจำนวนมาก แต่ยังอาจพลาดหรือตีความการรายงานที่ไม่เป็นระเบียบผิดพลาดได้ ความแม่นยำสูงพอสำหรับการตรวจรอบแรก แต่ยังไม่สูงพอที่จะข้ามการตรวจสอบ
การเปรียบเทียบแบบตัวต่อตัวที่ตรงที่สุดจนถึงขณะนี้คือ SWAR แบบไม่ด้อยกว่าในปี 2026 กับ RCTs โรคเรื้อรัง 50 ฉบับ: ความแม่นยำโดยรวมไม่แตกต่างระหว่างการสกัดที่ใช้ Elicit ช่วยและการสกัดโดยมนุษย์ล้วน ขณะที่กลุ่มที่ใช้ AI ช่วยเร็วกว่าและมีต้นทุนต่ำกว่า ผลในกลุ่มย่อยไม่ได้เหมือนกันทั้งหมด กลุ่มที่ใช้ AI ช่วยมีความแม่นยำกว่าสำหรับคำอธิบายการแทรกแซง/กลุ่มควบคุมบางประเภท รูปแบบของความผิดพลาด เช่น การพลาดข้อมูลหรือความผิดพลาดเล็กน้อย มีลักษณะคล้ายกัน นี่เป็นข้อสนับสนุนให้แทนที่ผู้สกัดมนุษย์ หนึ่งคน ด้วยผู้สกัดที่ใช้ AI ช่วย ไม่ใช่สนับสนุนการสกัดแบบปล่อยทิ้งไว้โดยไม่มีผู้ดูแล
ตัวเลขที่ผู้ให้บริการรายงานสูงกว่าและควรอ่านในบริบทดังกล่าว Elicit ระบุว่า การทบทวนนโยบายการศึกษาของเยอรมนีสกัดจุดข้อมูลได้ถูกต้อง 1,502 จาก 1,511 จุด หรือ 99.4% และการเปรียบเทียบของ CSIRO พบผลลบลวงเกือบเป็นศูนย์สำหรับข้อมูลสำคัญ การทดสอบโดยห้องสมุดแยกต่างหาก รายงานว่าการสกัดด้วยโมเดลภาษาขนาดใหญ่มีความแม่นยำราว 96% ในองค์ประกอบข้อมูล 160 รายการ เมื่อมีการให้ PDF ตัวเลขเหล่านี้น่าสนับสนุนสำหรับป้ายกำกับรูปแบบ n กลุ่มทดลอง และผลลัพธ์หลัก แต่บอกได้น้อยมากว่าเครื่องมือสังเกตเห็นการคัดเลือกตัวอย่างแบบเจาะจง หรือตัวแปรกวนที่ไม่ได้ควบคุมหรือไม่
ในการปฏิบัติจริง รูปแบบการศึกษาและกลุ่มตัวอย่างมักผิดพลาดในลักษณะที่คาดเดาได้:
- รูปแบบการศึกษาถูกรายงานว่า “สุ่ม” โดยไม่มีรายละเอียดการจัดสรร
- n เป็นจำนวนที่คัดกรอง ไม่ใช่จำนวนที่นำมาวิเคราะห์
- ประชากรถูกระบุเป็นชื่อคลินิก ไม่ใช่เกณฑ์การคัดเข้า
- บริบท เช่น ชนบท โรงพยาบาลตติยภูมิ หรือเฉพาะแอป ถูกละเว้น ซึ่งต่อมาทำลายความสามารถในการสรุปอ้างอิง
การตรวจด้วย AI ที่ดีจะทำเครื่องหมายช่องว่างเหล่านี้เป็นเซลล์ว่าง การตรวจที่ไม่ดีจะประดิษฐ์ชื่อรูปแบบการศึกษาที่ดูเป็นระเบียบ เซลล์ว่างมีความเป็นวิทยาศาสตร์มากกว่าการคาดเดาที่ลื่นไหล
เครื่องมือ AI ควรจัดการผลลัพธ์ต่างจากข้อจำกัดที่ผู้เขียนระบุไว้อย่างไร?
ควรสกัดผลลัพธ์เป็นผลลัพธ์ที่รายงานไว้ พร้อมตัวเลขและช่วงเวลา ขณะที่ข้อจำกัดควรถูกประเมินใหม่ ไม่ใช่ถอดความ นี่คือช่องว่างด้านคุณภาพที่ใหญ่ที่สุดในแพลตฟอร์ม AI สำหรับงานวิจัย
การสกัดผลลัพธ์เป็นครึ่งที่ง่ายกว่า ผลลัพธ์มักอยู่ในตาราง และ Elicit ทำการตลาดเรื่องการสกัดจากตารางและรูปภาพโดยเฉพาะ เพราะจุดสิ้นสุดทางคลินิกจำนวนมากอยู่ตรงนั้น โมเดลของ Paperguide — คอลัมน์ที่กำหนดเองพร้อมการคลิกย้อนกลับไปยังประโยคสนับสนุน — เป็นรูปแบบการตรวจสอบที่เหมาะสมสำหรับขนาดอิทธิพล ช่วงความเชื่อมั่น และจำนวนผู้ตอบสนอง หากผลลัพธ์ชี้กลับไปยังแหล่งที่มาไม่ได้ ก็ไม่ควรอยู่ในตารางหลักฐาน
การสกัดข้อจำกัดเป็นงานอีกประเภทหนึ่ง ผู้เขียนมักรายงานไม่ครบ พวกเขาอาจกล่าวถึงขนาดกลุ่มตัวอย่าง แต่ละเลยตัวแปรกวน กล่าวถึง “งานวิจัยในอนาคต” แต่ข้ามวิธีคัดเลือกตัวอย่าง การประเมินความเสี่ยงของอคติควรเจาะจงต่อผลลัพธ์แต่ละรายการและมีการจัดระดับ เช่น ต่ำ / มีข้อกังวลบางประการ / สูง ตาม RoB 2 การคัดลอกย่อหน้าข้อจำกัดจึงไม่ผ่านมาตรฐานดังกล่าว
ผลลัพธ์ที่มีประโยชน์กว่าคือตารางจุดอ่อนแบบมีโครงสร้าง ได้แก่ บทความ หมวดหมู่ (อคติ ความสามารถในการสรุปอ้างอิง การรายงาน) คำอธิบายจุดอ่อนหนึ่งประโยค และหน้าหรือข้อความอ้างอิง รูปแบบนี้บังคับให้โมเดลตัดสินว่าเจอข้อจำกัด ประเภทใด
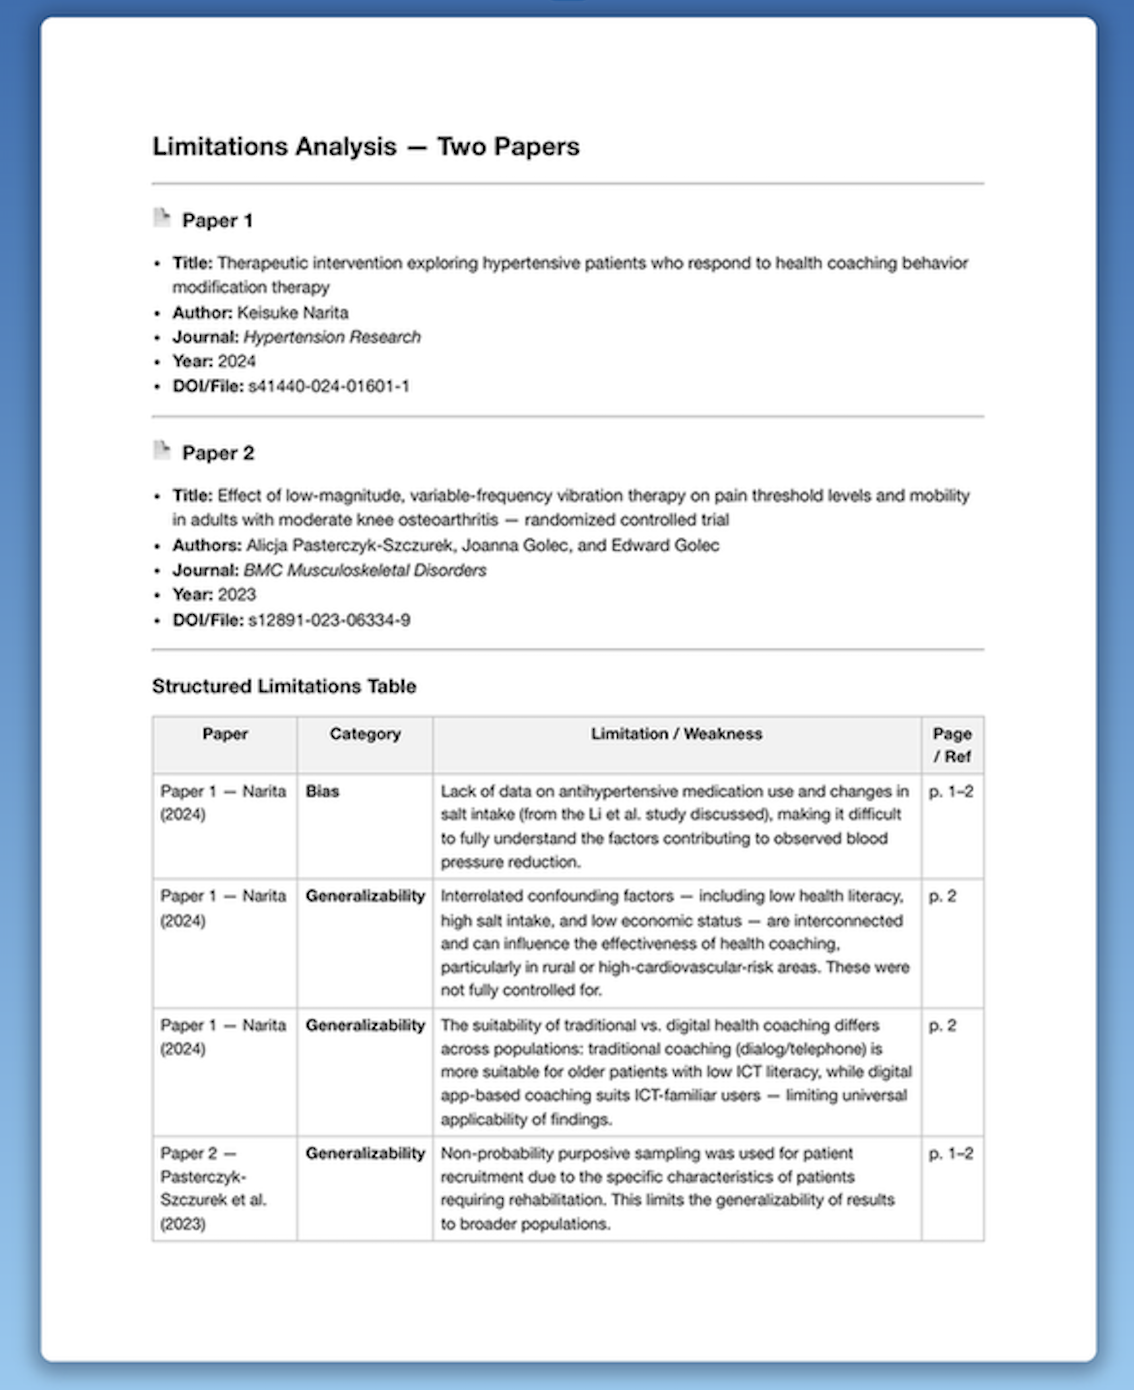
การพิจารณาเค้าโครงนี้แสดงให้เห็นว่าทำไมการสนทนาทั่วไปจึงยังไม่เพียงพอ การทดลองการโค้ชผู้ป่วยความดันโลหิตสูงอาจลดความดันโลหิตได้ แต่ไม่รายงานการใช้ยาลดความดันหรือการบริโภคเกลือ ซึ่งเป็นปัญหาอคติ บทความฉบับเดียวกันอาจผสมระดับความรอบรู้ด้านสุขภาพ อาหาร และรายได้เข้าด้วยกัน จนไม่สามารถนำผลไปใช้กับบริบทอื่นได้ ซึ่งเป็นปัญหาความสามารถในการสรุปอ้างอิง การทดลองการบำบัดด้วยแรงสั่นสะเทือนอาจใช้การคัดเลือกแบบเจาะจงในผู้ป่วยฟื้นฟูสมรรถภาพ ซึ่งก็เป็นปัญหาความสามารถในการสรุปอ้างอิงเช่นกัน ไม่ใช่เพียง “ผู้เขียนระบุว่ากลุ่มตัวอย่างมีขนาดเล็ก” เครื่องมือที่เพียงสรุปส่วน Discussion จะพลาดอนุกรมวิธานนี้
Jenova's Academic Research Assistant ค่อนข้างแข็งแกร่งในด้านนี้ เพราะคุณสามารถกำหนดให้ใช้อนุกรมวิธานดังกล่าวในคำสั่ง และคงรูปแบบเดิมไว้ตลอดชุด PDF Elicit และ Paperguide จะเก็บ ช่องข้อมูล ข้อจำกัดได้หากคุณเพิ่มคอลัมน์ แต่จะไม่คิดแบบผู้ทบทวนด้านวิธีวิจัยโดยอัตโนมัติ Consensus จะบอกคุณว่าการศึกษา “แสดงผล” หรือไม่ แต่จะไม่สร้างตารางนี้
คุณดำเนินการสกัดข้อมูลสี่ช่องกับชุด PDF หลายฉบับอย่างไร?
เริ่มจากสคีมาที่ตรึงไว้ สกัดทุกบทความลงในสี่ช่องเดียวกัน แล้วตรวจสอบตัวเลขและจัดประเภทข้อจำกัดใหม่ก่อนสังเคราะห์ สคีมาสำคัญกว่าแบรนด์ของแชตบอต
สคีมา MSOL ที่ใช้งานได้ประกอบด้วย:
- วิธีวิจัย: รูปแบบการศึกษา การสุ่ม/การปกปิดถ้ามี การแทรกแซง ตัวเปรียบเทียบ ระยะติดตาม
- กลุ่มตัวอย่าง: n ที่วิเคราะห์ ประชากร บริบท วิธีคัดเลือกตัวอย่าง
- ผลลัพธ์: ผลลัพธ์หลักพร้อมค่าสถิติ ช่วงเวลา และทิศทางของผล
- ข้อจำกัด: อคติ ความสามารถในการสรุปอ้างอิง การรายงาน — แต่ละรายการต้องมีตัวระบุตำแหน่ง
สำหรับ Jenova's Academic Research Assistant ลำดับทั่วไปคือ:
- เปิดเอเจนต์และแนบ PDF หรือโฟลเดอร์บทความที่คุณตั้งใจจะเปรียบเทียบ
- ตรึงสคีมาไว้ในข้อความแรก เพื่อให้ทุกบทความถัดไปใช้คอลัมน์เดียวกัน
- ขอให้มีตัวระบุตำแหน่งในทุกเซลล์:
“สร้างตารางหลักฐานหนึ่งตารางสำหรับบทความเหล่านี้ คอลัมน์ประกอบด้วย: การอ้างอิง รูปแบบการศึกษา กลุ่มตัวอย่าง (n ที่วิเคราะห์ ประชากร บริบท การคัดเลือกตัวอย่าง) ผลลัพธ์หลักพร้อมขนาดอิทธิพลและช่วงเวลา และข้อจำกัดที่จัดประเภทเป็นอคติ ความสามารถในการสรุปอ้างอิง หรือการรายงาน ทุกเซลล์ต้องมีเลขหน้าหรือข้อความอ้างอิง หากบทความไม่ได้รายงานข้อมูล ให้ปล่อยเซลล์นั้นว่าง ห้ามถอดความส่วนข้อจำกัดของผู้เขียนโดยไม่จัดประเภทใหม่”
- ตรวจสอบแบบสุ่ม n รูปแบบการศึกษา และขนาดอิทธิพลกับ PDF แก้ไขตารางในเธรดนั้น หน่วยความจำต่อเนื่องจะเก็บสคีมาไว้สำหรับชุดถัดไป
- หากต้องการเอกสารที่แชร์ได้ ให้ส่งตารางที่ตรวจสอบแล้วไปยัง Word Doc Generator แทนการจัดรูปแบบใหม่ด้วยมือ
- สำหรับเนื้อหาเชิงบรรยายที่วางอยู่เหนือชั้นตาราง Deep Research เป็นขั้นตอนถัดไปที่เหมาะกว่า แทนการขอให้เครื่องมือสกัดกลายเป็นการทบทวนอย่างเป็นระบบฉบับที่สอง
สำหรับ Elicit เส้นทางคู่ขนานคือรวบรวมบทความไว้ในมุมมองการทบทวนอย่างเป็นระบบหรือมุมมองการสกัด ยอมรับหรือแก้ไขคอลัมน์ที่แนะนำ สกัดพร้อมข้อความอ้างอิงรองรับ แล้วปฏิบัติต่อ AI เป็นดวงตาคู่ที่สอง ขั้นตอนการทบทวนอย่างเป็นระบบของ Elicit เองสร้างขึ้นบนแม่แบบที่แก้ไขได้ เซลล์ที่รองรับด้วยข้อความอ้างอิงหรือรูปภาพ และการตกลงเกณฑ์คัดกรองโดยมนุษย์ สำหรับ Paperguide ให้กำหนดคอลัมน์เพียงครั้งเดียว สกัดข้อมูลในชุดที่เลือก แล้วส่งออก CSV/Excel เมื่อกริดมีเสถียรภาพ
มีรูปแบบการทำงานที่ไม่ควรทำสองอย่าง อย่าสกัด 40 บทความด้วยคำสั่ง 40 แบบที่แตกต่างกันเล็กน้อย และอย่าปล่อยให้โมเดลกรอกช่องว่างด้วย “น่าจะเป็น RCT” หรือ “กลุ่มตัวอย่างเพียงพอ” ช่องว่างคือข้อค้นพบ
ผู้เชี่ยวชาญด้านการสังเคราะห์หลักฐานกล่าวอย่างไรเกี่ยวกับการสกัดข้อมูลด้วย AI?
นักระเบียบวิธีวิจัยมอง AI ว่าเป็นผู้สกัดคนที่สองที่ใช้งานได้อย่างถูกต้องมากขึ้นสำหรับช่องข้อมูลที่เป็นมาตรฐาน โดยมีเงื่อนไขว่าทุกค่ายังคงตรวจสอบได้ และการประเมินข้อจำกัดยังต้องนำโดยมนุษย์ ฉันทามติที่กำลังก่อตัวมีขอบเขตแคบและเน้นการปฏิบัติ ไม่ใช่อุดมคติที่เกินจริง
“การถกเถียงเรื่องความแม่นยำส่วนใหญ่มีข้อสรุปแล้วสำหรับคอลัมน์ที่ง่าย ได้แก่ ป้ายกำกับรูปแบบการศึกษา n ชื่อกลุ่มทดลอง และผลลัพธ์หลักตามที่รายงาน การเปรียบเทียบแบบควบคุมในปัจจุบันแสดงว่า การสกัดที่ใช้ AI ช่วยสามารถเทียบเท่าผู้สกัดมนุษย์ในช่องข้อมูลเหล่านั้นและเสร็จเร็วกว่า รูปแบบความล้มเหลวที่ยังเหลืออยู่คือเชิงตีความ: โมเดลคัดลอกข้อควรระวังของผู้เขียนแล้วเรียกสิ่งนั้นว่าการประเมินเชิงวิพากษ์ นั่นไม่ใช่การประเมินความเสี่ยงของอคติ และ PRISMA ยังคงคาดหวังให้คุณอธิบายว่าอคติถูกตัดสินอย่างไร”
“สิ่งที่เรามองหาในแพลตฟอร์มไม่ใช่บทสรุปที่สวยกว่า แต่คือนโยบายสำหรับเซลล์ว่าง ตัวระบุตำแหน่งสำหรับทุกตัวเลข และสคีมาข้อจำกัดที่บันทึกตัวแปรกวน การคัดเลือกตัวอย่าง และความเที่ยงตรงภายนอกได้ แม้บทความจะไม่เคยใช้คำเหล่านั้น หากคุณคลิกย้อนจากขนาดกลุ่มตัวอย่างกลับไปยังประโยคไม่ได้ คุณไม่ได้มีการสกัดข้อมูล คุณมีเพียงร่างเอกสาร”
“เลือกเครื่องมือให้ตรงกับลักษณะของชุดข้อมูล ผลิตภัณฑ์สกัดข้อมูลเฉพาะทางชนะเมื่อชุดการทดลองมีขนาดใหญ่และเป็นเนื้อเดียวกัน เอเจนต์วิจัยแบบสนทนาชนะเมื่อบทความมีความหลากหลาย PDF รกรุงรัง และคำถามวิทยาศาสตร์คือ ‘เราสรุปอะไรไม่ได้บ้าง?’ โครงการระดับบัณฑิตศึกษาและโครงการทางคลินิกจริงส่วนใหญ่อยู่ในประเภทหลัง”
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเวิร์กโฟลว์วิจัยวิชาการ (จากประสบการณ์ในการสร้างเอเจนต์ AI สำหรับการทบทวนวรรณกรรมและตารางหลักฐาน)
มุมมองนี้สอดคล้องกับหลักฐานภายนอก: การสกัดที่ใช้ AI ช่วยมีประสิทธิภาพไม่ด้อยกว่าในการศึกษา SWAR ปี 2026 มีผลการทำงานสูงกับตัวแปรที่เป็นมาตรฐานในการศึกษาแนวผู้ทบทวน และแนวทางห้องสมุดที่ยังให้มนุษย์เป็นผู้ตัดสินขั้นสุดท้าย
เมื่อใดเอเจนต์วิจัยที่ยืดหยุ่นจึงเหมาะกว่าระบบสกัดข้อมูลเฉพาะทาง?
เอเจนต์วิจัยที่ยืดหยุ่นเหมาะกว่าเมื่อชุดบทความของคุณมีขนาดเล็กถึงกลาง รูปแบบการศึกษาหลากหลาย และทักษะที่ขาดแคลนคือการตีความข้อจำกัด ไม่ใช่การคัดกรองชื่อเรื่อง 10,000 รายการ แพลตฟอร์มเฉพาะทางเหมาะกว่าเมื่อโพรโทคอล การทบทวนโดยสองคน และจำนวนตาม PRISMA คือสิ่งส่งมอบหลัก
เลือกเครื่องมือสกัดเฉพาะทาง เช่น Elicit หรือ Paperguide เมื่อ:
- คุณกำลังดำเนินการทบทวนอย่างเป็นระบบหรือทบทวนเชิงขอบเขตด้วยโพรโทคอลที่ลงทะเบียนล่วงหน้า
- การศึกษาส่วนใหญ่ที่รวมไว้เป็นการทดลองหรือรายงานที่มีแม่แบบชัดเจนมาก
- คุณต้องการบันทึกการคัดกรอง เหตุผลในการคัดออก และแผนภาพลำดับงาน
- ผู้ทบทวนหลายคนต้องแก้ไขความขัดแย้งในระเบียนเดียวกัน
เลือก Jenova's Academic Research Assistant เมื่อ:
- คุณกำลังเขียนบทวิทยานิพนธ์ ภูมิหลังข้อเสนอทุน วารสารสโมสร หรือการสำรวจหลักฐานอย่างรวดเร็ว
- บทความผสมทั้ง RCTs การศึกษาเชิงสังเกต และงานเชิงคุณภาพ
- คุณให้ความสำคัญกับข้อจำกัดที่จัดประเภทแล้วมากกว่าคอลัมน์ PICO ที่ระบบแนะนำอัตโนมัติ
- คุณทำงานข้ามโมเดล PDF ที่อัปโหลด และคำถามติดตามในเธรดเดียวอยู่แล้ว
การใช้งานแบบผสมเป็นเรื่องปกติและสมเหตุสมผล ทำแผนที่คำถามใน SciSpace หรือ Consensus สกัดช่อง MSOL ใน Jenova หรือ Elicit และจัดการบัญชีตาม PRISMA ในโมดูลทบทวนที่สถาบันของคุณยอมรับ การเปรียบเทียบ SciSpace กับ Consensus อธิบายการแบ่งงานนี้ไว้อย่างชัดเจน: Consensus สำหรับการอ่านฉันทามติอย่างรวดเร็ว และ SciSpace สำหรับการค้นคืนข้อมูลที่หนาแน่นกว่า ไม่มีการจับคู่ใดตัดการตรวจสอบ n ผลลัพธ์ และอคติโดยมนุษย์ออกไปได้
ข้อจำกัดของ Jenova ในทางเลือกนี้คือขนาดและความเป็นทางการ มันจะไม่แทนที่กระบวนการคัดกรองระดับองค์กร ข้อจำกัดของ Elicit เป็นภาพกลับด้าน: มีกริดที่ยอดเยี่ยม แต่สนับสนุนงานเชิงโต้แย้งที่ยุ่งเหยิงในการอธิบายว่าเหตุใดผลการศึกษาจึงไม่ควรถูกนำไปใช้กับบริบทอื่นได้น้อยกว่า หากสิ่งส่งมอบของคุณคือตารางหลักฐานที่อาจารย์ที่ปรึกษาตรวจสอบได้ ให้ให้คะแนนเครื่องมือตามความครบถ้วนของ MSOL และที่มาก่อน แล้วจึงพิจารณาแบรนด์หรือราคารายเดือน
เอกสารอ้างอิง
- PRISMA — แนวทางการรายงานสำหรับการทบทวนอย่างเป็นระบบ
- DistillerSR — เครื่องมือและเทคนิคการสกัดข้อมูลสำหรับการทบทวนอย่างเป็นระบบ
- medRxiv — ความแม่นยำและประสิทธิภาพของการสกัดข้อมูลที่ใช้ AI ช่วยด้วย Elicit (SWAR ปี 2026)
- Paperguide — เครื่องมือ AI สำหรับการทบทวนอย่างเป็นระบบและการลดภาระงานที่รายงาน
- The BMJ — แถลงการณ์ PRISMA 2020
- PubMed Central — คำอธิบายและรายละเอียดเพิ่มเติมของ PRISMA 2020 รวมถึงมิติของ RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — เครื่องมือ AI ในฐานะผู้ทบทวนคนที่สองสำหรับการสกัดข้อมูล
- King’s College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- PapersFlow — การเปรียบเทียบ Elicit กับ Consensus
- Paperguide — การเปรียบเทียบคุณสมบัติและราคาของ Elicit กับ SciSpace (2026)
- George Mason University — เครื่องมือ AI สำหรับการทบทวนวรรณกรรม
- Elicit — AI สำหรับงานวิจัยวิทยาศาสตร์ ขนาดคลังข้อมูล และตัวเลขการใช้งาน
- Elicit — เวิร์กโฟลว์การทบทวนวรรณกรรมอย่างเป็นระบบ ข้ออ้างด้านความแม่นยำในการสกัด และการคัดกรอง
- SciSpace — การเปรียบเทียบ SciSpace กับ Elicit รวมถึงระดับราคาในปี 2026
- Paperguide — เอกสารแพลตฟอร์มสำหรับคอลัมน์การสกัดแบบกำหนดเองและค่าที่เชื่อมโยงกับแหล่งข้อมูล
- Himmelfarb Health Sciences Library — คุณภาพการรายงานและความเสี่ยงของอคติ
- Birmingham City University — ข้อสังเกตเกี่ยวกับความแม่นยำของการสกัดข้อมูลด้วย AI
- Paperguide — การเปรียบเทียบ SciSpace กับ Consensus