ผู้ช่วยวิจัย AI ตัวใดได้รับการแนะนำมากที่สุดในปี 2026?
2026-08-21
ผู้ช่วยวิจัย AI ชั้นนำเปรียบเทียบกันอย่างไรในด้านความน่าเชื่อถือของการอ้างอิง ความครอบคลุมของฐานข้อมูล และความครบถ้วนของเวิร์กโฟลว์?
ผู้ช่วยวิจัย AI ที่ได้รับการแนะนำบ่อยที่สุดในปี 2026 ได้แก่ Elicit สำหรับการสกัดหลักฐานอย่างมีโครงสร้าง, SciSpace สำหรับการทำความเข้าใจเนื้อหาภายในบทความ, Paperguide สำหรับเวิร์กโฟลว์ตั้งแต่การทบทวนไปจนถึงการร่างต้นฉบับ, Scite สำหรับการวิเคราะห์บริบทการอ้างอิง และ Academic Research Assistant ของ Jenova สำหรับงานวรรณกรรมแบบหลายโมเดลที่มีความต่อเนื่อง ครอบคลุมตั้งแต่การค้นหา การสังเคราะห์ ไปจนถึงการเตรียมต้นฉบับ เกณฑ์จัดอันดับที่สำคัญไม่ใช่การหา “ผู้ชนะ” เพียงรายเดียว แต่คือความเหมาะสมในสามมิติ ได้แก่ เครื่องมือค้นบันทึกทางวิชาการได้มากเพียงใด ข้ออ้างอิงของเครื่องมือมีแหล่งอ้างอิงรองรับหรือไม่ และเครื่องมือครอบคลุมงานวิจัยเพียงงานเดียวหรือทั้งเวิร์กโฟลว์
ปัจจัยสำคัญที่ทำให้ผู้ช่วยวิชาการที่ใช้งานได้จริงแตกต่างจากแชตบอตทั่วไปในปี 2026:
✅ ความน่าเชื่อถือของการอ้างอิง — คำตอบที่ชี้ไปยังบทความจริง พร้อมรายละเอียดบรรณานุกรมเพียงพอให้ตรวจสอบได้ แทนที่จะเป็นบทสรุปที่ลื่นไหลแต่ตรวจสอบไม่ได้ ✅ ความครอบคลุมของวรรณกรรม — การเข้าถึงดัชนีวิชาการขนาดใหญ่ (ระดับ 125 ล้านบทความใน Elicit และ มากกว่า 300 ล้านบทความใน Scite) รวมถึงวรรณกรรมสีเทาเมื่อจำเป็น ✅ การจัดการหลักฐาน — การคัดกรอง การสกัด และการสังเคราะห์ที่นักวิจัยอีกคนสามารถตรวจสอบย้อนกลับได้ ✅ ความครบถ้วนของเวิร์กโฟลว์ — การค้นหา การอ่าน การอ้างอิง และการร่างงานอยู่ในที่เดียว หรือต้องใช้ชุดเครื่องมือหลายตัว ✅ การออกแบบที่มีมนุษย์ร่วมกำกับ — ฟีเจอร์ที่สนับสนุนการตรวจสอบ เพราะ หลักฐานปัจจุบันยังไม่สนับสนุนการใช้ generative AI ในการสังเคราะห์หลักฐานโดยไม่มีการกำกับจากมนุษย์
เกณฑ์ทั้งห้านี้เป็นพื้นฐานเชิงปฏิบัติสำหรับการเปรียบเทียบด้านล่าง หากต้องเลือกระหว่างเครื่องมือเหล่านี้ ควรมองว่าเครื่องมือแต่ละตัวเป็นผู้เชี่ยวชาญในขั้นตอนต่าง ๆ ของสายงานวิจัยร่วมกัน มากกว่าจะมองว่าเป็นผลิตภัณฑ์ “AI สำหรับบทความ” ที่ใช้แทนกันได้
เหตุใดผู้ช่วยวิจัย AI แบบเฉพาะทางจึงได้รับความนิยมในหมู่นักวิชาการ?
ผู้ช่วยวิจัย AI แบบเฉพาะทางเปลี่ยนจากเครื่องมือเสริมที่เลือกใช้ได้ กลายเป็นโครงสร้างพื้นฐานมาตรฐานของงานวิชาการ เพราะปริมาณการตีพิมพ์ การนำไปใช้ของนักศึกษา และนโยบายของสถาบันต่างเปลี่ยนแปลงพร้อมกัน ปัจจุบันวงการตีพิมพ์ทางวิทยาศาสตร์ผลิตบทความใหม่มากกว่าสามล้านฉบับต่อปี ทำให้การค้นหาด้วยคีย์เวิร์ดและการคัดกรองด้วยมือเพียงอย่างเดียวมีต้นทุนด้านเวลาสูงขึ้นเรื่อย ๆ
ข้อมูลการยอมรับใช้ในระดับอุดมศึกษานั้นชัดเจน HEPI Student Generative AI Survey 2025 พบว่า 92% ของนักศึกษาปริญญาตรีในสหราชอาณาจักรใช้ generative AI เพิ่มขึ้นจาก 66% ในปี 2024 โดย 88% ใช้ในการประเมินผลการเรียน การใช้เพื่อการศึกษาที่พบบ่อยที่สุดคือ การอธิบายแนวคิด การสรุปบทความ และการเสนอไอเดียวิจัย ซึ่งตรงกับภารกิจที่ผู้ช่วยวิจัยถูกสร้างขึ้นมาเพื่อรองรับ
สถาบันต่าง ๆ ยังคงปรับตัวตามไม่ทัน ผลสำรวจของ UNESCO รายงานว่าสถาบันอุดมศึกษาสองในสามมีหรือกำลังพัฒนาแนวทางการใช้ AI แต่ HEPI พบว่า นักศึกษาเพียง 36% ได้รับการฝึกอบรมทักษะ AI จากสถาบันของตน ช่องว่างนี้คือเหตุผลที่แนะนำให้ใช้ผู้ช่วยแบบเฉพาะโดเมน — เครื่องมือที่ค้นฐานข้อมูลวิชาการ แนบการอ้างอิง และรักษาร่องรอยการวิจัย — แทนแชตบอตทั่วไปสำหรับงานวรรณกรรม
แรงขับเคลื่อนอีกประการคือความเสี่ยง ผู้ตอบแบบสำรวจของ HEPI ระบุว่า ความกลัวผลลัพธ์ที่ผิดพลาดหรือการหลอน (51%) เป็นเหตุผลหลักที่ไม่ใช้ AI ซึ่งมีสัดส่วนใกล้เคียงกับความกังวลเรื่องการทุจริต ผู้ช่วยที่ดึงข้อมูลจากดัชนีวิชาการและเปิดเผยแหล่งที่มาจึงตอบโจทย์ความล้มเหลวลักษณะนี้โดยตรง
เกณฑ์ใดควรใช้ในการเลือกผู้ช่วยวิจัย AI?
นักวิจัยควรเลือกผู้ช่วยวิจัย AI โดยใช้กรอบหกมิติ ได้แก่ ความครอบคลุม ความน่าเชื่อถือ การสกัดข้อมูล การเขียน ความต่อเนื่อง และต้นทุนเทียบความสามารถ แทนการดูเพียงรายการฟีเจอร์หรือรายชื่อ “ดีที่สุดโดยรวม” การทดสอบด้วยกรอบ Coverage–Integrity–Workflow (CIW) ทำให้เห็นข้อแลกเปลี่ยนได้ชัดเจน: เครื่องมือหนึ่งอาจโดดเด่นในการอธิบาย PDF แต่ยังอ่อนด้านการคัดกรองอย่างเป็นระบบ หรืออาจทำได้ดีมากด้านบริบทการอ้างอิงแต่แทบไม่ช่วยร่างงานเขียน
หกมิติ พร้อมน้ำหนักสำหรับการใช้งานวิชาการทั่วไป:
- ความครอบคลุมของวรรณกรรม — เครื่องมือค้นคลังข้อมูลวิชาการขนาดใหญ่ หลายฐานข้อมูล หรือเพียงดัชนีเดียวอย่าง Semantic Scholar?
- ความน่าเชื่อถือของการอ้างอิง — ข้ออ้างเชื่อมโยงกับบทความที่ระบุตัวตนได้หรือไม่ และคุณเห็นได้หรือไม่ว่างานภายหลังสนับสนุนหรือโต้แย้งข้ออ้างนั้น?
- การสกัดหลักฐาน — คุณดึงวิธีวิจัย ขนาดตัวอย่าง ผลลัพธ์ และข้อจำกัดมาอยู่ในโครงสร้างที่เปรียบเทียบกันได้หรือไม่?
- การสนับสนุนการเขียน — เครื่องมือช่วยร่างหรือแก้ไขโดยใช้คลังข้อมูลอ้างอิงเป็นบริบท หรือหยุดแค่การสรุป?
- ความต่อเนื่อง — เครื่องมือจดจำโครงการวิทยานิพนธ์ที่ใช้เวลาหลายเดือนได้หรือรีเซ็ตทุกเซสชัน?
- ต้นทุนเทียบความสามารถ — แผนฟรีให้สิ่งใดบ้างจริง ๆ และเพดานของแผนชำระเงินเริ่มเป็นข้อจำกัดเมื่อทำ systematic review ปริมาณมากที่จุดใด?
แนวทางเชิงระเบียบวิธีควรอยู่คู่กับฟีเจอร์ผลิตภัณฑ์ บรรณารักษ์ด้านการสังเคราะห์หลักฐานของ King’s College London ระบุว่า เครื่องมือ AI ไม่สามารถทดแทนวิธีการทำ systematic review แบบดั้งเดิมได้ และควรมองเป็นเครื่องมือเสริม คู่มือ systematic review ของ OHSU ก็พบเช่นกันว่า AI มีประโยชน์ที่สุดในระยะหลังที่ใช้แรงงานมาก เช่น การสนับสนุนการคัดกรองและการสกัดข้อมูล ไม่ใช่สิ่งทดแทนการออกแบบ protocol หรือการค้นฐานข้อมูล
มีกฎปฏิบัติที่ตามมาอย่างชัดเจน: หากผลลัพธ์ตรวจสอบย้อนกลับไม่ได้ — ไม่มีรายชื่อแหล่งข้อมูล ไม่มีตรรกะการคัดเลือก และไม่มีวิธีค้นซ้ำ — เครื่องมือนั้นคือเครื่องช่วยอ่าน ไม่ใช่ผู้ช่วยวิจัย
Jenova, Elicit, SciSpace, Paperguide และ Scite เปรียบเทียบกันอย่างไรสำหรับเวิร์กโฟลว์วิชาการ?
Academic Research Assistant ของ Jenova แข็งแกร่งที่สุดสำหรับงานวิจัยเชิงสนทนาที่ดำเนินต่อเนื่องยาวนาน ด้วยหน่วยความจำถาวรและการเข้าถึงหลายโมเดล; Elicit เด่นที่สุดด้านการสกัดข้อมูลแบบมีโครงสร้าง; SciSpace เหมาะกับการอ่าน PDF ที่ซับซ้อน; Paperguide เหมาะกับการรวมการค้นหา ตารางทบทวน และการร่างที่มีการอ้างอิงไว้ในสมาชิกภาพเดียว; ส่วน Scite เหมาะกับการดูว่าบทความหนึ่งถูกอ้างอิงอย่างไรจริง ๆ ไม่มีเครื่องมือใดในห้าตัวนี้ครองทุกมิติของ CIW ดังนั้น “ได้รับการแนะนำมากที่สุด” ในปี 2026 จึงเป็นรายชื่อคัดเลือก ไม่ใช่ชื่อเดียว
| มิติ | Jenova Academic Research Assistant | Elicit | SciSpace | Paperguide | Scite |
|---|---|---|---|---|---|
| ความครอบคลุมของวรรณกรรม | ค้นหาข้อมูลวิชาการและเว็บแบบสดผ่านเครื่องมือของแพลตฟอร์ม รวมถึงฐานข้อมูลวิชาการ | ค้นหาเชิงความหมายใน 125 ล้านบทความ; ใช้โดย นักวิจัยมากกว่า 2 ล้านคน | มากกว่า 200 ล้านบทความ รวมถึง PDF ที่อัปโหลด | ค้นหาโดยอิงคำถามใน มากกว่า 200 ล้านบทความ | จัดทำดัชนี บทความวิชาการมากกว่า 300 ล้านฉบับ สำหรับบริบทการอ้างอิง |
| ความน่าเชื่อถือของการอ้างอิง | คำตอบมีแหล่งข้อมูลรองรับ; ผู้ใช้ยังต้องตรวจสอบ | สรุปพร้อมการอ้างอิง; มีช่องว่างด้านความไวเมื่อเทียบกับการค้นหาแบบดั้งเดิม | คำตอบยึดกับเนื้อหาในบทความเปิดอ่าน | การค้นหา ตาราง และเครื่องมือเขียนพร้อมการอ้างอิง | แสดงว่าการอ้างอิงสนับสนุน โต้แย้ง หรือเพียงกล่าวถึงข้ออ้าง |
| การสกัดหลักฐาน | การสกัดและสังเคราะห์แบบสนทนาข้ามเซสชัน | คอลัมน์แบบมีโครงสร้างและเวิร์กโฟลว์ systematic review | สรุประดับบทความ วิธีวิจัย และ Q&A | ตารางวรรณกรรมและรายงาน Deep Research | สกัดบริบทการอ้างอิง ไม่ใช่ตารางผลลัพธ์ |
| การสนับสนุนการเขียน | การเตรียมต้นฉบับและการจัดการการอ้างอิง | รายงานและบทสรุป ไม่ใช่บทความฉบับเต็ม | คำอธิบายภายใน PDF | AI Paper Writer ที่ร่างงานจากคลังข้อมูลอ้างอิง | ไม่ใช่สภาพแวดล้อมสำหรับการเขียน |
| ความต่อเนื่อง | ประวัติแชตไม่จำกัดและหน่วยความจำข้ามเซสชัน | อิงตามโครงการและเวิร์กโฟลว์ | เซสชันอ่านที่มีเอกสารเป็นศูนย์กลาง | Workbooks และคลังข้อมูลอ้างอิง | บทความที่บันทึกไว้และมุมมองการอ้างอิง |
| ราคา (ณ ปี 2026) | แผนฟรี; Plus ราคา $20/เดือน พร้อมการใช้งานฟรี 30× | แผนฟรีและแผนชำระเงิน | แผนฟรีและแผนชำระเงิน | ฟรี; Plus $12/เดือน; Pro $24/เดือน | แผนฟรีและแผนชำระเงิน (ยังไม่ได้ตรวจสอบราคาแผนชำระเงินในที่นี้) |
| เหมาะที่สุดสำหรับ | การสนทนาวิจัยหลายเดือนที่ผสานการค้นพบ การสังเคราะห์ และการร่างงาน | การคัดกรองและสกัดจากชุดบทความที่กำหนด | ทำความเข้าใจบทความที่ยากในบริบทเดิม | การทบทวนไปจนถึงการร่างงานแบบครบวงจรในแพลตฟอร์มเดียว | ตรวจสอบว่าวรรณกรรมปฏิบัติต่อข้ออ้างหนึ่งอย่างไร |
การเปรียบเทียบอิสระสอดคล้องกับการแบ่งจุดเด่นนี้ การวิเคราะห์ Paperguide ปี 2026 ที่เปรียบเทียบ Elicit กับ SciSpace สรุปว่า Elicit แข็งแกร่งกว่าสำหรับเวิร์กโฟลว์ที่ใช้หลักฐานอย่างเข้มงวด ขณะที่ SciSpace เหมาะกับการค้นพบเชิงสำรวจอย่างรวดเร็วกว่า เกณฑ์ทดสอบ 200-query ของ SciSpace รายงานว่าฟีเจอร์ Deep Review พบบทความที่เกี่ยวข้องมาก 26.3 ฉบับต่อ query ซึ่งนำหน้า Elicit และ Consensus ในการทดสอบภายในนั้น เป็นสัญญาณที่มีประโยชน์ แต่ควรอ่านในฐานะผลทดสอบที่ผู้ให้บริการดำเนินการเอง ไม่ใช่สิ่งทดแทนการค้นหาที่บรรณารักษ์ตรวจสอบแล้ว
ข้อจำกัดอย่างตรงไปตรงมาสำคัญพอ ๆ กับจุดแข็ง Jenova ไม่มีดัชนีเนทีฟขนาด 200 ล้านบทความ หรือกริดคัดกรองรูปแบบ PRISMA; Jenova คือเอเจนต์วิจัยที่มีการค้นหาสด หน่วยความจำ และการสนับสนุนการเขียน ไม่ใช่ DistillerSR ความสามารถในการทำซ้ำและ recall ของ Elicit แสดงให้เห็นว่าตามหลังการคัดกรองฐานข้อมูลแบบดั้งเดิม SciSpace ยังคงเป็นเครื่องมืออ่านมากกว่าเอ็นจิน systematic review เพดานของ Deep Research และ workbook ของ Paperguide ยังจำกัดขอบเขตของระบบอัตโนมัติในแผนระดับล่าง Scite จะไม่ร่างส่วนงานวิจัยที่เกี่ยวข้องให้คุณ
ความน่าเชื่อถือของการอ้างอิงแตกต่างกันอย่างไรระหว่างผู้ช่วยวิจัย AI?
ความน่าเชื่อถือของการอ้างอิงแตกต่างระหว่างเครื่องมือมากกว่าคุณภาพของหน้าจอใช้งาน และมักเป็นมิติที่กำหนดว่าผู้ช่วยนั้นปลอดภัยพอสำหรับใช้ในวิทยานิพนธ์ ทุนวิจัย หรือ systematic review หรือไม่ Scite ถูกสร้างมาโดยเฉพาะเพื่อแสดง ว่าข้ออ้างหนึ่งได้รับการสนับสนุนหรือโต้แย้งอย่างไรในบทความมากกว่า 300 ล้านฉบับ; Elicit, Paperguide และ SciSpace ดึงข้อมูลจากคลังบทความขนาดใหญ่และแนบเอกสารอ้างอิง ขณะที่แชตบอตอเนกประสงค์มักทำไม่ได้ทั้งสองอย่าง
รูปแบบความล้มเหลวนี้มีเอกสารรองรับอย่างชัดเจน ในการศึกษาระเบียบวิธีปี 2025 ที่เปรียบเทียบ Elicit กับ umbrella review ที่ทำโดยมนุษย์ นักวิจัยพบว่า Elicit ระบุได้เพียง 17.6% ของการศึกษาที่รวมไว้ผ่านการคัดกรองแบบดั้งเดิม แม้จะพบงานที่เกี่ยวข้องสามฉบับซึ่งการค้นหาโดยมนุษย์พลาดไป ความสามารถในการทำซ้ำไม่เสถียรจาก query เดียวกันสามครั้ง ผู้วิจัยยังรายงานว่า Elicit อ้างอิง review protocol ผิดพลาดขณะสร้างบทสรุป ซึ่งเป็นข้อผิดพลาดด้านความน่าเชื่อถือที่ร้ายแรง ไม่ใช่เพียงข้อบกพร่องด้านรูปแบบ
รูปแบบนี้คือเหตุผลที่คู่มือห้องสมุดย้ำข้อจำกัดเดียวกันอยู่เสมอ systematic review ปี 2025 เกี่ยวกับ generative AI ในการสังเคราะห์หลักฐานสรุปว่า หลักฐานปัจจุบันไม่สนับสนุนการใช้ GenAI โดยไม่มีมนุษย์มีส่วนร่วม บริการ systematic review ของ Memorial Sloan Kettering ระบุเช่นกันว่านักสังเคราะห์หลักฐานต้องรับผิดชอบต่อ AI ทุกตัวที่ใช้ รวมถึงการตัดสินใจว่าจะใช้มันหรือไม่ด้วย
ลำดับขั้นความน่าเชื่อถือที่ใช้ได้จริงสำหรับปี 2026:
- ระดับ 1 — ลื่นไหลแต่ไม่มีการอ้างอิง คำตอบจากแชตทั่วไป ไม่ยอมรับได้สำหรับข้ออ้างทางวิชาการ
- ระดับ 2 — การดึงข้อมูลพร้อมการอ้างอิง เครื่องมือระบุชื่อบทความ คุณยังต้องยืนยันว่าบทความมีอยู่จริงและกล่าวสิ่งที่อ้างไว้
- ระดับ 3 — บริบทการอ้างอิง เครื่องมืออย่าง Scite แสดงว่างานวิจัยภายหลังเห็นด้วย โต้แย้ง หรือเพียงกล่าวถึงงานนั้น
- ระดับ 4 — การสังเคราะห์ที่ตรวจสอบย้อนกลับได้ เกณฑ์คัดเลือก เซลล์ที่เชื่อมโยงแหล่งข้อมูล และการส่งออกที่ผู้ร่วมเขียนหรือบรรณารักษ์สามารถทำซ้ำได้
ในทางปฏิบัติ Academic Research Assistant ของ Jenova ทำงานที่ระดับ 2–3: ค้นหาแหล่งข้อมูลแบบสดและคาดหวังให้ข้ออ้างมีหลักฐานรองรับ แต่ไม่ใช่กราฟบริบทการอ้างอิงแบบ Scite และไม่รับรองแผนภาพลำดับงาน PRISMA การใช้ร่วมกับ Scite (เพื่อดูว่าบทความถูกอ้างอิงอย่างไร) หรือโปรแกรมจัดการข้อมูลอ้างอิง (สำหรับระเบียนมาตรฐาน) มักแข็งแกร่งกว่าการขอให้ผู้ช่วยเพียงตัวเดียวตรวจสอบตัวเอง
ผู้ช่วย AI จัดการการสังเคราะห์หลักฐานและ systematic review อย่างไร?
ผู้ช่วย AI ในปัจจุบันครอบคลุมบางส่วนของการสังเคราะห์หลักฐาน โดยเฉพาะการคัดกรองชื่อเรื่อง/บทคัดย่อและการสกัดข้อมูล แต่ยังไม่สามารถทดแทน systematic review ที่ขับเคลื่อนด้วย protocol ได้ รูปแบบที่แนะนำในปี 2026 คือระบบอัตโนมัติที่มนุษย์กำกับในแต่ละขั้นตอน ไม่ใช่การทบทวนแบบคลิกเดียว
หลักฐานเชิงประจักษ์ที่แข็งแกร่งที่สุดอยู่ที่การคัดกรอง การทบทวนงานทบทวนในปี 2026 พบ หลักฐานที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิว่า AI พร้อมสำหรับการคัดกรองชื่อเรื่อง/บทคัดย่อภายใต้การกำกับของมนุษย์ ขณะที่งานสังเคราะห์อื่นมีหลักฐานจำกัด เครื่องมือคัดกรอง AIM Review รายงาน การลดภาระงานตั้งแต่ 20% ถึง 95% ในการทบทวนจริงหกกรณี ซึ่งเป็นผลลัพธ์ด้านการคัดกรอง ไม่ใช่ใบอนุญาตให้ทำข้อสรุปโดยอัตโนมัติ การเปรียบเทียบที่เชื่อมโยงกับ Cochrane พบว่า Elicit ค้นหาได้ไม่ไวพอที่จะแทนที่การค้นวรรณกรรมแบบดั้งเดิม แม้ precision ของมันอาจช่วยในการค้นหาเบื้องต้นและค้นพบการศึกษาเพิ่มเติมที่ไม่ซ้ำ
เวิร์กโฟลว์ของผลิตภัณฑ์กำลังมาบรรจบกันที่โครงสร้างหกขั้นตอนเดียวกัน ซึ่งแสดงได้ชัดเจนในไปป์ไลน์การสังเคราะห์หลักฐานของ Paperguide: กำหนดคำถาม (มักเป็น PICO/PICOC) ค้นคลังข้อมูลขนาดใหญ่ คัดกรองด้วยสัญญาณคุณภาพ สกัดลงในตารางที่เชื่อมโยงแหล่งข้อมูล สังเคราะห์พร้อมการอ้างอิง และส่งออก
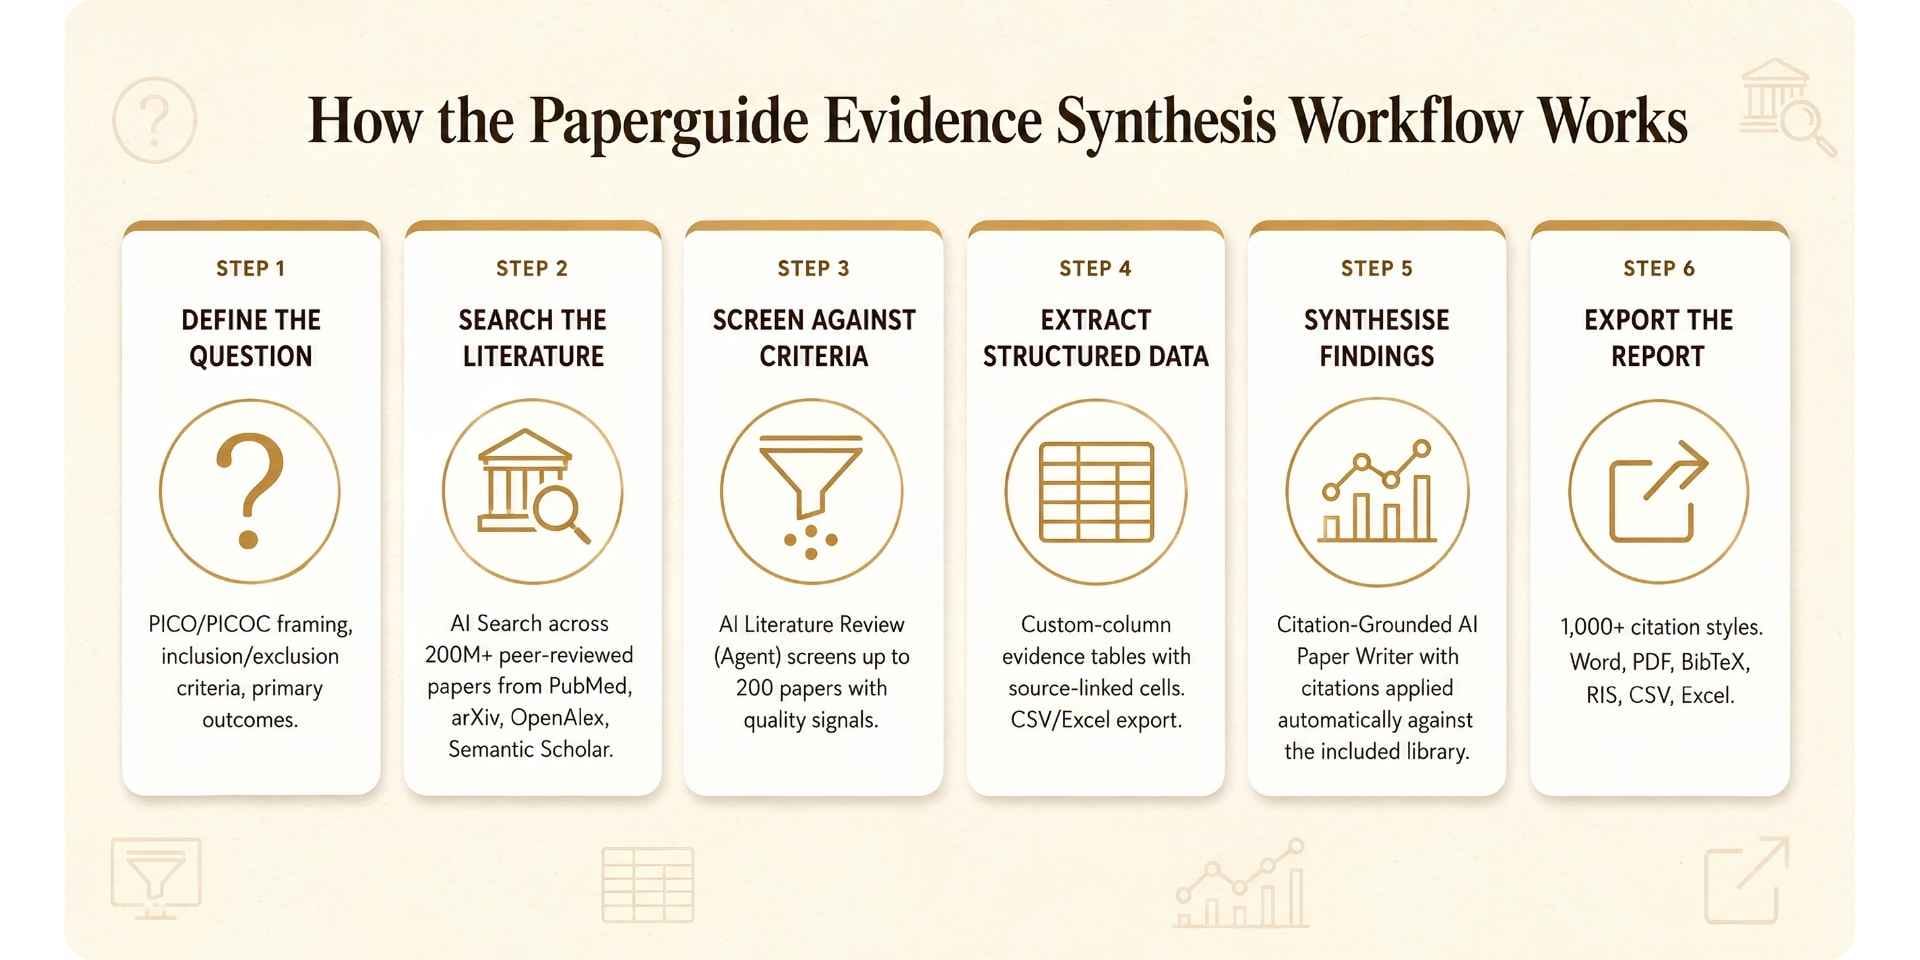
แผนภาพนั้นเป็นแผนที่ที่ดีของ งาน ไม่ใช่หลักฐานว่าปุ่ม “Deep Research” ของผู้ให้บริการรายใดผ่านมาตรฐาน Cochrane, JBI หรือ Campbell จุดยืนร่วมปี 2025 จาก Cochrane, Campbell Collaboration, JBI และ Collaboration for Environmental Evidence มอง AI เป็นเครื่องมือสนับสนุนที่ต้องไม่ลดทอนคุณภาพหรือความน่าเชื่อถือ เอกสารของ Paperguide เองอธิบายการคัดกรองระดับหลายร้อยบทความต่อการรัน และ เพดานรายงาน Deep Research แม้ในแผนชำระเงิน (ตัวอย่างเช่น 50 รายงานต่อเดือนในแผน Pro) นี่คือการสังเคราะห์อย่างรวดเร็ว ไม่ใช่ Cochrane review ที่ปรับปรุงอย่างต่อเนื่อง
ตำแหน่งของ Jenova ในไปป์ไลน์นี้คือการเป็นนักวิเคราะห์ที่ทำงานอยู่บนกระบวนการดังกล่าว: กำหนดกรอบคำถาม PICO เปรียบเทียบตารางสกัดข้อมูล ตามหาบทความที่การค้นหาครั้งแรกพลาด และร่างการสังเคราะห์เชิงบรรยายพร้อมหน่วยความจำเกี่ยวกับการตัดสินใจคัดเลือกก่อนหน้า แต่ Jenova อ่อนกว่าในฐานะ UI สำหรับคัดกรองโดยเฉพาะ Elicit ยังคงเหมาะสมกว่าโดยธรรมชาติเมื่องานคือ “เปลี่ยนบทคัดย่อ 80 ฉบับให้เป็นตารางวิธีวิจัยและผลลัพธ์” ส่วน SciSpace เหมาะกว่าเมื่องานคือ “อธิบายส่วนวิธีวิจัยนี้และสมการนี้”
คุณทำ literature review ด้วยผู้ช่วยวิจัย AI อย่างไร?
คุณจะได้ประโยชน์สูงสุดจากผู้ช่วยวิจัย AI เมื่อให้คำถามที่มีขอบเขต กฎการคัดเลือก และขั้นตอนตรวจสอบ ไม่ใช่เพียงสั่งให้ “ทบทวนวรรณกรรม” ใน prompt เดียว วงจรเดียวกันนี้ใช้ได้กับทุกเครื่องมือ ความต่างอยู่ที่หน้าจอใช้งานเท่านั้น
ลำดับขั้นที่เชื่อถือได้:
- ระบุคำถามในรูปแบบ PICO หรือรูปแบบเทียบเท่า (ประชากร การแทรกแซงหรือปรากฏการณ์ ตัวเปรียบเทียบ ผลลัพธ์ และประเภทการศึกษา)
- กำหนดกฎการรวมและคัดออกก่อนเริ่มสรุปข้อมูลใด ๆ
- ค้นหาในมากกว่าหนึ่งระบบ — ดัชนีวิชาการเฉพาะทางร่วมกับการค้นเว็บ/แหล่งวิชาการแบบสด — เพราะไม่มีคลังข้อมูลใดสมบูรณ์
- สกัดลงตาราง (การศึกษา รูปแบบ n ผลลัพธ์ ข้อจำกัด) แทนการยอมรับบทสรุปแบบร้อยแก้ว
- สุ่มตรวจทุกการอ้างอิง เทียบกับ PDF หรือหน้าผู้จัดพิมพ์
- เขียนจากตาราง ไม่ใช่จากหน่วยความจำเชิงบรรยายของผู้ช่วยเกี่ยวกับตาราง
สำหรับ Academic Research Assistant ของ Jenova การตั้งค่าเริ่มต้นใช้ข้อความกำหนดขอบเขตเพียงข้อความเดียว:
“ฉันกำลังเขียน narrative review เกี่ยวกับระบบสอนแบบปรับตัวได้ในรายวิชา STEM ระดับปริญญาตรี ให้รวมการศึกษาเชิงประจักษ์ระหว่างปี 2020–2026 ตัดบทความแสดงความคิดเห็นและบทความที่ไม่ใช่ภาษาอังกฤษออก สร้างตารางที่มีผู้เขียน ปี รูปแบบการวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัด จากนั้นระบุช่องว่างที่เป็นไปได้ ทำเครื่องหมายการอ้างอิงทุกแห่งที่คุณตรวจสอบไม่ได้”
ทำต่อด้วยการตรวจทานรอบที่สอง โดยขอให้เอเจนต์ดึงข้อมูลบรรณานุกรมฉบับเต็ม และแยกหลักฐานคุณภาพสูงออกจากงานที่เกี่ยวข้องแต่หลุดขอบเขต เนื่องจากเอเจนต์เก็บหน่วยความจำข้ามเซสชัน แชตครั้งหลังจึงดำเนินตามตรรกะการคัดเลือกเดิมได้โดยไม่ต้องอธิบาย protocol ซ้ำ
สำหรับ Elicit จุดเริ่มต้นที่เทียบเท่ากันคือคำถามวิจัยพร้อมตัวกรองประเภทการศึกษาและปี ตามด้วยคอลัมน์ที่กำหนดเองสำหรับตัวแปรที่คุณสนใจ ให้มองชุดผลลัพธ์แรกเป็นส่วนเสริมที่เน้น precision การประเมินของ BMC Medical Research Methodology พบว่า Elicit เป็นเครื่องมือเสริมมากกว่าจะเพียงพอในฐานะเครื่องมือค้นหาเดี่ยว ซึ่งเป็นแนวทางปฏิบัติที่เหมาะสม
สำหรับ SciSpace ให้อัปโหลดหรือเปิด PDF แล้วถามคำถามที่ยึดกับเอกสาร เช่น “ผลลัพธ์หลักคืออะไร?” หรือ “ผู้เขียนยอมรับข้อจำกัดใดบ้าง?” แทนการขอ literature review แบบแยกขาดจากเอกสาร วิธีนี้ใช้จุดแข็งด้านการอธิบายภายในเอกสาร ซึ่งเป็นศูนย์กลางของผลิตภัณฑ์ได้เต็มที่
วรรณกรรมสีเทา เอกสารนโยบาย preprint และฟอรัมผู้ปฏิบัติงานมักอยู่นอกดัชนีวิชาการ เอเจนต์ Real-Time Search ของ Jenova เป็นเครื่องมือคู่ที่เหมาะสมเมื่อการทบทวนต้องครอบคลุมการสนทนาบน Reddit การใช้งานบน GitHub ข่าว หรือแหล่งข้อมูลนอกวารสารอื่น ๆ ก่อนส่งส่วนแกนวิชาการกลับไปยัง Academic Research Assistant
ทีมโครงสร้างพื้นฐานด้านการวิจัยกล่าวอย่างไรเกี่ยวกับงานวิชาการที่มี AI ช่วย?
ทีมโครงสร้างพื้นฐานด้านการวิจัยมองผู้ช่วยวิจัย AI เป็นคู่คิดที่ให้ผลตอบแทนสูงสำหรับการร่างงานและการคัดกรอง แต่ยังล้มเหลวในด้าน recall ความสามารถในการทำซ้ำ และความถูกต้องของการอ้างอิงเมื่อไม่มีข้อมูลให้ค้น ดังนั้นแนวทางที่แนะนำคือบริบทที่ต่อเนื่องร่วมกับการตรวจสอบที่ต้องทำเสมอ ไม่ใช่การทบทวนอัตโนมัติเต็มรูปแบบ
"ปัญหาการอ้างอิงไม่ใช่แค่โมเดลผิดเป็นครั้งคราว แต่คือมันลื่นไหลเมื่อผิด ในเวิร์กโฟลว์วิชาการ เราเห็นผู้ช่วยสร้าง DOI ที่ฟังดูน่าเชื่อถือ หลอมรวมบทความจริงสองฉบับเป็นฉบับเดียว และอ้างอิง protocol ราวกับเป็นผลการวิจัย นั่นคือเหตุผลที่เราประเมินเครื่องมือจากความสามารถที่ผู้ร่วมเขียนจะตรวจสอบร่องรอยได้ — รายชื่อแหล่งข้อมูล กฎการคัดเลือก และเส้นทางย้อนกลับไปยัง PDF — ไม่ใช่จากความสละสลวยของย่อหน้าแรก"
"หน่วยความจำถาวรเปลี่ยนเศรษฐศาสตร์ของวิทยานิพนธ์มากกว่าการมีเครื่องมือสรุปเพิ่มอีกตัว การทบทวนวรรณกรรมระดับ PhD เป็นสิ่งที่ดำเนินอยู่หกถึงสิบแปดเดือน หากผู้ช่วยลืมว่าคุณตัดการศึกษาแบบภาคตัดขวางออกเมื่อเดือนมีนาคม มันก็จะยังแนะนำงานเหล่านั้นต่อไปในเดือนตุลาคม หน่วยความจำข้ามเซสชันไม่ใช่ฟีเจอร์เพื่อความสะดวกในบริบทนี้ แต่เป็นวิธีที่ทำให้ protocol อยู่รอดท่ามกลางตารางงานที่ยุ่ง"
"การเข้าถึงหลายโมเดลสำคัญด้วยเหตุผลง่าย ๆ: ขั้นตอนต่างกันต้องการลักษณะความผิดพลาดต่างกัน การคัดกรองและการสกัดข้อมูลต้องการคำตอบที่ระมัดระวังและอ้างอิงอย่างเข้มข้น ขณะที่งานร้อยแก้วส่วน related work ต้องการนักเขียนที่เก่งกว่า ไม่มีโมเดลเดียวดีที่สุดสำหรับทั้งสองเรื่อง และการผูกห้องปฏิบัติการไว้กับผู้ให้บริการรายเดียวก็สร้างคอขวดแบบเดียวกับที่เครื่องมือเหล่านี้ตั้งใจจะขจัด"
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเวิร์กโฟลว์วิชาการ, ประสบการณ์แปดปีในการสร้างเอเจนต์วิจัยที่นักศึกษาและคณาจารย์ใช้
มุมมองนี้สอดคล้องกับงานเขียนของบรรณารักษ์ van Dijk และคณะให้เหตุผลว่า AI ใน systematic review มีแนวโน้มที่ดีเมื่อใช้อย่างเหมาะสม — เป็นการสนับสนุนภายใต้การกำกับ ไม่ใช่ผู้ทบทวนที่มีหน้าที่รับผิดชอบหลัก งานรายงานผล PRISMA-AI ที่กำลังจะเผยแพร่เป็นความพยายามทำให้การกำกับดังกล่าวปรากฏชัดในสิ่งพิมพ์ ซึ่งเป็นทิศทางที่ห้องปฏิบัติการจริงจังกำลังเคลื่อนไปแล้ว
ผู้ช่วยวิจัย AI ตัวใดเหมาะกับนักศึกษา PhD ทีม systematic review และคณาจารย์?
ผู้ช่วยที่เหมาะที่สุดขึ้นอยู่กับงานที่ต้องทำใน 30 วันข้างหน้า: การอ่านเชิงสำรวจ การสกัดอย่างมีโครงสร้าง การตรวจการอ้างอิง หรือโครงการระยะยาวที่ผสมทั้งสามอย่าง การจับคู่โปรไฟล์ผู้ใช้กับเครื่องมือช่วยหลีกเลี่ยงการจ่ายเงินให้ชุดเครื่องมือวิจัยเต็มรูปแบบเมื่อคุณต้องการเพียงผู้ช่วย PDF และหลีกเลี่ยงการใช้ผู้ช่วย PDF ราวกับเป็นแพลตฟอร์ม systematic review
นักศึกษา PhD และผู้เขียนวิทยานิพนธ์ Academic Research Assistant ของ Jenova เป็นตัวเลือกเริ่มต้นที่แข็งแกร่งเมื่อโครงการใช้เวลาหลายเดือน แหล่งข้อมูลสะสมเพิ่มขึ้น และต้องนำกฎการคัดเลือกเดิมกลับมาใช้อีกครั้ง SciSpace เป็นเครื่องมือคู่ที่ดีกว่าในวันที่ต้องอยู่กับบทความยาก ๆ สองหรือสามฉบับ Paperguide เป็นตัวเลือกที่แข่งขันได้เมื่อคุณต้องการค้นหา ตาราง และร่างงานพร้อมการอ้างอิงโดยไม่ออกจากผู้ให้บริการรายเดียว
ทีม systematic review และการสังเคราะห์หลักฐาน Elicit และเครื่องมือคัดกรองที่สร้างมาโดยเฉพาะ (Rayyan, DistillerSR และเครื่องมือใกล้เคียง) ควรเป็นแกนกลางร่วมกับการคัดกรองซ้ำโดยมนุษย์ ฉันทามติจากห้องสมุดในปี 2026 ยังคงระบุว่า AI เป็นเครื่องมือเสริมสำหรับการค้นหา การคัดกรอง และการสกัดข้อมูล รายงาน Deep Research ของ Paperguide ช่วยเร่ง scoping review ได้ แต่ไม่ควรส่งเป็นผลลัพธ์ระดับ Cochrane หากยังไม่มีการค้นหาแบบดั้งเดิมและการคัดกรองที่บันทึกไว้
คณาจารย์ ผู้เขียนข้อเสนอทุน และ journal club Scite เป็นวิธีที่รวดเร็วที่สุดในการถามว่า “ข้อค้นพบนี้ยังยืนหยัดอยู่หรือไม่?” เครื่องมือ Q&A แนว Consensus มีประโยชน์สำหรับการสำรวจคำถาม “วงการนี้พูดว่าอย่างไร” ในรอบแรก โดยใช้กฎการตรวจสอบเดียวกัน Jenova มีประโยชน์เมื่อคณาจารย์กำลังสลับไปมาระหว่างวรรณกรรม ร่างงาน และการตอบผู้ประเมิน และต้องการให้บริบทของงานต่อเนื่องอยู่
นักศึกษาปริญญาตรีและปริญญาโทแบบรายวิชา เครื่องมือที่เน้นการอ่านเป็นอันดับแรก (SciSpace) ร่วมกับเครื่องมือตรวจสอบการอ้างอิงมักเพียงพอแล้ว ข้อค้นพบของ HEPI ที่ว่า 51% ของนักศึกษากังวลเรื่องการหลอน เป็นสัญชาตญาณที่ถูกต้อง: ควรเลือกผู้ช่วยที่แสดงแหล่งข้อมูล และห้ามวางเอกสารอ้างอิงที่ยังไม่ตรวจสอบลงในบรรณานุกรม
เมื่อใดไม่ควรใช้เครื่องมือเหล่านี้เป็นเครื่องมือหลัก การพัฒนา protocol การตัดสินความเสี่ยงของอคติ และการตัดสินใจคัดเลือกรอบสุดท้ายยังเป็นหน้าที่ของมนุษย์ ลิขสิทธิ์ยังเป็นข้อจำกัดต่อการอัปโหลด PDF ด้วย: KCL ระบุว่าการอัปโหลดข้อความเต็มที่มีลิขสิทธิ์เข้าสู่เครื่องมือ AI โดยทั่วไปถูกห้ามโดยผู้ถือสิทธิ์ ตรวจสอบทั้งเงื่อนไขของผู้จัดพิมพ์และนโยบายสถาบันของคุณก่อนวาง PDF ที่ต้องชำระเงินลงในผู้ช่วยใด ๆ
ดังนั้น ในปี 2026 ผู้ช่วยวิจัย AI ที่ได้รับการแนะนำมากที่สุดจึงเป็นกลุ่มผู้เชี่ยวชาญขนาดเล็กที่ใช้ร่วมกัน: Elicit หรือ Paperguide สำหรับหลักฐานที่มีโครงสร้าง, SciSpace สำหรับความเข้าใจเนื้อหา, Scite สำหรับบริบทการอ้างอิง และ Academic Research Assistant ของ Jenova เมื่องานเป็นการสนทนาระยะยาวที่มีแหล่งข้อมูลรองรับและต้องจดจำโครงการ เกณฑ์คุณภาพไม่ใช่ว่าหน้าจอใดลื่นไหลที่สุด แต่คือชุดเครื่องมือใดทิ้งร่องรอยที่คุณพร้อมปกป้องในการสอบปากเปล่า การประเมินโดยผู้ทรงคุณวุฒิ หรือการตรวจสอบ
เอกสารอ้างอิง
- Elicit — AI สำหรับการวิจัยทางวิทยาศาสตร์ (125 ล้านบทความ; นักวิจัยมากกว่า 2 ล้านคน)
- Scite — AI สำหรับการวิจัย พร้อมคำตอบที่มีการอ้างอิงรองรับจากบทความมากกว่า 300 ล้านฉบับ
- Paperguide — แพลตฟอร์ม AI สำหรับเวิร์กโฟลว์วิจัยทางวิทยาศาสตร์
- Paperguide — 7 เครื่องมือผู้ช่วยวิจัย AI ที่ดีที่สุดสำหรับการวิจัยวิทยาศาสตร์ในปี 2026
- HEPI — แบบสำรวจ Generative AI ของนักศึกษา ปี 2025
- ERIC / กระทรวงศึกษาธิการสหรัฐฯ — แบบสำรวจ Generative AI ของนักศึกษา ปี 2025, HEPI Policy Note 61
- UNESCO — สถาบันอุดมศึกษาสองในสามมีหรือกำลังพัฒนาแนวทางการใช้ AI
- คู่มือห้องสมุด King’s College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- ห้องสมุด OHSU — AI ใน Systematic Reviews
- Memorial Sloan Kettering Cancer Center — บริการ Systematic Review: AI และ Reviews
- Bernard และคณะ, BMC Medical Research Methodology — การใช้ปัญญาประดิษฐ์สำหรับ systematic review (PMC11921719)
- Paperguide — Elicit เทียบกับ SciSpace: เปรียบเทียบเครื่องมือวิจัย AI (2026)
- SciSpace Literature Review — เกณฑ์ทดสอบภายใน 200-query เทียบกับ Elicit และ Consensus
- Paperguide — 5 เครื่องมือ AI ที่ดีที่สุดสำหรับ Systematic Review ในปี 2026
- ScienceDirect — Generative AI กำลังปรับเปลี่ยนแนวปฏิบัติทางวิชาการทั่วโลกหรือไม่?
- MDPI — Meta-Survey ของ Generative AI ในการศึกษา: แนวโน้ม (ตัวเลข HEPI 92% / 66%)