แชต AI ด้วยหน่วยความจำเวกเตอร์: การจดจำเชิงความหมายแบบถาวรสำหรับเอเจนต์
2026-09-15
Jenova มอบแชต AI ด้วยหน่วยความจำเวกเตอร์ — บทสนทนาที่จดจำความหมาย ไม่ใช่เพียงไม่กี่ข้อความล่าสุด ณ เดือนกันยายน 2026 ผู้ช่วยส่วนใหญ่ยังคงลืมความต้องการ ทำบริบทโปรเจกต์หลุดหาย และบังคับให้คุณอธิบายไฟล์เดิมซ้ำแล้วซ้ำเล่า แพลตฟอร์มนี้จัดเก็บบทสนทนา เอกสาร และความต้องการ เพื่อให้เอเจนต์เฉพาะทางสามารถดึงบริบทที่ถูกต้องได้เมื่อคุณถาม
✅ หน่วยความจำถาวรข้ามเซสชัน ไม่ใช่หน้าต่างเลื่อนที่ล้างตัวเอง ✅ การค้นคืนเชิงความหมายเหนือกว่าคีย์เวิร์ด — ค้นหาสิ่งที่คุณหมายถึง ไม่ใช่เพียงสิ่งที่คุณพิมพ์ ✅ ฐานความรู้ที่แนบครั้งเดียวและใช้ซ้ำได้กับงานวิจัย โค้ด และการเขียน ✅ โมเดลหน่วยความจำเดียวกันบนเว็บ, iOS และ Android
แชตแบบไร้สถานะมีต้นทุนการรันต่ำ แต่มีต้นทุนการใช้งานสูง เพื่อทำความเข้าใจว่าทำไมหน่วยความจำเวกเตอร์จึงกลายเป็นหัวใจของแชต AI ที่ใช้งานได้จริง ควรดูว่าเอ็มเบดดิง การค้นคืน และบริบทระยะยาวล้มเหลวอย่างไรในงานประจำวัน
คำตอบสั้น ๆ: แชต AI ด้วยหน่วยความจำเวกเตอร์คืออะไร?
แชต AI ด้วยหน่วยความจำเวกเตอร์คือระบบการค้นคืนที่จัดเก็บความหมายของบทสนทนาเป็นเอ็มเบดดิง เพื่อให้ AI จดจำบริบท เอกสาร และความต้องการที่เกี่ยวข้องได้ข้ามเซสชัน นี่คือความแตกต่างระหว่างแชตบอตที่เริ่มต้นทุกเธรดใหม่ กับเอเจนต์ที่ทำงานต่อเนื่องได้
ความสามารถหลัก:
- แปลงข้อความ ไฟล์ และข้อเท็จจริงเป็นเวกเตอร์สำหรับการค้นหาความคล้ายคลึง
- ดึงเฉพาะความทรงจำที่เกี่ยวข้องที่สุดเข้าสู่หน้าต่างบริบทของโมเดล
- เก็บประวัติแชตได้ไม่จำกัดและรักษาความต้องการข้ามเซสชันไว้บนแพลตฟอร์มเดียว
- ยึดคำตอบกับฐานความรู้ที่แนบไว้ แทนการคาดเดาจากพารามิเตอร์ของโมเดล
- ใช้หน่วยความจำเดียวกันต่อจากเซสชันบนโต๊ะทำงานสู่โทรศัพท์ โดยไม่ต้องบรีฟเอเจนต์ใหม่
เหตุใดแชต AI ส่วนใหญ่จึงยังลืม
โมเดลภาษาขนาดใหญ่มีความสามารถด้านการให้เหตุผลสูง แต่เป็นนักจัดเก็บข้อมูลที่อ่อนแอ น้ำหนักของโมเดลเก็บความรู้ทั่วไปไว้ แต่ไม่ได้เก็บงานค้างของ คุณ สคีมาของ คุณ หรือการตัดสินใจล่าสุดของ คุณ การสร้างคำตอบแบบเสริมด้วยการค้นคืนมีอยู่โดยเฉพาะ เพราะหน่วยความจำเชิงพารามิเตอร์ไม่สม่ำเสมอและอัปเดตได้ยากสำหรับโดเมนส่วนตัว ซึ่งเป็นประเด็นที่สรุปไว้ในบทสำรวจสถาปัตยกรรม RAG ปี 2025
ความต้องการชั้นการค้นคืนนั้นในอุตสาหกรรมไม่ได้อยู่แค่ระดับการทดลองอีกต่อไป:
USD 2,652.1 million → USD 8,945.7 million — การคาดการณ์ตลาดฐานข้อมูลเวกเตอร์ทั่วโลกตั้งแต่ปี 2025 ถึง 2030 ที่ CAGR 27.5%
การใช้จ่ายดังกล่าวเป็นอาการของปัญหา ทีมต่าง ๆ กำลังซื้อโครงสร้างพื้นฐานเวกเตอร์ เพราะแชตที่ไร้หน่วยความจำยังคงล้มเหลวในรูปแบบเดิม:
- หน้าต่างบริบทล้น ทำให้การตัดสินใจเก่าหายไปกลางโปรเจกต์
- การค้นหาด้วยคีย์เวิร์ดพลาดการถอดความ คำพ้องความหมาย และเจตนาโดยนัย
- สแตก RAG ที่ทำเอง (การแบ่งส่วนข้อมูล ดัชนี การประเมินผล การยืนยันตัวตน) หยุดชะงักก่อนถึงการใช้งานจริง
- การปรับให้เป็นส่วนบุคคลถูกขังอยู่ในประวัติแชตของผู้ให้บริการรายเดียว
- คำตอบคลาดเคลื่อนเมื่อโมเดลไม่สามารถยึดโยงกับไฟล์ของคุณได้
แต่การนำหน่วยความจำที่ทนทาน เป็นส่วนตัว และค้นหาได้เชิงความหมายมาไว้ในแชตประจำวัน ยังเป็นเรื่องยากอย่างน่าหงุดหงิด:
หน้าต่างบริบทไม่ใช่หน่วยความจำ
หน้าต่างบริบทคือบัฟเฟอร์ ไม่ใช่คลังเก็บถาวร ประวัติการสนทนา คำถามของผู้ใช้ และ “ข้อเท็จจริงที่บันทึกไว้” เพียงเล็กน้อยจะถูกนำมาต่อรวมกันเป็นพรอมป์ต์ ส่วนที่ไม่พอดีจะถูกตัดทิ้ง นี่คือเหตุผลที่เอเจนต์เขียนโค้ดลืมข้อผิดพลาดที่คุณวางไว้เมื่อวาน และเหตุผลที่ติวเตอร์ถามคะแนนเป้าหมายของคุณซ้ำ หน่วยความจำเวกเตอร์อยู่ นอก หน้าต่างนี้ โดยค้นคืนส่วนย่อยที่เกี่ยวข้องเมื่อทำการอนุมาน แทนการหวังว่าบทสนทนาฉบับเต็มจะยังพอดี
การค้นหาด้วยคีย์เวิร์ดไม่สามารถแทนความหมายได้
การค้นหาแบบดั้งเดิมให้รางวัลกับโทเค็นที่ตรงกันเป๊ะ การค้นหาเวกเตอร์เปรียบเทียบเอ็มเบดดิง — ตัวแทนเชิงตัวเลขหลายมิติของความหมาย — โดยใช้เมตริกอย่าง cosine similarity หรือ Euclidean distance เอ็มเบดดิงร่วมกับดัชนีเวกเตอร์คือชั้นการค้นคืนที่ทำให้แอปพลิเคชัน LLM สมัยใหม่เป็นไปได้ หากไม่มีชั้นนี้ “แผนการจ้างงานไตรมาส 3” จะไม่สามารถค้นคืนบันทึกที่คุณตั้งชื่อว่า “จำนวนพนักงานสำหรับฤดูใบไม้ร่วง” ได้
RAG ที่ทำเองคือโปรเจกต์โครงสร้างพื้นฐาน
ไปป์ไลน์การค้นคืนสำหรับใช้งานจริงต้องมีกลยุทธ์การแบ่งส่วนข้อมูล การเลือกเอ็มเบดดิง ดัชนี ANN ตัวกรองเมทาดาทา การประเมินผล และงานรีเฟรช เกณฑ์เปรียบเทียบ ANN ที่เผยแพร่แล้ว แสดงให้เห็นว่าทำไมทีมจึงให้ความสำคัญกับเรื่องนี้: เอนจินต่าง ๆ ถูกเปรียบเทียบทั้งด้านเวลาแฝง ปริมาณงาน และความแม่นยำ เพราะความเร็วที่ไม่มีการค้นคืนครบถ้วนคือผลิตภัณฑ์คนละประเภท คนส่วนใหญ่ที่เพียงต้องการแชตที่จดจำได้ ไม่ควรต้องดูแลสแตกนั้นเอง
การปรับให้เป็นส่วนบุคคลโดยไม่มีหน่วยความจำที่พกพาได้เปราะบาง
Stanford’s Digital Economy Lab เห็นว่าความได้เปรียบที่ยั่งยืนของ AI จะมาจากบริบทส่วนบุคคลที่ถาวรและผู้ใช้กำกับได้ ไม่ใช่จากแชตบอตแยกส่วนอีกตัวหนึ่ง ปัจจุบัน หน่วยความจำมักเป็นฟีเจอร์ของผู้ให้บริการ: มันไม่ได้เดินทางไปกับคุณ และอาจกำหนดสิ่งที่คุณเห็นอย่างเงียบ ๆ รายงานของ Columbia Journalism Review เกี่ยวกับหน่วยความจำแชตบอตชี้ว่า การจดจำผู้ใช้อาจเปลี่ยนแปลงข้อมูลที่ผู้คนได้รับ
นี่คือสิ่งที่ Jenova ถูกสร้างขึ้นมาเพื่อแก้ไข
โซลูชันของ Jenova
Jenova ทำให้แชต AI ด้วยหน่วยความจำเวกเตอร์เป็นค่าเริ่มต้น ไม่ใช่ส่วนเสริมที่คุณต้องมาต่อเองภายหลัง ประวัติแชตไม่จำกัด หน่วยความจำข้ามเซสชันแบบถาวร และฐานความรู้ที่แนบได้ อยู่ใต้เอเจนต์เฉพาะทางทุกตัว คุณสื่อสารด้วยภาษาธรรมชาติ แล้วแพลตฟอร์มจะค้นคืนเอ็มเบดดิง เครื่องมือ และไฟล์ที่ถูกต้องก่อนโมเดลตอบ
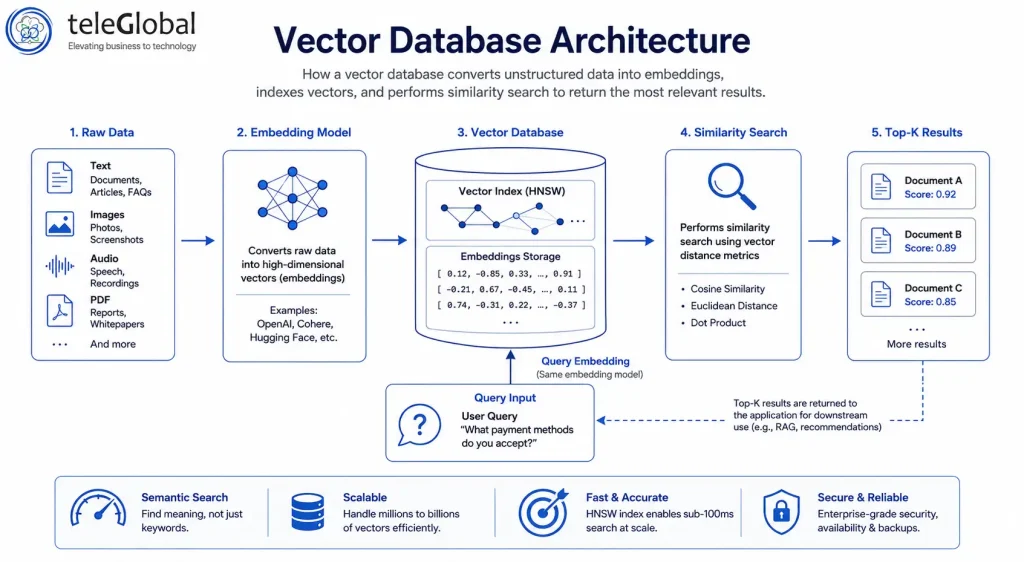
แผนภาพข้างต้นแสดงกลไกเบื้องหลังประสบการณ์ดังกล่าว: ข้อความ ภาพ และเอกสารที่ไม่มีโครงสร้างจะกลายเป็นเอ็มเบดดิง ถูกเก็บในดัชนีเวกเตอร์ และส่งกลับเป็นรายการที่ตรงกันสูงสุด top-k สำหรับคำค้น คุณไม่ต้องกำหนดค่าพารามิเตอร์ HNSW หรือเลือกเมตริกระยะทาง คุณเพียงเริ่มเธรดสนทนา
| แนวทางดั้งเดิม | Jenova |
|---|---|
| วางบรีฟเดิมในทุกแชตใหม่ | หน่วยความจำถาวรข้ามเซสชันและเอเจนต์ |
| ค้นหาด้วยคีย์เวิร์ดในโน้ตและ PDFs | ค้นคืนเชิงความหมายจากเอ็มเบดดิง |
| โฮสต์ vector DB, ตัวสร้างเอ็มเบดดิง และการประเมิน RAG ด้วยตนเอง | พื้นที่จัดเก็บและการค้นคืนที่บริหารจัดการครบถ้วน |
| ผู้ให้บริการโมเดลรายเดียว หน่วยความจำแบบไซโลเดียว | เข้าถึงหลายโมเดลพร้อมบริบทที่ใช้ร่วมกัน |
| ประวัติบนเดสก์ท็อปเท่านั้นที่หายไปบนมือถือ | ความสามารถเทียบเท่ากันครบถ้วนบนเว็บ, iOS และ Android |
งานวิจัยที่ต่อยอดได้แทนการเริ่มใหม่
การทบทวนวรรณกรรมและการสำรวจตลาดล้มเหลวเมื่อผู้ช่วยจำไม่ได้ว่าคุณปฏิเสธบทความใดไปแล้ว Real-Time Search ดึงผลลัพธ์สดจาก Google, Reddit, YouTube, GitHub และอื่น ๆ ขณะที่หน่วยความจำเวกเตอร์คงเกณฑ์การคัดเลือก การอ้างอิงก่อนหน้า และกฎ “ห้ามใช้แหล่งข้อมูลนี้” ของคุณไว้ คุณไม่ได้เริ่มคำค้น Boolean ใหม่ทุกเช้า แต่กำลังทำการสืบค้นที่มีการค้นคืนรองรับต่อเนื่อง
โค้ดเบสที่เอเจนต์รู้จักจริง
Python Coding Assistant มีประโยชน์ตั้งแต่วันแรกสำหรับสคริปต์หนึ่งชุด แต่จะยิ่งมีคุณค่าในวันที่สิบสอง เมื่อมันยังรู้โครงสร้างแพ็กเกจของคุณ เทสต์ที่ไม่เสถียรซึ่งคุณตัดสินใจข้าม และสัญญา API ที่คุณล็อกไว้เมื่อสัปดาห์ก่อน แนบบันทึกของรีโปหรือเอกสารการออกแบบครั้งเดียว พรอมป์ต์ครั้งต่อไปจะค้นคืนบริบทนั้น แทนการประดิษฐ์สถาปัตยกรรมคู่ขนานขึ้นมา
งานเขียนที่รักษาน้ำเสียงและข้อเท็จจริงของคุณ
ร่างงานมักหยุดชะงักในแชตไร้สถานะ เพราะน้ำเสียง วลีต้องห้าม และ URL ที่เป็นแหล่งอ้างอิงหลักหลุดออกจากหน้าต่างบริบท เอเจนต์ที่เน้นงานเขียนบนแพลตฟอร์มสามารถเก็บตัวอย่างสไตล์และการตัดสินใจด้านโครงร่างไว้เป็นหน่วยความจำ แล้วค้นคืนเมื่อคุณพูดว่า “ใช้น้ำเสียงเดียวกับโพสต์เปิดตัว” เมื่อทำงานร่วมกับเอกสารแนบ นี่คือหน่วยความจำเวกเตอร์ที่สร้างความต่อเนื่องด้านบรรณาธิการ ไม่ใช่เพียงพรอมป์ต์ที่ยาวขึ้น
ชีวิตและการเรียนรู้ที่ไม่ควรถูกรีเซ็ต
การโค้ชและการฝึกภาษาใช้ได้ผลก็ต่อเมื่อเอเจนต์จดจำข้อจำกัด เช่น อาการบาดเจ็บ วันสอบ และคำศัพท์ที่คุณรู้แล้ว หน่วยความจำถาวรเปลี่ยนติวเตอร์ทั่วไปให้เป็นติวเตอร์ที่เลิกสอนแบบฝึกหัดสัปดาห์แรกซ้ำ ๆ คลังเดียวกันที่ค้นคืน Python traceback ได้ ก็สามารถค้นคืนข้อเท็จจริงว่าคุณเรียนรู้ได้ดีกว่าด้วยการสวมบทบาทมากกว่าตารางไวยากรณ์
ลองใช้แพลตฟอร์มฟรี — ไม่ต้องใช้บัตรเครดิต
เอเจนต์ AI เฉพาะทางสำหรับแชต AI ด้วยหน่วยความจำเวกเตอร์
หน่วยความจำจะมีประโยชน์ได้เท่ากับเวิร์กโฟลว์ที่มันรองรับ เอเจนต์เหล่านี้ถูกสร้างขึ้นสำหรับงานที่การลืมมีต้นทุนสูง — งานวิจัยระยะยาว โลจิสติกส์ที่เกิดซ้ำ การฝึกแบบมีส่วนร่วม และการเล่นที่รักษาความสอดคล้องของตัวละคร
Deep Research
งานวิจัยหลายชั่วโมงคือตัวอย่างคลาสสิกของแชต AI ด้วยหน่วยความจำเวกเตอร์ เอเจนต์นี้ค้นหาแหล่งข้อมูลหลายร้อยแห่ง สังเคราะห์ข้อค้นพบพร้อมการอ้างอิงในเนื้อหา และส่งรายงานที่คุณทำต่อในวันพรุ่งนี้ได้โดยไม่ต้องกำหนดขอบเขตคำถามใหม่
- เก็บคำถามวิจัย แหล่งข้อมูลที่ตัดออก และข้อเสนอหลักระหว่างพัฒนา
- ค้นคืนข้อค้นพบก่อนหน้าเพื่อไม่ให้ส่วนหลังขัดแย้งกับส่วนก่อนหน้า
- ยึดข้ออ้างกับเนื้อหาที่มีการอ้างอิง แทนการพึ่งพาความจำของโมเดลเพียงอย่างเดียว
Academic Research Assistant
เวิร์กโฟลว์ของนักศึกษา PhD และคณาจารย์ครอบคลุมวรรณกรรม รูปแบบการอ้างอิง และเวอร์ชันต้นฉบับนานหลายเดือน ผู้ช่วยนี้ค้นพบบทความจากฐานข้อมูลหลักและช่วยเตรียมต้นฉบับ ขณะที่หน่วยความจำช่วยรักษาข้อมูลวารสารเป้าหมาย ระเบียบวิธี และชุดบทความที่อ่านแล้วของคุณไว้ครบถ้วน
- ค้นคว้าวรรณกรรมแบบเรียลไทม์จากคลังวิชาการ
- สนับสนุนการอ้างอิงและต้นฉบับที่เชื่อมกับร่างงานต่อเนื่องของคุณ
- มีความต่อเนื่องข้ามบทความที่เกี่ยวข้อง ไม่ใช่คำตอบแชตแบบครั้งเดียวจบ
Personal Secretary
งานโลจิสติกส์คือปัญหาด้านหน่วยความจำ: ผู้ให้บริการที่ใช้ประจำ ความต้องการด้านการเดินทาง และผู้รับอัปเดตวันศุกร์ เอเจนต์นี้ประสานปฏิทิน อีเมล และการดำเนินงานประจำวันด้วยบริบทส่วนบุคคลเชิงลึก เพื่อให้คุณไม่ต้องสอนกิจวัตรของตัวเองใหม่ทุกวันจันทร์
- จดจำความต้องการประจำและบุคคลที่คุณทำงานด้วย
- เชื่อมการวางแผนเข้ากับเครื่องมือที่คุณใช้อยู่แล้ว
- นำบริบทจากการสรุปตอนเช้าไปสู่การติดตามผลตอนบ่าย
Roleplay Game Master
ความสอดคล้องของเรื่องเล่าเป็นไปไม่ได้หากไม่มีหน่วยความจำระยะยาว เอเจนต์นี้สร้างมาเพื่อการสวมบทบาทที่ดื่มด่ำ ด้วยหน่วยความจำไม่จำกัดและตัวละครที่มั่นคง — คำมั่นสัญญาของพล็อต ชื่อกลุ่มอำนาจ และโทนเรื่องจะไม่ถูกรีเซ็ตเมื่อหน้าต่างบริบทล้น
- หน่วยความจำไม่จำกัดสำหรับสถานะเรื่องราวและน้ำเสียงของตัวละคร
- ค้นคืนฉากก่อนหน้าเมื่อบทถัดไปต้องใช้
- มีขอบเขตความคิดสร้างสรรค์โดยไม่สูญเสียความต่อเนื่อง
Learn Russian Through Roleplay
การเรียนรู้ภาษาขึ้นอยู่กับบริบทส่วนบุคคลที่เว้นระยะอย่างเหมาะสม: คำที่คุณพลาด ระดับความเป็นทางการ และเรื่องราวที่คุณเคยผ่านมาด้วยกัน เมนเทอร์นี้ใช้สถานการณ์ได้ไม่จำกัดและหน่วยความจำไม่จำกัด เพื่อให้การฝึกต่อยอดแทนการวนซ้ำสคริปต์สำหรับผู้เริ่มต้น
- จดจำช่องว่างด้านคำศัพท์และประเภทสถานการณ์ที่คุณชอบ
- รักษาตัวละครและฉากให้สอดคล้องกันข้ามเซสชัน
- เปลี่ยนทุกบทสนทนาให้เป็นการฝึกที่มีการค้นคืนรองรับ
แชต AI ด้วยหน่วยความจำเวกเตอร์ทำงานอย่างไร
คุณไม่ต้องติดตั้งฐานข้อมูลเวกเตอร์เอง เพียงเริ่มบทสนทนา แล้วแพลตฟอร์มจะจัดการเอ็มเบดดิง การค้นคืน และหน้าต่างบริบทให้
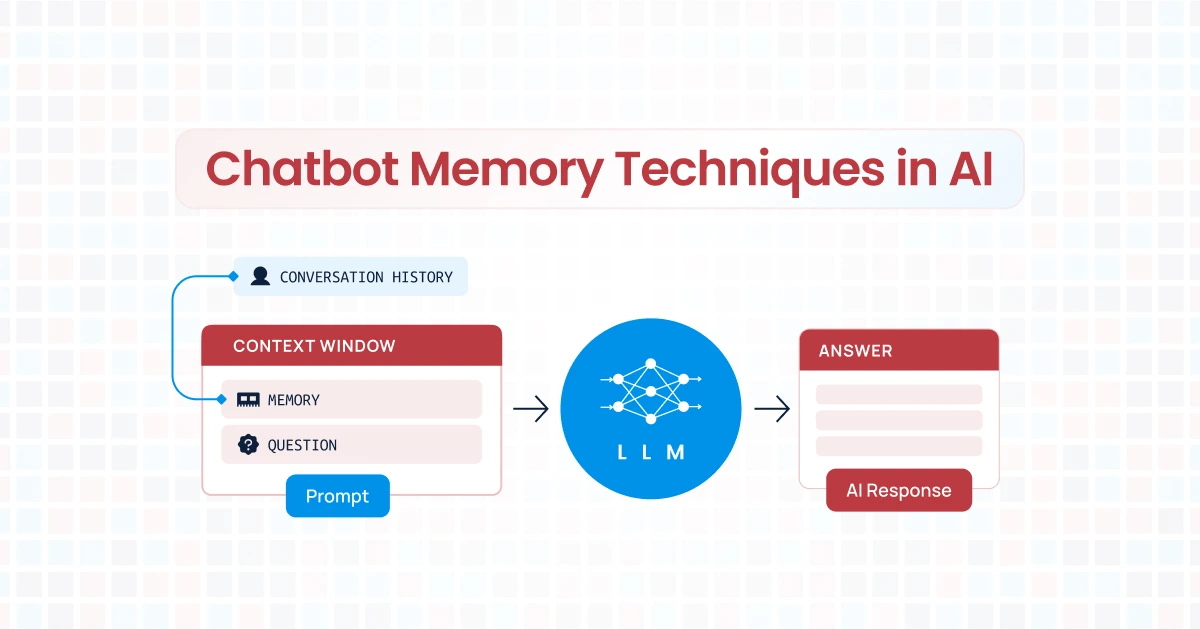
แผนภาพที่สองนี้คือวงจรที่ผู้ใช้มองเห็น ประวัติ หน่วยความจำที่จัดเก็บไว้ และคำถามใหม่จะถูกรวมเข้าเป็นพรอมป์ต์ จากนั้นโมเดลจึงตอบ การค้นคืนเวกเตอร์เป็นผู้ตัดสินว่า ความทรงจำ ใด ควรอยู่ในพรอมป์ต์นั้น เพื่อให้หน้าต่างบริบทยังคงมีสมาธิ
ขั้นตอนที่ 1: เปิดเอเจนต์และระบุผลลัพธ์ เลือกผู้เชี่ยวชาญสำหรับงานนั้น — วิจัย โค้ด เดินทาง หรือติว — แล้วบอกว่าคำว่า “เสร็จแล้ว” มีหน้าตาอย่างไร ข้อความแรกจะกลายเป็นเอ็มเบดดิงเช่นเดียวกับทุกข้อความหลังจากนั้น
“ฉันกำลังเขียนการทบทวนวรรณกรรมอย่างเป็นระบบเกี่ยวกับการสร้างคำตอบแบบเสริมด้วยการค้นคืน เลือกบทสำรวจตั้งแต่ปี 2024 เป็นต้นไป ไม่ใช้บล็อกของผู้ให้บริการ และคงรูปแบบการอ้างอิง IEEE”
ขั้นตอนที่ 2: แนบความรู้ที่โมเดลควรเชื่อถือ อัปโหลดบรีฟ PDFs โน้ต หรือข้อกำหนด เอกสารเหล่านั้นจะถูกทำดัชนีเพื่อการค้นหาเชิงความหมาย เพื่อให้คำถามในภายหลังค้นคืนข้อความตามความหมาย นี่คือรูปแบบเดียวกับโครงสร้างพื้นฐาน RAG ที่องค์กรต่าง ๆ กำลังลงทุน โดยที่คุณไม่ต้องดูแลดัชนีเอง
“ใช้เมทริกซ์วรรณกรรมที่แนบไว้ หากบทความใดถูกระบุว่าปฏิเสธแล้ว อย่าอ้างอิงบทความนั้นอีก”
ขั้นตอนที่ 3: ทำงานต่อข้ามเซสชัน ปิดแล็ปท็อป วันถัดไปจึงถามคำถามต่อยอด หน่วยความจำถาวรและประวัติไม่จำกัดทำให้เอเจนต์ค้นคืนขอบเขตของการทบทวน รายการที่ปฏิเสธ และหัวข้อสุดท้ายในโครงร่าง แทนการทักทายคุณราวกับเป็นคนแปลกหน้า
“ทำต่อจากส่วนข้อจำกัด และดึงบทความสามฉบับที่เราทำเครื่องหมายไว้สำหรับส่วนอภิปราย”
ขั้นตอนที่ 4: สลับอุปกรณ์โดยไม่ต้องบรีฟใหม่ เปิดเธรดเดิมบน iOS หรือ Android การตั้งค่าและประวัติจะซิงก์กัน พรอมป์ต์ระหว่างเดินทางสามารถค้นคืนเวกเตอร์ชุดเดียวกับเซสชันบนโต๊ะทำงาน ซึ่งคือสิ่งที่แชต AI ด้วยหน่วยความจำเวกเตอร์มีไว้เพื่อทำ: ความต่อเนื่อง ไม่ใช่ไซโลแชตใหม่สำหรับแต่ละอุปกรณ์
“กำลังไปมหาวิทยาลัย — ทดสอบฉันเกี่ยวกับโหมดความล้มเหลวของ RAG สามข้อที่เราระบุไว้เมื่อวาน”
ผลลัพธ์และกรณีใช้งาน
หน่วยความจำเวกเตอร์ปรากฏในรูปของชั่วโมงที่ไม่ต้องทำซ้ำ ไม่ใช่กราฟเกณฑ์เปรียบเทียบ สถานการณ์เหล่านี้เป็นตัวอย่างทั่วไปของสิ่งที่เปลี่ยนไปเมื่อแชตสามารถค้นคืนความหมายได้
📊 การสังเคราะห์วรรณกรรมหลายสัปดาห์
สถานการณ์: นักศึกษาบัณฑิตศึกษาต้องการภาพรวมพร้อมการอ้างอิงของบทความด้านความทนทานของ RAG ซึ่งอัปเดตทุกสองสามวันเมื่อมี preprints ใหม่ออกมา
แนวทางดั้งเดิม: โฟลเดอร์ PDFs สเปรดชีตบันทึก และแชตบอตที่ลืมรายการตัดออก ต้องวางบรีฟซ้ำทุกเซสชัน จึงง่ายต่อการอ้างอิงซ้ำหรือพลาดความขัดแย้ง
Deep Research: คำถาม รายการตัดออก และโครงร่างระหว่างพัฒนายังคงอยู่ การทำงานรอบใหม่ค้นคืนการสังเคราะห์ก่อนหน้า เพื่อให้รายงานเติบโตแทนที่จะแตกแขนง
- การอ้างอิงยังสอดคล้องกับส่วนก่อนหน้า
- แหล่งข้อมูลที่ปฏิเสธแล้วจะยังคงถูกปฏิเสธ
- คำถามต่อยอดมีต้นทุนต่ำกว่าการค้นหารอบแรก
💼 บริการ Python ที่ครอบคลุมหลายสปรินต์
สถานการณ์: คุณกำลังสร้างบริการ FastAPI ที่มีข้อกำหนด OpenAPI ถูกล็อกไว้ มีเทสต์ที่ไม่เสถียรซึ่งทราบอยู่แล้ว และมีข้อจำกัดการดีพลอยบน Python 3.11
แนวทางดั้งเดิม: ทุกแชตใหม่สร้างโครงสร้างโฟลเดอร์ที่แตกต่างกัน คุณใช้สิบนาทีแรกอธิบายการตัดสินใจซ้ำ ซึ่งโมเดลมองไม่เห็น
Python Coding Assistant: บันทึกสถาปัตยกรรมและข้อกำหนดอยู่ในหน่วยความจำและเอกสารแนบ รายงานบั๊กในวันพฤหัสบดีสามารถค้นคืนรายการข้อจำกัดของวันพุธได้
- การรีแฟกเตอร์ที่ขัดแย้งกันน้อยลง
- การดีบักเริ่มจากสแตกจริง
- การส่งต่องานให้ตัวคุณในอนาคต หรือเพื่อนร่วมทีมที่อ่านเธรด ทำได้รวดเร็วขึ้น
🎭 แคมเปญที่ต้องไม่ขัดแย้งกับตัวเอง
สถานการณ์: เกมรายสัปดาห์ที่มี NPC ที่ตั้งชื่อไว้ ความลับที่กลุ่มผู้เล่นยังไม่รู้ และโทนเรื่องที่คุณกำหนดไว้แล้วในเซสชันแรก
แนวทางดั้งเดิม: โน้ตเซสชันอยู่ในแอปอื่น แชตบอตยัดตัวร้ายใหม่เข้ามาเพราะไม่สามารถค้นคืนคำมั่นสัญญาเก่าได้
Roleplay Game Master: สถานะของเรื่องราวคือหน่วยความจำ เมื่อผู้เล่นอ้างถึงรายละเอียดเล็กน้อยจากสามเซสชันก่อน การค้นคืนสามารถนำมันกลับเข้าสู่ฉากได้
- น้ำเสียงของตัวละครยังคงเสถียร
- คำมั่นสัญญาของพล็อตยังค้นหาได้
- เนื้อเรื่องระยะยาวยังคงกลมกลืน
📱 วางแผนทริปจากคิวสนามบิน
สถานการณ์: คุณวางแผนทริปสามเมืองบนโต๊ะทำงานแล้ว — จำกัดงบ เดินเป็นหลักในแต่ละวัน และไม่เอาเที่ยวบินตาแดง ที่ประตูขึ้นเครื่อง คุณต้องการปรับเฉพาะกำหนดการพรุ่งนี้โดยอิงสภาพอากาศ
แนวทางดั้งเดิม: แคปหน้าจอโน้ตของตัวเอง แล้วหวังว่าแชตบอตบนมือถือจะอนุมานข้อจำกัดที่มันไม่เคยเห็นได้
Travel Planning Advisor: ความต้องการและแผนการเดินทางอยู่ในหน่วยความจำแล้ว พรอมป์ต์จากโทรศัพท์ค้นคืนข้อมูลเหล่านั้นและเปลี่ยนหนึ่งวันโดยไม่ต้องสร้างทริปใหม่
- ข้อจำกัดยังคงอยู่แม้เปลี่ยนอุปกรณ์
- คำถามต่อยอดเกี่ยวกับสถานที่ยังคงอยู่ในงบ
- คุณไม่ต้องพิมพ์บรีฟใหม่ระหว่างทางขึ้นเครื่อง
เมื่อพิจารณาการใช้งานจริง จะเห็นรูปแบบเดียวกับที่ผู้ซื้อฐานข้อมูลเวกเตอร์ระดับองค์กรกำลังจ่ายเงินเพื่อมัน: การค้นคืนเชิงความหมายที่มีเวลาแฝงต่ำภายใต้คำถามสด ไม่ใช่กล่องแชตที่ใหญ่ขึ้น
คำถามที่พบบ่อย
แชต AI ด้วยหน่วยความจำเวกเตอร์คืออะไร?
แชต AI ด้วยหน่วยความจำเวกเตอร์จัดเก็บข้อความ ไฟล์ และข้อเท็จจริงเป็นเอ็มเบดดิง จากนั้นค้นคืนรายการที่ใกล้เคียงที่สุดเมื่อคุณถามคำถาม รายการเหล่านั้นจะถูกใส่ลงในหน้าต่างบริบทของโมเดล เพื่อให้คำตอบใช้ประวัติและเอกสารของคุณได้ บน Jenova การค้นคืนนี้ถูกสร้างไว้ในเอเจนต์เฉพาะทาง แทนที่จะเป็นฐานข้อมูลแยกต่างหากที่คุณต้องดูแล
Jenova ใช้แชต AI ด้วยหน่วยความจำเวกเตอร์ได้ฟรีหรือไม่?
ได้ แพ็กเกจฟรีมีฟีเจอร์หลักพร้อมขีดจำกัดการใช้งานรายเดือน แพ็กเกจแบบชำระเงินเพิ่มขีดความสามารถในการใช้งาน และเพิ่มตัวเลือกอย่างการเลือกโมเดลแบบกำหนดเอง การใช้งานจะรีเซ็ตในวันเรียกเก็บเงิน โดยให้โควตาเต็มตั้งแต่วันแรก แทนการทยอยให้รายวัน
สิ่งนี้ต่างจากแชตบอตที่ “บันทึกความทรงจำ” อย่างไร?
ผลิตภัณฑ์จำนวนมากเก็บรายการข้อเท็จจริงสั้น ๆ หรือบทสนทนาแบบเลื่อนต่อเนื่อง หน่วยความจำเวกเตอร์ค้นคืนด้วยความคล้ายคลึงเชิงความหมายจากประวัติไม่จำกัดและความรู้ที่แนบไว้ ซึ่งใกล้เคียงกับ RAG มากกว่ากระดาษโน้ต งานอิสระเกี่ยวกับหน่วยความจำระยะยาวสำหรับเอเจนต์ในระบบใช้งานจริง มองหน่วยความจำที่ขยายขนาดได้เป็นปัญหาระบบในตัวเอง ไม่ใช่สวิตช์ในหน้าการตั้งค่า OpenAI ยังได้ขยายความสามารถของ ChatGPT ในการอ้างอิงบริบทจากแชตก่อนหน้า คำถามเชิงสถาปัตยกรรมคือ หน่วยความจำเป็นไซโลของผู้ให้บริการ หรือเป็นโครงสร้างพื้นฐานใต้ทุกเวิร์กโฟลว์ที่คุณใช้งาน
ฉันสามารถยึดแชตกับเอกสารของตัวเองได้หรือไม่?
ได้ แนบไฟล์ที่ควรมีน้ำหนักเหนือความรู้เดิมของโมเดล — ข้อกำหนด หลักสูตรการสอน บันทึกถอดเสียง หรือคู่มือแบรนด์ การค้นคืนจะให้ความสำคัญกับคลังข้อมูลนั้นเมื่อคุณถามคำถามที่เกี่ยวข้อง ซึ่งช่วยลดการสร้างข้อมูลเท็จในเนื้อหาส่วนตัวได้ Writing Assistant สามารถใช้ตัวอย่างเหล่านั้นสำหรับน้ำเสียงได้อย่างต่อเนื่อง ส่วนเอเจนต์วิจัยสามารถใช้ตัวอย่างเหล่านั้นสำหรับข้ออ้างได้
แชต AI ด้วยหน่วยความจำเวกเตอร์ใช้บนมือถือได้หรือไม่?
ได้ เว็บ, iOS และ Android ใช้ประวัติ การตั้งค่า และหน่วยความจำร่วมกัน มีระบบแปลงเสียงเป็นข้อความเมื่อคุณพิมพ์ไม่ได้ สถานการณ์การเดินทางด้านบนคือแนวทางการออกแบบที่ตั้งใจไว้: ค้นคืนเวกเตอร์ชุดเดียวกันจากโทรศัพท์กับที่คุณสร้างไว้บนโต๊ะทำงาน
เอเจนต์ที่มีหน่วยความจำแม่นยำเพียงพอสำหรับหัวข้ออ่อนไหวหรือไม่?
หน่วยความจำช่วยเพิ่มความสม่ำเสมอ แต่ไม่ได้ทำให้โมเดลไร้ข้อผิดพลาด บทสำรวจ RAG ยังคงระบุว่าคุณภาพการค้นคืน บริบทที่มีสัญญาณรบกวน และความซื่อตรงต่อแหล่งข้อมูลเป็นปัญหาที่ยังเปิดอยู่ (Sharma, 2025) สำหรับการตัดสินใจด้านสุขภาพ กฎหมาย หรือการเงิน ให้ใช้เอเจนต์เป็นเครื่องมือสนับสนุนและตรวจสอบกับแหล่งข้อมูลปฐมภูมิ Personal Therapist สามารถจดจำประเด็นที่คุณขอให้เก็บไว้ ซึ่งมีประโยชน์ต่อความต่อเนื่อง — แต่ไม่ใช่สิ่งทดแทนการดูแลโดยผู้เชี่ยวชาญที่มีใบอนุญาต
หน่วยความจำเวกเตอร์คืออินเทอร์เฟซแชตที่ต่อยอดได้อย่างแท้จริง
แชต AI แบบไร้สถานะสิ้นเปลืองปัจจัยนำเข้าที่มีจำกัดที่สุดของคุณ: เวลาที่ใช้ในการอธิบายตัวเอง แชต AI ด้วยหน่วยความจำเวกเตอร์จัดเก็บความหมายเป็นเอ็มเบดดิง ค้นคืนเมื่อต้องการ และช่วยให้เอเจนต์เฉพาะทางทำงานต่อได้ ตลาดสำหรับชั้นการค้นคืนนี้กำลังขยายตัว เพราะปัญหานี้เกิดขึ้นกับทุกคน — ตั้งแต่การค้นหาเชิงความหมายในระบบใช้งานจริง ไปจนถึงบริบทส่วนบุคคลที่ควรเป็นของผู้ใช้
Jenova วางหน่วยความจำนี้ไว้ใต้งานวิจัย โค้ด เรื่องเล่า และการวางแผน โดยไม่บังคับให้คุณดูแลฐานข้อมูลเวกเตอร์เอง ทำรายงาน Deep Research บริการ Python หรือแคมเปญสวมบทบาท ต่อเนื่อง ราวกับเอเจนต์อยู่ในห้องเดียวกับคุณมาตลอด
สำรวจคลังเอเจนต์ทั้งหมดได้ที่ Jenova
สำหรับนักพัฒนา: เอเจนต์ทุกตัวในบทความนี้พร้อมใช้งานแบบโปรแกรมผ่าน Jenova API — ผสานหน่วยความจำเวกเตอร์ การค้นคืน และเอเจนต์หลายโมเดลเข้ากับแอปของคุณด้วยการเชื่อมต่อเพียงครั้งเดียว เอกสารฉบับเต็ม →