โครงสร้างพื้นฐานหน่วยความจำของ Jenova AI สร้างรายได้ ARR ทะลุ 1 ล้านดอลลาร์ พร้อมผู้ใช้กว่า 200,000 คนใน 70+ ประเทศ
2026-06-20
นิวยอร์ก, NY — 18 มิถุนายน 2026 — Azeroth Inc. บริษัทเทคโนโลยีในนิวยอร์กและผู้พัฒนาแพลตฟอร์มเอเจนต์ AI Jenova ประกาศในวันนี้ว่าสถาปัตยกรรมหน่วยความจำถาวรของบริษัทได้ผลักดันให้แพลตฟอร์มมีรายได้ประจำปี (ARR) มากกว่า 1 ล้านดอลลาร์ และมีการลงทะเบียนผู้ใช้มากกว่า 200,000 คนในกว่า 70 ประเทศ โดยเกือบ 100% ของการเติบโตนี้เป็นการเติบโตแบบออร์แกนิก
หลักการสำคัญของ Jenova คือเอเจนต์ AI ควรจะฉลาดขึ้นยิ่งคุณใช้งานนานขึ้น ทุกการโต้ตอบ ทุกเอกสารที่อัปโหลด ทุกความชอบที่แสดงออกในบริบทหนึ่งจะถูกส่งต่อไปยังบริบทถัดไป หน่วยความจำไม่ใช่ส่วนเสริม แต่มันคือรากฐานของผลิตภัณฑ์ และเป็นสิ่งที่แยก Jenova ออกจากเครื่องมือ AI ทั่วไปที่รีเซ็ตทุกครั้งที่เริ่มเซสชันใหม่
Pinecone ซึ่งมีฐานข้อมูลเวกเตอร์เป็นพื้นฐานของชั้นการดึงข้อมูลของ Jenova ได้เผยแพร่ กรณีศึกษาโดยละเอียด ที่ครอบคลุมสถาปัตยกรรมและผลกระทบของมัน
หน่วยความจำของ Jenova ทำงานอย่างไร
Jenova นำเสนอเอเจนต์ AI เฉพาะทางหลายร้อยตัว ตั้งแต่ Manga Creator ที่ควบคุมความสอดคล้องทางภาพในหลายร้อยหน้า ไปจนถึง Fundamental Stock Analyst ที่ดำเนินกระบวนการวิจัยจากหลายแหล่งข้อมูล และ Roleplay Game Master ที่รักษาสถานะของโลกอย่างถาวรในเซสชันที่ไม่จำกัดจำนวน แต่ละเอเจนต์เป็นระบบผู้เชี่ยวชาญอัตโนมัติที่ออกแบบมาสำหรับโดเมนเฉพาะพร้อมเวิร์กโฟลว์ที่เข้ารหัส ไม่ใช่แค่การครอบพรอมต์บนโมเดลทั่วไป
สิ่งที่ทำให้เอเจนต์เหล่านี้มีมูลค่าเพิ่มขึ้นเมื่อเวลาผ่านไปคือหน่วยความจำ ทุกการสนทนา ทุกไฟล์ที่อัปโหลด ทุกบริบทที่ผู้ใช้ให้ไว้จะถูกเก็บรักษา จัดทำดัชนี และสามารถเรียกค้นได้ เมื่อผู้ใช้ส่งข้อความ ไปป์ไลน์การจัดการของ Jenova จะพิจารณาว่าความรู้ก่อนหน้านี้ใดที่เกี่ยวข้อง ดึงข้อมูลนั้น และใส่เข้าไปในบริบทของเอเจนต์ก่อนที่จะสร้างการตอบกลับ เอเจนต์จะทำงานด้วยมุมมองที่คัดสรรจากประวัติทั้งหมดของผู้ใช้ ไม่ใช่แค่หน้าต่างการสนทนาในปัจจุบัน
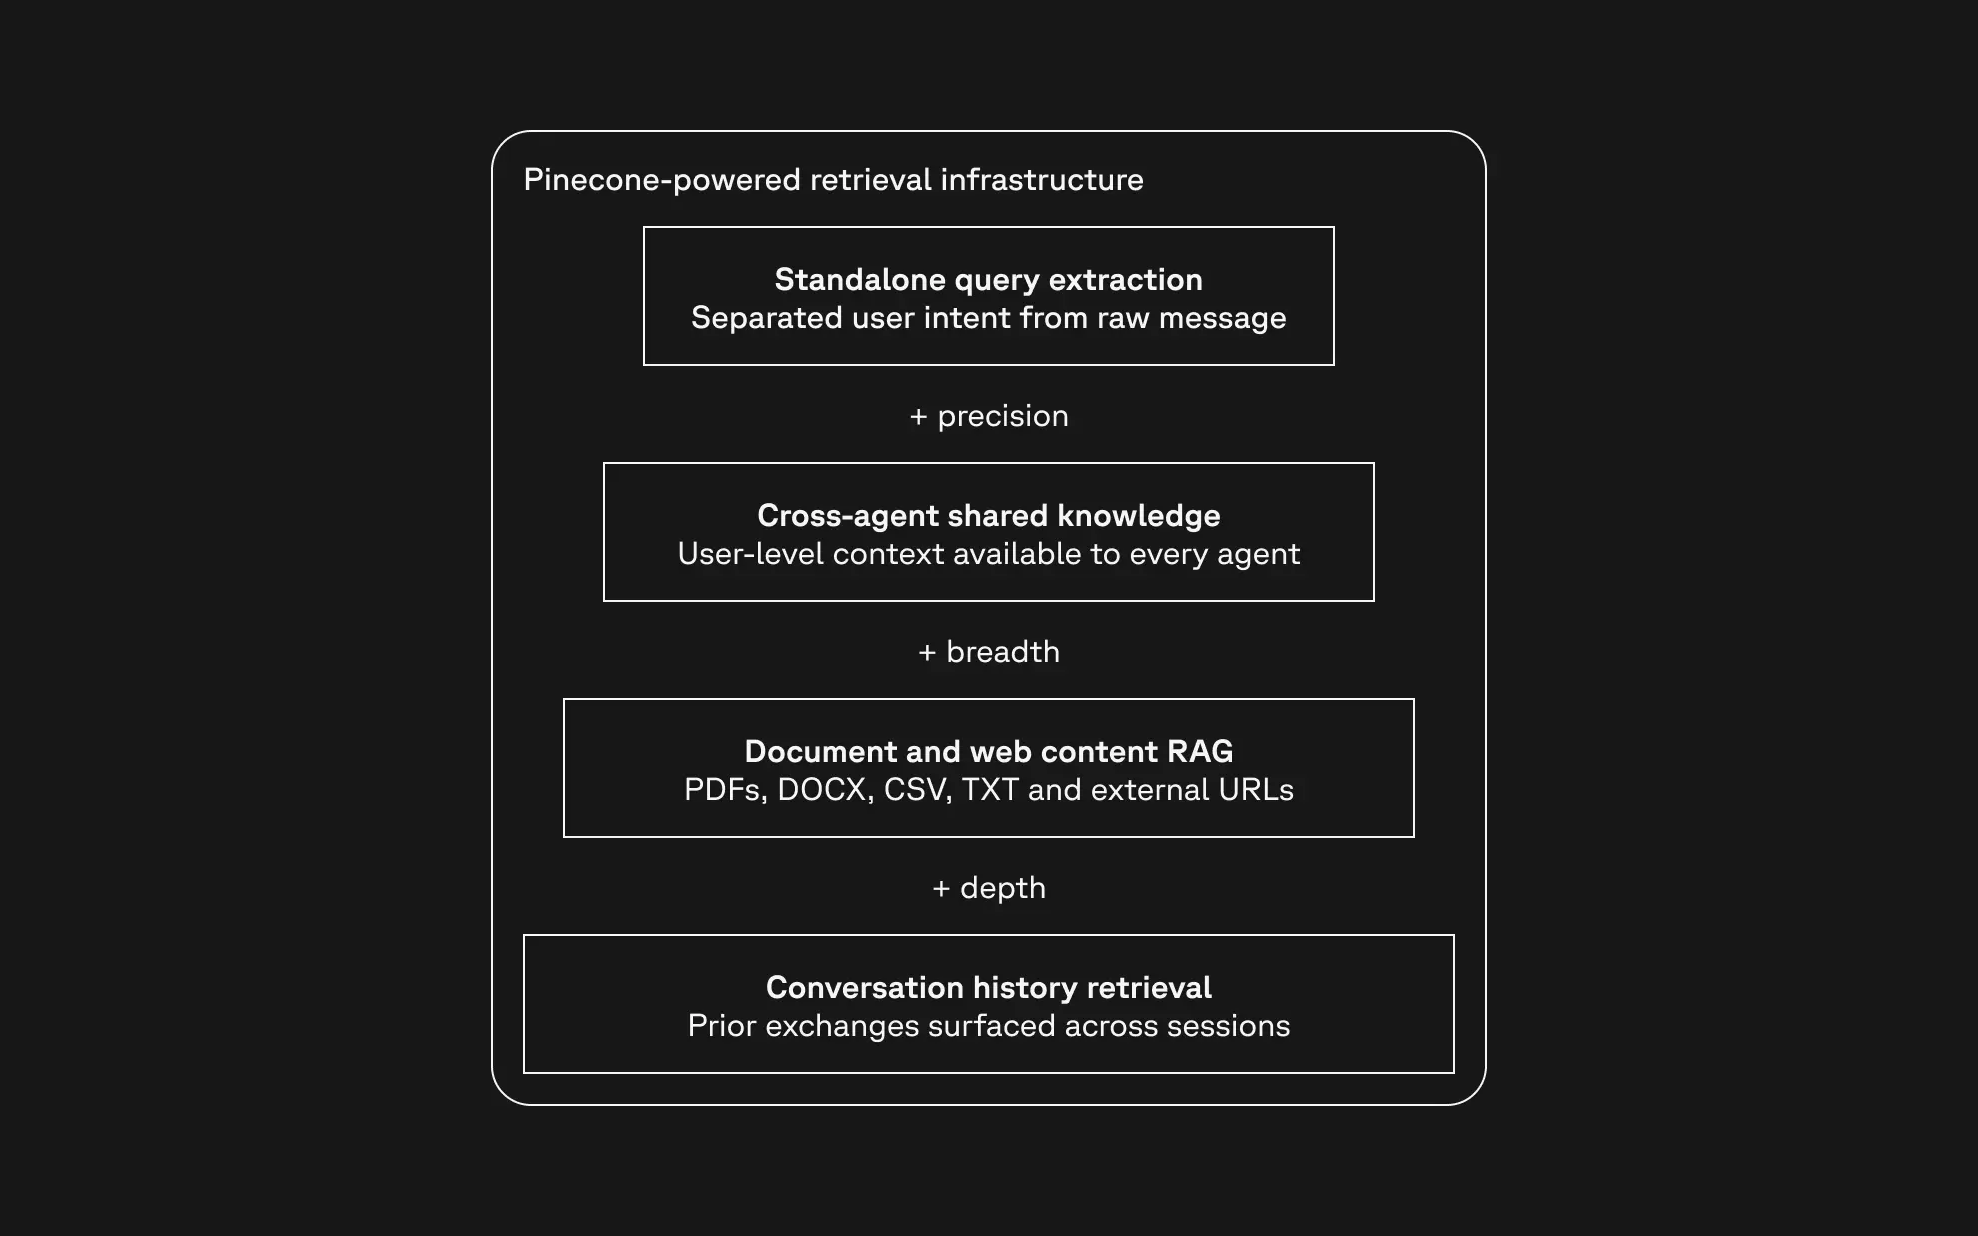
ระบบหน่วยความจำได้พัฒนาผ่านหลักชัยสำคัญสี่ประการ:
- ประวัติการสนทนาไม่จำกัด ทุกการแลกเปลี่ยนจะถูกจัดเก็บโดยไม่มีการบีบอัดหรือวันหมดอายุ เซสชันที่ใช้งานยาวนานที่สุดบนแพลตฟอร์มได้สะสมโทเค็นมากกว่า 16 ล้านโทเค็น แทนที่จะบังคับให้ประวัติทั้งหมดนั้นเข้าสู่บริบท ระบบการดึงข้อมูลของ Jenova จะเลือกแสดงเฉพาะสิ่งที่เกี่ยวข้องกับการโต้ตอบปัจจุบัน ไม่มีอะไรสูญหาย แต่ก็ไม่มีอะไรที่ไม่เกี่ยวข้องมาบดบังความสนใจของเอเจนต์
- การรวมเอกสารและเนื้อหาเว็บ ชั้นหน่วยความจำขยายเกินกว่าการสนทนาเพื่อจัดทำดัชนีไฟล์ที่อัปโหลดในกว่า 40 รูปแบบ (PDF, DOCX, XLSX, CSV, TXT, ไฟล์โค้ด, รูปภาพ และอื่นๆ) รวมถึงเนื้อหาเว็บภายนอก เอเจนต์จะดึงข้อมูลจากเอกสารที่ผู้ใช้ให้ไว้ควบคู่ไปกับประวัติเซสชันเมื่อสร้างการตอบกลับ
- หน่วยความจำที่ใช้ร่วมกันระหว่างเอเจนต์ ชั้นหน่วยความจำที่มีโครงสร้างช่วยให้ทุกเอเจนต์บนแพลตฟอร์มสามารถเข้าถึงบริบทระดับผู้ใช้ที่คงอยู่ข้ามเอเจนต์ ไม่ใช่แค่ข้ามเซสชัน สิ่งที่เอเจนต์หนึ่งเรียนรู้เกี่ยวกับผู้ใช้จะพร้อมใช้งานสำหรับเอเจนต์อื่น ๆ ที่ผู้ใช้โต้ตอบด้วย ผู้ใช้ประมาณหนึ่งในสี่บนแพลตฟอร์มได้เปิดใช้งานหน่วยความจำข้ามเอเจนต์
- การดึงข้อมูลตามเจตนา การเปลี่ยนแปลงสถาปัตยกรรมล่าสุดได้แยกเจตนาของผู้ใช้ออกจากข้อความดิบก่อนการดึงข้อมูล การประเมินภายในแสดงให้เห็นถึงการปรับปรุงความแม่นยำในการดึงข้อมูล 20 ถึง 25 เปอร์เซ็นต์ ซึ่งหมายความว่าเอเจนต์จะแสดงบริบทก่อนหน้าที่ถูกต้องได้บ่อยขึ้นอย่างมีนัยสำคัญ โดยเฉพาะในเซสชันที่ดำเนินมายาวนานซึ่งมีประวัติที่สามารถค้นหาได้จำนวนมาก
ผลลัพธ์
สถาปัตยกรรมหน่วยความจำให้ผลลัพธ์ที่วัดผลได้ในทุกเมตริกที่สำคัญ ดังที่ กรณีศึกษาที่เผยแพร่โดย Pinecone ได้บันทึกไว้อย่างเป็นอิสระ:
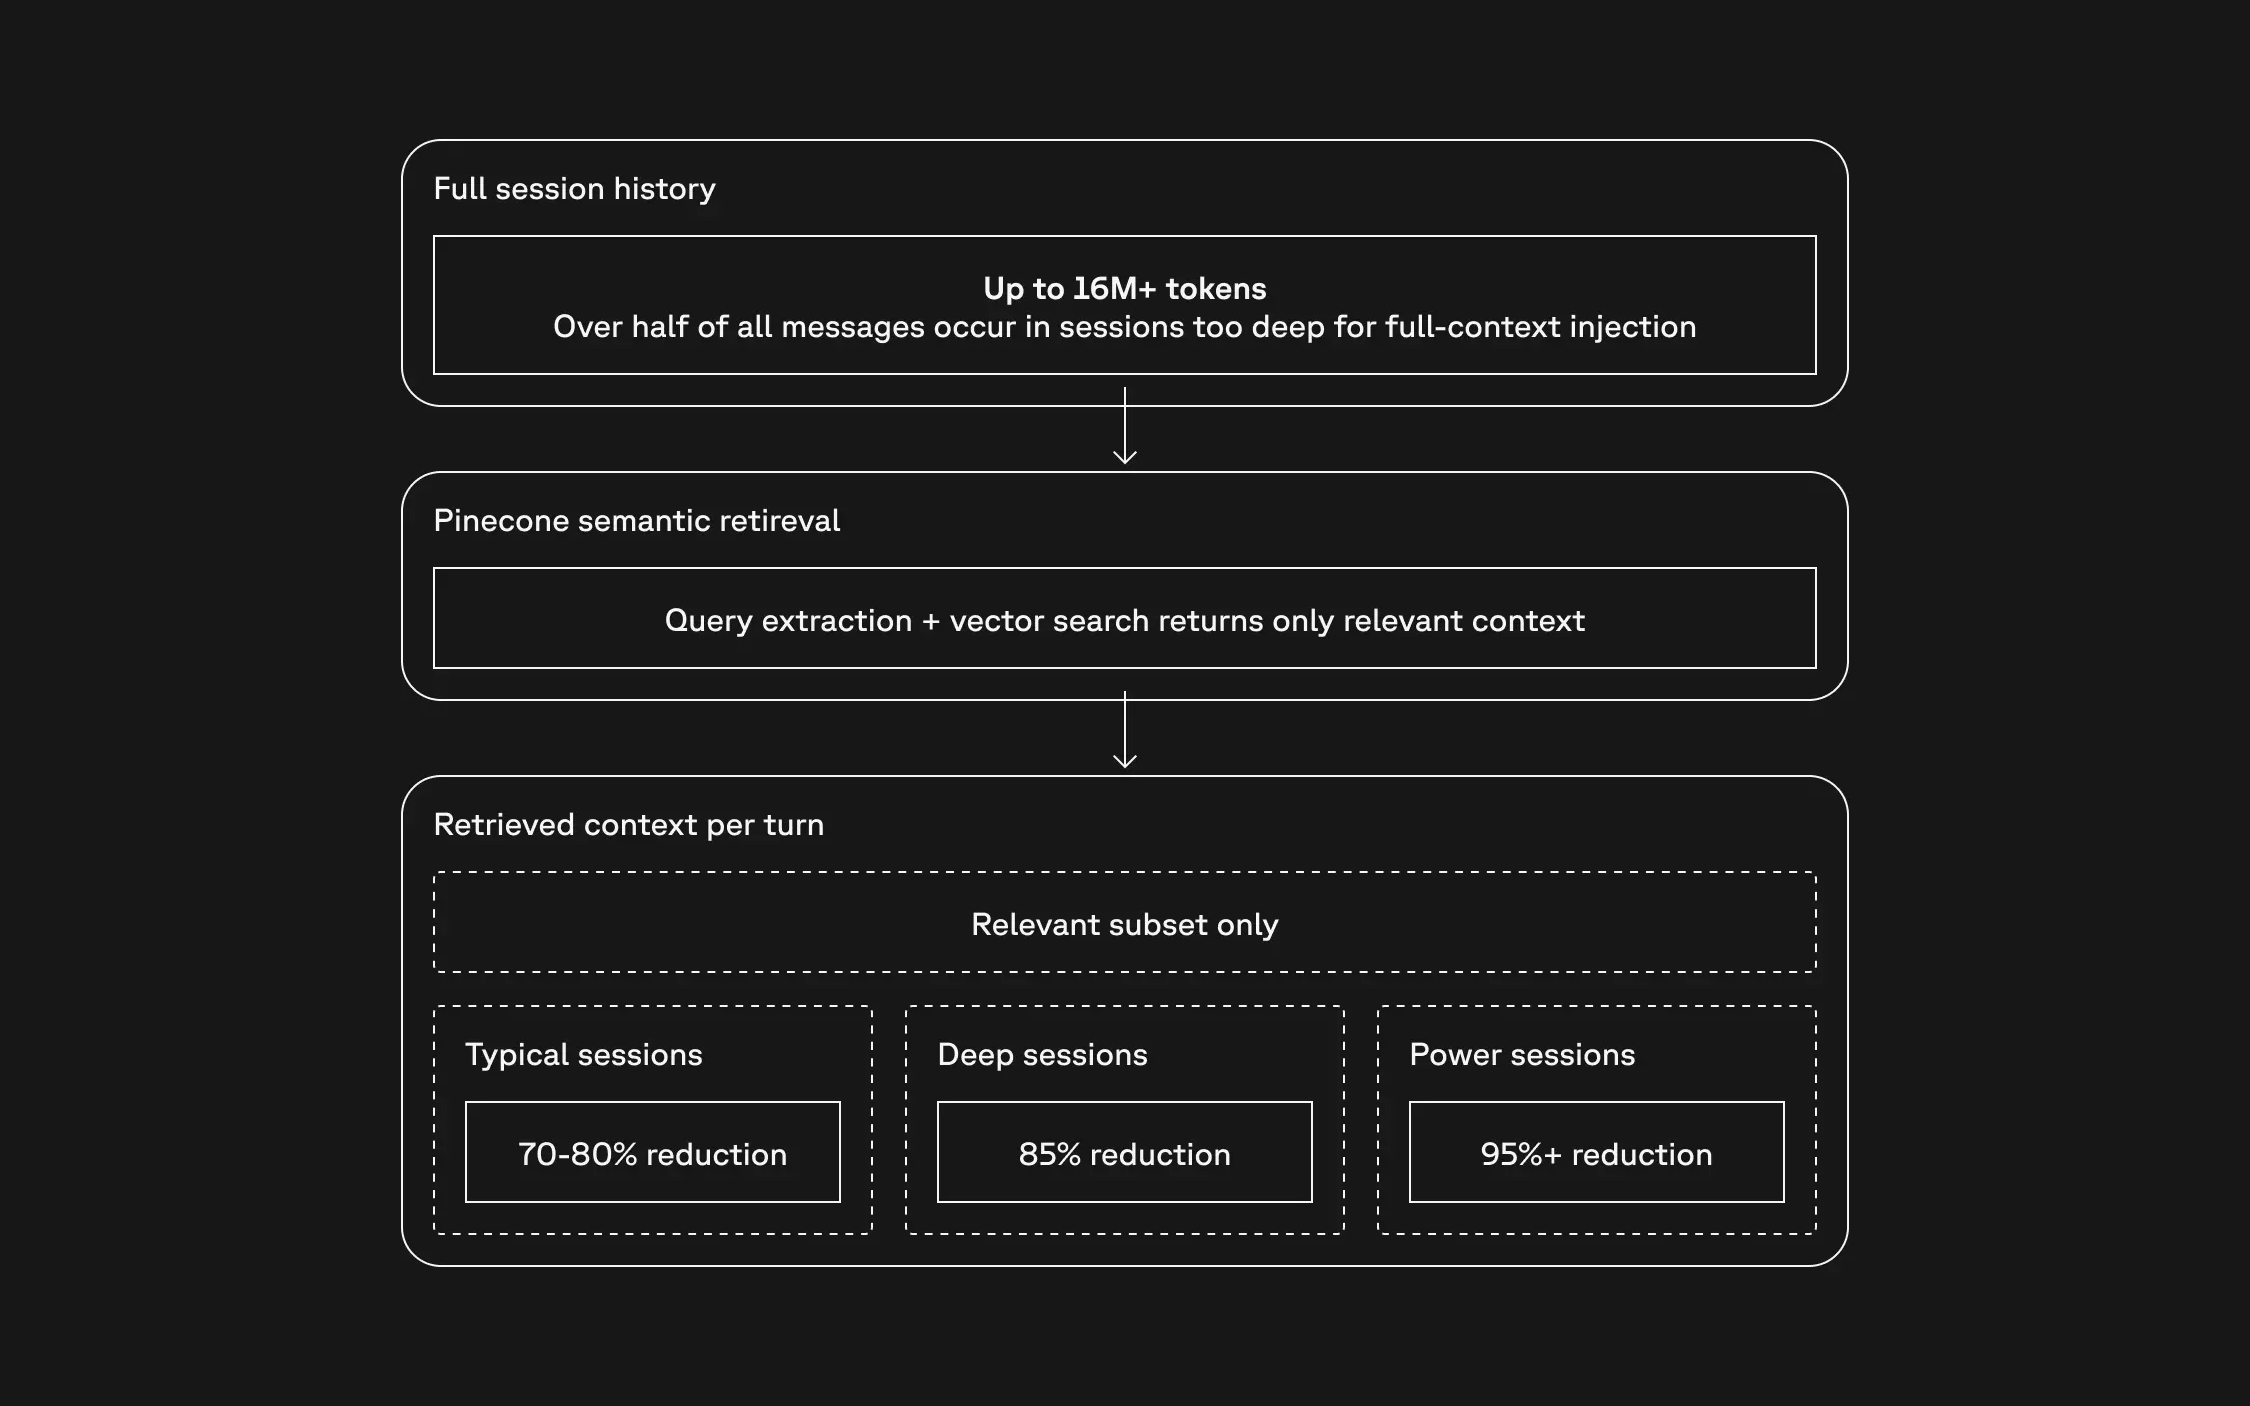
- ลดการใช้โทเค็นต่อเอเจนต์ 70 ถึง 95% มากกว่าครึ่งหนึ่งของข้อความทั้งหมดบนแพลตฟอร์มเกิดขึ้นในเซสชันที่ลึกพอที่การใส่ประวัติทั้งหมดเข้าไปจะมีค่าใช้จ่ายสูงเกินไปหรือเกินขีดจำกัดของโมเดลโดยสิ้นเชิง การดึงข้อมูลแบบเลือกสรรมาแทนที่การใส่บริบทแบบ brute-force สำหรับเซสชันที่มีการใช้งานทั่วไป สิ่งนี้ช่วยลดการใช้โทเค็นได้ 70 ถึง 80% สำหรับเซสชันเชิงลึก 85% และสำหรับเซสชันของผู้ใช้งานหนักที่ยาวนานที่สุด การลดลงเกิน 95% การประหยัดเหล่านั้นส่งผลโดยตรงต่อกำไรขั้นต้น
- ความหน่วงในการดึงข้อมูลต่ำกว่า 10ms การดึงข้อมูลจากหน่วยความจำเสร็จสิ้นในเวลาเพียงไม่กี่มิลลิวินาที ซึ่งเร็วพอที่จะมองไม่เห็นในการโต้ตอบแบบสนทนาที่ผู้ใช้คาดหวังการตอบกลับทันที
- การรักษาผู้ใช้ที่มีมูลค่าสูงผ่านความรู้ที่สะสม ผู้ใช้งานหนักชั้นนำของแพลตฟอร์ม ซึ่งเน้นเวิร์กโฟลว์ที่ใช้หน่วยความจำมาก เช่น การสวมบทบาท การเขียนเชิงสร้างสรรค์ และการวิจัยเฉพาะทางที่ยาวนาน ใช้จ่าย 500 ถึง 2,000 ดอลลาร์ต่อเดือน บริบทที่สะสมมาหลายร้อยเซสชันสร้างองค์ความรู้ที่ไม่สามารถสร้างขึ้นใหม่ได้จากที่อื่น ประวัตินั้นเป็นต้นทุนในการเปลี่ยนไปใช้บริการอื่นที่เพิ่มขึ้นทุกครั้งที่มีการโต้ตอบ
- การเติบโตแบบออร์แกนิกที่ขับเคลื่อนโดยคุณภาพของหน่วยความจำ การเติบโตของ Jenova เกือบทั้งหมดเป็นแบบออร์แกนิก กลุ่มการสวมบทบาทซึ่งคิดเป็นประมาณ 30% ของผู้ใช้ทั้งหมด แสดงให้เห็นรูปแบบนี้ชัดเจนที่สุด: ประมาณ 60% ของผู้ใช้ที่จ่ายเงินใหม่ในหมวดหมู่นี้มาจากการบอกต่อ เมื่อผู้ใช้อธิบายว่าทำไมพวกเขาถึงแนะนำแพลตฟอร์ม คุณภาพของหน่วยความจำเป็นคุณสมบัติที่พวกเขาพูดถึงมากที่สุด ผู้ใช้ที่เคยลองใช้ผลิตภัณฑ์ AI สำหรับการสวมบทบาทโดยเฉพาะต่างชี้ไปที่ชั้นความรู้ถาวรของ Jenova ว่าเป็นเหตุผลที่พวกเขาเปลี่ยนมาใช้
- ไม่มีเหตุการณ์ที่เกี่ยวข้องกับหน่วยความจำในระดับโปรดักชันตั้งแต่เปิดตัว สำหรับแพลตฟอร์มที่ความน่าเชื่อถือของหน่วยความจำเป็นส่วนหนึ่งของคำมั่นสัญญาของผลิตภัณฑ์ ประวัติการดำเนินงานดังกล่าวถือเป็นรากฐานที่สำคัญ
ความสามารถของแพลตฟอร์ม
ชั้นหน่วยความจำทำงานควบคู่ไปกับโครงสร้างพื้นฐานที่กว้างขึ้นของ Jenova:
- การใช้เครื่องมือเอเจนต์ชั้นนำ อัตราความสำเร็จในการเรียกใช้เครื่องมือ 97.3% ในการผสานรวม MCP ทั้งหมดพร้อมการปรับขนาดเครื่องมือที่ไม่จำกัด
- การสนับสนุนหลายโมเดล โมเดลชั้นนำจาก OpenAI, Anthropic, Google และผู้ให้บริการชั้นนำอื่น ๆ พร้อมใช้งานผ่านอินเทอร์เฟซเดียว
- ความเท่าเทียมกันของคุณสมบัติเต็มรูปแบบ เว็บ, iOS และ Android พร้อมการตั้งค่าทั้งหมดที่ซิงค์กันข้ามอุปกรณ์
อะไรจะเกิดขึ้นต่อไป
แผนงานของ Jenova จะเพิ่มการลงทุนในหน่วยความจำและการดึงข้อมูลในสามขอบเขต:
- หน่วยความจำหลายรูปแบบ (Multimodal Memory) ขยายการดึงข้อมูลให้ครอบคลุมเนื้อหารูปภาพผ่านการฝังข้อมูลหลายรูปแบบ ทำให้เอเจนต์อย่าง Manga Creator สามารถดึงข้อมูลจากประวัติภาพของผู้ใช้ตามความหมายแทนที่จะเป็นโครงสร้าง
- เอเจนต์เชิงรุก (Proactive Agents) ความสามารถของเอเจนต์แบบอะซิงโครนัสและเบื้องหลังจะช่วยให้เอเจนต์สามารถดึงและประมวลผลบริบทเชิงรุกได้ นักวิเคราะห์หุ้นที่แสดงบริบทพอร์ตโฟลิโอที่เกี่ยวข้องก่อนที่ผู้ใช้จะถาม เอเจนต์สร้างสรรค์ที่เตรียมบริบทความต่อเนื่องก่อนที่เซสชันจะเริ่มขึ้น
- Managed Agent API เมื่อ Jenova เปิดแพลตฟอร์มให้นักพัฒนาภายนอก เอเจนต์ของบุคคลที่สามจะสร้างขึ้นบนโครงสร้างพื้นฐานหน่วยความจำเดียวกันกับที่ขับเคลื่อนเอเจนต์ของ Jenova เอง โดยมีหน่วยความจำที่จัดการเต็มรูปแบบ, RAG และการจัดการเวิร์กโฟลว์ของเอเจนต์รวมอยู่ด้วย ความรู้ถาวรที่สนับสนุนโดยการดึงข้อมูลจะกลายเป็นความสามารถระดับแพลตฟอร์มแทนที่จะเป็นสิ่งที่นักพัฒนาแต่ละคนต้องสร้างขึ้นใหม่ตั้งแต่ต้น
เกี่ยวกับ Jenova
Jenova เป็นเจ้าภาพของระบบนิเวศที่ขยายตัวอย่างรวดเร็วของเอเจนต์ AI เฉพาะทางที่ออกแบบมาสำหรับกรณีการใช้งานระดับมืออาชีพและสร้างสรรค์โดยเฉพาะ โดยผสมผสานความรู้เชิงลึกในโดเมน การจัดการเวิร์กโฟลว์หลายขั้นตอน และหน่วยความจำถาวรเพื่อส่งมอบระบบผู้เชี่ยวชาญที่มีมูลค่าเพิ่มขึ้นเมื่อเวลาผ่านไป แพลตฟอร์มนี้ได้รับความไว้วางใจจากผู้ใช้ในกว่า 70 ประเทศ ตั้งแต่นักเรียนและนักวิจัยรายบุคคลไปจนถึงทีมงานภายในบริษัทใน Fortune 500
ติดต่อ
Azeroth Inc. อีเมล: [email protected] เว็บไซต์: www.jenova.ai