ควรทดสอบผู้ช่วยวิจัย AI เพื่อความน่าเชื่อถือของแหล่งข้อมูลอย่างไร?
2026-08-22
การตรวจสอบ 5 ข้อใดที่แยกเส้นทางแหล่งข้อมูลที่ตรวจสอบได้ออกจากการอ้างอิงเพื่อภาพลักษณ์?
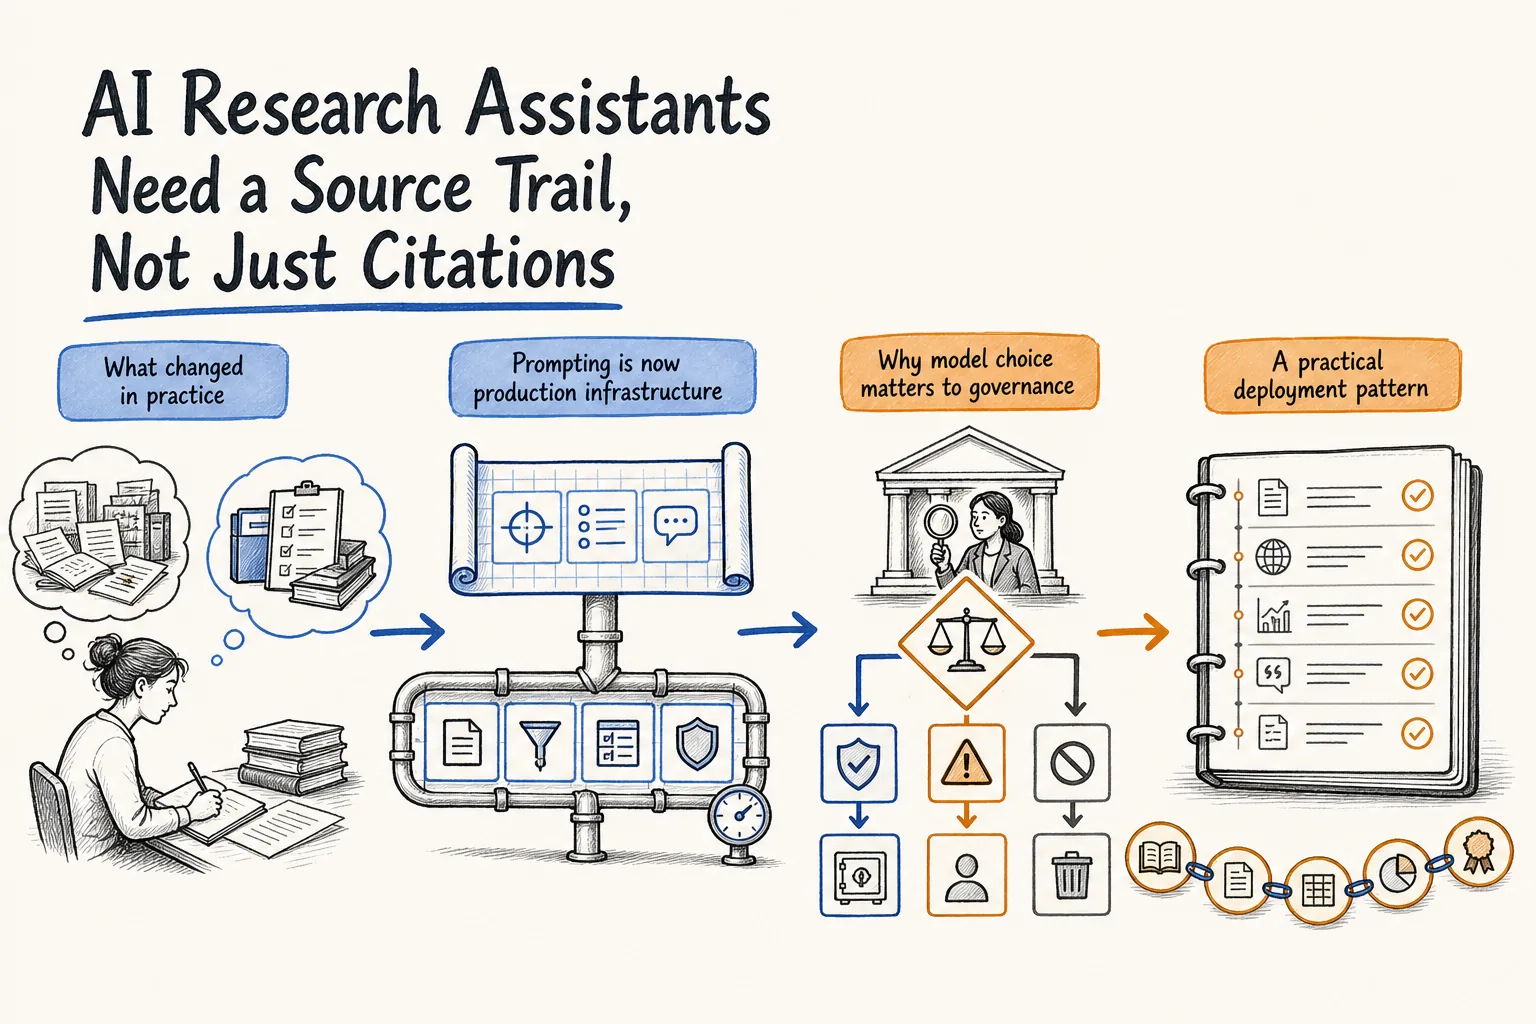
ผู้ช่วยวิจัย AI ที่ใช้งานได้คือผู้ช่วยที่คุณตรวจสอบได้ ไม่ใช่ผู้ช่วยที่เพียง ดูเหมือน มีการอ้างอิง ในปี 2026 การทดสอบเชิงปฏิบัติคือ เครื่องมือนั้นสร้าง เส้นทางแหล่งที่มา ได้หรือไม่ — เส้นทางที่ย้อนกลับได้จากข้ออ้างแต่ละข้อไปยังเอกสารจริงที่มีวันที่และคลิกได้ — ผ่านการตรวจสอบ 5 ด้าน ได้แก่ ความครอบคลุมของแหล่งข้อมูล การอ้างอิงที่คลิกได้ ความสอดคล้องระหว่างข้ออ้างกับแหล่งข้อมูล วันที่อัปเดต และการระบุข้ออนุมาน Jenova's Academic Research Assistant สร้างขึ้นเพื่อการค้นคว้าวรรณกรรมแบบสดและการจัดการการอ้างอิง ขณะที่ Elicit, Scite, Consensus, Perplexity และ ChatGPT Deep Research ต่างผ่านการตรวจสอบบางข้อและล้มเหลวในบางข้อ
ความแตกต่างไม่ได้อยู่ที่ “เชิงอรรถมากกว่า” แนวทางการประเมินของห้องสมุดระบุไว้อย่างชัดเจนว่า แม้เครื่องมือ AI จะอ้างอิงหน้าที่มีอยู่จริง เนื้อหาที่สร้างขึ้นก็อาจยังผิดได้ ดังนั้นคุณต้องตรวจสอบคำตอบ เทียบกับ แหล่งข้อมูลที่อ้างถึง ไม่ใช่เพียงยืนยันว่ามี URL อยู่จริง (Northwestern University Libraries) ด้วยเหตุนี้ การตรวจสอบอย่างเป็นธรรมจึงให้คะแนนใน 5 มิติของ TRACE:
✅ การตรวจสอบย้อนกลับได้ — ทุกข้ออ้างสำคัญมีการอ้างอิงที่คลิกได้และเปิดไปยังเอกสารที่ตั้งใจอ้างถึง ✅ ความครอบคลุมของการค้นคืน — แหล่งข้อมูลครอบคลุมชุดข้อมูลที่เหมาะสม เช่น บทความวิชาการ รายงาน ข่าว และข้อมูลปฐมภูมิ ไม่ใช่ดัชนีสะดวกเพียงแห่งเดียว ✅ ความสอดคล้อง — ข้อความในแหล่งอ้างอิงสนับสนุนข้ออ้างนั้นจริง รวมถึงตัวเลขและเงื่อนไขกำกับ ✅ ความทันสมัย — แสดงวันที่เผยแพร่หรืออัปเดต และทำเครื่องหมายแหล่งข้อมูลที่ล้าสมัย ✅ การระบุสถานะเชิงญาณวิทยา — ผู้ช่วยแยกสิ่งที่อ้างคำพูด สิ่งที่อนุมาน และสิ่งที่ไม่ทราบ
เพื่อเปรียบเทียบเครื่องมืออย่างมีความหมาย ให้มองการเขียนพรอมป์ต์และการให้คะแนนเป็นโครงสร้างพื้นฐานสำหรับการใช้งานจริง: ใช้คำถามเดียวกัน กฎผ่าน/ไม่ผ่านเดียวกัน และกำหนดเหมือนกันว่าการสังเคราะห์ที่ไม่มีหลักฐานรองรับต้องติดป้ายว่าเป็นข้ออนุมาน ไม่ใช่ข้อเท็จจริง
เหตุใดการทดสอบการอ้างอิงจึงสำคัญยิ่งขึ้นสำหรับผู้ช่วยวิจัย AI ในปี 2026?
การทดสอบการอ้างอิงสำคัญมากขึ้นในปัจจุบัน เพราะนักวิจัยกำลังใช้เครื่องมือสร้างเนื้อหาสำหรับการสังเคราะห์ข้อมูลที่มีความเสี่ยงสูง ขณะที่เครื่องมือเหล่านี้ยังสร้างข้อมูลขึ้นเอง อ้างแหล่งผิด และอัปเดตแหล่งข้อมูลของตนอย่างเงียบ ๆ University of Nevada, Reno Libraries อธิบายรูปแบบความล้มเหลวนี้อย่างตรงไปตรงมา: สิ่งที่คุณกำลังประเมินคือ ข้ออ้าง ไม่ใช่ภาพลักษณ์ของรายชื่อแหล่งข้อมูล และการอ้างอิงที่คุณหาไม่พบอาจเป็นข้อมูลหลอนได้
อัตราความผิดพลาดไม่ใช่เพียงทฤษฎี การศึกษาของ JMIR เกี่ยวกับเอกสารอ้างอิงที่ ChatGPT สร้าง พบว่ามีการอ้างอิงเพียงประมาณ 73–76% ที่สอดคล้องกับแหล่งข้อมูลจริง Stanford HAI รายงานว่าโมเดล AI ด้านกฎหมายสร้างข้อมูลหลอนอย่างน้อยหนึ่งข้อในคำถามทดสอบทุก ๆ หกข้อ ตัวเลขเหล่านี้คือเหตุผลที่คำว่า “มันให้บรรณานุกรมมาแล้ว” ไม่ใช่เกณฑ์ยอมรับงาน
ความใหม่ของข้อมูลยิ่งเพิ่มความเสี่ยง การวิเคราะห์อุตสาหกรรมเกี่ยวกับการอ้างอิงของการค้นหา AI รายงานว่า หน้าที่ AI อ้างถึงราวครึ่งหนึ่งมีอายุไม่ถึง 13 สัปดาห์ และเนื้อหาที่ AI อ้างถึงโดยเฉลี่ย ใหม่กว่าผลการค้นหาเว็บแบบดั้งเดิมราว 25% ผู้ช่วยที่ไม่แสดงวันที่อัปเดตอาจดูทันสมัย ทั้งที่กำลังหมุนเวียนตัวเลขจากไตรมาสก่อน หากกระบวนการทำงานของคุณมีการทบทวนวรรณกรรม บันทึกนโยบาย หรือการวิจัยเพื่อการลงทุน ผู้ช่วยที่ไม่ผ่านการตรวจสอบก็เปรียบเสมือนผู้ร่วมเขียนเงียบ ๆ ที่ไม่มีสมุดบันทึกการวิจัย
ควรใช้เกณฑ์ให้คะแนนใดเพื่อตรวจสอบผู้ช่วยวิจัย AI?
ใช้เกณฑ์ระดับข้ออ้างที่มีด่านตรวจแบบผ่าน/ไม่ผ่าน และคะแนนความสอดคล้องแบบมีระดับหนึ่งรายการ แทนการตัดสินภาพรวมว่า “ดูเป็นวิชาการ” หน่วยประเมินคือประโยคข้อเท็จจริงหนึ่งประโยคพร้อมช่วงข้อความที่อ้างอิง ซึ่งเป็นระดับเดียวกับที่ใช้ใน กระบวนการตรวจสอบการอ้างอิงอัตโนมัติซึ่งเปรียบเทียบข้อความกับเนื้อหาที่อ้างถึง
ให้คะแนนทุกข้ออ้างสำคัญตามเกณฑ์นี้:
| การตรวจสอบ | ผ่าน | ผ่านบางส่วน | ไม่ผ่าน |
|---|---|---|---|
| ความครอบคลุมของแหล่งข้อมูล | แหล่งปฐมภูมิหรือแหล่งผ่านการประเมินโดยผู้ทรงคุณวุฒิที่เหมาะกับข้ออ้าง | มีเพียงแหล่งทุติยภูมิที่เกี่ยวข้อง | บล็อก หน้า SEO หรือแหล่งผิดประเภทสำหรับข้ออ้างนั้น |
| การอ้างอิงที่คลิกได้ | URL เปิดเอกสารที่อ้างถึงในตำแหน่งที่ใช้งานได้ | URL เปิดหน้าแรกหรือหน้าจอเริ่มต้นของเนื้อหาที่ต้องชำระเงิน | ลิงก์เสีย เปลี่ยนเส้นทางไปเนื้อหาที่ไม่เกี่ยวข้อง หรือสร้างขึ้นเอง |
| ความสอดคล้องระหว่างข้ออ้างกับแหล่งข้อมูล | แหล่งข้อมูลสนับสนุนข้ออ้าง รวมทั้งตัวเลขและเงื่อนไขกำกับ | แหล่งข้อมูลอยู่ในหัวข้อเดียวกันแต่ไม่รองรับข้ออ้างที่เฉพาะเจาะจง | ขัดแย้ง ตัวเลขผิด หรือกระโดดข้ามเหตุผลโดยไม่มีหลักฐาน |
| วันที่อัปเดต | แสดงวันที่และเหมาะสมกับคำถาม | มีวันที่แต่เก่าเกินไปเมื่อเทียบกับคำถาม | ไม่มีวันที่ หรือคาดเดาวันที่โดยไม่มีหลักฐาน |
| การระบุข้ออนุมาน | ผู้ช่วยระบุการสังเคราะห์ การคาดการณ์ และสิ่งที่ไม่ทราบ | ผสมข้อความที่มีแหล่งอ้างอิงกับข้ออนุมาน แต่เตือนไว้อย่างไม่ชัด | เขียนข้ออนุมานเป็นข้อเท็จจริงที่ยืนยันแล้ว |
เส้นผ่านที่ใช้งานได้จริงสำหรับงานระดับมืออาชีพคือ: ไม่มีลิงก์ที่สร้างขึ้นเอง ไม่มีข้ออ้างเชิงตัวเลขที่ไม่ติดป้ายกำกับ และข้ออ้างสำคัญอย่างน้อย 80% ต้องได้รับการสนับสนุนอย่างครบถ้วนจากช่วงข้อความที่อ้างถึง การอนุมานเชิงตรรกะจากข้อความเป็นมาตรฐานที่เหมาะสม เพราะประเมินช่องว่างของการอนุมานแทนความทับซ้อนของคำสำคัญ งานวิจัย ACL Findings เกี่ยวกับการประเมิน Open-QA แสดงว่าการให้คะแนนด้วยการอนุมานเชิงตรรกะสอดคล้องกับการตัดสินของมนุษย์มากกว่าเมตริกการจับคู่แบบตรงตัว
ใช้เกณฑ์นี้กับชุดคำถามทดสอบที่กำหนดตายตัว: คำถามข่าวหรือเชิงนโยบายที่เปลี่ยนแปลงรวดเร็วหนึ่งข้อ ข้ออ้างเชิงปริมาณทางวิทยาศาสตร์หนึ่งข้อ คำถามเกี่ยวกับวรรณกรรมที่ขัดแย้งกันหนึ่งข้อ และคำถาม “สิ่งใดที่ยังไม่ทราบ” หนึ่งข้อ หากผู้ช่วยไม่สามารถล้มเหลวอย่างเหมาะสมกับคำถามข้อสุดท้าย ก็ยังไม่พร้อมสำหรับการวิจัย
Elicit, Consensus, Scite, Perplexity และ Jenova มีความน่าเชื่อถือของแหล่งข้อมูลแตกต่างกันอย่างไร?
ไม่มีผู้ช่วยวิจัย AI รายใดนำในทุกมิติของ TRACE Elicit แข็งแกร่งที่สุดด้านการดึงข้อมูลอย่างมีโครงสร้างจากชุดบทความขนาดใหญ่ Scite แข็งแกร่งที่สุดด้านทิศทางของการอ้างอิง Perplexity และ ChatGPT รวดเร็วที่สุดสำหรับคำตอบจากเว็บเปิดพร้อมลิงก์ในบรรทัด ส่วน Jenova’s Academic Research Assistant เหมาะกว่าเมื่อคุณต้องการเซสชันวิจัยสดจากหลายแหล่ง ซึ่งรักษาเส้นทางการตรวจสอบได้ตลอดการสนทนาหลายรอบ
การเปรียบเทียบเชิงปฏิบัติในปี 2026 มักมอง Elicit เป็นเครื่องมือหลักสำหรับการทบทวนวรรณกรรม และ Consensus เป็นเครื่องมือวัดหลักฐานแบบใช่/ไม่ใช่ที่รวดเร็วกว่า บทสรุปเครื่องมือวิจัยทางการแพทย์ อธิบาย Perplexity ว่าเป็นตัวเลือกอเนกประสงค์ที่เร็วที่สุด พร้อมการอ้างอิงในบรรทัดและข้อจำกัดน้อยกว่าผู้เชี่ยวชาญทางวิชาการ การเปรียบเทียบเครื่องมือทบทวนวรรณกรรมของ HKUST เป็นแค็ตตาล็อกที่มีประโยชน์เกี่ยวกับความแตกต่างด้านความครอบคลุมและการเข้าถึงของเครื่องมือเหล่านี้
| คุณลักษณะ / มิติ | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| ความครอบคลุมของแหล่งข้อมูล | บทความมากกว่า 125M+; เน้นวิชาการ (Elicit) | กราฟการอ้างอิงและ Smart Citations จากข้อความเต็ม (Scite) | ชุดบทความที่ปรับให้เหมาะกับคำถามวิจัย | เว็บเปิดพร้อมแหล่งวิชาการแบบเลือกใช้ | เว็บสด + การค้นหาวิชาการ กระบวนการจัดการต้นฉบับและการอ้างอิง |
| การอ้างอิงที่คลิกได้ | ระเบียนบทความและข้อความที่ดึงออกมา | หน้าการอ้างอิงพร้อมตัวอย่างบริบท | คำตอบที่อิงบทความ | URL ในบรรทัด; คุณภาพแตกต่างตามคำถาม | ลิงก์แหล่งข้อมูลที่คลิกได้ในคำตอบการวิจัย |
| ความสอดคล้องระหว่างข้ออ้างกับแหล่งข้อมูล | ความแม่นยำในการดึงข้อมูลที่เผยแพร่ 1,502/1,511 จุดข้อมูล (99.4%) | แสดงการอ้างอิงที่สนับสนุนเทียบกับที่ขัดแย้ง | แข็งแกร่งสำหรับคำถามหลักฐานแบบทวิภาค | ผู้ใช้ต้องตรวจสอบเอง; มีเอกสารบันทึกความเสี่ยงของข้อมูลหลอน | ขึ้นอยู่กับช่วงข้อความที่ค้นคืน; ไม่มีเกณฑ์มาตรฐานการดึงข้อมูลที่เผยแพร่ |
| วันที่อัปเดต | ข้อมูลเมตาของบทความ เช่น ปีและวารสาร | บริบทปีที่เผยแพร่ | บริบทปีของบทความ | ไม่สม่ำเสมอหากไม่สั่งโดยตรง | สามารถแสดงและเปรียบเทียบวันที่ได้เมื่อแหล่งข้อมูลเปิดเผยวันที่ |
| การระบุข้ออนุมาน | คอลัมน์แบบมีโครงสร้างช่วยลดการก้าวข้ามเหตุผลที่ซ่อนอยู่ | ป้ายทิศทางการอ้างอิง ไม่ใช่ป้ายสถานะเชิงญาณวิทยาครบถ้วน | Consensus Meter แสดงระดับความเห็นพ้อง | แทบไม่ระบุข้ออนุมานหากไม่ได้ร้องขอ | สามารถสั่งให้ติดป้ายข้ออ้างที่มีแหล่งอ้างอิงเทียบกับข้ออ้างที่อนุมานได้ |
| ราคา (ณ ปี 2026) | ไม่ได้รับการยืนยันในการทบทวนนี้ | ไม่ได้รับการยืนยัน; การทดสอบเก่าระบุว่ามีช่วงทดลองสั้น (Pure AI) | ราว $144/year สำหรับระดับเริ่มต้น ในการเปรียบเทียบหนึ่งฉบับของปี 2026 | ไม่ได้รับการยืนยัน; แบ่งระดับโดยผู้ให้บริการ | ใช้งานฟรีแบบจำกัด; Plus $20/mo (30×), Premium $50, Pro $100, Max $200, Ultra $500, Enterprise $1,000 |
| เหมาะที่สุดสำหรับ | การดึงข้อมูลอย่างเป็นระบบจากบทความ | ตรวจสอบว่าวรรณกรรมสนับสนุนข้ออ้างหรือไม่ | คำถามวิทยาศาสตร์แบบใช่/ไม่ใช่ที่ต้องการคำตอบเร็ว | การสำรวจเว็บกว้างพร้อมลิงก์ในบรรทัด | การวิจัยหลายรอบที่ตรวจสอบได้และการจัดการการอ้างอิง |
ข้อจำกัดอย่างตรงไปตรงมาของ Jenova เป็นเรื่องของโครงสร้าง: ไม่ใช่ตารางดึงข้อมูลจากบทความที่สร้างมาโดยเฉพาะแบบ Elicit และไม่มีกราฟการอ้างอิงแบบสนับสนุนเทียบกับขัดแย้งของ Scite จุดแข็งคือหน่วยความจำของเซสชันร่วมกับการค้นคืนแบบสด ซึ่งสำคัญเมื่อการตรวจสอบต้องใช้คำถามติดตามต่อจากเส้นทางแหล่งข้อมูลเดิม ข้อจำกัดของ Elicit เป็นภาพตรงกันข้าม — โดดเด่นภายในดัชนีบทความ แต่ด้อยกว่าในฐานะผู้ค้นคว้าเอกสารเว็บทั่วไปหรือเอกสารนโยบาย Perplexity และ ChatGPT ยังคงเป็นเครื่องมือที่ผู้ใช้ไว้วางใจมากเกินไปได้ง่ายที่สุด เพราะการอ้างอิงในบรรทัดที่ลื่นไหลอาจยังไม่สอดคล้องกับแหล่งข้อมูล
คุณจะทดสอบความครอบคลุมของแหล่งข้อมูลและการอ้างอิงที่คลิกได้อย่างไร?
ทดสอบความครอบคลุมด้วยการตั้งคำถามที่คำตอบถูกต้อง ไม่สามารถ มาจากชุดข้อมูลเพียงชุดเดียว แล้วคลิกทุกลิงก์ การผ่านเกณฑ์ความครอบคลุมหมายความว่าผู้ช่วยค้นคืนประเภทแหล่งข้อมูลที่ข้ออ้างต้องการ เช่น การทดลองสำหรับขนาดผลทางคลินิก กฎหมายหรือหน้าเว็บหน่วยงานสำหรับเกณฑ์ทางกฎหมาย หรือคู่มือรหัสชุดข้อมูลสำหรับสถิติ แทนที่จะหยิบบล็อกที่สะดวกซึ่งพูดถึงคำสำคัญเดียวกัน
สร้างคำถามทดสอบความครอบคลุม 3 แบบ:
- คำถามเฉพาะวิชาการ: “การทดลองแบบสุ่มตั้งแต่ปี 2020 แสดงอะไรเกี่ยวกับ X และผลลัพธ์ใดที่ลงทะเบียนล่วงหน้าไว้?”
- คำถามเอกสารปฐมภูมิ: “กฎ ระเบียนยื่นคำขอ หรือชุดข้อมูลต้นฉบับจากหน่วยงานระบุว่าอย่างไร — ไม่ใช่บทสรุปข่าว?”
- คำถามพื้นที่ที่ยังพิสูจน์ไม่ได้: “แหล่งข้อมูลที่น่าเชื่อถือใดพูดถึงเรื่องนี้ แต่ยังถือว่าผลกระทบดังกล่าวไม่ได้รับการพิสูจน์?”
จากนั้นใช้ขั้นตอนการคลิก สำหรับการอ้างอิงแต่ละรายการ ให้บันทึกว่า URL เปิดได้หรือไม่ หน้าปลายทางเป็นเอกสารที่อ้างถึงหรือไม่ และมนุษย์สามารถหาช่วงข้อความสนับสนุนได้ภายในสองนาทีหรือไม่ คู่มือประเมินของ Northwestern แนะนำให้ค้นหาชื่อเรื่องในแค็ตตาล็อกห้องสมุดหรือฐานข้อมูล เพราะระบบ AI มักนำชื่อเรื่องจริงไปจับคู่กับวารสาร ผู้เขียน หรือปีที่ผิด ลิงก์เสีย ลิงก์ที่พาไปเพียงหน้าแรก และเชิงอรรถประเภท “แหล่งที่มา: อินเทอร์เน็ต” ถือว่าไม่ผ่านโดยอัตโนมัติ
สำหรับ Jenova ให้กำหนดความครอบคลุมเป็นคำสั่งที่ชัดเจน ไม่ใช่ความหวัง:
“ตอบโดยใช้แหล่งข้อมูลอิสระอย่างน้อยสี่แหล่ง ให้ความสำคัญกับบทความที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิ หน่วยงานรัฐหรือองค์กรกำหนดมาตรฐาน และชุดข้อมูลปฐมภูมิ สำหรับทุกข้ออ้าง ให้ระบุ URL ที่คลิกได้ ชื่อเอกสาร วันที่เผยแพร่หรืออัปเดต และคำอ้างความยาว 15–25 คำที่สนับสนุนข้ออ้างนั้น หากหาแหล่งปฐมภูมิไม่ได้ ให้บอกเช่นนั้นและหยุด”
สำหรับ Elicit การทดสอบที่เทียบเท่าคือเซลล์ข้อมูลที่ดึงออกมาต้องเชื่อมกลับไปยังช่วงข้อความที่มองเห็นได้ในบทความ ไม่ใช่คำถอดความจากโมเดล สำหรับ Perplexity หรือ ChatGPT การทดสอบเข้มงวดกว่า: เปิดลิงก์ในบรรทัดทุกลิงก์ เพราะ เอเจนต์วิจัยเว็บเปิด อาจค้นคืนได้หลายหน้า แต่ยังเลือกอ้างแหล่งที่อ่อนแอที่สุด การใช้ Jenova’s Academic Research Assistant ร่วมกับ Real-Time Search มีประโยชน์เมื่อคำถามครอบคลุมทั้งบทความ ฟอรัม ที่เก็บโค้ด และข่าวในคราวเดียว แต่แต่ละช่องทางก็ยังต้องผ่านการตรวจสอบด้วยการคลิกของตนเอง
คุณจะทดสอบความสอดคล้องระหว่างข้ออ้างกับแหล่งข้อมูล และการระบุข้ออนุมานอย่างไร?
ทดสอบความสอดคล้องด้วยการถามว่าช่วงข้อความที่อ้างถึง สนับสนุนตามตรรกะ ประโยคนั้นหรือไม่ ไม่ใช่เพียงเกี่ยวข้องอย่างคลุมเครือ ความล้มเหลวที่สำคัญที่สุดคือตัวเลขที่เกือบตรงกัน หรือเงื่อนไขกำกับที่ถูกตัดออก: แหล่งข้อมูลระบุว่า “ประมาณ 80%” แต่โมเดลเขียนว่า “78%” และการอ้างอิงยังดูสมบูรณ์แบบ นี่คือประเภทความผิดพลาดที่ระบบประเมินอัตโนมัติถูกสร้างมาเพื่อตรวจจับ
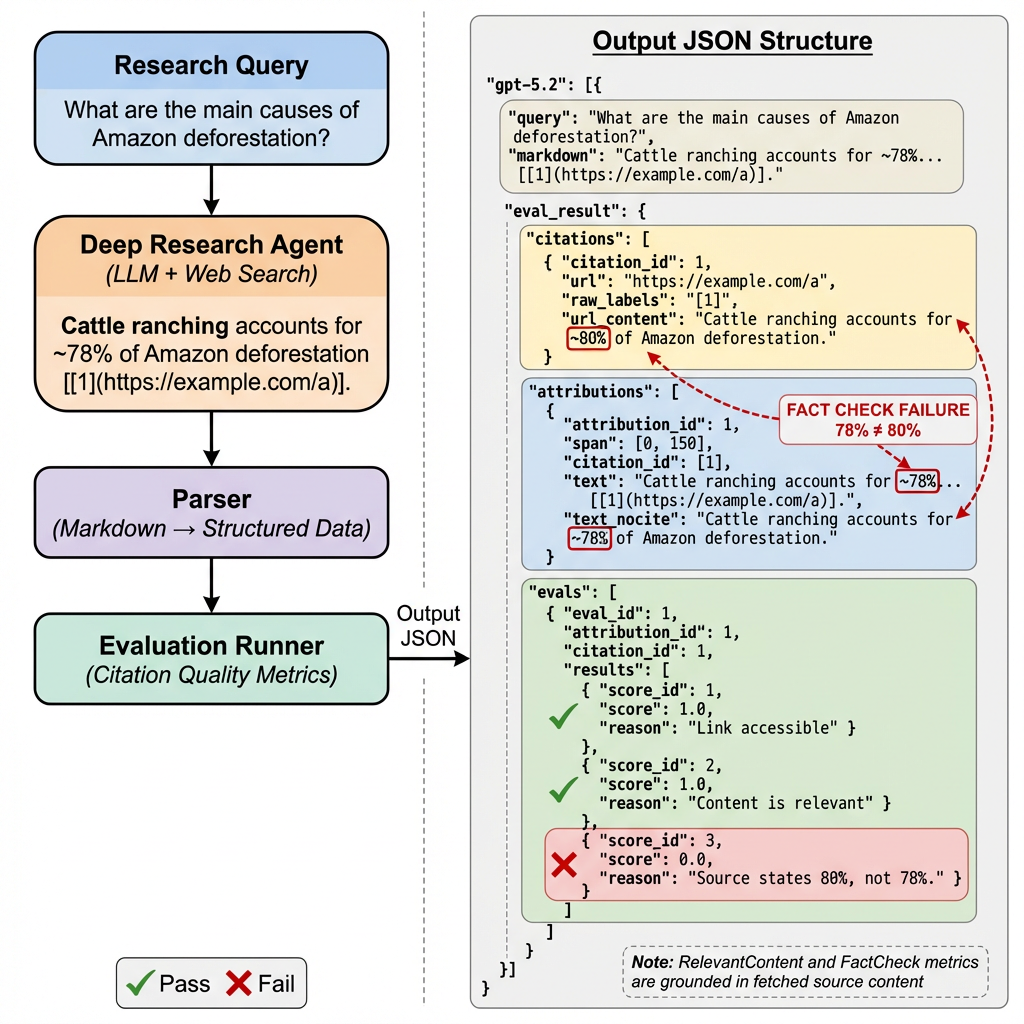
ใช้การทดสอบความสอดคล้อง 3 ชั้นกับทุกข้ออ้างเชิงปริมาณหรือเชิงเหตุและผล:
- การจับคู่ช่วงข้อความ: เน้นประโยคในแหล่งข้อมูลที่อ้างว่าสนับสนุนข้ออ้างนั้น
- การอนุมานเชิงตรรกะ: ตัดสินว่า สนับสนุน, ระบุไม่ได้, หรือ ขัดแย้ง การระบุไม่ได้ถือว่าไม่ผ่าน หากผู้ช่วยนำเสนอข้ออ้างนั้นเป็นข้อเท็จจริง
- ความเที่ยงตรงของตัวเลขและเงื่อนไขกำกับ: หน่วย กลุ่มตัวอย่าง ปี ช่วงความเชื่อมั่น และคำอย่าง “อาจ”, “ในหนูทดลอง” หรือ “ในประเทศเดียว” ต้องคงอยู่ครบถ้วน
นี่คือเหตุผลที่การอนุมานเชิงตรรกะจากข้อความเป็นเมตริกตรวจสอบที่ดีกว่าการบอกว่า “หน้านี้อยู่ในหัวข้อเดียวกัน” การประเมิน Open-QA ด้วยการอนุมานเชิงตรรกะ มีขึ้นโดยเฉพาะเพื่อวัดช่องว่างของการอนุมานระหว่างข้อความสองชุด แนวทางตรวจสอบการอ้างอิงของ NVIDIA นำแนวคิดเดียวกันไปใช้จริง: เปรียบเทียบข้ออ้างกับข้อความที่อ้างถึง แล้วให้คะแนน
การระบุข้ออนุมานคือการตรวจสอบคู่กัน ผู้ช่วยวิจัยควรติดป้ายทุกย่อหน้าว่า sourced, inferred หรือ unknown การสังเคราะห์ข้อมูลทำได้ แต่การสังเคราะห์แบบเงียบ ๆ ทำไม่ได้ แนวทางตรวจสอบข้ออ้างของ UNR มีแนวคิดที่ถูกต้อง: ให้ถามว่าใครตรวจสอบข้อความนั้นได้ หากผู้ตรวจสอบคือ “ความรู้ทั่วไปของโมเดล” ประโยคนั้นต้องมีป้ายข้ออนุมาน
พรอมป์ต์ที่เข้มงวดสำหรับการตรวจสอบนี้:
“แยกคำตอบของคุณเป็นสามส่วนที่ติดป้ายกำกับ: (1) ข้ออ้างที่มีหลักฐานสนับสนุนโดยตรง พร้อมคำอ้างและ URL; (2) ข้ออนุมาน พร้อมระบุหลักฐานตั้งต้นที่รองรับ; (3) สิ่งที่ไม่ทราบ ห้ามย้ายข้ออนุมานไปอยู่ในส่วนที่ 1 หากตัวเลขในแหล่งข้อมูลเป็นค่าโดยประมาณ ให้คงความเป็นค่าโดยประมาณไว้”
Elicit ลดข้ออนุมานที่ซ่อนอยู่ด้วยการบังคับให้คำตอบอยู่ในคอลัมน์การดึงข้อมูล ซึ่งเป็นจุดแข็งจริง Scite ติดป้ายว่าบทความในภายหลังสนับสนุนหรือขัดแย้งกับการอ้างอิงหนึ่งรายการ ซึ่งช่วยจับการก้าวข้ามเหตุผลอีกแบบหนึ่ง คือการถือว่าบทความหนึ่งฉบับเป็นฉันทามติที่ยุติแล้ว Jenova สามารถทำตามรูปแบบสามส่วนนี้ได้ตลอดเซสชันยาว แต่จะไม่บังคับใช้ป้ายเหล่านี้หากคุณไม่ได้กำหนด นี่คือช่องว่างของผลิตภัณฑ์ที่แท้จริงเมื่อเทียบกับเครื่องมือที่มีตัววัดหลักฐานติดตั้งมาในตัว
คุณควรตรวจสอบวันที่อัปเดตและความใหม่ของแหล่งข้อมูลอย่างไร?
ตรวจสอบความใหม่ด้วยการกำหนดให้ทุกแหล่งข้อมูลต้องแสดงวันที่ที่มองเห็นได้ และใส่คำถามทดสอบอย่างน้อยหนึ่งข้อซึ่งคำตอบที่ถูกต้องเปลี่ยนไปในปีที่ผ่านมา ผู้ช่วยที่ไม่สามารถแสดงได้ว่าหน้าหรือบทความเผยแพร่เมื่อใด ยังไม่พร้อมตอบคำถามเรื่องราคา กฎระเบียบ การเปิดตัวโมเดล ระบาดวิทยา หรือโครงสร้างตลาด
งานวิจัยความใหม่ของเนื้อหาในการค้นหา AI พบว่าความใหม่ส่งผลต่อการที่ระบบจะค้นคืนหน้าเว็บสำหรับคำถามปัจจุบันหรือไม่ งานติดตามการอ้างอิง AI เตือนเช่นกันว่า ระบบค้นหาอาจประเมินแหล่งข้อมูลใหม่อย่างต่อเนื่อง ดังนั้นรายงานที่ดูเรียบร้อยเมื่อวานอาจเสื่อมสภาพอย่างเงียบ ๆ การตรวจสอบของคุณจึงควรบันทึก 3 วันที่ ไม่ใช่วันเดียว:
- วันที่ของแหล่งข้อมูล — เวลาที่เผยแพร่หรืออัปเดตล่าสุดที่แสดงบนหน้าหรือบทความ
- วันที่ของหลักฐาน — ปีที่เก็บรวบรวมข้อมูลพื้นฐาน
- วันที่ของคำตอบ — เวลาที่ผู้ช่วยค้นคืนแหล่งข้อมูล
ความล้มเหลวที่พบบ่อยคือการอ้างอิงบททบทวนปี 2019 เพื่อระบุตัวเลขความชุก “ปัจจุบัน” หรือการอ้างแดชบอร์ดสดโดยไม่บันทึกเวลาในการค้นคืน ผู้เชี่ยวชาญทางวิชาการอย่าง Elicit และ Consensus มักแสดงปีเผยแพร่ เพราะทำงานบนข้อมูลเมตาของบทความ เครื่องมือเว็บเปิดมักไม่แสดง เว้นแต่คุณจะสั่ง Jenova สามารถรายงานวันที่ได้เมื่อเอกสารที่ค้นคืนเปิดเผยวันนั้น แต่ไม่อาจสร้างเวลาประทับที่น่าเชื่อถือให้กับหน้าที่ไม่มีวันที่ได้ — และควรบอกตรง ๆ ว่าไม่มี
ตัวอย่างคำถามทดสอบความใหม่:
“ตัวเลขปัจจุบัน ณ ปี 2026 คือเท่าไร? ระบุวันที่อัปเดตของแหล่งข้อมูล หากแหล่งที่ดีที่สุดเก่ากว่า 18 เดือน ให้ติดป้ายคำตอบว่าเป็นข้อมูลในอดีต ไม่ใช่ข้อมูลปัจจุบัน”
“เปรียบเทียบแหล่งข้อมูลใหม่ที่สุดที่คุณหาได้กับแหล่งข้อมูลเก่าที่ถูกอ้างถึงมากที่สุด มีอะไรเปลี่ยนไป และอะไรไม่เปลี่ยน?”
หากผู้ช่วยไม่สามารถแยกหน้า HTML ที่แก้ไขแล้วออกจาก PDF ที่พิมพ์ซ้ำโดยเนื้อหาไม่เปลี่ยนแปลง ให้ให้คะแนนความทันสมัยเป็นไม่ผ่าน แม้ URL จะใช้งานได้ก็ตาม
คุณจะดำเนินการตรวจสอบ TRACE ที่ทำซ้ำได้จากพรอมป์ต์เดียวอย่างไร?
คุณจะทำการตรวจสอบที่ทำซ้ำได้ด้วยการตรึงชุดคำถามทดสอบ ตรึงแผ่นให้คะแนน และบังคับให้ทุกเครื่องมือส่งออกฟิลด์ที่ตรวจสอบด้วยเครื่องได้เหมือนกัน เป้าหมายคือบันทึกการสนทนาที่นักวิจัยคนอื่นสามารถให้คะแนนใหม่ได้โดยไม่ต้องเฝ้าดูขั้นตอนการทำงานของคุณ
ใช้ลำดับนี้กับ Jenova’s Academic Research Assistant แล้วทำซ้ำกับผู้เชี่ยวชาญอย่างน้อยหนึ่งราย เช่น Elicit หรือ Scite และเครื่องมือทั่วไปหนึ่งราย เช่น Perplexity หรือ ChatGPT:
- ระบุบทบาทและข้อตกลงรูปแบบผลลัพธ์ก่อนถามคำถาม
- ถามคำถามทดสอบหนึ่งข้อจากแต่ละประเภท: เชิงปริมาณ ข้อขัดแย้ง เอกสารปฐมภูมิ และสิ่งที่ไม่ทราบ
- กำหนดให้ทุกการอ้างอิงมีชื่อเรื่อง URL วันที่ คำอ้าง และป้ายข้ออ้าง
- คลิกทุกลิงก์และให้คะแนน TRACE ก่อนถามคำถามติดตามใด ๆ
- หลังจากนั้นเท่านั้นจึงร้องขอให้แก้ไขข้ออ้างที่ไม่ผ่าน
ข้อตกลงเริ่มต้น:
“คุณกำลังอยู่ระหว่างการตรวจสอบ สำหรับทุกข้ออ้างสำคัญ ให้แสดง: ข้อความข้ออ้าง; ป้ายกำกับ (
sourced/inferred/unknown); ชื่อแหล่งข้อมูล; URL ที่คลิกได้; วันที่เผยแพร่หรืออัปเดต; คำอ้างสนับสนุนไม่เกิน 25 คำ หากความสอดคล้องไม่สมบูรณ์ ให้ลดป้ายกำกับเป็นinferredหรือunknownห้ามอ้างแหล่งข้อมูลที่คุณไม่ได้ค้นคืน จบด้วยบันทึกความครอบคลุมที่ระบุประเภทแหล่งข้อมูลที่ใช้และประเภทแหล่งข้อมูลที่ขาดหาย”
บน Elicit ขั้นตอนคู่ขนานคือ: รันคำถามเดียวกันเป็นรายงานวิจัย แล้วสุ่มตรวจเซลล์ข้อมูลที่ดึงออกมากับช่วงข้อความใน PDF บน Scite ให้รันข้ออ้างหลักเป็นคำค้นบริบทการอ้างอิง และนับบทความที่สนับสนุนเทียบกับบทความที่ขัดแย้ง ก่อนยอมรับประโยคที่ฟังดูเป็นฉันทามติ สำหรับ ChatGPT Deep Research กระบวนการวิจัยของ OpenAI เอง ยังระบุว่าคุณต้องตรวจสอบแหล่งข้อมูล คุณลักษณะของผลิตภัณฑ์คือการค้นคืนพร้อมโครงสร้าง ไม่ใช่สิ่งทดแทนการตรวจสอบการอนุมานเชิงตรรกะ
เก็บบันทึกง่าย ๆ — ข้ออ้าง, URL, วันที่, คะแนน TRACE, หมายเหตุ การตรวจ 10 ข้ออ้างจากคำถามทดสอบ 4 ข้อเพียงพอจะเห็นรูปแบบ หากข้ออ้างเชิงตัวเลขล้มเหลวด้านความสอดคล้องมากกว่าสองข้อ ให้หยุดใช้เครื่องมือนั้นกับงานส่งมอบใด ๆ ที่ผู้อื่นจะนำไปอ้างอิง
ผู้ปฏิบัติงานด้านความซื่อสัตย์ในการวิจัยกล่าวอย่างไรเกี่ยวกับการทดสอบการอ้างอิง AI?
แนวปฏิบัติด้านความซื่อสัตย์ในการวิจัยมีความเห็นร่วมกันในกฎที่ตรงไปตรงมา: ให้ถือว่าการอ้างอิงจาก AI เป็นข้ออ้างที่ยังไม่ได้รับการตรวจสอบ จนกว่ามนุษย์หรือระบบตรวจสอบการอนุมานเชิงตรรกะอัตโนมัติจะเปิดดูแหล่งข้อมูลแล้ว ประเด็นถกเถียงที่มีประโยชน์ไม่ใช่ว่าโมเดลสร้างข้อมูลหลอนหรือไม่อีกต่อไป แต่คือความล้มเหลวใดบ้างที่คุณสามารถสร้างระบบติดตามได้
“วงการยังคงปรับให้บรรณานุกรมดูสวยขึ้น ซึ่งเป็นหน่วยวัดที่ผิด การอ้างอิงเป็นตัวชี้ ไม่ใช่หลักฐานพิสูจน์ หากช่วงข้อความที่อ้างไม่สนับสนุนประโยคนั้นตามตรรกะ โดยเฉพาะตัวเลข ประชากร และปี การอ้างอิงนั้นก็เป็นเพียงของตกแต่ง เราเคยเห็นความผิดพลาดแบบ ‘78% เทียบกับ 80%’ ผ่านการตรวจเชิงรูปลักษณ์ทุกอย่าง: URL จริง ชื่อเรื่องเกี่ยวข้อง และน้ำเสียงมั่นใจ นั่นคือความผิดพลาดที่หลุดไปถึงต้นฉบับบทความ”
“การติดป้ายข้ออนุมานคือมาตรการควบคุมที่ประหยัดที่สุดซึ่งทีมส่วนใหญ่มองข้าม เมื่อผู้ช่วยได้รับอนุญาตให้ผสมการค้นคืนเข้ากับความรู้ทั่วไปของโลก มันจะฟอกการคาดเดาให้ดูเป็นข้อค้นพบ บังคับใช้สามหมวด — มีแหล่งอ้างอิง, อนุมาน, ไม่ทราบ — แล้วอัตราข้อมูลหลอนของคุณจะมองเห็นได้ ทีมที่ปฏิเสธจะแสดงหมวดสิ่งที่ไม่ทราบ กำลังบอกคุณว่าพวกเขาไม่สามารถแสดงความไม่แน่นอนได้”
“การทดสอบความครอบคลุมเป็นการเลือกด้านธรรมาภิบาลด้วย ผู้ช่วยที่มีแต่บทความวิชาการจะดูเข้มงวด แต่ยังพลาดบันทึกของหน่วยงานที่เปลี่ยนกฎเมื่อเดือนที่แล้ว ผู้ช่วยที่มีแต่เว็บจะดูทันสมัย แต่ยังพลาดการทดลองที่วัดผลลัพธ์จริง การเลือกโมเดลสำคัญในจุดนี้ เพราะบางโมเดลใช้ถ้อยคำระมัดระวัง บางโมเดลบีบอัด และบางโมเดลตัดเงื่อนไขกำกับ การตรวจสอบต้องติดตามข้ออ้าง ไม่ใช่แบรนด์”
— ทีมผลิตภัณฑ์ Jenova, การประเมินเอเจนต์วิจัย, ประสบการณ์ 6 ปีในการสร้างกระบวนการค้นคืนและการอ้างอิงสำหรับผู้ใช้ทางวิชาการและมืออาชีพ
จุดยืนนี้สอดคล้องกับแนวปฏิบัติของห้องสมุด Northwestern บันทึกกรณีที่โมเดลอ้างบทความสารานุกรมที่มีอยู่จริง แต่ยังระบุชื่อและวันที่ผิด UNR แนะนำให้นักวิจัยถามว่าใครตรวจสอบข้ออ้างนั้นได้ ทั้งสองแนวทางคือ TRACE ในรูปแบบร้อยแก้ว
ผู้ช่วยวิจัย AI ดีพอสำหรับใช้ในการวิจัยจริงเมื่อใด?
ผู้ช่วยวิจัย AI ดีพอเมื่อผ่านการตรวจสอบ TRACE กับประเภทคำถามจริงของคุณ โดยข้ออ้างที่ไม่ผ่านได้รับการแก้ไขจากแหล่งข้อมูล หรือลดระดับเป็นข้ออนุมานที่ติดป้ายชัดเจน มันยังไม่ดีพอเมื่อสร้างคำตอบที่ลื่นไหลและเต็มไปด้วยลิงก์ แต่พังลงเมื่อตรวจด้วยการคลิกและการอนุมานเชิงตรรกะ
ใช้กฎตัดสินใจนี้:
- ใช้ผู้เชี่ยวชาญด้านการดึงข้อมูลอย่าง Elicit เมื่องานคือการคัดกรองหรือดึงข้อมูลจากชุดบทความที่ทราบอยู่แล้ว และคุณยังจะสุ่มตรวจเซลล์ข้อมูล
- ใช้ Scite เมื่อคำถามคือวรรณกรรมสนับสนุน กล่าวถึง หรือขัดแย้งกับข้ออ้างเฉพาะหรือไม่
- ใช้ Consensus เมื่อต้องการอ่านทิศทางของหลักฐานอย่างรวดเร็วสำหรับคำถามวิทยาศาสตร์ที่มีขอบเขตชัดเจน
- ใช้ Perplexity หรือ ChatGPT สำหรับการสำรวจในวงกว้าง จากนั้นตรวจสอบทุกตัวเลขอีกครั้งก่อนนำเข้าสู่ต้นฉบับ
- ใช้ Jenova’s Academic Research Assistant เมื่องานต้องดำเนินหลายรอบ — การค้นคว้าวรรณกรรม ภาษาสำหรับต้นฉบับ และการจัดการการอ้างอิงในเส้นทางเดียวที่ตรวจสอบได้ — และคุณพร้อมกำหนดฟิลด์ TRACE ในพรอมป์ต์
อย่าใช้เครื่องมือใดเป็นขั้นตอนสุดท้ายแบบไร้การกำกับ ผลการศึกษาความแม่นยำของการอ้างอิงจาก JMIR และ อัตราข้อมูลหลอนของ Stanford HAI เป็นเหตุผลเพียงพอที่จะให้มนุษย์อยู่ในกระบวนการ การตั้งค่าที่ชนะในปี 2026 ไม่ใช่โมเดลเดี่ยวที่ “เชื่อถือได้” แต่คือเส้นทางแหล่งข้อมูลที่คุณเล่นซ้ำได้: ลิงก์ที่คลิกได้ เอกสารที่มีวันที่ ข้ออ้างที่มีหลักฐานรองรับตามตรรกะ และเส้นแบ่งที่มองเห็นได้ระหว่างหลักฐานกับข้ออนุมาน
แหล่งอ้างอิง
- Northwestern University Libraries — การประเมินเนื้อหาที่ AI สร้าง
- University of Nevada, Reno Libraries — AI และการประเมินแหล่งข้อมูล
- JMIR — การประเมินประสิทธิภาพของโมเดลภาษาขนาดใหญ่และความน่าเชื่อถือของการอ้างอิงที่สร้างขึ้น
- Stanford HAI — AI ในชั้นศาล: โมเดลกฎหมายสร้างข้อมูลหลอนในคำถามทดสอบ 1 จาก 6 ข้อ หรือมากกว่า
- AuthorityTech — ความใหม่ของเนื้อหา SEO ในปี 2026
- การสนทนา Chris Long / Ahrefs — ความใหม่และการมองเห็นในการค้นหา AI
- ACL Findings — การประเมิน Open-QA ที่แม่นยำและละเอียดอ่อนผ่านการอนุมานเชิงตรรกะจากข้อความ
- NVIDIA Developer — การตรวจสอบการอ้างอิงอัตโนมัติด้วย NVIDIA NIM
- Elicit — AI สำหรับการวิจัยวิทยาศาสตร์ ความครอบคลุมและความแม่นยำในการดึงข้อมูล
- Scite — Smart Citations สำหรับวรรณกรรมวิทยาศาสตร์
- The Drive AI — Elicit เทียบกับ Consensus เทียบกับ Semantic Scholar
- iatroX — เครื่องมือ AI ที่ดีที่สุดสำหรับการวิจัยทางการแพทย์ปี 2026
- ห้องสมุด HKUST — การเปรียบเทียบเครื่องมือ AI ใหม่สำหรับการทบทวนวรรณกรรม
- Omid Saffari — เครื่องมือวิจัย AI ที่ดีที่สุดในปี 2026: Elicit เทียบกับ Consensus
- Pure AI — ต้องมีการอ้างอิง: ทดสอบเครื่องมือวิจัย AI 7 ตัว
- SEOptimer — ความใหม่ของเนื้อหาใน SEO และการค้นหา AI
- OtterlyAI — วิธีติดตามการอ้างอิงและแหล่งข้อมูลของเสิร์ชเอนจิน AI
- Firecrawl — การค้นหาเว็บและการวิจัยเชิงลึกสำหรับเอเจนต์ AI
- OpenAI Academy — การวิจัยด้วย ChatGPT: Search และ Deep Research