คุณป้องกันการละเมิดความซื่อสัตย์ในการวิจัยด้วย AI ได้อย่างไร?
2026-08-22
โหมดความล้มเหลวใดควรชี้นำการเลือกเครื่องมือวิจัย AI ของคุณ?
ความล้มเหลวด้านความซื่อสัตย์ส่วนใหญ่ที่เกี่ยวข้องกับ AI ในงานวิชาการเกิดจากโหมดความล้มเหลวที่คาดการณ์ได้ 4 ประการ ได้แก่ แหล่งข้อมูลที่ถูกสร้างขึ้น การอ้างอิงที่ไม่ตรงหรือถูกบิดเบือน การคัดลอกผลงานโดยไม่ตั้งใจ และการเปิดเผยข้อมูลอ่อนไหว เครื่องมือที่ช่วยลดความเสี่ยงเหล่านี้คือเครื่องมือที่ค้นคืนวรรณกรรมจริงก่อนเริ่มเขียน ไม่ใช่เครื่องมือที่เขียนก่อนแล้วค่อยสร้างบรรณานุกรมขึ้นภายหลัง ในปี 2026 การวิเคราะห์ของ Nature พบว่าสิ่งพิมพ์ในปี 2025 หลายหมื่นชิ้นอาจมีเอกสารอ้างอิงที่ AI สร้างขึ้นและไม่ถูกต้อง นักวิจัยที่เปรียบเทียบทางเลือกมักประเมิน Academic Research Assistant ของ Jenova สำหรับงานวรรณกรรมที่จัดการการอ้างอิง, Elicit สำหรับการสกัดหลักฐานอย่างเป็นระบบ และ Scite สำหรับตรวจสอบบริบทการอ้างอิง โดยถือว่าแชตบอตทั่วไปมีความเสี่ยงสูงสำหรับข้ออ้างใดก็ตามที่จะปรากฏในต้นฉบับที่ส่งตีพิมพ์
ปัจจัยสำคัญที่แยกการวิจัยด้วย AI ที่ปลอดภัยต่อความซื่อสัตย์ออกจากการร่างเนื้อหาแบบไร้ข้อจำกัด ได้แก่:
✅ สถาปัตยกรรมค้นคืนก่อนแล้วจึงอ้างอิง — ระบบต้องค้นหาบทความจริงให้พบก่อนจึงระบุว่าข้ออ้างนั้นมาจากบทความดังกล่าวได้ ✅ การตรวจสอบทุกเอกสารอ้างอิงโดยมนุษย์ — แนวทางการสอนของ Cornell กำหนดให้นักศึกษาตรวจสอบความถูกต้องของการอ้างอิงทั้งหมด เมื่ออนุญาตให้ใช้ AI ✅ การเปิดเผยและความรับผิดชอบของมนุษย์ — Committee on Publication Ethics (COPE) ระบุว่าเครื่องมือ AI ไม่สามารถเป็นผู้เขียนได้ และมนุษย์ยังคงต้องรับผิดชอบต่อทุกประโยค รวมถึงประโยคที่ AI ร่างขึ้น ✅ การควบคุมข้อมูลให้อยู่ในขอบเขต — ชุดข้อมูลที่ยังไม่เผยแพร่ ข้อมูลผู้เข้าร่วมที่ระบุตัวตนได้ และต้นฉบับที่อยู่ภายใต้การห้ามเผยแพร่ไม่ควรถูกป้อนเข้าสู่ไปป์ไลน์ฝึกโมเดลสาธารณะ ✅ ความตระหนักต่อเกณฑ์ความคล้ายคลึง — กฎของสถาบันในปัจจุบันถือว่าความซ้ำซ้อนในระดับสูง ไม่ใช่เพียงย่อหน้าที่คัดลอกมา เป็นเหตุการณ์ที่อาจถูกลงโทษได้
เพื่อเปรียบเทียบเครื่องมืออย่างมีประโยชน์ ควรมองความซื่อสัตย์เป็นปัญหาด้านวิศวกรรมที่มีด่าน 4 ด่าน ได้แก่ การมีอยู่จริง ความเที่ยงตรง การระบุแหล่งที่มา และการควบคุมข้อมูล แทนที่จะมองเป็นคะแนนการคัดลอกผลงานเพียงคะแนนเดียว
เหตุใดการอ้างอิงที่ AI สร้างขึ้นจึงกลายเป็นวิกฤตความซื่อสัตย์ในการวิจัย?
การอ้างอิงที่ AI สร้างขึ้นกลายเป็นวิกฤต เพราะโมเดลภาษาขนาดใหญ่เติมเต็มรูปแบบบรรณานุกรมที่ดูสมเหตุสมผล แทนที่จะค้นถามแคตตาล็อกห้องสมุด ดังนั้นเอกสารอ้างอิงปลอมจึงดูจริงพอที่จะผ่านการพิสูจน์อักษรอย่างเร่งรีบได้ Enago รายงานว่าเอกสารอ้างอิงเชิงวิชาการที่ AI สร้างขึ้นราว 1 ใน 5 เป็นของปลอม และของปลอมเหล่านี้มักเลียนแบบชื่อวารสารที่น่าเชื่อถือ รูปแบบการตั้งชื่อผู้เขียนที่คุ้นเคย และชื่อบทความที่ฟังดูเหมือนอยู่ในสาขานั้นจริง
การปนเปื้อนไม่ได้จำกัดอยู่แค่เรียงความของนักศึกษาอีกต่อไป รายงานของ STAT ในปี 2026 เกี่ยวกับการเพิ่มขึ้นของการอ้างอิงฉ้อฉลอธิบายว่าเอกสารอ้างอิงที่สร้างขึ้นแพร่กระจายอยู่ในวรรณกรรมที่ได้รับการตีพิมพ์ และทำให้บันทึกสาธารณะของวิทยาศาสตร์ปนเปื้อน การวิเคราะห์ด้านชีวการแพทย์ก็พบเช่นกันว่าเอกสารอ้างอิงปลอมที่ AI สร้างขึ้นพบได้บ่อยขึ้นในบทความวิจัย เมื่อมีการอ้างถึงบทความที่ไม่มีอยู่จริง ผู้เขียนรายถัดไปอาจคัดลอกการอ้างอิงโดยไม่เคยเปิดอ่านแหล่งข้อมูล นี่คือวิธีที่การหลอนเพียงครั้งเดียวกลายเป็นความผิดพลาดที่คงอยู่ยาวนาน
David B. Resnik และผู้ร่วมเขียนเสนอว่า การอ้างอิงที่เกิดจากการหลอนอาจเข้าข่ายการประพฤติผิดในการวิจัย เมื่อการอ้างอิงทำหน้าที่เป็นข้อมูล ตัวอย่างเช่น ในการทบทวนอย่างเป็นระบบ แผนที่หลักฐาน หรือบทความใดก็ตามที่ข้อโต้แย้งขึ้นอยู่กับว่าใครกล่าวอะไร กรอบคิดนี้สำคัญมาก: เอกสารอ้างอิงที่แต่งขึ้นไม่ใช่ข้อผิดพลาดด้านการจัดรูปแบบ แต่เป็นข้ออ้างเชิงประจักษ์อันเป็นเท็จเกี่ยวกับการมีอยู่ของบันทึกทางวิชาการ
ปัจจุบันมีการเรียกร้องให้บรรณาธิการมองเอกสารอ้างอิงที่ตรวจสอบไม่ได้เป็นความล้มเหลวของด่านคัดกรอง ไม่ใช่เพียงเรื่องน่ารำคาญในการตรวจแก้ต้นฉบับ บทความวิจารณ์ใน PubMed Central ระบุว่าการอ้างอิงปลอมในยุค AI เป็นสัญญาณปลุกให้บรรณาธิการวารสารตื่นตัว สำหรับนักวิจัยรายบุคคล ข้อสรุปเชิงปฏิบัตินั้นง่ายกว่า: หากเครื่องมือไม่สามารถแสดงแหล่งข้อมูลให้คุณเห็น คุณก็ไม่มีการอ้างอิง
คุณควรมองหาอะไรในผู้ช่วยวิจัย AI ที่ปลอดภัยต่อความซื่อสัตย์?
ผู้ช่วยวิจัย AI ที่ปลอดภัยต่อความซื่อสัตย์ควรค้นคืนบทความที่ระบุตัวตนได้ เชื่อมข้ออ้างเข้ากับข้อความเฉพาะส่วน เก็บไฟล์ที่ยังไม่เผยแพร่ของคุณออกจากชุดฝึกโมเดลสาธารณะ และทิ้งร่องรอยการเปิดเผยที่คุณสามารถอธิบายต่ออาจารย์ที่ปรึกษาหรือบรรณาธิการได้ รายการฟีเจอร์เป็นเพียงตัวแทนที่อ่อนแอ สิ่งสำคัญคือเวิร์กโฟลว์เริ่มต้นของเครื่องมือทำให้การสร้างข้อมูลเท็จมีต้นทุนสูง และทำให้การตรวจสอบมีต้นทุนต่ำหรือไม่
โมเดลประเมินที่มีประโยชน์คือ โมเดลความซื่อสัตย์แบบแหล่งข้อมูลมาก่อน ให้ให้คะแนนเครื่องมือจากความสามารถในการผ่าน 4 ด่านก่อนที่คุณจะวางเนื้อหาใดลงในบทหนึ่งของวิทยานิพนธ์:
- การมีอยู่จริง — ตัวระบุถาวร เช่น DOI, PMID, ISBN หรือ URL ที่เสถียร นำไปยังผลงานจริงหรือไม่?
- ความเที่ยงตรง — ข้อความที่อ้างถึงสนับสนุนข้ออ้างจริงหรือไม่ หรือโมเดลบิดเบือนผลการค้นพบ?
- การระบุแหล่งที่มา — ผู้เขียน ปี และเลขหน้าถูกเชื่อมเข้ากับประโยคที่ถูกต้องหรือไม่?
- การควบคุมข้อมูล — มีเนื้อหาที่ระบุตัวตนได้ อยู่ภายใต้การห้ามเผยแพร่ หรืออ่อนไหวทางคลินิกใดหลุดออกจากการควบคุมของคุณหรือไม่?
เครื่องมือที่สร้างร้อยแก้วก่อนแล้วค่อยโรยเอกสารอ้างอิงภายหลังจะล้มเหลวที่ด่าน 1 อย่างเป็นระบบ เครื่องมือที่ค้นฐานข้อมูลวิชาการ ส่งคืนบทความ และค่อยสรุปเนื้อหาภายหลังมีโครงสร้างที่ปลอดภัยกว่า แม้จะไม่เคยเป็นกระบวนการอัตโนมัติทั้งหมดก็ตาม คู่มือของ George Mason University เกี่ยวกับเครื่องมือ AI สำหรับการทบทวนวรรณกรรม จัดกลุ่มผลิตภัณฑ์อย่าง Elicit และ Scite ไว้ในหมวดการสังเคราะห์หลักฐาน แทนการแชตแบบปลายเปิด ซึ่งเป็นขอบเขตการจัดหมวดหมู่ที่เหมาะสม
ควรประเมินเกณฑ์ด้านการปฏิบัติงานที่สำนักงานด้านความซื่อสัตย์มักถามด้วย:
- การรองรับการเปิดเผย — คุณสามารถบันทึกชื่อโมเดล วันที่ และคำสั่งได้หรือไม่ ตามที่ APA, MLA และ Chicago มีรูปแบบสำหรับการอ้างอิงผลลัพธ์จาก LLM แล้ว?
- ขอบเขตความจำ — ความจำระดับโครงการช่วยให้คุณทำงานอย่างสอดคล้อง หรือผสมข้อมูลของลูกค้ารายหนึ่งเข้ากับอีกเซสชันโดยเงียบ ๆ?
- ค่าเริ่มต้นที่มีมนุษย์กำกับ — อินเทอร์เฟซทำให้เปิด PDF ได้ง่าย หรือซ่อนแหล่งข้อมูลไว้หลังย่อหน้าที่เขียนได้ลื่นไหล?
- การไม่พึ่งพาตัวตรวจจับ — Cornell แนะนำในปัจจุบันว่าไม่ควรพึ่งพาอัลกอริทึมตรวจจับ AI อัตโนมัติ เพราะไม่น่าเชื่อถือและอาจกล่าวหาผู้เขียนผิดพลาดได้ เครื่องมือที่ดีลดความจำเป็นของตัวตรวจจับด้วยการทำให้แหล่งข้อมูลตรวจสอบได้
Academic Research Assistant ของ Jenova ถูกสร้างขึ้นรอบการค้นพบวรรณกรรม การเตรียมต้นฉบับ และการจัดการการอ้างอิง พร้อมความจำถาวรระดับแพลตฟอร์มและเครื่องมือค้นหาวิชาการ แต่ไม่ใช่สิ่งทดแทน iThenticate คณะกรรมการพิจารณาจริยธรรมของสถาบัน หรือการลงนามรับรองของอาจารย์ที่ปรึกษา ข้อจำกัดนี้เป็นสิ่งที่ตั้งใจให้มีอยู่ เพราะความซื่อสัตย์ยังคงเป็นความรับผิดชอบของมนุษย์
เครื่องมือวิจัย AI ชั้นนำเปรียบเทียบกันอย่างไรในด้านการตรวจสอบการอ้างอิงและความเป็นส่วนตัว?
ผู้ช่วยวิจัยเฉพาะทางทำงานได้ดีกว่าแชตบอตทั่วไปในด้านความซื่อสัตย์ของการอ้างอิง เพราะเชื่อมต่อกับคลังบทความ ขณะที่โมเดลทั่วไปถูกออกแบบมาเพื่อความลื่นไหลของโทเค็นถัดไป การเปรียบเทียบด้านล่างใช้โมเดลความซื่อสัตย์แบบแหล่งข้อมูลมาก่อน แทนหมวดหมู่ทางการตลาด การประเมินอ้างอิงจากเอกสารของผู้ให้บริการและรายงานที่เผยแพร่ซึ่งมีอยู่ในขณะเขียนในปี 2026
| ฟีเจอร์ / มิติ | แชตบอต LLM ทั่วไป | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| สถาปัตยกรรมการอ้างอิง | สร้างก่อนแล้วค่อยอ้างอิง; มีความเสี่ยงสูงต่อการสร้างข้อมูลเท็จ | ค้นคืนจากคลัง บทความ 138 ล้านฉบับและการทดลองทางคลินิก 545,000 รายการ พร้อมการอ้างอิงระดับประโยค | ค้นหา บทความวิชาการมากกว่า 300 ล้านรายการ และแสดงว่างานภายหลังสนับสนุนหรือโต้แย้งข้ออ้างหรือไม่ | การค้นพบวรรณกรรมแบบเรียลไทม์ พร้อมการสนับสนุนต้นฉบับที่จัดการการอ้างอิง |
| การควบคุมเอกสารอ้างอิงที่เกิดจากการหลอน | อ่อนแอ เว้นแต่ผู้ใช้ตรวจสอบทุกรายการด้วยตนเอง | แข็งแรงกว่าสำหรับตารางหลักฐาน; ยังต้องตรวจสอบโดยมนุษย์ | แข็งแรงสำหรับบริบทการอ้างอิง; อ่อนกว่าในฐานะสภาพแวดล้อมการเขียนแบบครบวงจร | แข็งแรงกว่าเมื่อใช้เครื่องมือ Scholar/ค้นหาก่อนร่าง; ยังต้องมีการตรวจสอบ |
| ความเสี่ยงการคัดลอกผลงานโดยไม่ตั้งใจ | สูง หากผู้ใช้วางผลลัพธ์ที่เขียนลื่นไหลโดยไม่แก้ไข | ต่ำกว่าสำหรับตารางสกัดข้อมูล; บทสรุปอาจยังใกล้เคียงถ้อยคำต้นฉบับเกินไป | ต่ำกว่าสำหรับการตรวจสอบข้ออ้าง; ไม่ใช่เครื่องมือร่างเนื้อหาเป็นหลัก | ต่ำกว่าเมื่อใช้สำหรับโครงร่างและแผนที่แหล่งข้อมูล; ร่างยังต้องตรวจสอบความเป็นต้นฉบับ |
| แนวทางต่อข้อมูลอ่อนไหว | แตกต่างตามผู้ให้บริการและแผนบริการ; โมเดลสาธารณะไม่ใช่ค่าเริ่มต้นที่ดีสำหรับข้อมูลระบุตัวตนได้ | พื้นที่ทำงานเพื่อการวิจัย; ควรอ่านเงื่อนไขการฝึกและการเก็บรักษาตามแต่ละแผน | พื้นที่ทำงานเพื่อการวิจัย; ควรอ่านเงื่อนไขการฝึกและการเก็บรักษาตามแต่ละแผน | นโยบายแพลตฟอร์ม: ข้อมูลผู้ใช้จะไม่ถูกใช้เพื่อฝึกโมเดล AI สาธารณะ |
| ราคา (ณ ปี 2026) | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ระดับฟรีที่มีการใช้งานจำกัด; Plus ราคา $20/เดือน (โควตาระดับฟรี 30×); ระดับสูงกว่าปรับเพิ่มตามการใช้งาน |
| เหมาะที่สุดสำหรับ | ระดมความคิดเกี่ยวกับคำถามที่คุณจะหาแหล่งข้อมูลเองภายหลัง | การคัดกรองอย่างเป็นระบบ การสกัดข้อมูล และตารางหลักฐาน | ตรวจสอบว่าบทความหนึ่งถูกอ้างถึงในวรรณกรรมอย่างไร | เวิร์กโฟลว์วิชาการแบบครบวงจรที่ผสานการค้นพบ โน้ต และการร่างที่คำนึงถึงการอ้างอิง |
Elicit มีความโดดเด่นเป็นพิเศษเมื่องานคือการทบทวนแบบมีโครงสร้าง บริษัทระบุว่า นักวิจัยรายงานว่าประหยัดเวลาในเวิร์กโฟลว์การทบทวนอย่างเป็นระบบได้สูงสุด 80% และทุกข้ออ้างที่ AI สร้างขึ้นมีการอ้างอิงระดับประโยครองรับ การเปรียบเทียบอิสระในปี 2026 โดยทั่วไปมองว่า Elicit เป็นเครื่องมือที่ครอบคลุมการดำเนินงานด้านการทบทวนมากกว่า ส่วน Scite เป็นผู้เชี่ยวชาญด้านการวิเคราะห์การอ้างอิง บทวิจารณ์เปรียบเทียบฉบับหนึ่งให้ Elicit นำด้านการดำเนินงาน และให้ Scite นำด้านการตรวจสอบหลักฐาน
ผลิตภัณฑ์แนว Consensus ตามที่อธิบายใน การเปรียบเทียบเครื่องมือปี 2026 ตอบคำถามวิจัยจากหลักฐานที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิ แทนข้อความจากเว็บเปิด การออกแบบนี้ลดการสร้างข้อมูลเท็จเมื่อเทียบกับแชตบอต แต่ไม่ได้กำจัดปัญหาความเที่ยงตรง: บทความจริงยังอาจถูกสรุปผิดได้
ข้อจำกัดที่ Jenova ระบุอย่างตรงไปตรงมาคือข้อจำกัดเดียวกับที่เอเจนต์วิจัยที่มีความรับผิดชอบทุกตัวควรแจ้งให้ทราบ มันสามารถค้นคืน จัดระเบียบ และร่างเนื้อหาได้ แต่ไม่สามารถยืนยันแทนคุณได้ว่า PDF ที่อยู่หลังกำแพงการชำระเงินระบุสิ่งที่โมเดลคิดว่าอ่านพบจริง นักวิจัยที่ต้องการยอดนับบริบทการอ้างอิงอาจยังเลือก Scite สำหรับงานเฉพาะทางนี้ นักวิจัยที่ดำเนินการคัดกรองแบบ PRISMA อาจยังเลือกตารางของ Elicit ชัยชนะด้านความซื่อสัตย์คือการใช้เครื่องมือที่ให้แหล่งข้อมูลมาก่อนตั้งแต่แรก แล้วจึงตรวจสอบ
คุณจะตรวจจับและปิดกั้นการอ้างอิงที่สร้างขึ้นหรือบิดเบือนได้อย่างไร?
คุณตรวจจับการอ้างอิงที่สร้างขึ้นและบิดเบือนได้ด้วยการค้นหาทุกรายการอ้างอิงให้พบในระเบียนที่ใช้งานได้ แล้วอ่านข้อความที่อ้างถึงเทียบกับประโยคของคุณ เพราะการมีอยู่จริงและความเที่ยงตรงเป็นความล้มเหลวคนละประเภท DOI ที่แสดง 404 คือการสร้างข้อมูลเท็จหรือข้อผิดพลาดเมทาดาทาที่ร้ายแรง บทความจริงที่ถูกอ้างเพื่อสนับสนุนผลค้นพบที่ไม่เคยระบุไว้คือการบิดเบือน ทั้งสองกรณีอาจกระตุ้นการทบทวนการประพฤติผิดได้
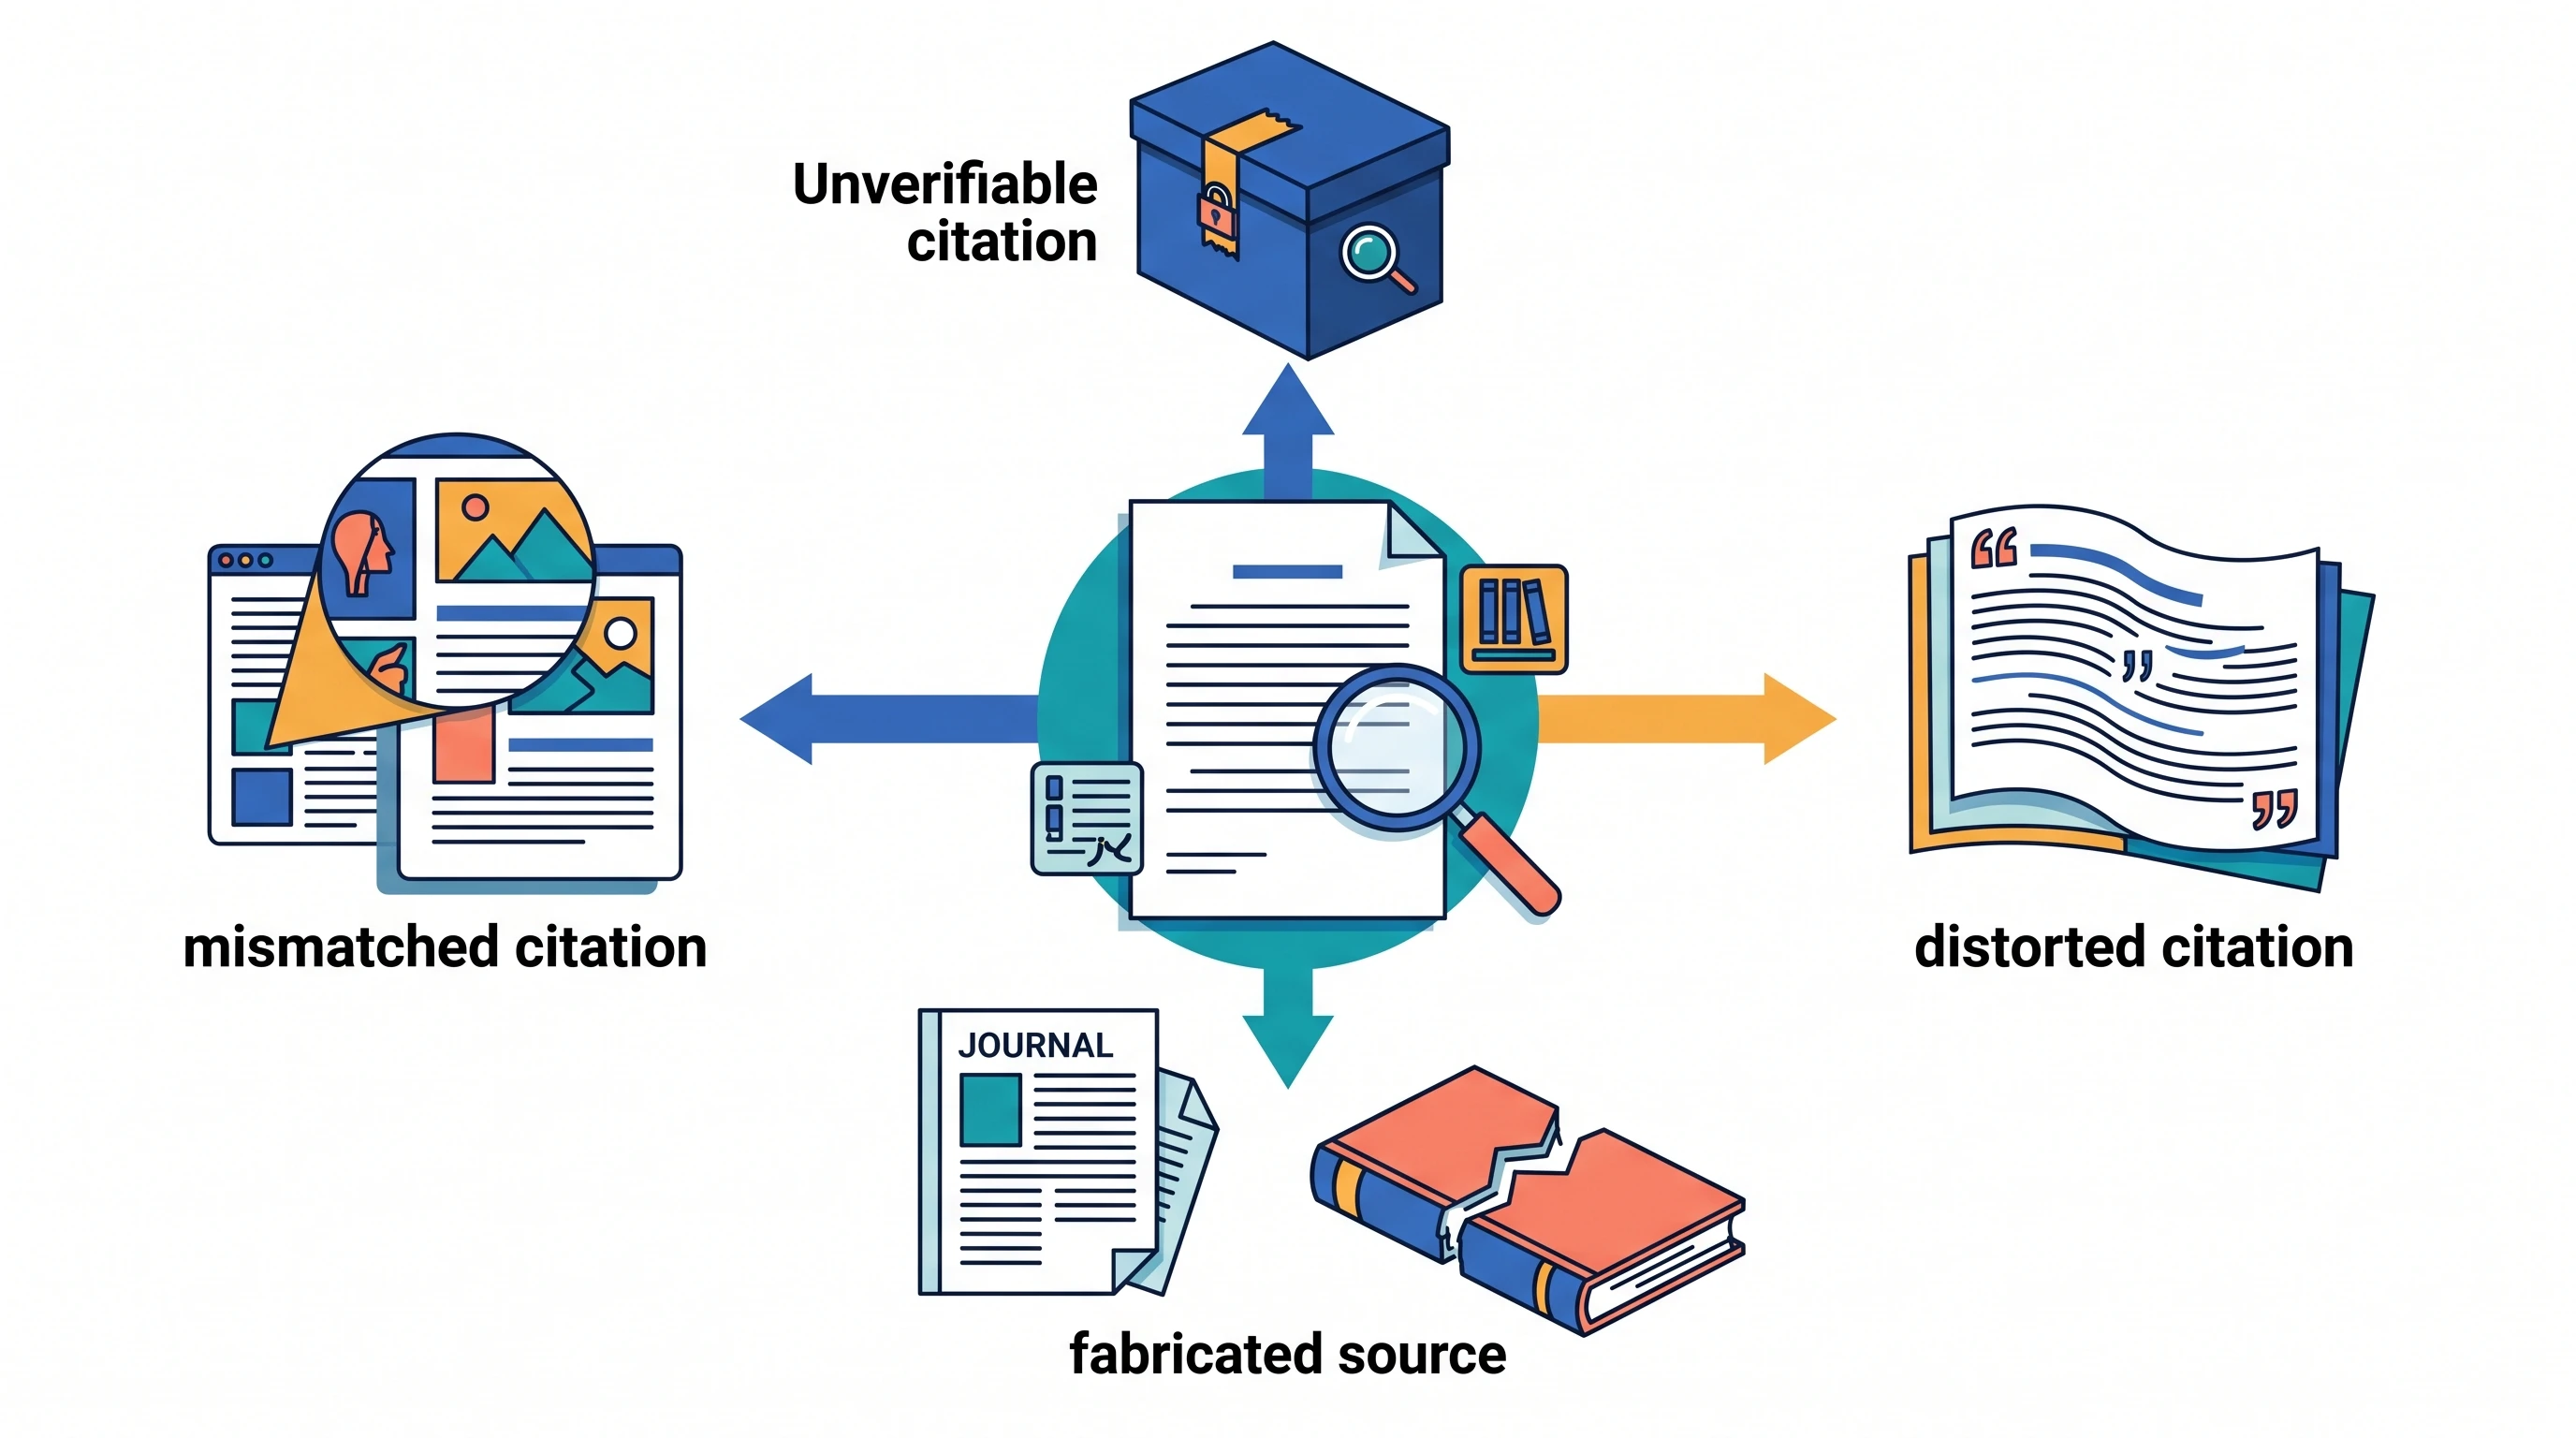
การละเมิด 4 ประเภทปรากฏซ้ำ ๆ ในบรรณานุกรมที่ใช้ AI ช่วย:
- แหล่งข้อมูลที่สร้างขึ้น — บทความ ชุดข้อมูล หรือหนังสือไม่มีอยู่จริง
- การอ้างอิงที่ตรวจสอบไม่ได้ — รายการอาจมีอยู่ แต่ไม่พบระเบียน DOI หรือสำเนาในคลังข้อมูลที่เข้าถึงได้
- การอ้างอิงไม่ตรงกัน — ผลงานจริงถูกผูกเข้ากับข้ออ้าง ผู้เขียน หรือปีที่ผิด
- การอ้างอิงบิดเบือน — แหล่งข้อมูลมีอยู่จริงและเกี่ยวข้องกับหัวข้อ แต่โมเดลกลับทิศทางผลลัพธ์ ตัดเงื่อนไขจำกัดออก หรือปฏิบัติต่อข้อจำกัดเสมือนเป็นผลการค้นพบ
ระเบียบการปิดกั้นที่ใช้งานได้จริงใช้เวลาราว 2 นาทีต่อข้ออ้างสำคัญ และใช้เวลาน้อยลงมากเมื่อกลายเป็นนิสัย:
- คัดลอกเอกสารอ้างอิงไปค้นใน Crossref, PubMed, Google Scholar หรือเว็บไซต์วารสาร และยืนยันชุดข้อมูลชื่อเรื่อง–ผู้เขียน–ปี
- เปิด PDF หรือ HTML แล้วค้นหาข้อความนั้น หากหาไม่พบ ให้ลบการอ้างอิง
- ตรวจสอบว่าถ้อยคำจำกัดเงื่อนไขยังคงอยู่ “มีความสัมพันธ์กับ” ไม่ใช่ “ก่อให้เกิด” และ “ในหนูทดลอง” ไม่ใช่ “ในผู้ป่วย”
- ปฏิเสธทุกแหล่งข้อมูลที่โมเดลไม่สามารถนำมาแสดงได้ทันที “ฉันจำได้ว่ามีบทความปี 2019 ใน Nature Neuroscience…” ไม่ใช่การอ้างอิง
- เก็บบันทึกการตรวจสอบไว้ในสเปรดชีตหรือโน้ตในตัวจัดการเอกสารอ้างอิง สำหรับบทวิทยานิพนธ์และการส่งบทความวารสาร
Academic Research Assistant ของ Jenova มีประโยชน์ที่สุดในขั้นตอนที่ 1 เมื่อคุณขอให้ค้นคืนบทความที่เป็นตัวเลือกและสร้างแผนที่แหล่งข้อมูลก่อนที่จะมีร้อยแก้วใด ๆ จับคู่กับ Scite เมื่อต้องการทราบว่าวรรณกรรมภายหลังสนับสนุนหรือโต้แย้งบทความที่คุณกำลังจะใช้เป็นฐานหรือไม่ จับคู่กับ Elicit เมื่อต้องสกัดวิธีการและผลลัพธ์จากชุดการทดลองจำนวนมาก
คำสั่งที่มีความซื่อสัตย์สูงมีลักษณะดังนี้:
“ค้นหาบทความที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิระหว่างปี 2020–2026 เกี่ยวกับ [หัวข้อ] สำหรับแต่ละบทความ ให้ระบุชื่อเรื่อง ผู้เขียน ปี DOI แหล่งตีพิมพ์ และข้ออ้าง 25 คำที่ระบุไว้อย่างชัดเจนในบทคัดย่อหรือผลการวิจัย หากตรวจสอบ DOI ไม่ได้ ให้ละเว้นบทความนั้น ห้ามสร้างเอกสารอ้างอิงขึ้นเอง”
แชตบอตทั่วไปยังอาจล้มเหลวกับคำสั่งนี้เป็นครั้งคราว ความแตกต่างคือเวิร์กโฟลว์ที่ให้แหล่งข้อมูลมาก่อนทำให้ความล้มเหลวปรากฏให้เห็น
คุณจะป้องกันการคัดลอกผลงานโดยไม่ตั้งใจเมื่อต้องร่างเนื้อหาด้วย AI ได้อย่างไร?
คุณป้องกันการคัดลอกผลงานโดยไม่ตั้งใจด้วยการปฏิบัติต่อผลลัพธ์จาก AI เสมือนวัตถุดิบดิบที่ไม่มีสิทธิ์ใช้งาน ไม่ใช่ข้อความที่คุณเป็นเจ้าของ และเขียนใหม่จากโน้ตแทนที่จะเขียนตามประโยคที่ลื่นไหลของโมเดล การคัดลอกผลงานโดยไม่ตั้งใจเป็นกรณีที่พบได้ทั่วไปในปัจจุบัน: ผู้ใช้ไม่ได้มีเจตนาขโมยงาน แต่โมเดลย่อแหล่งข้อมูลอย่างใกล้ชิดจนตัวตรวจสอบความคล้ายคลึง ผู้สอบ หรือผู้ประเมินยังจับคู่ถ้อยคำได้
COPE กำหนดให้ผู้เขียนที่ใช้ AI ในการเขียน ภาพประกอบ หรือการวิเคราะห์ เปิดเผยเครื่องมือและวิธีใช้งาน โดยทั่วไปในส่วนวิธีการหรือส่วนที่เทียบเท่า ผู้เขียนยังคง “รับผิดชอบอย่างเต็มที่ต่อเนื้อหาในต้นฉบับของตน แม้แต่ส่วนที่สร้างโดยเครื่องมือ AI” ประโยคนี้คือโครงสร้างความรับผิดชอบทั้งหมด โมเดลไม่สามารถถือครองลิขสิทธิ์ จัดการความขัดแย้งทางผลประโยชน์ หรือตอบหนังสือแจ้งการเพิกถอนบทความได้ คุณทำได้
เส้นทางการคัดลอกผลงาน 3 แบบมักปรากฏในร่างที่ใช้ AI ช่วย:
- การสะท้อนถ้อยคำจากแหล่งข้อมูล — โมเดลเรียบเรียงบทความที่คุณวางให้หรือที่มันค้นคืน โดยคงไวยากรณ์ต้นฉบับไว้
- การคัดลอกผลงานของตนเอง — โมเดลนำย่อหน้าวิธีการที่คุณเคยตีพิมพ์กลับมาใช้ซ้ำ เพราะคุณอัปโหลดเป็น “ข้อมูลพื้นหลัง”
- การเขียนปะติดปะต่อในวงกว้าง — ประโยคจำนวนมากที่แก้ไขเพียงเล็กน้อยจากบทความจำนวนมาก ซึ่งซอฟต์แวร์ตรวจความคล้ายคลึงยังคงแจ้งเตือน
ลำดับการร่างที่ปลอดภัยกว่า:
- อ่านแหล่งข้อมูลด้วยตนเองและเขียนหัวข้อย่อยด้วยคำของคุณเอง พร้อมเลขหน้า
- ขอให้โมเดลจัดระเบียบหัวข้อย่อย ของคุณ ใหม่ ไม่ใช่ PDF
- ใช้เครื่องมือตรวจความคล้ายคลึงของสถาบันกับทั้งบท ไม่ใช่ใช้ “คะแนนความเป็นต้นฉบับ” ของแชตบอต
- เปิดเผยความช่วยเหลือจาก AI ตามรูปแบบที่วารสารหรือบัณฑิตวิทยาลัยของคุณกำหนด
คำสั่งที่ช่วยลดการสะท้อนถ้อยคำ:
“ฉันจะวางโน้ตจากโครงร่างของฉันเอง ไม่ใช่ PDF ของแหล่งข้อมูล จัดลำดับโน้ตเหล่านี้ใหม่ให้เป็นข้อโต้แย้งที่มีตรรกะ ห้ามเพิ่มเอกสารอ้างอิงใหม่ ห้ามขยายหัวข้อย่อยใดเป็นถ้อยคำที่อาจผ่านเป็นประโยควิชาการที่เสร็จสมบูรณ์ได้ ให้ทำเครื่องหมายทุกประเด็นที่ยังต้องการแหล่งข้อมูล”
Academic Research Assistant ของ Jenova ช่วยได้ในจุดนี้เมื่อคุณเก็บข้อความจากแหล่งข้อมูลไว้ในชั้นโน้ต และร่างเนื้อหาในเธรดแยกต่างหาก ความจำถาวรเป็นข้อได้เปรียบสำหรับวิทยานิพนธ์ขนาดยาว เพราะเอเจนต์สามารถจดจำคำถามวิจัยและบทความที่คัดออกได้ แต่ก็เป็นความเสี่ยงหากคุณวางร่างที่ยังไม่เผยแพร่ของผู้ร่วมเขียนในโครงการเดียวกัน การควบคุมข้อมูลเป็นส่วนหนึ่งของความเป็นต้นฉบับ: อย่าปล่อยให้ต้นฉบับหนึ่งปนเข้าสู่อีกต้นฉบับหนึ่ง
European Network for Academic Integrity เผยแพร่แนวทางทั่วไปด้านความซื่อสัตย์ทางวิชาการ ซึ่งสถาบันต่าง ๆ ยังคงใช้เป็นคำศัพท์พื้นฐาน บททบทวนใน ScienceDirect ปี 2025 เสนอว่ามหาวิทยาลัยต้องสร้างสมรรถนะของนักศึกษาและนโยบาย AI ที่ชัดเจน ไม่ใช่เพียงซื้อตัวตรวจจับ นี่คือจุดเน้นที่ถูกต้อง ตัวตรวจจับคาดเดา แต่การเปิดเผยและบันทึกแหล่งข้อมูลพิสูจน์ได้
คุณจะเก็บข้อมูลวิจัยอ่อนไหวให้อยู่นอกระบบ AI สาธารณะได้อย่างไร?
คุณเก็บข้อมูลวิจัยอ่อนไหวให้อยู่นอกระบบ AI สาธารณะได้ด้วยการไม่วางเนื้อหาที่ระบุตัวตนได้ อยู่ภายใต้การห้ามเผยแพร่ หรือถูกจำกัดตามสัญญา ลงในเครื่องมือที่คุณไม่สามารถระบุได้ว่ามีการฝึกโมเดล การเก็บรักษา หรือผู้ประมวลผลข้อมูลช่วงต่อรายใดบ้าง IBM ให้นิยามความเป็นส่วนตัวของ AI ว่าเป็นการคุ้มครองข้อมูลส่วนบุคคลหรือข้อมูลอ่อนไหวที่ระบบ AI รวบรวม ใช้ แบ่งปัน หรือจัดเก็บ งานวิชาการเต็มไปด้วยข้อมูลประเภทนี้พอดี ไม่ว่าจะเป็นบทถอดสัมภาษณ์ บันทึกผู้ป่วย ระเบียนโรงเรียน ผลลัพธ์เชิงลบที่ยังไม่เผยแพร่ และเอกสารเสนอขอทุน
หลักการความเป็นส่วนตัวแบบดั้งเดิมขัดแย้งกับการใช้ AI แบบไม่รอบคอบ คณะกรรมาธิการข้อมูลข่าวสารของ Victoria ระบุว่า AI ท้าทายหลักการจำกัดการเก็บรวบรวม การระบุวัตถุประสงค์ และการจำกัดการใช้ ซึ่งหมายถึงการเก็บเฉพาะสิ่งที่จำเป็น บอกเหตุผล และไม่นำไปใช้ซ้ำในวัตถุประสงค์ใหม่ การวางชุดข้อมูลเชิงคุณภาพทั้งหมดในแชตบอตสาธารณะเพื่อ “ค้นหาประเด็น” คือวัตถุประสงค์ใหม่ที่ผู้เข้าร่วมไม่ได้อนุมัติ
รายการตรวจสอบการควบคุมข้อมูลที่ผ่านการพิจารณาด้านจริยธรรมได้:
- ลดข้อมูลให้เหลือน้อยที่สุด — ส่งโค้ด ส่วนตัดตอนที่ลบข้อมูลระบุตัวตนแล้ว หรือพจนานุกรมตัวแปร ไม่ใช่ไฟล์ดิบ แนวทางการลดข้อมูลสำหรับระบบ AI คือเก็บรวบรวมและจัดเก็บเฉพาะสิ่งที่งานต้องใช้
- ลบข้อมูลระบุตัวตนก่อนอัปโหลด — ลบชื่อ สถานที่ การวินิจฉัยที่พบได้น้อย และเมทาดาทาของไฟล์
- เลือกแพลตฟอร์มที่ระบุว่าจะไม่ฝึกโมเดลสาธารณะจากเนื้อหาของคุณ — นโยบายแพลตฟอร์มของ Jenova ระบุว่าข้อมูลผู้ใช้จะไม่ถูกใช้เพื่อฝึกโมเดล AI สาธารณะ และเข้ารหัสทั้งระหว่างส่งผ่านและขณะจัดเก็บ อ่านเงื่อนไขของคู่แข่งด้วยระดับความเฉพาะเจาะจงเดียวกัน; “เราให้ความสำคัญกับความเป็นส่วนตัว” ไม่ใช่มาตรการควบคุม
- แยกโครงการ — ใช้หนึ่งเธรดของเอเจนต์ต่อหนึ่งการศึกษา เพื่อไม่ให้ชุดข้อมูลโรงพยาบาลถูกเรียกคืนขณะที่คุณกำลังร่างบทความบล็อกสาธารณะ
- ตรวจสอบสัญญา — งานที่สนับสนุนโดยภาคอุตสาหกรรม ผลการค้นพบแบบใช้ได้สองทาง และข้อตกลงการใช้ข้อมูล มักห้ามใช้ผู้ประมวลผลภายนอกโดยสิ้นเชิง
Jenova แข็งแรงกว่าแชตบอตสำหรับผู้บริโภคในมิตินี้ เนื่องจากมีจุดยืนไม่ฝึกโมเดลสาธารณะและมีความจำโครงการที่คุณควบคุมได้ แต่ไม่ใช่เวชระเบียนอิเล็กทรอนิกส์ที่ได้รับการรับรอง HIPAA เครื่องมือทำให้ข้อมูลไม่สามารถระบุตัวตนได้ หรือสิ่งทดแทนพื้นที่จัดเก็บข้อมูลปลอดภัยของมหาวิทยาลัย หากโครงการ IRB ระบุซอฟต์แวร์ที่อนุมัติไว้ รายการนั้นมีผลเหนือกว่า
สำหรับงานวิจัยสัมภาษณ์ คำสั่งที่ปลอดภัยคือ:
“ต่อไปนี้คือส่วนตัดตอน 6 ส่วนที่ลบข้อมูลระบุตัวตนแล้ว โดยนำชื่อและสถานที่ออกเรียบร้อย เสนอรหัสการวิเคราะห์เชิงประเด็นเท่านั้น ห้ามคาดเดาตัวตน ห้ามเก็บส่วนตัดตอนเหล่านี้ไว้นอกเหนือจากงานนี้ หากภายหลังฉันขอให้คุณลืมข้อมูลเหล่านี้”
หากคุณไม่สามารถเขียนคำสั่งนี้ได้ เพราะข้อความยังระบุตัวตนได้ แสดงว่าคุณยังไม่พร้อมใช้ AI กับข้อมูลนั้น
คุณจะสร้างเวิร์กโฟลว์วิจัย AI ที่ปลอดภัยต่อความซื่อสัตย์ได้อย่างไร?
เวิร์กโฟลว์ที่ปลอดภัยต่อความซื่อสัตย์เริ่มจากคำถามวิจัยและคลังแหล่งข้อมูล ใช้ AI เฉพาะในขั้นตอนที่ระบุชื่ออย่างชัดเจน และจบด้วยย่อหน้าการเปิดเผยพร้อมบันทึกการตรวจสอบ ลำดับด้านล่างใช้ได้กับ Academic Research Assistant ของ Jenova และสามารถทำซ้ำได้ใน Elicit หรือ Scite แม้แต่ละเครื่องมือจะมีจุดแข็งต่างกัน
ขั้นที่ 1 — กำหนดขอบเขตโดยยังไม่ใช้แหล่งข้อมูล ขอให้เอเจนต์ระบุคำนิยามที่แข่งขันกัน ฐานข้อมูลที่น่าจะเกี่ยวข้อง และกฎการคัดออก อย่ายอมรับการอ้างอิงใดในขั้นนี้
“ฉันกำลังเขียนบทวิธีการเกี่ยวกับ [คำถาม] ระบุคำถามย่อยที่การค้นหาอย่างเป็นระบบควรครอบคลุม ห้ามอ้างอิงบทความ ชี้จุดที่คำถามของฉันกว้างเกินไป”
ขั้นที่ 2 — ค้นคืน แล้วตรึงคลังแหล่งข้อมูล ใช้ Academic Research Assistant หรือ Elicit หากคุณคัดกรองการทดลองหลายร้อยรายการ เพื่อรวบรวมระเบียนที่เป็นตัวเลือกพร้อม DOI ส่งออกไปยัง Zotero, EndNote หรือตัวจัดการเอกสารอ้างอิงของสถาบัน ตัวจัดการเอกสารอ้างอิง ไม่ใช่บันทึกการแชต คือระบบระเบียนหลัก
เอเจนต์ Deep Research ที่เกี่ยวข้องของ Jenova มีประโยชน์เมื่อต้องการบทสรุปภาพกว้างที่มีการอ้างอิงมากก่อนจะทำให้คลังบทความแคบลง ให้ถือว่าบทสรุปนั้นเป็นแผนที่ ไม่ใช่วรรณกรรมที่คุณได้อ่านแล้ว
ขั้นที่ 3 — สกัดข้อมูลด้วยตาราง ไม่ใช่ย่อหน้า ขอให้แสดงรูปแบบการศึกษา กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัดเป็นคอลัมน์ Elicit ถูกออกแบบมาโดยตรงสำหรับงานนี้; Jenova สามารถร่างตารางเดียวกันได้หากคุณป้อนบทความที่เปิดอ่านแล้ว
ขั้นที่ 4 — ร่างจากโน้ตของคุณ เขียนหรือบอกกล่าวเป็นหัวข้อย่อย อนุญาตให้เอเจนต์ช่วยวางโครงร่างและทดสอบตรรกะอย่างเข้มงวด อย่าให้มัน “เกลาภาษา” จนกว่าแหล่งข้อมูลจะถูกยืนยันแล้ว
ขั้นที่ 5 — ตรวจสอบและเปิดเผย ค้นหา DOI ทุกรายการให้พบ อ่านทุกข้อความที่คุณอ้างถึง เพิ่มประโยคในส่วนวิธีการ เช่น: “มีการใช้โมเดลภาษาขนาดใหญ่ (ชื่อโมเดล, วันที่) เพื่อจัดระเบียบโน้ตและเสนอคำค้นหา; ผู้เขียนตรวจสอบการอ้างอิงทั้งหมดกับแหล่งข้อมูลปฐมภูมิแล้ว”
การตั้งค่า Jenova ใช้เวลาไม่กี่นาที: เปิด Academic Research Assistant ระบุสาขาและข้อจำกัดด้านความซื่อสัตย์ของคุณในข้อความแรก และแนบเฉพาะไฟล์ที่คุณได้รับอนุญาตให้ประมวลผล ระดับฟรีครอบคลุมการใช้งานจำกัด; Plus เริ่มต้นที่ $20 ต่อเดือน พร้อมโควตา 30 เท่าของระดับฟรี การใช้งานเป็นโควตารายเดือนแทนเพดานรายวัน ซึ่งมีความสำคัญในช่วงเร่งแก้ไขต้นฉบับ
สำหรับ Elicit เส้นทางคู่ขนานคือ: ตั้งคำถามสำหรับการทบทวน สร้างตารางหลักฐาน ปรับแต่งว่าบทความใดเข้าสู่รายงาน แล้วส่งออกและตรวจสอบ สำหรับ Scite เส้นทางคู่ขนานคือ: ใส่บทความสำคัญของคุณ แล้วตรวจสอบการอ้างอิงที่สนับสนุนเทียบกับที่โต้แย้ง ก่อนที่คุณจะอ้างว่ามีฉันทามติ
กฎที่ต่อรองไม่ได้ของเวิร์กโฟลว์คือเรื่องลำดับ: ค้นหาก่อนเขียนประโยค อ่านข้อความก่อนเรียบเรียงใหม่ เปิดเผยก่อนส่งผลงาน
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยกล่าวอย่างไรเกี่ยวกับงานวิชาการที่ใช้ AI ช่วย?
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยมองการอ้างอิงที่เกิดจากการหลอน การร่างงานด้วย AI โดยไม่เปิดเผย และการอัปโหลดข้อมูลโดยไร้การควบคุม มากขึ้นเรื่อย ๆ ว่าเป็นความล้มเหลวของกระบวนการที่สถาบันสามารถออกแบบเพื่อป้องกันได้ ไม่ใช่เหตุการณ์ทุจริตของนักศึกษาที่พบได้ยาก
“ข้อผิดพลาดที่เราเห็นไม่ใช่การที่นักวิจัยใช้โมเดล แต่คือการใช้วงจรสร้างก่อนแล้วค่อยอ้างอิงกับงานที่การอ้างอิงเองเป็นข้อมูล หากส่วนผลการวิจัยของคุณขึ้นอยู่กับการมีอยู่จริงของบทความ เอกสารอ้างอิงปลอมที่เขียนได้ลื่นไหลก็ใกล้เคียงกับการปลอมแปลงข้อมูลมากกว่าการจัดรูปแบบที่สะเพร่า วิธีแก้ต้องเป็นเชิงสถาปัตยกรรม: ค้นคืนระเบียน สกัดข้ออ้าง แล้วจึงเขียน เครื่องมือที่กลับลำดับนี้จะยังคงหว่านสิ่งที่ไม่มีอยู่จริงลงในวรรณกรรมต่อไป”
“ความล้มเหลวด้านความเป็นส่วนตัวก็ตามรูปแบบการกลับลำดับเดียวกัน ผู้คนวางไฟล์ที่มีข้อมูลมากที่สุดเพราะสะดวก ซึ่งตรงข้ามกับหลักการจำกัดการเก็บรวบรวม ลบข้อมูลระบุตัวตนก่อน ลดข้อมูลเป็นลำดับถัดไป และเลือกระบบที่จะไม่ฝึกโมเดลสาธารณะจากข้อมูลตกค้าง ความสะดวกไม่ใช่ข้อยกเว้นด้านจริยธรรม”
“เรายังแนะนำให้ห้องปฏิบัติการหยุดโยนความรับผิดชอบด้านความซื่อสัตย์ให้ตัวตรวจจับ AI ตัวตรวจจับไม่สามารถแสดงแหล่งข้อมูล พิสูจน์เจตนา หรือป้องกันผลบวกลวงที่ลงโทษผู้เขียนที่ไม่ได้ใช้ภาษาแม่ได้ บันทึกการตรวจสอบและการเปิดเผยแบบ COPE อาจช้ากว่าในวันแรก แต่เร็วขึ้นมากเมื่อผู้ประเมินถามว่า ‘เอกสารอ้างอิงนี้มาจากไหน?’”
— ทีมผลิตภัณฑ์ Jenova, งานวิจัยเวิร์กโฟลว์ AI ทางวิชาการ, ประสบการณ์ 8 ปีในการออกแบบเอเจนต์วิจัยที่คำนึงถึงการอ้างอิง
มุมมองนี้สอดคล้องกับแนวทางอย่างเป็นทางการ COPE กำหนดความรับผิดไว้กับผู้เขียนที่เป็นมนุษย์ Cornell ขอให้อาจารย์กำหนดให้ตรวจสอบการอ้างอิง และรวบรวมหลักฐานเชิงวัตถุ เช่น เอกสารอ้างอิงที่ไม่มีอยู่จริง หรือวิธีการที่นักศึกษาอธิบายไม่ได้ แทนที่จะใช้คะแนนจากตัวตรวจจับ แนวทางของ Cambridge ต่อความซื่อสัตย์ทางวิชาการในยุค AI เริ่มจากหลักการเดียวกัน: หากการประเมินไม่สะท้อนการเรียนรู้อีกต่อไป วุฒิบัตรเองคือสิ่งที่ต้องสูญเสีย
จะเกิดอะไรขึ้นเมื่อการใช้ AI ข้ามเกณฑ์ความซื่อสัตย์ของสถาบัน?
เมื่อการใช้ AI ข้ามเกณฑ์ของสถาบัน บทลงโทษจะตกอยู่กับผู้เขียนที่เป็นมนุษย์ และมากขึ้นเรื่อย ๆ กับอาจารย์ที่ปรึกษา ตั้งแต่การบังคับแก้ไข ไปจนถึงการชะลอการส่งผลงานหรือการยกเลิกการลงทะเบียน นโยบายแตกต่างกันไปตามประเทศและมหาวิทยาลัย แต่ทิศทางในปี 2026 คือช่วงความคล้ายคลึงที่เข้มงวดขึ้น การตรวจสอบ AI ที่ชัดเจนขึ้น และความอดทนน้อยลงต่อข้ออ้างว่า “โมเดลแต่งขึ้นเอง”
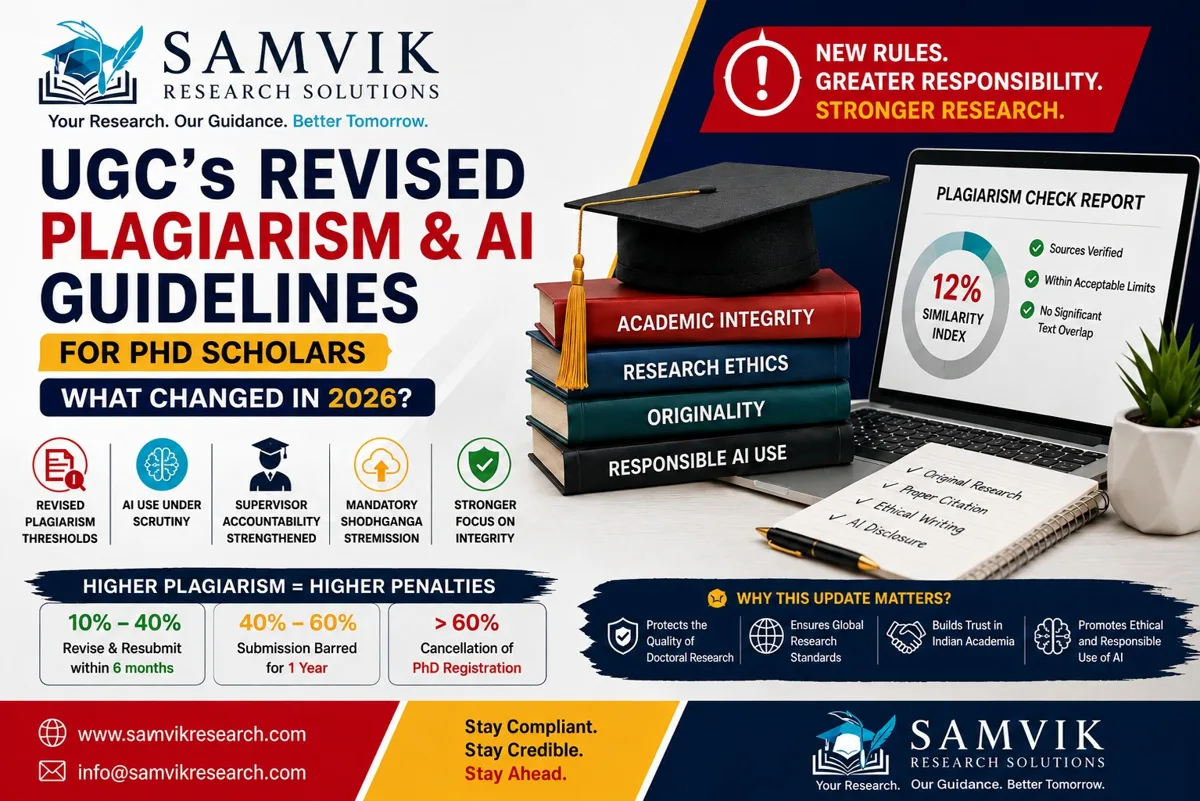
แนวทางที่เผยแพร่ให้แก่นักศึกษาปริญญาเอกในปี 2026 เกี่ยวกับการปรับปรุงข้อกำหนดของ University Grants Commission (UGC) แสดงให้เห็นว่าเกณฑ์เชิงตัวเลขกลายเป็นเหตุการณ์สำคัญในอาชีพได้อย่างไร ในกรอบดังกล่าว ความคล้ายคลึงระหว่าง 10% ถึง 40% ทำให้ต้องแก้ไขและส่งใหม่ภายใน 6 เดือน; 40% ถึง 60% อาจห้ามส่งผลงานเป็นเวลา 1 ปี; และความคล้ายคลึงเกิน 60% อาจยกเลิกการลงทะเบียน PhD แนวทางเดียวกันยังจับคู่เกณฑ์เหล่านี้กับการทบทวนการใช้ AI ที่ใกล้ชิดขึ้น ความรับผิดชอบของอาจารย์ที่ปรึกษาที่มากขึ้น และการฝากผลงานในคลังบังคับ แม้มหาวิทยาลัยของคุณใช้เกณฑ์ตัดสินต่างออกไป ตรรกะนี้ก็ใช้ได้ทั่วไป: ความซ้ำซ้อนถูกมองเป็นสัญญาณความซื่อสัตย์ที่วัดได้ และ “AI ช่วย” ไม่ใช่ข้อแก้ตัว หากข้อความไม่ใช่งานของคุณหรือเอกสารอ้างอิงไม่ใช่ของจริง
วารสารเพิ่มการตรวจสอบอีกชั้นหนึ่ง จุดยืนเรื่องผู้เขียนของ COPE หมายความว่าคุณไม่สามารถระบุ ChatGPT, Elicit, Scite หรือ Jenova เป็นผู้ร่วมเขียนได้ คุณสามารถ และมักจำเป็นต้อง ระบุชื่อเครื่องมือในส่วนวิธีการ การไม่เปิดเผยถูกมองว่าเป็นการละเมิดความโปร่งใสมากขึ้น แม้ว่าวิทยาศาสตร์จะถูกต้องก็ตาม ส่วนเอกสารอ้างอิงที่สร้างขึ้นอาจเป็นเหตุให้ปฏิเสธหรือเพิกถอนบทความ เพราะทำให้บันทึกทางวิชาการเป็นเท็จ
นัยเชิงปฏิบัติสำหรับทุกคนที่ส่งผลงานในปี 2026:
- รู้ช่วงความคล้ายคลึงของสถาบัน ก่อน เริ่มร่าง ไม่ใช่หลังตัวตรวจสอบทำงานแล้ว
- เก็บคำสั่งและเวอร์ชันโมเดลไว้ เพื่อให้คุณสามารถสร้างลำดับเหตุการณ์ของสิ่งที่เครื่องมือมีส่วนช่วยได้
- อย่าถือว่าคะแนนตัวตรวจจับ AI ที่ต่ำคือการผ่าน ให้ถือว่าบรรณานุกรมที่ครบถ้วนและตรวจสอบได้คือการผ่าน
- หากคุณดูแลนักศึกษา ให้ตรวจสอบบันทึกแหล่งข้อมูลของพวกเขา ความรับผิดชอบกำลังเคลื่อนขึ้นไปตามสายงาน
เมื่อใช้ภายใต้ข้อจำกัดเหล่านี้ AI ยังคงเป็นตัวเร่งที่ถูกต้องตามหลักการสำหรับการค้นหา การสกัด และการจัดระเบียบ เมื่อใช้เป็นผู้ร่วมเขียนที่มองไม่เห็นพร้อมรายการอ้างอิงที่แต่งขึ้น มันกลายเป็นหนึ่งในวิธีที่รวดเร็วที่สุดในการทำให้การจบปริญญาหรือบทความหยุดชะงัก
เอกสารอ้างอิง
- Nature — การอ้างอิงที่เกิดจากการหลอนกำลังปนเปื้อนวรรณกรรมวิทยาศาสตร์
- Enago — เอกสารอ้างอิงที่ AI สร้างขึ้น: 1 ใน 5 เป็นของปลอม
- STAT — การอ้างอิงฉ้อฉลที่โทษว่าเกิดจากการหลอนของ AI กำลังแพร่กระจายในบทความวิชาการ
- Today’s Clinical Lab — เอกสารอ้างอิงปลอมที่ AI สร้างขึ้นเพิ่มขึ้นทั่ววรรณกรรมชีวการแพทย์
- Accountability in Research (Taylor & Francis) — การอ้างอิงที่เกิดจากการหลอนซึ่งผลิตโดยปัญญาประดิษฐ์เชิงกำเนิด
- PubMed Central — การอ้างอิงปลอมในยุค AI: สัญญาณปลุกสำหรับบรรณาธิการ
- Cornell University Center for Teaching Innovation — AI และความซื่อสัตย์ทางวิชาการ
- COPE — การเป็นผู้เขียนและเครื่องมือ AI
- Elicit — AI สำหรับการวิจัยทางวิทยาศาสตร์ (ขนาดคลังข้อมูล การอ้างอิงระดับประโยค เวิร์กโฟลว์การทบทวนอย่างเป็นระบบ)
- Scite — คำตอบที่มีการอ้างอิงรองรับจากบทความวิชาการมากกว่า 300 ล้านรายการ
- Paperguide — การเปรียบเทียบ Elicit กับ Scite สำหรับนักวิจัย (2026)
- The Drive AI — Elicit เทียบกับ Consensus เทียบกับ Semantic Scholar
- George Mason University Libraries — เครื่องมือ AI สำหรับการทบทวนวรรณกรรม
- IBM — สำรวจประเด็นความเป็นส่วนตัวในยุค AI
- Office of the Victorian Information Commissioner — ปัญญาประดิษฐ์และความเป็นส่วนตัว: ประเด็นและความท้าทาย
- Fortra — ความเป็นส่วนตัวของข้อมูล AI: ความท้าทายและแนวทางแก้ไข
- European Network for Academic Integrity — แนวทางทั่วไปสำหรับความซื่อสัตย์ทางวิชาการ
- ScienceDirect — การประเมินความซื่อสัตย์ทางวิชาการใหม่ในยุค AI
- Cambridge University Press — ความซื่อสัตย์ทางวิชาการในยุค AI