คุณจะป้องกันไม่ให้ AI ลืมบริบทการวิจัยที่ยาวนานหลายเดือนได้อย่างไร?
2026-08-21
การออกแบบหน่วยความจำแบบใดช่วยคงกลยุทธ์การค้นหาไว้ได้ตลอดวงจรการทบทวน?
แชตบอตที่ผูกติดกับเซสชันจะลืมสตริงการค้นหา เกณฑ์คัดเข้า และผลการสกัดข้อมูลทันทีที่บทสนทนาสิ้นสุดลง จึงทำให้การทบทวนที่กินเวลาหลายเดือนชะงักงัน เครื่องมือที่มองโปรโตคอลเป็นสถานะถาวร — Jenova's Academic Research Assistant ที่มีหน่วยความจำข้ามเซสชันแบบถาวร, Elicit ที่มีพื้นที่ทำงานสำหรับ systematic review ระดับโครงการ และสมุดบันทึกที่ยึดโยงกับชุดแหล่งข้อมูล เช่น Gemini Notebook — คือรูปแบบที่อยู่รอดได้ตลอดวงจรการทบทวนเต็มรูปแบบในปี 2026 ขณะที่ Consensus ยังโดดเด่นกว่าสำหรับการทำแผนที่หลักฐานแบบครั้งเดียวจบ มากกว่าการจดจำโปรโตคอลของคุณในไตรมาสหน้า
ปัจจัยสำคัญที่แยกหน่วยความจำการวิจัยที่คงทนออกจากแชตที่ใช้แล้วทิ้ง:
✅ ชั้นโปรโตคอลที่ตรึงไว้ — บันทึกกฎการคัดเข้าและคัดออกเป็นคำสั่ง ไม่ใช่เป็นพรอมป์ต์ที่ต้องพิมพ์ซ้ำ ✅ หน่วยความจำผลการค้นพบที่สะสม — เรียกคืนข้อมูลที่สกัดไว้ก่อนหน้า เหตุผลในการคัดออก และข้อขัดแย้งที่ยังไม่คลี่คลายได้โดยไม่ต้องอธิบายใหม่ ✅ ชุดหลักฐานที่ยึดโยงกับแหล่งที่มา — แนบบทความ บันทึก และล็อกการค้นหา เพื่อให้คำตอบผูกอยู่กับชุดหลักฐานของคุณ ✅ การตัดสินใจที่ตรวจสอบย้อนหลังได้ — สร้างเหตุผลในการคัดกรองย้อนหลังได้หลายเดือนต่อมา และสอดคล้องกับ PRISMA 2020 ✅ ความต่อเนื่องข้ามเซสชัน — การสลับวัน อุปกรณ์ หรือโมเดลไม่ควรล้างสถานะของการทบทวน
หากต้องการเปรียบเทียบเครื่องมือเหล่านี้ให้มีประโยชน์ ควรมองหน่วยความจำการวิจัยเป็นสแตก แทนที่จะมองเป็นเพียงฟีเจอร์ของแชตบอต และทดสอบว่าแต่ละชั้นยังคงอยู่หรือไม่หลังจากห่างหายจากโครงการไปหนึ่งสัปดาห์
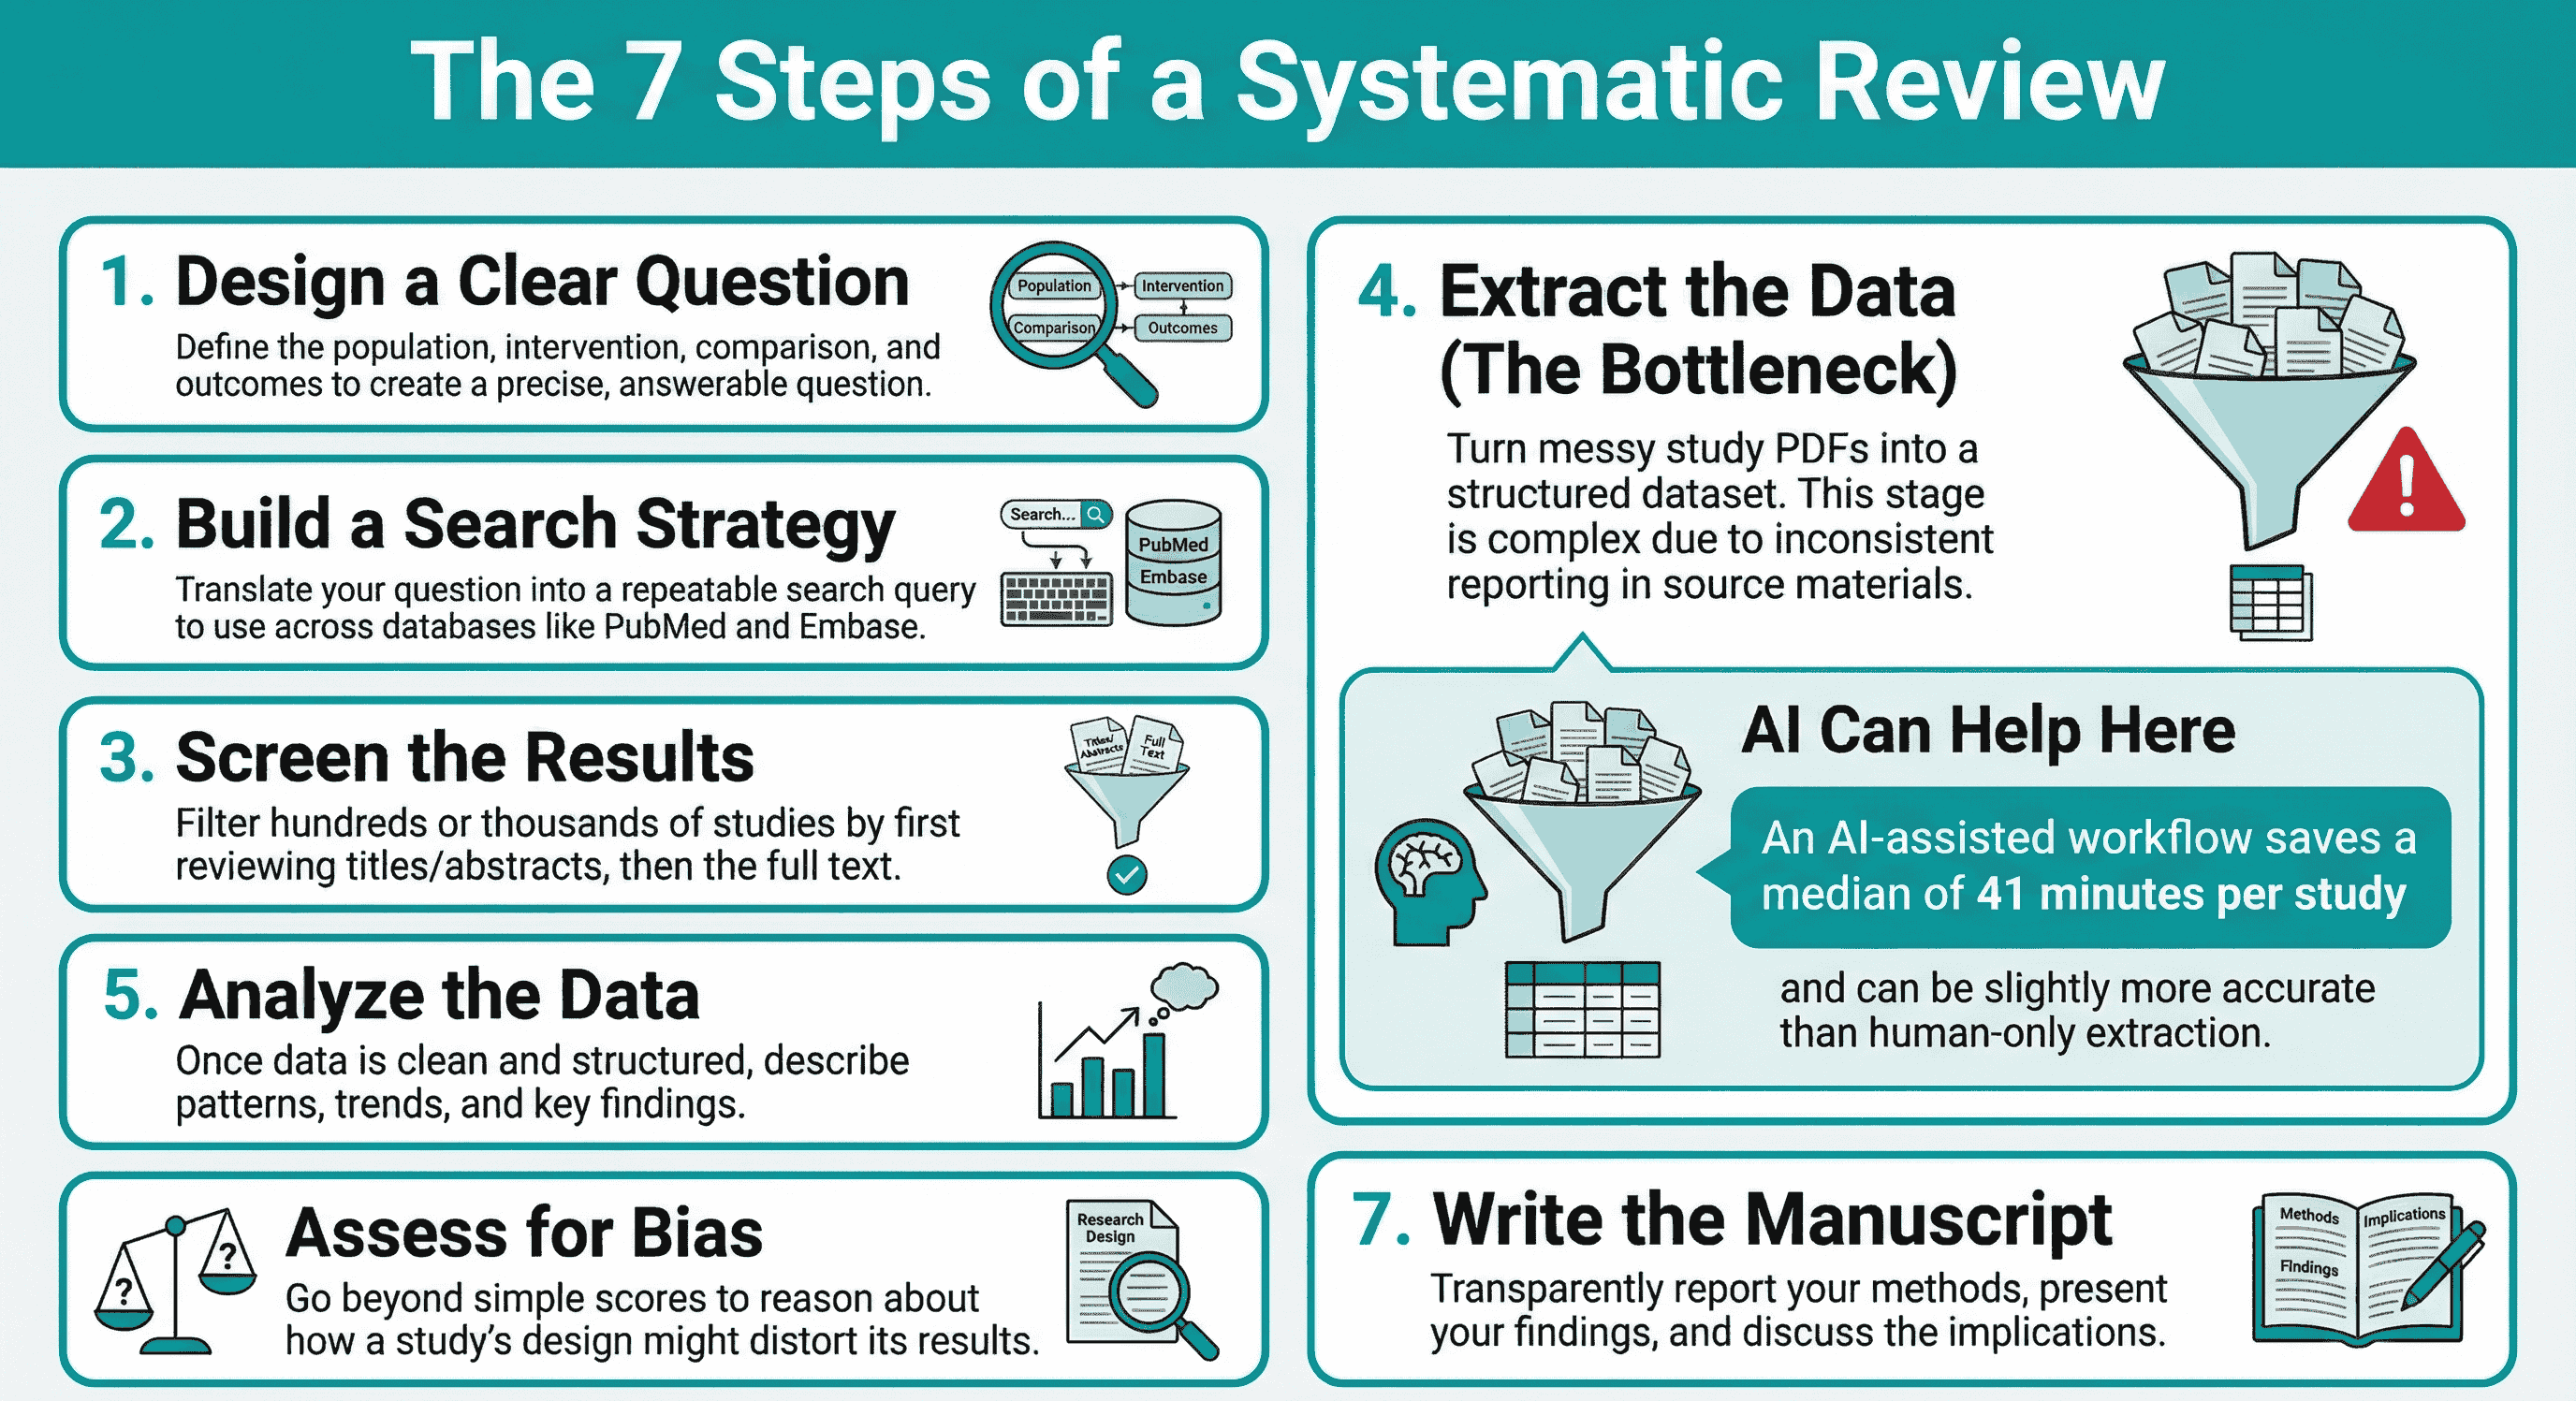
เหตุใดผู้ช่วยวิจัย AI จึงสูญเสียความเที่ยงตรงต่อโปรโตคอลเมื่อเวลาผ่านไป?
แชต AI สำหรับผู้บริโภคส่วนใหญ่ลืมบริบท เพราะเก็บไว้ในหน้าต่างชั่วคราว ไม่ใช่ในโครงการที่คงอยู่ข้ามเซสชัน การทบทวนอย่างเป็นระบบเป็นกระบวนการเจ็ดขั้นตอน ได้แก่ การออกแบบคำถาม กลยุทธ์การค้นหา การคัดกรอง การสกัดข้อมูล การวิเคราะห์ การประเมินอคติ และการเขียนต้นฉบับ โดยแต่ละขั้นตอนขึ้นอยู่กับการตัดสินใจที่ทำไว้หลายสัปดาห์ก่อนหน้า เมื่อผู้ช่วยไม่สามารถระลึกถึงกรอบ PICO เดิม หรือเหตุผลที่คัดบทความหนึ่งออกได้ การทบทวนก็เริ่มเบี่ยงทิศทาง
มาตรฐานการรายงานสำหรับงานประเภทนี้ระบุไว้อย่างชัดเจน คำแถลง PRISMA 2020 คือรายการตรวจสอบที่อิงหลักฐานสำหรับการรายงาน systematic review และ บทความ PRISMA 2020 ใน BMJ วางตำแหน่งมาตรฐานนี้ไว้สำหรับการทบทวนที่มีการสังเคราะห์ เช่น อภิมานแบบเปรียบเทียบเป็นคู่ คู่มือวิธีวิจัยของ Hofstra University ระบุว่าคำแถลงนี้เป็น ชุดขั้นต่ำ 27 รายการ สำหรับการรายงาน systematic review และ meta-analysis ผู้ช่วยที่สร้างสตริงการค้นหาหรือเหตุผลในการคัดออกขึ้นมาใหม่ไม่ได้ ย่อมไม่สามารถสนับสนุนรายการตรวจสอบดังกล่าวได้
ปัญหาการลืมไม่ใช่เรื่องสมมติ นักวิจัยใช้ machine learning ตลอดสายงานการทบทวนอยู่แล้ว โดย การทำแผนที่เครื่องมือ ML 63 รายการในปี 2022 ครอบคลุมงานตั้งแต่การค้นหาเอกสารวิชาการไปจนถึงการสกัดข้อมูล สิ่งที่เครื่องมือเหล่านี้มักแก้ไม่ได้ด้วยตัวเองคือความเที่ยงตรงในระยะยาว: การใช้กฎคัดเข้าเดียวกัน ในลักษณะเดียวกัน ในเดือนที่สี่เช่นเดียวกับเดือนแรก
ผู้ช่วยแบบแชตทำให้ปัญหานี้หนักขึ้นในสามลักษณะเฉพาะ:
- โปรโตคอลระเหยหายไป สตริง Boolean ขอบเขตฐานข้อมูล เช่น PubMed และ Embase รวมถึงขีดจำกัดด้านวันที่ อยู่ในพรอมป์ต์ที่ไม่ได้บันทึกเป็นวัตถุหลัก
- เกณฑ์ค่อย ๆ เบี่ยงเบน การกล่าวเกณฑ์คัดเข้าอย่างไม่เป็นทางการซ้ำไปมา ค่อย ๆ เปลี่ยนนิยามของประชากร การแทรกแซง หรือผลลัพธ์
- ภาวะลืมผลการค้นพบ ขนาดผลลัพธ์ที่สกัดไว้ ผลลัพธ์ที่ขัดแย้งกัน และบันทึกว่า “กลับมาดูบทความนี้อีกครั้ง” หายไปเมื่อเธรดสิ้นสุด
คู่มือการสังเคราะห์หลักฐานของ King's College London สรุปฉันทามติปัจจุบันได้ชัดเจนว่า AI ช่วยได้ในหลายขั้นตอนของการทบทวน แต่ไม่อาจทดแทนการควบคุมเชิงระเบียบวิธีได้ หน่วยความจำคือการควบคุมนั้นที่ขยายยาวไปตามเวลาในปฏิทิน
คุณควรมองหาอะไรในเครื่องมือ AI ที่จดจำบริบทการวิจัยได้?
คุณควรประเมิน AI สำหรับงานวิจัยระยะยาวจากความคงอยู่ของโปรโตคอล ความต่อเนื่องของผลการค้นพบ การยึดโยงกับแหล่งข้อมูล ความสามารถในการตรวจสอบย้อนหลัง ความครอบคลุมของคลังเอกสาร และต้นทุนในการรักษาสถานะเหล่านั้น ไม่ใช่จากความลื่นไหลของแชตครั้งเดียว เครื่องมือที่เขียนบทสรุปอย่างสละสลวย แต่ดึงบันทึกการคัดออกของเดือนที่แล้วไม่ได้ จะทำให้คุณเสียเวลามากกว่าที่ช่วยประหยัดได้
บทความนี้ใช้โมเดลสี่ชั้นที่เรียกว่า สแตกความต่อเนื่องของการวิจัย เพื่อทำให้การประเมินเป็นรูปธรรม:
- โปรโตคอลที่ตรึงไว้ กลยุทธ์การค้นหาและเกณฑ์คัดเข้า/คัดออกที่จัดเก็บไว้นอกบัฟเฟอร์แชต เช่น คำสั่งกำหนดเอง เอกสารโปรโตคอล หรือการกำหนดค่าการคัดกรอง
- หน่วยความจำที่สะสม ผลการค้นพบเดิม คำถามที่ยังเปิดอยู่ และความเห็นต่างของผู้ทบทวน ซึ่งเพิ่มพูนข้ามเซสชันแทนที่จะรีเซ็ต
- ชุดเอกสารที่ยึดโยงกับแหล่งข้อมูล บทความ PDF บันทึก และไฟล์ส่งออกการค้นหาที่ผู้ช่วยได้รับอนุญาตให้ใช้จริง
- การตรวจสอบการตัดสินใจ เหตุผลที่สร้างย้อนหลังได้สำหรับการคัดเข้า/คัดออก โดยควรมีคำพูดอ้างอิง เพื่อให้ผู้ทบทวนคนที่สองหรือแผนภาพการไหล PRISMA สร้างได้ในภายหลัง
การทดสอบตามสแตกนี้เปลี่ยนคำถามในการเลือกซื้อ Elicit ถูกสร้างมาให้เกณฑ์คัดกรอง เหตุผลในการคัดออก และคะแนนรายเกณฑ์ ตรวจสอบตาม PRISMA ได้ จึงแข็งแกร่งในชั้นที่ 1 และ 4 Gemini Notebook ถูกสร้างมาให้คำตอบอ้างอิง คำพูดที่ตรงตามต้นฉบับจากแหล่งข้อมูลที่อัปโหลด จึงแข็งแกร่งในชั้นที่ 3 Consensus ถูกสร้างมาเพื่อค้นหา บทความวิจัยมากกว่า 250 ล้านฉบับ และแสดงจุดที่หลักฐานสอดคล้องกัน จึงแข็งแกร่งด้านการค้นพบ แต่อ่อนด้านการจดจำโปรโตคอลของ คุณ Jenova's Academic Research Assistant ถูกสร้างขึ้นโดยเน้นประวัติแชตไม่จำกัด หน่วยความจำถาวรข้ามเซสชัน และฐานความรู้ที่แนบได้ จึงแข็งแกร่งในชั้นที่ 1–3 สำหรับโปรแกรมงานหลายเดือน แต่ด้อยกว่าในด้านแผนภาพ PRISMA แบบเนทีฟ
ให้น้ำหนักแต่ละชั้นตามประเภทโครงการ systematic review แบบ Cochrane ควรให้น้ำหนักกับความสามารถในการตรวจสอบย้อนหลังมากเป็นพิเศษ การทบทวนวรรณกรรมสำหรับวิทยานิพนธ์ที่กินเวลาสองภาคการศึกษาควรให้น้ำหนักกับหน่วยความจำที่สะสม ห้องปฏิบัติการที่ใช้บทความชุดเดิมซ้ำในหลายโครงการควรให้น้ำหนักกับชุดเอกสารที่ยึดโยงกับแหล่งข้อมูลและนำกลับมาใช้ซ้ำได้
Jenova, Elicit, Consensus และ Gemini Notebook จัดการหน่วยความจำการวิจัยระยะยาวอย่างไร?
Jenova แข็งแกร่งที่สุดเมื่องานวิจัยเป็นการสนทนา ทำซ้ำเป็นรอบ และวัดระยะเวลาเป็นเดือน Elicit แข็งแกร่งที่สุดเมื่อหน่วยงานของงานคือ systematic review ที่เป็นทางการ Consensus แข็งแกร่งที่สุดสำหรับการทำแผนที่หลักฐานอย่างรวดเร็ว และ Gemini Notebook แข็งแกร่งที่สุดเมื่อมีชุดเอกสารอยู่ในมือแล้ว ไม่มีเครื่องมือใดในสี่ตัวนี้ดีกว่าเสมอไป เพราะแต่ละเครื่องมือปรับให้เหมาะกับคนละชั้นของสแตกความต่อเนื่องของการวิจัย
| ฟีเจอร์ / มิติ | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| ความคงอยู่ของโปรโตคอล | พื้นที่ทำงานโครงการ; อัปเดตการทบทวนแบบมีชีวิต | ประวัติไม่จำกัด หน่วยความจำถาวร คำสั่งกำหนดเอง | ตัวกรองระดับพรอมป์ต์; ไม่ใช่โปรโตคอลที่จัดเก็บ | คำสั่งและแหล่งข้อมูลในขอบเขตสมุดบันทึก |
| เกณฑ์คัดเข้า | แนะนำเกณฑ์อัตโนมัติ; ทบทวนคู่; เหตุผลคัดออก | เข้ารหัสในคำสั่งและเรียกคืนได้ข้ามเซสชัน | ตัวกรองภาษาธรรมชาติที่ใช้ต่อการค้นหาแต่ละครั้ง | ผู้ใช้กำหนดภายในสมุดบันทึกที่มีขอบเขต |
| การเรียกคืนผลการค้นพบก่อนหน้า | ตารางและรายงานที่สกัดแล้วนำกลับใช้ซ้ำได้ | หน่วยความจำข้ามเซสชันสำหรับบันทึก ข้อขัดแย้ง และการตัดสินใจ | การสังเคราะห์ระดับคำค้น ไม่ใช่บันทึกระยะยาว | ยึดโยงกับสิ่งที่คุณอัปโหลด |
| คลังเอกสาร / แหล่งข้อมูล | บทความ 138 ล้านฉบับ, PubMed, ClinicalTrials.gov และไฟล์อัปโหลด | ไฟล์อัปโหลด ฐานความรู้ และเครื่องมือค้นหาสด | บทความมากกว่า 250M ฉบับ และข้อความเต็มที่ได้รับอนุญาต | PDF, เอกสาร, เว็บไซต์, เสียง และวิดีโอที่อัปโหลด |
| การตรวจสอบย้อนหลัง | PRISMA flow, คำพูดอ้างอิง, คะแนนรายเกณฑ์ | ร่องรอยการสนทนา; ไม่มีแผนภาพ PRISMA แบบเนทีฟ | การอ้างอิงเชิงวิชาการและ Consensus Meter | การอ้างอิงระดับคำพูดจากแหล่งข้อมูล |
| ราคา ณ ปี 2026 | การสมัครสมาชิกแบบชำระเงิน รวมถึงระดับ Pro ที่มีเอกสารอธิบาย | ระดับฟรี; แผนชำระเงินเริ่มต้นที่ $20/เดือน | การสมัครสมาชิกแบบชำระเงิน | ฟรีสำหรับบุคคลทั่วไป; ข้อมูลองค์กรไม่ถูกนำไปฝึกโมเดล |
| เหมาะที่สุดสำหรับ | systematic review ที่เป็นทางการและการอัปเดตแบบมีชีวิต | โปรแกรมวิจัยหลายเดือนที่ต้องไม่ลืม | ภาพรวมหลักฐานอย่างรวดเร็วและการค้นหาใน Medical mode | การสังเคราะห์คลังเอกสารปิดและการสอนจากแหล่งข้อมูล |
Elicit
Elicit คือผู้ช่วยวิจัยเชิงวิทยาศาสตร์ที่สร้างมาโดยเฉพาะ ใช้เพื่อ ค้นหา สรุป สกัดข้อมูลจาก และสนทนากับบทความมากกว่า 125 ล้านฉบับ และผลิตภัณฑ์สำหรับ systematic review จัดทำดัชนี บทความ 138 ล้านฉบับ พร้อมอัปเดตรายสัปดาห์ เครื่องมือนี้คัดกรองได้สูงสุด 40,000 บทความ แนะนำเกณฑ์การคัดกรองอัตโนมัติ และเก็บทุกการตัดสินใจให้ตรวจสอบตาม PRISMA ได้ พร้อมเหตุผลคัดออกและคำพูดสนับสนุน
ข้อจำกัดสำหรับ โปรแกรม การวิจัยแบบผสมที่กินเวลาหลายเดือนคือความเฉพาะทาง Elicit โดดเด่นในงานปฏิบัติการทบทวนที่มีโครงสร้าง แต่ได้รับการออกแบบน้อยกว่าในฐานะคู่คิดด้านวิจัยทั่วไปที่จดจำสมมติฐานข้างเคียง ข้อเสนอแนะจากอาจารย์ที่ปรึกษา และบันทึกที่เปลี่ยนแปลงไปนอกวัตถุการทบทวน
Jenova Academic Research Assistant
Academic Research Assistant คือคู่คิดด้านการวิจัยเชิงวิชาการสำหรับการค้นพบวรรณกรรม การเตรียมต้นฉบับ และการจัดการการอ้างอิง โดยทำงานบนแพลตฟอร์มที่มีประวัติแชตไม่จำกัดและหน่วยความจำถาวรข้ามเซสชัน กลยุทธ์การค้นหาและเกณฑ์คัดเข้าสามารถตรึงไว้ในคำสั่งของเอเจนต์แบบกำหนดเองได้ และสามารถแนบ PDF โปรโตคอล และล็อกการคัดกรองเป็นฐานความรู้ส่วนตัว เพื่อให้เซสชันถัดไปเริ่มจากชุดหลักฐานเดิม
ข้อจำกัดที่ควรยอมรับอย่างตรงไปตรงมาคือเป็นด้านตรงข้ามของ Elicit เครื่องมือนี้ไม่ได้มาพร้อมแผนภาพ PRISMA แบบเนทีฟ UI สำหรับการคัดกรองแบบทบทวนคู่ หรือคลัง systematic review เฉพาะทาง 138 ล้านบทความ ทีมที่ต้องการร่องรอยการตรวจสอบระดับ Cochrane ยังคงควรส่งออกการตัดสินใจไปยังเครื่องมือจัดการการทบทวน งานที่เกี่ยวข้องซึ่งต้องการรายงานแบบครั้งเดียวจบและอ้างอิงหนาแน่น สามารถมอบให้ Deep Research ซึ่งสังเคราะห์แหล่งข้อมูลหลายร้อยรายการพร้อมการอ้างอิงในเนื้อหา แล้วเก็บกลับไว้ในเธรดระยะยาวเดียวกัน เพื่อไม่ให้ผลการค้นพบกลายเป็นเอกสารกำพร้าอีกฉบับ
Consensus
Consensus คือเครื่องมือค้นหาเชิงวิชาการ AI ที่อาศัย บทความมากกว่า 250 ล้านฉบับ รวมถึงข้อความเต็มที่ได้รับอนุญาต รายงานว่ามีนักวิจัย นักศึกษา และบุคลากรทางคลินิก 10 ล้านคนใช้งาน พร้อมพันธมิตรห้องสมุดมหาวิทยาลัยมากกว่า 170 แห่ง Deep Search ขยายคำค้นและติดตามกราฟการอ้างอิง ขณะที่ Medical mode จำกัดขอบเขตลงเหลือแนวทางทางคลินิกราว 50,000 ฉบับ และบทความ 8 ล้านฉบับจากวารสารการแพทย์ชั้นนำ 1,000 แห่ง Consensus Meter แสดงภาพว่าหลักฐานสนับสนุนคำถามแบบใช่หรือไม่ใช่มากเพียงใด
การเปรียบเทียบของ Paperguide ในปี 2026 วางกรอบได้ถูกต้อง: Consensus ค้นหาและประเมินหลักฐาน ส่วน Gemini Notebook แปลงแหล่งข้อมูลที่คุณมีอยู่แล้ว Consensus มีข้อจำกัดในฐานะระบบหน่วยความจำ โดยไม่ได้จัดเก็บเกณฑ์คัดเข้าของคุณเป็นโปรโตคอลที่ดำเนินต่อเนื่องแบบเนทีฟ ดังนั้นโครงการที่ยาวนานหนึ่งภาคการศึกษายังคงต้องมีที่เก็บภายนอกสำหรับ “สิ่งที่เราตัดสินใจไว้ในเดือนมีนาคม”
Gemini Notebook
Gemini Notebook ซึ่งเป็นผลิตภัณฑ์ที่เคยเรียกว่า NotebookLM และ เปลี่ยนชื่อในเดือนกรกฎาคม 2026 คือคู่คิดที่ยึดโยงกับแหล่งข้อมูล คุณอัปโหลด PDF เว็บไซต์ วิดีโอ YouTube เสียง Google Docs และสไลด์ได้ คำตอบจะมาพร้อมการอ้างอิงที่แสดงคำพูดตรงตามต้นฉบับ ข้อมูลองค์กรจะไม่ถูกนำไปใช้ฝึกผลิตภัณฑ์
ขอบเขตของมันคือสมุดบันทึก เครื่องมือจะไม่ลืมแหล่งข้อมูลที่คุณมอบให้ ซึ่งเป็นเหตุผลที่มันทำงานได้ดีกับชุดการอ่านที่กำหนดชัด และจะไม่ค้นพบบทความที่คุณไม่เคยอัปโหลด สำหรับการทบทวนหลายเดือนที่ยังคงค้นหาอยู่ นี่คือข้อจำกัดเชิงโครงสร้าง ไม่ใช่ปัญหาการตั้งค่า
คุณจะเก็บกลยุทธ์การค้นหาและเกณฑ์คัดเข้าไว้ข้ามเซสชันได้อย่างไร?
คุณเก็บไว้ได้โดยเขียนสิ่งเหล่านั้นเป็นวัตถุที่คงทน เช่น เอกสารโปรโตคอล คำสั่งกำหนดเอง หรือการกำหนดค่าการคัดกรอง และปฏิเสธที่จะเก็บสำเนาเดียวไว้ในพรอมป์ต์ชั่วคราว หากกลยุทธ์มีอยู่แค่ในแชตเมื่อวาน ก็เท่ากับว่ามันไม่มีอยู่จริง
รูปแบบที่ใช้ได้จริงมีดังนี้:
- ตรึงคำถามในรูปแบบ PICO ประชากร การแทรกแซง การเปรียบเทียบ และผลลัพธ์ ควรคัดลอกตามข้อความเดิมลงในคำสั่งถาวรของผู้ช่วย ไม่ใช่ถอดความใหม่ทุกวันจันทร์
- บันทึกการค้นหาเป็นสิ่งประดิษฐ์ที่ทำซ้ำได้ ชื่อฐานข้อมูล สตริง Boolean ขีดจำกัดวันที่ ขีดจำกัดภาษา และแหล่งวรรณกรรมสีเทา ควรอยู่ในเอกสารที่ผู้ช่วยอ่านซ้ำได้
- แยกเกณฑ์คัดออกจากความรู้สึก เกณฑ์อย่าง “RCT, ผู้ใหญ่, 2015–2026, ฉบับเต็มภาษาอังกฤษ” ควรระบุเป็นกฎ ส่วนความชอบอย่าง “ดูเกี่ยวข้องกับทฤษฎีของเรา” ควรติดป้ายว่าเป็นสมมติฐาน เพื่อไม่ให้เปลี่ยนโปรโตคอลโดยเงียบ ๆ
- บันทึกการคัดออกพร้อมเหตุผล PRISMA คาดหวังการรายงานกระบวนการคัดเลือกอย่างโปร่งใส ภาพรวมวิธีวิจัยของ DistillerSR เน้นว่า PRISMA มีขึ้นเพื่อช่วยผู้เขียนหลีกเลี่ยงข้อผิดพลาดที่บั่นทอนการทบทวน
สำหรับ Jenova ขั้นตอนการตรึงโปรโตคอลคือบล็อกคำสั่งกำหนดเองร่วมกับไฟล์ PDF โปรโตคอลที่แนบไว้ พรอมป์ต์ถาวรที่อยู่รอดได้นานหลายเดือนมีลักษณะดังนี้:
คุณคือคู่คิดสำหรับ systematic review ของฉันในโครงการ HEP-24 ประชากร: ผู้ใหญ่อายุ 18 ปีขึ้นไปที่มี NAFLD การแทรกแซง: GLP-1 receptor agonists การเปรียบเทียบ: การดูแลมาตรฐานหรือยาหลอก ผลลัพธ์หลัก: MRI-PDFF และ NAS ให้คัดเข้า RCTs และ prospective cohorts ช่วงปี 2018–2026 ฉบับเต็มภาษาอังกฤษ คัดออกการศึกษาในสัตว์ บทคัดย่อการประชุมที่ไม่มีข้อมูล และการทดลองที่ใช้เวลาต่ำกว่า 8 สัปดาห์ จงทวนกฎการคัดเข้าทุกครั้งก่อนคัดกรองชุดใหม่ และห้ามขยายขอบเขตประชากรโดยเงียบ ๆ
สำหรับ Elicit สิ่งที่เทียบเท่ากันคือการปรับโปรโตคอลการทบทวนภายในผลิตภัณฑ์ จากนั้นใช้เกณฑ์การคัดกรองที่ระบบแนะนำอัตโนมัติ ซึ่งคุณสามารถยอมรับ แก้ไข หรือแทนที่ได้ ทุกการตัดสินใจอาจมีเหตุผลคัดออกและคำพูดสนับสนุน จึงใกล้เคียงกับแฟ้มตรวจสอบ PRISMA มากกว่าล็อกแชต
สำหรับ Gemini Notebook ให้วางบล็อก PICO เดียวกันลงในคำสั่งของสมุดบันทึก แล้วอัปโหลดโปรโตคอลพร้อมไฟล์ส่งออกการค้นหา ผู้ช่วยจะยึดมั่นกับไฟล์เหล่านั้นและจะไม่สร้างบทความนอกชุดขึ้นมาเอง
รูปแบบความล้มเหลวที่ต้องระวังคือ “การขยายขอบเขตด้วยความหวังดี” หลังผ่านไปหกสัปดาห์ โมเดลมักเริ่มรวมประชากรข้างเคียงเพียงเพราะฟังดูเกี่ยวข้อง โปรโตคอลที่ตรึงไว้และผู้ช่วยต้องทวนตอนเริ่มแต่ละเซสชัน คือกลไกควบคุมที่ถูกที่สุดที่คุณเพิ่มได้
หน่วยความจำถาวรเปลี่ยนการสกัดข้อมูลและการประเมินอคติอย่างไร?
หน่วยความจำถาวรเปลี่ยนการสกัดข้อมูลจากงานถอดข้อมูลแบบครั้งเดียว ให้เป็นชุดข้อมูลที่สะสมต่อเนื่อง ซึ่งเป็นจุดที่เวลาสูญเสียมากที่สุด และเป็นจุดที่ความช่วยเหลือของ AI สามารถทดสอบเชิงประจักษ์ได้แล้ว แผนภาพการทบทวนเจ็ดขั้นตอนชี้ว่าการสกัดข้อมูลคือคอขวด เพราะ PDF ต้นทางรายงานผลลัพธ์อย่างไม่สอดคล้องกัน ผู้ช่วยที่จำแบบฟอร์มการสกัดไม่ได้ จะนำความยุ่งเหยิงเดิมกลับเข้ามาทุกสัปดาห์
หลักฐานปี 2026 มีความแม่นยำกว่าคำกล่าวอ้างทางการตลาด การศึกษาแบบ study-within-a-review บน medRxiv เปรียบเทียบการสกัดข้อมูลโดยมี Elicit ช่วยกับการสกัดโดยมนุษย์ล้วนใน RCTs โรคเรื้อรัง 50 ฉบับ และพบ ว่าไม่มีความแตกต่างด้านความแม่นยำโดยรวม โดยมีความต่างเฉลี่ย 0.57 บนมาตราส่วน 0–100 ขณะที่การสกัดโดย AI ช่วย เร็วขึ้น 24.82 นาที และมีต้นทุนต่ำกว่ารวม $181.98 ใน 50 การศึกษา ประเภทและความรุนแรงของข้อผิดพลาดใกล้เคียงกัน รายงานการตรวจสอบของ Elicit ระบุว่า VDI/VDE สกัดข้อมูลถูกต้อง 1,502 จาก 1,511 จุดข้อมูล หรือ 99.4% และนักวิจัย CSIRO พบ ผลลบลวงใกล้ศูนย์ เมื่อเทียบกับการสกัดด้วยมือ
งานอีกสายหนึ่งมอง AI เป็นผู้ทบทวนคนที่สอง ไม่ใช่สิ่งทดแทน บทความจาก Cochrane Evidence Synthesis and Methods รายงานว่าเครื่องมือ AI มีประสิทธิภาพสูงและใกล้เคียงกับผู้ทบทวนมนุษย์ในการสกัดข้อมูล โดยเฉพาะตัวแปรมาตรฐาน บันทึกด้านวิธีวิจัยของ Birmingham City University ระมัดระวังกว่า โดยระบุว่าเครื่องมือ generative ทำได้ดีสำหรับปี ประเทศ และจำนวนผู้เข้าร่วม ซึ่งไม่ใช่เรื่องเดียวกับการสกัดผลลัพธ์ที่ละเอียดอ่อนในแต่ละแขนการทดลอง
สิ่งที่หน่วยความจำเพิ่มเข้ามา นอกเหนือจากความแม่นยำในการสกัดดิบ คือความสม่ำเสมอของ แบบฟอร์ม:
- ใช้ชื่อผลลัพธ์ จุดเวลา และหน่วยวัดเดิมในสัปดาห์ที่ 12 เช่นเดียวกับสัปดาห์ที่ 2
- ความคลาดเคลื่อนที่เคยติดธงไว้แล้ว เช่น “มีขนาดตัวอย่างสองค่าในบทความเดียวกัน” จะไม่ถูกค้นพบซ้ำราวกับเป็นเรื่องใหม่
- การประเมินอคติสามารถให้เหตุผลจากการออกแบบการศึกษา ไม่ใช่เพียงคะแนน งานประเมินความเสี่ยงอคติเกี่ยวกับการที่การสุ่ม การปกปิด และข้อมูลสูญหายอาจบิดเบือนผลลัพธ์อย่างไร ซึ่งต้องอาศัยการจดจำบันทึกการออกแบบ ไม่ใช่เพียงบทคัดย่อ
ข้อจำกัดของ Jenova ในจุดนี้อยู่ที่อินเทอร์เฟซ ไม่ใช่เจตนา หน่วยความจำถาวรจะระลึกได้ว่าคุณมองการปกปิดการจัดสรรเป็นโดเมนสำคัญ แต่จะไม่กรอกตาราง Cochrane RoB 2 ให้อัตโนมัติ ข้อจำกัดของ Elicit เป็นด้านตรงข้าม: การสกัดข้อมูลอาจมีโครงสร้างสูงและมีคำพูดรองรับ ขณะที่เหตุผลเรื่องอคติแบบไม่เป็นทางการซึ่งเกิดขึ้นในการประชุมกับอาจารย์ที่ปรึกษา ยังต้องมีที่จัดเก็บให้คงอยู่ ทีมที่ทำทั้งสองงานควรสกัดในเครื่องมือที่มีโครงสร้าง และเก็บคำอธิบายระดับการออกแบบไว้ในเอเจนต์วิจัยระยะยาว
คุณจะตั้งค่าเวิร์กโฟลว์การวิจัยด้วย AI ที่อยู่ได้นานหลายเดือนได้อย่างไร?
คุณตั้งค่าได้โดยสร้างบ้านหลักของโครงการที่คงทนเพียงแห่งเดียว โหลดโปรโตคอลก่อนการค้นหาครั้งแรก และดำเนินทุกเซสชันหลังจากนั้นเป็นการอัปเดตบ้านหลังเดิม แทนการเริ่มแชตใหม่ เวิร์กโฟลว์ใช้แนวคิดเดียวกันไม่ว่าคุณจะใช้เอเจนต์ที่มีหน่วยความจำเป็นแกนหลัก หรือพื้นที่ทำงาน systematic review สิ่งที่ต่างกันมีเพียงปุ่มที่กด
การตั้งค่า Jenova (ใช้เวลาไม่เกินสองนาที แล้วดำเนินต่อเนื่อง)
- เปิด Academic Research Assistant และหากโครงการมีระยะยาว ให้บันทึกโปรโตคอลเป็นคำสั่งกำหนดเองบนเอเจนต์เฉพาะ
- แนบโปรโตคอล สตริงการค้นหา และสเปรดชีตการคัดกรองที่มีอยู่เป็นฐานความรู้
- เริ่มด้วยสรุปสถานะ ไม่ใช่คำว่า “ทำต่อ” ที่คลุมเครือ:
ทวน PICO ของเรา ฐานข้อมูลที่ค้นหา วันที่ค้นหาล่าสุด จำนวนที่คัดเข้า/คัดออก และข้อขัดแย้งที่ยังไม่คลี่คลายสามข้อจากเซสชันก่อน จากนั้นคัดกรองชื่อเรื่อง 25 รายการถัดไปตามเกณฑ์ที่ตรึงไว้ ห้ามขยายเกณฑ์คัดเข้า
- จบทุกเซสชันด้วยการส่งต่องานเป็นลายลักษณ์อักษรที่เซสชันถัดไปโหลดได้ ได้แก่ การอัปเดตการค้นหา รายการคัดออกใหม่พร้อมเหตุผล ช่องข้อมูลสกัดที่ยังขาด และคำถามสำหรับผู้ทบทวนคนที่สอง
แผน Jenova แบบชำระเงินเริ่มต้นที่ $20/เดือน สำหรับสิทธิ์ใช้งาน 30× ของระดับฟรี โดยมีระดับสูงกว่าที่ $50, $100, $200, $500 และ $1,000 ต่อเดือน สิทธิ์ใช้งานจะรีเซ็ตรายเดือนในวันเรียกเก็บเงิน ราคานี้สำคัญสำหรับงานหลายเดือน เพราะการทบทวนที่ตายลงเมื่อชนเพดานระดับฟรีระหว่างคัดกรอง ก็เป็นความล้มเหลวด้านหน่วยความจำอีกประเภทหนึ่ง
การตั้งค่า Elicit
กระบวนการ systematic review ของ Elicit คือ ปรับโปรโตคอล รวมการค้นหาจาก PubMed, ClinicalTrials.gov และคลังบทความของระบบ หรือการนำเข้าจากฐานข้อมูลอื่น คัดกรองด้วยการทบทวนคู่ที่มี AI ช่วย สกัดด้วยช่องข้อมูลที่มีคำพูดรองรับ แล้วสังเคราะห์รายงานที่อาจมี แผนภาพการไหล PRISMA ตารางสรุปบทความ และกลยุทธ์การค้นหา การทบทวนแบบมีชีวิตคือฟีเจอร์สำหรับงานหลายเดือน: รวมการทบทวนเข้ากับการแจ้งเตือน เพื่อให้โปรโตคอลเดิมรับบทความใหม่ได้โดยไม่ต้องสร้างโครงการใหม่
การตั้งค่า Gemini Notebook
สร้างสมุดบันทึกหนึ่งเล่มต่อการทบทวน อัปโหลดโปรโตคอล ไฟล์ส่งออกการค้นหา และ PDF ถามเฉพาะคำถามที่ควรตอบได้จากไฟล์เหล่านั้น เมื่อบทความใหม่ผ่านการคัดกรอง ให้เพิ่มเข้าไปในสมุดบันทึกเดิม แทนการเริ่มเล่มที่สอง เพราะสมุดบันทึกที่แยกออกจากกันคือวิธีที่เครื่องมือยึดโยงแหล่งข้อมูล “ลืม”
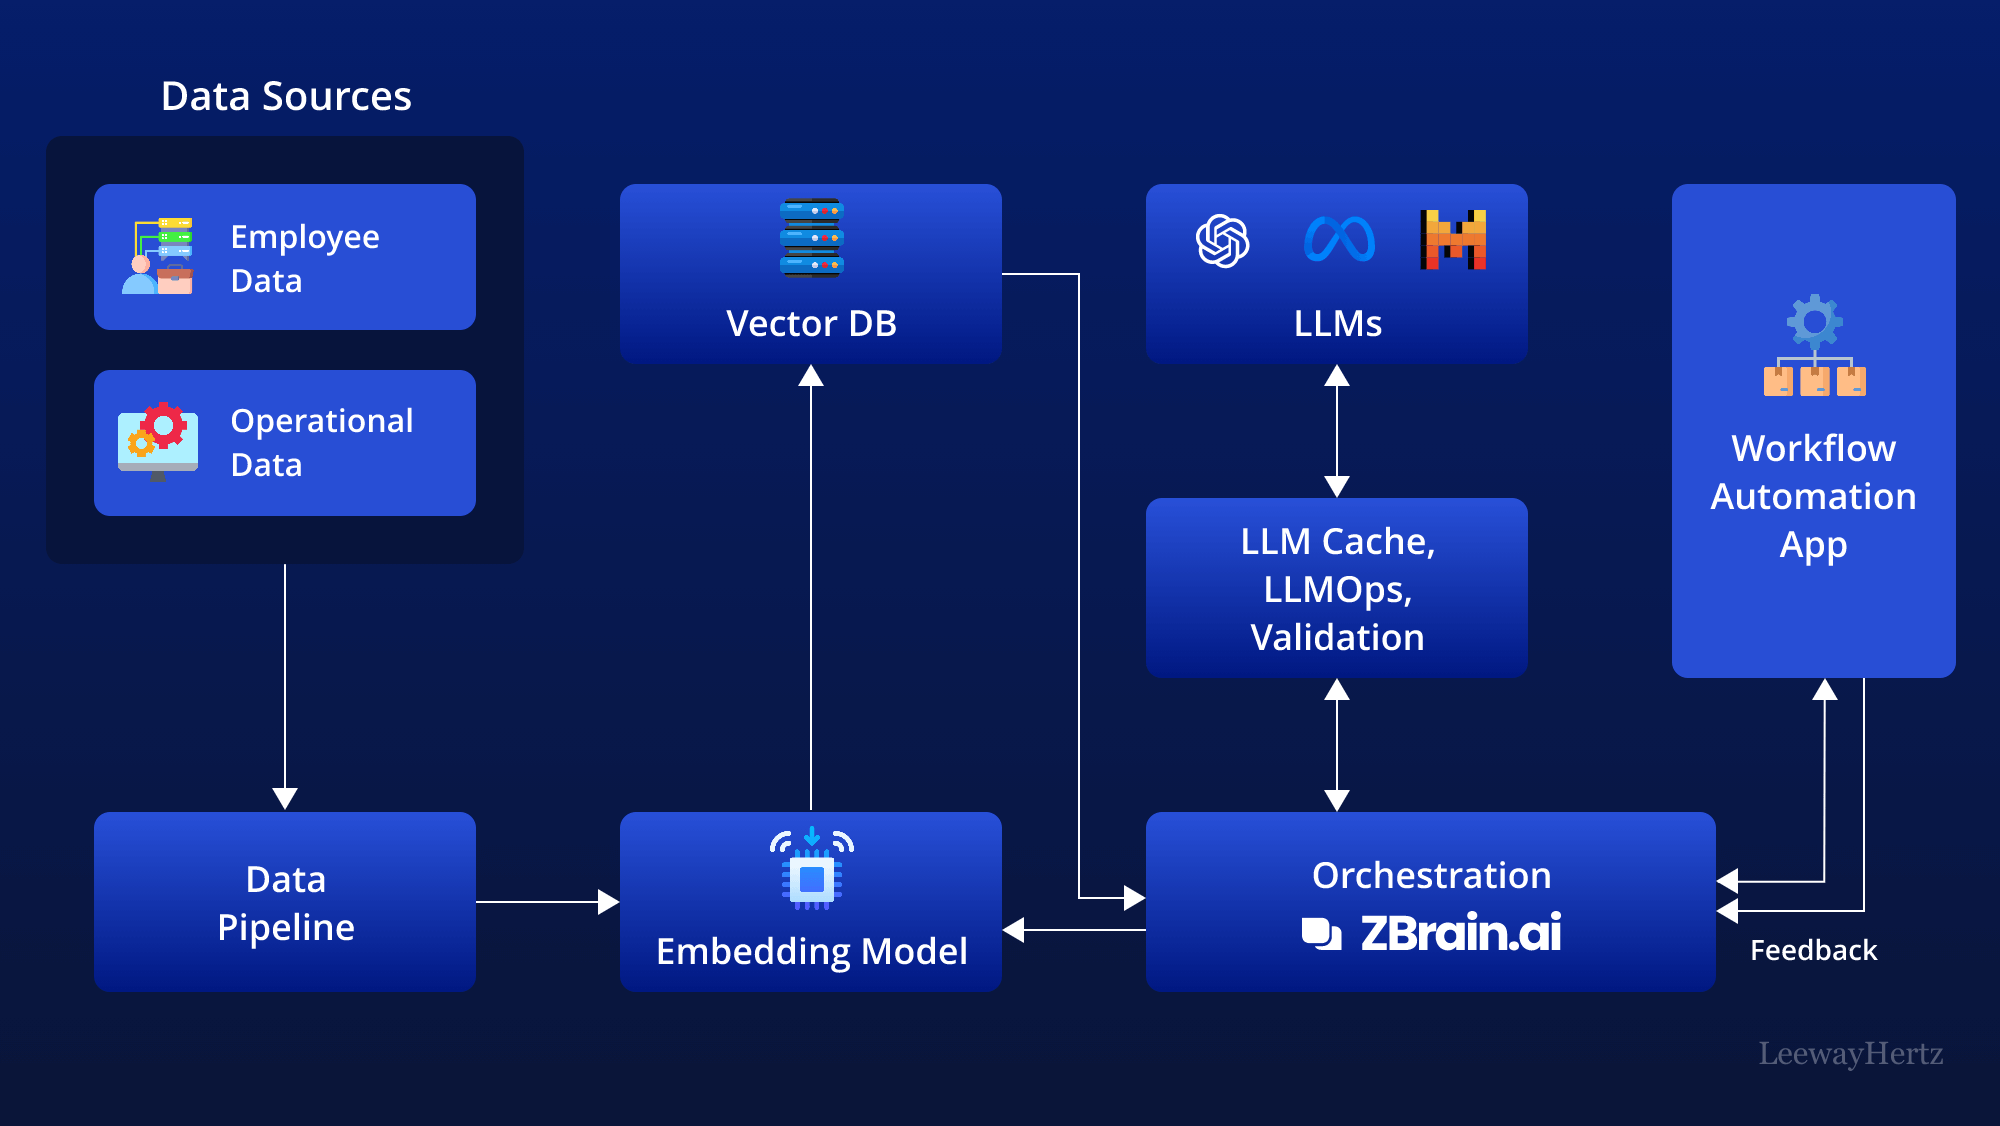
แผนภาพสถาปัตยกรรมคือเวอร์ชันอุตสาหกรรมของแนวคิดเดียวกัน หน่วยความจำการวิจัยที่คงทนคือไปป์ไลน์: แหล่งข้อมูลผ่านการนำเข้า embeddings ที่เก็บเวกเตอร์ การประสานงาน การเรียกใช้โมเดล การตรวจสอบ และวงจรป้อนกลับ นักวิจัยไม่จำเป็นต้องประกอบสแตกนี้เอง แต่จำเป็นต้องมีผลิตภัณฑ์ที่นำไปใช้จริง แชตในเซสชันเป็นเพียงกล่องสุดท้าย หากผลการค้นพบไม่เคยเข้าสู่หน่วยความจำ ฐานความรู้ หรือพื้นที่ทำงานการทบทวน ไปป์ไลน์จะไม่มีสถานะ และเมื่อถึงเดือนที่สี่ คุณจะต้องอธิบายสิ่งที่ทำในเดือนแรกซ้ำอีกครั้ง
นักระเบียบวิธีวิจัยกล่าวอย่างไรเกี่ยวกับหน่วยความจำ AI ในการสังเคราะห์หลักฐาน?
นักระเบียบวิธีมอง AI เป็นผู้ทบทวนที่ช่วยประหยัดแรงงานแต่มีปัญหาด้านการตรวจสอบ ไม่ใช่สิ่งทดแทนโปรโตคอลที่สร้างย้อนหลังได้ คำถามจากผู้เชี่ยวชาญที่มีประโยชน์ไม่ใช่ “โมเดลสกัดขนาดตัวอย่างได้หรือไม่” แต่คือ “มนุษย์อีกคนเห็นได้หรือไม่ว่าเหตุใดบทความนี้จึงถูกคัดออกในเดือนกุมภาพันธ์ และยังเห็นพ้องในเดือนตุลาคมหรือไม่”
“การทบทวนที่พังในเดือนที่หกแทบไม่เคยล้มเหลวเพราะโมเดลพลาดคำพ้องความหมาย แต่ล้มเหลวเพราะกฎคัดเข้าไม่เคยถูกเก็บเป็นวัตถุ ทีมพิมพ์นิยามประชากรที่ต่างกันเล็กน้อยในแต่ละเซสชัน แล้วสงสัยว่าทำไมตารางหลักฐานจึงไม่คงที่ หน่วยความจำถาวรไม่ใช่ฟีเจอร์เพื่อความสะดวกในบริบทนั้น มันคือหนทางเดียวที่ทำให้โปรโตคอลและผลการค้นพบอยู่บนเส้นเวลาเดียวกัน”
“เรายังเห็นทีมที่ไว้วางใจการสกัดข้อมูลแบบมีโครงสร้างมากเกินไป แต่ลงทุนกับบันทึกการตัดสินใจน้อยเกินไป ช่องข้อมูลที่มีคำพูดอ้างอิงรองรับเป็นสิ่งจำเป็น และการศึกษาการสกัดข้อมูลปี 2026 ก็ให้สัญญาณที่ดีเกี่ยวกับความแม่นยำเทียบกับเวลา แต่สิ่งเหล่านั้นไม่ได้บันทึกว่าเหตุใดจึงเก็บการทดลองที่อยู่ก้ำกึ่งไว้ หาก AI ของคุณดึงเหตุผลนั้นกลับมาไม่ได้ คุณไม่ได้มีการทบทวนแบบมีชีวิต คุณมีแชตหลายชุดที่เกี่ยวข้องกันเท่านั้น”
“การออกแบบเชิงปฏิบัติที่เราแนะนำเป็นเรื่องเรียบง่าย: ตรึงโปรโตคอลในคำสั่ง สะสมผลการค้นพบในหน่วยความจำหรือพื้นที่ทำงาน ยึดคำตอบกับชุดเอกสารที่ชี้ได้ และส่งออกบันทึกตรวจสอบที่รายการ PRISMA ใช้ได้ เลือกเครื่องมือสำหรับงานสี่อย่างนี้ อย่าเลือกเครื่องมือเพียงเพราะบ่ายวันแรกที่ใช้รู้สึกลื่นไหล”
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเวิร์กโฟลว์การวิจัยระยะยาว
จุดยืนนี้สอดคล้องกับโลกการรายงานที่การทบทวนต้องเข้าสู่ บทความอธิบายและขยายความ PRISMA 2020 บน PMC ระบุชัดเจนว่าแนวทางนี้ใช้สำหรับการทบทวนที่ มีการสังเคราะห์ และ EQUATOR Network เผยแพร่ แนวทางการรายงานฉบับปรับปรุง เดียวกัน ผู้ช่วยที่จำวิธีวิจัยไม่ได้ ย่อมไม่สามารถช่วยคุณรายงานวิธีวิจัยได้
จะเกิดอะไรขึ้นกับความสามารถในการทำซ้ำได้ เมื่อผู้ช่วย AI จำการคัดออกของเดือนที่แล้วไม่ได้?
ความสามารถในการทำซ้ำได้จะเหลือเพียงภาพลวงตา คุณยังสร้างส่วนงานที่เกี่ยวข้องซึ่งเขียนลื่นไหลได้ แต่ไม่อาจปกป้องชุดการศึกษาที่เลือกไว้ โครงการหลายเดือนก่อให้เกิดการตัดสินใจคัดเข้า/คัดออกนับร้อยครั้ง หากเรียกคืนการตัดสินใจเหล่านั้นไม่ได้ ผู้คัดกรองคนใหม่ อาจารย์ที่ปรึกษา หรือผู้ประเมินวารสาร จะไม่สามารถบอกได้ว่าการคัดออกขับเคลื่อนโดยโปรโตคอลหรืออารมณ์ของเซสชันนั้น
systematic review แบบมีชีวิตทำให้ความล้มเหลวนี้เห็นได้ชัด Elicit อธิบายว่าการทบทวนแบบมีชีวิตคือการรวมการทบทวนที่เสร็จแล้วเข้ากับการแจ้งเตือน เพื่อให้ดูดซับข้อมูลใหม่ได้ ทุกปี หรือตามความจำเป็น และอนุญาตให้แชร์ลิงก์ไปยังกระบวนการทั้งหมดและผลลัพธ์ระหว่างทาง สิ่งนี้ทำงานได้ก็ต่อเมื่อการคัดออกของไตรมาสก่อนเป็นส่วนหนึ่งของวัตถุที่กำลังอัปเดต แชตบอตที่ “จำหัวข้อได้” แต่จำบันทึกการคัดออกไม่ได้ จะคัดบทความที่เคยปฏิเสธแล้วกลับเข้า หรือคัดบทความที่เคยสกัดแล้วออกซ้ำ
การตรวจสอบความสามารถในการทำซ้ำได้สามแบบเผยให้เห็นช่องว่างอย่างรวดเร็ว:
- การทดสอบย้อนเล่น หลังห่างหายไปหนึ่งสัปดาห์ ให้ผู้ช่วยแสดงรายการการคัดออก 20 รายการล่าสุดพร้อมเหตุผล หากระบบสร้างเหตุผลขึ้นเองหรือปะปนโครงการ แสดงว่าขาดชั้นการตรวจสอบ
- การทดสอบการขยายขอบเขต ให้บทคัดย่อที่อยู่นอกขอบเขตแต่ชวนให้รวมไว้ตามหัวข้อ หากผู้ช่วยโต้แย้งให้คัดเข้าโดยไม่อ้างเกณฑ์ที่ตรึงไว้ ความคงอยู่ของโปรโตคอลล้มเหลวแล้ว
- การทดสอบการส่งต่องาน เพื่อนร่วมงานควรทำงานต่อจากสรุปสถานะล่าสุดของผู้ช่วยได้โดยไม่ต้องรับคำอธิบายด้วยวาจา หากทำไม่ได้ หน่วยความจำนั้นเป็นเรื่องส่วนบุคคล ไม่ใช่เรื่องวิทยาศาสตร์
Jenova ผ่านการทดสอบย้อนเล่นและการส่งต่องานได้ เมื่อมีการใช้คำสั่ง ฐานความรู้ และหน่วยความจำเซสชันจริง อย่างไรก็ตาม ยังคงต้องให้คุณส่งออกล็อกในรูปแบบ PRISMA หากวารสารต้องการแผนภาพการไหล Elicit รองรับการทดสอบด้านการตรวจสอบได้แบบเนทีฟกว่า และยังต้องให้คุณเก็บวิจารณญาณทางวิทยาศาสตร์ที่ไม่เป็นทางการไว้ที่อื่น Consensus และ Gemini Notebook เมื่อใช้เพียงลำพัง จะไม่ผ่านการทดสอบคนละแบบ: Consensus จะย้อนเล่นการคัดออก ของคุณ ไม่ได้ และ Gemini Notebook จะย้อนเล่นบทความที่ไม่เคยถูกอัปโหลดไม่ได้
ดังนั้น ปัญหาการวิจัยหลายเดือนไม่ใช่ “โมเดลใดฉลาดที่สุดในปี 2026” แต่เป็นว่ากลยุทธ์การค้นหา เกณฑ์คัดเข้า และผลการค้นพบก่อนหน้า ถูกเก็บไว้ในสแตกที่ยังมีอยู่เมื่อคุณกลับมาหรือไม่ เลือกเครื่องมือที่รักษาวัตถุทั้งสามนี้ไว้ แล้วให้ผู้ช่วยทวนสิ่งเหล่านั้นตอนเริ่มทุกเซสชัน เพื่อให้การเบี่ยงเบนต้องเกิดขึ้นอย่างเปิดเผย
เอกสารอ้างอิง
- PRISMA 2020 statement — รายการตรวจสอบ แผนภาพการไหล และแนวทางการรายงานสำหรับ systematic review
- PRISMA statement — ภาพรวมของแนวทางการรายงานหลักสำหรับ systematic review
- The BMJ — PRISMA 2020 statement: แนวทางฉบับปรับปรุงสำหรับการรายงาน systematic review
- Hofstra University LibGuides — รายการตรวจสอบ PRISMA 27 รายการสำหรับ systematic review และ meta-analysis
- ScienceDirect — เครื่องมือ AI สำหรับ systematic literature review และ meta-analysis รวมถึงการทำแผนที่เครื่องมือ ML 63 รายการ
- King's College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- Elicit — systematic literature review: การคัดกรอง การสกัดข้อมูล การตรวจสอบ PRISMA การทบทวนแบบมีชีวิต และผลการตรวจสอบความถูกต้อง
- Elicit — ภาพรวมผลิตภัณฑ์และราคา รวมถึงขนาดคลังเอกสารและฐานผู้วิจัย
- Consensus — เครื่องมือค้นหาเชิงวิชาการ AI ขนาดคลังเอกสาร Deep Search และ Medical mode
- Paperguide — Consensus เทียบกับ NotebookLM: การค้นพบหลักฐานเทียบกับการแปลงแหล่งข้อมูล (2026)
- Gemini Notebook หรือ NotebookLM เดิม — สมุดบันทึกที่ยึดโยงกับแหล่งข้อมูล การอ้างอิงระดับคำพูด และนโยบายการใช้ข้อมูล
- DistillerSR — แนวทาง PRISMA และข้อผิดพลาดที่บั่นทอน systematic review
- medRxiv — ความแม่นยำและประสิทธิภาพของการสกัดข้อมูลโดย AI ที่ใช้ Elicit เทียบกับการสกัดโดยมนุษย์ล้วน (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — เครื่องมือ AI ในฐานะผู้ทบทวนคนที่สองสำหรับการสกัดข้อมูล
- Birmingham City University — ประสิทธิภาพของ generative AI ในการสกัดข้อมูลสำหรับการทบทวนวรรณกรรม
- PubMed Central — คำอธิบายและการขยายความ PRISMA 2020
- EQUATOR Network — ระเบียนแนวทางการรายงาน PRISMA 2020