ฉันจะป้องกันไม่ให้ผู้ช่วยวิจัย AI สร้างการอ้างอิงปลอมได้อย่างไร?
2026-08-21
กลไกป้องกันใดที่แยกเครื่องมือวิจัย AI ที่ยึดโยงกับการอ้างอิง ออกจากแชตบอตที่หลอนข้อมูล?
วิธีที่น่าเชื่อถือที่สุดในการหยุดผู้ช่วยวิจัย AI ไม่ให้สร้างบทความปลอม คือปฏิเสธเครื่องมือที่สร้างรายการอ้างอิงจากความจำ บังคับให้ทุกข้ออ้างเชื่อมโยงกับระเบียนที่ค้นคืนมาและมีตัวระบุที่ตรวจสอบได้ด้วยเครื่อง และตรวจสอบการอ้างอิงทุกแห่งกับแหล่งต้นฉบับก่อนนำเข้าสู่ต้นฉบับบทความ ในปี 2026 ชุดกลไกนี้ — การค้นคืนที่ยึดโยงกับหลักฐาน การตรวจสอบตัวระบุ และการยืนยันโดยมนุษย์ — คือสิ่งที่แยกเครื่องมือวรรณกรรม เช่น Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus และ Scite ออกจากแชตบอตใช้งานทั่วไปที่ยังคงสร้างรายการอ้างอิงหน้าตาสมจริงแต่เป็นของปลอม
ปัจจัยสำคัญที่ช่วยลดแหล่งข้อมูลที่ถูกสร้างขึ้นจริง:
✅ ค้นคืนแทนการระลึกจากความจำ — ผู้ช่วยต้องค้นหาระเบียนวิชาการที่จัดทำดัชนีไว้ ไม่ใช่เติมบรรณานุกรมอัตโนมัติจากข้อมูลฝึกสอน ✅ การผูกกับตัวระบุ — งานทุกชิ้นที่อ้างควรมี DOI, PMID, arXiv ID หรือ URL ของสำนักพิมพ์ที่เข้าถึงและตรวจสอบได้อย่างอิสระ ✅ ความสอดคล้องกับหลักฐาน ไม่ใช่แค่การมีอยู่จริง — บทความจริงที่ถูกอ้างเพื่อสนับสนุนข้อค้นพบซึ่งไม่มีอยู่ในบทความนั้น ก็ยังเป็นความล้มเหลว ดังที่ งานวิจัยการประเมิน RAG แสดงให้เห็น ✅ ความแม่นยำทางบรรณานุกรม — ชื่อผู้เขียน ปี เล่ม และช่วงหน้าต้องตรงกับระเบียน ไม่ใช่รายการที่คล้ายเคียงซึ่งโมเดลแต่งขึ้น ✅ วงจรการยืนยันโดยมนุษย์ — Stanford Libraries และคู่มือรูปแบบการอ้างอิงรายใหญ่ระบุว่าผู้เขียน ไม่ใช่เครื่องมือ ต้องรับผิดชอบต่อการอ้างอิงทุกแห่ง
เพื่อเปรียบเทียบเครื่องมืออย่างมีประโยชน์ ควรมองความครบถ้วนของการอ้างอิงเป็นปัญหาด้านสถาปัตยกรรมระบบ มากกว่าจะเป็นเทคนิคการเขียนพรอมต์ เนื้อหาที่เหลือของคู่มือนี้จะอธิบายสถาปัตยกรรมดังกล่าว รูปแบบความล้มเหลวที่ออกแบบมาเพื่อดักจับ และเวิร์กโฟลว์ที่คุณใช้ได้กับผู้ช่วยทุกตัว
เหตุใดการอ้างอิง AI ที่แต่งขึ้นจึงปรากฏในบทความที่ตีพิมพ์ในปี 2026?
การอ้างอิงที่แต่งขึ้นไม่ใช่เพียงเกร็ดเล่าในห้องเรียนอีกต่อไป มันกำลังเข้าสู่วารสาร เอกสารขอทุน และดัชนีการอ้างอิง เพราะนักวิจัยคัดลอกบรรณานุกรมจากแชตบอตใส่ต้นฉบับโดยไม่ตรวจสอบรายการอ้างอิงแต่ละรายการ บทวิเคราะห์ของ Nature ในปี 2026 ประเมินว่าสิ่งพิมพ์ปี 2025 หลายหมื่นชิ้นอาจมีรายการอ้างอิงที่ AI สร้างขึ้นและไม่ถูกต้อง
รูปแบบการปนเปื้อนนี้มีลักษณะเฉพาะ Guillaume Cabanac นักวิทยาการคอมพิวเตอร์ได้รับแจ้งว่าบทความชิ้นหนึ่งของเขาถูกอ้างใน International Dental Journal — สาขาที่ไม่เกี่ยวข้องกับงานของเขาเรื่องการตรวจจับบทความที่แต่งขึ้น — และพบว่าเขาจำรายการอ้างอิงของตนเองไม่ได้ นี่คือวิธีที่การอ้างอิงผีแพร่กระจาย: มันมีรูปแบบเหมือนจริง ตั้งชื่อวารสารที่ฟังดูมีอยู่จริง และผ่านการตรวจแบบกวาดตา
กรณีที่มีการบันทึกไว้นั้นรุนแรงพอจะบังคับให้มีการถอนบทความ Resnik และ Hosseini สรุปบทความใน Academic Ethics ที่มีการอ้างอิงหลอน 19 รายการจาก 29 รายการ บทความ PLOS ONE ที่ต่อมาถูกถอนโดยพบว่ามีการอ้างอิงที่แต่งขึ้น 18 รายการจาก 76 รายการ และบทความมุมมองใน Digestive Diseases and Sciences ที่รายการอ้างอิง 12 จาก 14 รายการไม่มีอยู่จริง งานศึกษาสุขภาพจิตในปี 2025 เกี่ยวกับการอ้างอิงจาก GPT-4o พบว่า 56% มีข้อผิดพลาด โดยประมาณหนึ่งในห้าเป็นการหลอนข้อมูลโดยสมบูรณ์
ความกังวลของคณาจารย์ปัจจุบันอยู่ในระดับเกือบเป็นสากล งานวิจัยของ College Board รายงานว่าผู้สอนกังวลว่าการใช้ AI กำลังบั่นทอนการคิดเชิงวิพากษ์ การเขียนต้นฉบับ และความซื่อสัตย์ทางวิชาการ คู่มือห้องสมุด เช่น ของ UNC Charlotte จึงมองการอ้างอิงหลอนเป็นความเสี่ยงมาตรฐานในการวิจัย ไม่ใช่กรณีชายขอบ
นัยต่อการเลือกเครื่องมือจึงชัดเจน หากผู้ช่วยสามารถสร้างรายการอ้างอิงแบบ APA หรือ Vancouver ที่ดูดีโดยไม่ค้นคืนระเบียนจริงได้ ก็สามารถแต่งบทความที่ไม่เคยมีอยู่จริงได้ — และบทความนั้นอาจหลุดรอดไปถึงสิ่งพิมพ์
คุณควรประเมินอะไรบ้างก่อนมอบรายการอ้างอิงของคุณให้ผู้ช่วยวิจัย AI?
คุณควรประเมินผู้ช่วยวิจัย AI ผ่าน Citation Integrity Stack ห้าองค์ประกอบ ได้แก่ แหล่งความจริง การผูกกับตัวระบุ ความสอดคล้องระหว่างข้ออ้างกับข้อความต้นทาง ความแม่นยำทางบรรณานุกรม และวงจรการยืนยันโดยมนุษย์แบบบังคับ เครื่องมือที่ทำคะแนนด้านความลื่นไหลของภาษาดีแต่ทำคะแนนในชุดเกณฑ์นี้ต่ำ ไม่ปลอดภัยสำหรับรายการอ้างอิง ไม่ว่าข้อความจะดูประณีตเพียงใด
1. แหล่งความจริง
ถามว่าคำตอบมาจากคลังข้อมูลที่ค้นคืนหรือจากความจำเชิงพารามิเตอร์ ระบบแบบ retrieval-augmented ค้นหา Google Scholar, PubMed, Semantic Scholar, Scopus หรือ arXiv แล้วจึงสร้างคำตอบ แชตบอตที่ไม่มีการค้นคืนจะคาดการณ์โทเคนถัดไปของการอ้างอิง ตัวชี้วัดความสอดคล้องกับหลักฐาน มีขึ้นโดยเฉพาะ เพราะการสร้างคำตอบอาจคลาดจากบริบทที่ค้นคืนแม้จะมีการค้นคืนเกิดขึ้นแล้ว
2. การผูกกับตัวระบุ
ชุดข้อมูลชื่อเรื่อง-ผู้เขียน-ปีไม่เพียงพอ กำหนดให้ต้องมี DOI, PMID, PMCID หรือ URL ของสำนักพิมพ์ แล้วตรวจสอบด้วยตนเอง การอ้างอิงผีมักไม่ผ่านการทดสอบนี้ทันที ส่วนรายการบรรณานุกรมที่คลาดเคลื่อนเล็กน้อย — บทความจริงแต่ระบุเล่มหรือช่วงหน้าผิด — จะไม่ผ่านเมื่อพิจารณาอย่างละเอียดอีกครั้ง
3. ความสอดคล้องระหว่างข้ออ้างกับข้อความต้นทาง
งานวิจัย ACM เกี่ยวกับการอ้างอิง RAG พบว่าความถูกต้องไม่เท่ากับความสอดคล้องกับหลักฐาน: การอ้างอิงมากถึง 57% อาจไม่สนับสนุนข้ออ้างที่ตนควรเป็นหลักฐานให้ บทความที่มีอยู่จริงแต่ไม่มีข้อค้นพบที่กล่าวอ้างนั้นอันตรายไม่ต่างจากบทความที่ไม่มีอยู่จริง เพราะมันฟอกผลลัพธ์เท็จผ่านชื่อผู้เขียนจริง
4. ความแม่นยำทางบรรณานุกรม
ลำดับผู้เขียน ปี วารสาร เล่ม ฉบับ และหน้าต้องตรงกับระเบียน การทดสอบเครื่องมือ RAG ในสาขาบริหารธุรกิจแสดงให้เห็นว่ารายการ “ผี” ที่แต่งขึ้นทั้งหมดอาจพบไม่บ่อย แต่ข้อผิดพลาดบรรณานุกรมขนาดเล็กยังพบได้ทั่วไป ข้อผิดพลาดเหล่านี้ยังทำให้ดัชนีการอ้างอิงเสียหาย และอาจซ่อนการสลับบทความผิดรายการได้
5. วงจรการยืนยันโดยมนุษย์
นโยบายวารสาร APA ตามที่ Stanford สรุป ระบุว่าผู้เขียนต้องตรวจสอบข้อมูลและการอ้างอิงทุกอย่างที่เครื่องมือ AI ให้มา แนวทางสำหรับนักวิจัยของ Wiley และ แนวทางความซื่อสัตย์ในการวิจัยของ Harvard ก็ระบุเช่นกันว่าผู้เขียนมนุษย์เป็นผู้รับผิดชอบการเปิดเผยการใช้เครื่องมือและความถูกต้อง ไม่มีผู้ช่วยประเภทนี้ตัวใดลบภาระหน้าที่ดังกล่าวได้
ให้น้ำหนักองค์ประกอบตามลักษณะงาน การทบทวนอย่างเป็นระบบควรให้น้ำหนักมากกับความสอดคล้องกับหลักฐานและการผูกกับตัวระบุ การสำรวจเบื้องต้นอาจยอมรับการค้นพบที่กว้างขึ้นได้ หากรายการที่คัดเลือกทุกชิ้นผ่านการตรวจสอบก่อนนำไปอ้าง อย่าให้น้ำหนักคุณภาพของร้อยแก้วมากเกินไป ย่อหน้าที่ลื่นไหลคือกลไกที่ทำให้การอ้างอิงปลอมดูน่าเชื่อ
เครื่องมือวิจัย AI ยอดนิยมแตกต่างกันอย่างไรในด้านความน่าเชื่อถือของการอ้างอิง?
เครื่องมือเหล่านี้แตกต่างกันอย่างชัดเจนว่า รายการอ้างอิงถูกค้นคืนจากดัชนีวิชาการหรือสร้างจากความจำของโมเดล และตัวเลือกการออกแบบเพียงอย่างเดียวนี้ทำนายความเสี่ยงของการอ้างอิงผีได้เป็นส่วนใหญ่ แชตบอตใช้งานทั่วไปยังคงเป็นตัวเลือกที่มีความเสี่ยงสูงสุดสำหรับบรรณานุกรม ผู้ช่วยวิจัยที่สร้างขึ้นโดยเฉพาะช่วยลดรายการอ้างอิงผี แต่ยังอาจอ้างข้อความผิด จัดเก็บเมทาดาทาผิด หรือกล่าวเกินกว่าที่บทความแสดงได้
ณ ปี 2026 การเปรียบเทียบเชิงปฏิบัติมีลักษณะดังนี้:
| ฟีเจอร์ / มิติ | แชตบอตทั่วไป (เช่น ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| แหล่งหลักฐาน | ส่วนใหญ่เป็นความจำเชิงพารามิเตอร์ เว้นแต่เปิดการท่องเว็บ | บทความที่ค้นคืนและตารางสกัดข้อมูล | การค้นคืนจากหลายฐานข้อมูล (Google Scholar, PubMed, arXiv) | บทความที่ค้นคืนสำหรับคำถามเชิงประจักษ์ | ดัชนีการอ้างอิงพร้อมบริบทสนับสนุน/ขัดแย้ง | การค้นคว้าวรรณกรรมแบบเรียลไทม์ผ่านฐานข้อมูลวิชาการและคลังเอกสาร |
| ความเสี่ยงรายการอ้างอิงผี | สูง; มีบันทึกในวารสารและห้องปฏิบัติการ | ต่ำในการศึกษา RAG เกี่ยวกับรายการอ้างอิง | ต่ำในการศึกษา RAG เกี่ยวกับรายการอ้างอิง | ใช้การค้นคืน; ยังต้องตรวจสอบ | ต่ำสำหรับรายการในกราฟการอ้างอิง | ใช้การค้นคืน; ยังคงต้องตรวจสอบ DOI อย่างอิสระ |
| ความสอดคล้องระหว่างข้ออ้างกับแหล่งข้อมูล | อ่อนแอหากไม่มีข้อความที่ค้นคืน | แข็งแกร่งกว่าสำหรับการสกัดแบบมีโครงสร้าง | แข็งแกร่งขึ้นเมื่อคำตอบอ้างบทความที่ค้นคืน | แข็งแกร่งกว่าสำหรับคำถามเชิงประจักษ์แบบใช่/ไม่ใช่ | แข็งแกร่งสำหรับการดูว่า อย่างไร ที่บทความถูกอ้าง | ขึ้นอยู่กับข้อความที่ค้นคืนและการเลือกโมเดล; ต้องตรวจโดยมนุษย์ |
| ความแม่นยำทางบรรณานุกรม | รายละเอียดที่แต่งขึ้นเกิดขึ้นบ่อย | มีรายงานความคลาดเคลื่อนเล็กน้อยในการตรวจสอบ RAG | มีรายงานความคลาดเคลื่อนเล็กน้อยในการตรวจสอบ RAG | ยังไม่ยืนยันในระดับการตรวจสอบภาคสนาม | แข็งแกร่งในส่วนบริบทของการอ้างอิง | รับช่วงเมทาดาทาจากระเบียนที่ค้นคืน; ร้อยแก้วยังอาจคลาดเคลื่อน |
| ราคา (ณ ปี 2026) | แตกต่างตามแพ็กเกจของผู้ให้บริการ | ยังไม่ยืนยัน | ยังไม่ยืนยัน | ยังไม่ยืนยัน | ยังไม่ยืนยัน | มีระดับใช้งานฟรีแบบจำกัด; แพ็กเกจแบบชำระเงินเริ่มต้นที่ $20/เดือน |
| เหมาะที่สุดสำหรับ | ร่างภาษา ไม่ใช่สร้างรายการอ้างอิง | ตารางหลักฐานและการสกัดอย่างเป็นระบบ | การค้นหาวรรณกรรมแบบกว้างและข้ามสาขา | คำตอบรวดเร็วสำหรับคำถามเชิงประจักษ์แบบใช่/ไม่ใช่ | ตรวจสอบว่าการอ้างอิงสนับสนุนหรือขัดแย้งกับข้ออ้างหรือไม่ | การค้นคว้าวรรณกรรมแบบครบวงจร การเตรียมต้นฉบับ และการจัดการการอ้างอิงพร้อมหน่วยความจำต่อเนื่อง |
แชตบอตใช้งานทั่วไป
แชตบอตโดดเด่นในการวางโครงเรื่องและเรียบเรียงใหม่ แต่ล้มเหลวในการสร้างบรรณานุกรม การตรวจสอบ GPT-4o ด้านสุขภาพจิตที่อ้างถึงข้างต้นคือตัวเลขเตือนใจ: มากกว่าครึ่งของการอ้างอิงที่สร้างขึ้นมีข้อผิดพลาด หากเครื่องมือสามารถสร้างรายการอ้างอิงที่ดูสมบูรณ์แบบได้โดยไม่มีระเบียนจริง ให้ถือว่าการอ้างอิงทุกแห่งยังไม่ผ่านการตรวจสอบ
Elicit
Elicit แข็งแกร่งกว่าเมื่อหน้าที่คือคัดกรองบทความและสกัดวิธีวิจัย ผลลัพธ์ และข้อจำกัดลงในตาราง การเปรียบเทียบอิสระระบุว่า Elicit เหมาะกับเวิร์กโฟลว์ที่ใช้หลักฐานอย่างเข้มงวดมากกว่าการค้นหาเชิงสำรวจแบบรวดเร็ว ข้อจำกัดคือความหนาแน่นของความครอบคลุม: ใน เกณฑ์ทดสอบ 200 คำค้นที่ดำเนินการโดย SciSpace Elicit ส่งคืนบทความที่เกี่ยวข้องสูง 13.0 ชิ้นต่อคำค้น เทียบกับ 26.3 ชิ้นสำหรับ SciSpace Deep Review ช่องว่างนี้มีผลต่อการค้นพบให้ครอบคลุม ไม่ใช่ความเสี่ยงการอ้างอิงผี
SciSpace
SciSpace ค้นหาหลายฐานข้อมูลวิชาการ และในการประเมิน Deep Review ของตนเอง มีความแม่นยำสูงสุดตั้งแต่ P@3 ถึง P@70 ความครอบคลุมนี้ช่วยสำหรับคำถามข้ามสาขาที่หลักฐานอยู่ใน PubMed, arXiv และ Google Scholar พร้อมกัน ข้อจำกัดเป็นเรื่องระเบียบวิธี: เกณฑ์ทดสอบที่เป็นจุดเด่นนั้นดำเนินการโดย SciSpace แม้ป้ายกำกับความเกี่ยวข้องมาจากโมเดลภายนอกสามตัวก็ตาม ให้มองเกณฑ์ทดสอบจากผู้ขายเป็นเพียงทิศทาง แล้วตรวจสอบรายการที่คัดเลือกด้วยตนเอง
Consensus
Consensus ถูกสร้างมาเพื่อตอบคำถามวิทยาศาสตร์เชิงประจักษ์จากบทความ มากกว่าการเขียนบททบทวนเชิงบรรยาย ในการทดสอบ 200 คำค้นเดียวกัน Consensus Deep มี ความแม่นยำดีที่สุดที่ผลลัพธ์ลำดับแรก (P@1 = 0.5882) แล้วเสียความได้เปรียบนี้เมื่อพิจารณาลึกลงไปในรายการ จึงเป็นเครื่องมือเริ่มต้นที่ดี และเป็นเครื่องมือหลักที่อ่อนกว่าสำหรับชุดคัดกรองขนาดใหญ่
Scite
จุดแข็งเฉพาะตัวของ Scite คือความฉลาดด้านการอ้างอิง — การเห็นว่าบทความในภายหลังสนับสนุน กล่าวถึง หรือขัดแย้งกับข้ออ้างหนึ่งอย่างไร การเปรียบเทียบต่าง ๆ วางตำแหน่งให้ Scite มีขอบเขตแคบกว่าเครื่องมือดำเนินงานวิจัยเต็มรูปแบบ แต่แข็งแกร่งกว่าในการตรวจสอบหลักฐาน หากรูปแบบความล้มเหลวของคุณคือ “บทความจริงนี้ไม่ได้กล่าวสิ่งที่ผู้ช่วยอ้าง” บริบทการอ้างอิงแบบ Scite คือเครื่องมือที่เหมาะสม
Jenova Academic Research Assistant
Jenova's Academic Research Assistant สร้างขึ้นสำหรับนักวิชาการและนักศึกษาปริญญาเอกที่ต้องการค้นคว้าวรรณกรรม พร้อมการสนับสนุนการจัดทำต้นฉบับและการอ้างอิงในพื้นที่ทำงานถาวรเดียวกัน สามารถค้นหาฐานข้อมูลวิชาการและคลังเอกสารหลักแบบเรียลไทม์ เก็บหน่วยความจำของโครงการข้ามเซสชัน และร่างเนื้อหาด้วยโมเดลปัจจุบันแทนที่จะผูกติดกับผู้ให้บริการรายเดียว ชุดความสามารถนี้มีประโยชน์เมื่อการทบทวนใช้เวลาหลายสัปดาห์และผู้ช่วยต้องจดจำเกณฑ์การคัดเข้า บทความที่คัดออก และ DOI ที่ยังไม่ได้ข้อยุติ
มันไม่ใช่ดัชนีบริบทการอ้างอิงโดยเฉพาะ จึงไม่อาจแทน Scite สำหรับแผนที่การสนับสนุนเทียบกับการขัดแย้งได้ และไม่ใช่ตารางการสกัดข้อมูลที่สร้างมาโดยเฉพาะในความหมายของ Elicit การค้นหาแบบเรียลไทม์อาจค้นคืนระเบียนคุณภาพต่ำหรือไม่ตรงประเด็น ซึ่งโมเดลที่เขียนได้ลื่นไหลอาจตีความเกินจริง กฎการใช้งานที่ซื่อตรงจึงเหมือนกันสำหรับเครื่องมือค้นคืนทุกตัว: ใช้เพื่อค้นหาและจัดระเบียบรายการที่เป็นไปได้ ไม่ใช่เพื่อรับรองบรรณานุกรม
Retrieval-Augmented Generation ช่วยหยุดรายการอ้างอิงผีได้ทั้งหมดหรือไม่?
ไม่ได้ Retrieval-augmented generation (RAG) ช่วยลดบทความที่แต่งขึ้นทั้งหมดในรายการอ้างอิงอย่างมาก แต่ไม่ได้กำจัดข้อผิดพลาดทางบรรณานุกรม และไม่รับประกันว่าบทความที่ค้นคืนจะสนับสนุนประโยคที่นำไปแนบไว้ ดังนั้นการป้องกันจึงต้องมุ่งเป้าไปที่รูปแบบความล้มเหลวสามแบบ ไม่ใช่เพียงแบบเดียว
ทั้งสามแบบสับสนกันได้ง่าย เพราะล้วนสร้าง “การอ้างอิงที่ดูสมจริง”:
- รายการอ้างอิงผี — งานที่อ้างนั้นไม่มีอยู่จริง
- ความคลาดเคลื่อนทางบรรณานุกรม — งานมีอยู่จริง แต่ผู้เขียน ปี เล่ม หรือหน้าผิด
- การหลอนบริบท — งานมีอยู่จริงและเมทาดาทาส่วนใหญ่ถูกต้อง แต่ผู้ช่วยระบุข้อค้นพบที่บทความไม่มี
การวิเคราะห์ภาคสนามของ Scopus AI, Elicit, SciSpace และ Scite ในสาขาบริหารธุรกิจพบว่า เครื่องมือที่ใช้ RAG โดยทั่วไปไม่ได้สร้างรายการอ้างอิงผีที่ตรวจสอบได้ ความคลาดเคลื่อนทางบรรณานุกรมเล็กน้อยยังปรากฏอยู่ แต่แหล่งข้อมูลที่ไม่มีอยู่จริงโดยสิ้นเชิงมีน้อยมากในรายการที่สร้างขึ้นเหล่านั้น นี่คือวิธีที่ควรมอง RAG: เป็นกลไกควบคุมที่แข็งแกร่งต่อรายการผี ไม่ใช่ระบบคุณภาพการอ้างอิงแบบครบวงจร
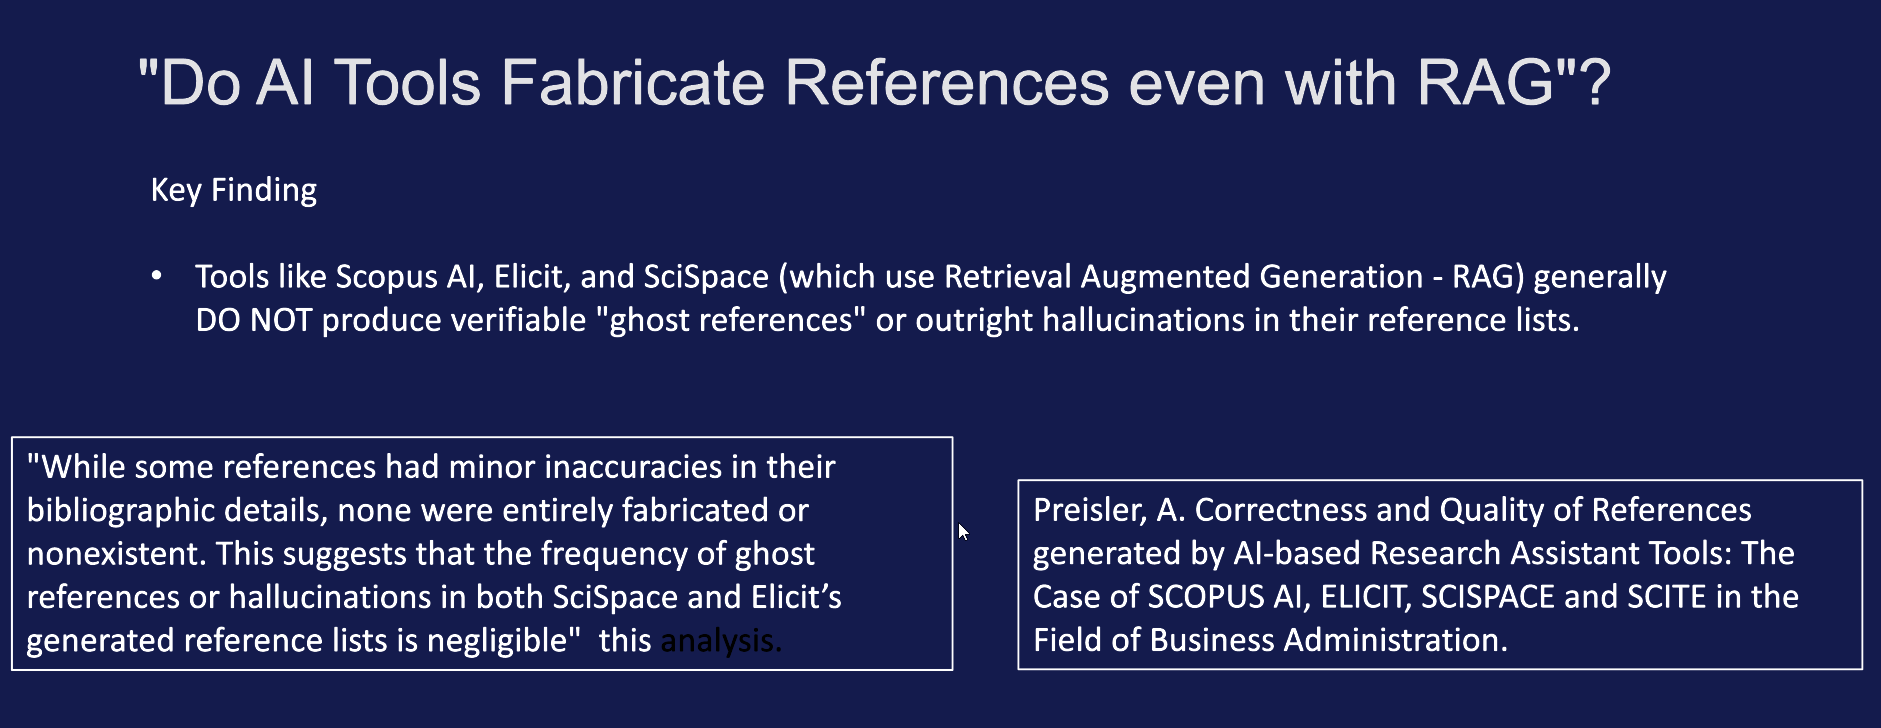
งานวิจัยด้านความสอดคล้องกับหลักฐานอธิบายความเสี่ยงที่เหลืออยู่ กรอบการประเมิน RAG แยกความเกี่ยวข้องของคำตอบออกจากความสอดคล้องกับหลักฐาน: คำตอบอาจตรงประเด็นแต่ยังไม่ได้ยึดโยงกับข้อความที่ค้นคืน ข้อค้นพบของ ACM ที่ว่าการอ้างอิง RAG สัดส่วนมากอาจขาดความสอดคล้องกับหลักฐานคือคำเตือนในการปฏิบัติงาน หากคุณตรวจเพียงว่า DOI เข้าถึงได้ คุณจะจับรายการผีได้ แต่พลาดข้ออ้างที่ระบุแหล่งผิด
แชตบอตทั่วไปล้มเหลวในแบบแรก ผู้ช่วย RAG ส่วนใหญ่มักล้มเหลวในแบบที่สองและสาม ดังนั้นเวิร์กโฟลว์ป้องกันที่ถามเพียงว่า “บทความนี้มีอยู่จริงหรือไม่?” จึงยังไม่ครบถ้วนสำหรับเครื่องมือที่นักวิจัยควรใช้งานจริง
คุณตรวจสอบการอ้างอิงที่ผู้ช่วยวิจัย AI ส่งกลับมาอย่างไร?
ให้ตรวจสอบด้วยโปรโตคอลสองรอบ: ตรวจสอบตัวระบุก่อน จากนั้นยืนยันว่าข้อความเฉพาะเจาะจงสนับสนุนข้ออ้าง การข้ามขั้นตอนใดขั้นตอนหนึ่งคือช่องทางที่ทำให้แหล่งข้อมูลที่แต่งขึ้นหรือถูกใช้ผิดไปถึงการตีพิมพ์
รอบที่ 1 — ระเบียนนี้มีอยู่จริงหรือไม่?
- คัดลอกชื่อเรื่อง ผู้เขียนคนแรก ปี และ DOI ตรงตามที่ส่งกลับมา
- เปิด DOI ผ่านหน้าของหน่วยงานลงทะเบียนหรือสำนักพิมพ์ หากไม่มี DOI ให้ค้นหาชื่อเรื่องแบบตรงตัวใน Google Scholar, PubMed หรือเว็บไซต์วารสาร ตามแนวทางการค้นหาโดยตรงที่คู่มือวิจัยแนะนำ
- ปฏิเสธทุกรายการที่เปิดไม่ได้ เปิดไปยังบทความอื่น หรือมีอยู่เพียงในรูปแบบการอ้างอิงที่ AI จัดให้
- ตรวจลำดับผู้เขียน ปี เล่ม ฉบับ และหน้ากับระเบียนของสำนักพิมพ์ ไม่ใช่กับบล็อกบรรณานุกรมของผู้ช่วย
รอบที่ 2 — บทความนี้สนับสนุนประโยคนี้หรือไม่?
- เปิดข้อความเต็ม PDF หรือ HTML บทคัดย่อไม่เพียงพอสำหรับข้ออ้างเชิงสาเหตุ ขนาดผลกระทบ หรือข้อความประเภท “หลักฐานแรก”
- ค้นหาข้อความที่ควรสนับสนุนข้ออ้างนั้น แล้วบันทึกคำพูดดังกล่าวไว้ในโน้ตของคุณ
- ทำเครื่องหมายการอ้างอิงว่าเป็นการสนับสนุน การกล่าวถึง หรือการขัดแย้ง — ความแตกต่างที่ Scite ทำให้เป็นผลิตภัณฑ์ และคุณก็ประยุกต์ด้วยตนเองได้
- หากผู้ช่วยเรียบเรียงข้อจำกัดให้กลายเป็นข้อค้นพบ หรือเรียบเรียงสมมติฐานให้กลายเป็นผลลัพธ์ ให้ตัดการอ้างอิงนั้นออกจากประโยคดังกล่าว
สำหรับ Jenova's Academic Research Assistant ให้กำหนดขอบเขตการค้นคืนก่อนสร้างรายการอ้างอิง:
“ค้นหาบทความที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิและ preprints เกี่ยวกับ [หัวข้อ] ช่วงปี 2019–2026 ส่งกลับเฉพาะรายการที่มี DOI หรือ PMID สำหรับแต่ละรายการ ให้ระบุ: ชื่อเรื่อง ผู้เขียน ปี วารสาร ตัวระบุ ข้อค้นพบหนึ่งประโยค และข้อความที่ยกมา หากไม่สามารถค้นคืนระเบียนที่ตรวจสอบได้ ให้ละเว้นรายการนั้นทั้งหมด ห้ามเติมหรือคาดเดาเมทาดาทา”
จากนั้นนำรายการที่คัดเลือกแล้วชุดเดียวกันไปตรวจสอบกับ Elicit หรือ SciSpace เพื่อเป็นการตรวจสอบคลังข้อมูลรอบที่สอง ความไม่ตรงกันระหว่างเครื่องมือเป็นข้อดี เพราะมันชี้ให้เห็นบทความที่ระบบหนึ่งจัดอันดับได้ แต่อีกระบบหนึ่งค้นคืนไม่ได้
รายงานของ Science เกี่ยวกับบทความวิทยาศาสตร์ที่หลอนข้อมูล แสดงให้เห็นว่าเหตุใดการอ่านเพียงชื่อเรื่องจึงล้มเหลว ผู้ช่วยอาจอ้างบทความจริงหนึ่งชิ้นได้ถูกต้อง แล้วแต่งอีกชิ้นที่อยู่ใกล้เคียงขึ้นมาในย่อหน้าเดียวกัน การตรวจสอบต้องทำทีละรายการ ไม่ใช่ทีละย่อหน้า
การอ้างอิงที่หลอนข้อมูลอาจถือเป็นการประพฤติมิชอบในการวิจัยหรือไม่?
ได้ ในกรณีที่กำหนดไว้ — และแม้ไม่เข้าเกณฑ์ตามนิยามทางกฎหมายของการประพฤติมิชอบ ก็ยังอาจนำไปสู่การถอนบทความ ปัญหาด้านทุนวิจัย และความเสียหายต่ออาชีพ แรงจูงใจในการป้องกันจึงไม่ใช่เรื่องมารยาท แต่เป็นเรื่องความรับผิด
Resnik และ Hosseini ให้เหตุผล ว่าการอ้างอิงหลอนอาจเข้าข่ายการประพฤติมิชอบในการวิจัยที่พิสูจน์ได้ภายใต้ข้อบังคับของรัฐบาลกลางสหรัฐฯ เมื่อมีเงื่อนไขสามประการ: นักวิจัยใช้เครื่องมือ generative เพื่อสร้างการอ้างอิงที่ไม่มีอยู่จริง; การอ้างอิงเหล่านั้นทำหน้าที่เป็นข้อมูลเพราะใช้สนับสนุนข้อค้นพบ เช่น ในงานทบทวนหรือการศึกษาบรรณมิติ; และนักวิจัยแสดงความไม่ใส่ใจต่อความเสี่ยงในการปลอมแปลงด้วยการไม่ตรวจสอบผลลัพธ์ รายการอ้างอิงผีในบทนำเชิงบรรยายคือผลงานวิชาการที่ด้อยคุณภาพ แต่รายการอ้างอิงผีที่ถูกนับเป็นหลักฐานในการทบทวนอย่างเป็นระบบนั้นใกล้เคียงกับการปลอมแปลงข้อมูลมากกว่า
ผู้ให้ทุนเริ่มปฏิบัติต่อปัญหานี้ในฐานะประเด็นการดำเนินงานแล้ว ในฤดูร้อนปี 2025 เจ้าหน้าที่ทบทวนทุน NIH ต้องรับมือกับข้อเสนอโครงการที่ใช้ AI จำนวนมาก และหน่วยงานระบุว่าการใช้ AI อย่างไม่เหมาะสมที่พบหลังได้รับทุนอาจถูกส่งต่อเพื่อตรวจสอบด้านความซื่อสัตย์ ศูนย์ความซื่อสัตย์ในการวิจัยของ Harvard ย้ำข้อจำกัดที่เกี่ยวข้อง: ไม่สามารถระบุเครื่องมือ AI เป็นผู้เขียนได้ ผู้ทบทวนทางวิทยาศาสตร์ของ NIH ถูกห้ามใช้ generative AI เพื่อเขียนคำวิจารณ์ และผู้เขียนต้องเปิดเผยวิธีใช้เครื่องมือ
วารสารต่าง ๆ กำลังมีแนวทางความรับผิดชอบแบบเดียวกัน เอกสารรวบรวมกฎของ APA, MLA, Chicago และ IEEE โดย Stanford กำหนดให้เปิดเผยเนื้อหาที่ AI สร้าง และในกรณีของ APA ต้องให้มนุษย์ตรวจสอบการอ้างอิงอย่างชัดแจ้ง แนวทางการสอนของ Cornell ยังเตือนว่าอัลกอริทึมตรวจจับ AI อัตโนมัติไม่น่าเชื่อถือเกินกว่าจะใช้เป็นกลยุทธ์ความซื่อสัตย์ได้ การตรวจจับหลังเกิดเหตุเป็นสิ่งทดแทนที่อ่อนแอสำหรับการตรวจสอบก่อนส่ง
มาตรฐานเชิงปฏิบัตินั้นเรียบง่าย หากคุณไม่สามารถชี้ไปยังระเบียนที่เข้าถึงได้และข้อความที่สนับสนุนข้ออ้าง การอ้างอิงนั้นไม่ควรอยู่ในต้นฉบับ สไลด์นำเสนอ หรือข้อเสนอทุน
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยกล่าวอย่างไรเกี่ยวกับการอ้างอิงที่ AI สร้างขึ้น?
ผู้เชี่ยวชาญปัจจุบันมองรายการอ้างอิงที่แต่งขึ้นเป็นความล้มเหลวของกระบวนการ — การใช้โมเดล generative เสมือนเป็นห้องสมุด — ไม่ใช่บั๊กลึกลับของโมเดลที่ผู้ใช้คาดการณ์ไม่ได้ ข้อสรุปร่วมกันระหว่างหน่วยงานด้านความซื่อสัตย์และการศึกษาการอ้างอิงคือ RAG ช่วยลดรายการผี การยืนยันโดยมนุษย์ยังจำเป็น และบรรณานุกรมจากแชตบอตที่ปล่อยไว้โดยไม่มีการตรวจสอบถือเป็นการกระทำที่ประมาท เมื่อพิจารณาจากสิ่งที่ทราบแล้วเกี่ยวกับอัตราความล้มเหลว
“ข้อผิดพลาดที่ยังไปถึงวารสารไม่ใช่เพราะโมเดลคาดเดาเป็นครั้งคราว แต่เป็นเพราะนักวิจัยให้โมเดลภาษาทำหน้าที่จัดทำระเบียนที่มันไม่ได้ถูกออกแบบมาให้ทำ หากผู้ช่วยไม่ได้ค้นคืนระเบียน มันกำลังเติมรูปแบบบรรณานุกรม และรูปแบบที่ถูกเติมนี่เองทำให้เกิดบทความที่ดูเหมือนจริงในวารสารที่ดูเหมือนจริง พร้อม DOI ที่เปิดไม่ได้ การเปลี่ยนไปใช้เครื่องมือค้นคืนช่วยลดรูปแบบความล้มเหลวนี้อย่างมาก แต่มันไม่ลดความล้มเหลวถัดไป: การอ้างบทความจริงเพื่อผลลัพธ์ที่อยู่ในสรุปของโมเดล ไม่ได้อยู่ในส่วนผลลัพธ์ของบทความ”
“เราแนะนำผู้ใช้ด้านการวิจัยให้ใช้เวิร์กโฟลว์สามถัง ถัง A คือรายการที่ค้นคืนและตรวจข้อความแล้ว — สามารถใช้การอ้างอิงเหล่านั้นได้ ถัง B คือรายการที่ค้นคืนแต่ตรวจเพียงเมทาดาทา — ให้อยู่ในรายการอ่าน ถัง C คือทุกอย่างที่โมเดลสร้างขึ้นโดยไม่มีตัวระบุที่เข้าถึงได้ — ให้ลบทิ้ง ไม่ใช่ ‘ค่อยค้นทีหลัง’ ทีมที่ข้ามถัง C เพราะรูปแบบดูน่าเชื่อถือ มักเป็นทีมที่ภายหลังค้นพบว่า 12 จาก 14 รายการอ้างอิงไม่เคยมีอยู่จริง ต้นทุนของการตรวจเพิ่มหนึ่งรอบเล็กน้อยมากเมื่อเทียบกับการถอนบทความหรือการส่งเรื่องตรวจสอบความซื่อสัตย์ด้านทุน”
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเอเจนต์วิจัย AI สำหรับเวิร์กโฟลว์วิชาการ
คำแนะนำนี้สอดคล้องกับนโยบายของสำนักพิมพ์และมหาวิทยาลัย: ระบุชื่อเครื่องมือ ระบุงานที่เครื่องมือทำ และให้ผู้เขียนมนุษย์รับผิดชอบต่อรายการอ้างอิงทุกแห่ง แนวทางด้านความซื่อสัตย์ไม่ได้กล่าวว่า “หลีกเลี่ยง AI” อีกต่อไป แต่กล่าวว่า “อย่าจ้างภายนอกให้ AI ยืนยันการมีอยู่ของแหล่งข้อมูลของคุณ”
คุณดำเนินการทบทวนวรรณกรรมด้วย AI อย่างปลอดภัยต่อการอ้างอิงได้อย่างไร?
ให้ดำเนินการเป็นไปป์ไลน์ที่ค้นคืนก่อน สกัดข้อมูลเป็นลำดับที่สอง เขียนร้อยแก้วเป็นลำดับสุดท้าย และมีด่านตรวจสอบที่ไม่มีประโยคใดข้ามได้ การกลับลำดับนี้ — เขียนข้อโต้แย้งก่อน แล้วจึงขอให้ผู้ช่วย “เพิ่มการอ้างอิง” — คือรูปแบบพรอมต์ที่สัมพันธ์กับรายการอ้างอิงผีมากที่สุด
เวิร์กโฟลว์ที่ยืนหยัดต่อการตรวจสอบของวารสารและผู้ให้ทุน:
- เขียนกฎการคัดเข้าก่อนค้นหา ประชากร การแทรกแซง ช่วงปี ภาษา และประเภทการศึกษา วางกฎเหล่านั้นในผู้ช่วย เพื่อให้หน่วยความจำของเครื่องมือ หากมี สามารถคงอยู่ข้ามเซสชันได้
- ค้นหาด้วยเครื่องมือค้นคืนสองตัว ไม่ใช่ตัวเดียว ตัวอย่างการจับคู่: Jenova's Academic Research Assistant กับ Elicit หรือ SciSpace เก็บผลลัพธ์รวมของทั้งสองชุด อย่าเชื่อรายการจัดอันดับเพียงรายการเดียว
- ตรึงชุดรายการที่เป็นไปได้พร้อมตัวระบุ ส่งออกชื่อเรื่อง ผู้เขียน ปี วารสาร DOI/PMID ทุกรายการที่ไม่มีตัวระบุให้รออยู่นอกชุดนี้
- สกัดข้อมูล ไม่ใช่สรุป จากข้อความเต็ม วิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ ข้อจำกัด และประโยคที่ยกมา ตารางแบบ Elicit มีประโยชน์ในขั้นตอนนี้ ส่วนสรุปเชิงบรรยายคือจุดที่การหลอนบริบทแทรกเข้ามา
- ร่างจากตารางสกัดข้อมูล หากประโยคไม่มีแถวในตาราง ก็ไม่ควรมีการอ้างอิง — และอาจไม่ควรอยู่ในบทความ
- เปิดเผยเครื่องมือที่ใช้ ปฏิบัติตามเอกสารรวบรวมกฎคู่มือรูปแบบของ Stanford: ชื่อเครื่องมือ เวอร์ชัน วันที่ และหน้าที่ที่ดำเนินการ เช่น การค้นหา การสกัดข้อมูล หรือการแก้ไขภาษา
- ตรวจ DOI รอบสุดท้ายในบรรณานุกรมที่จะส่ง รอบสุดท้ายนี้ช่วยจับความคลาดเคลื่อนจากการคัดลอกวาง และรายการอ้างอิงใด ๆ ที่โมเดลแทรกระหว่างการแก้ไข
พรอมต์ที่ทำให้ Jenova อยู่ภายในไปป์ไลน์ แทนที่จะทำงานในโหมดแชตบอต:
“ใช้เฉพาะชุดรายการที่เป็นไปได้ที่ฉันอัปโหลดเพื่อร่างส่วนภูมิหลัง ทุกประโยคเชิงประจักษ์ต้องอ้าง DOI จากชุดนั้น และห้ามนำแหล่งข้อมูลใหม่เข้ามา หากข้ออ้างไม่ได้รับการสนับสนุนจากโน้ตการสกัดข้อมูล ให้ระบุว่า UNSUPPORTED แทนการอ้างอิง”
สำหรับ SciSpace หรือ Elicit ให้ใช้มุมมองการค้นคืนหรือการสกัดข้อมูลของแต่ละเครื่องมือเพื่อสร้างตารางเดียวกันขึ้นใหม่และเปรียบเทียบแต่ละแถว เมื่อทั้งสองตารางไม่ตรงกันเกี่ยวกับข้อค้นพบ ให้อ่าน PDF ความไม่ตรงกันนั้นมีต้นทุนต่ำกว่าการแก้ไขหลังการตีพิมพ์
ข้อจำกัดที่ทำให้ไปป์ไลน์นี้ใช้ได้ผล เป็นเรื่องจิตวิทยาพอ ๆ กับเรื่องเทคนิค: อย่าขอให้ผู้ช่วยตัวใดก็ตาม รวมถึงตัวที่เก่งมาก “หาแหล่งอ้างอิง” ให้กับร้อยแก้วที่เขียนขึ้นโดยไม่มีแหล่งข้อมูล พรอมต์นั้นจะเปลี่ยนเครื่องมือวิจัยกลับไปเป็นเครื่องสร้างการอ้างอิง ซึ่งเป็นรูปแบบความล้มเหลวที่ชุดกลไกทั้งหมดนี้ออกแบบมาเพื่อป้องกัน
เอกสารอ้างอิง
- Nature — การอ้างอิงหลอนกำลังปนเปื้อนวรรณกรรมวิทยาศาสตร์
- Accountability in Research (Resnik & Hosseini) — การอ้างอิงหลอนที่สร้างโดย generative artificial intelligence
- Stanford Libraries — AI ในการวิจัยวิชาการ: แนวทางการอ้างอิง
- ACM Digital Library — ความถูกต้องไม่เท่ากับความสอดคล้องกับหลักฐานใน Retrieval Augmented Generation
- DeepEval — ตัวชี้วัดความสอดคล้องกับหลักฐานสำหรับระบบ RAG
- Confident AI — ตัวชี้วัดการประเมิน RAG: ความเกี่ยวข้องของคำตอบ ความสอดคล้องกับหลักฐาน และความเกี่ยวข้องกับบริบท
- UNC Charlotte Library — คู่มือวิจัยการอ้างอิงหลอนจาก AI
- Wiley — แนวทาง AI สำหรับนักวิจัย
- College Board — ความกังวลของคณาจารย์ว่าการใช้ AI ของนักศึกษาบั่นทอนความซื่อสัตย์ทางวิชาการ
- Harvard Medical School Academic and Research Integrity — AI ในการวิจัย
- Cornell Center for Teaching Innovation — AI และความซื่อสัตย์ทางวิชาการ
- SciSpace — เกณฑ์เปรียบเทียบการค้นหาวรรณกรรม SciSpace vs Elicit vs Consensus จาก 200 คำค้น
- Paperguide — การเปรียบเทียบ Elicit vs SciSpace
- Paperguide — การเปรียบเทียบ Elicit vs Scite
- Science — อ้างสิ่งที่ไม่เคยเห็น: เมื่อ AI หลอนบทความวิทยาศาสตร์
- SciSpace — การเปรียบเทียบผลิตภัณฑ์ SciSpace vs Elicit