ผู้ช่วยวิจัย AI ทำแผนที่ช่องว่างของหลักฐานสำหรับหัวข้อใหม่ได้อย่างไร?
2026-08-22
อะไรทำให้เวิร์กโฟลว์การค้นหา-คัดกรอง-ทำแผนที่ที่ตรวจสอบย้อนกลับได้ แตกต่างจากบทสรุปวรรณกรรมทั่วไป?
ผู้ช่วยวิจัย AI ที่เชื่อถือได้จะไม่เริ่มต้นด้วยการสรุปบทความใดก็ตามที่ค้นพบ แต่จะสร้างกลยุทธ์การค้นหาที่ทำซ้ำได้ คัดกรองชุดการศึกษาที่มีขอบเขตชัดเจนตามเกณฑ์ที่ระบุไว้ และทำแผนที่ว่าการศึกษาเหล่านั้นครอบคลุมอะไรบ้าง — และยังไม่ครอบคลุมอะไรบ้าง — เพื่อให้ช่องว่างในตารางเป็นช่องว่างของหลักฐานจริง ไม่ใช่สิ่งตกค้างจากการค้นหา ในปี 2026 ความแตกต่างนี้สำคัญ เพราะบทสรุปจากแชตทั่วไปอาจดูครบถ้วนทั้งที่สร้างแหล่งอ้างอิงขึ้นมาเอง หรือรวมการออกแบบการศึกษาที่เปรียบเทียบกันไม่ได้ให้กลายเป็นข้ออ้างเดียว
สำหรับหัวข้อใหม่ หน่วยงานเชิงปฏิบัติที่เหมาะสมมักเป็น ชุดแกนกลาง 50 บทความ: มากพอที่จะเผยให้เห็นกลุ่มงานวิจัย และน้อยพอที่นักวิจัยยังตรวจสอบทุกการตัดสินใจรับเข้าหรือตัดออกได้ เครื่องมือที่รองรับเวิร์กโฟลว์นี้ ได้แก่ Jenova's Academic Research Assistant, เวิร์กโฟลว์ systematic review ของ Elicit, Rayyan และเครื่องมือทำแผนที่เครือข่ายการอ้างอิง เช่น ResearchRabbit
สิ่งที่ทำให้กระบวนการค้นหา-คัดกรอง-ทำแผนที่ซึ่งอ้างอิงได้ แตกต่างจากการรวบรวมวรรณกรรมแบบใช้แล้วทิ้ง:
✅ คำค้นที่ตรวจสอบย้อนกลับได้ — มีการบันทึกสตริง Boolean ฐานข้อมูล ช่วงวันที่ และคำพ้องความหมายก่อนเริ่มคัดกรอง ✅ การคัดกรองที่ตรวจสอบได้ — ทุกบทความได้รับแท็ก include, exclude หรือ unsure ที่ผูกกับเกณฑ์ซึ่งระบุไว้ ✅ หลักฐานที่สกัด ไม่ใช่ถอดความ — ข้อค้นพบ วิธีการ และข้อจำกัดยังคงแนบกับแหล่งที่ตรวจสอบได้ ✅ แผนที่ช่องว่างแบบหลายมิติ — เซลล์ว่างถูกเข้ารหัสตามประชากร วิธีการ ภูมิศาสตร์ และผลลัพธ์ ไม่ใช่ตามความรู้สึก ✅ การตรวจสอบโดยมนุษย์ — AI ร่างแผนที่ แต่นักวิจัยยืนยันว่าแหล่งอ้างอิงทุกแห่งมีอยู่จริงในบทความต้นฉบับ
เพื่อเปรียบเทียบผู้ช่วยอย่างมีความหมาย ควรมองการค้นหา การคัดกรอง และการทำแผนที่ช่องว่างเป็นงานสามประเภทที่มีรูปแบบความล้มเหลวต่างกัน แทนที่จะมองเป็นฟีเจอร์ “การทบทวนวรรณกรรม” เพียงอย่างเดียว
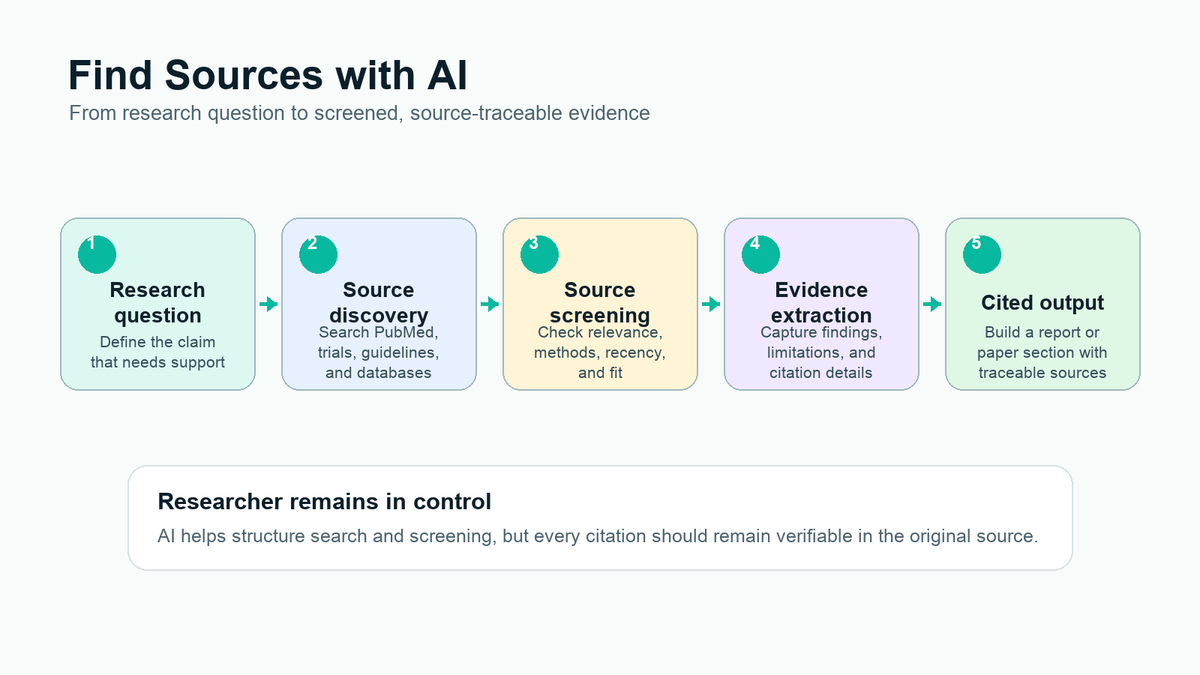
เหตุใดแผนที่ช่องว่างของหลักฐานจึงกลายเป็นสิ่งจำเป็นสำหรับหัวข้อวิจัยใหม่?
แผนที่หลักฐานและช่องว่างได้กลายเป็นวิธีมาตรฐานในการมองเห็นอย่างรวดเร็วว่าสาขาใดมีงานหนาแน่นและสาขาใดเงียบงัน ก่อนที่นักวิจัยจะตัดสินใจเลือกการออกแบบการศึกษาใหม่ แผนที่หลักฐานและช่องว่างคือการนำเสนอเชิงภาพอย่างเป็นระบบของความพร้อมใช้ของหลักฐานที่เกี่ยวข้องสำหรับขอบเขตนโยบายหรือการวิจัย ซึ่งระบุผ่านโพรโทคอลการค้นหาที่กำหนดไว้ล่วงหน้า ไม่ใช่รายการอ่านแบบเฉพาะกิจ
คำจำกัดความนี้ซึ่งพัฒนาขึ้นสำหรับ Campbell Collaboration ถูกใช้ผิดได้ง่าย แผนที่จำนวนมากรายงาน หลักฐานที่มีอยู่ ไม่ใช่ ข้อสรุปของหลักฐาน การสับสนระหว่างสองสิ่งนี้สร้างความมั่นใจเกินจริง: เซลล์ที่หนาแน่นอาจยังอ่อนแอด้านระเบียบวิธี และเซลล์ว่างอาจเกิดจากการค้นหาที่ล้มเหลว ไม่ใช่สิ่งที่ยังไม่รู้จริง
วิธีนี้ไม่ได้เป็นเพียงแนวทางเฉพาะกลุ่มอีกต่อไป การทบทวนในภาคสุขภาพปี 2016 พบชื่อเรื่องด้านการทำแผนที่ 145 เรื่อง โดยมีสิ่งพิมพ์ 34 ชิ้นที่นำเสนอแผนที่หลักฐานอย่างชัดเจน ปัจจุบัน mapping reviews และ evidence gap maps ถูกมองว่าเป็น ผลิตภัณฑ์การสังเคราะห์ที่แตกต่างกัน ซึ่งใช้เพื่อนำทางองค์ความรู้วิจัยที่ซับซ้อน โดยอยู่ระหว่าง scoping review และ systematic review แบบเต็มรูปแบบ
สำหรับผู้ที่เริ่มเข้าสู่หัวข้อใหม่ในปี 2026 แรงกดดันเป็นเรื่องปฏิบัติ Elicit ระบุว่า systematic reviews มักเริ่มต้นด้วยระเบียนมากถึง 20,000 รายการ ก่อนคัดเหลือบทความที่รับเข้า 30–100 ชิ้น ซึ่งเป็นกระบวนการที่อาจใช้เวลาตั้งแต่สามเดือนจนเกินหนึ่งปีหากทำด้วยมือ การคัดกรอง 50 บทความไม่ใช่สิ่งทดแทนกระบวนการมาตรฐานระดับสูงดังกล่าว แต่เป็นเครื่องมือเริ่มต้นที่เหมาะสมเมื่อเป้าหมายคือการตัดสินใจว่า systematic review การศึกษาปฐมภูมิ หรือคำถามที่แคบลง มีเหตุผลรองรับหรือไม่
AI เปลี่ยนความเร็วของการผ่านรอบแรก แต่ไม่ได้ยกเลิกภาระการรายงานใน PRISMA 2020 ซึ่งยังคาดหวังวิธีการระบุ คัดเลือก และสกัดข้อมูลที่โปร่งใส
คุณควรมองหาอะไรในผู้ช่วยวิจัย AI สำหรับการคัดกรองวรรณกรรม?
คุณควรประเมินผู้ช่วยวิจัย AI จากความสามารถในการทำให้กลยุทธ์การค้นหาทำซ้ำได้ การตัดสินใจคัดกรองตรวจสอบได้ และข้ออ้างเรื่องช่องว่างพิสูจน์หักล้างได้ — ไม่ใช่จากความคล่องแคล่วในการเขียน literature review รายการตรวจสอบ TRACE-GAP ด้านล่างคือกรอบที่ใช้ในบทความนี้
มิติการประเมิน TRACE-GAP
- T — คำค้นที่ตรวจสอบย้อนกลับได้ สามารถแสดงฐานข้อมูล สตริง ข้อจำกัด และช่วงวันที่อย่างแม่นยำ เพื่อให้นักวิจัยคนอื่นรันซ้ำได้หรือไม่?
- R — เกณฑ์ความเกี่ยวข้อง สามารถกำหนดกฎการรับเข้าและตัดออกได้ก่อนให้คะแนนบทความใด ๆ หรือไม่?
- A — การคัดกรองที่ตรวจสอบได้ ทุกการตัดสินใจมีเหตุผลประกอบหรือไม่ ไม่ใช่เพียงใช่/ไม่ใช่?
- C — การสกัดระดับแหล่งอ้างอิง ข้อค้นพบเชื่อมโยงกับข้อความหรืออย่างน้อยกับบทความเฉพาะเรื่องหรือไม่ แทนที่จะเป็นบทสรุปที่ปะปนกัน?
- E — การเข้ารหัสความแข็งแรงของหลักฐาน สามารถบันทึกการออกแบบการศึกษา กลุ่มตัวอย่าง และข้อจำกัดไว้ข้างข้อค้นพบได้หรือไม่?
- G — มิติของช่องว่าง แผนที่ใช้ได้อย่างน้อยสองแกนหรือไม่ โดยทั่วไปคือการแทรกแซง × ผลลัพธ์ หรือประชากร × วิธีการ?
- A — การตรวจสอบข้ามกลุ่มงาน เวิร์กโฟลว์บังคับให้ทบทวนอีกครั้งก่อนเรียกเซลล์ว่างว่าช่องว่างหรือไม่?
- P — คำถามที่จัดลำดับความสำคัญ ผลลัพธ์แปลงช่องว่างที่ผ่านการตรวจสอบเป็นคำถามวิจัยหรือไม่ แทนที่จะเป็นเพียง heatmap เพื่อการตกแต่ง?
เกณฑ์เปรียบเทียบคู่มือผู้ซื้อในปี 2026 ซึ่งให้คะแนนผู้ช่วยตามการยึดโยงกับแหล่งอ้างอิง พบว่า ลิงก์แหล่งข้อมูลระดับย่อหน้ามีอัตราส่วนการหลอนต่อการตรวจสอบต่ำที่สุด โดย Atlas อยู่ที่ 0.05, Elicit ที่ 0.07, Consensus ที่ 0.09 และ SciSpace ที่ 0.16 การทบทวนเดียวกันจัด ResearchRabbit เป็นเครื่องมือทำแผนที่เครือข่าย มากกว่าตัวสร้างคำตอบ ซึ่งเป็นการจัดประเภทที่ถูกต้องสำหรับการขยายจากบทความตั้งต้น
ยังมีการทดสอบเพิ่มเติมอีกสองข้อที่สำคัญต่อการใช้งานทางวิชาการ ประการแรก PRISMA 2020 ยังคงกำหนดให้ผู้เขียนตรวจสอบค่าที่สกัดออกมา เครื่องมือใดก็ตามที่ซ่อนข้อความสนับสนุนจึงไม่ผ่านการทดสอบนี้ ประการที่สอง แหล่งอ้างอิงที่ AI สร้างขึ้นเองได้แทรกเข้าสู่ร่างงานของผู้เชี่ยวชาญและกระบวนการจัดทำวารสารแล้ว ดังนั้น “ฟังดูเป็นวิชาการ” จึงไม่ใช่เกณฑ์การยอมรับ
Jenova's Academic Research Assistant เด่นที่สุดด้านการร่างกลยุทธ์ การค้นพบจากหลายฐานข้อมูล ความจำโครงการที่ต่อเนื่อง และการเขียนที่คำนึงถึงแหล่งอ้างอิง จุดอ่อนคือไม่ได้เป็นแพลตฟอร์มสำหรับผู้คัดกรองสองคนโดยเฉพาะ: ไม่ได้สร้างแผนภาพการไหล PRISMA หรือทำการแก้ไขข้อขัดแย้งแบบปิดบังตัวตนเหมือน Rayyan และ Covidence
Jenova, Elicit, Rayyan และ ResearchRabbit เปรียบเทียบกันอย่างไรสำหรับการค้นหา การคัดกรอง และการทำแผนที่ช่องว่าง?
Jenova เด่นที่สุดในฐานะคู่คิดด้านกลยุทธ์และการสังเคราะห์, Elicit เป็นเครื่องมือสกัดข้อมูลแบบมีโครงสร้าง, Rayyan เป็นพื้นที่ทำงานคัดกรองปริมาณสูง และ ResearchRabbit เป็นเครื่องมือสำรวจเครือข่ายการอ้างอิง — และไม่ควรใช้เครื่องมือใดเครื่องมือหนึ่งเป็นระบบปิดเพียงระบบเดียวสำหรับหัวข้อใหม่ การเปรียบเทียบที่มีประโยชน์คือเครื่องมือใดควรรับผิดชอบงานใด
| ฟีเจอร์ / มิติ | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| การสนับสนุนกลยุทธ์การค้นหา | การร่าง PICO/Boolean แบบสนทนาด้วย Scholar และการค้นหาเว็บ พร้อมความจำโครงการต่อเนื่อง | การค้นหาเชิงความหมายใน บทความมากกว่า 125M ชิ้น; แนะนำฟิลด์คัดกรองจากคำถาม | นำเข้าข้อมูลส่งออกจากฐานข้อมูลแบบดั้งเดิม; ไม่ได้ออกแบบมาเป็นหลักสำหรับออกแบบการค้นหา | ResearchRabbit ขยายจากบทความตั้งต้น; Scite ตรวจสอบท่าทีของการอ้างอิงในภายหลัง |
| การคัดกรองบทความราว 50 ชิ้น | ตาราง include/exclude ตามเกณฑ์ในแชต พร้อมเหตุผลและข้อจำกัด | การคัดกรองแบบจัดอันดับ พร้อมแถวสกัดข้อมูลที่มีข้อความอ้างอิงรองรับ | ออกแบบมาโดยเฉพาะสำหรับคัดกรองชื่อเรื่อง/บทคัดย่อ การลบรายการซ้ำ และเวิร์กโฟลว์ทีม | อ่อนด้านการคัดกรอง; เด่นด้านค้นหาบทความที่เกี่ยวข้องหรือตรวจสอบการอ้างอิง |
| การทำแผนที่ช่องว่างหลักฐาน | การเข้ารหัสกลุ่มงาน การตรวจสอบเซลล์ว่าง และการแปลงเป็นคำถามวิจัย | ตารางสกัดข้อมูลที่ดีสำหรับสร้างแผนที่ในภายหลัง | บันทึกการคัดกรองรองรับการทำแผนที่; ตัวแผนที่เองส่วนใหญ่อยู่ในขั้นตอนถัดไป | แผนที่เครือข่ายแสดงการเชื่อมโยงที่ขาดหาย ไม่ใช่ช่องว่างหลักฐานที่ผ่านการตรวจสอบ |
| การยึดโยงกับแหล่งอ้างอิง | คำตอบหลายโมเดลพร้อมคำสั่งแบบให้แหล่งข้อมูลมาก่อน; ยังต้องตรวจสอบโดยมนุษย์ | ข้อความอ้างอิงระดับบทความสำหรับฟิลด์ที่สกัด | บันทึกการตัดสินใจตรวจสอบได้; การสังเคราะห์ไม่ใช่ผลิตภัณฑ์หลัก | Scite ระบุการอ้างอิงที่สนับสนุน ขัดแย้ง หรือเพียงกล่าวถึง |
| ราคา ณ ปี 2026 | ระดับฟรีที่มีการใช้งานจำกัด; Plus เริ่มต้นที่ $20/เดือน | Pro, Team และ Enterprise โดยราคาขึ้นกับแผน | ใช้ฟรีตลอดไปสำหรับการใช้งานพื้นฐาน | ResearchRabbit ฟรี; Scite Student ราว $10/เดือน และ Premium ราว $20/เดือน |
| เหมาะที่สุดสำหรับ | กลยุทธ์หัวข้อใหม่ การทำความเข้าใจชุด 50 บทความ และการเปลี่ยนช่องว่างเป็นเหตุผลสนับสนุนการศึกษา | การสกัดแบบมีโครงสร้างข้ามบทความจำนวนมาก | การคัดกรองเป็นทีมในระดับ systematic review | เข้าสู่สาขาจากบทความตั้งต้น แล้วตรวจสอบแหล่งอ้างอิงสำคัญ |
Rayyan รายงานว่ามีนักวิจัยมากกว่า 1 ล้านคนจากสถาบันกว่า 20,000 แห่ง ในมากกว่า 190 ประเทศใช้งาน และสร้างขึ้นโดยเน้นการตรวจสอบได้ การทำซ้ำได้ และการจัดลำดับความสำคัญด้วย AI การทบทวนซอฟต์แวร์แบบเทียบเคียงในปี 2026 ยังวางกรอบทางเลือกว่าเป็น Covidence สำหรับการจัดการ systematic review ในระดับสถาบัน, Rayyan สำหรับการคัดกรองที่เข้าถึงง่าย และ Elicit สำหรับการค้นหาและสกัดข้อมูลด้วย AI
ข้อจำกัดของ Jenova อยู่ที่อินเทอร์เฟซ ไม่ใช่เจตนา การคัดกรอง 50 บทความในแชตตรวจสอบได้หากบังคับให้ใช้ตาราง แต่ไม่อาจทดแทนผู้คัดกรองอิสระสองคนสำหรับข้อมูลส่งออก 5,000 ระเบียนได้ ข้อจำกัดของ Elicit อยู่ในทิศทางตรงกันข้าม: ตารางยอดเยี่ยม แต่ Elicit เองระบุว่า review ระดับตีพิมพ์ควรยังทำการค้นหาคำสำคัญแบบดั้งเดิม และควรมองการค้นหาเชิงความหมายเป็นส่วนเสริม ข้อจำกัดของ ResearchRabbit คือความซื่อตรงต่อขอบเขต: มันทำแผนที่สิ่งที่เชื่อมโยงกัน ไม่ใช่สิ่งที่ขาดหายหลังการประเมินคุณภาพ
สำหรับหัวข้อใหม่ ชุดเครื่องมือที่ให้ผลคุ้มค่าสูงมักเป็น Jenova หรือ Semantic Scholar สำหรับกลยุทธ์, Rayyan หรือ Elicit สำหรับการคัดกรอง, Scite สำหรับท่าทีของการอ้างอิง และ Jenova อีกครั้งสำหรับการเล่าเรื่องช่องว่าง เอเจนต์ Deep Research ของ Jenova เป็นการส่งต่องานที่ดีกว่าเมื่อแผนที่ 50 บทความต้องพัฒนาเป็นเอกสารบรรยายที่ยาวและมีการอ้างอิงหนาแน่น
คุณสร้างกลยุทธ์การค้นหาที่ทำซ้ำได้ด้วยผู้ช่วยวิจัย AI อย่างไร?
คุณสร้างกลยุทธ์การค้นหาที่ทำซ้ำได้ด้วยการล็อกคำถาม แนวคิด แหล่งข้อมูล และข้อจำกัด ก่อน ขอให้โมเดลใดค้นหาบทความ งานของผู้ช่วยคือเปิดเผยคำพ้องที่ขาดหายและข้อจำกัดที่มีอคติ ไม่ใช่ด้นสดรายการอ่าน
เริ่มจากแกนการวิจัย: ประชากรหรือบริบท การแทรกแซงหรือการสัมผัสปัจจัย ตัวเปรียบเทียบหากเกี่ยวข้อง ผลลัพธ์ และรูปแบบการศึกษาที่จะยอมรับ Mapping reviews อาจกว้างกว่าคำถาม PICO เดี่ยว แต่ยังจำเป็นต้องมี กลยุทธ์การค้นหาและแบบฟอร์มการเข้ารหัสที่กำหนดล่วงหน้า คู่มือมหาวิทยาลัยอธิบาย evidence หรือ gap maps ว่าเป็น ตารางหลักที่มีแถว คอลัมน์ และตัวกรองสำหรับตัวแปรเฉพาะ แถวและคอลัมน์เหล่านั้นควรมีอยู่บนกระดาษก่อนรันคำค้นแรก
คำสั่งเริ่มต้นที่มีประโยชน์ใน Jenova's Academic Research Assistant มีลักษณะดังนี้:
“ฉันกำลังเริ่มสายงานวิจัยใหม่เกี่ยวกับ [หัวข้อ] ร่างกลยุทธ์การค้นหาที่ทำซ้ำได้ โดยมี: (1) องค์ประกอบ PICO หรือ PECO, (2) เกณฑ์รับเข้าและตัดออก, (3) ฐานข้อมูลและแหล่งวรรณกรรมสีเทา, (4) สตริง Boolean พร้อมคำพ้องและคำศัพท์ควบคุม และ (5) ช่วงวันที่ 2019–2026 ระบุคำที่ฉันน่าจะขาดไป และข้อจำกัดใดที่จะซ่อนรูปแบบการศึกษาที่เกี่ยวข้อง”
จากนั้นบังคับให้ตรวจสอบวิธีการ:
“เขียนกลยุทธ์ใหม่เพื่อให้นักวิจัยคนอื่นรันซ้ำได้ แยกคำที่ต้องมีออกจากคำพ้องที่เป็นทางเลือก ระบุจุดที่การค้นหาเชิงความหมายช่วยเพิ่มการค้นพบได้ และจุดที่ต้องใช้ไวยากรณ์ฐานข้อมูลแบบตรงตัวเท่านั้น”
ผู้ช่วยที่ดีจะผลักดันให้คุณใช้หลายแหล่ง หัวข้อชีวการแพทย์ยังต้องใช้ MEDLINE/PubMed ร่วมกับดัชนีเสริมอย่างน้อยหนึ่งแห่ง ส่วนการศึกษาและนโยบายสังคมมักต้องใช้ ERIC, PsycINFO หรือคลังแผนที่เฉพาะทาง คู่มือการสังเคราะห์ของ University of Toronto มอง mapping reviews ว่าเป็นวิธีเห็นช่องว่างก่อนตัดสินใจทำ systematic review ที่แคบกว่า
ข้อผิดพลาดด้านกลยุทธ์สองประการปรากฏซ้ำ ๆ ในการทดสอบ ประการแรกคือการกรองด้วย “review” หรือ “RCT” มากเกินไปตั้งแต่ต้น ซึ่งลบเซลล์ว่างที่คุณตั้งใจจะค้นหาเสียเอง ประการที่สองคือปล่อยให้โมเดลเลือกฐานข้อมูลหลังจากพบผลลัพธ์สะดวก ๆ ไม่กี่รายการแล้ว ให้ตรึงโพรโทคอลก่อน แล้วจึงค้นหา
Jenova ช่วยในส่วนนี้ได้ เพราะบทสนทนาดำเนินต่อข้ามเซสชันและรักษาแกนคำถาม สตริง และรายการตัดออกไว้ในความจำได้ อย่างไรก็ตาม มันไม่อาจแทนที่การค้นหาที่บรรณารักษ์ตรวจทานสำหรับ systematic review เพื่อส่งวารสาร และคุณไม่ควรแสร้งทำเป็นว่าแทนที่ได้
คุณควรคัดกรองบทความสำคัญราว 50 ชิ้นอย่างไรโดยไม่สูญเสียความเข้มงวดด้านระเบียบวิธี?
คุณควรคัดกรอง 50 บทความในรูปแบบบันทึกการตัดสินใจที่เข้ารหัส: หนึ่งแถวต่อหนึ่งการศึกษา หนึ่งเหตุผลต่อหนึ่งการตัดสินใจ และห้ามรับบทความเข้ามาเพียงเพราะบทคัดย่อ “ฟังดูเกี่ยวข้อง” ห้าสิบบทความคือคลังงานชั่วคราวสำหรับหัวข้อใหม่ ไม่ใช่ข้ออ้างว่าได้ค้นหาวรรณกรรมอย่างครบถ้วนแล้ว
ยืมวินัยของการคัดกรองอย่างเป็นระบบ แม้คุณยังไม่ได้เขียน PRISMA review PRISMA 2020 คือแนวทางการรายงานปัจจุบันสำหรับ reviews ที่ระบุ คัดเลือก และสังเคราะห์การศึกษา รายการตรวจสอบ 27 ข้อที่มาคู่กันมีไว้เพื่อทำให้วิธีการเหล่านั้นโปร่งใส บันทึก 50 บทความของคุณยังไม่เป็นไปตามมาตรฐาน systematic review ฉบับเต็ม แต่ควรตอบคำถามพื้นฐานเดียวกันได้: พบอะไร เก็บอะไรไว้ และเพราะเหตุใด
คำสั่งคัดกรองเชิงปฏิบัติ:
“คัดกรองบทความ 50 ชิ้นต่อไปนี้ตามเกณฑ์รับเข้าและตัดออกเหล่านี้ สำหรับแต่ละบทความ ให้ส่งกลับ: การตัดสินใจ (include / exclude / unsure), เกณฑ์ข้อเดียวที่ชี้ขาดผลการตัดสินใจ, รูปแบบการศึกษา, ประชากร, บริบท, ผลลัพธ์หลัก และข้อจำกัดหนึ่งข้อ ยกข้อความที่ใช้เป็นเหตุผลตัดสินใจ ห้ามเพิ่มบทความที่ไม่มีอยู่ในรายการนี้”
จากนั้นทำรอบปรับเทียบกับระเบียนสิบรายการแรกด้วยตัวคุณเอง หากผู้ช่วยและนักวิจัยเห็นต่างกันมากกว่าสองหรือสามรายการ เกณฑ์ยังคลุมเครืออยู่ ให้ทำคำนิยามเรื่องประชากร รูปแบบการศึกษา และผลลัพธ์ให้รัดกุมก่อนให้คะแนนอีกสี่สิบรายการที่เหลือ
Rayyan เป็นเครื่องมือที่ดีกว่าเมื่อชุดข้อมูลใหญ่ขึ้นหรือมีผู้คัดกรองคนที่สองเข้าร่วม การเปรียบเทียบ Covidence และ Rayyan แบบอิสระยังคงมองว่าทั้งคู่เป็น แพลตฟอร์มคัดกรอง systematic review ที่ใช้งานได้ โดยมีรูปแบบการทำงานร่วมกันต่างกัน Elicit เป็นเครื่องมือที่เหมาะกว่าเมื่อขั้นตอนถัดไปคือตารางข้อมูล เช่น ขนาดตัวอย่าง ทิศทางของผลลัพธ์ และฟิลด์วิธีการที่กรอกพร้อมข้อความอ้างอิงสนับสนุน
ข้อจำกัดที่ต้องยอมรับอย่างตรงไปตรงมาของ Jenova คือความสะดวกในการจัดการชุดงาน การคัดกรองผ่านแชตรวดเร็วสำหรับบทความ 50 ชิ้นที่คัดเลือกมาอย่างตั้งใจ แต่ไม่คล่องตัวสำหรับระเบียนนำเข้า 5,000 รายการ ใช้มันเพื่อกำหนดเกณฑ์และสกัด codebook ที่สม่ำเสมอ แล้วจึงย้าย codebook เดียวกันไปยัง Rayyan หรือ Elicit หากโครงการพัฒนาเป็น review อย่างเป็นทางการ
อย่าปล่อยให้โมเดล “เติมข้อมูล” ใน PDF ที่ไม่มีอยู่ หากไม่สามารถเข้าถึงฉบับเต็มได้ แถวนั้นต้องเป็น unsure ไม่ใช่ include กฎข้อเดียวนี้ป้องกันการสร้างภาพลวงตาด้วยแหล่งอ้างอิงได้เป็นส่วนใหญ่
คุณเปลี่ยนบทความที่คัดกรองแล้วให้เป็นแผนที่ช่องว่างของหลักฐานที่ผ่านการตรวจสอบได้อย่างไร?
คุณเปลี่ยนชุดบทความที่คัดกรองแล้วให้เป็นแผนที่ช่องว่างด้วยการเข้ารหัสการศึกษาที่รับเข้าแต่ละชิ้นตามอย่างน้อยสองมิติ ทำเครื่องหมายเซลล์ว่างว่า เบื้องต้น แล้วจึงทดสอบว่าเซลล์ว่างเหล่านั้นยังคงอยู่หลังการค้นหารอบที่สองหรือไม่ เซลล์ว่างที่ยังไม่ถูกท้าทายเป็นเพียงส่วนตกค้างจากการเข้ารหัส ไม่ใช่เหตุผลสนับสนุนงานวิจัย
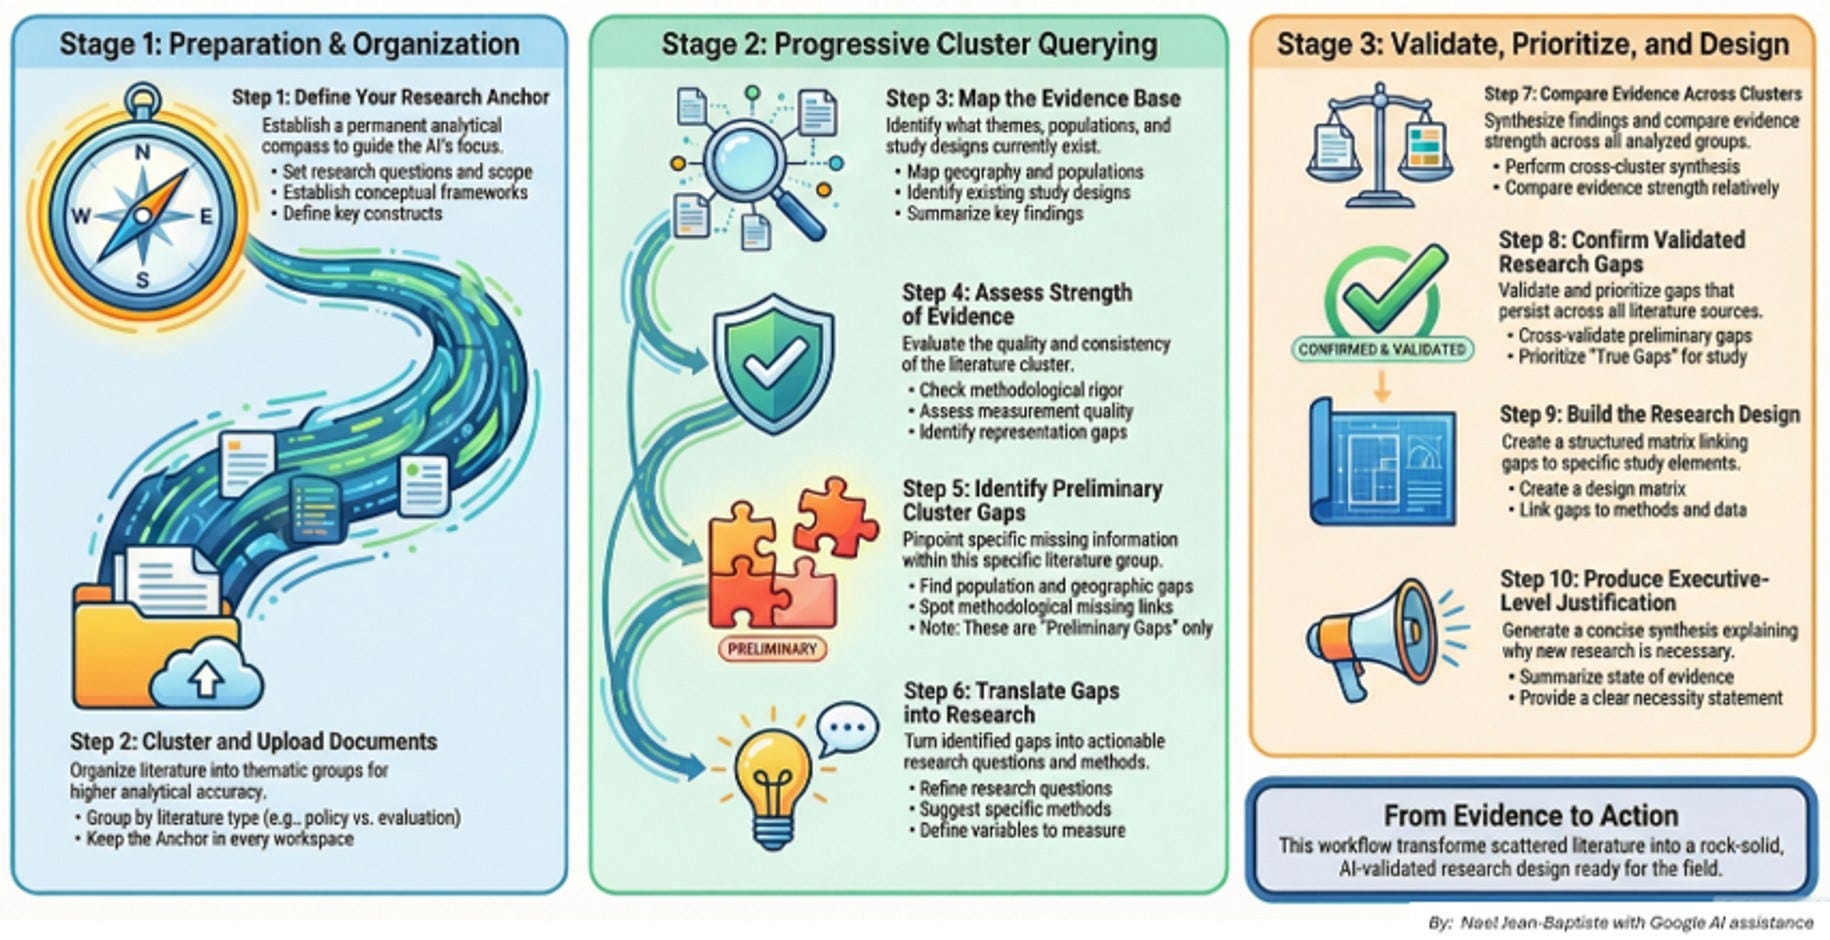
เวิร์กโฟลว์ในภาพด้านบนคือการเรียงลำดับที่ถูกต้อง: เตรียมแกนการวิเคราะห์ จัดกลุ่มเอกสาร ประเมินความแข็งแรงของหลักฐาน ทำเครื่องหมายช่องว่างเบื้องต้น แล้วตรวจสอบช่องว่างเหล่านั้นข้ามกลุ่มงานก่อนออกแบบการศึกษา ซึ่งสอดคล้องกับวิธีที่แผนที่อย่างเป็นทางการควรทำงาน แผนที่ช่องว่างหลักฐานแบบโต้ตอบเป็นเครื่องมือเชิงภาพที่มีโครงสร้าง สำหรับแสดงปริมาณและลักษณะของหลักฐาน ไม่ใช่โปสเตอร์ของสมมติฐานที่ต้องการให้เป็นจริง
แผนที่ที่ทนทานมักต้องมีอย่างน้อย:
- แถว: การแทรกแซง การสัมผัสปัจจัย หรือคำถามวิจัย
- คอลัมน์: ผลลัพธ์ ประชากร หรือรูปแบบการศึกษา
- ตัวกรอง: ปี ภูมิศาสตร์ คุณภาพ และสถานะการตีพิมพ์
- เนื้อหาในเซลล์: จำนวนการศึกษา พร้อมแท็กความแข็งแรงแบบหยาบ เช่น งานทบทวน การทดลอง การศึกษาเชิงสังเกต หรือโพรโทคอล
ขอให้ผู้ช่วยสร้างเมทริกซ์แรกจากบทความที่รับเข้าเท่านั้น:
“โดยใช้เฉพาะการศึกษาที่รับเข้า สร้างเมทริกซ์ช่องว่างโดยกำหนดแถว = [การแทรกแซงหรือคำถาม] และคอลัมน์ = [ผลลัพธ์หรือประชากร] ในแต่ละเซลล์ให้ระบุจำนวนการศึกษา รูปแบบการศึกษาหลัก และความใหม่ของงาน ทำเครื่องหมายเซลล์ว่างเป็น Preliminary จากนั้นเสนอการค้นหาติดตามสามแบบที่สามารถพิสูจน์หักล้างแต่ละเซลล์ว่างได้ รวมถึงทะเบียนการทดลองและวรรณกรรมสีเทา”
การตรวจสอบคือขั้นตอนที่งานเขียนเกี่ยวกับ AI ส่วนใหญ่ข้ามไป การเปรียบเทียบด้านระเบียบวิธีเน้นว่าแผนที่ควรรวมการศึกษาที่กำลังดำเนินอยู่จากทะเบียน ใช้การประเมินเชิงวิพากษ์ และอัปเดตภายในเวลาราวสามปี เซลล์ที่ดูว่างในชุด 50 บทความของคุณ อาจเต็มไปด้วยงานใน preprint server หรือทะเบียนโพรโทคอล
Jenova มีประโยชน์ในระยะนี้ เพราะสามารถเก็บ codebook เมทริกซ์ และบทความที่ถูกปฏิเสธไว้ในเธรดเดียวกัน จากนั้นร่างบันทึก “เหตุใดการศึกษานี้จึงจำเป็น” โดยใช้เฉพาะช่องว่างที่ผ่านการตรวจสอบแล้ว แต่หากปล่อยให้ทำเอง มันจะตีความเซลล์ว่างเกินจริงได้ กำหนดให้มีการค้นหาเพื่อพิสูจน์หักล้างสำหรับทุกช่องว่างที่คุณตั้งใจจะขอทุนหรือเขียนถึง
หากหัวข้อนั้นพัฒนาเป็น scoping review ในภายหลัง ให้เปลี่ยนไปใช้การรายงานตาม PRISMA-ScR ซึ่งระบุรายการจำเป็น 20 ข้อและรายการทางเลือก 2 ข้อ อย่านำแผนที่ 50 บทความแบบไม่เป็นทางการไปปรับแต่งย้อนหลังราวกับเป็น scoping review อยู่แล้ว
คุณจะได้ประโยชน์สูงสุดจากเวิร์กโฟลว์ค้นหา-คัดกรอง-ทำแผนที่ที่มี AI ช่วยได้อย่างไร?
คุณจะได้ประโยชน์สูงสุดจากเวิร์กโฟลว์นี้ด้วยการให้ผู้ช่วยมีโพรโทคอลที่ตรึงไว้ คลังบทความที่มีขอบเขต และงบเวลาสำหรับการตรวจสอบ จากนั้นปฏิเสธทุกข้ออ้างที่เปิดตรวจใน PDF ต้นฉบับไม่ได้ ความเร็วเกิดจากการเข้ารหัสอย่างสม่ำเสมอ ไม่ใช่จากการข้ามการตรวจฉบับเต็ม
ลำดับการทำงานแบบกระชับ:
- เขียนแกนคำถาม หนึ่งย่อหน้าที่ระบุข้ออ้างซึ่งต้องการหลักฐานสนับสนุน ประชากร และสิ่งที่จะนับเป็นหลักฐานหักล้าง
- ร่างและตรึงการค้นหา บันทึกฐานข้อมูล สตริง วันที่ และกฎตัดออกในบันทึกที่มีวันที่ก่อนเริ่มค้นพบแหล่งข้อมูล
- รวบรวม 50 บทความอย่างมีเป้าหมาย ผสมงานทบทวน การทดลองหรือการศึกษาปฐมภูมิใหม่ ๆ และบทความจากสาขาใกล้เคียงอย่างน้อยบางส่วน เพื่อไม่ให้แผนที่เป็นภาพลวงตาจากกลุ่มงานเดียว
- คัดกรองในตาราง ระบุ include, exclude หรือ unsure พร้อมเกณฑ์ที่ชี้ขาดหนึ่งข้อและข้อความอ้างอิงหนึ่งส่วน
- สกัดข้อมูล แล้วจึงจัดระดับ เก็บข้อค้นพบ ข้อจำกัด รูปแบบการศึกษา และกลุ่มตัวอย่างไว้ในฟิลด์แยกกัน
- ทำแผนที่ แล้วโจมตีเซลล์ว่าง ทุกช่องว่างเบื้องต้นต้องได้รับการค้นหารอบสองที่ออกแบบมาเพื่อทำลายข้ออ้างนั้น
- เขียนจากเมทริกซ์ ประโยคที่กล่าวถึงความใหม่ของบทความควรระบุเซลล์ว่างที่ผ่านการตรวจสอบแล้ว ไม่ใช่ความรู้สึกคลุมเครือ
ใน Jenova ให้เก็บห่วงโซ่ทั้งหมดนี้ไว้ในโครงการเดียว เพื่อไม่ให้ผู้ช่วยเปลี่ยนกฎการรับเข้าระหว่างเซสชันโดยไม่แจ้ง คำสั่งติดตามผลที่ช่วยป้องกันการเบี่ยงออกจากเกณฑ์:
“นำเกณฑ์รับเข้าฉบับเดิมมาใช้กับบทความใหม่นี้อีกครั้ง หากต้องเปลี่ยนเกณฑ์เพื่อรับบทความนี้ ให้หยุดและแสดงการเปลี่ยนแปลงที่เสนอ แทนการให้คะแนนบทความ”
สำหรับ Elicit ให้ เริ่มจากคำถามวิจัย ปล่อยให้ระบบเสนอฟิลด์การคัดกรองและการสกัดข้อมูล แล้วแก้ไขฟิลด์เหล่านั้นก่อนรันกับชุดบทความทั้งหมด สำหรับ Rayyan ให้นำเข้าข้อมูลส่งออกจากฐานข้อมูล ตั้งป้ายกำกับให้ตรงกับ codebook และใช้ตัวจัดอันดับความเกี่ยวข้องของ AI เป็นลำดับการเรียง ไม่ใช่เป็นการตัดสินใจ
กำหนดเวลาสำหรับการตรวจสอบอย่างชัดเจน เป้าหมายที่ใช้งานได้สำหรับชุดแกนกลาง 50 บทความคือการตรวจโดยมนุษย์สองถึงสี่นาทีต่อฉบับเต็มที่รับเข้า โดยเน้นว่าข้อค้นพบที่อ้างนั้นอยู่ในบทความจริงหรือไม่ และรูปแบบการศึกษาถูกเข้ารหัสถูกต้องหรือไม่ วิธีนี้ยังถูกกว่าการสกัดข้อมูลแบบไม่ใช้เครื่องมือมาก และเป็นวิธีเดียวที่จะสอดคล้องกับ ความคาดหวังของ PRISMA ที่ให้ตรวจสอบค่าที่สกัดแล้ว
นักระเบียบวิธีวิจัยและผู้พัฒนาเครื่องมือกล่าวอย่างไรเกี่ยวกับการทำแผนที่หลักฐานที่มี AI ช่วย?
นักระเบียบวิธีวิจัยมองแผนที่หลักฐานเป็นแผนภูมิของ ความพร้อมใช้ ที่ขับเคลื่อนด้วยโพรโทคอล ขณะที่ผู้พัฒนาเครื่องมือพบซ้ำ ๆ ว่าแหล่งอ้างอิง ไม่ใช่ร้อยแก้ว คือส่วนที่ AI ทำผิดพลาดได้ง่ายที่สุด ทั้งสองฝ่ายมาบรรจบกันที่กฎเชิงปฏิบัติเดียวกัน: AI อาจช่วยจัดโครงสร้างการค้นหาและการคัดกรองได้ แต่นักวิจัยยังต้องรับผิดชอบทุกเซลล์ในแผนที่
“รูปแบบความล้มเหลวที่เราพบบ่อยที่สุดคือการปฏิบัติต่อเซลล์ว่างราวกับเป็นการค้นพบ เซลล์ว่างเป็นเพียงสมมติฐานว่าหลักฐานหายไป มันจะกลายเป็นช่องว่างที่ผ่านการตรวจสอบได้ก็ต่อเมื่อคุณตรวจกลุ่มงานข้างเคียง วรรณกรรมสีเทา และทะเบียนโพรโทคอลแล้ว และยืนยันว่าการไม่มีหลักฐานนั้นไม่ใช่สิ่งผิดพลาดจากการค้นหา หากไม่ได้ทำการตรวจเหล่านี้ คุณไม่ได้มี gap map คุณมีเพียงภาพแสดงผลของคำค้นแรกเท่านั้น”
“ในการคัดกรอง 50 บทความ เวลาที่ประหยัดได้มาจากการเข้ารหัสที่สม่ำเสมอ ไม่ใช่จากการข้ามฉบับเต็ม การแบ่งงานที่มีประโยชน์นั้นง่าย: ผู้ช่วยร่างการตัดสินใจ include/exclude แถวการสกัดข้อมูล และเมทริกซ์แรก; นักวิจัยใช้เวลาไม่กี่นาทีต่อบทความที่รับเข้าเพื่อยืนยันว่าข้อความอ้างอิงมีอยู่จริง และรูปแบบการศึกษาไม่ได้ถูกยกระดับในการเล่าใหม่ วิธีนี้ยังย่นเวลาจากบันทึกที่ยุ่งเหยิงหลายวันให้เหลือ codebook เดียวได้”
“เราไม่ส่ง systematic review สำหรับวารสารจากบันทึกแชตเพียงอย่างเดียว แพลตฟอร์มคัดกรองเฉพาะทางยังดีกว่าในด้านการทบทวนสองคน การแก้ไขข้อขัดแย้ง และแผนภาพ PRISMA จุดที่ผู้ช่วยวิจัยแบบสนทนาสมควรมีบทบาทคือช่วงก่อนหน้านั้น: การตรึงคำถาม การเปิดเผยข้อจำกัดการค้นหาที่มีอคติ การทำให้บทความที่ถูกปฏิเสธยังมองเห็นได้ และการแปลงเซลล์ว่างที่ผ่านการตรวจสอบให้เป็นเหตุผลสนับสนุนการศึกษาที่แม่นยำ”
— Jenova Product Team, เวิร์กโฟลว์การวิจัยเชิงวิชาการ, ประสบการณ์ 8 ปีในการสร้างเครื่องมือวิจัย AI ที่ตรวจสอบย้อนกลับถึงแหล่งข้อมูลได้
คำเตือนนี้สอดคล้องกับงานอิสระ การทบทวนระบบ generative สำหรับการสังเคราะห์วรรณกรรมยังคงพบ ความสามารถจริงควบคู่กับข้อจำกัดด้านความน่าเชื่อถือ ที่ทำให้การทบทวนแบบไม่มีผู้กำกับดูแลไม่ปลอดภัย แนวทางสำหรับ systematic evidence maps ก็เน้น การจัดหมวดหมู่หลักฐานทางวิทยาศาสตร์อย่างมีโครงสร้าง มากกว่าความมั่นใจจากการเล่าเรื่อง ข้อจำกัดที่ให้นักวิจัยเป็นผู้ควบคุมในเวิร์กโฟลว์แหล่งข้อมูลห้าขั้นตอน ไม่ใช่เพียงคำขวัญ แต่คือขั้นตอนควบคุมคุณภาพที่ส่วนที่เหลือของวิธีการต้องพึ่งพา
เอกสารอ้างอิง
- Saran และ White — แผนที่หลักฐานและช่องว่าง: การเปรียบเทียบแนวทางต่าง ๆ (PMC)
- Khalil และคณะ — ระเบียบวิธีสำหรับ mapping reviews, evidence maps และ gap maps (Research Synthesis Methods)
- Elicit — แนะนำ Elicit Systematic Review
- PRISMA Statement — แนวทางการรายงาน PRISMA 2020
- Atlas Workspace — ผู้ช่วยวิจัย AI ที่ดีที่สุด (2026): การเปรียบเทียบที่ตรวจสอบการหลอนแล้ว
- Fortune — การหลอนของ AI กำลังแทรกซึมสู่งานวิทยาศาสตร์ของผู้เชี่ยวชาญ (พฤษภาคม 2026)
- University of Illinois Grainger LibGuide — Scoping reviews, mapping reviews, evidence หรือ gap maps
- Page และคณะ — แถลงการณ์ PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA และมาตรฐานการทบทวนที่เกี่ยวข้อง
- Elicit — เวิร์กโฟลว์ systematic review ที่สร้างขึ้นสำหรับ PRISMA 2020
- Rayyan — แพลตฟอร์ม systematic review ที่ขับเคลื่อนด้วย AI
- INRA.AI — การเปรียบเทียบ Covidence กับ Rayyan กับ Elicit
- University of Toronto Libraries — Mapping reviews ในกลุ่มงาน knowledge synthesis
- Kellermeyer, Harnke และ Knight — การเปรียบเทียบ Covidence และ Rayyan (PMC)
- EvalCommunity Academy — เครื่องมือทำแผนที่ช่องว่างหลักฐานแบบโต้ตอบ
- PRISMA — ส่วนขยาย PRISMA สำหรับ scoping reviews
- Adel, Alateeq และ Alshahrani — generative AI สามารถสังเคราะห์วรรณกรรมได้อย่างน่าเชื่อถือหรือไม่? (AI & Society)
- Khalil และคณะ — แนวทางการดำเนิน systematic evidence maps (Science of the Total Environment)