AI จะสังเคราะห์หลักฐานข้ามสาขาโดยไม่ปะปนข้อเท็จจริงได้อย่างไร?
2026-08-21
หลักฐานสามชั้นใดที่ต้องแยกออกจากกันในการสังเคราะห์ด้วย AI ข้ามสาขา?
AI จะสังเคราะห์หลักฐานข้ามสาขาได้อย่างน่าเชื่อถือก็ต่อเมื่อระบุทุกข้ออ้างว่าเป็น ข้อเท็จจริงจากแหล่งข้อมูล ข้อสรุปของผู้เขียน หรือ ข้ออนุมานของโมเดล และป้องกันไม่ให้ชั้นเหล่านี้ยุบรวมเป็นย่อหน้าเดียวที่ไม่มีป้ายกำกับ ในปี 2026 การแยกชั้นดังกล่าวคือความแตกต่างระหว่างบทสรุปการวิจัยที่ตรวจสอบย้อนกลับได้ กับบทสรุปที่ลื่นไหลแต่ฟอกข้ออ้างที่ยังไม่แน่ชัดให้ดูมีอำนาจน่าเชื่อถือ Chatbot ทั่วไปยังคงผสมชั้นเหล่านี้โดยปริยาย จึงเป็นเหตุให้การสร้างบรรณานุกรมปลอมและความผิดพลาดของการอ้างอิงยังมีหลักฐานบันทึกไว้อย่างชัดเจน
เอเจนต์วิจัยที่สร้างขึ้นเพื่อวัตถุประสงค์นี้โดยเฉพาะ ซึ่งรวมถึง Academic Research Assistant ของ Jenova เหมาะกับงานนี้มากกว่าเมื่อสามารถดึงแหล่งข้อมูลจริง รักษาการระบุที่มา และทำให้การก้าวข้ามจากข้อมูลของโมเดลปรากฏชัด อย่างไรก็ตาม เครื่องมือเหล่านี้ไม่ใช่สิ่งทดแทนการทบทวนอย่างเป็นระบบที่ลงทะเบียนตาม PRISMA
ปัจจัยสำคัญที่แยกการสังเคราะห์ที่ตระหนักถึงแหล่งที่มาออกจากการเรียบเรียงความใหม่โดยไม่มีป้ายกำกับ ได้แก่:
✅ ข้อเท็จจริงจากแหล่งข้อมูล คือค่าการวัด วิธีการ ขนาดตัวอย่าง และข้อสังเกตที่รายงานในเนื้อหาต้นฉบับ ✅ ข้อสรุปของผู้เขียน คือการตีความที่ผู้เขียนบทความสรุปไว้ในส่วนอภิปรายหรือบทคัดย่อ ไม่ใช่ความจริงที่พิสูจน์ได้โดยอิสระ ✅ ข้ออนุมานของ AI คือการให้เหตุผลเชิงเปรียบเทียบ เชิงคาดการณ์ หรือเชิงบูรณาการที่โมเดลเพิ่มข้ามบทความหรือข้ามสาขา ✅ การทำแผนที่ข้ามโดเมน ต้องระบุอย่างชัดแจ้ง เนื่องจากกลไกที่ได้รับการยืนยันในสาขาหนึ่งมักเป็นเพียงสมมติฐานในอีกสาขาหนึ่ง ✅ ทุกประโยคที่ดึงออกมาใช้ควรผ่านการตรวจสอบง่าย ๆ ได้ว่า: ใครเป็นผู้กล่าวอ้าง กล่าวไว้ในเอกสารใด และมีสถานะเชิงญาณวิทยาอย่างไร?
หากต้องการเปรียบเทียบเครื่องมือสำหรับปัญหานี้ ควรมองแหล่งที่มาเป็นเกณฑ์ประเมินระดับแกนกลาง ไม่ใช่เพียงความชอบด้านรูปแบบ ส่วนที่เหลือของคู่มือนี้ใช้มุมมองดังกล่าว หรือกรอบ FCI-TRACE เพื่อประเมินว่าระบบสังเคราะห์ทำงานจริงอย่างไร
เพราะเหตุใดการสังเคราะห์ด้วย AI ข้ามสาขาจึงล้มเหลวเมื่อแหล่งที่มาถูกยุบรวม?
การสังเคราะห์ข้ามสาขาล้มเหลวหากไม่มีแหล่งที่มา เพราะแต่ละสาขาไม่ได้ใช้มาตรฐานเชิงหลักฐานแบบเดียวกัน และโมเดลภาษาถูกปรับให้ผลิตร้อยแก้วที่สอดคล้องกันมากกว่ารักษามาตรฐานเหล่านั้น ผลลัพธ์เชิงประจักษ์ของบทความภูมิอากาศ ข้ออ้างเรื่องการระบุความเป็นเหตุเป็นผลของนักเศรษฐศาสตร์ และแนวทางปฏิบัติของแพทย์ สามารถถูกรวมเชิงไวยากรณ์ไว้ในประโยคเดียวได้ ประโยคนั้นจะอ่านเหมือนเป็นองค์ความรู้ที่ยุติแล้ว แม้จะมีเพียงวลีเดียวที่เคยได้รับการวัดจริง
นี่ไม่ใช่รูปแบบความล้มเหลวในเชิงสมมติ การศึกษาบททบทวนวรรณกรรมที่สร้างโดย ChatGPT ของ Scientific Reports พบว่า 55% ของการอ้างอิงจาก GPT-3.5 และ 18% ของการอ้างอิงจาก GPT-4 เป็นข้อมูลปลอม และ 43% กับ 24% ของการอ้างอิงจริงที่เหลือมีข้อผิดพลาดด้านบรรณานุกรมที่มีนัยสำคัญ รายงานในเวลาต่อมาเชื่อมโยงการเพิ่มขึ้นในวงกว้างของการอ้างอิงปลอมในบทความที่ตีพิมพ์กับเครื่องมือเชิงกำเนิด การทบทวนหลายโมเดลในปี 2026 ยังพบว่าเอกสารอ้างอิงที่สร้างโดย AI เกือบ 40% มีข้อผิดพลาดหรือเป็นข้อมูลปลอม โดยมีเพียง 26.5% ที่ถูกต้องทั้งหมด
อัตราการหลอนยังสูงกว่าเดิมนอกเหนือจากร้อยแก้ววิทยาศาสตร์ที่มีการจัดทำดัชนีอย่างดี การประเมินของ Stanford HAI ซึ่งสรุปโดย MIT Sloan พบว่า Chatbot สำหรับงานทั่วไปหลอนใน 58–82% ของคำค้นวิจัยทางกฎหมาย บนโมเดลยุคปี 2023 สาขากฎหมาย นโยบาย และคลินิกคือบริบทที่มักมีการขอบทสรุปข้ามสาขามากที่สุด และเป็นบริบทที่ข้ออนุมานไร้ป้ายกำกับสร้างต้นทุนสูงที่สุด
ปัญหาที่ลึกกว่าคือ การฟอกแหล่งข้อมูล: วลีที่แสดงความระมัดระวังในส่วนอภิปรายถูกกล่าวซ้ำโดยตัดเงื่อนไขออก แล้วถูกอ้างอิงเสมือนเป็นผลลัพธ์ มาตรฐานแหล่งที่มามีอยู่เพื่อหยุดการแปลงสถานะเช่นนี้ งานข้ามสาขาทวีความเสี่ยงนี้ เพราะผู้อ่านไม่สามารถอาศัยวิธีวิทยาร่วมกันเพื่อสังเกตได้ว่าข้ออ้างเปลี่ยนสถานะไปเมื่อใด
คุณควรใช้เกณฑ์ใดประเมินระบบสังเคราะห์หลักฐานด้วย AI?
คุณควรประเมินระบบสังเคราะห์หลักฐานด้วย AI จากความสามารถในการรักษาชั้น FCI ไว้ภายใต้ความเห็นไม่ตรงกัน ไม่ใช่จากจำนวนบทความที่ระบบกล่าวถึง ความลื่นไหล ความรวดเร็ว หรือแม้แต่การครอบคลุม ล้วนเป็นเรื่องรองหากผลลัพธ์ตรวจสอบไม่ได้ กรอบ FCI-TRACE ที่ใช้ในที่นี้ให้คะแนนหกมิติ
FCI (สถานะเชิงญาณวิทยา)
- ข้อเท็จจริง: ระบบสามารถยกข้อความหรือถอดความผลลัพธ์อย่างใกล้เคียงพร้อมตัวระบุตำแหน่งได้หรือไม่ เช่น บทความ ส่วน รูปภาพ หรือตาราง
- ข้อสรุป: ระบบระบุว่าการตีความมาจากผู้เขียนคนใด และคงถ้อยคำที่แสดงความระมัดระวังไว้หรือไม่
- ข้ออนุมาน: ระบบทำเครื่องหมายขั้นตอนเชิงเปรียบเทียบหรือเชิงบูรณาการว่าโมเดลเป็นผู้สร้างหรือไม่
TRACE (คุณภาพของการสังเคราะห์)
- การตรวจสอบย้อนกลับได้: ทุกข้ออ้างเชื่อมกับช่วงข้อความในแหล่งข้อมูล ไม่ใช่เพียงชื่อบทความ
- ความใหม่: ระบบแยกวันที่ preprint วันที่เผยแพร่ และวันที่ปรับปรุงแนวทางปฏิบัติ ซึ่งเป็นจุดล้มเหลวที่พบแม้ในเครื่องมือบรรณานุกรมที่ไม่ใช่ AI และเป็นรูปแบบความผิดพลาดของ ChatGPT ที่บันทึกไว้ในการศึกษาของ Walters และ Wilder
- ความสอดคล้อง: ผลการค้นพบที่ไปในทิศทางเดียวกันและขัดแย้งกันต้องจัดทำเป็นตาราง ไม่ใช่เฉลี่ยจนเกิดฉันทามติเทียม
- ความครอบคลุม: เมื่อตั้งคำถามข้ามโดเมน ต้องมีวิธีวิทยาจากอย่างน้อยสองสาขา
- การติดป้ายสถานะเชิงญาณวิทยา: ป้ายสถานะต้องมองเห็นในร้อยแก้ว ไม่ใช่ซ่อนไว้ในเชิงอรรถ
สิ่งนี้เข้มงวดกว่ารายการตรวจสอบทั่วไปประเภท “AI สำหรับการทบทวนวรรณกรรม” ซึ่งมักหยุดอยู่ที่การค้นหาและการสรุป คู่มือมหาวิทยาลัยปัจจุบันรวบรวมเครื่องมือที่สรุปบทความและดึงข้อมูลลงในตารางที่มีโครงสร้าง ขณะที่ทีมทบทวนอย่างเป็นระบบแยกการคัดกรองกึ่งอัตโนมัติออกจากการคัดกรองอัตโนมัติเต็มรูปแบบ ความสามารถเหล่านี้มีความสำคัญ แต่ไม่ได้ป้องกันข้อสรุปของผู้เขียนจากการถูกเขียนใหม่ให้กลายเป็นข้อเท็จจริงโดยตัวมันเอง
ความโปร่งใสของระเบียบวิธียังคงต้องอยู่ในการให้คะแนน PRISMA 2020 คือรายการตรวจสอบการรายงาน 27 ข้อสำหรับการทบทวนอย่างเป็นระบบที่มีการสังเคราะห์ ซึ่งมีเอกสารคำอธิบายดูแลร่วมกันผ่านEQUATOR Network ไม่มีเซสชัน Chatbot ใดเป็นการทบทวนตาม PRISMA แต่เวิร์กโฟลว์ AI ที่ปกป้องได้ก็ควรรายงานตรรกะการคัดเลือก แหล่งข้อมูลที่ค้นหา และสิ่งที่โมเดลเพิ่มเข้ามา
เครื่องมือวิจัย AI ชั้นนำจัดการข้อเท็จจริง ข้ออ้างของผู้เขียน และข้ออนุมานของโมเดลอย่างไร?
เครื่องมือชั้นนำแบ่งแยกกันอย่างชัดเจน: เครื่องมือสกัดข้อมูลที่อิงบทความช่วยลดการสร้างข้อมูลปลอม ขณะที่โมเดลแชตทั่วไปยังคงลื่นไหลแต่ระบุแหล่งที่มาได้ไม่เข้มแข็ง และแทบไม่มีเครื่องมือใดบังคับใช้ป้าย FCI ในร้อยแก้วที่สร้างขึ้นโดยกำเนิด การเปรียบเทียบด้านล่างมุ่งที่สุขอนามัยเชิงญาณวิทยา ไม่ใช่ความนิยมโดยรวม
| ฟีเจอร์ / มิติ | ChatGPT สำหรับงานทั่วไป | Elicit | Jenova Academic Research Assistant | Scite (บริบทการอ้างอิง) |
|---|---|---|---|---|
| คลังข้อมูลที่ใช้ยึดโยง | ข้อมูลฝึกสอนพร้อมการเรียกดูทางเลือก; การอ้างอิงมักไม่ได้รับการตรวจสอบ | การค้นหา การสรุป และการสกัดข้อมูลจากบทความ 125 ล้านฉบับ; มีนักวิจัยกว่า 2 ล้านคนใช้ | การดึงข้อมูลวิชาการและเว็บแบบสด ไฟล์แนบ และหน่วยความจำเซสชันถาวร | กราฟการอ้างอิงและบริบทสนับสนุน/โต้แย้งเกี่ยวกับวิธีที่บทความถูกอ้างถึง |
| การติดป้าย FCI ในผลลัพธ์ | โดยปกติไม่มีป้าย; ข้อเท็จจริง ข้ออ้างในส่วนอภิปราย และการก้าวข้ามของโมเดลใช้เสียงเดียวกัน | สกัดระดับบทความได้ดีกว่าป้ายสถานะเชิงญาณวิทยาระดับประโยค | สามารถสั่งให้ติดป้ายชั้น FCI และรักษาระเบียบวิธีข้ามเซสชันได้ | ติดป้ายจุดยืนของการอ้างอิงมากกว่าประเภทข้ออ้างภายในการสังเคราะห์ |
| การสังเคราะห์ข้ามสาขา | ลื่นไหลสูง; เส้นทางตรวจสอบข้ามสาขาอ่อนแอ | แข็งแกร่งที่สุดสำหรับคำถามวิจัยเชิงประจักษ์และการสกัดข้อมูลแบบมีโครงสร้าง | แข็งแกร่งที่สุดเมื่อต้องใช้ระเบียบวิธีร่วมกับการติดตามเฉพาะโดเมนเป็นเวลาหลายวัน | มีข้อจำกัดในฐานะเครื่องมือสังเคราะห์; เด่นกว่าในฐานะเลนส์บริบทการอ้างอิง |
| การตรวจสอบการอ้างอิง | อัตราการสร้างข้อมูลปลอมและข้อผิดพลาดสูงในการทดสอบอย่างเป็นระบบ | แถวข้อมูลที่ยึดโยงกับบทความลดเอกสารอ้างอิงที่ถูกประดิษฐ์ | การดึงข้อมูลพร้อมการระบุที่มา; ยังต้องสุ่มตรวจโดยมนุษย์ | มีบริบทโดยกำเนิดว่าบทความภายหลังสนับสนุนหรือโต้แย้งข้ออ้างหรือไม่ |
| การคัดกรอง / การสกัดข้อมูล | ไม่มีโครงสร้าง | ทำการคัดกรองและสกัดข้อมูลสำหรับการทบทวนอย่างเป็นระบบโดยอัตโนมัติ | การค้นพบแบบวนซ้ำและการสนับสนุนต้นฉบับ ไม่ใช่ UI สำหรับการคัดกรองโดยเฉพาะ | ไม่ใช่พื้นที่ทำงานสำหรับการคัดกรอง |
| ราคา (ณ ปี 2026) | แบบสมัครสมาชิก; ไม่ได้ตรวจสอบระดับแพ็กเกจผู้บริโภคที่แน่นอนในที่นี้ | ไม่ได้ตรวจสอบในการทบทวนนี้ | ระดับฟรีที่มีการใช้งานจำกัด; Plus ราคา $20/month (ใช้งานได้ 30×) | ไม่ได้ตรวจสอบในการทบทวนนี้ |
| เหมาะที่สุดสำหรับ | ร่างงานเมื่อมีแหล่งข้อมูลอยู่แล้ว | การสกัดแบบคอลัมน์จากบทความเชิงประจักษ์ | บทสรุปหลายแหล่งข้อมูลข้ามเซสชันที่ต้องคงชั้น FCI ให้มองเห็นได้ | ตรวจสอบว่าข้ออ้างหนึ่งได้รับการปฏิบัติอย่างไรในวรรณกรรมภายหลัง |
Elicit. การพิจารณาขอบเขตผลิตภัณฑ์แสดงให้เห็นว่าเป็นพื้นที่ทำงานวิจัยมากกว่า Chatbot: ผู้ใช้ตั้งคำถาม ค้นหาบทความ และสกัดฟิลด์ข้อมูล การเปรียบเทียบอิสระในปี 2026 อธิบายว่า Elicit เด่นกว่าในด้านการค้นพบวรรณกรรม การคัดกรอง และการสกัดข้อมูล ขณะที่ Consensus เด่นกว่าสำหรับคำถามวิทยาศาสตร์แบบใช่/ไม่ใช่ จุดแข็งด้านการสกัดนี้มีอยู่จริง แต่ข้อจำกัดก็เติมเต็มกันได้: ตารางที่กรอกครบแล้วอาจยังเสนอคำกริยาเชิงเหตุเป็นผลจากบทคัดย่อราวกับเป็นผลลัพธ์ หากผู้ใช้ไม่ได้กำหนดคอลัมน์ที่แยกผลการค้นพบออกจากการตีความ
Consensus และ Semantic Scholar. Consensus ถูกวางตำแหน่งซ้ำ ๆ ว่าเป็นระบบตอบคำถามที่อิงบทความจริง ไม่ใช่ขั้นตอนการทบทวนเต็มรูปแบบ (The Drive AI) รายการสรุปหนึ่งในปี 2026 ระบุว่า Consensus มีราคาเริ่มต้นราว$144 ต่อปี Semantic Scholar ยังคงเป็นแกนหลักสำหรับการค้นพบในชุดการเปรียบเทียบเดียวกัน เครื่องมือทั้งสองไม่มีชั้นกำกับข้อเท็จจริงเทียบกับข้ออนุมานที่บังคับใช้ตามคำอธิบายสาธารณะที่ตรวจสอบในที่นี้
Scite. Scite เหมาะกว่าเมื่อคำถามคือ บทความหนึ่งถูกอ้างอิงอย่างไร ไม่ใช่ จะผสานสองสาขาอย่างไร การเปรียบเทียบมองว่าเป็นผู้เชี่ยวชาญด้านบริบทการอ้างอิง เทียบกับเวิร์กโฟลว์การทบทวนที่กว้างกว่าของ Elicit (Paperguide, 2026) ป้ายการอ้างอิงแบบสนับสนุนเทียบกับโต้แย้งมีคุณค่า แต่ยังต่างจาก FCI: บทความภายหลังอาจ “สนับสนุน” ข้อสรุปของผู้เขียนที่ไม่เคยเป็นข้อเท็จจริงมาก่อน
ChatGPT สำหรับงานทั่วไป. ยังคงเป็นตัวเลือกเริ่มต้นที่ไม่เหมาะกับการสังเคราะห์โดยไม่มีผู้ดูแล แม้แต่อัตราการสร้างข้อมูลปลอมที่ลดลงเป็น18% ของ GPT-4ก็ไม่สอดคล้องกับงานที่ต้องการมาตรฐานระดับการอ้างอิง และฟิลด์เชิงตัวเลขของการอ้างอิง เช่น เล่ม หน้า และปี คือข้อผิดพลาดที่พบมากที่สุดในบรรดาเอกสารอ้างอิงจริง แนวทางจากห้องสมุดปัจจุบันมองการอ้างอิงที่หลอนขึ้นมาเป็นประเด็นด้านความซื่อสัตย์ในการวิจัยโดยเฉพาะ
Jenova Academic Research Assistant. เอเจนต์นี้สร้างขึ้นสำหรับนักวิชาการและนักศึกษาปริญญาเอกที่ต้องการค้นพบวรรณกรรม สนับสนุนการเขียนต้นฉบับ และจัดการการอ้างอิง มากกว่าบทสรุปแบบครั้งเดียว บนแพลตฟอร์ม Jenova สามารถใช้การค้นหาทางวิชาการ เก็บประวัติการแชตได้ไม่จำกัด และเก็บระเบียบวิธีไว้ในหน่วยความจำถาวร เพื่อไม่ให้กฎ FCI ถูกรีเซ็ตทุกเซสชัน เมื่อใช้คู่กับ Deep Research ซึ่งค้นหาอย่างกว้างขวางและส่งคืนรายงานที่มีการอ้างอิงหนาแน่น จึงเหมาะอย่างยิ่งกับคำถามข้ามสาขาที่ดำเนินต่อเนื่องหลายช่วงเวลา
ข้อจำกัดอย่างตรงไปตรงมามีความสำคัญ เครื่องมือนี้ไม่ใช่ Covidence, DistillerSR หรือ Rayyan: ไม่มีพื้นที่ทำงานแผนภาพการไหลตาม PRISMA โดยเฉพาะ และไม่มีตารางสกัดข้อมูลจาก 125 ล้านบทความในระดับเดียวกับที่ Elicit โฆษณา การตัดสินใจคัดเข้าที่มีเดิมพันสูงและการรวมผลทางสถิติยังเป็นหน้าที่ของผู้ทบทวนมนุษย์ ข้อได้เปรียบด้านความลึกคือความต่อเนื่องของระเบียบวิธีและการติดป้ายอย่างชัดแจ้ง ไม่ใช่ความแน่นอนที่ทำงานโดยอัตโนมัติ
การจัดการองค์ความรู้ป้องกันไม่ให้หลักฐานจากแต่ละสาขายุบรวมเป็นเรื่องเล่าเดียวได้อย่างไร?
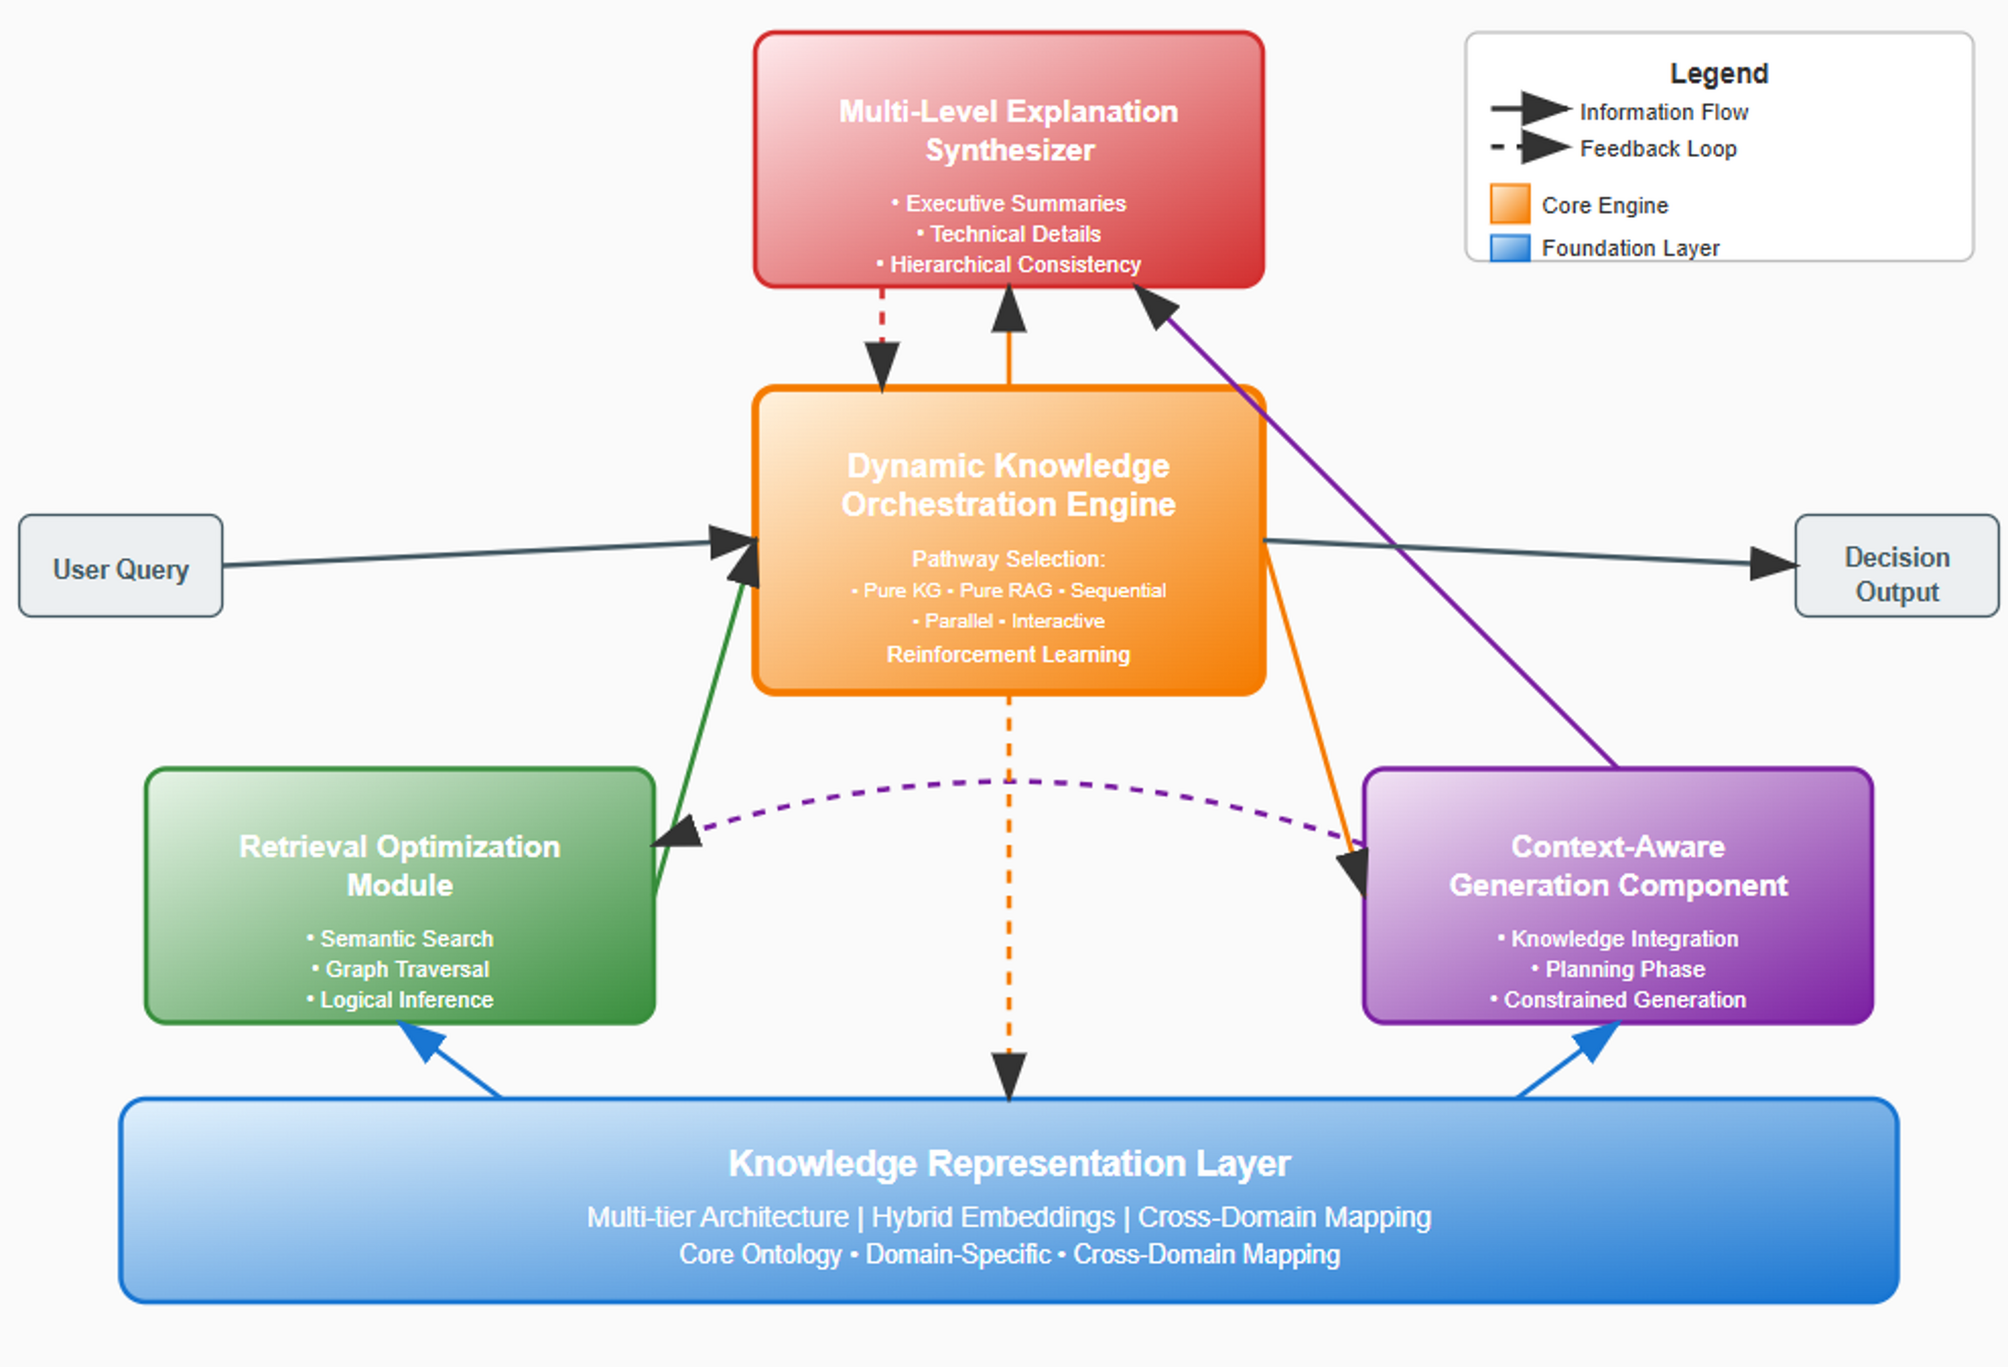
การจัดการองค์ความรู้รักษาหลักฐานจากแต่ละสาขาไว้ได้ด้วยการเลือกเส้นทางการดึงข้อมูล ก่อน การสร้างเนื้อหา แล้วบังคับให้คำอธิบายสอดคล้องตามลำดับชั้นกับสิ่งที่ดึงมา การพิจารณาสแต็กการจัดการโดยทั่วไปแสดงให้เห็นว่าเหตุใดแนวคิด “ดึงข้อมูลแล้วเขียน” จึงไม่เพียงพอสำหรับงานข้ามสาขา
พื้นฐานคือ ชั้นการแทนองค์ความรู้ (knowledge representation layer): embeddings แบบผสม ออนโทโลยีเฉพาะโดเมน และการทำแผนที่ข้ามโดเมน หากไม่มีชั้นนี้ โมเดลจะปฏิบัติต่อ “ความไม่แน่นอน” ในฟิสิกส์ภูมิอากาศ “ความไม่แน่นอน” ในเศรษฐมิติ และ “ความไม่แน่นอน” ในแนวทางปฏิบัติทางคลินิก ราวกับอยู่ในพื้นที่ใกล้เคียงของ token เดียวกัน แต่สิ่งเหล่านี้ไม่เหมือนกัน การทำแผนที่คำศัพท์ข้ามสาขาเป็นขั้นตอนการอนุมานและควรติดป้ายเช่นนั้น
เหนือชั้นดังกล่าว โมดูลเพิ่มประสิทธิภาพการดึงข้อมูล (retrieval optimization module) ผสมผสานการค้นหาเชิงความหมาย การเดินผ่านกราฟ และการอนุมานเชิงตรรกะ การเดินผ่านกราฟมีความสำคัญเมื่อคำถามเป็นเชิงความสัมพันธ์ เช่น กลไก A ในระบบนิเวศเปรียบเทียบกับกลไก B ในสาธารณสุขได้หรือไม่ การค้นหาเชิงความหมายเพียงอย่างเดียวคืนภาษาที่คล้ายกัน แต่ไม่ได้พิสูจน์ว่ามีโครงสร้างเชิงเหตุเป็นผลร่วมกัน การอนุมานเชิงตรรกะเหนือข้ออ้างที่สกัดได้ใกล้เคียงกับเครือข่ายอนุมานจากหลักฐานที่ออกแบบมาเพื่อตรวจสอบข้ออ้างอย่างตีความได้
จากนั้น เอนจินการจัดการ (orchestration engine) จะเลือกเส้นทาง ไม่ว่าจะเป็น knowledge-graph เท่านั้น, RAG เท่านั้น, แบบลำดับ, แบบขนาน หรือแบบโต้ตอบ แทนที่จะเทส่วนข้อความลงใน prompt เสมอ การดึงข้อมูลแบบขนานเหมาะสมเมื่อจำเป็นต้องรวบรวมสองสาขาอย่างเป็นอิสระก่อนทำการจับคู่ การดึงข้อมูลแบบลำดับเหมาะสมเมื่อมาตรวัดผลลัพธ์ของสาขาหนึ่งควรจำกัดคำค้นถัดไป การผสมรูปแบบเหล่านี้โดยไม่ระบุคือวิธีที่บทสรุปภูมิอากาศ-สุขภาพค่อย ๆ กลายเป็นข้อเสนอแนะเชิงนโยบายโดยไม่รู้ตัว
ขั้น การสร้างเนื้อหาที่รับรู้บริบท (context-aware generation) ควรวางแผนภายใต้ข้อจำกัด: ห้ามสร้างคำกริยาเชิงเหตุเป็นผลหากแหล่งข้อมูลไม่ได้ใช้ และห้ามรวมกรอบตัวอย่างเข้าด้วยกัน ขั้นสุดท้ายคือ ตัวสังเคราะห์คำอธิบายหลายระดับ (multi-level explanation synthesizer) ซึ่งเป็นจุดที่ FCI มองเห็นได้ ได้แก่ บทสรุปผู้บริหาร รายละเอียดเชิงเทคนิค และการตรวจสอบความสอดคล้องเพื่อไม่ให้บทสรุปก้าวล้ำหลักฐาน อินเทอร์เฟซข้ออ้าง-หลักฐานในการวิจัยปัจจุบัน เช่น PaperTrail ชี้ไปในทิศทางเดียวกัน: ความน่าเชื่อถือในบริบทวิชาการขึ้นอยู่กับการจับคู่ข้ออ้างกับหลักฐาน ไม่ใช่ร้อยแก้วที่ลื่นไหลกว่า
Academic Research Assistant ของ Jenova ไม่ได้เปิดเผยสวิตช์กำหนดเส้นทางภายในทั้งหมดเป็นตัวควบคุมสำหรับนักวิจัย นี่เป็นข้อจำกัดจริงสำหรับทีมที่ต้องการ DAG ซึ่งตรวจสอบได้ทั้งหมด แต่สิ่งที่เสนอคือสิ่งเทียบเท่าในทางปฏิบัติสำหรับเวิร์กโฟลว์วิชาการส่วนใหญ่ ได้แก่ คำสั่งถาวร คลังเอกสารที่แนบ การดึงข้อมูลแบบสด และหน่วยความจำเพียงพอที่จะทำให้ระเบียบวิธีการติดป้ายคงที่ขณะที่หลักฐานสะสมเพิ่มขึ้น
กระบวนการอ้างอิงเชิงความหมายตรวจสอบข้ออ้างก่อนเข้าสู่การสังเคราะห์ได้อย่างไร?
กระบวนการอ้างอิงเชิงความหมายตรวจสอบข้ออ้างด้วยการปฏิบัติต่อการอ้างอิงทุกครั้งเป็นสมมติฐานที่ต้องจับคู่กับเอกสารแหล่งข้อมูล ไม่ใช่เครื่องประดับที่จัดรูปแบบไว้ท้ายย่อหน้า หากข้ามขั้นตอนนี้ การสังเคราะห์ข้ามสาขาจะรับช่วงเอกสารอ้างอิงที่ถูกประดิษฐ์หรือคลาดเคลื่อนทั้งหมดที่ตัวสร้างเนื้อหาผลิตขึ้น
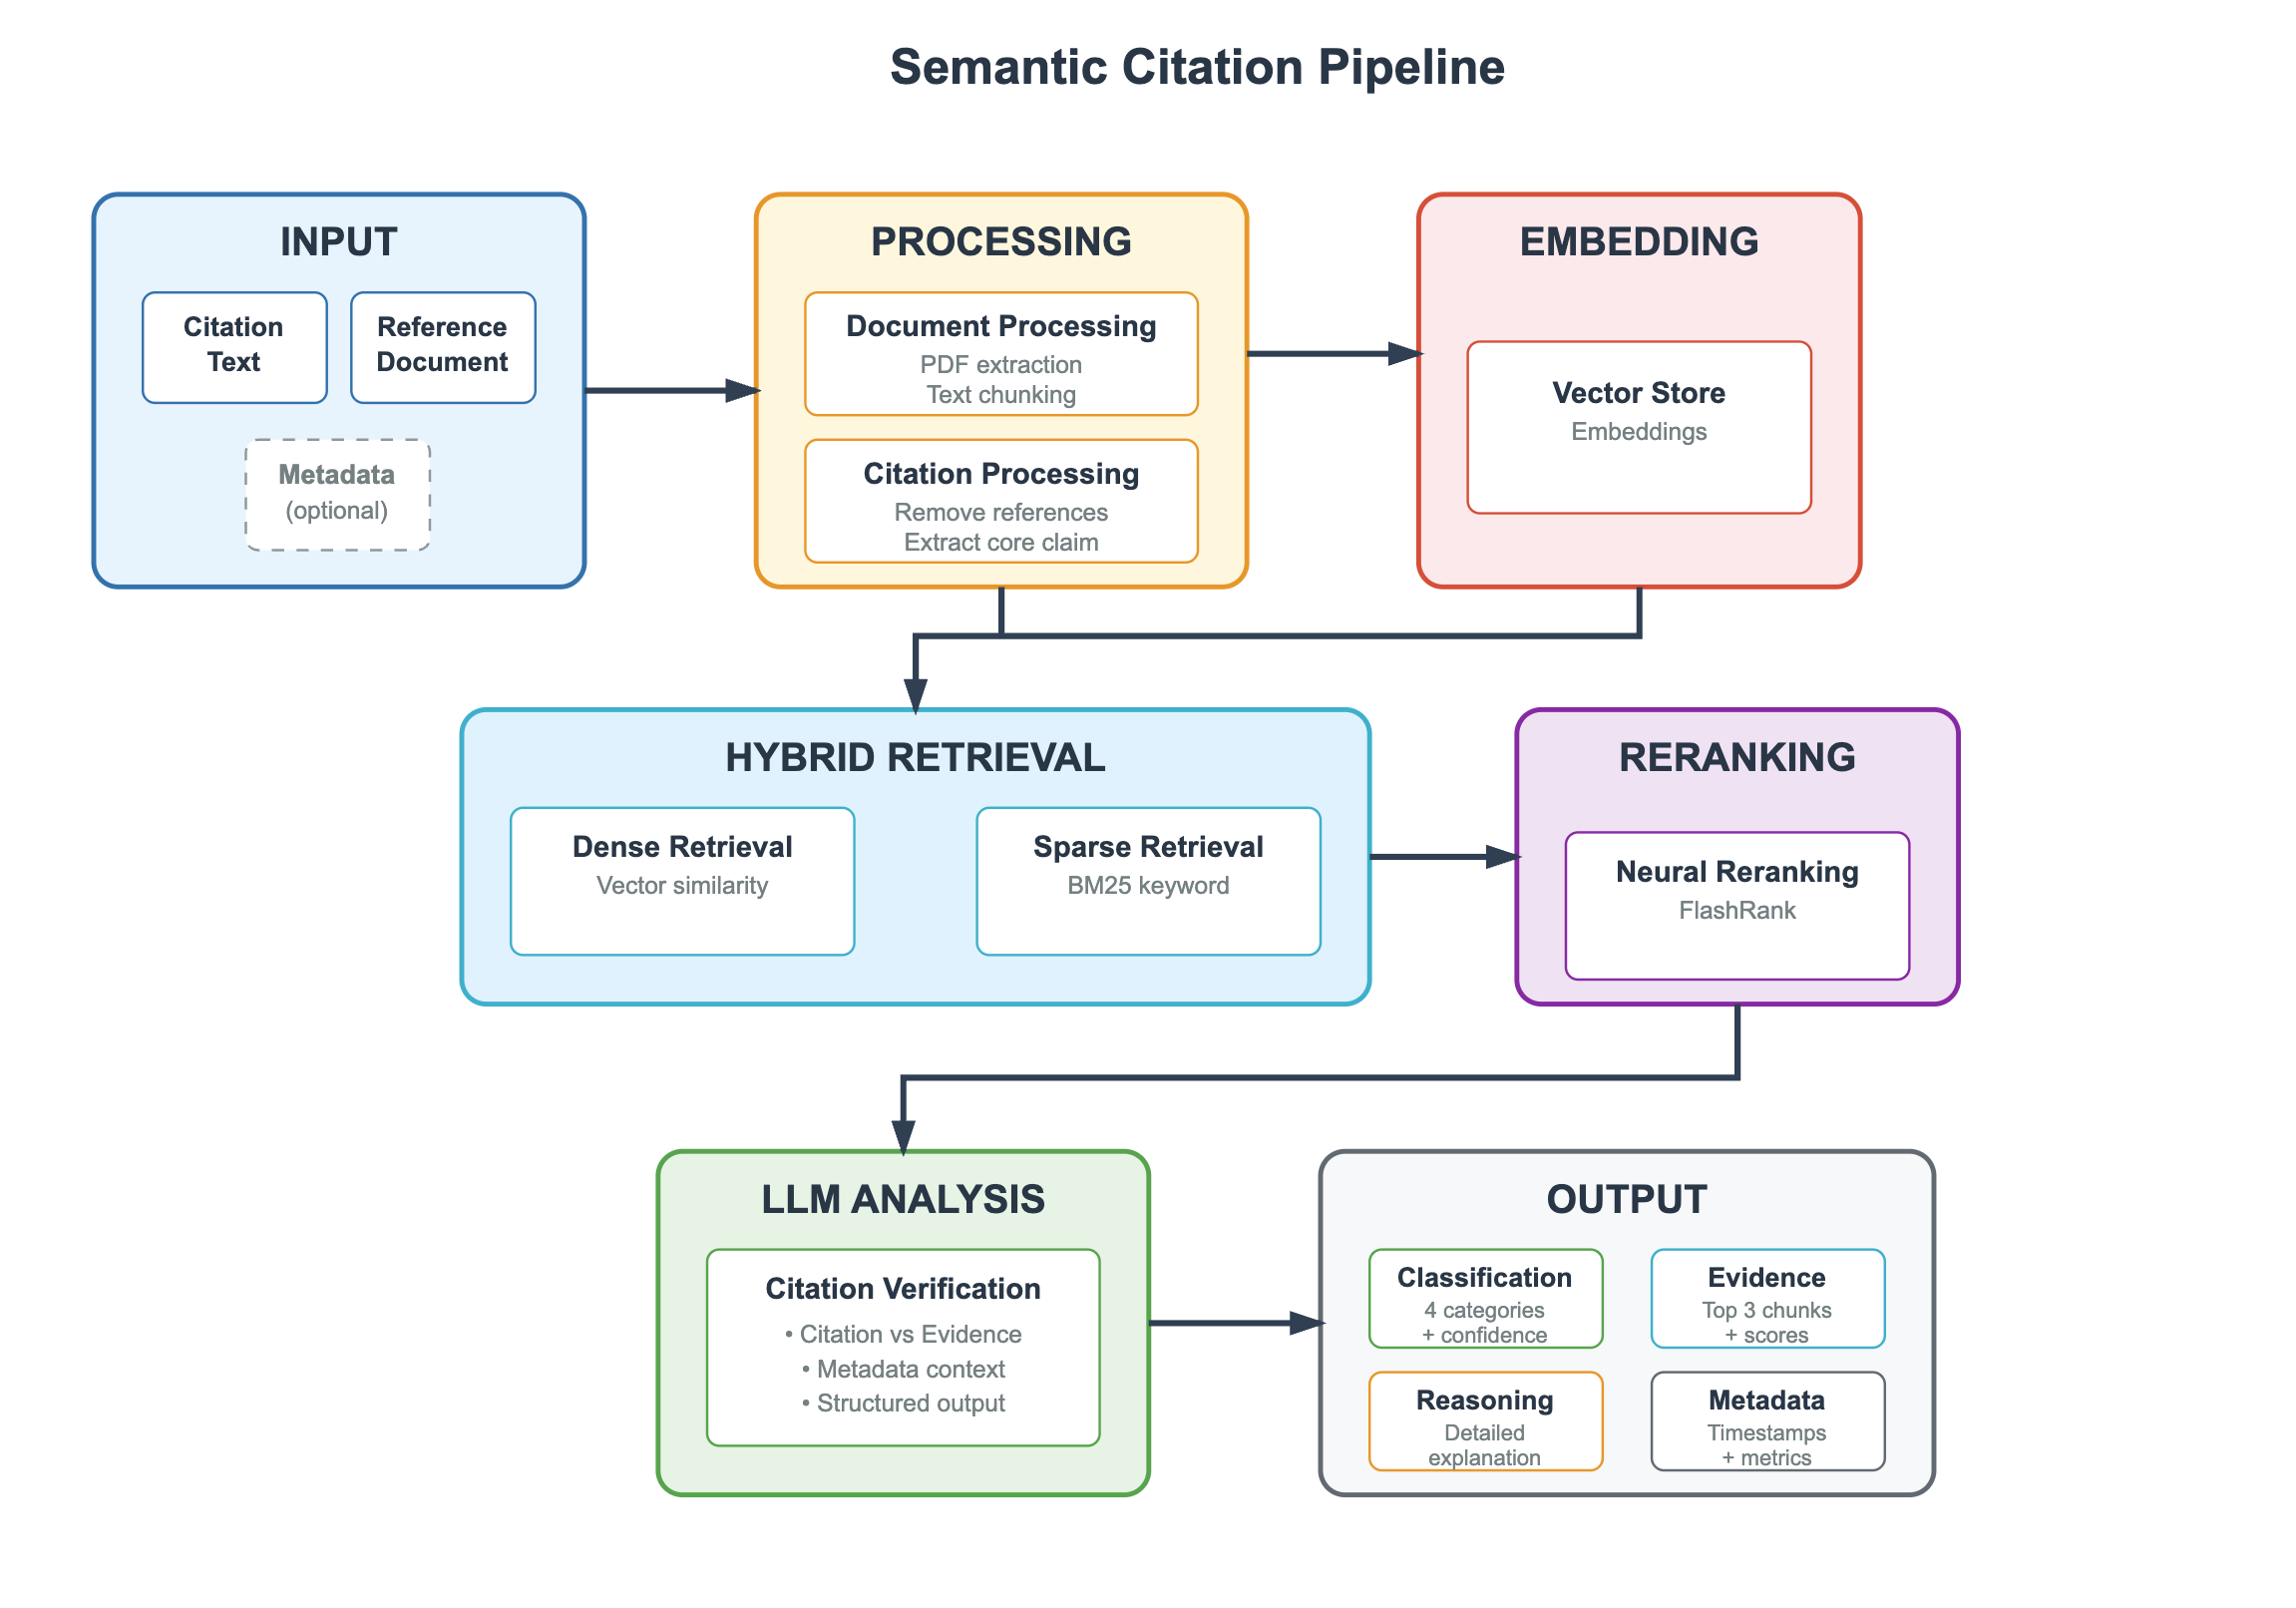
การพิจารณา pipeline ระดับใช้งานจริงแสดงลำดับที่ตายตัว ข้อมูลนำเข้า (Input) คือข้อความการอ้างอิง เอกสารอ้างอิง และ metadata ทางเลือก การประมวลผล (Processing) สกัดข้อความ PDF แบ่งเป็นส่วนข้อความ ลบรายการอ้างอิงออกเพื่อไม่ให้โมเดล “ตรวจสอบ” ข้ออ้างด้วยการอ่านบรรณานุกรม และแยกข้ออ้างหลักออกมา การสร้าง Embedding (Embedding) จัดเก็บส่วนข้อความเหล่านั้น จากนั้น การดึงข้อมูลแบบผสม (Hybrid retrieval) จะทำ dense vector search และ sparse BM25 แบบขนาน ซึ่งจำเป็นเพราะศัพท์เฉพาะสาขาและสัญลักษณ์ทางสถิติมักทำให้การค้นหา embedding ล้วนล้มเหลว การจัดอันดับใหม่ด้วยระบบประสาท (Neural reranking) เช่น FlashRank จะเก็บช่วงข้อความอันดับสูงสุดไว้ หลังจากนั้นเท่านั้น การวิเคราะห์ด้วย LLM (LLM analysis) จึงจัดประเภทความสัมพันธ์ระหว่างข้ออ้างกับหลักฐาน
ผลลัพธ์ที่มีประโยชน์ไม่ใช่การผ่านหรือไม่ผ่านแบบทวิภาค การจัดประเภทสี่ทางพร้อมระดับความเชื่อมั่น ได้แก่ สนับสนุน โต้แย้ง ไม่ได้กล่าวถึง หรือกล่าวถึงเพียงบางส่วน รวมถึงช่วงหลักฐานอันดับต้นและเหตุผลที่เขียนอธิบาย คือสิ่งที่เอเจนต์สังเคราะห์ควรนำเข้า รูปแบบนี้สอดคล้องกับแนวโน้มที่กว้างขึ้นสู่การตรวจสอบข้ออ้างระดับหลักฐานที่อธิบายได้ และสอดคล้องกับสิ่งที่หน่วยงานการสอนของมหาวิทยาลัยแนะนำแล้วเมื่ออธิบายผู้ช่วย AI ที่สกัดหลักฐานแทนการประดิษฐ์เรื่องเล่า
แม้มี pipeline แล้ว ยังเหลือรูปแบบความล้มเหลวสองประการ ประการแรก ข้อสรุปของผู้เขียนที่อ้างอย่างถูกต้องอาจยังถูกจัดเข้าหมวดข้อเท็จจริงอย่างผิดพลาด หากตัวจำแนกละเลยบริบทของส่วนเนื้อหา เช่น ผลลัพธ์เทียบกับการอภิปราย ประการที่สอง การดึงข้อมูลแบบผสมอาจแสดงประโยคที่คล้ายกันมากจากบทความอีกฉบับในสาขาเดียวกัน ซึ่งเป็นการเลื่อนการอ้างอิงผ่านการถอดความ ดังนั้น การตรวจโดยมนุษย์ของช่วงข้อความอันดับต้นจึงเป็นส่วนหนึ่งของวิธีการ ไม่ใช่การยอมรับความพ่ายแพ้
เวิร์กโฟลว์ Jenova สามารถประมาณ pipeline นี้ได้โดยกำหนดให้ต้องมีข้อความอ้างพร้อมตัวระบุตำแหน่งก่อนอนุญาตให้ข้ออ้างเข้าสู่บันทึกการสังเคราะห์ จากนั้นเรียกใช้ Deep Research เป็นรอบที่สองเหนือบรรณานุกรมชุดเดิม เครื่องมือเหล่านี้ไม่ได้แทนบริการตรวจสอบการอ้างอิงเฉพาะทางที่มีตัวชี้วัดการประเมินแบบตรึงไว้ สำหรับบทวิทยานิพนธ์และการส่งวารสาร ให้ส่งออกตารางหลักฐานและตรวจสอบด้วยตนเอง
คุณจะสั่งเอเจนต์วิจัย AI ให้แยกข้อเท็จจริง ข้อสรุป และข้ออนุมานได้อย่างไร?
คุณต้องสั่งเอเจนต์ด้วยระเบียบวิธีถาวรที่กำหนดป้ายกำกับ ห้ามการยกระดับสถานะข้ออ้างโดยเงียบ ๆ และขอตารางความขัดแย้งก่อนเรื่องเล่าข้ามโดเมนทุกครั้ง การเลือกเครื่องมือมีความสำคัญ แต่ prompt ที่ไม่มีป้ายกำกับจะทำให้ FCI ยุบรวมบนทุกแพลตฟอร์ม
สำหรับ Academic Research Assistant ของ Jenova การตั้งค่าที่ยั่งยืนมีลักษณะดังนี้:
- เปิดเอเจนต์ที่ jenova.ai/a/academic-research-assistant และระบุคำถามวิจัย สาขาที่อยู่ในขอบเขต และขอบเขตวันที่
- วางระเบียบวิธี FCI ถาวร (บันทึกใน custom instructions หากต้องการให้กฎเดียวกันใช้ข้ามเซสชัน):
“ระเบียบวิธีการทำงาน: ติดป้ายทุกประโยคเป็น [FACT], [AUTHOR CONCLUSION] หรือ [AI INFERENCE] ข้อเท็จจริงต้องมีตัวระบุตำแหน่งแหล่งข้อมูล ข้อสรุปของผู้เขียนต้องระบุชื่อบทความและคงถ้อยคำที่แสดงความระมัดระวังไว้ ข้ออนุมานของ AI รวมถึงการทำแผนที่ข้ามโดเมน การก้าวข้ามเชิงเหตุเป็นผล หรือข้อเสนอแนะที่แหล่งข้อมูลไม่ได้ระบุ หากหลักฐานขัดแย้งกัน ห้ามเฉลี่ยผล จัดทำตาราง: Claim | Layer | Source | Locator | Agreement (support / contradict / absent)”
- สร้างคลังเอกสารเริ่มต้น แนบ PDF ที่คุณเชื่อถืออยู่แล้ว จากนั้นขอให้ค้นพบแหล่งเพิ่มเติม แทนที่จะปล่อยให้การค้นหาครั้งแรกกำหนดทั้งสาขา
- กำหนดให้ส่งมอบงานแบบเป็นชั้น ได้แก่ บรรณานุกรมพร้อมคำอธิบาย ผลการค้นพบติดป้าย FCI แล้วจึงเป็นบทสังเคราะห์สั้นที่ไม่สามารถเพิ่มข้อเท็จจริงใหม่ได้
prompt ในรอบแรกที่มักสร้างโครงสร้างใช้งานได้:
“คำถาม: ความรุนแรงของปรากฏการณ์เกาะความร้อนในเมือง คุณภาพที่อยู่อาศัย และการเข้ารับการรักษาฉุกเฉินจากโรคหัวใจและหลอดเลือด มีความสัมพันธ์กันอย่างไรในเมืองรายได้สูงตั้งแต่ปี 2015? สาขา: ภูมิอากาศวิทยา ระบาดวิทยา เศรษฐศาสตร์เมือง ผลลัพธ์: (1) แผนที่แหล่งข้อมูล (2) ผลการค้นพบติดป้าย FCI (3) บันทึกความขัดแย้ง (4) ข้ออนุมานของ AI ที่ระบุไว้ท้ายสุดและทำเครื่องหมายว่ายังไม่ผ่านการทดสอบ ห้ามอ้างอิงสิ่งใดที่คุณยังไม่ได้ดึงมา”
สำหรับ Elicit วินัยที่เทียบเท่ากันอยู่ที่การออกแบบคอลัมน์มากกว่าป้ายในร้อยแก้ว สร้างฟิลด์การสกัดแยกต่างหากสำหรับ ผลลัพธ์ที่รายงาน การตีความของผู้เขียน ประชากร และ ข้อจำกัดที่ระบุ ตามเวิร์กโฟลว์จากคำถามสู่การสกัดข้อมูลของเครื่องมือ อย่าใช้คอลัมน์ “ข้อค้นพบหลัก” เพียงคอลัมน์เดียว เพราะคอลัมน์นั้นคือจุดที่คำกริยาในส่วนอภิปรายถูกยกระดับเป็นผลลัพธ์
สำหรับ Chatbot ทั่วไป ให้เพิ่มการตรวจสอบเชิงเผชิญหน้าที่การศึกษาของ Nature ชี้ว่าจำเป็น: ขอคำพูดอ้างโดยตรง แล้วตรวจสอบการอ้างอิงทุกฉบับอย่างอิสระในฐานข้อมูลห้องสมุด การถามโมเดลเดียวกันว่า “การอ้างอิงนี้มีจริงหรือไม่?” นั้นไม่น่าเชื่อถือ หากโครงการเป็นการทบทวนอย่างเป็นระบบ ให้ใช้เครื่องมือคัดกรองที่อธิบายไว้ในแนวทางห้องสมุดด้านการสังเคราะห์หลักฐานสำหรับการตัดสินใจคัดเข้า และไม่ให้ Chatbot มีส่วนในการตัดสินคุณสมบัติ
Deep Research บน Jenova เป็นขั้นตอนติดตามที่ดีกว่าเมื่อบรรณานุกรมมีขนาดใหญ่และคุณต้องการการทบทวนรอบสองที่มีการอ้างอิงหนาแน่น ควรใช้หลังจากวางกฎ FCI แล้ว ไม่ใช่เป็นการกวาดค้นครั้งแรกแบบไม่มีป้ายกำกับ
นักระเบียบวิธีวิจัยกล่าวอย่างไรเกี่ยวกับแหล่งที่มาของหลักฐาน AI?
นักระเบียบวิธีวิจัยมองการสังเคราะห์ด้วย AI ที่ไม่มีป้ายกำกับว่าเป็นความล้มเหลวด้านการรายงาน ไม่ใช่การเพิ่มผลิตภาพ: หากผู้อ่านมองไม่เห็นว่าประโยคอยู่ในชั้นใด เอกสารนั้นยังไม่ใช่หลักฐาน มุมมองนี้สอดคล้องกับการยืนยันของ PRISMA เรื่องการสังเคราะห์อย่างโปร่งใส และการศึกษาความซื่อสัตย์ของการอ้างอิงที่มองเอกสารอ้างอิงปลอมเป็นภัยต่อบันทึกเชิงหลักฐาน
“รูปแบบความล้มเหลวที่เราเห็นไม่ใช่ว่าโมเดลอ่านบทความไม่ได้ แต่คือมันเขียนด้วยเสียงเชิงญาณวิทยาเพียงเสียงเดียว ตัวเลขวิธีวิทยา วลีที่แสดงความระมัดระวังจากส่วนอภิปราย และการเปรียบเทียบข้ามสาขา ออกจากโมเดลมาเป็นภาษาอังกฤษที่มั่นใจเท่ากัน คณะกรรมการข้ามสาขาจึงถกเถียงกันเรื่องข้อสรุป ทั้งที่ควรถกเถียงกันเรื่องชั้นของข้ออ้าง หากประโยคหนึ่งตอบไม่ได้ว่า ‘ใครกล่าวอ้างสิ่งนี้ และสิ่งนั้นถูกวัดหรือถูกอนุมาน?’ ประโยคนั้นไม่ควรเข้าสู่บทสรุปผลลัพธ์”
“การติดป้าย FCI มีต้นทุนต่ำกว่าการถอนกลับภายหลัง ทีมที่บังคับให้มีตัวระบุตำแหน่งก่อนการสังเคราะห์จะใช้เวลามากกว่าในรอบแรก และใช้เวลาน้อยกว่ามากในการแกะรอยการเลื่อนการอ้างอิง การศึกษา ChatGPT ของ Nature ยังคงเป็นกรณีฐานสำหรับการเตือน: แม้การสร้างข้อมูลปลอมจะลดลงมาก ก็ยังเหลืออัตราความผิดพลาดที่ยอมรับไม่ได้ในรายการอ้างอิง แหล่งที่มาคือระบบควบคุม ความลื่นไหลไม่ใช่”
“pipeline การจัดการและการตรวจสอบการอ้างอิงคือวิธีทำให้มาตรฐานดังกล่าวเกิดขึ้นจริง ดึงข้อมูลจากสาขาแบบขนานเมื่อสาขาเหล่านั้นไม่ได้ใช้โครงสร้างแนวคิดร่วมกัน ตรวจสอบข้ออ้างกับส่วนข้อความก่อนถึงตัวสังเคราะห์ แยกขั้นตอนการบูรณาการของโมเดลไว้ในบล็อกเฉพาะที่มีชื่อกำกับ สถาปัตยกรรมนี้อนุรักษนิยมกว่าบทสรุปจาก Chatbot ซึ่งนั่นคือประเด็น”
— Jenova Product Team, การออกแบบเอเจนต์วิจัย AI, มีประสบการณ์แปดปีในการสร้างเวิร์กโฟลว์การดึงข้อมูลและการระบุที่มาสำหรับผู้ใช้วิชาการและวิชาชีพ
นัยต่อการเลือกเครื่องมือมีขอบเขตชัดเจน เลือกระบบที่รักษาระเบียบวิธี แสดงแหล่งข้อมูล และยอมรับความขัดแย้งได้ อย่าเลือกเพียงระบบที่ฟังดูเหมือนเข้าใจงานข้ามสาขา
เมื่อใดที่การทบทวนโดยมนุษย์ควรมีอำนาจเหนือการสังเคราะห์ด้วย AI ข้ามสาขา?
การทบทวนโดยมนุษย์ควรมีอำนาจเหนือการสังเคราะห์ด้วย AI ทุกครั้งที่ข้ออ้างเปลี่ยนแปลงการตัดสินใจ ข้ามขอบเขตวิธีวิทยาของสาขา หรือตรวจสอบย้อนกลับไปยังตัวระบุตำแหน่งไม่ได้ ซึ่งครอบคลุมงานส่วนใหญ่ที่สมควรต้องสังเคราะห์ตั้งแต่แรก AI เป็นตัวคูณสำหรับการร่างและการดึงข้อมูล ไม่ใช่อำนาจเชิงญาณวิทยา
การแทรกแซงมีความจำเป็นอย่างไม่อาจต่อรองได้ในอย่างน้อยห้าเงื่อนไข:
- มี ภาษาที่สื่อถึงความเป็นเหตุเป็นผล ในการสังเคราะห์ แต่ไม่มีอยู่ในส่วนผลลัพธ์ของงานที่อ้างอิง
- อาจเกิด ความไม่ตรงกันของโครงสร้างแนวคิด ได้ เช่น “ความเครียด” ในจิตวิทยา เทียบกับ “ภาระอัลโลสแตติก” ในการแพทย์ หรือ “ความผันผวน” ในเศรษฐศาสตร์
- เกี่ยวข้องกับ แนวทางปฏิบัติหรือกฎหมาย; อัตราการหลอนในคำค้นทางกฎหมายสูงเป็นพิเศษในการทดสอบแบบควบคุม
- มีการบ่งชี้ถึง การรวมผลทางสถิติ โมเดลภาษาไม่สามารถทำ meta-analysis ที่ปกป้องได้เพียงด้วยการถอดความบทคัดย่อ และPRISMA 2020มีขึ้นเฉพาะสำหรับการทบทวนที่มีการสังเคราะห์
- ยังไม่ได้ทำ การตรวจสอบการอ้างอิง กับ PDF เอกสารอ้างอิงที่ถูกประดิษฐ์หรือกลายรูปยังพบได้บ่อยพอในปี 2026 จนวารสารและห้องสมุดมองว่าเป็นปัญหาด้านความซื่อสัตย์
การแบ่งงานเชิงปฏิบัติมีลักษณะดังนี้ Academic Research Assistant เสนอแผนที่แหล่งข้อมูล ป้าย FCI และบันทึกความขัดแย้ง Elicit หรือเครื่องมือคัดกรองรับผิดชอบการสกัดข้อมูลอย่างมีโครงสร้างเมื่อคลังเอกสารเป็นการทบทวนอย่างเป็นทางการ นักระเบียบวิธีมนุษย์ตัดสินการยกระดับชั้นและข้ออนุมานข้ามโดเมนทั้งหมด AI อาจเสนอการทำแผนที่ได้ แต่มีเพียงมนุษย์เท่านั้นที่อาจยกระดับให้เป็นข้อสรุป
เมื่อใช้อย่างนั้น การสังเคราะห์ด้วย AI ไม่ใช่สิ่งทดแทนวิจารณญาณข้ามสาขา แต่เป็นวิธีรักษาข้อเท็จจริง ข้อสรุปของผู้เขียน และข้ออนุมานของโมเดลไว้ในกระแสแยกต่างหากที่ตรวจสอบได้ เพื่อให้วิจารณญาณมีข้อมูลที่ซื่อสัตย์สำหรับทำงานต่อ
เอกสารอ้างอิง
- Rules Integrity Initiative — แหล่งที่มาและการฟอกแหล่งข้อมูล
- Walters & Wilder, Scientific Reports — การสร้างข้อมูลปลอมและข้อผิดพลาดในการอ้างอิงบรรณานุกรมที่สร้างโดย ChatGPT
- Forbes — AI ถูกกล่าวโทษว่าทำให้การอ้างอิงปลอมในบทความวิจัยเพิ่มขึ้น (2026)
- Enago — การหลอนของ AI ในการอ้างอิงงานวิจัย (2026)
- MIT Sloan — การรับมือการหลอนและอคติของ AI รวมถึงอัตราคำค้นทางกฎหมายของ Stanford HAI
- ห้องสมุด George Mason University — เครื่องมือ AI สำหรับการทบทวนวรรณกรรม
- King's College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- แถลงการณ์ PRISMA 2020
- Page et al., The BMJ — แถลงการณ์ PRISMA 2020
- EQUATOR Network — แนวทางการรายงาน PRISMA
- Elicit — AI สำหรับงานวิจัยวิทยาศาสตร์
- Paperguide — การเปรียบเทียบ Elicit กับ Scite (2026)
- PapersFlow — Elicit เทียบกับ Consensus AI
- The Drive AI — Elicit เทียบกับ Consensus เทียบกับ Semantic Scholar
- Omid Saffari — เครื่องมือวิจัย AI ที่ดีที่สุดปี 2026
- UNC Charlotte Library — การอ้างอิงที่ AI หลอนขึ้นมา
- Wu et al., AAAI — Evidence Inference Networks สำหรับการตรวจสอบข้ออ้างอย่างตีความได้
- PaperTrail — อินเทอร์เฟซข้ออ้าง-หลักฐานสำหรับยึดโยงผลลัพธ์ LLM ทางวิชาการ (arXiv)
- Zhang et al., EACL — การตรวจสอบข้ออ้างแบบหลายสื่อและอธิบายได้
- University of Iowa — การทบทวนวรรณกรรมที่มี AI ช่วย