AI ค้นหาหลักฐานและร่างคำตอบผู้ประเมินได้อย่างไร?
2026-08-22
อะไรทำให้เครื่องมือตอบผู้ประเมินที่ยึดหลักฐานแตกต่างจากการร่างด้วย AI ทั่วไป?
เครื่องมือที่ช่วยผู้เขียนตอบผู้ประเมินได้ดีในปี 2026 ไม่ใช่เครื่องมือที่เขียนร้อยแก้วได้ลื่นไหลที่สุด แต่เป็นเครื่องมือที่จับคู่ข้อคิดเห็นของผู้ประเมินแต่ละข้อกับหลักฐานที่อ้างอิงได้ ตรวจสอบว่าหลักฐานนั้นสนับสนุนข้ออ้างจริงหรือไม่ แล้วจึงร่างคำตอบที่มีน้ำหนักไม่เกินกว่าหลักฐานที่มีอยู่ Jenova's Academic Research Assistant ถูกออกแบบมาสำหรับวงจรที่ให้หลักฐานมาก่อนนี้ — การค้นคว้าวรรณกรรม การจัดการการอ้างอิง และการร่างที่ยึดต้นฉบับ — ขณะที่ Scite, Elicit, SciSpace และ Consensus ต่างครอบคลุมงานส่วนหนึ่งเดียวกันด้วยจุดแข็งที่แตกต่างกัน
สิ่งที่ทำให้เวิร์กโฟลว์การโต้แย้งด้วย AI ใช้งานได้จริง แทนที่จะเป็นเพียงงานเขียนลื่นไหลแต่เสี่ยง คือ:
✅ การค้นคืนข้อมูลระดับข้อคิดเห็น ไม่ใช่การรวบรวมวรรณกรรมก้อนเดียวสำหรับทั้งจดหมาย ✅ การตรวจสอบการอ้างอิงที่เปิดไปยังประโยคต้นทาง ไม่ใช่เพียงสตริงบรรณานุกรม ✅ ป้ายกำกับระดับการสนับสนุนสำหรับทุกข้ออ้าง — สอดคล้องเต็มที่ สอดคล้องบางส่วน ขัดแย้ง หรือไม่สามารถระบุได้ ✅ การร่างอย่างระมัดระวังที่สอดคล้องกับป้ายกำกับ แทนที่จะยกระดับคำว่า “ชี้ให้เห็น” เป็น “พิสูจน์ให้เห็น” ✅ การตรวจทานโดยมนุษย์ที่สามารถปฏิเสธ ทำให้แคบลง หรือลบประโยคที่ AI เสนอได้
รายงานของ Nature ปี 2026 เกี่ยวกับแบบสำรวจ Frontiers ในกลุ่มนักวิชาการราว 1,600 คนจาก 111 ประเทศ พบว่านักวิจัยมากกว่าครึ่งใช้ AI ระหว่างการประเมินโดยผู้ทรงคุณวุฒิมาแล้ว แรงกดดันเดียวกันนี้กำลังตกอยู่กับผู้เขียนที่ต้องเขียนจดหมายตอบกลับ เพื่อเปรียบเทียบเครื่องมืออย่างมีประโยชน์ ควรมองการค้นหาหลักฐาน การตรวจยืนยันการอ้างอิง และการปรับระดับข้ออ้างเป็นงานสามประเภทแยกกัน ไม่ใช่งานเขียนเพียงงานเดียว
เหตุใดจดหมายตอบผู้ประเมินจึงล้มเหลวเมื่อการอ้างอิงไม่ได้รับการตรวจสอบ?
การแก้ไขที่ล้มเหลวหรือล่าช้าส่วนใหญ่ไม่ได้พังเพราะผู้เขียนหยาบคาย แต่พังเพราะการอ้างอิงไม่ได้กล่าวอย่างที่จดหมายอ้าง การวิเคราะห์ที่สัญญาไว้ไม่มีอยู่ในต้นฉบับ หรือคำตอบกล่าวเกินกว่าที่บทความสนับสนุนได้อย่างอ่อน ๆ บรรณาธิการและผู้ประเมินตรวจพบความไม่สอดคล้องเหล่านี้ได้ภายในไม่กี่นาที
โมเดลสำหรับใช้งานทั่วไปทำให้รูปแบบความล้มเหลวนี้ง่ายขึ้น ไม่ได้ทำให้ยากขึ้น แนวทางจากมหาวิทยาลัยระบุชัดเจนว่า ระบบ AI มักสร้างการอ้างอิงที่ดูเหมือนจริงแต่ไม่มีอยู่จริง และการส่งเอกสารอ้างอิงที่ปลอมขึ้นถือเป็นการทุจริตทางวิชาการ แนวทางการใช้งานอย่างรับผิดชอบของ Stellenbosch University เสริมว่าเครื่องมือจำนวนมาก ไม่สามารถตรวจสอบเอกสารอ้างอิงกับฐานข้อมูลแบบสดได้แบบเรียลไทม์ จดหมายตอบกลับเป็นพื้นที่เสี่ยงสูงที่จะเรียนรู้บทเรียนนี้ เพราะการอ้างอิงใหม่ทุกครั้งคือคำมั่นโดยนัยว่าแหล่งข้อมูลนั้นมีอยู่จริงและสนับสนุนประโยคที่คุณเพิ่งเขียนอย่างตรงจุด
ยังมีความล้มเหลวอีกประเภทที่เงียบกว่า: บทความมีอยู่จริง แต่ถูกใช้ผิดประเภท บทความวิธีวิจัยที่ถูกอ้างเป็นหลักฐานผลลัพธ์ บทความทบทวนที่ถูกอ้างเป็นการทดลองปฐมภูมิ หรือผลจากประชากรอีกกลุ่มหนึ่งที่ถูกนำเสนอเป็นการยืนยันโดยตรง ทั้งหมดนี้ผ่านการตรวจ DOI ได้แต่ยังทำให้เข้าใจผิด Smart Citations ของ Scite มีขึ้นโดยเฉพาะเพื่อแสดงว่างานภายหลังสนับสนุน โต้แย้ง หรือเพียงกล่าวถึงข้ออ้างหนึ่งหรือไม่ ซึ่งเป็นปัญหาคนละเรื่องกับการตรวจว่ารูปแบบเอกสารอ้างอิงถูกต้องหรือไม่
เครื่องมือตรวจเอกสารอ้างอิงตามกฎมีความแข็งแกร่งจริงในชั้นกลไก PoolText ระบุว่าเครื่องมือตรวจเอกสารอ้างอิงด้วย AI มีความแม่นยำสูงมากสำหรับข้อผิดพลาดด้านรูปแบบ ข้อมูลที่ขาด เครื่องหมายวรรคตอน และรูปแบบ DOI สิ่งนี้จำเป็น แต่ยังไม่เพียงพอ ข้ออ้างที่ไม่รองรับแต่จัดรูปแบบอย่างสมบูรณ์แบบก็ยังเป็นการกล่าวเกินจริง
คุณควรมองหาอะไรในเวิร์กโฟลว์ AI สำหรับตอบผู้ประเมิน?
คุณควรประเมินเครื่องมือในหกมิติ ได้แก่ การแยกข้อคิดเห็น การค้นคืนหลักฐาน การตรวจยืนยันประโยคต้นทาง การจัดประเภทการสนับสนุนข้ออ้าง การร่างอย่างปรับระดับ และความจำการแก้ไข เครื่องมือที่ทำได้ดีเพียงมิติเดียวจะยังสร้างจดหมายที่ดูเสร็จแล้ว ทั้งที่ยังไม่พร้อมส่ง
กรอบการจับคู่ข้อคิดเห็นกับหลักฐาน ที่ใช้ในบทความนี้ให้น้ำหนักหกมิติดังนี้:
- การแยกข้อคิดเห็น (15%) — ระบบสามารถแยกคำขอของผู้ประเมินแต่ละข้อ รวมถึงข้อคิดเห็นที่ซ่อนความต้องการสองอย่างไว้ในย่อหน้าเดียวได้หรือไม่?
- การค้นคืนหลักฐาน (20%) — ระบบค้นหาต้นฉบับ ข้อมูลของผู้เขียน และวรรณกรรมภายนอกแยกกันหรือไม่ แล้วระบุได้หรือไม่ว่าการสนับสนุนมาจากแหล่งใด?
- การตรวจยืนยันประโยคต้นทาง (20%) — มนุษย์สามารถเปิดดูประโยคที่ตรงกันซึ่งควรสนับสนุนคำตอบได้หรือไม่?
- การจัดประเภทการสนับสนุนข้ออ้าง (20%) — การอ้างอิงที่เสนอมาทุกรายการถูกติดป้ายว่าได้รับการสนับสนุน สนับสนุนบางส่วน ไม่ได้รับการสนับสนุน หรือไม่แน่ชัดหรือไม่?
- การร่างอย่างปรับระดับ (15%) — ร้อยแก้วสืบทอดระดับตามป้ายกำกับ หรือใช้ภาษาอังกฤษเชิงวิชาการที่มั่นใจเป็นค่าเริ่มต้น?
- ความจำการแก้ไข (10%) — ระบบจำรอบก่อนหน้า การวิเคราะห์ที่เคยสัญญาไว้ และถ้อยคำที่เคยปฏิเสธได้หรือไม่?
การให้น้ำหนักนี้มีเจตนา การร่างเป็นส่วนที่มีต้นทุนต่ำที่สุดของงาน การค้นคืนและการจัดประเภทคือจุดที่จดหมายจะกลายเป็นงานที่อ้างอิงได้ หรือกลายเป็นปัญหาสำหรับการประเมินรอบที่สอง งานวิจัยที่เปรียบเทียบการประเมินโดย AI กับมนุษย์ยังไม่พบคุณค่าเพิ่มของ AI เหนือผู้ประเมินมนุษย์อย่างเป็นข้อสรุป ซึ่งเป็นคำเตือนที่มีประโยชน์สำหรับผู้เขียนเช่นกัน: ความลื่นไหลไม่ใช่สัญญาณของความถูกต้อง
การทดสอบเชิงปฏิบัติที่เผยจุดอ่อนของเครื่องมือได้รวดเร็ว:
- ให้โมเดลรับข้อคิดเห็นที่บทความของคุณตอบได้ไม่ครบ แล้วดูว่ามันสร้างผลลัพธ์ขึ้นเองหรือไม่
- ขอให้โมเดลยกประโยคที่สนับสนุนจากบทความที่อ้างทุกฉบับ ไม่ใช่เพียงคีย์การอ้างอิง
- บังคับให้มีป้ายกำกับการสนับสนุนสี่ทางก่อนร่างประโยคตอบกลับใด ๆ
- ประมวลผลข้อคิดเห็นเดิมอีกครั้งในหนึ่งสัปดาห์ แล้วตรวจว่าจดหมายขัดแย้งกับการยอมรับข้อจำกัดก่อนหน้าหรือไม่
หากผลิตภัณฑ์ไม่สามารถล้มเหลวในการทดสอบเหล่านี้อย่างมองเห็นได้ มันไม่ได้ช่วยคุณ แต่มันกำลังซ่อนความไม่แน่นอนที่คุณควรจัดการ
เครื่องมือวิจัย AI ชั้นนำเปรียบเทียบกันอย่างไรในด้านการค้นคืนหลักฐานและการตรวจการอ้างอิง?
ในปัจจุบันยังไม่มีผลิตภัณฑ์เดียวที่ครองทั้งสามงาน — การค้นหาหลักฐานสำหรับข้อคิดเห็นแต่ละข้อ การตรวจยืนยันการอ้างอิง และการร่างคำตอบที่ไม่กล่าวเกินจริง การเปรียบเทียบที่เป็นประโยชน์คือเครื่องมือแต่ละตัวถูกสร้างมาเพื่อทำงานใดจริง ๆ
| ฟีเจอร์ / มิติ | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| การค้นคืนหลักฐาน | การค้นหาและสกัดข้อมูลด้วย AI ครอบคลุม บทความมากกว่า 125 ล้านฉบับ | การค้นหาวรรณกรรมแบบเรียลไทม์พร้อมฐานความรู้ที่แนบกับต้นฉบับ | เนื้อหาเต็มทางวิชาการที่ได้รับสิทธิ์และบริบทการอ้างอิงในคลังขนาดใหญ่ที่ได้รับการสนับสนุนจากสำนักพิมพ์ | เวิร์กโฟลว์เอเจนต์ที่ยึดบทความ มุ่งตอบข้อคิดเห็นผู้ประเมิน |
| การตรวจยืนยันการอ้างอิง | แข็งแกร่งด้านการสกัดอย่างมีโครงสร้าง; ข้อมูลถูกต้อง 1,502 จาก 1,511 จุด (99.4%) ในการทดสอบที่ Elicit รายงาน | ค้นคืนแหล่งข้อมูลและรายละเอียดการอ้างอิงที่เป็นไปได้; ยังคงต้องให้มนุษย์ยืนยันประโยคต้นทาง | ข้ออ้าง AI ทุกข้อเชื่อมไปยังประโยคเฉพาะในบทความเฉพาะ | มีประโยชน์สำหรับจัดทำชุดคำตอบ; ความลึกของการตรวจยืนยันขึ้นกับแหล่งข้อมูลพื้นฐาน |
| การร่างจดหมายตอบกลับ | ทางอ้อม — เหมาะกับตารางและคำตอบด้านวรรณกรรมมากกว่าจดหมายฉบับเต็ม | แข็งแกร่งสำหรับร่างแบบตอบทีละข้อเมื่อมีข้อคิดเห็นและต้นฉบับอยู่ในเซสชัน | ทางอ้อม — สร้างมาเพื่อทดสอบว่าข้อค้นพบยังคงยืนได้หรือไม่ ไม่ใช่เพื่อเขียนจดหมาย | เวิร์กโฟลว์ การร่างคำตอบผู้ประเมิน ที่ออกแบบมาเฉพาะ |
| สัญญาณการสนับสนุนข้ออ้าง | ความแม่นยำในการสกัด ไม่ใช่รูปแบบการสนับสนุนสี่ป้ายกำกับ | การจัดประเภทที่ผู้ใช้กำหนดภายในวงจรการร่าง | บริบทการอ้างอิงแบบสนับสนุน โต้แย้ง และกล่าวถึง | โครงสร้างที่สอดคล้องกับผู้ประเมินมากกว่าระบบจัดประเภทการสนับสนุนอย่างเป็นทางการ |
| ราคา (ณ ปี 2026) | ไม่ได้รับการยืนยันในการทบทวนนี้ | ระดับใช้งานฟรีมีข้อจำกัด; แผนชำระเงินเริ่มต้นที่ $20/เดือน | ไม่ได้รับการยืนยันในการทบทวนนี้ | ไม่ได้รับการยืนยันในการทบทวนนี้ |
| เหมาะที่สุดสำหรับ | การสกัดอย่างเป็นระบบและตารางหลักฐาน | วงจรการแก้ไขแบบครบวงจรที่ผูกอยู่กับต้นฉบับหนึ่งฉบับ | ตรวจว่าวรรณกรรมสนับสนุนประโยคจริงหรือไม่ | ผู้เขียนที่ต้องการเอเจนต์ร่างคำโต้แย้งโดยเฉพาะ |
Elicit แข็งแกร่งที่สุดเมื่อผู้ประเมินขอการเปรียบเทียบที่ขาดหาย แผนผังงานที่เกี่ยวข้องที่ชัดขึ้น หรือตัวเลขที่สกัดจากชุดการศึกษา สรุปจากคู่มือวิจัยของ George Mason University อธิบายว่าเป็นเครื่องมือที่ สรุปบทความและสกัดข้อมูลเป็นมุมมองหลักฐานแบบมีโครงสร้าง ข้อจำกัดสำหรับคำโต้แย้งคือขอบเขต: ตารางหลักฐานที่ยอดเยี่ยมยังไม่ใช่จดหมายที่ปรับโทนอย่างเหมาะสม และมันจะไม่หยุดคุณโดยอัตโนมัติจากการยกระดับผลที่สกัดมาเป็นข้ออ้างเชิงสาเหตุ
Scite แข็งแกร่งที่สุดเมื่อความเสี่ยงคือการอ่านวรรณกรรมผิด มันค้นหา บทความวิชาการมากกว่า 300 ล้านฉบับ และที่สำคัญกว่านั้น คือแสดงว่าบทความภายหลังปฏิบัติต่อข้ออ้างหนึ่งอย่างไร นี่คือเครื่องมือที่เหมาะสมเมื่อผู้ประเมินบอกว่า “การอ้างอิงนี้ไม่สนับสนุนข้อสรุปของคุณ” หรือเมื่อคุณอยากอ้างบทความหมุดหมายราวกับว่าสาขานั้นยังเห็นพ้องกับมันอยู่ มันอ่อนกว่าในฐานะเลขานุการการแก้ไขแบบครบวงจร: เพียงลำพังมันจะไม่ดูแลจดหมายตอบกลับ 14 ข้อคิดเห็น ติดตามเลขบรรทัดในต้นฉบับ หรือจำสิ่งที่คุณยอมรับในรอบแรก
SciSpace เป็นหนึ่งในไม่กี่ผลิตภัณฑ์ที่ปฏิบัติต่อ “การตอบผู้ประเมิน” เป็นเวิร์กโฟลว์ระดับแรก แทนที่จะเป็นคำสั่งแชต จุดเน้นนี้เป็นข้อได้เปรียบจริงเมื่อคุณต้องการโครงสร้าง ข้อจำกัดที่ตามมาคือข้อจำกัดเดียวกับเอเจนต์การร่างทุกประเภท: ผลลัพธ์ที่มีโครงสร้างยังอาจกล่าวเกินผลลัพธ์ได้ หากชั้นหลักฐานด้านล่างบางเกินไป
Consensus เป็นเอนจินค้นหาวรรณกรรมผ่านการประเมินโดยผู้ทรงคุณวุฒิ ซึ่งออกแบบมาเพื่อ ค้นหา จัดระเบียบ และวิเคราะห์ข้ออ้างทางวิทยาศาสตร์ได้อย่างรวดเร็ว มันมีประโยชน์สำหรับส่วน “ปัจจุบันสาขานี้กล่าวว่าอย่างไร?” ของคำโต้แย้ง แต่ไม่ใช่ผู้ตรวจสอบการอ้างอิงและไม่ใช่เครื่องมือจัดรูปแบบจดหมาย
Jenova's Academic Research Assistant อยู่ระหว่างเครื่องมือเฉพาะทางเหล่านี้ มันสามารถเก็บต้นฉบับ PDF ของผู้ประเมินและจดหมายโต้ตอบก่อนหน้าไว้ในพื้นที่ทำงานถาวรเดียว ค้นหาวรรณกรรม และร่างคำตอบทีละข้อคิดเห็นได้ มันยังไม่มีการนับการอ้างอิงแบบสนับสนุนเทียบกับโต้แย้งในสไตล์ Scite โดยกำเนิด และไม่ใช่เครื่องมือส่งออกชุดการแก้ไขที่พร้อมใช้ใน Word ในความหมายที่ เวิร์กโฟลว์ตอบผู้ประเมินของ PeerReply โฆษณาไว้ ช่องว่างเหล่านี้เป็นข้อจำกัดที่ควรยอมรับอย่างตรงไปตรงมา จุดแข็งที่ชดเชยคือความต่อเนื่อง: การแก้ไขที่กินเวลาหกสัปดาห์ต้องการความจำมากกว่าตัวสร้างจดหมายแบบครั้งเดียวจบ
Paper Digest ควรเพิ่มเข้ามาในฐานะผู้เชี่ยวชาญเฉพาะด้าน การมุ่งตรวจสอบข้ออ้างของมันใกล้เคียงกับ Scite มากกว่าแชตบอตสำหรับร่างข้อความ จึงเหมาะเป็นผู้ตรวจรอบที่สองมากกว่านักเขียนรอบแรก
เอนจิน Q&A หลายมิติค้นหาหลักฐานสนับสนุนสำหรับข้อคิดเห็นแต่ละข้อได้อย่างไร?
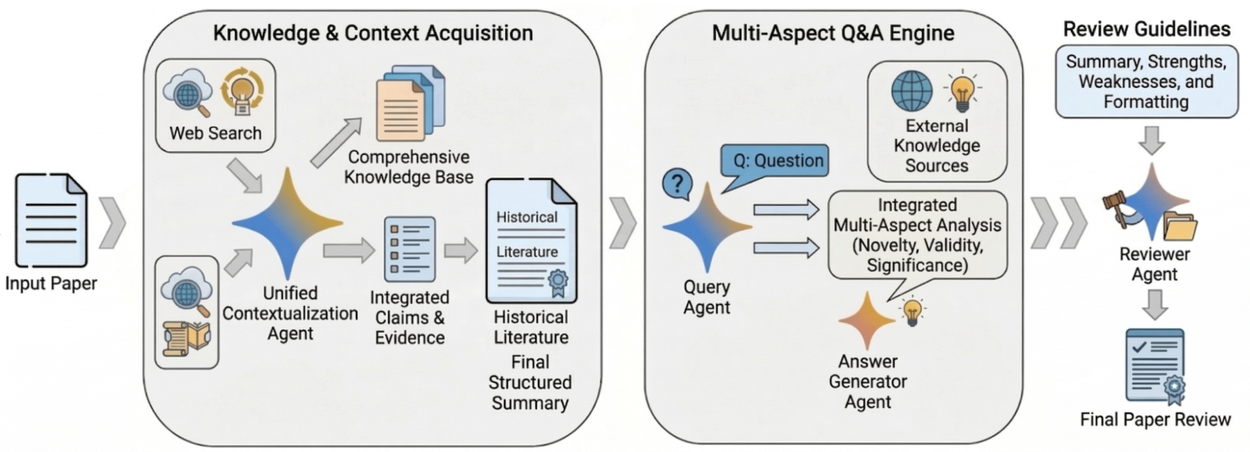
ระบบที่น่าเชื่อถือไม่ได้ “อ่านบทวิจารณ์แล้วเขียนจดหมาย” แต่มันเปลี่ยนข้อคิดเห็นผู้ประเมินแต่ละข้อเป็นคำค้น ค้นคืนจากแหล่งความรู้สามกลุ่มแยกจากกัน แล้วจึงตัดสินว่าควรเขียนคำตอบได้หรือไม่ นั่นคือสถาปัตยกรรมที่แผนภาพไปป์ไลน์ด้านบนแสดงไว้: รับความรู้ก่อน ตอบคำถามหลายมิติเป็นลำดับถัดมา และสังเคราะห์เป็นขั้นสุดท้าย
ควรแยกแหล่งข้อมูลสามกลุ่มออกจากกัน:
- กลุ่มต้นฉบับ — รูป ตาราง วิธีการ ข้อจำกัด และการวิเคราะห์ใด ๆ ที่คุณทำไปแล้ว
- กลุ่มข้อมูลผู้เขียน — บันทึกห้องปฏิบัติการ การตรวจสอบความทนทานเพิ่มเติม พจนานุกรมข้อมูล และจดหมายตอบกลับก่อนหน้า
- กลุ่มวรรณกรรม — บทความที่กล่าวถึงข้อคัดค้านของผู้ประเมินโดยตรง ซึ่งค้นคืนผ่านการค้นหาแบบ Scholar แทนความจำของโมเดล
การปะปนกลุ่มข้อมูลเหล่านี้คือจุดเริ่มต้นของการกล่าวเกินจริง ประโยคที่จริงในวรรณกรรมไม่ใช่ผลลัพธ์ในบทความของคุณ การตรวจความไวในสมุดบันทึกไม่ใช่ตารางที่เผยแพร่ เอเจนต์ค้นหาที่มีประสิทธิภาพจะถามคำถามต่างกันสามข้อสำหรับข้อคิดเห็นเดียว: สิ่งนี้อยู่ในต้นฉบับแล้วหรือไม่? หากไม่อยู่ ผู้เขียนมีหลักฐานที่ยังไม่เผยแพร่หรือไม่? หากไม่อยู่ วรรณกรรมสนับสนุนข้ออ้างแบบจำกัด การแก้ไข หรือการยอมรับข้อจำกัดหรือไม่?
ในทางปฏิบัติ ขั้นตอนการค้นคืนสำหรับ Jenova's Academic Research Assistant มีลักษณะดังนี้:
- แนบต้นฉบับ จดหมายตัดสิน และเอกสารเสริม
- ขอรายการคำขอของผู้ประเมินแบบมีหมายเลข รวมถึงคำขอโดยนัย
- สำหรับทุกคำขอ ให้บังคับค้นหาจากสามกลุ่มก่อนเริ่มร่าง:
“ผู้ประเมิน 2 ข้อคิดเห็น 3 ถามว่าผลยังคงอยู่หรือไม่เมื่อไม่รวมกลุ่มตัวอย่างย่อยปี 2019 ให้ค้นหาเฉพาะต้นฉบับที่แนบมาก่อน อ้างข้อความจากตาราง ส่วน หรือประโยคที่ตอบคำถามนี้ หากไม่พบ ให้ระบุว่า ‘ไม่อยู่ในต้นฉบับ’ และบอกว่าต้องทำการวิเคราะห์ใด ห้ามอ้างบทความภายนอกราวกับเป็นผลลัพธ์ของเรา”
- เอเจนต์ควรค้นหาวรรณกรรมหรือเสนอการวิเคราะห์ใหม่หลังจากหาไม่พบในต้นฉบับเท่านั้น
ผลิตภัณฑ์โต้แย้งเฉพาะทางก็ใช้การแบ่งแยกคล้ายกัน Manusights ให้เหตุผลว่าโมเดลภาษาทั่วไปยังคงเป็นเครื่องมือที่ใช้งานได้จริงที่สุดสำหรับการร่างจดหมายเอง ซึ่งถูกต้องในแง่ร้อยแก้ว เอนจินหลักฐานยังต้องอยู่ก่อนหน้าโมเดลร้อยแก้วนั้น มิฉะนั้นจดหมายจะกลายเป็นการกล่าวซ้ำอย่างมั่นใจจากสิ่งที่แชตบอตพบว่าใกล้เคียงที่สุด ไม่ใช่สิ่งที่หลักฐานรองรับ
ความใหม่ ความถูกต้อง และความสำคัญ — แกนวิเคราะห์สามด้านในเอนจินการประเมินหลายมิติ — ก็เป็นสามแกนที่ข้อคิดเห็นผู้ประเมินส่วนใหญ่ตั้งอยู่จริง ข้อคิดเห็นเรื่องเส้นฐานที่ขาดหายเป็นคำถามด้านความถูกต้อง ข้อคิดเห็นเรื่องการมีส่วนร่วมแบบเพิ่มขึ้นทีละน้อยเป็นคำถามด้านความใหม่ และข้อคิดเห็นเรื่องเหตุผลที่คนอื่นควรใส่ใจเป็นคำถามด้านความสำคัญ การติดป้ายข้อคิดเห็นในลักษณะนี้ป้องกันไม่ให้ตอบข้อคัดค้านด้านความถูกต้องด้วยย่อหน้าเรื่องความสำคัญ
AI ควรจัดประเภทการสนับสนุนการอ้างอิงอย่างไรก่อนที่คุณจะยกแหล่งข้อมูล?
การอ้างอิงทุกฉบับในจดหมายตอบกลับควรได้รับหนึ่งในสี่ป้ายกำกับก่อนอนุญาตให้เข้าสู่ร่าง: ได้รับการสนับสนุน สนับสนุนบางส่วน ไม่ได้รับการสนับสนุน หรือไม่แน่ชัด หากระบบกำหนดป้ายกำกับไม่ได้ ก็ไม่ควรกำหนดเชิงอรรถ
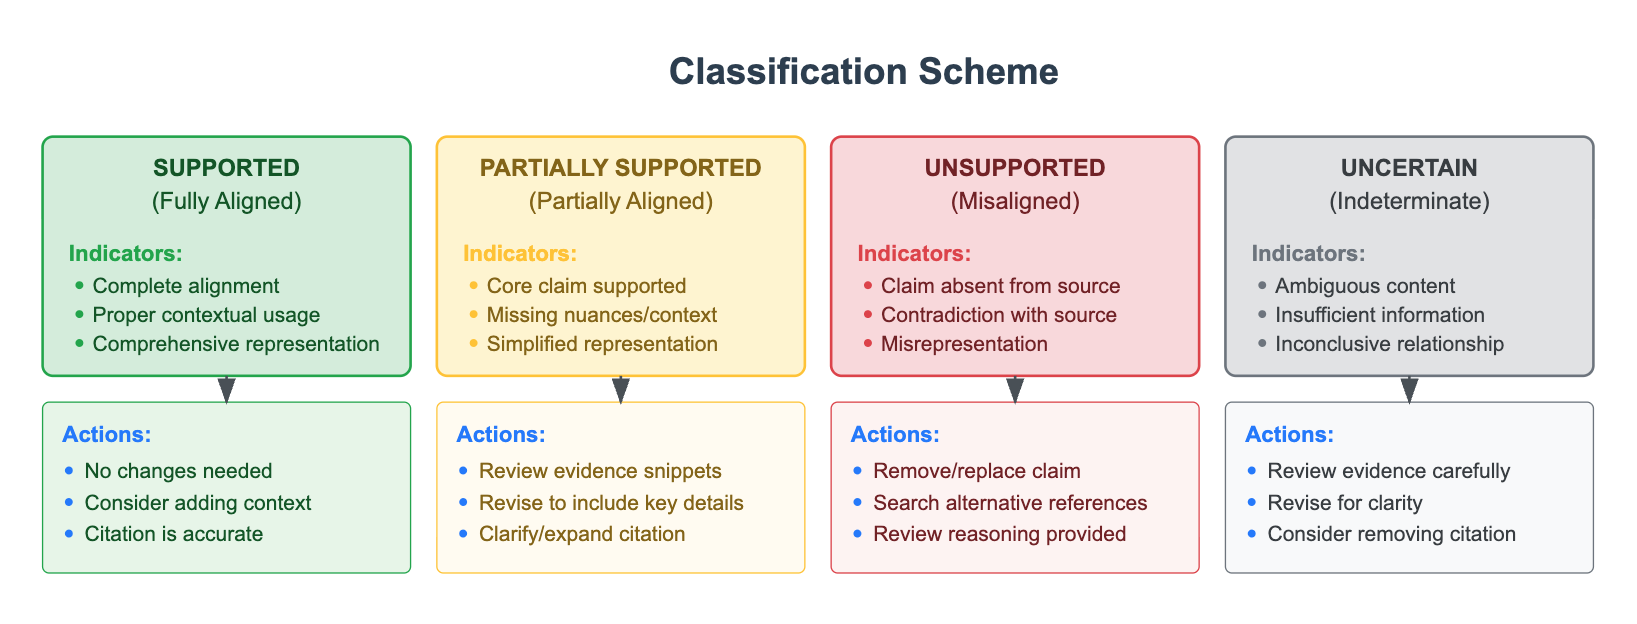
การจัดประเภทนี้คือความแตกต่างระหว่างผู้ตรวจสอบการอ้างอิงกับผู้ตรวจสอบข้ออ้าง
ได้รับการสนับสนุน หมายความว่าแหล่งข้อมูลระบุข้ออ้างนั้นในขอบเขต ประชากร และระดับความเป็นเหตุเป็นผลเดียวกับที่คุณกำลังจะใช้ การดำเนินการ: คงการอ้างอิงไว้ พิจารณาเพิ่มวลีบริบทสั้น ๆ เพื่อให้ผู้ประเมินเห็นความสอดคล้อง
สนับสนุนบางส่วน หมายความว่าข้อเท็จจริงหลักอยู่ในแหล่งข้อมูล แต่ประโยคของคุณตัดเงื่อนไข ข้อจำกัดกลุ่มตัวอย่าง หรือผลรองที่ขัดแย้งออกไป การดำเนินการ: เขียนประโยคใหม่ให้รวมความละเอียดอ่อนที่ขาดไป หรือแทนการอ้างอิงด้วยแหล่งข้อมูลปฐมภูมิที่ดีกว่า นี่คือป้ายกำกับที่ซื่อสัตย์และพบบ่อยที่สุดในการโต้แย้งจริง และเป็นป้ายที่แชตบอตทั่วไปมักทำให้แบนราบเป็น “ได้รับการสนับสนุน”
ไม่ได้รับการสนับสนุน หมายความว่าข้ออ้างไม่มีอยู่ ถูกโต้แย้ง หรือถูกใช้ในลักษณะที่แหล่งข้อมูลไม่อนุญาต การดำเนินการ: ลบหรือแทนที่ อย่าคงการอ้างอิงไว้เพียงเพราะรายชื่อผู้เขียนมีชื่อเสียงหรือ DOI เปิดได้
ไม่แน่ชัด หมายความว่า PDF อยู่หลังการชำระเงิน ส่วนที่เกี่ยวข้องมีความกำกวม หรือไม่อาจกำหนดความสัมพันธ์ระหว่างข้ออ้างกับแหล่งข้อมูลจากข้อความที่มีอยู่ได้ การดำเนินการ: เปิดอ่านบทความ หรือตัดการอ้างอิงออก ความไม่แน่ชัดไม่ใช่รูปแบบที่อ่อนลงของการสนับสนุน
Scite นำแนวคิดใกล้เคียงกับระบบนี้ไปใช้กับวรรณกรรมในระดับกว้าง โดยแสดงว่าบทความภายหลัง สนับสนุน ท้าทาย หรืออภิปรายข้อค้นพบหนึ่ง สิ่งนี้มีค่ามากสำหรับการอ้างอิงภายนอก แต่มันไม่ได้จัดประเภทประโยคใหม่ของคุณเทียบกับรูปของคุณเอง สำหรับข้ออ้างภายในต้นฉบับ เวิร์กโฟลว์การร่างต้องใช้ระบบสี่ป้ายกำกับนี้ด้วยตนเอง
คำสั่งที่บังคับใช้ระบบนี้:
“สำหรับทุกประโยคที่คุณเสนอในคำตอบต่อผู้ประเมิน 1 ให้แสดง: (1) ประโยค (2) การอ้างอิง (3) ข้อความคำต่อคำจากแหล่งข้อมูลหรือต้นฉบับ (4) หนึ่งป้ายกำกับ — ได้รับการสนับสนุน / สนับสนุนบางส่วน / ไม่ได้รับการสนับสนุน / ไม่แน่ชัด และ (5) การเขียนใหม่ที่ป้ายกำกับนั้นกำหนด ห้ามรวมประโยคใดที่มีป้ายกำกับว่าไม่ได้รับการสนับสนุน เขียนประโยคที่สนับสนุนบางส่วนใหม่ทั้งหมดก่อนแสดงให้ฉันดู”
การเปรียบเทียบเอนจินค้นหาด้วย AI ของ Columbia Journalism Review พบความล้มเหลวด้านการอ้างอิงอย่างเป็นระบบ แม้แหล่งข่าวที่ระบุจะเป็นสื่อที่มีชื่อเสียง เครื่องมือวิชาการทำได้ดีกว่าเอนจินตอบคำถามบนเว็บเปิดในมิตินี้ แต่รูปแบบความล้มเหลวเหมือนกัน: ชื่อสถาบันที่น่าเชื่อถือถูกใช้แทนประโยคที่ผ่านการตรวจสอบ ประตูสี่ป้ายกำกับมีไว้เพื่อหยุดการแทนที่นี้
คุณจะร่างคำตอบแบบตอบทีละข้อโดยไม่กล่าวเกินข้อสรุปได้อย่างไร?
ให้ร่างหลังจากมีป้ายกำกับแล้ว และให้ป้ายกำกับเป็นผู้เลือกกริยา “แสดงให้เห็น” “พิสูจน์” และ “ยืนยัน” ควรสงวนไว้สำหรับข้ออ้างที่ได้รับการสนับสนุนและมีขอบเขตสอดคล้องกัน ข้ออ้างที่สนับสนุนบางส่วนควรใช้ “สอดคล้องกับ” “ตอบประเด็นได้บางส่วน” หรือ “ยังคงอยู่ภายใต้ [ข้อจำกัดที่ระบุ]” ข้ออ้างไม่แน่ชัดไม่ควรมีกริยา แต่ควรมีแผนหรือการลบออก
โครงร่างจดหมายตอบกลับที่สะอาดมีลักษณะดังนี้:
- กล่าวซ้ำประเด็นของผู้ประเมินด้วยภาษากลาง
- ระบุสิ่งที่คุณทำ: มีอยู่แล้วในบทความ วิเคราะห์ใหม่ หรือยอมรับข้อจำกัด
- ชี้ไปยังตำแหน่ง: หน้า บรรทัด ตาราง รูป หรือเอกสารเสริม
- อ้างงานภายนอกเฉพาะเมื่อข้อคิดเห็นเกี่ยวกับวรรณกรรม และต้องมีป้ายกำกับการสนับสนุนเท่านั้น
- ปิดท้ายด้วยการแก้ไขต้นฉบับที่แน่นอน หรือเหตุผลแบบจำกัดว่าทำไมจึงไม่ได้แก้ไข
Jenova's Academic Research Assistant สามารถรักษาโครงร่างนี้ตลอดจดหมายยาวได้ หากคุณให้ข้อจำกัดไว้ตั้งแต่ต้น:
“ร่างคำตอบต่อผู้ประเมิน 2 โดยใช้เฉพาะรายการที่ได้รับการสนับสนุนและรายการสนับสนุนบางส่วนที่เขียนใหม่แล้วจากตารางหลักฐาน ใช้รายการกริยาที่ฉันให้ไว้ ทุกย่อหน้าต้องมีตำแหน่งอ้างอิงในต้นฉบับหรือการยอมรับข้อจำกัดอย่างชัดเจน ห้ามนำเสนอการทดลองในอนาคตราวกับทำเสร็จแล้ว ห้ามอธิบายส่วนอภิปรายของบทความที่อ้างราวกับเป็นผลลัพธ์ของเรา”
สำหรับ SciSpace หรือโมเดลทั่วไปที่ใช้เป็นผู้เขียนจดหมาย ต้องวางข้อจำกัดเดียวกันนี้ลงไป เพราะผลิตภัณฑ์การร่างมักปรับให้เหมาะกับความครบถ้วนและความสุภาพ ความครบถ้วนคือที่มาของการวิเคราะห์ที่ไม่มีอยู่จริง ความสุภาพคือวิธีที่ความเห็นต่างถูกยกระดับเป็น “เราเห็นด้วยและได้แสดงให้เห็นแล้ว”
การใช้ถ้อยคำระมัดระวังไม่ใช่การตกแต่ง แต่เป็นคุณสมบัติของความเที่ยงตรง ถ้อยคำระมัดระวังที่มีประโยชน์ควรเฉพาะเจาะจง:
- การจำกัดขอบเขต: “ในกลุ่มตัวอย่างนี้” “ภายใต้ข้อกำหนดเชิงเส้น” “ในกลุ่มผู้เข้าร่วมที่มีการติดตามผลครบถ้วน”
- การจำกัดเชิงญาณวิทยา: “สอดคล้องกับ” “ยังไม่ตัดความเป็นไปได้ของ” “ให้การสนับสนุนเบื้องต้น”
- การจำกัดเชิงกระบวนการ: “ขณะนี้เรารายงาน” “เราได้เพิ่ม” “เราไม่สามารถทดสอบได้ด้วยการออกแบบปัจจุบัน”
การยกระดับที่ควรห้ามในร่างคำโต้แย้ง ได้แก่ การเปลี่ยนสหสัมพันธ์เป็นผลกระทบ การเปลี่ยนการตรวจความทนทานเป็นการทำซ้ำ การเปลี่ยนผลที่ไม่มีนัยสำคัญเป็น “ไม่มีความแตกต่าง” และการเปลี่ยนการอ้างอิงสนับสนุนเพียงฉบับเดียวเป็น “เป็นที่ยอมรับอย่างกว้างขวาง” แนวทางเกี่ยวกับการเขียนวิชาการโดยใช้ AI ชี้ว่าผู้เขียนยังคงรับผิดชอบในการตรวจว่าข้อความที่สร้างขึ้นตรงกับข้ออ้างจริงของต้นฉบับ วารสารแต่ละแห่งมีข้อกำหนดการเปิดเผยแตกต่างกัน แต่ สรุปกฎของสำนักพิมพ์โดย The Conversation ระบุว่าความช่วยเหลือเชิงกลไกตามปกติอาจไม่ต้องอ้างถึง ขณะที่เนื้อหาสาระที่ AI สร้างมักต้องเปิดเผย จดหมายตอบกลับที่มีการตีความวรรณกรรมซึ่งร่างโดยโมเดลมักอยู่ในกรณีหลัง
คู่มือเชิงปฏิบัติของ ProofreaderPro สำหรับจดหมายตอบผู้ประเมิน ถูกต้องเกี่ยวกับโครงสร้างและโทน แต่โครงสร้างและโทนไม่ใช่ส่วนที่ยาก ส่วนที่ยากคือการปฏิเสธที่จะตอบข้อคิดเห็นแรงกว่าที่ตารางของคุณอนุญาต หากผู้ประเมินขอกลยุทธ์ระบุความเป็นเหตุเป็นผลที่คุณไม่มี ร่างที่ซื่อสัตย์คือย่อหน้าระบุข้อจำกัด และหากทำได้คือการวิเคราะห์ที่อ่อนกว่าแต่ระบุได้ — ไม่ใช่การกล่าวซ้ำรีเกรสชันเดิมอย่างมั่นใจยิ่งขึ้น
คำสั่งสำหรับตรวจรอบที่สองเพื่อจับการกล่าวเกินจริง:
“เปรียบเทียบทุกย่อหน้าคำตอบกับตารางหลักฐาน ทำเครื่องหมายทุกประโยคที่ใช้กริยาแรงกว่าป้ายกำกับการสนับสนุน ทำเครื่องหมายทุกการอ้างอิงที่ไม่มีข้อความอ้างโดยตรง และทำเครื่องหมายทุกคำสัญญาที่ไม่สอดคล้องกับการแก้ไขต้นฉบับที่ติดตามไว้”
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยกล่าวอย่างไรเกี่ยวกับคำโต้แย้งที่ใช้ AI ช่วย?
นักวิจัยที่ทำงานด้านความซื่อสัตย์ของการประเมินโดยผู้ทรงคุณวุฒิมักกลับมาสู่ประเด็นเดิม: AI อาจเร่งการค้นคืนและการจัดรูปแบบได้ แต่ผู้เขียนยังคงเป็นเจ้าของค่าความจริงของทุกประโยคที่ส่งกลับไปยังบรรณาธิการ
“ความล้มเหลวที่เราเห็นแทบไม่ใช่เครื่องหมายจุลภาคที่หายไปในรายการอ้างอิง แต่เป็นประโยคที่แข็งแรงเกินไปหนึ่งระดับเชิงญาณวิทยาสำหรับบทความที่มันอ้าง โมเดลที่ถูกให้รางวัลเพราะความช่วยเหลือจะปิดช่องว่างนั้นให้คุณ เว้นแต่คุณจะห้ามมัน มาตรการควบคุมที่ต้นทุนต่ำที่สุดคือการออกแบบสถาปัตยกรรม: ค้นคืน ติดป้ายกำกับ แล้วจึงร่าง หากสลับลำดับ จดหมายจะมีข้ออ้างที่คุณพยายามหาเหตุผลสนับสนุนในภายหลัง”
“เครื่องมืออ้างอิงอัจฉริยะเปลี่ยนต้นทุนของการตรวจว่าสาขานั้นยังเชื่อบทความหนึ่งอยู่หรือไม่ แต่มันไม่ได้เปลี่ยนต้นทุนของการตรวจว่าตาราง 3 ของคุณเองสนับสนุนกริยาในย่อหน้า 6 ของคำตอบหรือไม่ การตรวจอย่างหลังยังคงเป็นมนุษย์อ่านตัวเลขข้างประโยค ผู้เขียนที่ข้ามขั้นนี้ไม่ได้ประหยัดเวลา แต่กำลังกู้เวลาจากรอบประเมินถัดไป”
“เรายังแนะนำให้ทีมเก็บบันทึกการปฏิเสธ ทุกครั้งที่โมเดลต้องการเขียนว่า ‘เราแสดงให้เห็น’ แต่ป้ายกำกับเป็นเพียงสนับสนุนบางส่วน ให้บันทึกประโยคที่ปฏิเสธไว้ หลังทำสองหรือสามบทความ คุณจะเห็นรูปแบบการกล่าวเกินจริงพื้นฐานของห้องปฏิบัติการคุณ — โดยทั่วไปคือกริยาเชิงสาเหตุ การสรุปเกินกลุ่มตัวอย่าง และการอ้างบทความทบทวนราวกับเป็นการทดลอง คำสั่งแบบกำหนดเองเป็นเพียงวิธีเข้ารหัสบันทึกนั้น”
— Jenova Product Team, การออกแบบเวิร์กโฟลว์วิชาการ, สนับสนุนระบบต้นฉบับและการอ้างอิงมาแปดปี
คำแนะนำนี้สอดคล้องกับวรรณกรรมวิจัยเกี่ยวกับ AI ในการประเมินเอง บททบทวนใน PMC เกี่ยวกับ AI ในการประเมินโดยผู้ทรงคุณวุฒิเน้นว่าผู้ประเมินยังต้องประเมินเนื้อหาที่ AI สร้างอย่างมีวิจารณญาณก่อนตัดสินใจใด ๆ ภาระหน้าที่เดียวกันนี้ใช้เมื่อ AI อยู่ฝ่ายผู้เขียนในจดหมายตัดสิน ผู้เขียนที่ใช้โมเดลระดับ ChatGPT ในการโต้ตอบเรื่องการประเมินโดยผู้ทรงคุณวุฒิได้รับคำเตือนโดยเฉพาะให้ทดสอบข้อเสนอแนะเทียบกับข้ออ้างหลักของต้นฉบับและความซื่อสัตย์ในการวิจัย
การทดสอบ AI กับคำตอบการประเมินโดยผู้ทรงคุณวุฒิของ Editage มีประโยชน์น้อยกว่าในฐานะการจัดอันดับแบบผู้ชนะเพียงรายเดียว แต่มากกว่าในรูปแบบที่มันเผยให้เห็น: โมเดลสามารถตัดสินได้ว่าคำตอบดูครบถ้วนหรือไม่ ขณะที่ยังอ่อนแอในการตัดสินว่าคำตอบนั้นจริงหรือไม่ ความดูครบถ้วนคือคุณสมบัติที่ทำให้จดหมายถูกส่งเร็วเกินไป
เมื่อใดที่คุณควรแทนที่คำตอบผู้ประเมินที่ AI ร่างไว้?
คุณควรแทนที่ร่างทุกครั้งที่ป้ายกำกับการสนับสนุนอ่อนกว่าประโยค ทุกครั้งที่ข้อคิดเห็นขอการตัดสินที่โมเดลไม่มีหลักฐานรองรับ หรือทุกครั้งที่การเห็นด้วยจะผูกมัดคุณกับข้ออ้างที่คุณไม่สามารถปกป้องได้ในรอบถัดไป การแทนที่คือเส้นทางปกติ ไม่ใช่เส้นทางยกเว้น
ควรแทนที่ทันทีในกรณีต่อไปนี้:
- เอเจนต์อ้างบทความที่คุณยังไม่ได้เปิดอ่าน
- เอเจนต์ตอบคำวิจารณ์ด้านวิธีวิจัยด้วยข้อความบทนำเพิ่มเติม โดยไม่มีการทดสอบใหม่
- เอเจนต์ปฏิบัติต่อความเข้าใจผิดของผู้ประเมินเสมือนเป็นคำขออ้างอิงเพิ่ม แทนที่จะเขียนคำอธิบายของคุณใหม่
- เอเจนต์ “พบ” การวิเคราะห์ที่ไม่มีอยู่ในคลังเก็บข้อมูล
- เอเจนต์เห็นด้วยกับผู้ประเมินสองคนที่ขอการวิเคราะห์ซึ่งเข้ากันไม่ได้ โดยไม่แจ้งความขัดแย้ง
- เอเจนต์ใช้บทความทบทวนเพื่อรองรับข้ออ้างเชิงประจักษ์ปฐมภูมิ
ข้อคิดเห็นบางประเภทไม่ควรถูกมอบหมายทั้งหมด คำขอเกี่ยวกับจริยธรรมการวิจัย การเข้าถึงข้อมูล ผลประโยชน์ทับซ้อน และความมีนัยสำคัญทางคลินิกหรือนโยบายของผลลัพธ์ ต้องการการตัดสินโดยมนุษย์ว่าคุณยินดีรับรองสิ่งใด AI ช่วยรวบรวมเอกสารได้ แต่ไม่อาจรับผิดชอบแทนคุณได้
ยังมีปัญหาย้อนกลับที่กำลังเพิ่มขึ้น: ปัจจุบันผู้เขียนพบข้อคิดเห็นผู้ประเมินที่ดูเหมือนสร้างขึ้นโดย AI คำตอบที่ถูกต้องยังคงต้องให้หลักฐานมาก่อน กล่าวซ้ำคำขอทางวิทยาศาสตร์ที่ปฏิบัติได้ในข้อคิดเห็นนั้น ตัดข้อความทั่วไปที่ไม่จำเป็นออก และตอบคำขอที่คุณบันทึกหลักฐานได้ การจับคู่บทวิจารณ์ที่ฟังดูเป็น AI ด้วยจดหมายที่ฟังดูเป็น AI เพียงเพิ่มข้อความที่ไม่มีหลักฐานในไฟล์เป็นสองเท่า
ขั้นตอนปิดงานแบบมนุษย์อยู่ในวงจรที่ใช้ได้สำหรับข้อคิดเห็นแต่ละข้อ:
- อ่านประโยคของผู้ประเมินและเขียนสรุปหกคำด้วยตัวเอง
- ยอมรับหรือปฏิเสธแถวหลักฐานของเอเจนต์ก่อนดูย่อหน้าที่ร่าง
- หากปฏิเสธแถวนั้น อย่าแก้ย่อหน้า ให้ส่งเอเจนต์กลับไปค้นคืนข้อมูล
- หากยอมรับแถวที่สนับสนุนบางส่วน ให้แก้กริยาด้วยตัวเอง
- จากนั้นจึงวางย่อหน้าลงในจดหมาย
เมื่อใช้ในลักษณะนี้ Jenova's Academic Research Assistant, Scite, Elicit และเอเจนต์ร่างเฉพาะทางอย่าง SciSpace จะเสริมกันแทนที่จะทดแทนกัน เครื่องมือค้นคืนลดโอกาสที่คุณจะพลาดบทความหนึ่ง การจัดประเภทลดโอกาสที่คุณจะใช้บทความนั้นผิด เครื่องมือร่างลดโอกาสที่จดหมายจะไร้ระเบียบ ไม่มีเครื่องมือใดลดโอกาสการกล่าวเกินจริงได้ เว้นแต่คุณปฏิเสธที่จะร่างจากข้ออ้างที่ยังไม่มีป้ายกำกับ
มาตรฐานที่ควรยึดถือเรียบง่ายพอจะวางไว้เหนือหน้าต่างคำสั่ง: หากคุณไม่สามารถชี้ไปยังประโยค ตาราง หรือการยอมรับข้อจำกัดที่รองรับกริยานั้นได้ ประโยคนั้นไม่ควรอยู่ในคำตอบ
เอกสารอ้างอิง
- Nature — นักวิจัยมากกว่าครึ่งใช้ AI สำหรับการประเมินโดยผู้ทรงคุณวุฒิแล้ว
- University of Pretoria Library — การจัดการการอ้างอิงและความเสี่ยงจาก AI สร้างข้อมูลเท็จ
- Stellenbosch University — แนวทางการใช้ AI อย่างรับผิดชอบในการเขียนวิชาการ
- Scite — Smart Citations และการตรวจยืนยันข้ออ้างระดับประโยค
- PoolText — สิ่งที่ AI ทำได้และทำไม่ได้ในการประเมินโดยผู้ทรงคุณวุฒิ รวมถึงการตรวจเอกสารอ้างอิง
- ScienceDirect — การเปรียบเทียบการประเมินที่สร้างโดย AI และมนุษย์
- Elicit — การค้นหาวรรณกรรมด้วย AI และความแม่นยำในการสกัดที่รายงาน
- George Mason University Libraries — เครื่องมือ AI สำหรับการทบทวนวรรณกรรม
- SciSpace — เวิร์กโฟลว์เอเจนต์ตอบผู้ประเมิน
- Consensus — การค้นหาด้วย AI บนวรรณกรรมที่ผ่านการประเมินโดยผู้ทรงคุณวุฒิ
- PeerReply — เวิร์กโฟลว์คำตอบทีละข้อและชุดการแก้ไข
- Paper Digest — การตรวจสอบข้ออ้างเทียบกับหลักฐานทางวิชาการ
- Manusights — เครื่องมือ AI ที่ดีที่สุดสำหรับตอบผู้ประเมิน
- Columbia Journalism Review — เอนจินค้นหาด้วย AI และความล้มเหลวด้านการอ้างอิง
- PMC — การเขียนวิชาการโดยใช้ AI ช่วย
- The Conversation — แนวทางของสำนักพิมพ์เกี่ยวกับ AI ในบทความวารสาร
- ProofreaderPro — วิธีเขียนจดหมายตอบผู้ประเมินโดยใช้ AI ช่วย
- PMC — AI ในการประเมินโดยผู้ทรงคุณวุฒิ
- PMC — การรับมือการประเมินโดยผู้ทรงคุณวุฒิด้วย ChatGPT 4
- Editage — การทดสอบ AI กับคำตอบการประเมินโดยผู้ทรงคุณวุฒิ
- ResearchGate — การอภิปรายเกี่ยวกับข้อคิดเห็นผู้ประเมินที่สร้างโดย AI