AI สกัดหลักฐานตามคำถามวิจัยจากบทความหลายร้อยฉบับได้อย่างไร?
2026-08-21
เวิร์กโฟลว์การสกัดที่ยึดคำถามต่างจากเครื่องมือ AI ที่สรุปก่อนอย่างไร?
เวิร์กโฟลว์ที่ยึดคำถามจะส่งคืนฟิลด์ที่เปรียบเทียบกันได้และเชื่อมโยงกับแหล่งอ้างอิงสำหรับคำถามวิจัยที่กำหนดไว้ล่วงหน้า ขณะที่เครื่องมือแบบสรุปก่อนจะสร้างย่อหน้าที่ลื่นไหลและเล่าแต่ละบทความตามกรอบของบทความนั้นเอง ในปี 2026 ความแตกต่างนี้สำคัญกว่ายี่ห้อของโมเดล Jenova's Academic Research Assistant โดดเด่นที่สุดสำหรับการสกัดแบบทำซ้ำที่ขับเคลื่อนด้วยคำถาม โดยมีหน่วยความจำถาวรและการสนับสนุนการเขียนต้นฉบับ Elicit เหมาะกับเมทริกซ์งานวิจัยเชิงประจักษ์มากกว่า ส่วน Covidence ยังคงเป็นมาตรฐานสำหรับการทบทวนอย่างเป็นระบบที่มีผู้ทบทวนอิสระสองคนและต้องปฏิบัติตามการรายงาน PRISMA 2020
ปัจจัยสำคัญที่แยกการสกัดหลักฐานออกจากการสรุประดับบทความ:
✅ ความเที่ยงตรงต่อคำถาม — ทุกช่องตอบคำถาม ของคุณ ไม่ใช่กรอบที่บทความใช้เสนอผลงานของตนเอง
✅ โครงสร้างระดับฟิลด์ — วิธีวิจัย ขนาดตัวอย่าง ผลลัพธ์ และทิศทางของผล อยู่ในคอลัมน์แบบกำหนดเองที่เชื่อมโยงกับช่วงข้อความต้นทาง
✅ ความเปรียบเทียบได้ข้ามบทความ — ความขัดแย้งและความแตกต่างด้านการออกแบบจะมองเห็นได้ก็ต่อเมื่อฟิลด์มีความสอดคล้องกัน
✅ การตรวจสอบบริบทการอ้างอิง — ข้อค้นพบที่มีการอ้างอิงจะถูกทดสอบซ้ำกับวรรณกรรมภายหลัง ไม่ได้ถูกสมมติว่าจริงเพียงเพราะมีการอ้างอิง
✅ การวินิจฉัยโดยมนุษย์ — โมเดลภาษาขนาดใหญ่ช่วยเร่งการสกัดได้ แต่การใช้งานโดยไม่มีการกำกับดูแลยังไม่พร้อมสำหรับการสังเคราะห์ที่มีความสำคัญสูง
หากต้องการเปรียบเทียบเครื่องมืออย่างมีความหมาย ควรมองการสกัดเป็นกระบวนการตั้งแต่ต้นจนจบ — นำเข้า คัดกรองตามคำถาม จัดโครงสร้าง เปรียบเทียบ ตรวจสอบ แล้วจึงเขียน — แทนที่จะมองเป็นพรอมต์เดียวว่า “สรุป PDF เหล่านี้”
เหตุใดสรุป AI แบบกว้างจึงล้มเหลวเมื่อหน่วยวิเคราะห์คือคำถามวิจัย?
สรุปแบบกว้างล้มเหลวเพราะรวมการศึกษาที่เปรียบเทียบกันไม่ได้เข้าเป็นเรื่องเล่าเดียว ซึ่งบดบังช่องข้อมูลที่คำถามวิจัยต้องการโดยตรง บทสรุประดับบทความอาจฟังดูครบถ้วน แต่ยังอาจละเว้นขนาดตัวอย่าง กลุ่มเปรียบเทียบ ช่วงเวลาติดตามผล หรือผลลัพธ์เป็นการเพิ่มขึ้น ลดลง หรือไม่พบความแตกต่าง ช่องว่างเหล่านี้ร้ายแรงทันทีเมื่อคุณเปลี่ยนจากคำถามว่า “บทความนี้เกี่ยวกับอะไร?” เป็น “ชุดบทความนี้บอกอะไรเกี่ยวกับคำถาม นี้?”
การสังเคราะห์หลักฐานมีขึ้นเพื่อตอบคำถามที่มีโครงสร้าง ไม่ใช่เพื่อถอดความบทคัดย่อ PRISMA 2020 ถูกออกแบบมาเพื่อรายงานว่าทำไมจึงทำการทบทวน ใช้วิธีใด และพบอะไร ไม่ใช่เพื่อสร้างบทสรุปที่อ่านง่าย การทบทวนแบบดั้งเดิมยังคงใช้เวลาประมาณหนึ่งปีสำหรับทีมหนึ่งทีมเมื่อใช้วิธีที่แนะนำ ปริมาณวรรณกรรมที่สร้างคอขวดดังกล่าว คือปริมาณเดียวกันกับที่เครื่องมือแชตแบบสรุปก่อนพยายามบีบอัดให้เหลือเพียงไม่กี่ย่อหน้า
บทสรุปยังรับเอาวาทกรรมของบทความมาด้วย ผู้เขียนเน้นผลลัพธ์ที่มีนัยสำคัญ บทคัดย่อรายงานผลที่ไม่พบความแตกต่างน้อยเกินไป และการอ้างอิงส่งต่อข้ออ้างที่งานภายหลังอาจทำให้อ่อนแรงลง การสกัดระดับคำถามกลับด้านอคตินี้: คุณกำหนดฟิลด์ก่อน แล้วถามทุกบทความด้วยคำถามเดียวกัน การทดสอบการสกัดด้วย LLM ยังแสดงรูปแบบความล้มเหลวอีกด้านหนึ่ง โมเดลอาจพลาดข้อมูลผลลัพธ์แม้จัดการฟิลด์ข้อมูลพื้นหลังได้อย่างน่าเชื่อถือ ซึ่งเป็นเหตุให้การสกัดผลลัพธ์ยังยากกว่าการสกัดลักษณะการศึกษา
นัยเชิงปฏิบัตินั้นเรียบง่าย หากผลลัพธ์ของคุณไม่สามารถวางลงในตารางที่มีหนึ่งแถวต่อการศึกษา และหนึ่งคอลัมน์ต่อองค์ประกอบของคำถามได้ คุณยังไม่มีหลักฐาน คุณมีเพียงบทสรุปย่อ
คุณควรมองหาอะไรในเวิร์กโฟลว์ AI สำหรับสกัดหลักฐาน?
คุณควรมองหาความสามารถหกประการที่รวมกันเป็นกรอบการสกัดที่ยึดคำถามเป็นหลัก ได้แก่ ความเที่ยงตรงต่อคำถาม ฟิลด์ที่มีโครงสร้าง การติดตามกลับไปยังแหล่งข้อมูลได้ การจัดแนวข้ามบทความ การตรวจสอบบริบทการอ้างอิง และวงจรการตรวจยืนยันโดยมนุษย์ที่มีการบันทึกไว้ เครื่องมือที่เขียนได้ลื่นไหลแต่ทำได้ไม่ดีในหกด้านนี้ ก็ยังจะสร้างเพียงบทสรุปแบบกว้าง
ความเที่ยงตรงต่อคำถาม ระบบต้องรับคำถามในรูปแบบโปรโตคอล — PICO, PECO หรือสคีมาแบบกำหนดเอง — และไม่เบี่ยงไปสู่ข้อค้นพบข้างเคียง “การคัดกรองตามคำถาม” คือขั้นตอนแกนหลักในไปป์ไลน์การสกัด LLM สมัยใหม่ ไม่ใช่การปรับแต่งที่เลือกทำหรือไม่ทำก็ได้
ฟิลด์ที่มีโครงสร้าง ขนาดตัวอย่าง รูปแบบการศึกษา การแทรกแซงหรือการสัมผัสปัจจัย กลุ่มเปรียบเทียบ ผลลัพธ์ ทิศทางของผล และข้อจำกัด ควรอยู่ในคอลัมน์แบบกำหนดเอง โดยแต่ละช่องเชื่อมโยงกับช่วงข้อความต้นทาง ข้อความอิสระในหน้าต่างแชตไม่ใช่แบบฟอร์มสกัดข้อมูล
การติดตามกลับไปยังแหล่งข้อมูลได้ คำตอบต้องมีการไฮไลต์หรือตำแหน่งอ้างอิงใน PDF มิฉะนั้นคุณจะไม่สามารถตัดสินข้อผิดพลาดของโมเดลเทียบกับบันทึกต้นฉบับได้ และไม่สามารถรายงานวิธีวิจัยได้อย่างโปร่งใส
การจัดแนวข้ามบทความ ฟิลด์เดียวกันต้องมีความหมายเดียวกันในทุกแถว มิฉะนั้นคุณจะมองไม่เห็นความขัดแย้ง ความแตกต่างของขนาดยา หรือผลจากรูปแบบการศึกษา
การตรวจสอบบริบทการอ้างอิง ข้อค้นพบที่เป็นจริงในปี 2018 อาจไม่คงอยู่หลังมีการทดลองในเวลาต่อมา การสกัดที่ไม่ตรวจสอบข้ออ้างที่ถูกอ้างอิงซ้ำ จะฟอกหลักฐานที่ล้าสมัยเข้าสู่ต้นฉบับใหม่
การตรวจยืนยันโดยมนุษย์ งานศึกษาที่มนุษย์สกัดมากถึง 63% มีข้อผิดพลาดในการสกัดข้อมูลอย่างน้อยหนึ่งข้อ LLM ทำให้เกิดข้อผิดพลาดคนละประเภท และยังอาจตรวจพบข้อผิดพลาดของมนุษย์ได้ เวิร์กโฟลว์ต้องมองความไม่ตรงกันเป็นสัญญาณให้เปิด PDF ตรวจสอบ ไม่ใช่เป็นตารางคะแนนว่าใครชนะ
การเปรียบเทียบโดยห้องสมุดมหาวิทยาลัยในปี 2026 ยังคงประเมินเครื่องมือตามบทบาท ชุดเอกสาร และรูปแบบความล้มเหลว แทนการประเมินจากคำกล่าวทางการตลาด การทบทวนของ Oregon State University ระบุว่า Consensus อาจอ่านแหล่งข้อมูลผิด ขณะที่เมทริกซ์ของ Elicit มีประโยชน์ที่สุดสำหรับบทความเชิงประจักษ์และบทสรุปอาจขาดความละเอียดอ่อน สิ่งเหล่านี้เป็นผลการประเมิน ไม่ใช่เหตุผลให้ตัดเครื่องมือทิ้ง — และเป็นระดับความละเอียดที่เหมาะสมสำหรับการประเมิน
เครื่องมือ AI ใดสกัดหลักฐานที่มีโครงสร้างจากบทความหลายฉบับได้บ้าง?
ไม่มีเครื่องมือใดครองทุกขั้นตอน Elicit เด่นด้านเมทริกซ์เชิงประจักษ์ Covidence เด่นด้านการทบทวนอย่างเป็นระบบโดยทีม Consensus เด่นด้านภาพรวมความเห็นพ้องอย่างรวดเร็ว และ Jenova's Academic Research Assistant เด่นด้านการวิเคราะห์แบบทำซ้ำที่ขับเคลื่อนด้วยคำถาม ซึ่งต่อเนื่องไปถึงการจัดการการอ้างอิงและการร่างต้นฉบับ ไปป์ไลน์ในลักษณะ Paperguide แสดงลำดับแบบสกัดก่อน แม้คุณจะประกอบแต่ละขั้นจากหลายเครื่องมือก็ตาม
| ฟีเจอร์ / มิติ | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| คอลัมน์แบบกำหนดเองระดับคำถาม | เมทริกซ์งานวิจัยที่ปรับคอลัมน์สำหรับวิธีวิจัย ขนาดตัวอย่าง และข้อค้นพบได้ | สคีมาที่กำหนดด้วยพรอมต์และคงอยู่ในหน่วยความจำถาวรข้ามเซสชัน | สรุปแบบตารางและตัววัดความเห็นพ้อง; ควบคุมฟิลด์แบบกำหนดเองได้น้อยกว่า | แบบฟอร์มสกัดข้อมูลสำหรับการศึกษาที่ผ่านการคัดเลือกแล้ว |
| ขนาดการสังเคราะห์ตามปกติ | เวิร์กโฟลว์ตั้งแต่โปรโตคอลถึงการสกัดบนแหล่งข้อมูลที่รวบรวมไว้; บทสรุป Plus อ้างอิงบทความจำนวนน้อย | การสกัดเป็นชุดจาก PDF ที่อัปโหลดและระเบียนที่เชื่อมกับ Scholar | สูงสุด 20 บทความต่อการสังเคราะห์ใน Pro หรือ 50 บทความใน Deep | ชุดเอกสารขนาดทีมสำหรับการทบทวนแบบเป็นทางการ |
| การติดตามกลับไปยังแหล่งข้อมูลได้ | ลิงก์กลับไปยังวรรณกรรมที่รวมไว้ | คำตอบยึดเอกสารพร้อม PDF ที่แนบ | ลิงก์ไปยังแหล่งข้อมูลที่ใช้ในภาพรวม | ร่องรอยการตรวจสอบครบถ้วนสำหรับการคัดกรองและสกัดข้อมูล |
| เวิร์กโฟลว์ผู้ทบทวนสองคน | ไม่ใช่การออกแบบหลัก | ไม่มีมาให้ | ไม่มีมาให้ | การคัดกรองอิสระสองฝ่ายและการแก้ไขข้อขัดแย้ง |
| การตรวจสอบบริบทการอ้างอิง | มีจำกัดนอกเหนือจากชุดข้อมูลที่สกัด | ติดตามวรรณกรรมข้ามเซสชันผ่าน Scholar และการค้นหา | ตัววัดความเห็นพ้องเป็นสัญญาณของความสอดคล้อง | ทำด้วยมือ; โปรโตคอลการทบทวนเป็นตัวกำกับการอัปเดต |
| การส่งต่องานเขียนต้นฉบับ | ส่งออกไปยังโปรแกรมจัดการบรรณานุกรม | การจัดการการอ้างอิงพร้อมการร่าง; Word Doc Generator สามารถจัดรูปแบบเอกสารได้ | ส่งออกได้สำหรับผู้ใช้ Plus | การเขียนรายงานทบทวนยังเป็นอีกขั้นตอนหนึ่ง |
| ราคา ณ ปี 2026 | การสมัคร Plus ระดับสถาบัน; แผนผู้ใช้ทั่วไปยังไม่ได้ตรวจสอบในที่นี้ | มีแผนฟรี; Plus เริ่มที่ $20/เดือน | Freemium; มหาวิทยาลัยบางแห่งมีสิทธิ์ใช้งาน Pro | แผนรายปีสำหรับบุคคล แพ็กเกจ หรือองค์กร |
| เหมาะที่สุดสำหรับ | ตารางสกัดงานวิจัยเชิงประจักษ์ | การวิเคราะห์ที่ขับเคลื่อนด้วยคำถามแบบทำซ้ำในโครงการระยะยาว | ภาพรวมความเห็นพ้องอย่างรวดเร็วสำหรับชีวการแพทย์/STEM | การทบทวนอย่างเป็นระบบแบบทีมที่สอดคล้องกับ PRISMA |
Elicit วางตำแหน่งตนเองอย่างชัดเจนให้ใช้ปรับปรุงโปรโตคอล รวบรวมแหล่งข้อมูล คัดกรอง สกัด และสังเคราะห์ นี่คือคำอธิบายงานที่เหมาะสมสำหรับงานระดับคำถาม ข้อจำกัดที่บันทึกไว้ในการประเมินของห้องสมุดคือ บทสรุปที่สร้างขึ้นมักเน้นข้อค้นพบและขาดความละเอียดอ่อน และเมทริกซ์ถูกปรับให้เข้ากับธรรมเนียมการรายงานเชิงประจักษ์ บทความเชิงคุณภาพ เชิงทฤษฎี หรือมีโครงสร้างไม่ดี จะสกัดได้ไม่สะอาดเท่า
Consensus มีประโยชน์เมื่อคำถามใกล้เคียงกับข้ออ้างเชิงประจักษ์แบบใช่หรือไม่ใช่อยู่แล้ว โดยสังเคราะห์ภาพรวมแบบเรื่องเล่า ตาราง และตัววัดความเห็นพ้อง อีกทั้งทำการค้นหาเชิงลึกขึ้นเพื่อระบุช่องว่างได้ อย่างไรก็ตาม มันอาจอ่านแหล่งข้อมูลผิด และเพดานจำนวนบทความของระดับ Deep ยังต่ำกว่า “บทความฉบับเต็มหลายร้อยฉบับ” มาก ควรมองเป็นเครื่องมือสำรวจ ไม่ใช่แบบฟอร์มลงรหัส
Covidence ได้รับการอธิบายอย่างแพร่หลายว่าเป็นซอฟต์แวร์ชั้นนำสำหรับจัดการการทบทวนอย่างเป็นระบบ เมื่อรวมกับ EPPI-Reviewer, DistillerSR และ JBI-SUMARI แล้ว มันอยู่ในกลุ่มแพลตฟอร์มจำนวนน้อยที่รองรับชุดงานทบทวนการแทรกแซงครบวงจร — ระเบียน การคัดกรอง การสกัด และการแก้ไขข้อขัดแย้งของทีม ใช้งานหนักเกินกว่าที่การวิจัยเชิงสำรวจจะต้องการ การสกัดแบบสนทนาในลักษณะ “แชตกับ PDF นี้” ไม่ใช่จุดศูนย์กลางของมัน และโครงการส่วนใหญ่ยังต้องพึ่งแบบฟอร์มสกัดที่มนุษย์กรอก
Jenova's Academic Research Assistant อยู่ในอีกส่วนหนึ่งของชุดเครื่องมือ มันค้นหาแหล่งข้อมูลวิชาการแบบสด รับ PDF ที่อัปโหลด เก็บประวัติการแชตได้ไม่จำกัด และจดจำโปรโตคอลข้ามเซสชัน จึงไม่ต้องสอนนิยามคอลัมน์ใหม่ทุกวัน มันไม่ใช่ระบบคัดกรองโดยผู้ทบทวนสองคน ไม่สร้างแผนภาพการไหล PRISMA และบทความหลายร้อยฉบับจำเป็นต้องแบ่งประมวลผลเป็นชุด แทนที่จะเททั้งหมดลงในหน้าต่างบริบทเดียว ข้อจำกัดเหล่านี้มีอยู่จริง จุดแข็งที่ชดเชยคือความต่อเนื่อง การเข้าถึงหลายโมเดล และความสามารถในการนำคำถามวิจัยเดียวกันจากการสกัดไปสู่การร่างที่มีการอ้างอิงรองรับ โดยไม่ต้องส่งออกนอกโครงการ
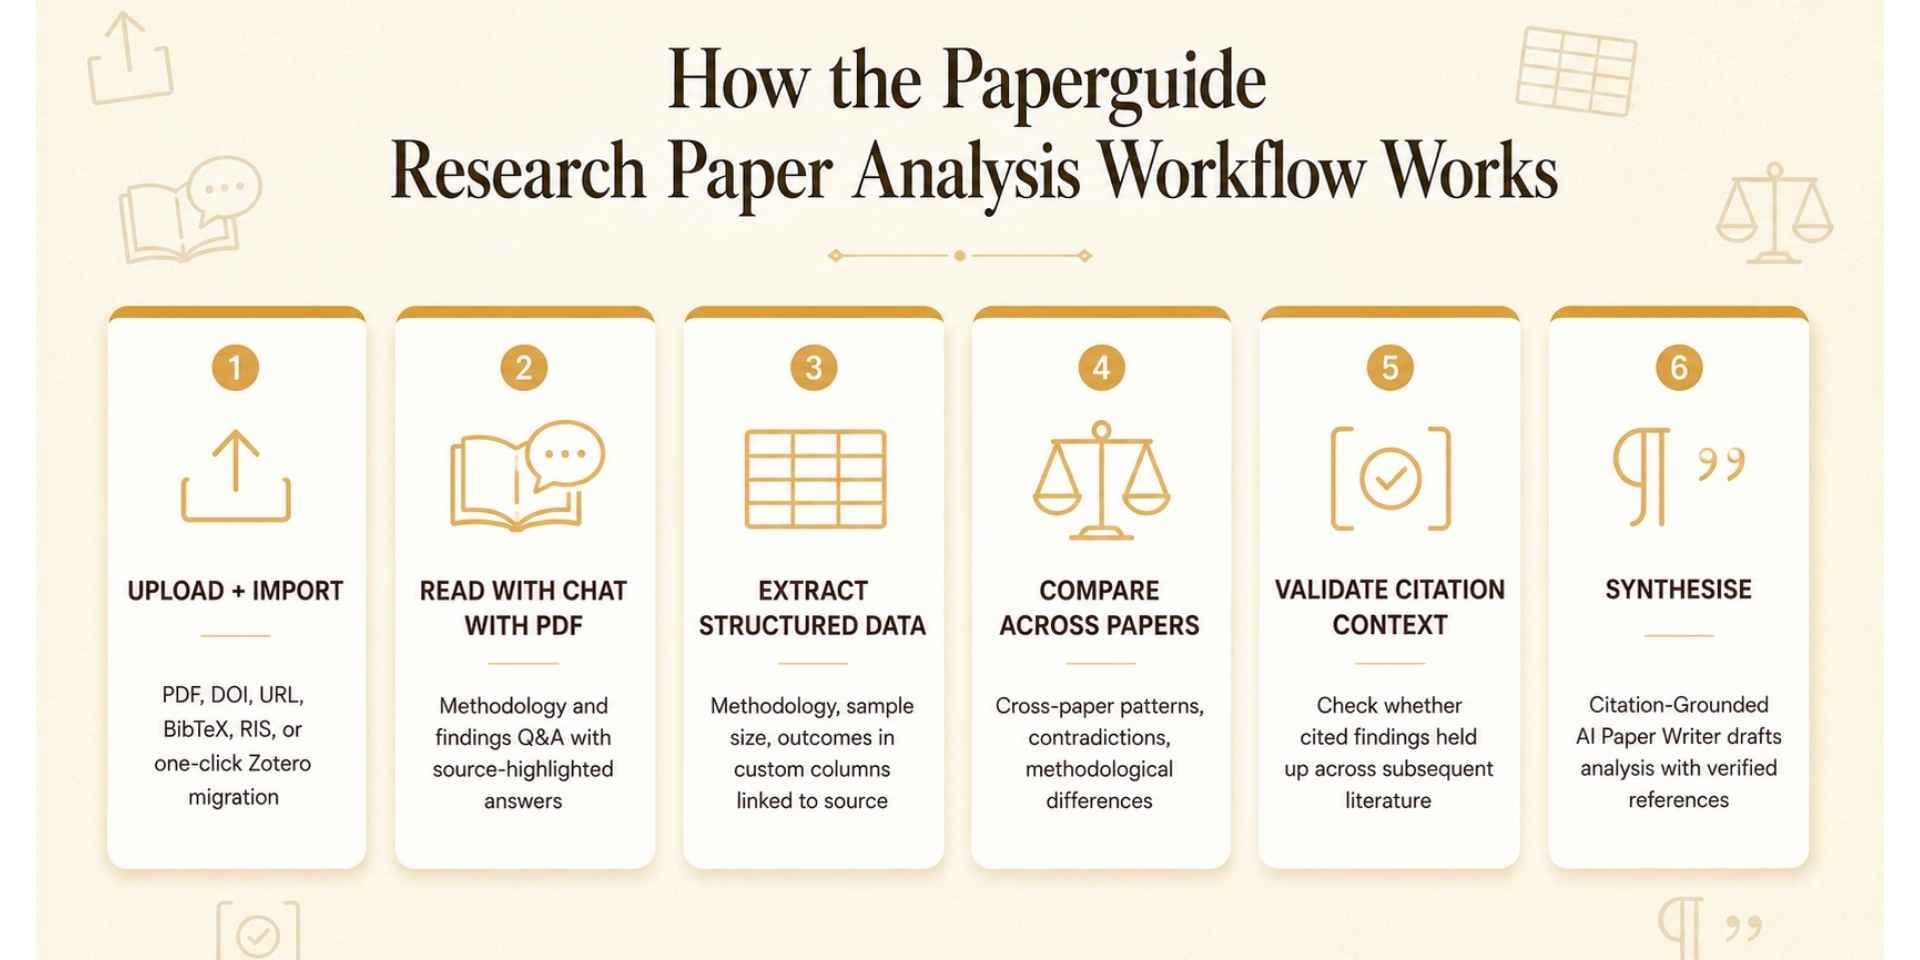
ลำดับหกขั้นตอนที่ Paperguide เผยแพร่ — อัปโหลด แชตกับ PDF จัดคอลัมน์เป็นโครงสร้าง เปรียบเทียบข้ามบทความ ตรวจสอบบริบทการอ้างอิง แล้วจึงเขียนโดยมีการอ้างอิงรองรับ — เป็นการประกาศรูปแบบสกัดก่อนที่ชัดเจน ตัวเลขความแม่นยำและราคาของ Paperguide จากแหล่งอิสระยังไม่ได้รับการตรวจสอบสำหรับบทความนี้; ตัวเวิร์กโฟลว์เองคือสิ่งที่มีประโยชน์ในการเปรียบเทียบ
การสกัดข้อมูลแบบมีโครงสร้างทำงานอย่างไรเมื่อชุดเอกสารมีบทความหลายร้อยฉบับ?
วิธีนี้ทำงานโดยแปลงแต่ละบทความเป็นแถวของฟิลด์ที่กำหนดตามโปรโตคอล จากนั้นคัดกรองแถวเหล่านั้นด้วยคำถามวิจัยก่อนเขียนข้อความสังเคราะห์ใด ๆ การขยายขนาดเกิดจากการทำสคีมาเดิมซ้ำ ไม่ใช่จากการสร้างบทสรุปให้ยาวขึ้น
ขั้นแรกคือการนำเข้า PDF, DOI, URL, BibTeX, RIS หรือไฟล์ส่งออกจากโปรแกรมจัดการบรรณานุกรม เพื่อสร้างชุดเอกสาร การแชตกับ PDF คือขั้นตอนที่สอง ไม่ใช่ขั้นสุดท้าย: คุณใช้มันเพื่อค้นหาช่วงข้อความในส่วนวิธีวิจัยและผลลัพธ์ แล้วตรึงช่วงข้อความเหล่านั้นไว้ในคอลัมน์ การทบทวนแบบมีชีวิตเกี่ยวกับการสกัดอัตโนมัติพบสิ่งพิมพ์ 76 รายการในหัวข้อนี้ แต่มีเครื่องมือสำหรับผู้ใช้ปลายทางที่นำไปใช้งานจริงเพียงหกตัว และ84% ของอัลกอริทึมขุดข้อมูลจากชื่อเรื่องและบทคัดย่อเท่านั้น การสกัดจากบทคัดย่อเพียงอย่างเดียวจะพลาดผลลัพธ์ การวิเคราะห์กลุ่มย่อย และรายละเอียดความเสี่ยงของอคติที่อยู่ในเนื้อหาฉบับเต็ม เวิร์กโฟลว์ใดที่อ้างว่าจัดการ “บทความหลายร้อยฉบับ” จากบทคัดย่ออย่างเดียว กำลังสรุป ไม่ได้ลงรหัสข้อมูล
คอลัมน์แบบกำหนดเองควรสอดคล้องกับคำถาม ไม่ใช่เทมเพลตเริ่มต้นของผู้จำหน่าย สำหรับคำถามด้านประสิทธิผล ฟิลด์ทั่วไปคือรูปแบบการศึกษา ประชากร การแทรกแซงหรือการสัมผัสปัจจัย กลุ่มเปรียบเทียบ ผลลัพธ์หลัก ทิศทางของผล ขนาดผลพร้อมช่วงความเชื่อมั่น ระยะติดตามผล และข้อจำกัด สำหรับคำถามด้านกลไก ให้แทนขนาดผลด้วยเส้นทางที่ตั้งสมมติฐานไว้ และระบุว่าการศึกษาทดสอบเส้นทางนั้นจริงหรือไม่ การเชื่อมแต่ละช่องกับช่วงข้อความต้นทางคือสิ่งที่ทำให้การเปรียบเทียบภายหลังเป็นไปได้ หากไม่มีตำแหน่งอ้างอิง ตารางก็เป็นเพียงบทสรุปอีกชนิดหนึ่งที่มีพื้นที่ว่างมากกว่า
บทความหลายร้อยฉบับยังบังคับให้ต้องแบ่งเป็นชุด หน้าต่างบริบท ข้อจำกัดอัตราการใช้งาน และข้อผิดพลาดการแยกวิเคราะห์ PDF ทำให้การสกัดชุดเอกสารของการทบทวนอย่างเป็นระบบทั้งหมดในครั้งเดียวไม่น่าเชื่อถือ รูปแบบที่ยั่งยืนคือ กำหนดสคีมาจากชุดนำร่อง 8–15 บทความ วัดความสอดคล้องเทียบกับการลงรหัสโดยมนุษย์ ตรึงพรอมต์ แล้วจึงประมวลผลบทความที่เหลือเป็นระลอก ข้อความของพรอมต์กำหนดความครบถ้วนและรูปแบบ; พรอมต์ที่ไม่ซ้ำกันสำหรับแต่ละบทความไม่สามารถทำให้เป็นมาตรฐานได้ จึงควรนำร่องกับส่วนย่อย แล้วคงพรอมต์เดิมไว้
Jenova's Academic Research Assistant สนับสนุนรูปแบบนี้ เพราะสคีมาสามารถอยู่ในหน่วยความจำถาวรและ PDF ยังคงแนบอยู่กับโครงการ แต่คุณยังต้องแบ่งเป็นชุด เมทริกซ์ของ Elicit ใกล้เคียงกับแผ่นงานลงรหัสสำหรับฟิลด์เชิงประจักษ์โดยธรรมชาติมากกว่า ส่วน Covidence ถือว่าชุดเอกสารผ่านการคัดกรองมาแล้ว เลือกเครื่องมือให้ตรงกับขั้นตอนที่คุณอยู่จริง
คุณตรวจสอบข้อค้นพบที่สกัดแล้วกับบริบทการอ้างอิงและรูปแบบการศึกษาอย่างไร?
คุณตรวจสอบโดยเช็กว่าข้ออ้างที่สกัดมายังคงอยู่จริงในข้อความที่อ้างถึง ในวรรณกรรมภายหลัง และในรูปแบบการศึกษาต่าง ๆ ที่ตอบคำถามเดียวกันหรือไม่ การสกัดที่ไม่มีการตรวจสอบเหล่านี้จะผลิตซ้ำอคติจากการอ้างอิงด้วยความเร็วระดับเครื่องจักร
การตรวจสอบบริบทการอ้างอิงหมายถึงการเปิดช่วงข้อความที่ถูกอ้างถึง ไม่ใช่เชื่อประโยคที่อ้างถึงมัน บทความมักกล่าวเกินจริงว่าบรรณานุกรมชิ้นหนึ่งแสดงอะไร อ้างบทคัดย่อแทนผลลัพธ์ หรือส่งต่อข้อค้นพบที่การทดลองภายหลังหักล้าง การตรวจสอบเฉพาะว่า “ข้อค้นพบที่อ้างถึงนี้ยังคงใช้ได้หรือไม่?” จึงเป็นขั้นตอนที่แยกจากคำถามว่า “บทความนี้รายงานอะไร?” เวิร์กโฟลว์แบบ Paperguide วางการตรวจสอบนี้ไว้ก่อนการสังเคราะห์ทันที ซึ่งเป็นลำดับที่ถูกต้อง: อย่าเขียนย่อหน้าจนกว่าช่องข้อมูลจะมีเสถียรภาพ
การตรวจสอบที่คำนึงถึงรูปแบบการศึกษาก้าวไปไกลกว่านั้น แผนภาพวิธีวิจัยปี 2025 ใน Nature Communications แสดงไปป์ไลน์สองขั้นตอนที่เป็นสถาปัตยกรรมอ้างอิงที่มีประโยชน์ แม้คุณจะไม่ใช้สูตรการให้คะแนนของมันก็ตาม โมเดลภาษาขนาดใหญ่แยกข้อความอิสระออกเป็นประชากร การแทรกแซงหรือการสัมผัสปัจจัย ความสัมพันธ์ และผลลัพธ์ จากนั้นจัดประเภททิศทางของผลเป็นเพิ่มขึ้น ลดลง หรือไม่เปลี่ยนแปลง ระเบียนเหล่านี้ถูกแบ่งชั้นตามรูปแบบการศึกษา — การทดลองแบบสุ่ม การสุ่มแบบเมนเดล และการศึกษาเชิงสังเกต — เพื่อไม่ให้ผลลัพธ์ถูกมองว่าใช้แทนกันได้ข้ามวิธีวิจัย
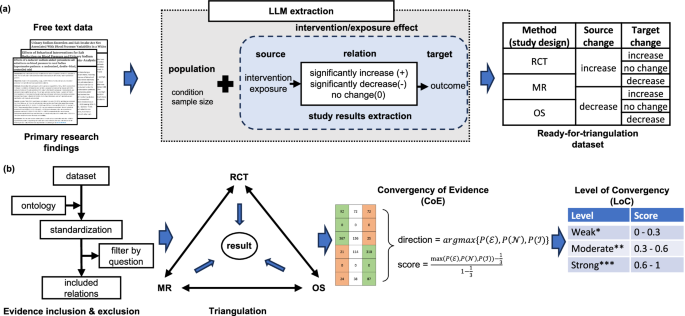
แผงที่สองคือส่วนที่เครื่องมือสรุปส่วนใหญ่มักข้าม หลังการทำให้เป็นมาตรฐานและคัดกรองการรวมผลลัพธ์แล้ว ผลลัพธ์จะถูกตรวจสอบสามเส้าข้ามรูปแบบการศึกษา คะแนน Convergence of Evidence ใช้ทิศทางที่มีมวลความน่าจะเป็นสูงสุด; แถบ Level of Convergence จะติดป้ายชุดหลักฐานว่าอ่อน ปานกลาง หรือแข็งแรง คุณไม่จำเป็นต้องใช้ตัวชี้วัดนี้อย่างตรงตัวเพื่อประยุกต์แนวคิด แต่คุณต้องหยุดรวมความสัมพันธ์เชิงสังเกตที่มีนัยสำคัญกับการทดลองที่ไม่พบผล ราวกับว่าเป็นประโยคเดียวว่า “วรรณกรรมกล่าวว่า X”
ความไม่ตรงกันระหว่างมนุษย์กับโมเดลควรได้รับการตัดสินโดยตรวจเทียบกับ PDF ในรอบที่สาม ไม่ใช่ให้คะแนนเป็นความล้มเหลวของโมเดลโดยอัตโนมัติ ในการพิสูจน์แนวคิดหนึ่ง Claude 2 ทำข้อผิดพลาดสำคัญหนึ่งข้อและข้อผิดพลาดเล็กน้อยห้าข้อ — และตรวจพบข้อผิดพลาดเล็กน้อย 21 ข้อในมาตรฐานอ้างอิงที่มนุษย์จัดทำ การมองการสกัดที่ตีพิมพ์แล้วเป็นมาตรฐานสูงสุดจะประเมินโมเดลต่ำเกินไปและประเมินมนุษย์สูงเกินไป หน่วยวิเคราะห์ที่ถูกต้องคือความสอดคล้องเชิงข้อเท็จจริงของแต่ละฟิลด์ โดยสถิติแบบประกอบ เช่น ค่าประมาณจุดพร้อมช่วงความเชื่อมั่น ต้องนับอย่างสอดคล้องกัน แทนที่จะนับเป็นตัวเลขสามตัวที่ไม่เกี่ยวข้องกัน
Jenova สามารถทำการตรวจสอบบริบทการอ้างอิงได้ เพราะค้นหาวรรณกรรมภายหลังและเก็บตารางการสกัดเดิมไว้ในหน่วยความจำได้ แต่มันไม่สามารถแทนผู้ทบทวนมนุษย์คนที่สองสำหรับการทบทวนแบบ Cochrane ได้ Covidence สามารถบังคับใช้ผู้ทบทวนคนที่สองนั้นได้ ใช้ข้อเท็จจริงทั้งสองโดยไม่ลดทอนให้กลายเป็นการหาผู้ชนะเพียงรายเดียว
คุณดำเนินเวิร์กโฟลว์การสกัดที่ขับเคลื่อนด้วยคำถามในทางปฏิบัติอย่างไร?
คุณกำหนดคำถามและฟิลด์ก่อน นำร่องสคีมา สกัดเป็นชุดพร้อมตำแหน่งอ้างอิง เปรียบเทียบแถว ตรวจสอบการอ้างอิงซ้ำ แล้วจึงเขียนจากตาราง การกลับลำดับนี้ — เขียนก่อน แล้วค่อยค้นหาคำพูดมารองรับภายหลัง — คือการสร้างปัญหาจากการสรุปขึ้นมาใหม่
สำหรับ Jenova's Academic Research Assistant ลำดับทั่วไปมีดังนี้:
- เปิดเอเจนต์และระบุโปรโตคอลไว้ในบล็อกเดียว รวมทั้งเกณฑ์การคัดเข้าและคอลัมน์ที่ต้องการอย่างชัดเจน
- แนบ PDF ชุดนำร่อง หรือ DOI แทนการใส่ชุดเอกสารทั้งหมด
- สกัดเป็นตาราง โดยกำหนดให้ทุกช่องต้องมีตำแหน่งอ้างอิง
- ตรึงพรอมต์หลังจากแก้ไขชุดนำร่องแล้ว
- แบ่งประมวลผลบทความที่เหลือเป็นชุด จากนั้นตรวจสอบความขัดแย้งและบริบทการอ้างอิงก่อนสังเคราะห์เป็นเรื่องเล่า
ตัวอย่างพรอมต์เริ่มต้นที่มีประโยชน์:
“คำถามวิจัย: ในผู้ใหญ่ที่มีภาวะซึมเศร้าดื้อการรักษา การใช้ ketamine เสริมช่วยลดคะแนน Montgomery–Åsberg เมื่อเทียบกับยาหลอกที่เวลา 24 ชั่วโมงหรือไม่? ให้รวมเฉพาะ RCTs สำหรับแต่ละบทความ ให้สกัด: รูปแบบการศึกษา จำนวนที่สุ่ม ขนาดยาและวิธีให้ยา กลุ่มเปรียบเทียบ ผลลัพธ์หลัก ช่วงเวลา ขนาดผลพร้อม 95% CI ทิศทาง (เพิ่มขึ้น / ลดลง / ไม่เปลี่ยนแปลง) และข้อจำกัด อ้างประโยคผลลัพธ์สำหรับขนาดผลทุกค่า ห้ามสรุปบทความที่ไม่ผ่านเกณฑ์การคัดเข้า ให้ทำเครื่องหมายช่องว่างแทนการอนุมาน”
ตัวอย่างพรอมต์เปรียบเทียบที่มีประโยชน์หลังมีตารางแล้ว:
“โดยใช้เฉพาะตารางการสกัด ให้ระบุ (1) ความขัดแย้งของทิศทางผล (2) ความแตกต่างด้านขนาดยาหรือช่วงเวลาที่อาจอธิบายความขัดแย้ง และ (3) แถวใดก็ตามที่การทดลองสนับสนุนที่อ้างถึงเก่ากว่าผลลัพธ์ล่าสุดที่ไม่พบความแตกต่างในผลลัพธ์เดียวกัน ห้ามเพิ่มบทความที่ไม่ได้อยู่ในตาราง”
สำหรับ Elicit เส้นทางที่เทียบเท่าคือการปรับปรุงโปรโตคอล รวบรวมแหล่งข้อมูล คัดกรอง แล้วสร้างเมทริกซ์คอลัมน์แบบกำหนดเอง — เป็นขั้นตอนที่ผลิตภัณฑ์อธิบายไว้สำหรับการทบทวนวรรณกรรมอย่างเป็นระบบ เริ่มจากคำถามเชิงประจักษ์ที่ฟิลด์ต่าง ๆ เช่น n วิธีวิจัย และผลลัพธ์ สอดคล้องกับเมทริกซ์อยู่แล้ว อย่าคาดหวังผลลัพธ์ในระดับเดียวกันจากบทความเชิงทฤษฎี
สำหรับ Covidence ให้ดำเนินการนำเข้าผลการค้นหา ลบรายการซ้ำ คัดกรองชื่อเรื่อง/บทคัดย่อโดยผู้ทบทวนสองคน คัดกรองเนื้อหาฉบับเต็ม แล้วใช้แบบฟอร์มสกัดข้อมูล คู่มือห้องสมุดมองซอฟต์แวร์กลุ่มนี้เป็นสภาพแวดล้อมสำหรับการสังเคราะห์หลักฐานที่มีโครงสร้าง โปร่งใส และทำซ้ำได้ ไม่ใช่แชตบอต หากคุณต้องการแผนภาพการไหล PRISMA และผู้ทบทวนอิสระสองคน ให้เริ่มที่นี่ และใช้ LLM เฉพาะภายในแบบฟอร์มสกัด โดยผู้ทบทวนคนที่สองยังคงเป็นมนุษย์
กฎการดำเนินงานสองข้อใช้ได้กับทั้งสามเครื่องมือ ข้อแรก อย่าให้โมเดลเติมช่องว่างด้วยค่าที่ฟังดูสมเหตุสมผล เพราะช่องว่างก็คือข้อมูล ข้อที่สอง วัดเวลาจากงานทั้งหมด — การปรับพรอมต์ การตัดสินข้อขัดแย้ง และการแก้ไข — ไม่ใช่เพียงเวลาหน่วงของโมเดล เวลาที่ใช้กับงานคือผลลัพธ์ด้านประสิทธิภาพที่เกี่ยวข้อง และการออกแบบพรอมต์เป็นส่วนหนึ่งของเวลานั้น
นักวิจัยด้านการสังเคราะห์หลักฐานกล่าวอย่างไรเกี่ยวกับการสกัดข้อมูลด้วย LLM?
นักวิจัยมอง LLM เป็นตัวเร่งที่มีแนวโน้มดีสำหรับฟิลด์ข้อมูลพื้นหลัง และยังไม่พิสูจน์ว่าใช้แทนการสกัดผลลัพธ์ได้ โดยรูปแบบการตรวจสอบความถูกต้องเองยังเป็นปัญหาเชิงระเบียบวิธีที่เปิดอยู่ ฉันทามติในบทความวิธีวิจัยปี 2025–2026 มีเงื่อนไขชัดเจน: มีประโยชน์ภายในเวิร์กโฟลว์ที่มีการกำกับดูแล แต่ยังไม่พร้อมเป็นเครื่องมือสกัดโดยไม่มีการกำกับดูแล
“คอขวดของการสังเคราะห์หลักฐานไม่ใช่ความเร็วในการอ่าน แต่คือการทำให้ทุกการศึกษาตอบคำถามเดียวกันในฟิลด์เดียวกัน แล้วสังเกตเมื่อฟิลด์เหล่านั้นไม่ตรงกัน บทสรุปอาจลื่นไหลแต่ยังใช้กับงานนี้ไม่ได้ เพราะความลื่นไหลซ่อนช่องว่างของข้อมูล เมื่อเราย้ายทีมจากการแชตระดับบทความไปสู่ตารางที่ยึดคำถาม สิ่งแรกที่ปรากฏไม่ใช่ข้อค้นพบใหม่ — แต่เป็นข้อมูลที่ขาดหาย ขนาดตัวอย่างที่ไม่มีตัวหาร ผลลัพธ์ที่ไม่มีช่วงเวลา และการอ้างอิงที่ไม่ได้สนับสนุนประโยคที่มันถูกแนบไว้”
“เรายังเลิกมองการสกัดโดยมนุษย์เป็นมาตรฐานสูงสุด งานที่มนุษย์ลงรหัสจำนวนมากมีข้อผิดพลาดในการสกัดอย่างน้อยหนึ่งข้อ และบางครั้งโมเดลก็จับข้อผิดพลาดเหล่านั้นได้ ขณะเดียวกันก็สร้างข้อผิดพลาดใหม่ โดยเฉพาะกับสถิติแบบประกอบ หน่วยประเมินที่ให้ผลจริงคือความสอดคล้องเชิงข้อเท็จจริงต่อฟิลด์ โดยตัดสินเทียบกับ PDF จนกว่าเวิร์กโฟลว์จะแสดงวงจรนี้ได้ — สคีมา ตำแหน่งอ้างอิง การประมวลผลเป็นชุด การตรวจหาความขัดแย้ง และการตรวจอ้างอิงซ้ำ — มันก็ยังเป็นเครื่องมือสรุป ไม่ว่าจะอ้างว่าอ่านบทความมาแล้วกี่ฉบับก็ตาม”
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเวิร์กโฟลว์วิจัย, ประสบการณ์ในการสร้างโครงการเอเจนต์วิชาการระยะยาวตั้งแต่การค้นพบวรรณกรรมจนถึงการเตรียมต้นฉบับ
จุดยืนนี้สอดคล้องกับความเห็นจากแหล่งอิสระ การทบทวนขอบเขตเกี่ยวกับ LLM ในการทบทวนอย่างเป็นระบบสรุปว่ามันกำลังเติบโต แต่ยังไม่พร้อมใช้งานในฐานะโครงสร้างพื้นฐานแบบแยกเดี่ยว งานแยกต่างหากเกี่ยวกับโมเดลภาษาเพื่อการสกัดข้อมูลและการประเมินความเสี่ยงของอคติกำลังทดสอบไปป์ไลน์ผสมระหว่างมนุษย์กับโมเดล แทนการทบทวนโดยโมเดลล้วน คำถามจริงของสาขานี้ไม่ใช่ “โมเดลอ่าน PDF 400 ฉบับได้หรือไม่?” แต่คือ “ตารางที่บันทึกกระบวนการและคัดกรองตามคำถาม จะผ่านการทบทวนโดยผู้ประเมินอิสระสองคนได้หรือไม่?”
เมื่อใดที่คุณควรใช้ซอฟต์แวร์สำหรับการทบทวนอย่างเป็นระบบโดยเฉพาะ แทนเอเจนต์วิจัย AI?
ใช้ซอฟต์แวร์สำหรับการทบทวนอย่างเป็นระบบโดยเฉพาะ เมื่อคุณต้องการการคัดกรองอิสระโดยผู้ทบทวนสองคน แผนภาพการไหล PRISMA ที่รายงานได้ และร่องรอยการตรวจสอบที่วารสาร หน่วยงาน HTA หรือคณะจัดทำแนวทางเวชปฏิบัติจะตรวจสอบ ใช้เอเจนต์วิจัย AI เมื่อคุณยังปรับกรอบคำถาม ลงรหัสชุดเอกสารที่มีการอัปเดตต่อเนื่อง หรือเปลี่ยนตารางที่มีเสถียรภาพเป็นต้นฉบับ ทั้งสองประเภทมักทำงานต่อเนื่องกันมากกว่าจะเป็นคู่แข่งกัน
Covidence, DistillerSR, EPPI-Reviewer และ JBI-SUMARI มีอยู่เพราะวิธีวิจัยที่ทำซ้ำได้ เวิร์กโฟลว์ทีม และระเบียนที่สอดคล้องกับ PRISMAเป็นข้อกำหนด ไม่ใช่ความชอบ สำหรับการทบทวนการแทรกแซง การเรียนรู้ของเครื่องในแพลตฟอร์มเหล่านี้ช่วยได้มากที่สุดในขั้นคัดกรอง — การประเมินหนึ่งพบว่าลดภาระงานคัดกรองได้สูงสุด 60% — ขณะที่เครื่องมือสกัดและประเมินความเสี่ยงของอคติยังมีข้อจำกัดมากกว่า หากผลลัพธ์ของคุณเป็นการทบทวนที่ลงทะเบียนไว้ อย่าข้ามชุดเครื่องมือนี้เพียงเพราะโมเดลแชตสามารถถอดความ PDF ได้
เอเจนต์เป็นสภาพแวดล้อมที่ดีกว่าสำหรับการทำงานทุกวันเมื่อคำถามยังเปลี่ยนแปลงอยู่ คุณสามารถแนบ PDF ใหม่ ปรับคอลัมน์ และเก็บการตัดสินใจเกี่ยวกับโปรโตคอลไว้ในหน่วยความจำ โดยไม่ต้องเปิดโครงการทบทวนใหม่ทุกครั้งที่เปลี่ยนทิศทาง Jenova's Academic Research Assistant สร้างมาเพื่อการทำงานลักษณะนี้: การค้นหาวิชาการแบบสด เนื้อหาฉบับเต็มที่แนบไว้ สคีมาการสกัดที่คงอยู่ และเส้นทางสู่การร่างที่จัดการการอ้างอิงได้ มันจะไม่ตอบสนองโปรโตคอลที่ต้องมีผู้คัดกรองสองคน การระบุขีดจำกัดนี้คือส่วนหนึ่งของการใช้งานอย่างถูกต้อง
รูปแบบการแบ่งงานที่หลายกลุ่มใช้ในปี 2026 มีลักษณะดังนี้ สำรวจและกำหนดฟิลด์ด้วยเอเจนต์หรือ Elicit ลงทะเบียนโปรโตคอล คัดกรองและสกัดใน Covidence หรือเครื่องมือเทียบเท่า โดยอาจใช้การลงรหัสที่ LLM ช่วยแต่ยังมีมนุษย์ตรวจยืนยัน จากนั้นกลับไปที่เอเจนต์เพื่อตรวจสอบบริบทการอ้างอิงอย่างเข้มงวด และเขียนจากตารางที่ตรึงไว้ รายการชุดเครื่องมือสังเคราะห์หลักฐานของ Duke ย้ำเตือนว่าไม่มีแอปเดียวครอบคลุมทุกขั้นตอน; ทักษะเชิงวิชาชีพคือการรู้ว่าคุณอยู่ในขั้นใด
การทดสอบที่ควรใช้ตัดสินชุดเครื่องมือ คือการทดสอบเดียวกับที่เปิดบทความนี้ หากคุณชี้ไปยังคำถามวิจัย คอลัมน์สำหรับทุกองค์ประกอบของคำถาม ตำแหน่งอ้างอิงสำหรับทุกช่อง และบันทึกสิ่งที่ถูกคัดออกได้ คุณกำลังสกัดหลักฐาน หากคุณมีเพียงภาพรวมที่เขียนอย่างดีเกี่ยวกับ “สิ่งที่บทความกล่าว” คุณยังคงกำลังสรุป — แม้ภาพรวมนั้นจะสร้างจากไฟล์หลายร้อยไฟล์ก็ตาม
เอกสารอ้างอิง
- PRISMA Statement — แนวทางการรายงานสำหรับการทบทวนอย่างเป็นระบบ
- The BMJ — แถลงการณ์ PRISMA 2020: แนวทางปรับปรุงสำหรับการรายงานการทบทวนอย่างเป็นระบบ
- ScienceDirect — LLM ในการทบทวนอย่างเป็นระบบ: กำลังเติบโต แต่ยังไม่พร้อมใช้งาน (การทบทวนขอบเขต)
- PMC — เครื่องมือดิจิทัลเพื่อสนับสนุนกระบวนการทบทวนอย่างเป็นระบบ
- BMJ Evidence-Based Medicine — ความท้าทายและข้อควรระวังในการประเมิน LLM สำหรับการสกัดข้อมูล
- Oregon State University Libraries — การเปรียบเทียบเครื่องมือ AI สำหรับการค้นคว้าวรรณกรรม
- Elicit — เวิร์กโฟลว์การทบทวนวรรณกรรมอย่างเป็นระบบ
- Covidence — ซอฟต์แวร์จัดการการทบทวนอย่างเป็นระบบ
- UCL Library Guides — ซอฟต์แวร์สำหรับการทบทวนอย่างเป็นระบบ
- Nature npj Digital Medicine — โมเดลภาษาเพื่อการสกัดข้อมูลและการประเมินความเสี่ยงของอคติ
- Duke University Libraries — ซอฟต์แวร์และเครื่องมือสำหรับการสังเคราะห์หลักฐาน