AI หลายโมเดลช่วยลดจุดบอดในการวิเคราะห์หุ้นได้ดีกว่าหรือไม่?
2026-08-24
ความเห็นต่างของโมเดลและการตรวจสอบแบบ Ensemble ช่วยเปิดเผยความเสี่ยงที่ซ่อนอยู่ในวิทยานิพนธ์ได้อย่างไร?
การตรวจสอบข้ามด้วยหลายโมเดลช่วยลดจุดบอดและความมั่นใจเกินเหตุได้อย่างน่าเชื่อถือกว่าการวิเคราะห์หุ้นด้วยโมเดลเดียว เพราะความเห็นต่างระหว่างโมเดลคือสัญญาณความเสี่ยง ไม่ใช่สิ่งรบกวนที่ควรนำไปเฉลี่ยทิ้ง ในปี 2026 คำตอบที่ลื่นไหลเพียงคำตอบเดียวจาก ChatGPT, Claude หรือ Gemini อาจให้ความรู้สึกราวกับว่างานวิจัยเสร็จสมบูรณ์แล้ว แต่ความลื่นไหลนั้นเองคือปัญหา โมเดลเดียว หน้าต่างบริบทเดียว และการกระจายตัวของข้อมูลฝึกสอนเพียงชุดเดียว สามารถสร้างเรื่องเล่าที่สอดคล้องกันได้ แม้ตัวเลขจะล้าสมัย อ่านเอกสารกำกับผิด หรือไม่มีกรณีขาลงอยู่เลยก็ตาม
สิ่งที่แยกการวิจัยหุ้นด้วย AI อย่างรอบคอบออกจากการคาดเดาอย่างมั่นใจจริง ๆ คือ:
✅ การยึดโยงกับแหล่งข้อมูล — เอกสารยื่นล่าสุด ประมาณการ และราคาแบบปัจจุบัน เทียบกับขีดจำกัดจากช่วงเวลาที่ฝึกสอน ✅ ความหลากหลายของโมเดล — มีผู้ให้บริการมากกว่าหนึ่งราย เพื่อให้ตรวจจับอคติจากคลังข้อมูลร่วมกันได้ง่ายขึ้น ✅ ความหลากหลายของบทบาท — มุมมองด้านปัจจัยพื้นฐาน เทคนิค มหภาค และพอร์ตโฟลิโอ แทนที่จะใช้ผู้เชี่ยวชาญทั่วไปเพียงคนเดียว ✅ การแสดงความไม่แน่นอน — ช่วงค่า ความขัดแย้ง และสถานะ “ตรวจสอบยืนยันไม่ได้” แทนความแม่นยำลวงตา ✅ ต้นทุนของการตรวจสอบซ้ำ — ต้องต่ำพอที่การตรวจสอบข้ามจะเกิดขึ้นจริงก่อนเพิ่มขนาดสถานะ
กฎการทำงานที่มีประโยชน์คือการทดสอบ ความเห็นต่างคือสัญญาณ: ให้ถือฉันทามติของโมเดลเป็นสมมติฐาน และให้ถือความขัดแย้งของโมเดลเป็นวาระการวิจัย ส่วนที่เหลือของบทความนี้จะนำการทดสอบดังกล่าวไปใช้กับแชตบอตโมเดลเดียว เครื่องมือให้คะแนนที่สร้างขึ้นเฉพาะทางอย่าง Danelfin เครื่องมือวิจัยที่ให้ความสำคัญกับการอ้างอิงอย่าง Perplexity และเอเจนต์หุ้นเฉพาะทางของ Jenova
เหตุใดความมั่นใจเกินเหตุจึงยังคงอยู่เมื่อนักลงทุนใช้ AI โมเดลเดียว?
ความมั่นใจเกินเหตุยังคงอยู่เพราะโมเดลเดียวส่งกลับเรื่องเล่าที่ขัดเกลามาแล้วหนึ่งเรื่อง และเรื่องเล่าที่ขัดเกลามักลดแรงเสียดทานซึ่งปกติจะบังคับให้ต้องตรวจสอบอีกครั้ง การเงินเชิงพฤติกรรม มองความมั่นใจเกินเหตุว่าเป็นอคติอย่างเป็นระบบ ไม่ใช่ข้อบกพร่องทางบุคลิกภาพ ในตลาด มันปรากฏเป็นการซื้อขายมากเกินไป การเดิมพันที่กระจุกตัว และการเพิกเฉยต่อหลักฐานที่ขัดแย้ง
รูปแบบนี้ไม่ได้หายไปเมื่อนักวิเคราะห์เป็น AI งานวิจัยเกี่ยวกับ ความมั่นใจเกินเหตุและอคติยืนยันความเชื่อในการซื้อขาย เชื่อมโยงอคติดังกล่าวกับการหมุนเวียนพอร์ตที่มากขึ้น การกระจายการลงทุนที่ลดลง และผลตอบแทนที่อ่อนแอกว่า บททบทวนพฤติกรรมนักลงทุนในยุค AI ปี 2025 พบว่าการแทรกแซงดุลยพินิจของมนุษย์สามารถลบล้างประสิทธิภาพที่อัลกอริทึมมอบให้ ทำให้ความผันผวนเพิ่มขึ้นแทนที่จะลดลง งานใหม่กว่านั้นเรียกปรากฏการณ์นี้ว่า “ความมั่นใจเกินเหตุจากอัลกอริทึม”: เมื่อมอบหมายการวิเคราะห์ให้โมเดล ผู้ใช้จะมองผลลัพธ์ว่าเป็นกลางมากกว่าความเป็นจริง
เซสชันกับโมเดลเดียวทำให้ปัญหาแย่ลงผ่านกลไกสามประการ ประการแรก โมเดลได้รับแรงจูงใจให้มีความสอดคล้อง จึงเติมช่องว่างแทนที่จะประกาศว่ามีช่องว่าง ประการที่สอง ผู้ใช้ไม่เห็นความเห็นต่างจากคู่เทียบ ซึ่งเป็นสัญญาณที่สถาบันใช้ขยายช่วงความเชื่อมั่น ประการที่สาม หน้าตาอินเทอร์เฟซเป็นบทสนทนา ดังนั้นแม้ตัวเลขที่ผิดก็ยังถูกส่งมาเป็นร้อยแก้วที่มั่นใจ คำเตือนนักลงทุนเกี่ยวกับ AI ของ U.S. SEC ระบุอย่างตรงไปตรงมาว่า AI สามารถสร้างและเผยแพร่ข้อมูลเท็จหรือไม่ถูกต้องได้ และนักลงทุนควรตรวจสอบข้ออ้างกับผู้เชี่ยวชาญที่ขึ้นทะเบียน
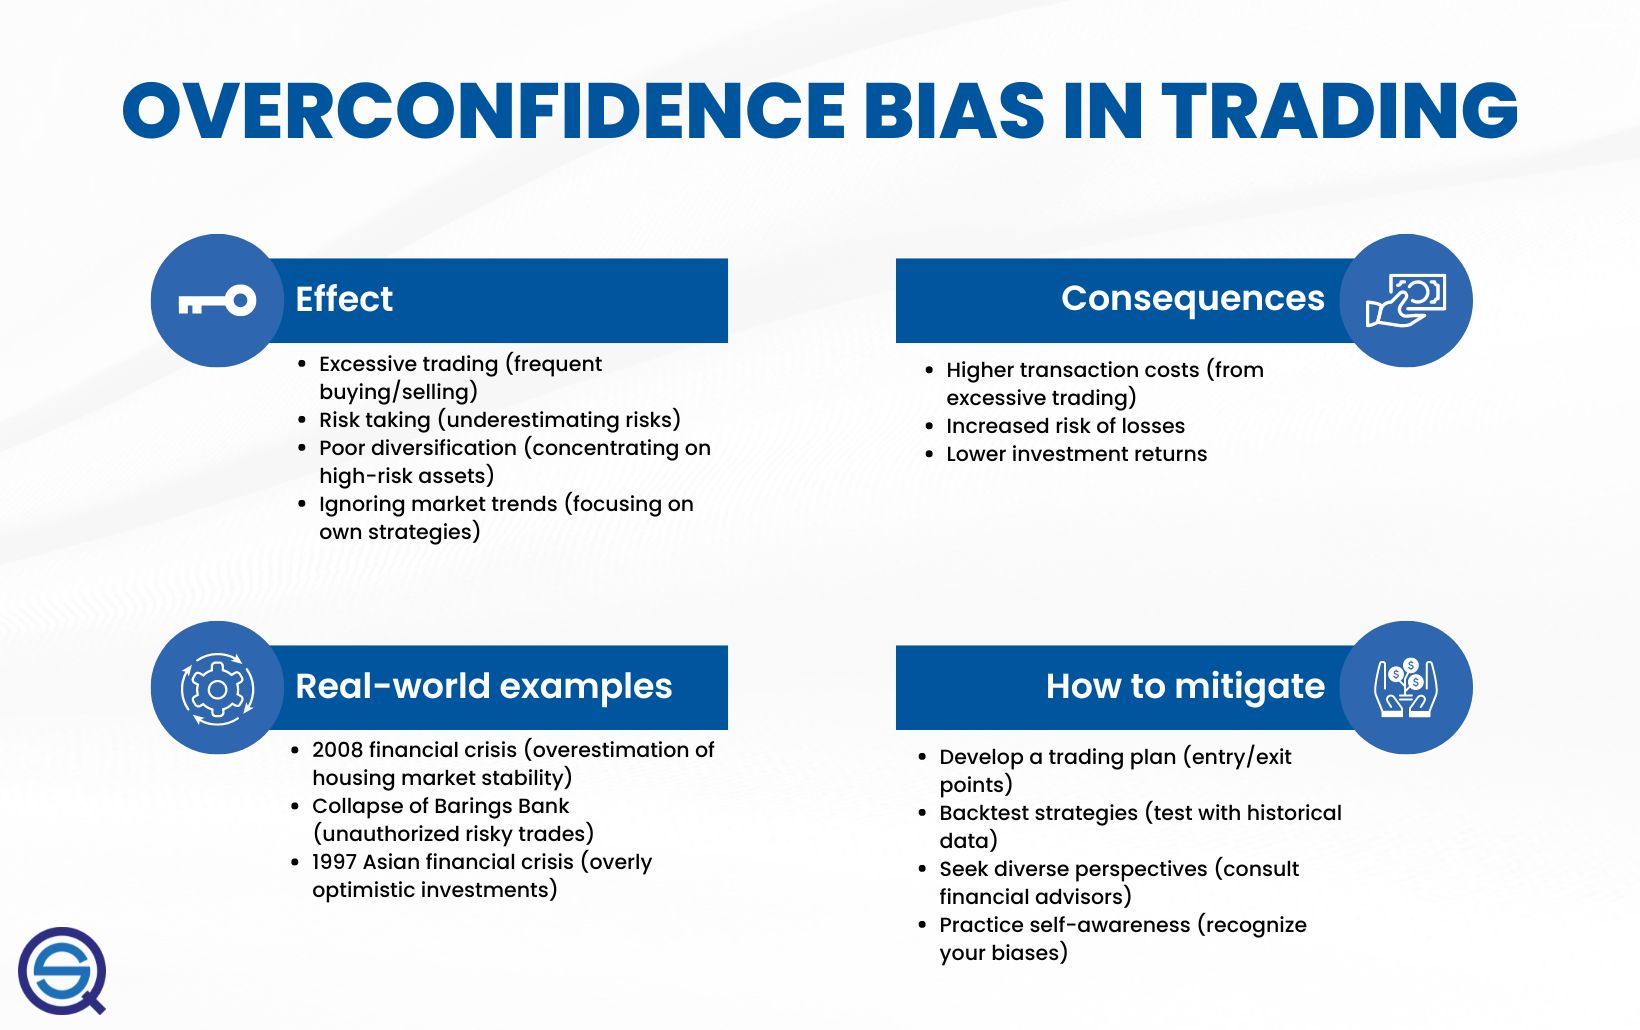
แนวทางลดผลกระทบแบบดั้งเดิม — แผนงานที่เป็นลายลักษณ์อักษร การทดสอบกับข้อมูลในอดีต และมุมมองที่หลากหลาย — เชื่อมโยงโดยตรงกับสถาปัตยกรรมการวิจัย โมเดลเดียวช่วยเขียนแผนได้ แต่ไม่สามารถเป็นมุมมองที่หลากหลายได้ด้วยตัวเอง
คุณควรประเมินอะไรเมื่อนำการวิเคราะห์หุ้นด้วยโมเดลเดียวมาเทียบกับหลายโมเดล?
คุณควรประเมินความครอบคลุมหกชั้น ไม่ใช่ว่าอินเทอร์เฟซใดฟังดูฉลาดกว่า เรียกสิ่งนี้ว่า การตรวจสอบจุดบอดหกชั้น ซึ่งเป็นเช็กลิสต์เชิงปฏิบัติสำหรับทุก Ticker ทุกเครื่องมือ และทุกกรอบเวลา
1. การยึดโยงกับแหล่งข้อมูล ระบบดึงเอกสารยื่น SEC ประมาณการ และราคาปัจจุบันหรือไม่ หรือกำลังเพียงเติมข้อความจากข้อมูลก่อนวันตัดยอด? Openbook Analytics ระบุว่าแชตบอตทั่วไป ไม่มีข้อมูลตลาดแบบสดและไม่สามารถยืนยันตัวเลขที่ตนสร้างขึ้นได้ และ CEO ของ Perplexity ยอมรับว่าข้อมูลตลาดบนแพลตฟอร์มอาจล้าสมัย
2. ความหลากหลายของโมเดล ผู้ให้บริการรายเดียวหมายถึงรูปแบบความล้มเหลวแบบเดียว การตรวจสอบผลลัพธ์กลุ่ม GPT กับ Claude, Gemini หรือ DeepSeek จะมีประโยชน์ก็ต่อเมื่อ Prompt ข้อมูล และบทบาทเปลี่ยนไปจริง การสลับแบรนด์บน Prompt เก่าที่ล้าสมัยไม่ใช่ความหลากหลาย
3. ความหลากหลายของบทบาท การอ่านปัจจัยพื้นฐาน การอ่านเทปและโครงสร้างราคา และการซ้อนทับมุมมองมหภาค จะจับความผิดพลาดคนละประเภท วิธีนี้ใกล้เคียงกับการประชุมวิจัยมากกว่ากระทู้แชตบอต
4. การนำเสนอความไม่แน่นอน เลือกช่วงค่า กรณีที่แข่งขันกัน และสถานะ “ยังไม่ยืนยัน” ที่ชัดเจน แทนราคาเป้าหมายเพียงค่าเดียว
5. ความต่อเนื่องของข้อมูล งานสร้างวิทยานิพนธ์ใช้เวลาหลายสัปดาห์ เครื่องมือที่ลืมมุมมองทางเลือกจากวันอังคารก่อน จะขยายความมั่นใจอีกครั้งในเซสชันถัดไป
6. ต้นทุนต่อการตรวจสอบ หากการให้โมเดลที่สองตรวจสอบมีราคาแพงหรือใช้งานยุ่งยาก ก็จะถูกข้ามไปในเวลาที่สถานะมีขนาดใหญ่ที่สุดพอดี
รายงาน FINRA เกี่ยวกับ AI ในอุตสาหกรรมหลักทรัพย์ ใช้ภาษากำกับดูแลกับประเด็นเดียวกัน ได้แก่ การจัดการความเสี่ยงของโมเดล ความสามารถในการอธิบายได้ ความสมบูรณ์ของข้อมูล และการควบคุมกำกับดูแล บริษัทต่าง ๆ ถูกคาดหวังให้เข้าใจว่าโมเดลสร้างผลลัพธ์อย่างไรก่อนจะพึ่งพาโมเดลในขั้นตอนการทำงานด้านคำแนะนำลงทุนภายใต้ Regulation Best Interest และ FINRA Rule 2111 นักลงทุนรายบุคคลไม่มีโครงการ Rule 3110 แต่ยังจำเป็นต้องมีนิสัยที่เทียบเท่า: รู้ว่าโมเดลมองไม่เห็นอะไร
บทความของ Harvard Business School ปี 2025 เกี่ยวกับอคติต่อต่างประเทศใน LLM ด้านการเงิน เพิ่มรูปแบบความล้มเหลวที่เงียบกว่า ข้อมูลอาจไม่มีในข้อมูลฝึกสอน หรือมีอยู่แต่ได้รับน้ำหนักน้อยเกินไป โมเดลสองตัวที่เน้นสหรัฐฯ อาจ “เห็นพ้องกัน” ต่อหุ้นตลาดเกิดใหม่ แต่ยังมีช่องว่างเดียวกัน
ChatGPT, Danelfin, Perplexity และ Jenova แตกต่างกันอย่างไรในด้านการครอบคลุมจุดบอด?
ความแตกต่างแรกอยู่ที่ว่าเครื่องมือผลิตคะแนนเดียว บทสรุปอ้างอิงเดียว หรือไฟล์วิจัยที่สามารถโต้แย้งได้ ChatGPT แข็งแกร่งที่สุดในฐานะคู่คิด และอ่อนแอที่สุดในฐานะเครื่องสร้างตัวเลข Danelfin แข็งแกร่งที่สุดในฐานะเครื่องคัดกรองที่โปร่งใส แต่ด้อยกว่าในการถกเถียงหลายบทบาท Perplexity แข็งแกร่งที่สุดในการดึงข้อความพร้อมแหล่งอ้างอิง แต่อ่อนแอเมื่อข้อความเหล่านั้นล้าสมัย Fundamental Stock Analyst ของ Jenova แข็งแกร่งที่สุดเมื่อวิทยานิพนธ์ต้องรวบรวมผลประกอบการ มูลค่า และภาวะความเชื่อมั่น แล้วท้าทายด้วยโมเดลอื่นหรือเอเจนต์เฉพาะทาง
Openbook Analytics ซึ่งสรุปการทดสอบก่อนหน้า รายงานว่า ChatGPT ตอบคำถามการเงินและการลงทุนผิดราว 35% และ Gemini สร้างข้อมูลการเงินหลอนในอัตราสูงถึง 88–91% ในการประเมินบางกรณี ตัวเลขเหล่านี้ไม่ใช่เหตุผลให้เลิกใช้โมเดลภาษา แต่เป็นเหตุผลที่ไม่ควรปล่อยให้โมเดลหนึ่งตัวปิดวิทยานิพนธ์
| ฟีเจอร์ / มิติ | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| ผลลัพธ์หลัก | คำอธิบายแบบร้อยแก้ว | AI Score ที่อธิบายได้และฟีเจอร์ต่าง ๆ | คำตอบจากเว็บพร้อมการอ้างอิง | บันทึกวิเคราะห์ปัจจัยพื้นฐานที่ยึดโยงกับเอกสารยื่น |
| ข้อมูลตลาดแบบสด / ที่ยืนยันแล้ว | อ่อนแอ; ถูกจำกัดด้วยช่วงข้อมูลฝึก | สร้างมาเพื่อจักรวาลหุ้นที่ให้คะแนน | มีการอ้างอิง แต่อาจล้าสมัย | เอกสารยื่น SEC ประมาณการ และภาวะความเชื่อมั่น |
| การตรวจสอบข้ามหลายโมเดล | ทำด้วยตนเอง หลายบัญชี | ระบบกรรมสิทธิ์เดียว | การค้นหาหลายโมเดล บทสรุปเดียว | มีผู้ให้บริการหลายรายในระบบ พร้อมเอเจนต์เฉพาะทาง |
| การจัดการความไม่แน่นอน | ร้อยแก้วที่มั่นใจเป็นค่าเริ่มต้น | คะแนนพร้อมการระบุที่มาของฟีเจอร์ | การอ้างอิง แต่แสดงความเสี่ยงคงเหลือน้อยกว่า | กรณีที่แข่งขันกัน ความเห็นต่างของโมเดล และความจำ |
| ราคา (ณ ปี 2026) | ราว $20/เดือนสำหรับแบบชำระเงิน | ยังไม่ได้ยืนยันในการทบทวนนี้ | $20/เดือนสำหรับ Pro; มีระดับฟรี | ระดับฟรี; แผนชำระเงินเริ่มที่ $20/เดือน |
| เหมาะที่สุดสำหรับ | ทบทวนแนวคิด ร่างกรณีขาลง | คัดกรองและกำหนดจังหวะให้รายชื่อที่รู้จัก | ข้อเท็จจริงพร้อมแหล่งข้อมูลอย่างรวดเร็ว | การวิจัยหุ้นที่ตรวจสอบข้ามแล้ว |
ChatGPT
ChatGPT ยังคงมีประโยชน์ในการแปลส่วนหนึ่งของ 10-K อธิบายโครงสร้างอุตสาหกรรม หรือบังคับให้เขียนกรณีขาลงด้วยภาษาที่เข้าใจง่าย การเปรียบเทียบสี่โมเดลปี 2026 จัดให้เป็นเครื่องมือกลุ่มทั่วไป ไม่ใช่ Terminal ข้อมูลสด ข้อจำกัดเป็นเชิงโครงสร้าง: มันยังสามารถเขียนสะพานเชื่อมอัตรากำไรที่ดูสะอาดตาจากความจำได้ และนี่คือช่องทางที่ความมั่นใจเกินเหตุเข้าสู่บันทึกวิจัย
Danelfin
Danelfin เป็นผลิตภัณฑ์ที่แตกต่างออกไป โดยเผยแพร่ AI Score แทนการสนทนา บริษัทระบุว่าหุ้นสหรัฐฯ ที่ได้คะแนน 10/10 ให้ผลตอบแทนเหนือกว่าตลาดด้วย Alpha ต่อปี 21.05% หลังสามเดือน นับตั้งแต่ปี 2017 ขณะที่หุ้นคะแนน 1/10 ให้ผลตอบแทนต่ำกว่าตลาด 33.28% และกลยุทธ์ AI Score ให้ผลตอบแทน 376% ตั้งแต่ 3 มกราคม 2017 ถึง 9 มิถุนายน 2025 เทียบกับ 166% ของ S&P 500 ฟีเจอร์ที่อธิบายได้เป็นวิธีแก้ปัญหาการให้คะแนนแบบกล่องดำอย่างแท้จริง แต่ข้อจำกัดเป็นสิ่งเสริมกัน: คะแนนสามารถจัดอันดับจักรวาลหุ้นได้โดยไม่ทดสอบความเสี่ยงเฉพาะด้านบัญชี ส่วนธุรกิจ หรือนโยบาย ที่จะทำลายสถานะ นี้
Perplexity
Perplexity มีบทบาทในฐานะชั้นการอ้างอิง การเปรียบเทียบของ Helm Terminal ปี 2026 ระบุว่า นำด้านข้อเท็จจริงสดพร้อมการอ้างอิงและฟีเจอร์การเงิน ขณะที่ Claude นำด้านการสังเคราะห์เอกสารยื่นเชิงลึก แต่ข้อจำกัดคือสิ่งที่ CEO ของ Perplexity เคยเตือนไว้แล้ว: การอ้างอิงจะสดใหม่ได้เท่ากับหน้าที่มันชี้ไป การตรวจสอบ Perplexity ข้ามกับขั้นตอนการทำงานที่ยึดเอกสารยื่นเป็นหลัก มีค่ามากกว่าการมองจำนวนการอ้างอิงเป็นหลักฐาน
Jenova Fundamental Stock Analyst
Fundamental Stock Analyst ของ Jenova ถูกสร้างเป็นผู้เชี่ยวชาญด้านหุ้น: ผลประกอบการ มูลค่าเปรียบเทียบ การวิเคราะห์โมเดลธุรกิจ และข้อมูลแบบเรียลไทม์จากเอกสารยื่น ประมาณการ และภาวะความเชื่อมั่น บนแพลตฟอร์ม Jenova สามารถรันซ้ำกับโมเดลจาก OpenAI, Anthropic, Google, DeepSeek และ xAI และทำงานเคียงข้างผู้เชี่ยวชาญอื่น แทนที่จะอ้างว่าเป็นทุกบทบาทในตัวเอง ความจำถาวรช่วยให้ความเห็นต่างครั้งก่อนยังคงอยู่บนโต๊ะ
ข้อจำกัดที่ตรงไปตรงมามีความสำคัญ Jenova ไม่ได้เผยแพร่คะแนนรวมระยะยาวที่เทียบกับประวัติผลการดำเนินงานของ Danelfin ในปี 2017–2025 ได้ การรันหลายโมเดลใช้โควตาการใช้งานมากกว่าการรันครั้งเดียว คำตอบที่ขัดแย้งเพิ่มภาระทางความคิด และผู้ใช้ยังต้องเปิด 10-K อยู่ดี สิ่งเหล่านี้คือต้นทุนจริง แต่ก็เป็นต้นทุนของการไม่สับสนระหว่างความลื่นไหลกับความรอบคอบ
การประสานงานหลายเอเจนต์เปลี่ยนการวิจัยหุ้นปัจจัยพื้นฐานอย่างไร?
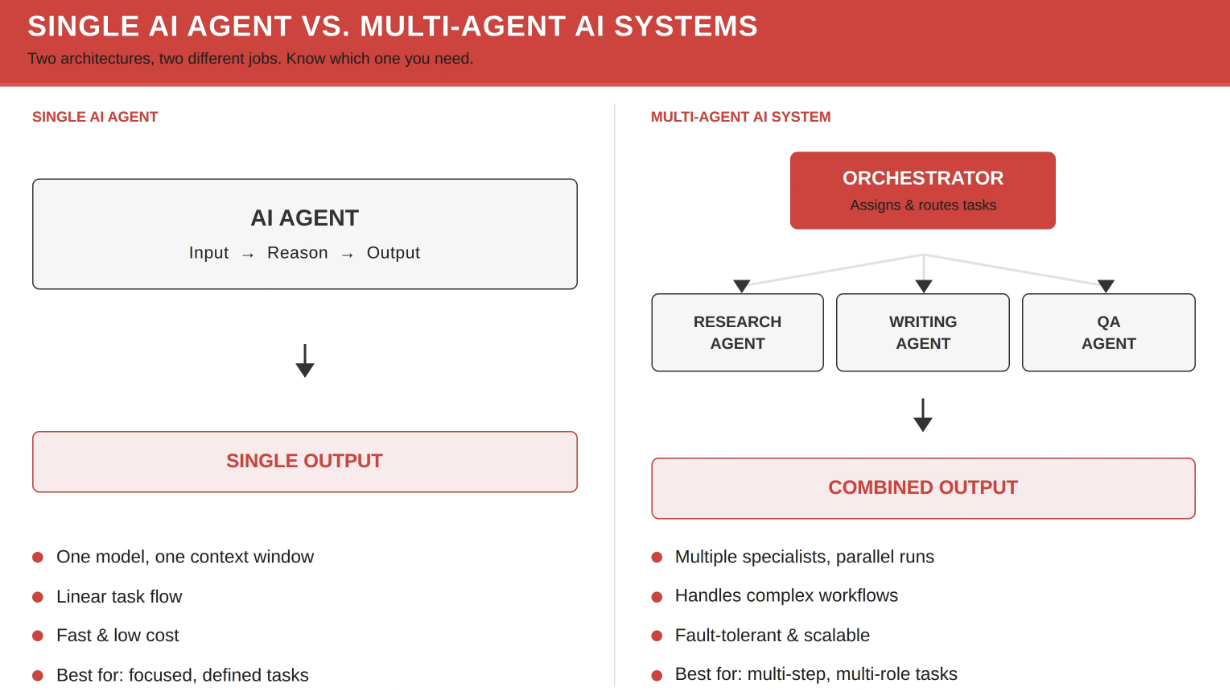
การประสานงานเปลี่ยนงานจาก “ถามนักวิเคราะห์คนเดียว” เป็น “จัดทีมเล็กและกระทบยอดไฟล์วิจัย” เอเจนต์เดี่ยวเดินตามเส้นทางเชิงเส้น: รับข้อมูล ให้เหตุผล ส่งผลลัพธ์ วิธีนี้รวดเร็ว ต้นทุนต่ำ และเหมาะสมเมื่อคำถามมีขอบเขตแคบ โครงสร้างหลายเอเจนต์เพิ่มตัวประสานงานที่มอบหมายงานให้ผู้เชี่ยวชาญ — วิจัย เขียน และตรวจสอบคุณภาพ — แล้วส่งกลับผลงานที่รวมเข้าด้วยกัน สถาปัตยกรรมนี้ช้ากว่าและแพงกว่า แต่เป็นวิธีป้องกันไม่ให้ความผิดพลาดที่พูดจาดีเพียงข้อเดียวกลายเป็นทั้งบันทึกวิเคราะห์
ในงานหุ้น การแบ่งงานที่เทียบเท่าไม่ใช่ “วิจัย / เขียน / QA” แบบนามธรรม แต่เป็น:
- ปัจจัยพื้นฐาน: คุณภาพกำไร เศรษฐศาสตร์ต่อหน่วย มูลค่า และการจัดสรรเงินทุน
- เทคนิค: โครงสร้างราคา ปริมาณ โมเมนตัม และระดับที่ทำให้วิทยานิพนธ์ใช้ไม่ได้
- มหภาค: นโยบาย อัตราดอกเบี้ย ระบอบสินทรัพย์ข้ามประเภท
- พอร์ตโฟลิโอ: ขนาดสถานะ ความสัมพันธ์ ความเสี่ยงขาดทุนสูงสุด และแนวคิดนั้นควรอยู่ในพอร์ต นี้ หรือไม่
Fundamental Stock Analyst ของ Jenova ครอบคลุมตำแหน่งแรก การจับคู่กับ Technical Stock Analyst และ Macro Strategist คือรูปแบบปฏิบัติของ QA แบบหลายเอเจนต์ โมเดลหนึ่งชอบเรื่องเล่า อีกโมเดลบอกว่าเทปเสีย และอีกโมเดลบอกว่าเส้นทางดอกเบี้ยจะทำลาย Multiple นั่นไม่ใช่การค้นหาที่ล้มเหลว แต่คือการประชุมความเสี่ยงที่สมบูรณ์
หลักฐานเกี่ยวกับ Ensemble นอกเหนือจากแชตบอตหุ้นชี้ไปในทิศทางเดียวกัน งานศึกษา arXiv ปี 2025 เกี่ยวกับ Ensemble ของ LLM บนข้อมูล Survey of Professional Forecasters พบว่าการผสม LLM เอาชนะการเฉลี่ยแบบง่ายในตัวชี้วัดระยะสั้นหลายตัว และยังมีประโยชน์มากกว่าเมื่อผู้เชี่ยวชาญมีความเห็นต่างสูง กลไกไม่ได้เป็นเรื่องมหัศจรรย์ Ensemble ลดน้ำหนักผู้เชี่ยวชาญที่เพิ่งคาดการณ์ผิด ปรับตามการแก้ไขย้อนหลัง และไม่ถือว่าทุกเสียงมีน้ำหนักเท่ากัน นี่ตรงข้ามกับการถามราคาเป้าหมายจากแชตบอตตัวเดียวแล้วหยุด
ภาษาของ FINRA เกี่ยวกับ โมเดลกล่องดำและความสามารถในการอธิบายได้ เกี่ยวข้องแม้กับขั้นตอนการทำงานของนักลงทุนรายย่อย หากคุณอธิบายไม่ได้ว่าเหตุใดกรณีขาขึ้นจึงยังอยู่รอดหลังเผชิญหน้ากับโมเดลที่สองและบทบาทที่สอง คุณไม่ได้มีกระบวนการลงทุน คุณมีเพียงบทถอดความ
เอเจนต์ด้านเทคนิค มหภาค และพอร์ตโฟลิโอจับสิ่งที่โมเดลเดียวพลาดได้หรือไม่?
ได้ พวกมันจับความผิดพลาดเชิงหมวดหมู่ — ข้อผิดพลาดที่โมเดลซึ่งดูเฉพาะปัจจัยพื้นฐานมีแนวโน้มเชิงโครงสร้างที่จะไม่สังเกต โมเดลภาษาที่เพิ่งเขียนเรื่องเล่าของบริษัทเติบโตคุณภาพสูงอย่างสะอาด มักไม่อาสาบอกว่าหุ้นยืดตัวมากเกินไป ภาคธุรกิจเป็นการเดิมพัน Duration โดยตรง หรือสถานะนั้นเพิ่มปัจจัยความเสี่ยงที่คุณถืออยู่แล้วเป็นสองเท่า
สิ่งที่แต่ละตำแหน่งมักพลาด:
- ตำแหน่งเทคนิค โมเดลปัจจัยพื้นฐานอาจประเมินมูลค่าถูกต้อง แต่เร็วเกินไปหนึ่งปี โครงสร้างราคา การทะลุแนวต้านที่ล้มเหลว และความแตกต่างของปริมาณซื้อขายไม่ใช่เชิงอรรถ แต่เป็นเรื่องจังหวะและจุดตัดขาดทุน Technical Stock Analyst ถูกออกแบบมาสำหรับคำถามเหล่านี้: โครงสร้างตลาด โมเมนตัม และความเสี่ยงที่กำหนดไว้
- ตำแหน่งมหภาค DCF ระดับหุ้นที่ละเลยระบอบนโยบาย คือสเปรดชีตที่ซ่อนสมมติฐานเรื่องอัตราดอกเบี้ยไว้ Macro Strategist ถูกออกแบบมาสำหรับการสังเคราะห์สินทรัพย์ข้ามประเภทและการวิเคราะห์นโยบาย ซึ่งเป็นจุดที่เรื่องเล่า “เฉพาะบริษัท” หลายเรื่องพังลงจริง
- ตำแหน่งพอร์ตโฟลิโอ แนวคิดที่ดีมากเมื่อพิจารณาแบบโดดเดี่ยว อาจเป็นการเพิ่มที่ไม่ดีให้กับพอร์ต Drift การทดสอบภาวะตึงเครียด และความสัมพันธ์ อยู่ในชั้นพอร์ตโฟลิโอ ซึ่งเป็นงานของ Portfolio Management Strategist ของ Jenova
นี่คือจุดที่แพลตฟอร์มคะแนนเดียวและโมเดลแชตเดียวมีจุดบอดร่วมกัน คะแนนของ Danelfin อาจโปร่งใสเกี่ยวกับฟีเจอร์เบื้องหลังอันดับ แต่ยังไม่บอกว่าพอร์ต ของคุณ มีสถานะ Long ในปัจจัยเดียวกันมากอยู่แล้วหรือไม่ ChatGPT อาจระบุความเสี่ยงในเชิงนามธรรม แต่ยังไม่รู้ว่าคุณถือหุ้นซอฟต์แวร์สามตัวที่ไวต่ออัตราดอกเบี้ยเหมือนกันอยู่แล้ว การทบทวนหลายบทบาทคือวิธีที่ข้อผิดพลาดเหล่านี้ปรากฏขึ้น
ข้อจำกัดคือความสัมพันธ์ของกรอบคิด หากทุกเอเจนต์ถูก Prompt ให้เป็นฝ่ายขาขึ้น หรือทุกโมเดลได้รับบทความบล็อกรองฉบับเดียวกัน คุณกำลังทำการแสดง ความหลากหลายของบทบาทใช้ได้ผลก็ต่อเมื่อเอเจนต์เทคนิคมีสิทธิ์ปฏิเสธการเทรด เอเจนต์มหภาคมีสิทธิ์ปรับราคา Multiple ใหม่ และเอเจนต์พอร์ตโฟลิโอมีสิทธิ์ลดขนาดสถานะลงเหลือเพียงเล็กน้อย
คุณจะทำการตรวจสอบข้ามหลายโมเดลสำหรับวิทยานิพนธ์หุ้นอย่างไร?
ให้ทำเป็นไฟล์สี่รอบ ไม่ใช่แชตที่ยาวขึ้น เป้าหมายคือสร้างความเห็นต่างโดยตั้งใจ แล้วตัดสินใจว่าหลักฐานใดจะช่วยยุติความเห็นต่างนั้น
รอบที่ 1 — ยึดข้อเท็จจริงกับแหล่งข้อมูล ขอให้ Fundamental Stock Analyst จัดทำ Snapshot ที่มีแหล่งอ้างอิงเท่านั้น: สองงวดที่รายงานล่าสุด Guidance ส่วนผสมรายได้ตาม Segment หนี้สุทธิ Buyback และ Multiple มูลค่าที่สอดคล้องกับธุรกิจจริง ห้ามระบุราคาเป้าหมายในรอบนี้
“โดยใช้ 10-K, 10-Q และ Earnings Call สองครั้งล่าสุดของ [TICKER] ให้ดึงรายได้ตาม Segment, Gross Margin และ Operating Margin, FCF, หนี้สุทธิ และจำนวนหุ้น Diluted Share Count ให้อ้างอิงเอกสารยื่นหรือ Call สำหรับทุกตัวเลข หากไม่สามารถระบุแหล่งที่มาของตัวเลขได้ ให้เขียนว่า ตรวจสอบยืนยันไม่ได้”
รอบที่ 2 — เปลี่ยนโมเดล ไม่ใช่คำถาม รันการดึงข้อมูลชุดเดียวกันกับผู้ให้บริการรายที่สอง ความแตกต่างที่มีนัยสำคัญในตัวเลขที่รายงานไม่ใช่ “สไตล์” แต่เป็นเหตุการณ์ด้านความสมบูรณ์ของข้อมูล ตรวจสอบเอกสารยื่นด้วยตัวเองก่อนเข้าสู่รอบที่ 3
รอบที่ 3 — จัดทีมตำแหน่งอื่น ส่ง Ticker เดียวกันไปให้ Technical Stock Analyst ระบุระดับที่ทำให้วิทยานิพนธ์ใช้ไม่ได้ และส่งให้ Macro Strategist วิเคราะห์สมมติฐานด้านดอกเบี้ย FX หรือสินค้าโภคภัณฑ์ที่ซ่อนอยู่ใน Multiple
“ละเว้นบันทึกปัจจัยพื้นฐานฝั่งขาขึ้น ระบุระดับราคาและระบอบมหภาคที่จะทำให้การถือครองนี้ไม่คุ้มค่า แม้ว่าวิทยานิพนธ์จะถูกต้องในท้ายที่สุดก็ตาม”
รอบที่ 4 — บังคับให้เขียนความเห็นคัดค้าน ให้โมเดลใดโมเดลหนึ่งโต้แย้งฝั่งตรงข้ามด้วยความยาวและการอ้างอิงเท่ากัน บทความการเงินเชิงพฤติกรรมของ Lucid.now ชี้ถึงรูปแบบมนุษย์ตามปกติ ได้แก่ ประเมินทักษะการคาดการณ์สูงเกินจริง ซื้อขายบ่อยเกินไป และกระจุกตัวในเรื่องเล่าที่ชื่นชอบ การกำหนดให้ต้องมีความเห็นคัดค้านคือวิธีขัดจังหวะรูปแบบนั้น เมื่อ “นักวิเคราะห์” ก็เป็นโมเดลเช่นกัน
เมื่อใช้ ChatGPT หรือ Claude เพียงอย่างเดียว คุณสามารถประมาณรอบที่ 2 และ 4 ได้ด้วยการเปิดผลิตภัณฑ์ที่สองและวางข้อมูลสกัดจากแหล่งอ้างอิงชุดเดียวกัน แต่คุณไม่สามารถประมาณการดึงเอกสารยื่นแบบสด หรือความจำถาวรข้ามหลายสัปดาห์ได้ เว้นแต่เครื่องมือนั้นมีความสามารถดังกล่าวจริง สำหรับ Danelfin รอบที่ 1 ถูกทำอัตโนมัติบางส่วนผ่านคะแนนและรายการฟีเจอร์ แต่รอบที่ 3 และ 4 ยังต้องใช้พื้นที่วิจัยแยกต่างหาก
ราคาของ Jenova เป็นแบบคิดตามการใช้งานในแต่ละระดับ: แผนฟรีที่มีการใช้งานจำกัด จากนั้น $20, $50, $100, $200, $500 และ $1,000 ต่อเดือนเมื่อโควตาเพิ่มขึ้น การตรวจสอบสี่รอบมีต้นทุนมากกว่าการแชตครั้งเดียว แต่สำหรับสถานะที่ใหญ่พอจะมีนัยสำคัญ นั่นคือความผิดพลาดที่มีต้นทุนถูกกว่า
ผู้ปฏิบัติงานในตลาดพูดอย่างไรเกี่ยวกับความมั่นใจเกินเหตุจาก AI ในงานวิจัย?
ผู้ปฏิบัติงานที่ทำงานกับเครื่องมือเหล่านี้ทุกวันมักมองความแน่นอนจากโมเดลเดียวว่าเป็นความล้มเหลวของกระบวนการ ไม่ใช่คุณลักษณะของโมเดลที่ “ดีกว่า”
“ความผิดพลาดที่แพงที่สุดที่เราเห็นไม่ใช่ตัวเลขผิด แต่เป็นตัวเลขที่ฟังดูถูกต้องซึ่งไม่เคยผ่านโมเดลที่สอง เมื่อผู้ให้บริการสามรายเห็นตรงกันเรื่องสะพานเชื่อมอัตรากำไรที่ไม่มีรายใดตรวจสอบกับ 10-Q ได้ ความเห็นตรงกันนั้นคือธงแดง เราอยากส่งบันทึกที่มีช่วงค่าขัดแย้งกันสองชุดและรายการสิ่งที่ตรวจสอบยืนยันไม่ได้ มากกว่าราคาเป้าหมายเดียวที่ไม่มีข้อสงสัยหลงเหลืออยู่”
“หลายโมเดลไม่ได้ปลอดภัยกว่าโดยอัตโนมัติ หากคุณถาม GPT, Claude และ Gemini ด้วยคำถามที่เลอะเทอะเหมือนกัน คุณมักได้คำตอบเลอะเทะแบบเดียวกันพร้อมคำคุณศัพท์ต่างกัน ความหลากหลายต้องถูกออกแบบ: บทบาทต่างกัน การดึงข้อมูลต่างกัน และคำสั่งถาวรให้คัดค้าน มิฉะนั้นคุณเพียงซื้อความมั่นใจเกินเหตุที่สัมพันธ์กันในราคา Token สามเท่า”
“บน Desk ความเห็นต่างคือวิธีที่เราตัดสินใจว่าจะอ่านอะไรต่อ หากปัจจัยพื้นฐานและมหภาคขัดแย้งกัน เราจะไปดูสมมติฐานอัตราดอกเบี้ย หากปัจจัยพื้นฐานและเทคนิคขัดแย้งกัน เราจะไปดูจังหวะและขนาดสถานะ หากทุกตำแหน่งเห็นตรงกันเร็วเกินไป เราจะถือว่าไฟล์นั้นบาง นิสัยนี้มีมาก่อน LLM นานแล้ว โมเดลเพียงทำให้การข้ามขั้นตอนง่ายขึ้น”
— Jenova Product Team, การออกแบบและประเมินผลเอเจนต์หุ้น และงานหลายปีเกี่ยวกับขั้นตอนการวิจัยหลายโมเดล
จุดยืนนี้สอดคล้องกับ การเน้นย้ำของ FINRA เรื่องการทดสอบ แผนสำรอง และการกำกับดูแลข้ามสายงาน ก่อนที่เครื่องมือ AI จะมีอิทธิพลต่อคำแนะนำลงทุน และยังสอดคล้องกับผลของการคาดการณ์แบบ Ensemble: การผสมผสานช่วยมากที่สุดเมื่อข้อมูลนำเข้าขัดแย้งกันและมีผู้กำหนดกฎการถ่วงน้ำหนัก
เมื่อใดการวิเคราะห์ด้วยโมเดลเดียวจึงยังเป็นทางเลือกที่ดีกว่า?
การวิเคราะห์ด้วยโมเดลเดียวยังเป็นทางเลือกที่ดีกว่าเมื่องานมีขอบเขตชัดเจน ต้นทุนของความผิดพลาดต่ำ และความเร็วสำคัญกว่าความเสี่ยงคงเหลือ การตรวจสอบข้ามหลายโมเดลคือระบบควบคุม คุณไม่จำเป็นต้องมีระบบควบคุมเพื่ออธิบาย ROIC หรือสรุปธุรกิจในสองย่อหน้า
โดยทั่วไป โมเดลเดียวเพียงพอเมื่อ:
- คุณกำลังเรียนรู้แนวคิด ไม่ใช่กำหนดขนาดสถานะ
- คุณเปิดเอกสารยื่นอยู่แล้วและต้องการเพียงผู้ช่วยอ่าน
- คุณกำลังคัดกรองภาษา ไม่ใช่คำนวณมูลค่า
- คุณต้องการโครงร่างรอบแรกก่อนเข้าสู่ขั้นตอนการทำงานที่ช้ากว่าและมีแหล่งอ้างอิง
- การเรียกโมเดลเพิ่มเติมจะไม่เปลี่ยนการตัดสินใจ
คู่มือปี 2026 ของ Openbook แบ่งหมวดหมู่ในแบบเดียวกัน: แชตบอตทั่วไปเป็นจุดเริ่มต้น ไม่ใช่เครื่องมือวิจัยหลัก คะแนนของ Danelfin เป็นระบบเดียว แต่เป็นระบบเฉพาะทาง การใช้เป็นเครื่องคัดกรองแล้วหยุดยังคงเป็นการตัดสินใจด้วยโมเดลเดียว หากไม่มีใครท้าทายหุ้นนั้น Perplexity เหมาะเป็นการใช้งานครั้งเดียวเมื่อคุณต้องการเส้นทางการอ้างอิงภายในไม่กี่นาที และจะตรวจสอบแหล่งข้อมูลปฐมภูมิด้วยตัวเอง
รูปแบบความล้มเหลวคือการใช้ขั้นตอนราคาถูกกับการตัดสินใจราคาแพง ความมั่นใจเกินเหตุไม่ได้เกิดจาก AI แต่เกิดจากการจบกระบวนการที่คำตอบแรกซึ่งฟังดูสอดคล้อง บทสรุปแนวทางของหน่วยงานกำกับการเงินสหรัฐฯ ปี 2025 จาก Sidley เน้นย้ำว่าบริษัทจำเป็นต้องปฏิบัติต่อ AI เป็นกิจกรรมที่มีการกำกับดูแล ไม่ใช่เป็นผู้พยากรณ์ นักลงทุนส่วนบุคคลควรทำตามเจตนารมณ์ของกฎนี้ แม้ไม่มีผู้ตรวจสอบมาถาม
กฎตัดสินใจแบบกระชับ: หากการผิดพลาดจะเปลี่ยนขนาดสถานะ ให้ใช้โมเดลอย่างน้อยสองตัวและสองบทบาท หากการผิดพลาดจะเปลี่ยนเพียงประโยคหนึ่งในบันทึกของคุณ โมเดลที่ดีหนึ่งตัวก็เพียงพอ
กฎระเบียบและความเสี่ยงของโมเดลควรกำหนดขั้นตอนการวิจัยด้วย AI ของคุณอย่างไร?
สิ่งเหล่านี้ควรบังคับให้คุณบันทึกสิ่งที่โมเดลมองไม่เห็น ไม่ใช่เพียงสิ่งที่โมเดลพูด การอภิปรายเรื่อง AI ของ FINRA เขียนขึ้นสำหรับ Broker-Dealer แต่ประเด็นด้านการควบคุมสามารถถ่ายทอดได้ การจัดการความเสี่ยงของโมเดล ธรรมาภิบาลข้อมูล ความสามารถในการอธิบายได้ และการกำกับดูแล ล้วนมีอยู่เพราะเครื่องมือที่ดูเหมือนทำงานอัตโนมัติล้มเหลวในรูปแบบที่สัมพันธ์กันได้
สำหรับกระบวนการวิจัยรายบุคคล การควบคุมที่นำไปใช้ได้มีขนาดเล็ก:
- เก็บแหล่งข้อมูลปฐมภูมิไว้ในไฟล์ หากโมเดลไม่สามารถชี้ไปที่ 10-K, 10-Q, 8-K หรือ Call Transcript ได้ ข้ออ้างนั้นยังเป็นเพียงร่าง
- บันทึกความเห็นต่าง บันทึกหนึ่งบรรทัด — “Claude เห็น Margin Compression, Gemini ไม่เห็น, 10-Q หน้า 37 ยังไม่ได้ข้อยุติ” — มีประโยชน์มากกว่าการสร้างกรณีขาขึ้นใหม่
- แยกคำแนะนำออกจากคำอธิบาย แชตบอตไม่ใช่เครื่องยนต์ตรวจสอบความเหมาะสม FINRA ระบุว่า เครื่องมือ AI ที่สร้างคำแนะนำอยู่ภายใต้ Regulation BI และ Rule 2111 สำหรับบริษัทสมาชิก ผู้ใช้รายย่อยควรมองผลลัพธ์ของโมเดลเป็นการวิเคราะห์ ไม่ใช่คำแนะนำเฉพาะบุคคล
- ถือว่ามีอคติร่วมกันจนกว่าจะพิสูจน์เป็นอย่างอื่น ผลการศึกษาอคติต่อต่างประเทศของ HBS เป็นหนึ่งตัวอย่าง สองโมเดลอาจพลาดข้อเท็จจริงนอกสหรัฐฯ เดียวกัน เอกสารยื่นท้องถิ่น แหล่งข้อมูลภาษาที่สอง หรือผู้เชี่ยวชาญมนุษย์ คือการกระจายความเสี่ยงที่แท้จริง
- เลือกเครื่องมือที่สามารถบอกว่า “ตรวจสอบยืนยันไม่ได้” ความแม่นยำลวงตาคือสัญญาณบ่งชี้ ระบบที่เติมย่อหน้าให้จบเสมอไม่ได้ “วิเคราะห์มากกว่า” แต่ถูกกำกับดูแลน้อยกว่า
ทั้งหมดนี้ไม่ต้องใช้งบแบบสถาบัน Terminal ระดับ Bloomberg ยังคงอยู่ในโลกต้นทุนอีกระดับหนึ่ง — Openbook อ้าง ราคา Bloomberg โดยทั่วไปสูงกว่า $25,000 ต่อปี แต่การควบคุมที่ลดความมั่นใจเกินเหตุได้จริงมีราคาถูกกว่า: โมเดลที่สอง ตำแหน่งที่สอง และกฎว่าฉันทามติที่ไร้แหล่งข้อมูลจะไม่เพิ่มขนาดสถานะ
การวิเคราะห์หุ้นด้วยโมเดลเดียวคือเครื่องมือร่างงาน การตรวจสอบข้ามด้วยหลายโมเดลและหลายบทบาทคือเครื่องมือลดจุดบอด ใช้สิ่งแรกเพื่อเริ่มไฟล์ ใช้สิ่งที่สองเพื่อตัดสินว่าไฟล์เสร็จแล้วหรือยัง
แหล่งอ้างอิง
- Openbook Analytics — เครื่องมือวิเคราะห์หุ้นด้วย AI ที่ดีที่สุดในปี 2026
- Investopedia — การเงินเชิงพฤติกรรม: อคติ อารมณ์ และพฤติกรรมนักลงทุน
- Preprints.org — ความมั่นใจเกินเหตุและอคติยืนยันความเชื่อในการซื้อขาย
- ResearchGate — ความมั่นใจเกินเหตุของนักลงทุนในยุค AI: การตัดสินใจของมนุษย์เทียบกับอัลกอริทึม
- SSRN — พฤติกรรมนักลงทุนในตลาดหุ้น: การเกิดขึ้นของ AI และความมั่นใจเกินเหตุจากอัลกอริทึม
- Investor.gov — ปัญญาประดิษฐ์ (AI) และการฉ้อโกงการลงทุน: คำเตือนนักลงทุน
- FINRA — ปัญญาประดิษฐ์ในอุตสาหกรรมหลักทรัพย์: ความท้าทายหลักและข้อพิจารณาด้านกฎระเบียบ
- Harvard Business School — เมื่อ LLM ไปต่างประเทศ: อคติต่อต่างประเทศในการวิเคราะห์การเงินด้วย AI
- Danelfin — ตัวคัดเลือกหุ้น AI และวิธีการของ AI Score
- AI Business Weekly — คู่มือราคา AI ปี 2026: ChatGPT, Claude และ Gemini
- Perplexity — ราคาสำหรับบุคคลทั่วไปและองค์กร
- Helm Terminal — ChatGPT เทียบกับ Claude เทียบกับ Gemini เทียบกับ Perplexity สำหรับการวิจัยหุ้น
- arXiv — LLM สามารถพัฒนาการรวมคาดการณ์ของผู้เชี่ยวชาญได้หรือไม่?
- Lucid.now — AI ในการตัดสินใจทางการเงิน: ข้อค้นพบเชิงพฤติกรรม
- Sidley Austin — ปัญญาประดิษฐ์: แนวทางหน่วยงานกำกับหลักทรัพย์และสินค้าโภคภัณฑ์ของสหรัฐฯ