เครื่องมือสร้างเสียงตัวละคร: เสียง AI สำหรับเกม เรื่องราว และภาพยนตร์
2026-09-06
Jenova ช่วยคุณออกแบบตัวละครที่โดดเด่น เขียนบทสนทนาที่พูดได้อย่างเป็นธรรมชาติ และเตรียมพรอมป์ต์ที่พร้อมใช้ในการผลิตสำหรับเครื่องมือสร้างเสียงตัวละครทุกรูปแบบ ในเดือนกันยายน 2026 ระบบเสียงพูด AI สามารถเลียนแบบคุณลักษณะน้ำเสียงได้ภายในไม่กี่วินาที แต่ผลงานส่วนใหญ่ยังฟังดูไร้เอกลักษณ์ เพราะงานเขียนเบื้องหลังไม่มีบุคลิก การพากย์เสียงในสตูดิโอยังคงช้าและมีต้นทุนสูงสำหรับทีมอินดี้ ขณะที่การใช้ text-to-speech แบบผิวเผินทำให้ทุกบทบาทมีจังหวะการพูดเหมือนกัน
- ✅ บุคลิกที่สอดคล้องกับตัวละครตลอดทั้งเรื่องยาวและลูปเกม
- ✅ บทสนทนาที่เขียนมาเพื่อให้พูดออกเสียง ไม่ใช่แค่อ่านบนหน้าเอกสาร
- ✅ พรอมป์ต์ที่มีโครงสร้างสำหรับโมเดลเสียงและการแปลเป็นภาษาท้องถิ่นสมัยใหม่
- ✅ รองรับสคริปต์ การ์ตูน เพลง และ roleplay ในเวิร์กโฟลว์สร้างสรรค์เดียว
หากต้องการเข้าใจว่าเหตุใดสิ่งนี้จึงสำคัญ ลองดูสิ่งที่ครีเอเตอร์ต้องการจากเครื่องมือสร้างเสียงตัวละครจริง ๆ: ไม่ใช่แถบเลื่อนอีกอันที่ระบุว่า “มีความสุข” แต่คือเสียงที่เป็นของใครบางคน คอขวดแทบไม่เคยอยู่ที่ระบบเรนเดอร์ หากแต่อยู่ที่การสร้างตัวละคร วิธีถ่ายทอดแต่ละประโยค และเส้นแบ่งทางจริยธรรมระหว่างการแสดงต้นฉบับกับการเลียนแบบโดยไม่ได้รับอนุญาต
คำตอบฉบับย่อ: เครื่องมือสร้างเสียงตัวละครคืออะไร?
เครื่องมือสร้างเสียงตัวละครคือระบบ AI ที่สร้างเสียงพูดเฉพาะตัวพร้อมบุคลิก เพื่อให้แต่ละบทบาทฟังดูเป็นคนละคนกัน ครีเอเตอร์ใช้กับเกม เรื่องราว วิดีโอ และการเข้าถึงสำหรับทุกคน — แต่เสียงจะใช้ได้ก็ต่อเมื่อตัวละครมีความชัดเจนอยู่แล้ว
ความสามารถหลัก:
- คุณลักษณะน้ำเสียง จังหวะ และช่วงอารมณ์ที่แตกต่างกันสำหรับแต่ละตัวละคร
- สคริปต์และพรอมป์ต์ที่ยังฟังเป็นธรรมชาติเมื่อผ่าน text-to-speech แทนที่จะฟังเหมือน GPS
- Roleplay ที่ล็อกความสม่ำเสมอของตัวละคร ก่อนที่คุณจะเริ่มสร้างเสียง
- เวิร์กโฟลว์ตัวละครต้นฉบับที่หลีกเลี่ยงการโคลนบุคคลจริงโดยไม่ได้รับความยินยอม
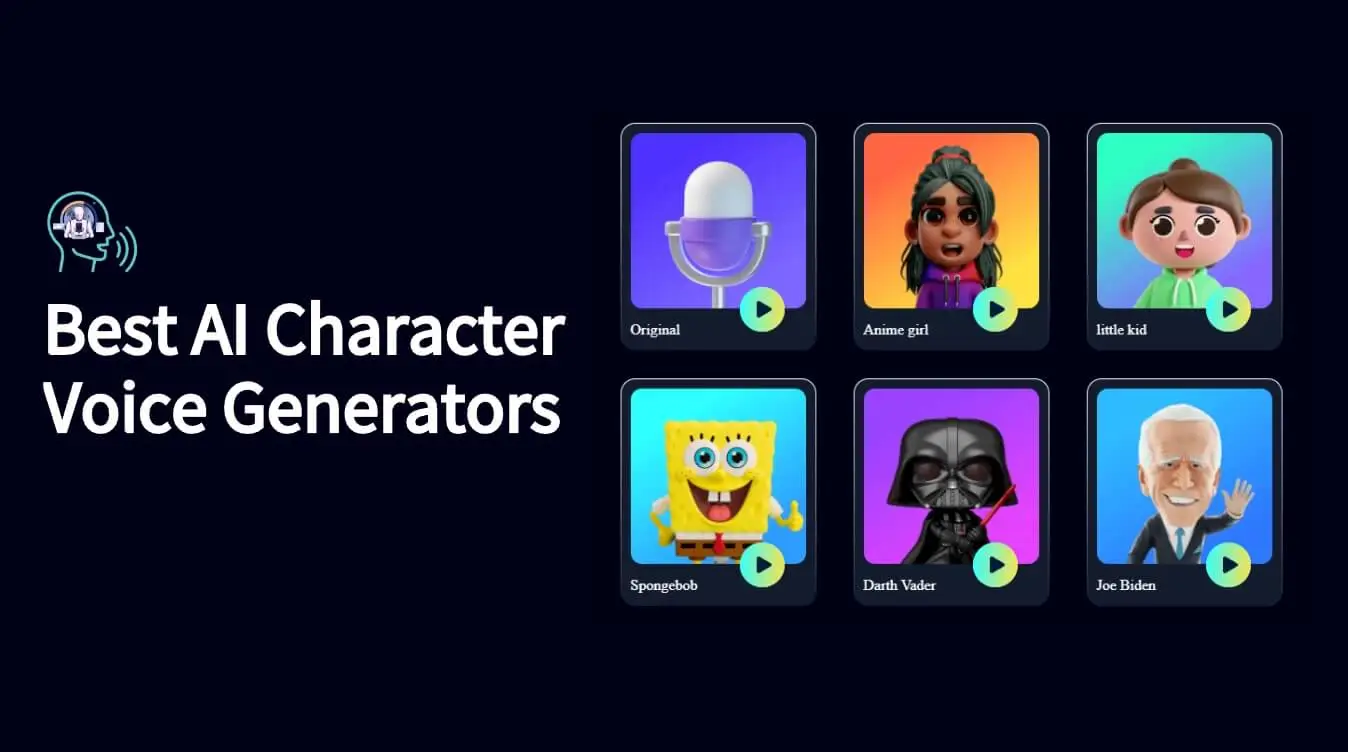
เหตุใดเครื่องมือสร้างเสียงตัวละครส่วนใหญ่จึงยังฟังดูทั่วไป
ความต้องการเสียงสังเคราะห์ไม่ได้เป็นเพียงเรื่องทดลองอีกต่อไป บริษัทวิจัยต่างติดตามการสร้างเสียง AI ในฐานะตลาดเฉพาะของตัวเอง ไม่ใช่ฟีเจอร์เสริมของแชตบอต
USD 6.4 billion — ขนาดตลาดเครื่องมือสร้างเสียง AI ทั่วโลกในปี 2025 โดยคาดว่าจะเติบโตจาก USD 8.36 billion ในปี 2026
USD 19.09 billion — ตลาดการรู้จำคำพูดและเสียงในปี 2025 ซึ่งคาดว่าจะอยู่ที่ USD 23.70 billion ในปี 2026
งบประมาณดังกล่าวกำลังไหลเข้าสู่เกม การแปลเป็นภาษาท้องถิ่น วิดีโอโซเชียล และเสียงสำหรับลูกค้า การใช้ Voice AI เติบโต 9 เท่าในปี 2025 และองค์กรที่สำรวจ 84 เปอร์เซ็นต์วางแผนเพิ่มงบประมาณเทคโนโลยีเสียง แต่การซื้อระบบเรนเดอร์ไม่ได้หมายความว่าคุณได้การแสดง การเข้าถึงเสียงที่ผู้ฟังจดจำได้ยังคงเป็นเรื่องยากอย่างน่าหงุดหงิด:
- ตัวละครทุกตัวได้รับจังหวะ รูปแบบลมหายใจ และโทน “ผู้ช่วยที่พร้อมให้บริการ” แบบเดียวกัน
- เซสชันในสตูดิโอช้าและแพงเกินไปสำหรับ NPC จำนวนมาก นักแสดงใน YouTube และการพากย์ webtoon รายสัปดาห์
- ประโยคที่เขียนมาเพื่ออ่านบนหน้าเอกสารพังเมื่อพูดออกเสียง — อนุประโยคซ้อนกัน มุกหมดความขลัง ชื่อถูกออกเสียงผิด
- การโคลนเสียงคนดังและนักการเมืองสร้างความเสี่ยงด้านกฎหมายและความน่าเชื่อถือ แม้ UI จะทำให้เข้าถึงได้ด้วยการคลิกเดียว
- ทีมต้องสลับระหว่างนักเขียน วิศวกรพรอมป์ต์ นักแต่งเพลง และเครื่องมือเสียง โดยไม่มีคู่มือตัวละครร่วมกัน
เสียงเดิม ป้ายชื่อต่างกัน
เครื่องมือสร้างเสียงตัวละครอาจเปลี่ยนระดับเสียงสูงต่ำได้ แต่ยังล้มเหลวในการสร้างอัตลักษณ์ ผู้ฟังรับรู้ท่าที ไม่ใช่แค่ความถี่: วายร้ายหน่วงพยัญชนะอย่างไร เด็กรีบพูดมุกอย่างไร กัปตันที่เหนื่อยล้าลดระดับเสียงตรงท้ายรายงานอย่างไร งานวิจัยเรื่องเสียงพูดที่รับรู้อารมณ์และเฉพาะตัวละครจากการ์ตูน และการสร้างเสียงหลายตัวละครที่ขับเคลื่อนด้วยข้อความ ยังคงพบข้อสรุปเดียวกัน — โมเดลต้องมีบริบทของตัวละคร ไม่ใช่เพียงเป้าหมายรูปคลื่น หากไม่มีบุคลิกที่เขียนไว้ คุณจะได้เพียงเครื่องแต่งกาย ไม่ใช่การแสดง
กำแพงต้นทุนสำหรับทีมอินดี้และทีมขนาดกลาง
นักแสดงมนุษย์ในบทนำยังคงเหมาะที่สุดสำหรับฉากที่ซับซ้อนทางอารมณ์ ปัญหาด้านการผลิตคือส่วนงานจำนวนมากที่เหลืออยู่: คำทักทายจาก NPC หลายพันประโยค เวอร์ชันภาษาท้องถิ่น และการออกเสียงชื่อผู้เล่น การวิเคราะห์อุตสาหกรรมเกี่ยวกับเสียง AI อย่างมีจริยธรรมในเกมอธิบายการแบ่งงานแบบมนุษย์ร่วมกับ AI — นักแสดงดูแลฉากสำคัญ ขณะที่การสังเคราะห์รับภาระงานปริมาณมาก — และระบุว่าทีมอินดี้สามารถแปลเป็นภาษาต่าง ๆ หลายสิบภาษาได้ในเวลาไม่กี่สัปดาห์แทนที่จะเป็นหลายเดือน สิ่งนี้จะช่วยได้ก็ต่อเมื่อประโยคต้นทางพูดได้อย่างเป็นธรรมชาติ และรายละเอียดตัวละครมีความคงที่ มิฉะนั้นคุณก็แค่จ่ายเงินเพื่อขยายจำนวนเสียงคุณภาพปานกลาง
สคริปต์ที่ไม่เคยถูกเขียนมาเพื่อให้ได้ยิน
ร้อยแก้วแบบนิยายและข้อความ UI ขัดกับการพูด อนุประโยคซ้อน คำย่อที่ไม่อธิบาย และชื่อแฟนตาซีที่ออกเสียงยาก บังคับให้โมเดลเน้นเสียงอย่างหุ่นยนต์ เครื่องมือสร้างเสียงตัวละครจะเรนเดอร์ประโยคที่แย่อย่างซื่อสัตย์ วิธีแก้อยู่ต้นน้ำ: จังหวะที่สั้นขึ้น การสะกดตามเสียง คำกำกับการแสดงด้านอารมณ์ และบทสนทนาที่นักแสดงสามารถพูดได้จริงในลมหายใจเดียว
ความยินยอม การโคลน และแพลตฟอร์มที่ชวนให้เกิดปัญหา
ระบบ zero-shot สามารถเลียนแบบคุณลักษณะน้ำเสียงได้ในเวลาราวสามวินาที ความเร็วนี้มีประโยชน์สำหรับเสียงจำลองที่ได้รับความยินยอมและตัวละครต้นฉบับ แต่เป็นอันตรายเมื่อคลังเสียงนำบุคคลสาธารณะหรือมาสคอตที่มีลิขสิทธิ์มาเป็นพรีเซ็ต FTC ระบุอย่างชัดเจนว่าไม่มีข้อยกเว้นสำหรับ AI จากกฎหมายคุ้มครองผู้บริโภคที่มีอยู่ และได้ใช้ทั้ง Voice Cloning Challenge และกฎต่อต้านการแอบอ้างเพื่อจัดการกับเสียงหลอกลวง ในเกม Interactive Media Agreement เดือนกรกฎาคม 2025 ผ่านการอนุมัติด้วยคะแนน 95.04% และกำหนดให้ความยินยอมเป็นลายลักษณ์อักษรเป็นสิ่งที่ต่อรองไม่ได้สำหรับการทำซ้ำเสียง หากไปป์ไลน์ของคุณพิสูจน์ความยินยอมไม่ได้ ก็อย่าสร้างเสียงนั้น
นี่คือสิ่งที่ Jenova ถูกสร้างขึ้นมาเพื่อทำโดยเฉพาะ: ความชาญฉลาดด้านตัวละครรอบเครื่องมือสร้างเสียง ไม่ใช่ทางลัดเพื่อหลีกเลี่ยงกฎหมาย
โซลูชันของ Jenova
เครื่องมือสร้างเสียงตัวละครเปลี่ยนข้อความเป็นเสียง Jenova ทำให้ข้อความนั้นคุ้มค่าที่จะพากย์ คุณกำหนดว่าใครกำลังพูด พวกเขาคิดอย่างไร มีอะไรที่พวกเขาจะไม่มีวันพูด และแต่ละประโยคควรส่งอารมณ์อย่างไร — จากนั้นจึงส่งพรอมป์ต์และสคริปต์ที่สะอาดให้กับโมเดลเสียงที่คุณใช้ แพลตฟอร์มเสียงเฉพาะทางเรนเดอร์รูปคลื่น ส่วนแพลตฟอร์มนี้สร้างบุคคลเบื้องหลังรูปคลื่น
| แนวทางดั้งเดิม | Jenova |
|---|---|
| จองห้องบันทึกเสียง รอเซสชัน และตัดต่อใหม่ทุกครั้งที่แก้เสียง | รายละเอียดตัวละครและฉบับร่างที่พูดได้ในเซสชันทำงานเดียว |
| เสียง TTS เดียวพร้อมชื่อที่แสดงใหม่ | บุคลิก การออกเสียง และจังหวะอารมณ์ที่เขียนแยกตามบทบาท |
| โคลนเสียงคนดังแล้วหวังว่าจะไม่มีใครสังเกต | ตัวละครต้นฉบับ เสียงจำลองที่ได้รับความยินยอม และการใช้งานที่มีเอกสารรองรับ |
| นักเขียนอยู่แท็บหนึ่ง โน้ตพรอมป์ต์อยู่แท็บหนึ่ง นักแต่งเพลงอยู่แท็บที่สาม | เอเจนต์ที่เชื่อมโยงกันสำหรับเรื่องราว พรอมป์ต์ การ์ตูน เพลง และการส่งมอบงาน |
| การแปลที่แบนราบและไม่สนใจอารมณ์ขันหรือจังหวะ | ประโยคที่จัดโครงสร้างให้พอดีกับจำนวนพยางค์และการปรับเขียนตามวัฒนธรรม |
คู่มือตัวละครก่อนแตะงานเสียง
เริ่มจากอัตลักษณ์ ไม่ใช่พรีเซ็ต Name Generator สร้างชื่อที่สอดคล้องกับวัฒนธรรมและออกเสียงได้ — ตัวกรองที่ใช้งานได้จริงซึ่งไปป์ไลน์เสียงจำนวนมากข้ามไปจนกระทั่งโมเดลเจอกลุ่มพยัญชนะยาก ๆ จับคู่กับ Writing Assistant เพื่อล็อกลักษณะการใช้ภาษา: ขอบเขตคำศัพท์ คำต้องห้าม มุกที่พูดซ้ำ และอุปมาเดียวที่ตัวละครมักหยิบมาใช้ เมื่อมีข้อจำกัดเหล่านี้ เครื่องมือสร้างเสียงตัวละครใด ๆ ก็จะมีสิ่งเฉพาะเจาะจงให้แสดง
บทสนทนาที่สร้างมาเพื่อปาก
Film Screenwriter มองแต่ละประโยคเป็นพฤติกรรมที่มีจังหวะ: การขัดจังหวะ ความเงียบ และความหมายแฝง ทักษะนี้ถ่ายทอดสู่ประโยคสั้นในเกม ดราม่าแนวตั้ง และการ์ตูนพากย์เสียงได้โดยตรง คุณจะได้คำกำกับในวงเล็บที่โมเดลเสียงทำตามได้ (“พูดพึมพำก่อน แล้วค่อยสดใสขึ้น”) แทนป้ายกว้าง ๆ อย่าง “เศร้า” สำหรับการเล่าเรื่องแบบซีรีส์บนมือถือ Microdrama Screenwriter ช่วยให้จุดค้างคาใจสั้นพอจะพากย์ได้โดยไม่ต้องหอบ
ตัวอย่างคำสั่งที่คุณวางลงในเครื่องมือสร้างเสียงได้:
"อ่านเป็น Captain Ilya Voss อายุ 50 กว่า ๆ เสียงต่ำแหบจากช่วงอก เธอไม่เคยเพิ่มระดับเสียงเมื่อโกรธ — เธอจะพูดช้าลง ประโยค: 'คุณเอาแผนที่มา แต่คุณไม่ได้เอาสภาพอากาศมา' หยุดหลังคำว่า แผนที่ อย่ายิ้ม"
พรอมป์ต์ที่อยู่รอดเมื่อต้องทำงานกับโมเดล
“เสียง AI ที่แย่” ส่วนใหญ่เกิดจากคำสั่งที่แย่ Prompt Generator เปลี่ยนคู่มือตัวละครเป็นข้อความพร้อมใช้กับโมเดล: โน้ตสำเนียง อายุ พื้นที่บันทึกเสียง แนวอารมณ์ และพรอมป์ต์เชิงลบ (“ไม่มีจังหวะแบบผู้ประกาศข่าว อย่ายิ้มในเสียงสระ”) นั่นคือความแตกต่างระหว่างบัตรรายการในคลังชื่อ “Anime Girl” กับบุคคลที่บังเอิญเป็นตัวละครแอนิเมชัน
ภาพ ดนตรีประกอบ และส่วนที่เหลือของฉาก
เสียงเป็นเพียงชั้นหนึ่ง Graphic Designer สร้างใบหน้าที่หูของผู้ฟังคาดว่าจะได้ยิน Manga Creator, Comic Creator และ Webtoon Creator สร้างงานศิลปะแบบลำดับภาพ ซึ่งคุณสามารถใส่ดนตรีประกอบให้เข้ากับการขยับปากและจังหวะแผงภาพได้ Music Composition Assistant และ Lyric Writer มอบทำนองประจำตัวละครและเนื้อร้องที่ร้องได้ เพื่อให้เสียงพูดและบทเพลงอยู่ในโลกเดียวกัน
ขณะที่ API เสียงเฉพาะทางเชี่ยวชาญด้านการเรนเดอร์เสียง Jenova เชี่ยวชาญด้านการเขียน การสร้างพรอมป์ต์ และความต่อเนื่อง ซึ่งเป็นตัวตัดสินว่าผู้คนอยากฟังเสียงนั้นเป็นครั้งที่สองหรือไม่
เอเจนต์ AI เฉพาะทางสำหรับงานเสียงตัวละคร
ลองใช้ Jenova ได้ฟรี — ไม่ต้องใช้บัตรเครดิต เอเจนต์เหล่านี้ครอบคลุมงานที่อยู่ก่อนและหลังเครื่องมือสร้างเสียงตัวละครโดยตรง
Roleplay Game Master
หากคุณต้องการ ได้ยิน ตัวละครผ่านภาษา ก่อนจะสังเคราะห์เสียง นี่คือห้องซ้อมของคุณ หน่วยความจำไม่จำกัดช่วยให้ลักษณะการใช้ภาษา ความลับ และความสัมพันธ์คงที่ข้ามแต่ละเซสชัน ซึ่งเทียบเท่ากับโมเดลเสียงที่ล็อกไว้ในรูปแบบข้อความ
- ทดสอบวลีติดปากจนฟังดูเป็นธรรมชาติอย่างหลีกเลี่ยงไม่ได้
- แยกเสียงของสมาชิกปาร์ตี้และ NPC ออกจากกันในแคมเปญยาว
- สร้างประโยคตามบุคลิกที่คุณสามารถใส่ลงในเครื่องมือสร้างเสียงได้ทันที
Film Screenwriter
ใช้เมื่อเสียงต้องแบกรับโครงเรื่อง ไม่ใช่แค่เพิ่มรสชาติ โครงสร้าง เป้าหมายของฉาก และงานฝีมือด้านบทสนทนาช่วยป้องกันไม่ให้การแสดงกลายเป็นคำอธิบายข้อมูลด้วยสำเนียงตลก ๆ
- จังหวะและความขัดแย้งที่รองรับการเปลี่ยนอารมณ์ในเสียง
- ประโยคสั้นที่แก้ไขเพิ่มเติมได้ง่ายสำหรับเกมและโฆษณา
- การพัฒนาตัวละครที่ยังคงอยู่ได้ผ่านการพากย์ 12 ตอน
Prompt Generator
โมเดลเสียงจะดีได้เท่ากับบรีฟที่ได้รับ เอเจนต์นี้เขียนพรอมป์ต์สำหรับระบบข้อความ ภาพ เพลง และวิดีโอ — รวมถึงโมเดลเสียงที่คุณจ่ายเงินใช้อยู่แล้ว
- บล็อกพรอมป์ต์ที่สม่ำเสมอสำหรับแต่ละตัวละคร เพื่อให้แต่ละตอนเข้ากัน
- คำบรรยายอารมณ์และพื้นที่ที่โมเดลทำตามได้จริง
- การปรับปรุงแบบวนซ้ำเมื่อเทคที่ได้สดใสหรือช้าเกินไป
Writing Assistant
เครื่องมือหลักสำหรับคู่มือตัวละคร คำบรรยาย และการเขียนใหม่ให้ “ฟังดูเหมือนพวกเขา” โดยจะปรับตามรูปแบบและกลุ่มผู้ฟัง ดังนั้นการเทข้อมูลตำนานโลกและคำด่าในโรงเตี๊ยมจึงไม่ใช้จังหวะประโยคเดียวกัน
- ตรวจแก้เพื่อให้พูดได้ง่ายและมีระดับการอ่านที่เหมาะสม
- จับคู่โทนให้สอดคล้องกันในข้อความภารกิจ ตัวอย่างภาพยนตร์ และบันทึกอัปเดต
- ทำงานร่วมกันเมื่อคุณมีฉบับร่างที่เกือบใช้ได้แล้ว
Music Composition Assistant
เครื่องมือสร้างเสียงตัวละครดูแลเสียงพูด เอเจนต์นี้ดูแลดนตรีรองรับด้านล่าง — ทำนองประจำตัว ฮาร์โมนี และโน้ตเรียบเรียงที่คุณส่งต่อให้ DAW หรือโมเดลอื่นได้
- Leitmotif ที่ผูกกับบทบาทเฉพาะ
- แผนจังหวะที่เว้นพื้นที่ให้บทสนทนา
- คำแนะนำที่คำนึงถึงทฤษฎีดนตรี เพื่อไม่ให้ธีมวายร้ายชนกับช่วงเสียงร้อง
Public Speaking Coach
เมื่อคุณเป็นผู้แสดงเอง — หรือต้องกำกับผู้แสดง — เอเจนต์นี้ช่วยเรื่องการถ่ายทอด ความกังวล และผู้ฟัง นี่คือคู่ขนานฝั่งมนุษย์ของเสียงสังเคราะห์: ลมหายใจ การเว้นจังหวะ และการเน้นเสียงที่คุณสามารถเข้ารหัสลงในพรอมป์ต์ได้
- เครื่องหมายกำกับความเร็วและการเน้นที่ถ่ายทอดไปยังแท็ก TTS ได้
- ซ้อม Q&A และการอ่านสดสำหรับสตรีมแบบผสม
- โน้ตว่าแต่ละประโยคกำลังทำอะไรกับผู้ฟัง ไม่ใช่แค่ฟังดูอย่างไร
เวิร์กโฟลว์เครื่องมือสร้างเสียงตัวละครทำงานอย่างไรจริง ๆ
คุณไม่จำเป็นต้องมีสตูดิโอก่อน คุณต้องการคนคนหนึ่งบนหน้าเอกสาร ประโยคที่พูดได้ และพรอมป์ต์ที่ไม่ขัดแย้งกันเอง
ขั้นตอนที่ 1: ล็อกบุคคล ไม่ใช่พรีเซ็ต
เขียนอายุ สถานะ ร่างกาย และกฎหนึ่งข้อที่พวกเขาไม่เคยละเมิด สร้างชื่อที่ออกเสียงได้ จากนั้นเขียนคู่มือตัวละคร 150 คำ หากตัวละครสองตัวสลับประโยคกันได้โดยไม่มีใครสังเกต แสดงว่าคุณยังไม่มีเสียงสองเสียง
"สร้างคู่มือตัวละครสำหรับ Ryn Calder อายุ 17 ปี เป็นผู้ส่งของทางแม่น้ำ สุภาพกับสินค้าเสมอแต่หยาบคายกับกัปตัน ใช้ประโยคสั้น ห้ามใช้สแลงที่เกิดขึ้นหลังหมู่บ้านของเธอถูกเผา บอกฉันสามประโยคที่เธอจะไม่มีวันพูด"
ขั้นตอนที่ 2: เขียนประโยคเพื่อการหายใจ ไม่ใช่เพื่อหน้าเอกสาร
ย้ายฉากไปที่ Writing Assistant หรือ Film Screenwriter ตัดอนุประโยคซ้อน สะกดชื่อยาก ๆ ตามเสียงในวงเล็บเหลี่ยม เพิ่มโน้ตการแสดงที่โมเดลทำได้
"เขียนย่อหน้าตำนานโลกนี้ใหม่เป็นประโยคพูดหกประโยคสำหรับ Ryn แต่ละประโยคยาวไม่เกิน 12 คำ และทำเครื่องหมายหยุดก่อนประโยคสุดท้าย"
ขั้นตอนที่ 3: เปลี่ยนคู่มือตัวละครเป็นพรอมป์ต์สำหรับเครื่องมือสร้างเสียง
ส่งข้อจำกัดชุดเดิมให้ Prompt Generator ระบุพื้นที่บันทึกเสียง ระยะห่างไมโครโฟน อารมณ์ในระดับ 1–5 และสิ่งที่ต้องหลีกเลี่ยง บันทึกบล็อกแยกสำหรับแต่ละตัวละครเพื่อไม่ให้ตอนที่สี่หลุดคาแรกเตอร์
"แปลงคู่มือตัวละครของ Ryn เป็นพรอมป์ต์สำหรับโมเดลเสียง: อัลโตวัยรุ่น แห้งกังวาน เสียงก้องในโกดังในร่ม จังหวะ 1.05x ไม่ยิ้ม ไม่มีการลงท้ายแบบผู้ประกาศข่าว ใส่พรอมป์ต์เชิงลบด้วย"
ขั้นตอนที่ 4: จับคู่ใบหน้า แผงภาพ และดนตรีประกอบ
ใส่คู่มือตัวละครชุดเดียวกันลงในเอเจนต์ภาพและดนตรี เพื่อให้ภาพและดนตรีรองรับสอดคล้องกับเสียง ใบหน้าการ์ตูนสดใสที่จับคู่กับการอ่านแบบไว้อาลัย คือวิธีที่ผู้ฟังตัดสินว่าเสียงนั้นปลอม แม้โมเดลจะแม่นยำก็ตาม
ขั้นตอนที่ 5: ซ้อมบนโทรศัพท์ แล้วค่อยเรนเดอร์
Jenova ทำงานได้เต็มฟีเจอร์เท่าเทียมกันบนเว็บ iOS และ Android อ่านประโยคออกเสียงระหว่างเดินทาง ทำเครื่องหมายจุดที่ติดขัด เขียนใหม่ แล้วค่อยวางลงในเครื่องมือสร้างเสียงตัวละครของคุณ การแก้เสียงที่ประหยัดที่สุดคือการแก้ที่คุณไม่ต้องบันทึกเลย
ผลลัพธ์และกรณีใช้งาน
🎮 NPC เกมอินดี้โดยไม่ต้องมีงบสตูดิโอ
สถานการณ์: RPG ความยาว 12 ชั่วโมงต้องใช้ประโยคที่ไม่ใช่ตัวละครหลัก 4,000 ประโยค พร้อมการออกเสียงชื่อผู้เล่น
แนวทางดั้งเดิม: เซสชันนักแสดงสหภาพสำหรับตัวละครหลัก คนอื่นเงียบหรือใช้ประโยคซ้ำ และการแปลเป็นภาษาท้องถิ่นถูกเลื่อนไปทำ “สักวันหนึ่ง”
Jenova: ฉากตัวละครหลักยังคงใช้มนุษย์ ส่วนงานปริมาณมากจะได้รับคู่มือตัวละคร ประโยคที่พูดได้ และพรอมป์ต์ที่คงที่ เพื่อให้เครื่องมือสร้างเสียงตัวละครของคุณเติมเต็มบทคนต้อนรับ เจ้าของร้าน และ NPC ที่บอกข่าวลือ โดยไม่ต้องโคลนเสียงคนดัง
- รายละเอียดตัวละครที่ทำให้ช่างตีเหล็กไม่ฟังดูเหมือนพ่อมด
- ประโยคสั้นที่พร้อมสำหรับการแปลเป็นภาษาท้องถิ่น
- บล็อกพรอมป์ต์ที่คุณจัดเวอร์ชันได้เหมือนโค้ด
🎬 การพากย์ Webtoon และ Comic
สถานการณ์: ซีรีส์แนวตั้งรายสัปดาห์ต้องการตอนเสียงโดยไม่ต้องรอทีมนักพากย์เต็มชุด
แนวทางดั้งเดิม: การพากย์โดยแฟนที่ใช้ไมโครโฟนไม่เข้ากัน หรือผู้บรรยายคนเดียวเล่นทุกบท
Jenova: Webtoon Creator และ Comic Creator รักษาความต่อเนื่องด้านภาพ ขณะที่นักเขียนบทแยกเสียงตามแต่ละแผงภาพ แต่ละบทบาทมีพรอมป์ต์ของตัวเอง เพื่อไม่ให้เครื่องมือสร้างเสียงต้องเดา
- ประโยคที่จับเวลาให้ตรงแผงภาพ แทนการเทร้อยแก้วจำนวนมาก
- นักแสดงที่แตกต่างสำหรับบทนำและกลุ่มคนจำนวนมาก
- คิวดนตรีที่เว้นพื้นที่ให้เสียงพูด
📱 ฝึกภาษาที่ฟังดูเหมือนคุยกับใครบางคน
สถานการณ์: คุณกำลังเดินทางและต้องการสนทนา ไม่ใช่เสียงจากตำราเรียน
แนวทางดั้งเดิม: แบบฝึกใน App ที่มีครูสังเคราะห์คนเดียว และไม่จดจำข้อผิดพลาดของคุณ
Jenova: Learn English Through Roleplay พาคุณเข้าไปอยู่ในฉากกับตัวละครที่มีความต่อเนื่อง จากนั้นคุณสามารถนำประโยคเดิมไปสร้างเสียงในเครื่องมือสร้างเสียง เพื่อฝึกการฟัง — โดยยังใช้ตัวละครต้นฉบับ ไม่ใช่การแอบอ้างบุคคลจริง
- หน่วยความจำที่ทำให้บาริสต้าไม่รีเซ็ตทุกเซสชัน
- สำนวนที่อยู่ในสถานการณ์ซึ่งคุณจะนำไปใช้ซ้ำได้จริง
- เซสชันบนมือถือที่พอดีกับการนั่งรถไฟ
🎙️ รายการ Podcast และคอนเทนต์โซเชียลที่มีเอกลักษณ์แบรนด์
สถานการณ์: ช่องผลิตภัณฑ์ต้องการพิธีกร เพื่อนคู่หูสายตั้งข้อสงสัย และคำปฏิเสธความรับผิดชอบแบบอ่านสดทุกสัปดาห์
แนวทางดั้งเดิม: ใช้เสียงผู้ก่อตั้งคนเดิมทุกช่วง หรือจ้างฟรีแลนซ์ที่ไม่ว่างทุกวันพฤหัสบดี
Jenova: Social Media Content Generator ร่างสคริปต์ตามธรรมชาติของแต่ละแพลตฟอร์ม ขณะที่เอเจนต์งานเขียนและพรอมป์ต์ป้องกันไม่ให้พิธีกรกับเพื่อนคู่หูหลอมรวมเป็นคนเดียวกัน คุณเรนเดอร์ด้วยเครื่องมือเสียงที่มีใบอนุญาต ไม่ใช่โคลนบุคคลสาธารณะโดยไม่ได้รับอนุญาต
- มุกประจำที่มีลักษณะการใช้ภาษาคงที่
- คำปฏิเสธความรับผิดชอบที่เขียนมาเพื่อพูด ไม่ใช่กวาดตาอ่าน
- เปิดเรื่องที่มีขนาดพอดีกับ Shorts, Reels และตอนเต็ม
คำถามที่พบบ่อย
เครื่องมือสร้างเสียงตัวละครคืออะไร?
เครื่องมือสร้างเสียงตัวละครคือซอฟต์แวร์ที่เปลี่ยนข้อความเป็นเสียงพูดโดยมีอัตลักษณ์ที่เลือกไว้ — อายุ ระดับเสียง สำเนียง และอารมณ์ — เพื่อไม่ให้บทบาทต่าง ๆ ใช้จังหวะเดียวกัน โมเดลเสียงให้คุณลักษณะน้ำเสียง งานเขียนตัวละคร คำกำกับการแสดง และพรอมป์ต์ให้ตัวตน เครื่องมือบน Jenova อยู่ฝั่งงานเขียนนี้: คู่มือตัวละคร บทสนทนา และคำสั่งพร้อมใช้กับโมเดล ซึ่งคุณวางลงในระบบเสียงที่มีใบอนุญาตใดก็ได้
เครื่องมือสร้างเสียงตัวละครใช้ฟรีได้หรือไม่?
App เสียงจำนวนมากมีระดับใช้งานฟรีแบบจำกัด และคิดค่าบริการสำหรับคลิปยาว สิทธิ์เชิงพาณิชย์ หรือเสียงที่โคลน Jenova มีแผนฟรีพร้อมฟีเจอร์หลัก และระดับแบบชำระเงินหากคุณต้องการใช้งานมากขึ้น วางงบสำหรับต้นทุนสองส่วน: งานสร้างสรรค์ (สคริปต์ พรอมป์ต์ ความต่อเนื่อง) และระบบเรนเดอร์ (นาทีของเสียง ใบอนุญาตเสียง) ความยินยอมและเงื่อนไขเชิงพาณิชย์สำหรับเสียงที่โคลนเป็นเรื่องแยกจากราคาสมาชิก — อ่านทั้งสองส่วนก่อนเผยแพร่
ฉันจะทำให้เสียงตัวละคร AI มีเอกลักษณ์ได้อย่างไร?
กำหนดกฎหนึ่งข้อ ขอบเขตคำศัพท์ และนิสัยทางกายภาพให้แต่ละบทบาท จากนั้นเขียนประโยคที่พวกเขาไม่สามารถสลับกันพูดได้ ใส่ข้อจำกัดเหล่านี้ลงในพรอมป์ต์ทุกครั้ง: พื้นที่ จังหวะ อารมณ์ และพรอมป์ต์เชิงลบเพื่อป้องกันจังหวะแบบผู้ประกาศข่าว Prompt Generator ถูกสร้างมาเพื่อบรีฟประเภทนี้ หากตัวละครสองตัวยังฟังเหมือนกันหลังจากใช้พรอมป์ต์ที่ดี ปัญหาอยู่ที่คู่มือตัวละคร ไม่ใช่แถบเลื่อน
การโคลนเสียงบุคคลจริงถูกกฎหมายหรือไม่?
ไม่ใช่โดยอัตโนมัติ และไม่ควรเป็นพรีเซ็ตเพื่อมุกตลก คุณต้องมีความยินยอมที่ชัดเจนและบันทึกไว้สำหรับการใช้งานที่คุณตั้งใจจริง รวมถึงต้องปฏิบัติตามกฎด้านสิทธิในภาพลักษณ์และลิขสิทธิ์ที่ใช้ในเขตอำนาจศาลของคุณ FTC มองการโคลนเสียง AI ที่หลอกลวงเป็นปัญหาด้านการคุ้มครองผู้บริโภค ไม่ใช่เรื่องแปลกใหม่ ข้อตกลงในเกมและบันเทิงกำหนดความยินยอมเป็นลายลักษณ์อักษรและการรายงานการใช้งานเพิ่มขึ้นเรื่อย ๆ สร้างตัวละครต้นฉบับหรือเสียงจำลองที่มีใบอนุญาต อย่าดึงเสียงนักการเมือง นักแสดง หรือนักร้องมาใช้เพียงเพราะแดชบอร์ดทำให้ง่าย
ฉันใช้เวิร์กโฟลว์นี้บนโทรศัพท์ได้หรือไม่?
ได้ Jenova สร้างขึ้นสำหรับเว็บ iOS และ Android พร้อมความสามารถหลักชุดเดียวกัน รวมถึง speech-to-text เมื่อคุณอยากพูดบันทึกแทนการพิมพ์ระหว่างเดินทาง ร่างประโยคบนรถไฟ ปรับให้กระชับ สร้างพรอมป์ต์ แล้วเรนเดอร์ในเครื่องมือเสียงบนเดสก์ท็อป หากเป็นที่ที่โมเดลที่มีใบอนุญาตของคุณอยู่
สิ่งนี้ต่างจาก text-to-speech ธรรมดาอย่างไร?
TTS ธรรมดาอ่านคำ เครื่องมือสร้างเสียงตัวละครพยายามแสดงบทบาท การแสดงยังคงขึ้นอยู่กับงานเขียน: อัตลักษณ์ ความขัดแย้ง และคำกำกับ Jenova ไม่ได้แทนที่ระบบเรนเดอร์เสียงที่มีใบอนุญาตของคุณ แต่สร้างงานด้านตัวละครที่ระบบเรนเดอร์นั้นต้องใช้ ผ่านเอเจนต์อย่าง Roleplay Game Master และ Film Screenwriter เพื่อให้คุณไม่ต้องจ่ายเงินเพื่อฟังผู้ช่วยฝึกงานคนเดิมในเครื่องแต่งกายหกชุด
บทสรุป
เครื่องมือสร้างเสียงตัวละครจะดีได้เท่ากับบุคคลที่คุณขอให้มันเป็น ตลาดเสียงพูด AI เติบโตอย่างรวดเร็ว โมเดลสามารถล็อกคุณลักษณะน้ำเสียงได้ในไม่กี่วินาที และหน่วยงานกำกับดูแลได้ปฏิเสธแนวคิดที่ว่า “AI เป็นคนทำ” คือข้อแก้ต่างไปแล้ว เส้นทางที่ใช้งานได้จริงนั้นแคบกว่าและดีกว่า: ตัวละครต้นฉบับ เสียงจำลองที่ได้รับความยินยอม งานเขียนที่พูดได้ และพรอมป์ต์ที่ทำซ้ำได้
ออกแบบบทบาท เขียนลมหายใจ แล้วจึงสร้างเทค เริ่มต้นกับ Jenova — แล้วนำประโยคเหล่านั้นไปใช้กับเครื่องมือเสียงที่คุณไว้วางใจอยู่แล้ว
สำรวจเวิร์กโฟลว์เดียวกันเพิ่มเติมด้วย Roleplay Game Master, Writing Assistant และ Prompt Generator เมื่อตัวละครชัดเจน เสียงก็มีที่ให้ไปต่อ
สำหรับนักพัฒนา: เอเจนต์ทุกตัวในบทความนี้พร้อมใช้งานผ่าน Jenova API — ผสานคู่มือตัวละคร การสร้างบทสนทนา และการสร้างพรอมป์ต์สำหรับโมเดลเสียงเข้ากับแอปพลิเคชันของคุณด้วยการเชื่อมต่อเพียงครั้งเดียว เอกสารฉบับเต็ม →