ผู้ช่วยวิจัย AI เฉพาะทางน่าเชื่อถือกว่าแชตบอตหรือไม่?
2026-08-22
การตรวจสอบย้อนกลับและการยึดโยงกับแหล่งข้อมูลทำให้ AI เพื่อการวิจัยต่างจากแชตบอตอย่างไร?
ผู้ช่วยวิจัยเชิงวิชาการเฉพาะทางมีความน่าเชื่อถือกว่าแชตบอต AI ทั่วไปในด้านการตรวจสอบย้อนกลับของการอ้างอิงและการดึงหลักฐาน เพราะพวกมันค้นคืนข้อมูลจากดัชนีงานวิชาการ เชื่อมข้ออ้างเข้ากับข้อความตอนที่ระบุได้ และแสดงบริบทที่สนับสนุนหรือขัดแย้งกัน แชตบอตทั่วไปสร้างภาษาบรรณานุกรมที่ลื่นไหลจากรูปแบบในข้อมูลฝึก จึงยังสามารถแต่งชื่อผู้เขียน ชื่อเรื่อง DOI และผลการศึกษา ซึ่งไม่อาจย้อนกลับไปยังแหล่งที่มาได้
ช่องว่างด้านความน่าเชื่อถือไม่ได้อยู่ที่คุณภาพการเขียน แต่อยู่ที่ว่าข้ออ้างหนึ่งสามารถตรวจสอบได้หรือไม่
ปัจจัยสำคัญที่แยกการช่วยวิจัยที่อ้างอิงได้ออกจากร้อยแก้วของแชตบอต:
✅ ค้นคืนก่อนสร้างคำตอบ — คำตอบประกอบขึ้นจากบทความที่อยู่ในดัชนี ไม่ใช่จากความน่าจะเป็นของโทเค็นถัดไปเพียงอย่างเดียว
✅ การระบุที่มาระดับข้อความตอน — ข้อค้นพบที่ดึงออกมาแต่ละข้อชี้ไปยังประโยค ตาราง หรือหัวข้อ ไม่ใช่เพียงชื่อบทความ
✅ การมองเห็นความขัดแย้ง — งานภายหลังที่สนับสนุน โต้แย้ง หรือเพียงกล่าวถึงข้ออ้าง จะถูกนำเสนอแทนที่จะถูกรวมเป็นบทสรุปเดียว
✅ การดึงข้อมูลแบบมีโครงสร้าง — วิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัด ถูกดึงเข้าสู่ฟิลด์ที่เปรียบเทียบกันได้ แทนการสรุปเป็นย่อหน้าที่ถอดความ
✅ ที่มาที่มนุษย์ตรวจสอบได้ — ทุกบทสรุป การอ้างอิง และข้อค้นพบที่ดึงออกมาสามารถเปิดเทียบกับแหล่งต้นฉบับได้
หากต้องการเปรียบเทียบเครื่องมือเหล่านี้อย่างมีประโยชน์ในปี 2026 ควรมองความน่าเชื่อถือของการอ้างอิงเป็นคุณสมบัติทางวิศวกรรม ไม่ใช่คำสัญญาของแบรนด์ ส่วนที่เหลือของบทความนี้จะประเมินแชตบอตและผู้ช่วยวิจัยตามคุณสมบัตินั้น
เหตุใดความน่าเชื่อถือของการอ้างอิงจึงกลายเป็นปัญหาด้านความซื่อสัตย์ในการวิจัย?
ความน่าเชื่อถือของการอ้างอิงกลายเป็นปัญหาด้านความซื่อสัตย์ในการวิจัย เพราะปัจจุบันมีการใช้ AI เชิงกำเนิดในระดับการเผยแพร่ผลงาน ขณะที่โมเดลทั่วไปยังสร้างเอกสารอ้างอิงปลอมที่ดูสมจริงพอจะผ่านการตรวจทานแบบผิวเผินได้ การนำไปใช้โดยนักศึกษาและนักวิจัยเพิ่มขึ้นอย่างรวดเร็วในปี 2025 และการอ้างอิงที่แต่งขึ้นไม่ใช่ความผิดพลาดแปลกใหม่อีกต่อไป แต่กำลังเข้าสู่เอกสารประชุม ต้นฉบับบทความ และกราฟการอ้างอิง
แบบสำรวจนักศึกษาปี 2025 ของ Higher Education Policy Institute พบว่า การใช้เครื่องมือ AI เชิงกำเนิดสำหรับการประเมินผลเพิ่มจาก 53% เป็น 88% ภายในหนึ่งปี รายงานที่เกี่ยวข้องจากแบบสำรวจเดียวกันระบุว่า ปัจจุบันนักศึกษา 92% ใช้ AI ไม่ทางใดก็ทางหนึ่ง เพิ่มจาก 66% ในปี 2024 ปริมาณการใช้งานนี้สำคัญ เพราะเอกสารอ้างอิงปลอมที่ดูน่าเชื่อถือจับได้ยากกว่าเอกสารอ้างอิงที่เว้นว่างไว้
การวิเคราะห์ในปี 2026 ใน Energy Research & Social Science รายงานว่า ChatGPT สร้างเอกสารอ้างอิง 178 รายการสำหรับข้อเสนอโครงการวิจัย โดย 69 รายการไม่มี DOI ที่ใช้ได้ บทความเดียวกันอ้างถึง การตรวจทานของ GPTZero ต่อบทความ NeurIPS 2025 จำนวน 4,841 ฉบับ ซึ่งยืนยันว่ามีการอ้างอิงหลอนอย่างน้อย 100 รายการในบทความที่ได้รับตอบรับ 53 ฉบับ การทบทวนโดยผู้เชี่ยวชาญหลายคนยังตรวจไม่พบสิ่งเหล่านี้
กลไกดังกล่าวได้รับการอธิบายไว้ชัดเจนแล้ว AI hallucination คือผลลัพธ์ที่ลื่นไหลแต่เป็นเท็จหรือไม่ยึดโยงกับแหล่งข้อมูล แนวทางจากห้องสมุดมหาวิทยาลัยระบุว่าแชตบอตสามารถแต่งการอ้างอิงขึ้นมาทั้งรายการได้ ทั้งผู้เขียน ชื่อเรื่อง และวารสาร Science ให้เหตุผลว่าโมเดลถูกฝึกให้สร้างคำตอบแม้เมื่อไม่รู้คำตอบนั้น เมื่อพรอมป์คือ “อ้างอิงแหล่งข้อมูล” โมเดลจะจับคู่รูปแบบของบรรณานุกรม สำหรับงานเฉพาะทางหรืองานล่าสุด การจับคู่รูปแบบนี้จึงกลายเป็นการแต่งข้อมูล
ควรประเมินอะไรเมื่อเลือกผู้ช่วยวิจัย AI?
คุณควรประเมินผู้ช่วยวิจัย AI จากการที่ทุกข้ออ้างสามารถตรวจสอบย้อนกลับ ยึดโยงกับแหล่งข้อมูล ระบุที่มา แสดงความขัดแย้ง และดึงออกมาได้หรือไม่ ไม่ใช่จากความประณีตของร้อยแก้ว คำย่อที่มีประโยชน์คือกรอบ TRACE: การตรวจสอบย้อนกลับ การยึดโยงด้วยการค้นคืน การระบุที่มาที่ละเอียด การตระหนักถึงความขัดแย้ง และความสามารถในการดึงข้อมูล
การตรวจสอบย้อนกลับ ถามว่าผู้อ่านสามารถย้ายจากประโยคในร่างงานไปยังข้อความตอนที่สนับสนุนอย่างตรงจุดได้หรือไม่ หากเครื่องมือสร้างเพียงเอกสารอ้างอิงที่จัดรูปแบบแล้ว เครื่องมือนั้นให้เพียงตัวชี้ ไม่ใช่หลักฐาน
การยึดโยงด้วยการค้นคืน ถามว่าระบบค้นหาคลังงานวิชาการหรือสุ่มตัวอย่างจากน้ำหนักของโมเดล การดึงข้อมูลที่ยึดโยงกับการอ้างอิงออกแบบมาเพื่อป้องกันทั้งการแต่งข้อมูลที่ไร้แหล่งที่มาและการถอดความโดยไม่ระบุที่มา ด้วยการกำหนดให้ทุกข้ออ้างที่ดึงออกมาต้องระบุแหล่งที่มาอย่างชัดเจน
ความละเอียดของการระบุที่มา แยกการอ้างอิงระดับบทความออกจากการอ้างอิงระดับประโยคหรือระดับฟิลด์ บทความหนึ่งอาจมีอยู่จริง แต่ข้อค้นพบที่อ้างอาจผิด ล้าสมัย หรือหยิบมาจากบทคัดย่อแทนผลการวิจัย
การตระหนักถึงความขัดแย้ง ถามว่าเครื่องมือแสดงการศึกษาภายหลังที่สนับสนุน ท้าทาย หรือเพียงกล่าวถึงข้ออ้างนั้นหรือไม่ บทคัดย่อชิ้นเดียวที่ยืนยันข้ออ้างไม่ใช่ภาพรวมของวรรณกรรม
ความสามารถในการดึงข้อมูล ถามว่าวิธีวิจัย กลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัดสามารถเปรียบเทียบกันในฟิลด์ที่มีโครงสร้างได้หรือไม่ บทสรุปแบบร้อยแก้วซ่อนข้อมูลที่ขาดหายไป ขณะที่ตารางทำให้เห็นช่องว่างได้ชัดเจน
แนวทางการสังเคราะห์หลักฐานของ King's College London กล่าวถึงนัยเชิงปฏิบัติอย่างตรงไปตรงมาว่า เครื่องมือ AI สามารถช่วยในบางขั้นตอนของการทบทวนได้ แต่ไม่อาจแทนที่วิธีค้นหาที่ผ่านการตรวจสอบแล้ว และระบบเชิงกำเนิดยังสร้างเอกสารอ้างอิงปลอมได้ บททบทวนในปี 2025 ที่อ้างในคู่มือนั้นสรุปว่า หลักฐานปัจจุบันยังไม่สนับสนุนการใช้ AI เชิงกำเนิดในการสังเคราะห์หลักฐานโดยปราศจากมนุษย์มีส่วนร่วม ดังนั้น คำถามในการประเมินจึงไม่ใช่ “เครื่องมือนี้เขียนได้หรือไม่” แต่เป็น “เครื่องมือนี้ตรวจสอบได้หรือไม่”
ผู้ช่วยวิจัยเฉพาะทางเปรียบเทียบกับแชตบอตทั่วไปอย่างไร?
ผู้ช่วยวิจัยเฉพาะทางทำได้ดีกว่าแชตบอตทั่วไปในด้านการตรวจสอบย้อนกลับของการอ้างอิง เพราะพวกมันผูกคำตอบเข้ากับบทความที่ค้นคืนมา ขณะที่แชตบอตยังโดดเด่นที่สุดด้านการร่าง การอธิบาย และการระดมความคิด การเปรียบเทียบที่ตรงไปตรงมาควรอิงตามบทบาท แชตบอตคือเครื่องมือเขียนที่ยืดหยุ่น ส่วนผู้ช่วยวิจัยคือระบบค้นคืนที่แคบกว่าแต่ตรวจสอบได้มากกว่า
Elicit ค้นหาบทความวิชาการหลายล้านฉบับและส่งคืนรายงานแบบมีโครงสร้างพร้อมการอ้างอิง เครื่องมือนี้โดดเด่นเป็นพิเศษเมื่อนักวิจัยต้องจัดเรียงวิธีวิจัย กลุ่มตัวอย่าง และข้อค้นพบจากการศึกษาหลายชิ้นเพื่อเปรียบเทียบกัน การเปรียบเทียบที่เชื่อมโยงกับ Cochrane ในปี 2026 ซึ่ง King's College London อ้างถึง พบว่า Elicit ค้นหาได้ไม่ไวพอที่จะทดแทนการค้นหาวรรณกรรมแบบดั้งเดิม แม้ความแม่นยำของมันจะทำให้มีประโยชน์ในฐานะเครื่องมือเสริม นี่คือข้อจำกัดจริง ไม่ใช่เชิงอรรถ
Scite สร้างขึ้นเพื่อการตรวจสอบมากกว่าการร่างงาน โดยรายงานความครอบคลุมของ บทความวิชาการมากกว่า 300 ล้านฉบับ และการเข้าถึงแบบมีใบอนุญาตผ่าน ข้อตกลงกับผู้จัดพิมพ์มากกว่า 40 ราย Smart Citations ของ Scite จัดประเภทว่าบทความภายหลังสนับสนุน โต้แย้ง หรือเพียงกล่าวถึงข้ออ้างหนึ่ง ทุกข้ออ้างที่ผู้ช่วยของ Scite สร้างเชื่อมโยงไปยังประโยคเฉพาะในบทความเฉพาะฉบับ ข้อแลกเปลี่ยนคือขอบเขตการใช้งาน: Scite แข็งแกร่งด้านข่าวกรองการอ้างอิงมากกว่าด้านเวิร์กโฟลว์ต้นฉบับแบบครบวงจร
ResearchRabbit โดดเด่นที่สุดด้านการทำแผนที่ ช่วยนักวิจัยค้นหาบทความที่เกี่ยวข้อง สร้างแผนที่การอ้างอิง และติดตามการขยายตัวของสาขาจากบทความตั้งต้น เครื่องมือนี้มีประโยชน์น้อยกว่าสำหรับการดึงหลักฐานหรือการตรวจสอบการอ้างอิง นั่นไม่ใช่ข้อบกพร่องหากงานที่ต้องทำคือการค้นพบ
แชตบอตทั่วไป เช่น ChatGPT ยังคงถูกใช้อย่างกว้างขวาง เพราะร่างงานได้รวดเร็วและจัดการคำถามข้ามสาขาที่ไม่เป็นระเบียบได้ จุดอ่อนที่มีการบันทึกไว้คือการแต่งข้อมูลทางบรรณานุกรม รายงานล่าสุดที่สรุปในงานวิเคราะห์ความซื่อสัตย์ทางวิชาการปี 2026 ระบุว่าอัตราการหลอนของการอ้างอิงเชิงข้อเท็จจริงสำหรับโมเดลขั้นสูง เช่น GPT-4o และ Claude 3.7 อยู่ในช่วง 15–20% และเพิ่มเป็น 35–55% สำหรับหัวข้อเฉพาะทางหรือหัวข้อล่าสุด เกณฑ์ทดสอบที่ตรวจสอบเอกสารอ้างอิงวิทยาศาสตร์ที่สร้างโดยโมเดลภาษาขนาดใหญ่ รายงานอัตราความผิดพลาดเกิน 30% ในบางบริบท
Academic Research Assistant ของ Jenova อยู่ในตำแหน่งที่แตกต่างออกไป เป็นเอเจนต์เฉพาะโดเมนสำหรับการค้นพบวรรณกรรม การเตรียมต้นฉบับ และการจัดการการอ้างอิง พร้อมหน่วยความจำถาวรและการค้นหาแบบสดผ่านฐานข้อมูลวิชาการ Jenova ทำได้ดีกว่าแชตบอตในการรักษาความต่อเนื่องของโครงการวิจัยข้ามเซสชัน แต่ด้อยกว่า Scite ด้านการจัดประเภทการอ้างอิงจากข้อความเต็มแบบมีใบอนุญาต และด้อยกว่า Elicit ในฐานะผลิตภัณฑ์ตารางดึงข้อมูลเฉพาะทาง ช่องว่างเหล่านี้คือเหตุผลที่ชุดเครื่องมือแบบผสมยังทำได้ดีกว่าผู้ช่วยเพียงระบบเดียว
| คุณสมบัติ / มิติ | แชตบอตทั่วไป (เช่น ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| การยึดโยงด้วยการค้นคืน | อาศัยหน่วยความจำของโมเดลเป็นหลัก; ความสามารถในการท่องเว็บแตกต่างตามผลิตภัณฑ์ | ค้นคืนข้อมูลวิชาการและเว็บแบบสดภายในเอเจนต์วิจัยที่มีความต่อเนื่อง | ค้นหาคลังบทความพร้อมรายงานแบบมีโครงสร้าง | เต็มรูปแบบเชิงวิชาการแบบมีใบอนุญาตร่วมกับคลังข้อมูลเปิด | การค้นพบผ่านกราฟการอ้างอิงจากบทความตั้งต้น |
| การตรวจสอบย้อนกลับของการอ้างอิง | มักตรวจสอบไม่ได้หรือถูกแต่งขึ้น | แหล่งข้อมูลในบรรทัดพร้อมการตรวจสอบต่อยอดกับต้นฉบับ | การอ้างอิงแนบกับฟิลด์ที่ดึงออกมา | ลิงก์ระดับประโยคพร้อมป้ายกำกับสนับสนุน/โต้แย้ง | ลิงก์เครือข่ายระหว่างบทความ ไม่ใช่หลักฐานระดับข้ออ้าง |
| การดึงหลักฐาน | บทสรุปแบบอิสระ | บันทึก การเปรียบเทียบ และการสังเคราะห์ที่พร้อมสำหรับต้นฉบับ | ตารางที่มีโครงสร้างแข็งแกร่ง | เด่นด้านบริบทการอ้างอิงมากกว่าการดึงฟิลด์ | จำกัด; เน้นการทำแผนที่มากกว่าการดึงข้อมูล |
| การตระหนักถึงความขัดแย้ง | โดยทั่วไปถูกยุบรวมเป็นคำตอบเดียว | เปรียบเทียบข้อค้นพบที่ขัดแย้งกันได้เมื่อมีคำขอ | ขึ้นอยู่กับชุดเอกสารที่ค้นคืน | เป็นคุณสมบัติหลักผ่าน Smart Citations | ทางอ้อม ผ่านกลุ่มงานที่เกี่ยวข้อง |
| ราคา (ณ ปี 2026) | ยังไม่ยืนยันในแต่ละแผน | มีระดับฟรี; แผนชำระเงินเริ่มที่ $20/เดือน | ยังไม่ยืนยัน | ยังไม่ยืนยัน | ยังไม่ยืนยัน |
| เหมาะที่สุดสำหรับ | การร่าง การอธิบาย การวางกรอบเบื้องต้น | โครงการวิชาการต่อเนื่องที่ต้องการทั้งการค้นพบและหน่วยความจำการเขียน | คัดกรองบทความเข้าสู่ตารางหลักฐานที่เปรียบเทียบได้ | ตรวจว่าข้ออ้างหนึ่งได้รับการสนับสนุนหรือถูกโต้แย้ง | การทำแผนที่วรรณกรรมเชิงภาพและการค้นพบผู้เขียน/กลุ่ม |
บทสรุปเครื่องมือ AI เพื่อการวิจัยวิชาการปี 2026 ให้ภาพการแบ่งงานคล้ายกัน: Elicit นำด้านการดึงข้อมูลแบบมีโครงสร้าง, Consensus เร็วที่สุดสำหรับการตรวจหลักฐานอย่างรวดเร็ว, และ Semantic Scholar ยังคงเป็นดัชนีการค้นพบฟรีที่แข็งแกร่งที่สุด ไม่มีคอลัมน์ใดคอลัมน์หนึ่งในภูมิทัศน์นี้ทดแทนคอลัมน์อื่นได้ทั้งหมด
การดึงหลักฐานแตกต่างกันอย่างไรในเครื่องมือ AI สำหรับงานวิชาการ?
การดึงหลักฐานแตกต่างกันที่ว่าเครื่องมือส่งคืนฟิลด์ที่เปรียบเทียบกันได้ หรือเพียงการถอดความเชิงบรรยาย การดึงข้อมูลระดับฟิลด์น่าเชื่อถือกว่าสำหรับวิธีวิจัย ขนาดกลุ่มตัวอย่าง ผลลัพธ์ และข้อจำกัด เพราะค่าที่ขาดหายไปยังมองเห็นได้ชัด การดึงข้อมูลเชิงบรรยายเร็วกว่าและอ่านง่ายกว่า แต่ซ่อนความแตกต่างระหว่างผลการศึกษา การตีความ และรายละเอียดที่แต่งขึ้น
Elicit คือตัวอย่างที่ชัดเจนที่สุดของแนวทางแบบมีโครงสร้าง ออกแบบมาเพื่อเปลี่ยนคำถามวิจัยเป็นรายงานที่แต่ละแถวคือบทความ และแต่ละคอลัมน์คือลักษณะของการศึกษา รูปแบบนี้คือเหตุผลที่ผู้ทบทวนจำนวนมากเลือกใช้ในช่วงคัดกรองเบื้องต้น แต่ยังต้องมีมนุษย์ตรวจสอบตรรกะการคัดเข้า เพราะ ความแม่นยำสูงไม่ได้เท่ากับการค้นพบที่ครอบคลุมสูง
Scite ดึงวัตถุคนละประเภทออกมา นั่นคือบริบทของการอ้างอิง แทนที่จะถามว่า “บทความนี้พบอะไร” Scite ถามว่า “บทความภายหลังนำข้อค้นพบนี้ไปใช้อย่างไร” สิ่งนี้ใกล้กับการประเมินหลักฐานมากกว่าการดึงข้อมูล และมีประโยชน์อย่างยิ่งหลังจากระบุบทความที่มีแนวโน้มเหมาะสมได้แล้ว
แชตบอตทั่วไปดึงข้อมูลในรูปแบบร้อยแก้ว หากขอให้เปรียบเทียบการทดลองแบบสุ่มสี่งาน พวกมันจะสร้างย่อหน้าที่มั่นใจ ย่อหน้านั้นอาจมีประโยชน์ในฐานะร่างแรก แต่เป็นสิ่งที่ตรวจสอบได้ยาก เพราะไม่มีฟิลด์ใดที่ระบุว่า “ไม่ได้รายงาน” ได้
Academic Research Assistant ของ Jenova และเอเจนต์คู่กันอย่าง Deep Research อยู่ระหว่างสองขั้วนี้ Deep Research ค้นหาอย่างกว้างขวางและส่งคืนรายงานสังเคราะห์พร้อมการอ้างอิงในบรรทัด ส่วน Academic Research Assistant รักษาสถานะของโครงการไว้: การตัดสินใจคัดเข้าเดิม บทความที่ปฏิเสธ ข้อกำหนดด้านรูปแบบ และส่วนของต้นฉบับที่ยังไม่เสร็จ จะยังใช้ได้ในเซสชันต่อมา การทดสอบเวิร์กโฟลว์นี้แสดงข้อได้เปรียบเชิงปฏิบัติสำหรับการทบทวนวรรณกรรมที่ใช้เวลาหลายสัปดาห์ ข้อจำกัดก็มีลักษณะเชิงปฏิบัติเช่นกัน ไม่มีเอเจนต์ใดเป็นเครื่องมือคัดกรองการทบทวนอย่างเป็นระบบโดยเฉพาะในรูปแบบของเครื่องมือที่สร้างมาเพื่อจุดประสงค์นี้ เช่น Rayyan หรือ DistillerSR ซึ่ง บรรณารักษ์ด้านการสังเคราะห์หลักฐานยังมองว่าเป็นตัวเลือกที่ผ่านการประเมินมากกว่าสำหรับการคัดกรองชื่อเรื่องและบทคัดย่อ
พรอมป์การดึงข้อมูลที่น่าเชื่อถือควรระบุฟิลด์ที่ต้องการอย่างชัดเจน:
“ดึงข้อมูลจากบทความเหล่านี้: รูปแบบการศึกษา ขนาดกลุ่มตัวอย่าง ประชากร ผลลัพธ์หลัก ทิศทางของผล ข้อจำกัดที่ผู้เขียนระบุ และประโยคที่แน่นอนซึ่งสนับสนุนแต่ละฟิลด์ หากไม่มีฟิลด์ใด ให้เขียนว่า ‘ไม่ได้รายงาน’ แทนการอนุมาน”
พรอมป์เดียวกันในแชตบอตจะดีได้เท่ากับข้อความที่ค้นคืนมาเท่านั้น หากโมเดลไม่เคยเปิดอ่านบทความ โมเดลจะเติมตารางจากความทรงจำเชิงรูปแบบภาษา
กระบวนการตรวจสอบการอ้างอิงต้องมีอะไรบ้างจริง ๆ?
กระบวนการตรวจสอบการอ้างอิงต้องใช้เอกสารต้นทาง ไม่ใช่เพียงสตริงอ้างอิง กระบวนการขั้นต่ำที่ใช้งานได้คือ นำเข้าข้อความที่ถูกอ้างอิง แบ่งเป็นส่วนย่อย ค้นคืนข้อความตอนที่เกี่ยวข้องกับข้ออ้างมากที่สุด จัดอันดับซ้ำ และจำแนกความสัมพันธ์ระหว่างข้ออ้างกับหลักฐาน สิ่งใดที่น้อยกว่านี้คือการจัดรูปแบบบรรณานุกรม
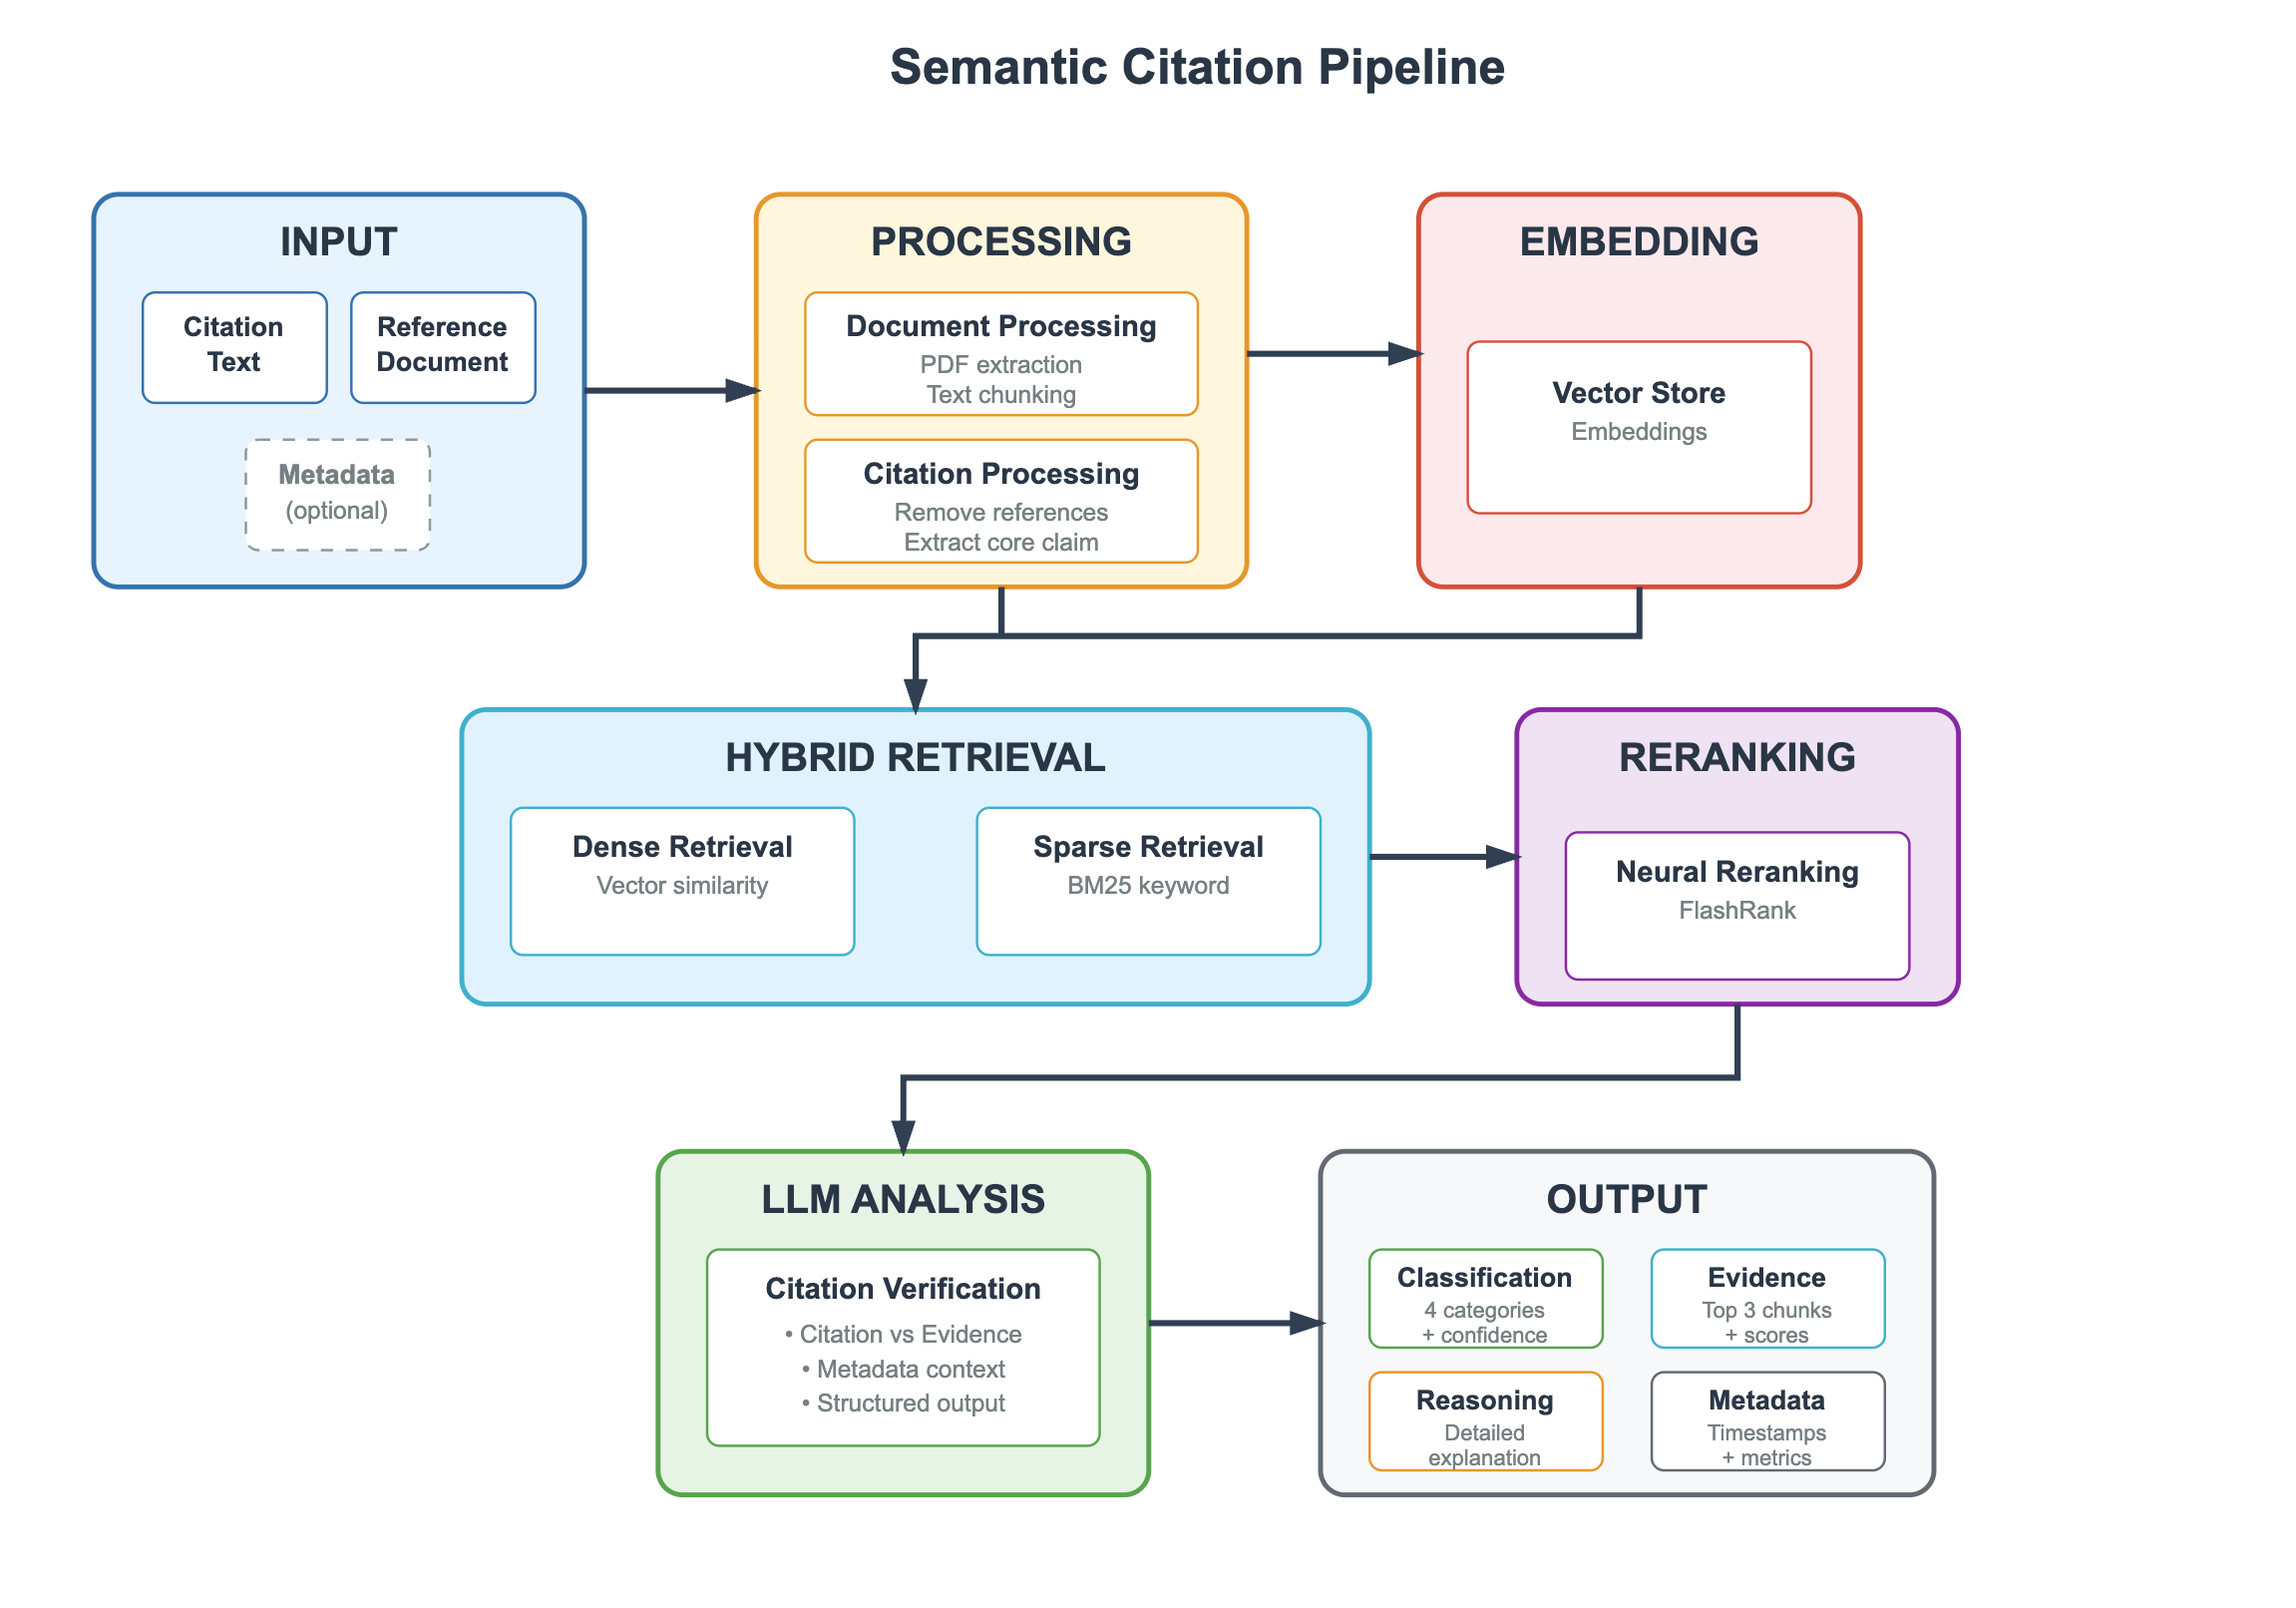
สถาปัตยกรรมข้างต้นคือความแตกต่างระหว่าง “การอ้างอิงนี้ดูเหมือนมีอยู่จริง” กับ “การอ้างอิงนี้ได้รับการสนับสนุน” อินพุตคือข้ออ้างพร้อมเอกสารอ้างอิง การประมวลผลจะตัดบรรณานุกรมออก ดึงข้ออ้างหลัก และแบ่ง PDF เป็นส่วนย่อย จากนั้นการค้นคืนแบบผสมจะค้นหาทั้งความคล้ายเชิงเวกเตอร์และความทับซ้อนของคำสำคัญ ซึ่งสำคัญเพราะชื่อวิธีวิจัยและตัววัดผลลัพธ์มักทำงานได้ไม่ดีกับการค้นหาเชิงความหมายล้วน การจัดอันดับซ้ำด้วยโครงข่ายประสาทจะคัดข้อความตอนอันดับสูงสุดไว้ แล้วจึงให้ LLM จำแนกความสัมพันธ์และส่งคืนหลักฐาน ระดับความเชื่อมั่น และเหตุผล
ระบบอย่าง SemanticCite กำลังถูกพัฒนาขึ้นโดยเฉพาะเพื่อยืนยันความถูกต้องของการอ้างอิงผ่านการวิเคราะห์แหล่งข้อมูลฉบับเต็ม การออกแบบเช่นนี้มีอยู่เพราะการจับคู่ข้อมูลเมตาไม่เพียงพอ DOI อาจใช้ได้จริง แต่ประโยคที่อ้างอาจมาจากบทความคนละฉบับ บทคัดย่อของ preprint หรือข้อค้นพบที่ผู้เขียนระบุเงื่อนไขเพิ่มเติมในภายหลัง
โครงสร้างพื้นฐานของผู้จัดพิมพ์ไม่แก้ปัญหานี้โดยอัตโนมัติ วารสารชั้นนำมีลิงก์อ้างอิงอยู่แล้ว แต่ การประมาณการที่กล่าวถึงในงานวิเคราะห์ความซื่อสัตย์ปี 2026 ระบุว่า DOI ที่ใช้ไม่ได้ หรือลิงก์เสีย อาจสูงถึง 37% ในเนื้อหาวิชาการที่สุ่มตรวจ ลิงก์ที่เปิดได้ไม่ใช่ข้ออ้างที่ผ่านการตรวจสอบ
นี่คือจุดที่แชตบอตทั่วไปล้มเหลวอย่างคาดเดาได้มากที่สุด พวกมันมุ่งเพิ่มประสิทธิภาพเพื่อคำตอบที่สมบูรณ์ ขณะที่กระบวนการตรวจสอบมุ่งเพิ่มประสิทธิภาพเพื่อความสัมพันธ์ที่จำแนกแล้ว ได้แก่ ได้รับการสนับสนุน ไม่ได้รับการสนับสนุน ถูกโต้แย้ง หรือมีหลักฐานไม่เพียงพอ ป้ายกำกับทั้งสี่นี้มีประโยชน์ทางวิทยาศาสตร์มากกว่าย่อหน้าที่สวยงาม เพราะบอกนักวิจัยได้ว่าต้องตรวจสอบเรื่องใดต่อ
เอเจนต์ของ Jenova สามารถทำเวอร์ชันน้ำหนักเบาของวงจรนี้ได้ โดยค้นคืนบทความที่เกี่ยวข้อง ยกข้อความตอนที่สนับสนุน และแจ้งข้ออ้างที่หาไม่พบ ปัจจุบันเอเจนต์ยังไม่สามารถแทนที่ตัวจัดประเภทการอ้างอิงจากข้อความเต็มแบบมีใบอนุญาตที่มีความครอบคลุมระดับผู้จัดพิมพ์ได้ นักวิจัยที่ต้องการป้ายกำกับ Smart Citation จึงยังจับคู่เอเจนต์เขียนงานกับ Scite แทนการให้ระบบเดียวทำทั้งสองงาน
คุณจะสร้างเวิร์กโฟลว์วรรณกรรมที่มี AI ช่วยซึ่งปลอดภัยกว่าได้อย่างไร?
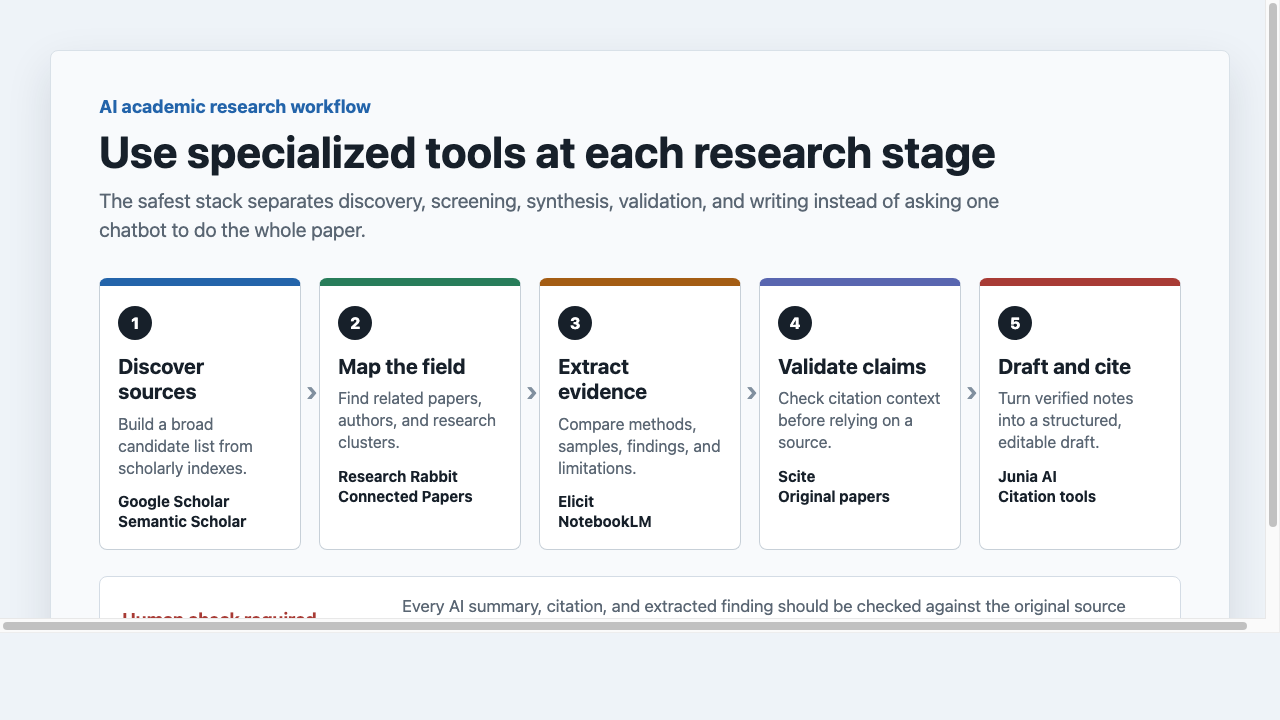
คุณสร้างเวิร์กโฟลว์วรรณกรรมที่มี AI ช่วยซึ่งปลอดภัยกว่าได้ด้วยการมอบหมายแต่ละขั้นให้กับเครื่องมือที่ตรวจสอบได้ แล้วตรวจทานทุกข้อค้นพบที่ดึงออกมากับบทความต้นฉบับ รูปแบบที่ไม่ปลอดภัยคือขอให้แชตบอตตัวเดียวค้นพบ คัดกรอง ดึงข้อมูล ตรวจสอบ และเขียนงาน
เวิร์กโฟลว์แบบเป็นขั้นตอนมีลักษณะดังนี้:
- ค้นพบแหล่งข้อมูล ในดัชนีวิชาการ เช่น Google Scholar หรือ Semantic Scholar ไม่ใช่ในหน้าต่างแชต
- ทำแผนที่สาขา ด้วย ResearchRabbit หรือ Connected Papers เพื่อให้เห็นผู้เขียนและกลุ่มงานที่เกี่ยวข้อง
- ดึงหลักฐาน ด้วย Elicit, NotebookLM หรือเอเจนต์วิจัยลงในบันทึกที่มีโครงสร้าง
- ตรวจสอบข้ออ้าง ใน Scite และใน PDF ต้นฉบับ ก่อนถือว่าประโยคใดอ้างอิงได้
- ร่างและอ้างอิง โดยใช้เฉพาะชุดบันทึกที่ผ่านการตรวจสอบแล้ว
สำหรับ Academic Research Assistant ของ Jenova การตั้งค่าเริ่มจากโจทย์วิจัย ไม่ใช่การแนะนำฟีเจอร์:
- เปิดเอเจนต์ที่ jenova.ai/a/academic-research-assistant
- ระบุคำถาม สาขา และนิยามของงานที่ “เสร็จสมบูรณ์”:
“ฉันกำลังเขียนส่วนวิธีวิจัยเกี่ยวกับอัตราความผิดพลาดในการอ้างอิงของ LLM ให้ความสำคัญกับการศึกษาที่ผ่านการทบทวนโดยผู้ทรงคุณวุฒิและการวิเคราะห์ของผู้จัดพิมพ์ในช่วงปี 2023–2026 สำหรับแต่ละแหล่งข้อมูล ให้ดึงกลุ่มตัวอย่าง นิยามความผิดพลาด อัตราการหลอน และการที่มนุษย์ตรวจสอบเอกสารอ้างอิงหรือไม่”
- ขอรายชื่อผู้สมัครก่อน ตามด้วยตารางดึงข้อมูล แล้วจึงขอร้อยแก้ว อย่าข้ามไปยังร่างงานทันที
- เก็บบทความที่ปฏิเสธไว้ในเธรดเดียวกัน เพื่อไม่ให้เอเจนต์นำกลับมาเสนออีกในภายหลัง
สำหรับ Elicit จุดเริ่มต้นที่เทียบเท่าคือคำถามที่แคบและรายการคอลัมน์ ได้แก่ ประชากร การแทรกแซง ผลลัพธ์ และประเภทการศึกษา สำหรับ Scite ให้เริ่มจากบทความหรือข้ออ้างที่ทราบอยู่แล้ว และตรวจการอ้างอิงที่สนับสนุนเทียบกับที่โต้แย้งก่อนเขียน สำหรับแชตบอตทั่วไป การใช้งานที่ปลอดภัยที่สุดคือการวางโครงและการแก้ไขภาษา หลังจากมีแหล่งข้อมูลอยู่แล้ว
กฎการทำงานสองข้อป้องกันความล้มเหลวได้ส่วนใหญ่ ประการแรก อย่ายอมรับการอ้างอิงที่เปิดไม่ได้ ประการที่สอง อย่าปล่อยให้โมเดลร่างงานเป็นบันทึกเพียงฉบับเดียวของสิ่งที่บทความกล่าวไว้ บันทึกที่ผ่านการตรวจสอบคือแหล่งความจริง ร่างงานเป็นเพียงการจัดเรียงบันทึกนั้นใหม่
เมื่อใดที่แชตบอตอเนกประสงค์ยังเป็นเครื่องมือวิชาการที่ดีกว่า?
แชตบอตอเนกประสงค์ยังเป็นเครื่องมือวิชาการที่ดีกว่าเมื่อภารกิจเกี่ยวกับภาษา โครงสร้าง หรือคำอธิบาย มากกว่าหลักฐาน ความน่าเชื่อถือขึ้นอยู่กับงาน การตรวจสอบย้อนกลับของการอ้างอิงเป็นเกณฑ์ที่ไม่เหมาะสำหรับโมเดลเขียนงาน เช่นเดียวกับความลื่นไหลของร้อยแก้วไม่ใช่เกณฑ์ที่เหมาะสำหรับดัชนีค้นคืนข้อมูล
แชตบอตยังมีประโยชน์สำหรับ:
- เปลี่ยนโครงร่างที่ผ่านการตรวจสอบให้เป็นร้อยแก้ววิชาการที่ชัดเจนขึ้น
- อธิบายวิธีวิจัยที่นักวิจัยอ่านมาแล้ว
- สร้างสตริงค้นหา ข้อโต้แย้ง หรือรายการตรวจสอบสำหรับการแก้ไข
- แปลข้อความหนาแน่นให้เป็นภาษาที่เข้าใจง่ายขึ้นเพื่อใช้ในบันทึก ไม่ใช่เพื่อการอ้างอิง
อย่างไรก็ตาม แชตบอตเป็นเครื่องมือหลักสำหรับวรรณกรรมที่ไม่ดีนัก งานจัดประเภทที่เชื่อมโยงกับ Nature ถือว่าข้อความจากแชตบอตที่ไม่มีหลักฐานรองรับเป็นการหลอนประเภทหนึ่งโดยเฉพาะ และแนวทางห้องสมุดยังย้ำคำเตือนเดิมว่า การอ้างอิงที่แต่งขึ้นอาจมีครบทั้งผู้เขียน ชื่อเรื่อง และชื่อวารสาร รูปแบบความล้มเหลวนี้มีต้นทุนสูงในวิทยานิพนธ์ ข้อเสนอทุน และบทความวารสาร เพราะเอกสารอ้างอิงที่แต่งขึ้นเพียงรายการเดียวอาจทำลายความน่าเชื่อถือของข้อโต้แย้งที่รอบคอบทั้งชิ้น
ยังมีเหตุผลด้านเวิร์กโฟลว์ที่ควรเก็บแชตบอตไว้ในชุดเครื่องมือ เครื่องมือเฉพาะทางมีขอบเขตแคบกว่า Elicit จะไม่ช่วยปรับจังหวะของย่อหน้า Scite จะไม่สนทนาให้คำปรึกษาต่อเนื่องตลอดภาคการศึกษาเกี่ยวกับบทวิทยานิพนธ์ ResearchRabbit จะไม่จัดรูปแบบการอ้างอิงตามสไตล์ของวารสาร แชตบอตหรือเอเจนต์เขียนงานทั่วไปจึงเติมเต็มช่องว่างเหล่านี้ได้หลังจากล็อกหลักฐานแล้ว
กฎเชิงปฏิบัติคือลำดับการใช้งาน ใช้การค้นคืนและการตรวจสอบเฉพาะทางก่อน ใช้โมเดลทั่วไปเป็นลำดับสอง และใช้เฉพาะกับข้อความที่มีแหล่งข้อมูลอยู่แล้วในคลังที่คุณเปิดตรวจได้ หากแชตบอตเสนอการอ้างอิงใหม่ระหว่างการแก้ไข ให้ถือว่าการอ้างอิงนั้นยังไม่น่าเชื่อถือจนกว่าจะผ่านการตรวจ TRACE แบบเดียวกับส่วนอื่นของต้นฉบับ
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยกล่าวอย่างไรเกี่ยวกับการอ้างอิงจาก AI?
ผู้เชี่ยวชาญด้านความซื่อสัตย์ในการวิจัยมองแชตบอตทั่วไปเป็นเครื่องมือช่วยร่างงาน และมองระบบเฉพาะทางที่ผูกกับแหล่งข้อมูลเป็นชั้นเดียวที่ยอมรับได้สำหรับข้ออ้างที่จะถูกอ้างอิง ฉันทามติไม่ใช่ “หลีกเลี่ยง AI” แต่คือ “อย่าปล่อยให้เครื่องสร้างข้อความที่ไม่ยึดโยงกับแหล่งข้อมูลกลายเป็นบันทึกว่าเอกสารวิชาการกล่าวอะไร”
“ความล้มเหลวที่เราเห็นซ้ำแล้วซ้ำเล่าไม่ใช่ว่าโมเดลเขียนได้ไม่ดี แต่คือพวกมันสร้างบรรณานุกรมที่สมบูรณ์สำหรับบทความที่ไม่มีอยู่จริง หรือบทความจริงที่ไม่มีผลลัพธ์ตามที่อ้าง เมื่อสตริงเหล่านั้นเข้าสู่ร่างงาน พวกมันทำหน้าที่เสมือนหลักฐาน ผู้ตรวจ ผู้เขียนร่วม และเครื่องมืออ้างอิงในภายหลังอาจเผยแพร่ต่อไปก่อนที่ใครจะเปิดแหล่งข้อมูล”
“ผู้ช่วยวิจัยเฉพาะทางเปลี่ยนหน่วยของงาน แทนที่จะขอย่อหน้าพร้อมการอ้างอิง คุณขอข้ออ้าง ข้อความตอน และการจัดประเภท: ได้รับการสนับสนุน ไม่ได้รับการสนับสนุน ถูกโต้แย้ง หรือมีหลักฐานไม่เพียงพอ ผลลัพธ์ดังกล่าวช้ากว่าและไม่สละสลวยเท่า แต่เป็นผลลัพธ์เดียวที่ส่วนวิธีวิจัยสามารถปกป้องได้”
“หน่วยความจำโครงการถาวรสำคัญกว่าที่คนส่วนใหญ่คาดคิด การหลอนมักกลับเข้าสู่บทความระหว่างการแก้ไข เมื่อมีการขอให้แชตบอตทั่วไป ‘เพิ่มแหล่งข้อมูล’ ในส่วนที่สะอาดอยู่แล้ว ผู้ช่วยที่จดจำได้ว่าบทความใดถูกตัดออกและเพราะเหตุใด กำลังทำงานเพื่อความซื่อสัตย์ ไม่ใช่เพียงความสะดวก ถึงอย่างนั้น PDF ต้นฉบับยังคงเป็นอำนาจสูงสุด”
— ทีมผลิตภัณฑ์ Jenova, เวิร์กโฟลว์การวิจัยวิชาการ, งานหลายปีด้านการออกแบบเอเจนต์ที่ยึดโยงกับการอ้างอิง
จุดยืนนี้สอดคล้องกับแนวทางจากบรรณารักษ์และผู้เชี่ยวชาญด้านการสังเคราะห์หลักฐาน King's College London แนะนำให้ใช้ AI เป็นเครื่องมือเสริม ตรวจสอบลิขสิทธิ์ก่อนอัปโหลดข้อความเต็ม และตั้งสมมติฐานว่าเครื่องมือเชิงกำเนิดยังสามารถแต่งเอกสารอ้างอิงและหัวเรื่องขึ้นมาได้ การวิเคราะห์ระดับผู้จัดพิมพ์ปัจจุบันมองเอกสารอ้างอิงที่เกิดจากการหลอนเป็นปัญหาระดับคลังข้อมูล ไม่ใช่เพียงเหตุการณ์เฉพาะราย ข้อคิดเห็นชิ้นหนึ่งในปี 2026 ซึ่งอ้างอิงการตรวจสอบของ Nature ต่อสิ่งพิมพ์ราว 4,000 รายการ ระบุว่า เอกสาร 65 ฉบับจาก 100 ฉบับที่น่าสงสัยที่สุดมีเอกสารอ้างอิงที่ไม่ถูกต้องอย่างน้อยหนึ่งรายการ ซึ่งอาจหมายถึงบทความที่ได้รับผลกระทบมากกว่า 110,000 ฉบับจากสิ่งพิมพ์ปี 2025 ราว 7 ล้านฉบับ
นัยสำหรับผู้เชี่ยวชาญคือการปฏิบัติการ เลือกเครื่องมือที่ทำให้การตรวจสอบมีต้นทุนต่ำ ปฏิเสธเครื่องมือที่ทำให้การตรวจสอบดูไม่จำเป็น
เอกสารอ้างอิง
- Higher Education Policy Institute — แบบสำรวจ AI เชิงกำเนิดของนักศึกษา 2025
- ERIC / กระทรวงศึกษาธิการสหรัฐฯ — แบบสำรวจ AI เชิงกำเนิดของนักศึกษา 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — การหลอนใน AI เชิงกำเนิดและความซื่อสัตย์ทางวิชาการ
- Wikipedia — Hallucination (artificial intelligence)
- McGoogan Library, University of Nebraska Medical Center — การหลอนของ AI พร้อมการอ้างอิง
- Science / AAAS — เหตุใดโมเดล AI จึงหลอนแทนที่จะยอมรับความไม่แน่นอน
- LlamaIndex — การดึงข้อมูลที่ยึดโยงกับการอ้างอิง
- คู่มือห้องสมุด King's College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- Elicit — AI สำหรับการวิจัยทางวิทยาศาสตร์
- Scite — การวิจัยที่มีการอ้างอิงรองรับและ Smart Citations
- ResearchRabbit — การทำแผนที่วรรณกรรมและเครือข่ายการอ้างอิง
- newline — เกณฑ์ทดสอบสำหรับตรวจเอกสารอ้างอิงวิทยาศาสตร์ที่สร้างโดย LLM
- Paperguide — การเปรียบเทียบเครื่องมือ AI เพื่อการวิจัยวิชาการ ปี 2026
- arXiv — SemanticCite: การตรวจสอบการอ้างอิงด้วยการวิเคราะห์ข้อความเต็ม
- Nature Humanities and Social Sciences Communications — การจัดประเภทการหลอนของ AI