แพลตฟอร์ม AI หลายโมเดลดีกว่าเครื่องมือวิจัยโมเดลเดียวหรือไม่?
2026-08-22
การกำหนดเส้นทางงานและความหลากหลายของโมเดลเปลี่ยนคุณภาพการวิจัยและการเขียนอย่างไร?
สำหรับเวิร์กโฟลว์การค้นหา การวิเคราะห์ และการเขียนที่ซับซ้อนในปี 2026 แพลตฟอร์มกำหนดเส้นทางงานแบบหลายโมเดลโดยทั่วไปทำผลงานได้ดีกว่าเครื่องมือวิจัยโมเดลเดียว เพราะสามารถมอบหมายงานค้นหา งานให้เหตุผล และงานร่างเนื้อหาให้โมเดลต่างกัน แทนที่จะบังคับให้ระบบเดียวทำทุกอย่าง Jenova โดดเด่นที่สุดเมื่อโครงการต้องดำเนินจากการรวบรวมแหล่งข้อมูล ไปสู่การสังเคราะห์ และต่อเนื่องจนเป็นร่างงานเสร็จสมบูรณ์ในพื้นที่ทำงานถาวรเดียวกัน ส่วน ChatGPT และ Claude ยังคงเหนือกว่าสำหรับการร่างเนื้อหาแบบรวดเร็วและจบในตัว ขณะที่ Perplexity และ Elicit ยังคงเหมาะกว่าเมื่อค้นหาข้อมูลเฉพาะขอบเขตผ่านอินเทอร์เฟซที่คุ้นเคย
ช่องว่างด้านคุณภาพไม่ได้ขึ้นอยู่กับว่าแบรนด์ใดมีโมเดลขนาดใหญ่ที่สุด แต่ขึ้นอยู่กับว่าสแตกนั้นสามารถเปลี่ยนโมเดล เครื่องมือ และผู้เชี่ยวชาญตามลักษณะงานที่เปลี่ยนไปได้หรือไม่
ปัจจัยสำคัญที่แยกแชตวิจัยที่มีความสามารถออกจากแพลตฟอร์มเวิร์กโฟลว์ ได้แก่:
✅ ความเที่ยงตรงของการค้นหา — คำตอบยังเชื่อมโยงกับแหล่งข้อมูลที่เรียกค้นกลับได้หรือไม่ แทนที่จะพึ่งพาความจำของโมเดลเดียว ✅ ความฉลาดของการกำหนดเส้นทาง — ระบบสามารถส่งงานทบทวนวรรณกรรม งานคำนวณ และงานเขียนร้อยแก้วไปยังโมเดลที่ต่างกันได้หรือไม่ ✅ ความต่อเนื่องของการเรียบเรียง — บริบทการวิจัยคงอยู่ต่อไปจนถึงโครงร่าง ร่างบทความ และการแก้ไขหรือไม่ ✅ การตรวจจับข้อผิดพลาด — โมเดลหรือเอเจนต์ตัวที่สองสามารถท้าทายผลลัพธ์รอบแรกได้หรือไม่ ✅ การควบคุมต้นทุน — โมเดลระดับแนวหน้าที่มีค่าใช้จ่ายสูงถูกสงวนไว้สำหรับขั้นตอนที่ยากหรือไม่
AWS ระบุว่าโมเดลภาษาขนาดใหญ่ (LLM) เพียงตัวเดียวมักไม่สามารถเพิ่มประสิทธิภาพต้นทุน เวลาแฝง และคุณภาพสำหรับงานผสมได้พร้อมกัน ซึ่งเป็นเหตุผลที่การกำหนดเส้นทางกลายเป็นการตัดสินใจด้านสถาปัตยกรรมหลัก เพื่อเปรียบเทียบเครื่องมือเหล่านี้อย่างเป็นธรรม ควรแยกให้ชัดว่าโมเดลหนึ่งตัวทำอะไรได้ดี และเวิร์กโฟลว์หลายเอเจนต์ที่มีการกำหนดเส้นทางสามารถรองรับสิ่งใดได้อย่างต่อเนื่อง
เหตุใดเวิร์กโฟลว์การค้นหาและการเขียนที่ซับซ้อนจึงกำลังเติบโตเกินกว่าเครื่องมือโมเดลเดียว?
งานวิจัยและการเขียนที่ซับซ้อนกำลังเติบโตเกินกว่าเครื่องมือโมเดลเดียว เพราะงานไม่ได้เป็นเพียงพรอมป์ต์เดียวอีกต่อไป แต่เป็นลำดับของการค้นหา การคัดกรอง การเปรียบเทียบ การวางโครงร่าง การร่าง และการตรวจสอบข้อเท็จจริง ซึ่งแต่ละขั้นตอนให้รางวัลกับจุดแข็งที่ต่างกัน
การสำรวจวรรณกรรมต้องการแหล่งข้อมูลปัจจุบัน การวิจารณ์ระเบียบวิธีต้องอาศัยการให้เหตุผลอย่างรอบคอบ บันทึกเสนอผู้ว่าจ้างต้องควบคุมน้ำเสียง แชตเดียวอาจเลียนแบบทั้งสามอย่างได้ แต่โดยทั่วไปจะทำภายในหน้าต่างบริบทเดียว พร้อมจุดบอดของโมเดลเดียวที่ยังคงอยู่
บรรณารักษ์สถาบันการศึกษาระบุว่าเครื่องมือ generative AI ยังคงมีแนวโน้มเกิดข้อผิดพลาด เข้าใจบริบทได้จำกัด และมีความสามารถในการค้นหาจำกัด คู่มือวิจัยของมหาวิทยาลัยยังชี้ให้เห็นภาพหลอนของ AI ช่องว่างในข้อมูลฝึก และวรรณกรรมที่อยู่หลัง paywall ว่าเป็นข้อจำกัดเชิงโครงสร้าง ข้อจำกัดเหล่านี้ทบต้นขึ้นเมื่อโมเดลเดียวทั้งค้นคืนข้อมูลและเขียนเนื้อหา
ด้วยเหตุนี้ นักวิจัยจึงนำเครื่องมือเฉพาะทางมาร้อยต่อกัน การเปรียบเทียบ AI สำหรับงานวิจัยในปี 2026 พบซ้ำ ๆ ว่าไม่มีผลิตภัณฑ์เดียวที่ครอบคลุมการค้นพบ การวิเคราะห์ การเขียน และการนำเสนอได้ดีเท่าเทียมกัน บทสรุปเวิร์กโฟลว์วิชาการยังคงแบ่งงานระหว่าง Consensus, Elicit, Semantic Scholar และ Perplexity แทนการแนะนำแชตบอตทั่วไปเพียงตัวเดียว
คำถามเชิงปฏิบัติไม่ใช่ "โมเดลใดฉลาดที่สุด" อีกต่อไป แต่เป็นสแตกของคุณสามารถกำหนดเส้นทางแต่ละขั้นไปยังระบบที่มีโอกาสล้มเหลวน้อยที่สุดในขั้นนั้นได้หรือไม่
คุณควรประเมินอะไรเมื่อเลือกสแตก AI สำหรับการวิจัยและการเขียน?
คุณควรประเมินสแตก AI สำหรับการวิจัยและการเขียนด้วยความเที่ยงตรงของการค้นหา ความฉลาดของการกำหนดเส้นทาง และความต่อเนื่องของการเรียบเรียง — การทดสอบสามส่วนที่เราเรียกว่า SRC Framework — ไม่ใช่จากคุณภาพคำตอบแบบสาธิตต่อพรอมป์ต์เดียว
SRC Framework ตั้งคำถามสามข้อที่สอดคล้องกับลักษณะที่งานวิจัยล้มเหลวจริง:
- ความเที่ยงตรงของการค้นหา เครื่องมือสามารถค้นหาเนื้อหาปัจจุบันที่อ้างอิงได้ หรือเพียงสร้างคำตอบจากข้อมูลฝึกขึ้นมาใหม่?
- ความฉลาดของการกำหนดเส้นทาง สามารถส่งคำถามด้านระเบียบวิธี งานเขียนใหม่ที่อ่อนไหวต่อต้นทุน และการสังเคราะห์เนื้อหายาวไปยังโมเดลต่างกันได้หรือไม่?
- ความต่อเนื่องของการเรียบเรียง พื้นที่ทำงานเดียวกันสามารถจดจำแหล่งข้อมูล ข้ออ้างที่ถูกปฏิเสธ และข้อจำกัดด้านน้ำเสียงตลอดกระบวนการร่างได้หรือไม่?
เกณฑ์เพิ่มเติมมีความสำคัญเมื่อเวิร์กโฟลว์ดำเนินนานกว่าหนึ่งช่วงการทำงาน:
- เครื่องมือยึดโยงกับแหล่งข้อมูล การค้นหาเว็บ การค้นหาวิชาการ ไฟล์ และการจัดการการอ้างอิง
- ความจำ ความชอบและข้อค้นพบก่อนหน้าคงอยู่ข้ามเซสชันหรือไม่
- การประสานงาน การวิจัย การเขียน และการทบทวนสามารถทำงานเป็นบทบาทที่ประสานกันได้หรือไม่
- การสังเกตตรวจสอบได้ คุณสามารถเห็นได้หรือไม่ว่าโมเดลหรือเอเจนต์ใดสร้างข้ออ้างใด
- โครงสร้างต้นทุน คุณต้องจ่ายอัตราโมเดลแนวหน้าสำหรับทุกขั้นตอนการจัดประเภทที่ราคาถูกหรือไม่
- รูปแบบความล้มเหลว คำตอบอ่อนแอเพียงหนึ่งข้อทำให้ทั้งโครงการล่มหรือไม่
HatchWorks อธิบายการตัดสินใจหลักว่าเป็นการเลือกระหว่าง LLM อเนกประสงค์หนึ่งตัวกับสแตกหลายโมเดลที่มอบหมายงานตามประเภทงาน TrueFoundry อธิบายการกำหนดเส้นทางหลายโมเดลว่าเป็นการส่งแต่ละคำขอไปยังโมเดลที่เหมาะกับงานนั้นที่สุด สิ่งเหล่านี้คือทางเลือกด้านสถาปัตยกรรม ไม่ใช่รายการตรวจสอบฟีเจอร์
เครื่องมืออาจได้คะแนนดีด้านคุณภาพแชต แต่ยังล้มเหลวในการทดสอบ SRC หากทุกคำตอบถูกสร้างโดยโมเดลเดียว ในเซสชันเดียว และไม่มีการตรวจสอบอิสระ
ChatGPT, Claude, Perplexity, Elicit และ Jenova แตกต่างกันอย่างไรสำหรับงานหลายขั้นตอน?
ChatGPT และ Claude โดดเด่นที่สุดในฐานะผู้ช่วยทั่วไปแบบอินเทอร์เฟซเดียว Perplexity และ Elicit โดดเด่นในฐานะอินเทอร์เฟซวิจัยเฉพาะทาง และ Jenova โดดเด่นเมื่อการค้นหา การวิเคราะห์ และการเขียนต้องเชื่อมโยงกันภายในพื้นที่ทำงานหลายโมเดล
ChatGPT ปรากฏอย่างสม่ำเสมอในรายชื่อเครื่องมือปี 2026 ในฐานะผู้ช่วยทั่วไปที่ใช้งานได้หลากหลาย Claude ได้รับการแนะนำบ่อยครั้งสำหรับการเขียนเชิงวิชาการรูปแบบยาว Perplexity ถูกใช้อย่างกว้างขวางสำหรับการค้นคว้าข้อมูล แม้ว่าคู่มือเวิร์กโฟลว์วิชาการบางฉบับจะแนะนำให้ใช้อย่างระมัดระวัง Elicit ถูกวางตำแหน่งเป็นผู้ช่วยวิจัย AI สำหรับการทบทวนวรรณกรรม
Jenova มีรูปแบบต่างออกไป ผู้ใช้สามารถสลับระหว่างโมเดลจาก OpenAI, Anthropic, Google, DeepSeek และ xAI เก็บประวัติแชตได้ไม่จำกัด และแนบฐานความรู้ได้ เอเจนต์เฉพาะโดเมน เช่น Academic Research Assistant และ Writing Assistant อยู่บนสแตกเดียวกันนั้น ดังนั้นผลการทบทวนวรรณกรรมจึงไม่ต้องถูกคัดลอกวางลงในเครื่องมือร่างเนื้อหาแยกต่างหาก
ข้อแลกเปลี่ยนนั้นมีอยู่จริง Elicit ยังคงถูกสร้างมาเฉพาะทางกว่าสำหรับการดึงข้อมูลอย่างมีโครงสร้างจากบทความ Claude ยังคงเรียบง่ายกว่าเมื่องานมีเพียงการร่างเนื้อหาที่ยาวและรอบคอบ ข้อได้เปรียบของ Jenova ปรากฏเมื่อโครงการมีหลายบทบาท ไม่ใช่เมื่อผู้ใช้ต้องการตั้งค่าน้อยที่สุด
| ฟีเจอร์ / มิติ | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| การเข้าถึงโมเดล | ผู้ช่วยทั่วไปจากผู้ให้บริการรายเดียว | โมเดลบริบทยาวจากผู้ให้บริการรายเดียว | อินเทอร์เฟซที่เน้นการค้นหาบนโมเดลที่โฮสต์ | โมเดลเวิร์กโฟลว์เฉพาะงานวิจัย | เข้าถึงผู้ให้บริการหลายรายพร้อมเลือกโมเดลระดับงาน |
| การค้นหาและการยึดโยงแหล่งข้อมูล | ช่วยค้นหาเว็บทั่วไปได้ดี; ไม่ใช่ฐานข้อมูลวรรณกรรมเฉพาะทาง | วิเคราะห์เอกสารได้ดี; อ่อนกว่าในฐานะดัชนีวิจัยสด | เหมาะกับการค้นหาเร็วพร้อมการอ้างอิง | เหมาะกับการทบทวนวรรณกรรมแบบมีโครงสร้าง | เว็บ, Scholar, ไฟล์ และฐานความรู้ในพื้นที่ทำงานเดียว |
| การประสานงานหลายขั้นตอน | ผู้ใช้จัดการพรอมป์ต์ข้ามแชตเอง | ผู้ใช้จัดการพรอมป์ต์บริบทยาวเอง | ดีที่สุดสำหรับวงจรคำถาม-คำตอบ | ดีที่สุดสำหรับไปป์ไลน์ทบทวน ไม่ใช่งานร่างเต็มรูปแบบ | การประสานงานเอเจนต์และกำหนดเส้นทางโมเดลตลอดงานวิจัยและการเขียน |
| ความจำและความต่อเนื่อง | ความจำการสนทนาภายในผลิตภัณฑ์ | บริบทในเธรดแข็งแกร่ง; อ่อนกว่าในฐานะระบบบันทึกข้ามโครงการ | ความจำโครงการจำกัดนอกเหนือจากเธรดค้นหา | เน้นงานศึกษาและบทความมากกว่าร่างเอกสาร | ความจำถาวรข้ามเซสชันและเอกสารที่แนบ |
| ราคา (ณ ปี 2026) | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ยังไม่ได้ตรวจสอบในการทบทวนนี้ | ระดับฟรีพร้อมการใช้งานจำกัด; แผนชำระเงินเริ่มต้นที่ $20/month |
| เหมาะที่สุดสำหรับ | การค้นคว้าทั่วไปและการร่างเนื้อหาอย่างรวดเร็ว | ต้นฉบับยาวและร้อยแก้วที่ละเอียดรอบคอบ | คำตอบพร้อมการอ้างอิงสำหรับคำถามเฉพาะ | การทบทวนวรรณกรรมเชิงวิชาการ | เวิร์กโฟลว์ค้นหา วิเคราะห์ และเขียนแบบครบวงจร |
อีกตัวเลือกแบบหลายโมเดลคือ Multi ซึ่งระบุว่าให้เข้าถึงโมเดลมากกว่า 300 โมเดลจากห้องปฏิบัติการรายใหญ่ผ่านเวิร์กโฟลว์สี่แบบ ทำให้มีความเกี่ยวข้องกับทีมที่ต้องการทางเลือกโมเดลแบบดิบ ๆ แต่จะเกี่ยวข้องน้อยกว่าหากผู้ใช้ต้องการเอเจนต์เฉพาะโดเมน ความจำโครงการถาวร และพื้นที่ทำงานเดียวตั้งแต่วิจัยจนถึงร่าง
แนวทาง AI ใดสร้างการค้นหาและการค้นพบแหล่งข้อมูลที่น่าเชื่อถือกว่า?
เครื่องมือเฉพาะทางด้านการค้นหา หรือแพลตฟอร์มหลายโมเดลที่มีการค้นคืนข้อมูลสด มีความน่าเชื่อถือสำหรับการค้นพบแหล่งข้อมูลมากกว่าโมเดลอเนกประสงค์เดียวที่ตอบจากความจำ เหตุผลนั้นเรียบง่าย: การค้นพบและการสังเคราะห์มีรูปแบบความล้มเหลวต่างกัน
แชตโมเดลเดียวมีประสิทธิภาพเมื่อคุณรู้คำถามอยู่แล้วและต้องการเพียงคำอธิบายรอบแรก แต่จะเปราะบางเมื่อคำตอบขึ้นกับสิ่งที่เผยแพร่หลังช่วงข้อมูลฝึก สิ่งที่อยู่หลัง paywall หรือสิ่งที่ฐานข้อมูลที่สองอาจขัดแย้ง
ConvergePanel ให้เหตุผลว่าการวิจัยด้วยโมเดลเดียวซ่อนความเห็นต่างด้วยการสังเคราะห์เร็วเกินไป ขณะที่การวิจัยหลายโมเดลรักษาสัญญาณความเห็นต่างและคุณภาพแหล่งข้อมูลไว้ Argumentree เสนอประเด็นคล้ายกัน: โมเดลเดียวสืบทอดข้อผิดพลาดของตนเองโดยไม่มีการตรวจสอบอิสระ ขณะที่การวิจัยหลายโมเดลสามารถตรวจสอบความถูกต้องของข้ออ้างได้
ในทางปฏิบัติ รูปแบบที่น่าเชื่อถือกว่ามีลักษณะดังนี้:
- ใช้เครื่องมือที่ให้การค้นคืนข้อมูลมาก่อนเพื่อรวบรวมแหล่งข้อมูลที่เป็นไปได้
- ใช้โมเดลตัวที่สองเพื่อดึงระเบียบวิธี ขนาดตัวอย่าง และข้อจำกัด
- ใช้การตรวจสอบรอบที่สามเพื่อระบุการสรุปข้ามหลักฐานที่ไม่มีการรองรับก่อนเริ่มเขียน
Elicit และ Consensus ถูกสร้างขึ้นมาเพื่อรองรับบางส่วนของลำดับนี้ Consensus เน้นคำตอบแบบอิงหลักฐานที่ดึงจากวรรณกรรมผ่านการทบทวนโดยผู้ทรงคุณวุฒิ Perplexity ทำงานได้เร็วกว่าเมื่อคำถามใกล้เคียงกับการค้นหาเว็บมากกว่าการทบทวนอย่างเป็นระบบ
Jenova มีประโยชน์มากกว่าเมื่อการค้นพบเป็นเพียงขั้นตอนแรก Academic Research Assistant สามารถค้นหาฐานข้อมูลวิชาการและคงการอ้างอิงไว้ จากนั้นส่งต่อบริบทโครงการเดียวกันให้เอเจนต์เขียนได้ นั่นไม่ได้แทนที่ฐานข้อมูลหลักฐานเฉพาะทางสำหรับการทบทวนอย่างเป็นระบบอย่างเป็นทางการ แต่ช่วยลดช่องว่างจากการคัดลอกวางที่มักทำให้การอ้างอิงคลาดเคลื่อน
พรอมป์ต์ที่น่าเชื่อถือสำหรับขั้นค้นพบควรระบุขอบเขตและกฎการคัดออกอย่างชัดเจน:
"ค้นหาแหล่งข้อมูลที่ผ่านการทบทวนโดยผู้ทรงคุณวุฒิระหว่างปี 2023–2026 เกี่ยวกับการกำหนดเส้นทาง multi-LLM ในระบบที่ใช้งานจริง ตัดหน้า landing page ของผู้ให้บริการออก สำหรับแต่ละแหล่งข้อมูล ให้ดึงผลประโยชน์ด้านต้นทุนหรือคุณภาพที่อ้าง วิธีประเมิน และข้อจำกัดหนึ่งข้อที่ผู้เขียนยอมรับ"
หากเครื่องมือไม่สามารถทำตามคำสั่งนี้โดยไม่สร้างบทความขึ้นเอง ก็เป็นเพียงเครื่องมือช่วยร่าง ไม่ใช่สแตกวิจัย
การกำหนดเส้นทางหลายโมเดลยกระดับการวิเคราะห์โดยไม่ทำให้ต้นทุนพุ่งขึ้นได้อย่างไร?
การกำหนดเส้นทางหลายโมเดลยกระดับการวิเคราะห์ด้วยการส่งงานจัดประเภทและค้นหาข้อมูลที่มีต้นทุนต่ำไปยังโมเดลขนาดเล็กกว่า และสงวนโมเดลที่ทรงพลังกว่าไว้สำหรับการเปรียบเทียบ การตรวจสอบความขัดแย้ง และการให้เหตุผลอย่างมีโครงสร้าง หากทำได้ดี จะยกระดับคุณภาพและลดค่าใช้จ่ายได้ หากทำไม่ดี ตัวกำหนดเส้นทางเองจะกลายเป็นอีกขั้นตอนที่คิดค่าบริการ
AWS อธิบายการกำหนดเส้นทางสองกลุ่ม ได้แก่ การกำหนดเส้นทางแบบคงที่ผ่านอินเทอร์เฟซเฉพาะ และการกำหนดเส้นทางแบบไดนามิกที่จัดประเภทพรอมป์ต์ก่อนเลือกโมเดล การกำหนดเส้นทางแบบไดนามิกอาจใช้โมเดลจำแนก ความคล้ายคลึงเชิงความหมาย หรือทั้งสองแบบผสมกัน Amazon Bedrock Intelligent Prompt Routing ถูกนำเสนอเป็นวิธีจัดการเพื่อลดต้นทุนคำขอได้สูงสุด 30% โดยเลือกโมเดลที่ถูกกว่าแต่ยังผ่านเกณฑ์คุณภาพ
MindStudio รายงานว่าการจับคู่งานกับโมเดลที่เหมาะสมช่วยลดต้นทุนได้ 60% เมื่อแยกการวางแผนและการดำเนินการ แทนการส่งทุกขั้นตอนไปยังโมเดลแนวหน้า ตัวเลขนี้เป็นรายงานจากผู้ให้บริการและควรมองเป็นขีดสูงสุด ไม่ใช่การรับประกัน อย่างไรก็ตาม ตรรกะพื้นฐานยังคงจริง: การวิเคราะห์มีทั้งงานย่อยราคาถูกและงานย่อยราคาแพง
การแบ่งงานเชิงปฏิบัติสำหรับการวิเคราะห์วิจัยมีลักษณะดังนี้:
- โมเดลขนาดเล็กหรือรวดเร็ว: ติดแท็กเอกสาร ดึงข้อความอ้างอิง ปรับรูปแบบการอ้างอิงให้เป็นมาตรฐาน และจัดกลุ่มธีม
- โมเดลระดับกลาง: สรุประเบียบวิธีและระบุตัวเปรียบเทียบที่ขาดหาย
- โมเดลความสามารถสูง: กระทบยอดข้อขัดแย้ง ทดสอบความแข็งแรงของข้ออ้างเชิงสาเหตุ และเขียนบันทึกวิเคราะห์
Jenova รองรับการแบ่งงานนี้ เพราะผู้ใช้เปลี่ยนผู้ให้บริการโมเดลภายในโครงการเดียวได้โดยไม่ต้องส่งออกบันทึกระหว่างแอป ข้อจำกัดคือการกำหนดเส้นทางจะดีได้เท่ากับนิยามงานเท่านั้น หากคุณสั่งเอเจนต์หนึ่งตัวให้ "วิเคราะห์ทุกอย่าง" คุณก็สร้างเวิร์กโฟลว์โมเดลเดียวขึ้นใหม่พร้อมค่าใช้จ่ายส่วนเกิน
AWS ยังระบุว่าการกำหนดเส้นทางแบบกำหนดเองเพิ่มเวลาแฝงและต้นทุนของตัวจำแนก ดังนั้นเงินที่ประหยัดต้องมากกว่าภาษีของการกำหนดเส้นทาง สำหรับบรีฟ 20 นาที โมเดลที่แข็งแกร่งเพียงตัวเดียวมักถูกกว่า สำหรับไปป์ไลน์วิจัยที่เกิดซ้ำ การกำหนดเส้นทางมักคุ้มทุนเอง
เมื่อใด AI โมเดลเดียวจึงยังสร้างงานเขียนได้ดีกว่า?
AI โมเดลเดียวยังสร้างงานเขียนได้ดีกว่าเมื่องานเป็นเส้นตรง ชุดแหล่งข้อมูลถูกเลือกไว้แล้ว และความสม่ำเสมอด้านรูปแบบสำคัญกว่าการตรวจสอบอย่างอิสระ ในกรณีเช่นนี้ เอเจนต์เพิ่มเติมอาจเพิ่มรอยต่อ ความล่าช้า และการแก้ไขที่ขัดแย้งกัน
คำแนะนำของ GitHub เกี่ยวกับการประสานงานเอเจนต์ระบุอย่างชัดเจนว่า หากงานเรียบง่ายและเป็นเส้นตรง เอเจนต์เดียวคือทางเลือกที่เหมาะกว่า งานเขียนมักเข้ากับคำอธิบายนี้ โมเดลบริบทยาวตัวเดียวที่เห็นโครงร่าง บันทึก และย่อหน้าสามย่อหน้าล่าสุด มักรักษาน้ำเสียงได้คงที่กว่าเอเจนต์ผู้เชี่ยวชาญสามตัวที่ส่งร่างต่อกัน
Claude คือตัวอย่างที่ชัดเจนที่สุด มีการแนะนำซ้ำ ๆ สำหรับการเขียนเชิงวิชาการรูปแบบยาว เพราะงานนี้ต้องใช้ร้อยแก้วต่อเนื่อง ไม่ใช่การสลับเครื่องมือ ChatGPT มักเพียงพอสำหรับอีเมล บรีฟ และร่างแรกที่ความเร็วสำคัญกว่าสถาปัตยกรรมการอ้างอิง
การเขียนด้วยโมเดลเดียวเริ่มเสียเปรียบเมื่อร่างนั้นขึ้นกับหลักฐานสด เวอร์ชันสำหรับผู้มีส่วนได้ส่วนเสียหลายกลุ่ม หรือรอบ QA ที่ไม่ควรไว้วางใจผู้เขียนต้นฉบับ นั่นคือจุดที่เอเจนต์เขียนบวกเอเจนต์ตรวจทานแยกต่างหากมีความสมเหตุสมผล
Writing Assistant ของ Jenova สร้างขึ้นสำหรับจุดกึ่งกลางของสเปกตรัมนี้: ปรับตามรูปแบบและกลุ่มผู้อ่าน รักษาน้ำเสียงคงที่ และทำงานภายในพื้นที่ทำงานที่มีข้อมูลวิจัยอยู่แล้ว ไม่ได้ดีกว่า Claude โดยอัตโนมัติสำหรับเรียงความที่จบในตัว แต่แข็งแกร่งกว่าเมื่อร่างต้องใช้แหล่งข้อมูล กฎการคัดออก และศัพท์เฉพาะชุดเดิมที่รวบรวมไว้ก่อนหน้า
บรีฟสำหรับการเขียนด้วยโมเดลเดียวก็ควรกระชับและชัดเจน:
"โดยใช้เฉพาะแหล่งข้อมูลทั้งแปดรายการที่อยู่ในโครงการนี้ เขียนบทความอธิบายความยาว 900 คำสำหรับผู้จัดการผลิตภัณฑ์ ห้ามเพิ่มการอ้างอิงใหม่ รักษาระดับการอ่านให้ไม่เป็นเชิงเทคนิค ระบุข้ออ้างใดก็ตามที่ไม่ได้รับการสนับสนุนจากบันทึกที่แนบ"
หากงานเขียนของคุณระบุได้ชัดเจนถึงระดับนั้น โมเดลเดียวไม่ใช่การประนีประนอม แต่เป็นสถาปัตยกรรมที่ถูกต้อง
สถาปัตยกรรมเอเจนต์เดี่ยวและหลายเอเจนต์แตกต่างกันอย่างไรสำหรับเวิร์กโฟลว์วิจัย?
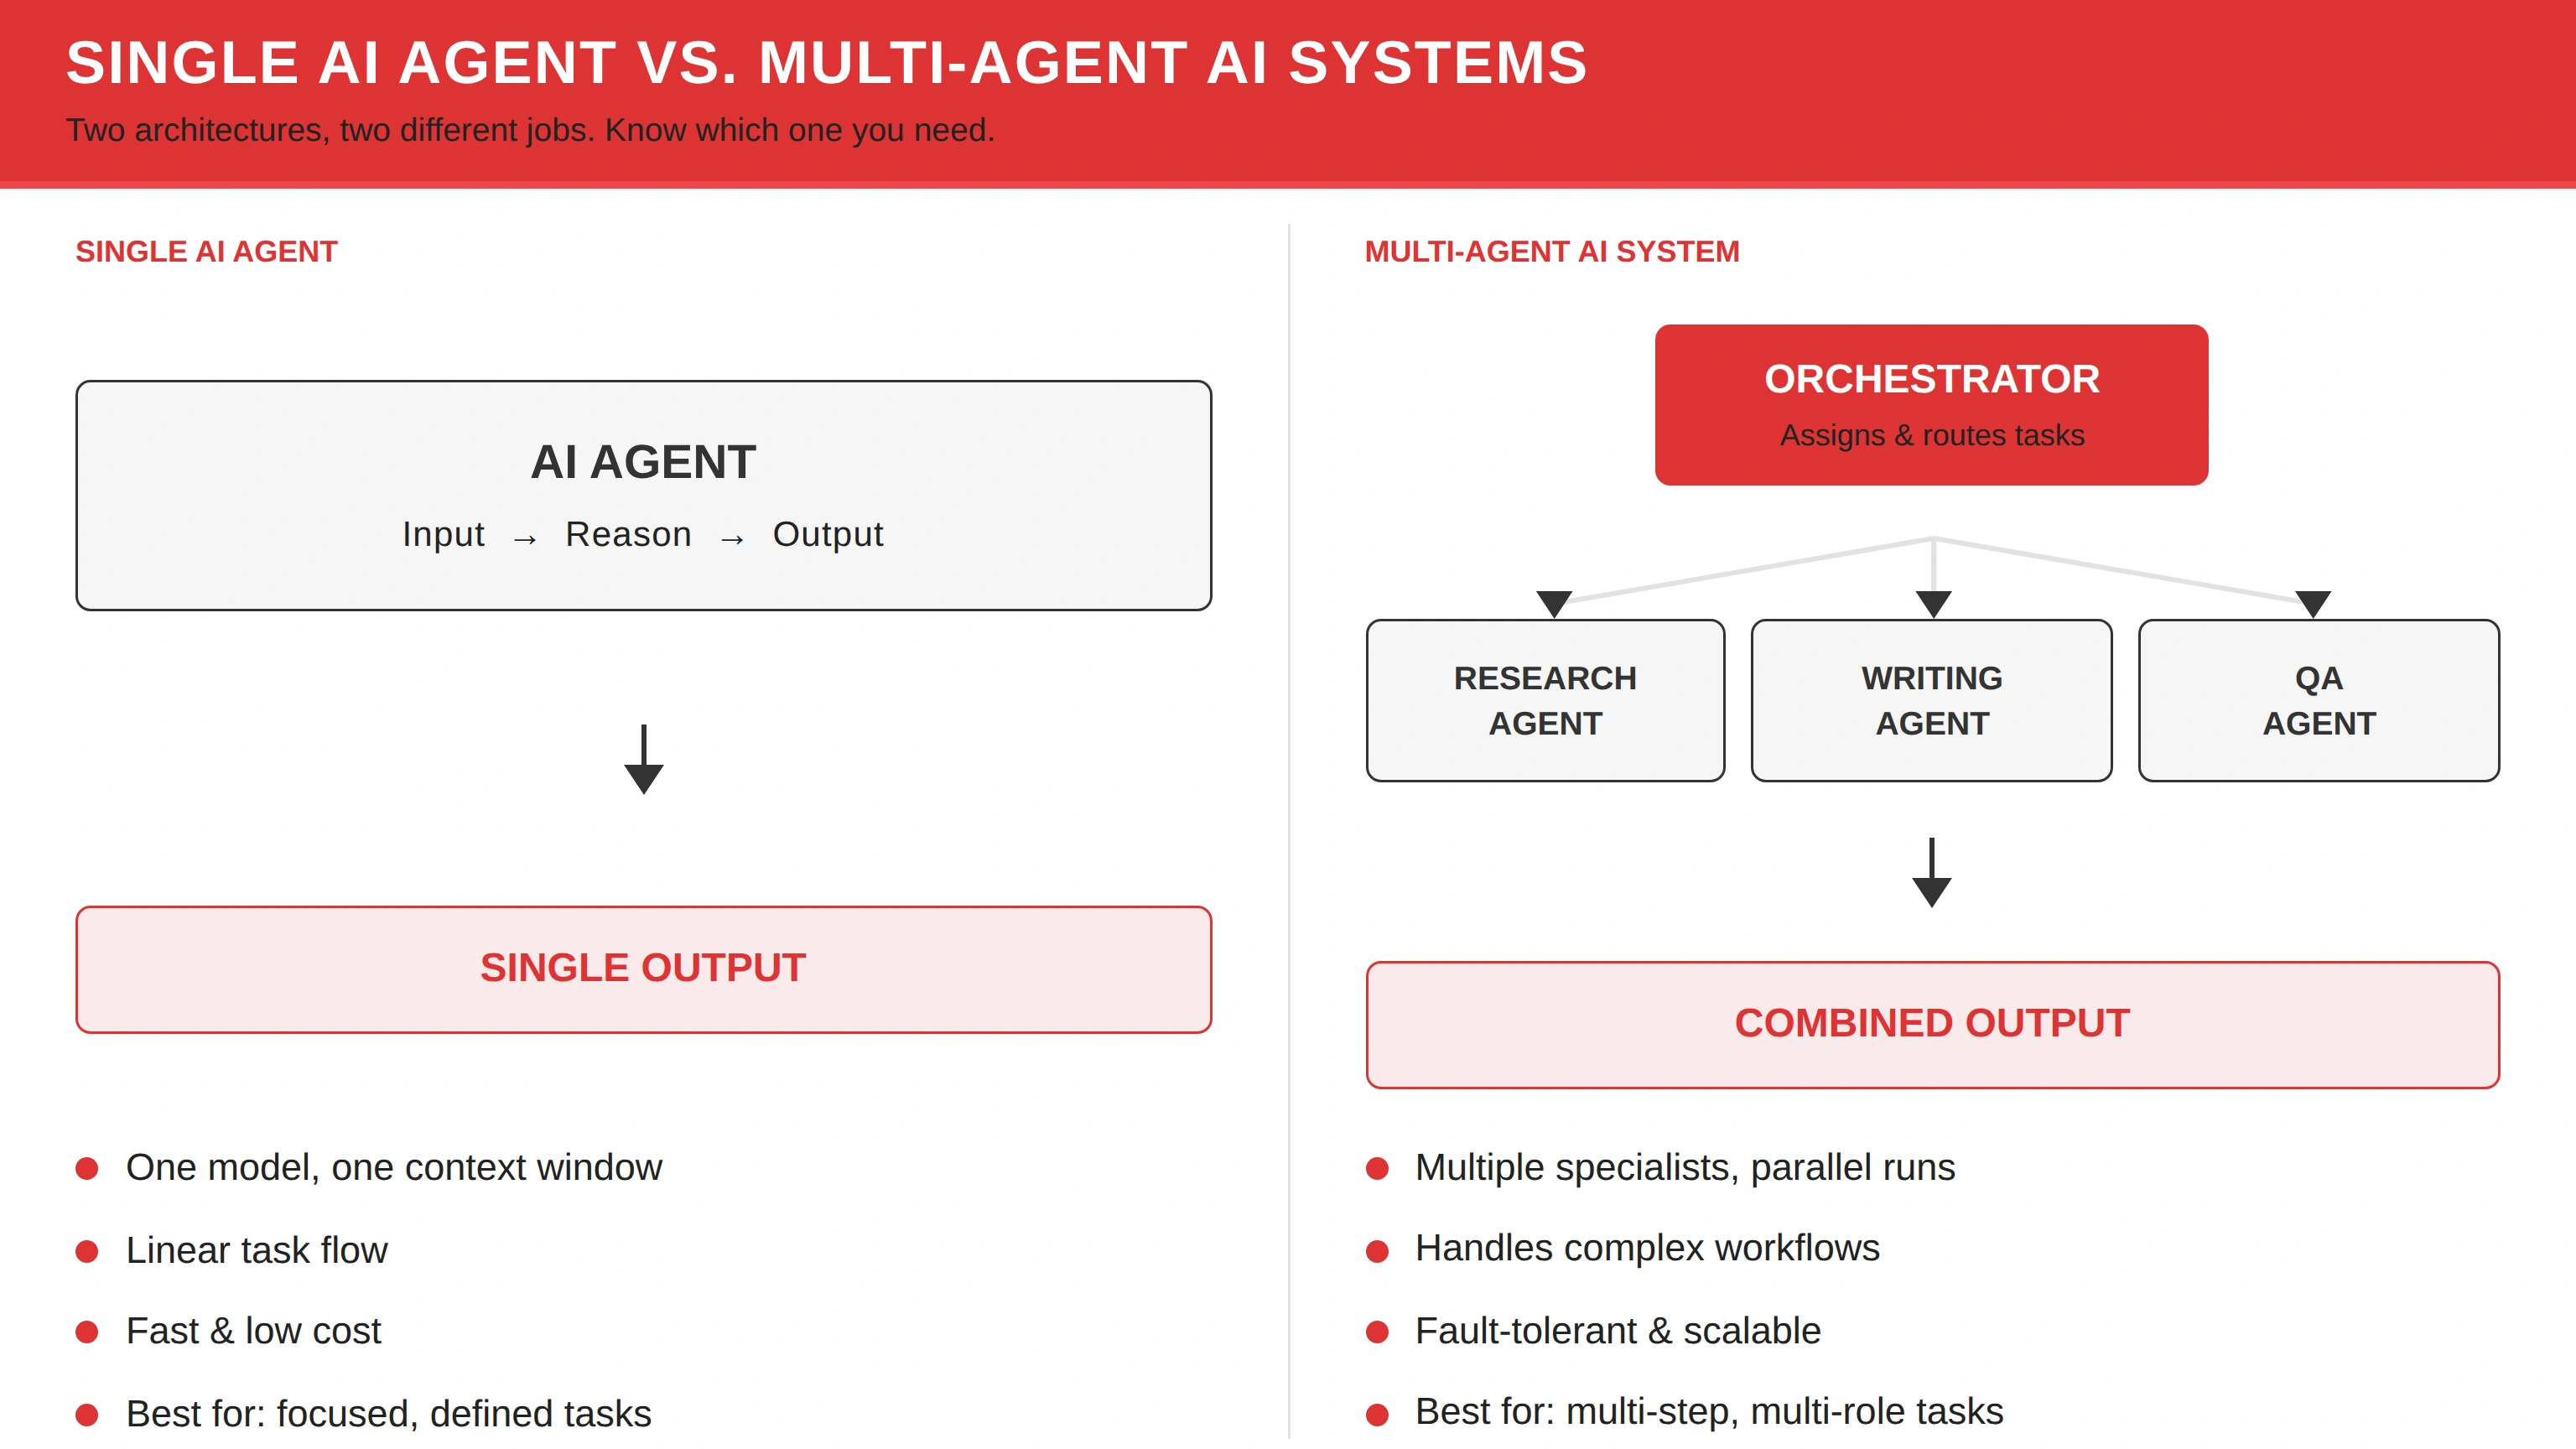
ระบบเอเจนต์เดี่ยวใช้โมเดลหนึ่งตัวและหน้าต่างบริบทหนึ่งชุดในวงจรเชิงเส้น อินพุต-ให้เหตุผล-เอาต์พุต ขณะที่ระบบหลายเอเจนต์ใช้ตัวประสานงานเพื่อมอบหมายบทบาทเฉพาะทาง เช่น การวิจัย การเขียน และ QA แบบแรกเร็วกว่าและถูกกว่าสำหรับงานที่กำหนดชัดเจน แบบที่สองทนทานต่อความผิดพลาดกว่าในงานหลายขั้นตอน
การประสานงานเอเจนต์ AI คือชั้นควบคุมที่ประสานเอเจนต์อัตโนมัติหลายตัวไปสู่เป้าหมายร่วมกัน รวมถึงสถานะ สิทธิ์ และจุดตรวจโดยมนุษย์ สิ่งนี้ต่างจากการมีเอเจนต์หลายตัวเพียงอย่างเดียว และต่างจากการประสานงาน AI ทั่วไปที่แค่จัดลำดับโมเดลและ API Kimi อธิบายรูปแบบเดียวกันในแง่เวิร์กโฟลว์: เอเจนต์หนึ่งค้นคว้า อีกตัววางแผน และอีกตัวเขียน
ความแตกต่างด้านสถาปัตยกรรมเห็นได้ง่ายที่สุดในการผลิตงานวิชาการ ในเดือนเมษายน 2026 Google Research อธิบาย PaperVizAgent ว่าเป็นระบบห้าเอเจนต์ — ตัวค้นคืนข้อมูล นักวางแผน นักปรับรูปแบบ นักสร้างภาพ และนักวิจารณ์ — ซึ่งได้คะแนน 60.2 เทียบกับเกณฑ์มนุษย์ 50.0 ในงานสร้างภาพประกอบ ระบบคู่กันชื่อ ScholarPeer ใช้หลายเอเจนต์เพื่อยึดโยงการทบทวนโดยผู้ทรงคุณวุฒิกับวรรณกรรมสด แทนที่จะมองการทบทวนเป็นการสร้างข้อความครั้งเดียว ผลลัพธ์เหล่านั้นไม่ได้พิสูจน์ว่าสแตกหลายเอเจนต์ทุกแบบดีกว่า แต่แสดงให้เห็นว่าเหตุใดความเชี่ยวชาญเฉพาะทางร่วมกับการวิจารณ์จึงอาจชนะพรอมป์ต์เดียว
ต้นทุนก็เป็นรูปธรรมไม่แพ้กัน ระบบหลายเอเจนต์ต้องการโปรโตคอลที่ชัดเจน โครงสร้างพื้นฐานเพิ่มขึ้น และเพดานต้นทุน หากไม่มีการประสานงาน เอเจนต์อาจทำงานซ้ำ ขัดแย้งกัน หรือลองซ้ำจนค่าใช้จ่ายพุ่งสูง ระบบเอเจนต์เดี่ยวมีความเสี่ยงตรงกันข้าม: ความล้มเหลวครั้งเดียวทำให้งานจบลง
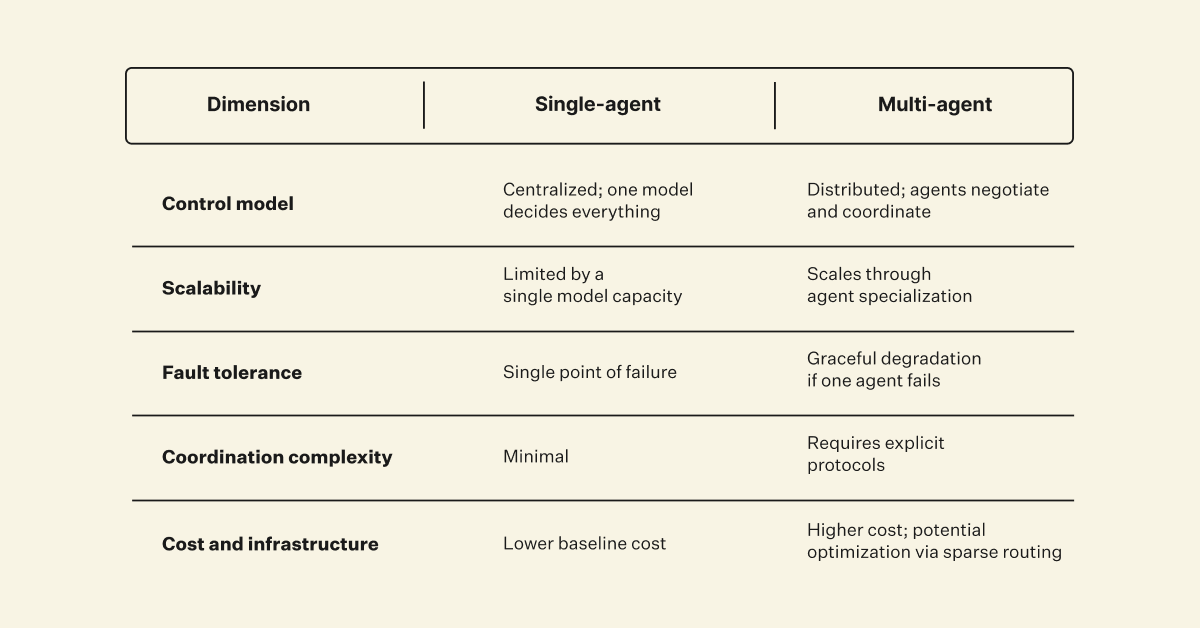
สำหรับการวิจัยและการเขียน กฎที่มีประโยชน์คือจำนวนบทบาท หากงานมีบทบาทเดียว ให้ใช้เอเจนต์เดียว หากงานมีนักวิจัย นักเขียน และผู้ตรวจทาน ให้ใช้ระบบที่มีการประสานงาน — หรือยอมรับว่าคุณคือตัวประสานงานเอง
คุณสร้างเวิร์กโฟลว์การวิจัยและการเขียนที่มี AI ช่วยอย่างครบถ้วนได้อย่างไร?
คุณสร้างเวิร์กโฟลว์การวิจัยและการเขียนที่มี AI ช่วยอย่างครบถ้วนด้วยการแยกการค้นพบ การวิเคราะห์ และการเรียบเรียงออกจากกัน แล้วเลือกเครื่องมือโมเดลเดียวหรือแพลตฟอร์มที่มีการกำหนดเส้นทางสำหรับแต่ละชั้น แทนที่จะใช้แชตเดียวสำหรับทั้งโครงการ
ลำดับที่ใช้ได้อย่างยั่งยืนมีดังนี้:
- กำหนดการตัดสินใจ เขียนคำถามที่เอกสารสุดท้ายต้องตอบ รวมถึงสิ่งใดที่จะหักล้างคำตอบนั้นได้
- รวบรวมแหล่งข้อมูลด้วยเครื่องมือที่ให้การค้นคืนข้อมูลมาก่อน ใช้ Elicit หรือ Consensus สำหรับการทบทวนระดับบทความ ใช้ Perplexity สำหรับบรีฟระดับเว็บ หรือใช้ Academic Research Assistant ของ Jenova เมื่อพื้นที่ทำงานเดียวต้องเก็บการอ้างอิงไว้
- วิเคราะห์ด้วยโมเดลตัวที่สอง ดึงระเบียบวิธี ความเห็นต่าง และระดับความเชื่อมั่น ไม่ใช่แค่บทสรุป
- ร่างด้วยผู้เชี่ยวชาญด้านการเขียน ใช้ Claude สำหรับต้นฉบับที่จบในตัว หรือใช้ Writing Assistant ของ Jenova เมื่อต้นร่างต้องเชื่อมโยงกับความจำโครงการ
- ทำ QA แบบโจมตีเต็มรูปแบบ ขอให้โมเดลอื่นตรวจโจมตีการอ้างอิง ลำดับเวลา และข้ออ้างเกินจริง
- ล็อกชิ้นงาน ส่งออกหลังจากลบหรือลดระดับข้ออ้างที่ไม่มีหลักฐานรองรับแล้วเท่านั้น
บน Jenova ลำดับนี้สามารถอยู่ภายในบัญชีเดียว ผู้ใช้สามารถเริ่มด้วย Academic Research Assistant สลับโมเดลสำหรับขั้นวิเคราะห์ แล้วดำเนินต่อด้วย Writing Assistant หรือ SEO Blog Generator หากผลลัพธ์เป็นบทความสาธารณะ ความจำถาวรและไฟล์ที่แนบช่วยลดการสูญเสียข้อจำกัดระหว่างเครื่องมือที่เกิดขึ้นตามปกติ
พรอมป์ต์ส่งต่องานระหว่างการวิจัยกับการเขียนที่ดีต้องระบุชัดเจนว่าสิ่งใดห้ามเปลี่ยน:
"นี่คือชุดแหล่งข้อมูลและข้ออ้างที่เราปฏิเสธไปแล้ว ร่างส่วนวิเคราะห์สำหรับผู้อ่านด้านนโยบาย ทุกย่อหน้าต้องมีแหล่งข้อมูลที่ยังคงใช้ได้หนึ่งรายการ หากข้ออ้างเป็นการอนุมาน ให้ระบุว่าเป็นการอนุมาน ห้ามนำข้ออ้างที่ปฏิเสธแล้วกลับมาใช้"
บนเครื่องมือโมเดลเดียว เวิร์กโฟลว์เดียวกันยังทำได้ คุณเพียงกลายเป็นตัวกำหนดเส้นทางเอง: เปิดแชตใหม่ วางบันทึก และใช้โมเดล QA ด้วยตนเอง นั่นอาจเป็นการออกแบบที่เหมาะสมสำหรับงานเป็นครั้งคราว แต่จะเปราะบางเมื่อโครงการกินเวลาหลายสัปดาห์หรือเกี่ยวข้องกับเอกสารหลายประเภท
Jenova ไม่ใช่วิธีที่เงียบที่สุดสำหรับทำบทสรุปครั้งเดียว ข้อได้เปรียบคือเวิร์กโฟลว์ข้างต้นไม่จำเป็นต้องใช้สมาชิกสามบริการและระบบจดบันทึกส่วนตัวเพื่อรักษาความสอดคล้องของทุกส่วน
ทีมโครงสร้างพื้นฐาน AI พูดอย่างไรเกี่ยวกับสแตกโมเดลเดียวเทียบกับหลายโมเดล?
ทีมโครงสร้างพื้นฐาน AI โดยทั่วไปมองว่าเครื่องมือโมเดลเดียวเป็นค่าเริ่มต้นที่ถูกต้องสำหรับงานเชิงเส้น และแพลตฟอร์มหลายโมเดลเป็นค่าเริ่มต้นที่ถูกต้องเมื่อเวิร์กโฟลว์มีบทบาทเฉพาะทาง ข้อจำกัดต้นทุน หรือขั้นตรวจทานอิสระ
"ความผิดพลาดด้านการวิจัยที่มีต้นทุนสูงที่สุดที่เราเห็น ไม่ใช่การเลือกโมเดลแนวหน้าผิดตัว แต่คือการใช้โมเดลเดียวเป็นทั้งนักวิจัย นักวิเคราะห์ และบรรณาธิการ แล้วเชื่อความลื่นไหลของย่อหน้าสุดท้าย เมื่อระบบเดียวสร้างแหล่งข้อมูลขึ้นมาเอง แล้วเขียนประโยคที่พึ่งพาแหล่งนั้น ก็ไม่มีสัญญาณเตือนภายใน โมเดลตัวที่สองไม่ได้รับประกันความจริง แต่ทำให้เกิดโอกาสที่จะเห็นต่าง"
"การกำหนดเส้นทางคุ้มกับความซับซ้อนก็ต่อเมื่อคุณระบุชื่องานได้ 'ค้นคว้าเรื่องนี้แล้วเขียนสรุป' ยังเป็นงานเดียว 'รวบรวมบทความที่เป็นไปได้ ดึงระเบียบวิธี กระทบยอดข้อขัดแย้ง ร่าง แล้วโจมตีการอ้างอิง' คือห้างาน ทีมที่ข้ามการแยกย่อยนี้ซื้อแผนภาพหลายเอเจนต์ แต่ยังคงรันพรอมป์ต์เดียว"
"ข้อโต้แย้งเรื่องต้นทุนเป็นเรื่องจริง แต่มีได้ทั้งสองทาง งานด้านการกำหนดเส้นทางที่ Amazon เผยแพร่แสดงว่าการส่งทุกคำขอไปยังโมเดลที่แข็งแกร่งที่สุดทำให้เสียเงินเปล่า และรายงานผู้ให้บริการที่อ้างการประหยัด 30% ถึง 60% ก็เป็นไปได้เมื่อแยกการจัดประเภทกับการร่างออกจากกัน ความล้มเหลวตรงข้ามก็พบได้บ่อย: ตัวประสานงาน ตัวจำแนก และผู้เชี่ยวชาญสามตัวใช้เงินมากกว่าโมเดลที่รอบคอบเพียงตัวเดียวจะใช้กับบันทึกสั้น"
— ทีมผลิตภัณฑ์ Jenova, สถาปัตยกรรมเวิร์กโฟลว์ AI, ประสบการณ์ 8 ปีในการสร้างระบบเอเจนต์หลายโมเดล
มุมมองนี้สอดคล้องกับวรรณกรรมวิศวกรรมสาธารณะ AWS มองการกำหนดเส้นทาง multi-LLM เป็นการตอบสนองต่อประเภทงานผสม ไม่ใช่การยกระดับที่ใช้ได้กับทุกกรณี GitHub มองว่าการประสานงานจำเป็นหลังจากเอเจนต์เพิ่มจำนวนขึ้น ไม่ใช่ก่อนหน้านั้น ฉันทามติของผู้เชี่ยวชาญมีเงื่อนไข: เพิ่มโมเดลเมื่องานมีรอยต่อ อย่าเพิ่มโมเดลเพื่อประดับงานที่เรียบง่าย
เมื่อใดคุณควรใช้เครื่องมือวิจัยโมเดลเดียวต่อไป?
คุณควรใช้เครื่องมือวิจัยโมเดลเดียวต่อไปเมื่อคำถามมีขอบเขตชัดเจน แหล่งข้อมูลอยู่ในมือแล้ว กำหนดเวลาสั้น และคุณไม่ต้องการระบบที่สองมาตรวจสอบระบบแรก ในเงื่อนไขเหล่านั้น การกำหนดเส้นทางหลายโมเดลเพิ่มต้นทุนการประสานงานโดยแทบไม่ได้เพิ่มความจริง
ใช้ ChatGPT หรือ Claude ต่อไปเมื่อคุณกำลัง:
- อธิบายแนวคิดที่คุ้นเคย แทนที่จะทำแผนที่วรรณกรรม
- เขียนเอกสารที่คุณเชื่อถืออยู่แล้วใหม่
- สำรวจน้ำเสียง โครงสร้าง หรือลำดับข้อโต้แย้ง
- ทำงานให้เสร็จในช่วงเดียวโดยไม่มีการส่งต่องานให้เพื่อนร่วมทีม
ใช้ Perplexity หรือ Elicit ต่อไปเมื่อคุณกำลัง:
- ถามคำถามเฉพาะที่ต้องการการอ้างอิง
- คัดกรองบทคัดย่อก่อนอ่านเชิงลึก
- ทบทวนวรรณกรรมที่จะนำไปเขียนต่อที่อื่น
ย้ายไปยังแพลตฟอร์มกำหนดเส้นทางงานหลายโมเดลเมื่อมีเงื่อนไขตั้งแต่สองข้อขึ้นไปต่อไปนี้:
- โครงการผสมการค้นหา การวิเคราะห์ และงานเขียนสำเร็จรูป
- ผลลัพธ์ต้องรักษาร่องรอยแหล่งข้อมูลข้ามร่างต่าง ๆ
- คุณต้องการโมเดลต่างกันสำหรับการดึงข้อมูล การให้เหตุผล และร้อยแก้ว
- งานเกิดซ้ำบ่อยพอที่เวิร์กโฟลว์นำกลับมาใช้ใหม่มีความสำคัญ
- การอ้างอิงที่ผิดพลาดมีต้นทุนสูง
Jenova เหมาะกับรายการหลังนี้ อ่อนกว่าเวิร์กโฟลว์การดึงข้อมูลจากบทความของ Elicit และอ่อนกว่า Claude ในฐานะนักเขียนบริบทยาวที่ทำงานเงียบ ๆ แต่แข็งแกร่งกว่าเมื่องานเหล่านั้นต้องเกิดขึ้นร่วมกัน พร้อมความจำ ทางเลือกโมเดล และเอเจนต์เฉพาะทางในที่เดียว
ดังนั้น การตัดสินใจจึงไม่ใช่ "โมเดลเดียวเทียบกับหลายโมเดล" ในฐานะบททดสอบความภักดี แต่เป็นการพิจารณาว่าเวิร์กโฟลว์ของคุณยังเหมือนบทสนทนา หรือเริ่มเหมือนสายการผลิตแล้ว บทสนทนาเหมาะกับโมเดลเดียว สายการผลิตเหมาะกับตัวกำหนดเส้นทาง
แหล่งอ้างอิง
- AWS Machine Learning Blog — กลยุทธ์การกำหนดเส้นทาง Multi-LLM สำหรับแอปพลิเคชัน generative AI บน AWS
- The Chicago School Library — เครื่องมือและทรัพยากร Artificial Intelligence: ประโยชน์และข้อจำกัด
- University of the District of Columbia Library — การใช้งานและข้อจำกัดของ Generative AI
- PapersFlow — AI ที่ดีที่สุดสำหรับนักวิจัยในปี 2026: เปรียบเทียบ 10 เครื่องมือตามหมวดหมู่
- Thesify — เครื่องมือ AI ที่ดีที่สุดสำหรับการวิจัยเชิงวิชาการในปี 2026
- HatchWorks AI — กรณีใช้งาน Large Language Model: LLM หนึ่งตัวเทียบกับหลายโมเดล
- TrueFoundry — การกำหนดเส้นทางหลายโมเดล: เพิ่มประสิทธิภาพงาน AI อย่างมีประสิทธิผล
- Synthesia — เครื่องมือ AI ที่ดีที่สุด 12 รายการสำหรับปี 2026
- AnswerThis — 10 เครื่องมือ AI ชั้นนำสำหรับนักวิจัยในปี 2026
- Zerve — เครื่องมือ AI สำหรับการวิจัยในปี 2026: การทบทวนวรรณกรรม การวิเคราะห์
- Multi — งานหนึ่งงาน พร้อมเวิร์กโฟลว์ AI ที่เหมาะสม
- ConvergePanel — เครื่องมือ AI หลายโมเดลที่ดีที่สุดสำหรับการวิจัย
- Argumentree.AI — การวิจัย AI หลายโมเดลเทียบกับโมเดลเดียว
- MindStudio — วิธีลดต้นทุน 60% ด้วยการจับคู่งานกับโมเดลที่เหมาะสม
- GitHub Resources — การประสานงานเอเจนต์ AI คืออะไร?
- Kimi AI — การประสานงานเอเจนต์ AI: ประเภท ขั้นตอน และประโยชน์
- Google Research — เปิดตัวเอเจนต์ AI สองตัวเพื่อภาพประกอบและการทบทวนโดยผู้ทรงคุณวุฒิที่ดีขึ้น