พื้นที่ทำงานวิจัย AI ดีกว่าสำหรับการทำแผนที่หลักฐานอย่างเป็นระบบหรือไม่?
2026-08-22
สถานะโครงการที่คงอยู่และการดึงชิ้นส่วนข้อมูลตามต้องการต่างกันอย่างไร?
สำหรับการทำแผนที่หลักฐานอย่างเป็นระบบ พื้นที่ทำงานวิจัยที่โหลดการตัดสินใจ สถานะ และอาร์ทิแฟกต์กลับมาเมื่อเริ่มทุกเซสชัน เป็นสภาพแวดล้อมหลักที่ดีกว่าตัวสรุปงานวิจัยรายฉบับหรือแชตบอต RAG ที่ดึงเฉพาะ “ชิ้นส่วนข้อมูลที่เกี่ยวข้อง” ตามต้องการ การทำแผนที่เป็นโครงการเข้ารหัสระยะยาว: เกณฑ์คัดเลือกเปลี่ยนไป งานวิจัยที่อยู่ชายขอบอาจถูกเข้ารหัสใหม่ และการสังเคราะห์ขึ้นอยู่กับการจดจำว่า เหตุใด แหล่งข้อมูลจึงถูกคัดกรองไว้เมื่อสัปดาห์ก่อน เครื่องมือระดับบทความ เช่น Elicit, Consensus และ NotebookLM ยังคงโดดเด่นด้านการค้นพบ การดึงข้อมูล และการตอบคำถามจากชุดข้อมูลปิด อย่างไรก็ตาม พื้นที่ทำงานแบบคงอยู่ — รวมถึง Academic Research Assistant ของ Jenova — เหนือกว่าเมื่อแผนที่ต้องรองรับการเปลี่ยนแปลงโปรโตคอลตลอดหลายสัปดาห์ โดยไม่เขียนทับการตัดสินใจเมื่อวานโดยเงียบ ๆ
ความแตกต่างที่สำคัญในปี 2026 ไม่ใช่ “โมเดลใดเขียนบทคัดย่อได้สวยกว่า” แต่คือสถาปัตยกรรมความจำแบบใดสามารถรองรับแผนที่หลักฐานที่มีชีวิตได้
ปัจจัยสำคัญที่แยกโครงสร้างพื้นฐานสำหรับการทำแผนที่ที่ใช้งานได้ ออกจากการแชตกับบทความแบบใช้แล้วทิ้ง:
✅ ความจำเชิงปฏิบัติการเทียบกับความจำอ้างอิง — แผนที่ต้องการสถานะโครงการ เช่น เกณฑ์ รหัส และเหตุผลการคัดออก ไม่ใช่เพียงข้อความที่ดึงมา ✅ ที่มาของการตัดสินใจ — การตัดสินใจรับเข้า/คัดออกทุกครั้งควรตรวจสอบย้อนกลับได้ข้ามเซสชัน ✅ การดึงข้อมูลอย่างมีโครงสร้าง — ฟิลด์ที่เปรียบเทียบกันได้มีประโยชน์กว่าสรุปเชิงบรรยายแบบครั้งเดียว ✅ ความเที่ยงตรงต่อโปรโตคอลภายใต้การกำกับของมนุษย์ — แวดวงหลักฐานยังถือว่า AI เป็นเครื่องมือเสริม ไม่ใช่ผู้ตรวจทานทดแทน ✅ การสังเคราะห์ที่กำหนดเวอร์ชันได้ — รายงาน รูปภาพ และรายชื่อแหล่งข้อมูลควรสะสมต่อเนื่อง แทนที่จะสร้างใหม่จากศูนย์
เพื่อเปรียบเทียบเครื่องมือเหล่านี้อย่างเป็นธรรม ควรมองการทำแผนที่หลักฐานเป็นปัญหาความต่อเนื่องสี่ชั้น แทนที่จะเป็นการแข่งขันสรุปเนื้อหา
เหตุใดการทำแผนที่หลักฐานอย่างเป็นระบบจึงท้าทายเครื่องมือ AI สำหรับบทความรายฉบับ?
การทำแผนที่หลักฐานอย่างเป็นระบบท้าทายตัวสรุปบทความรายฉบับ เพราะแผนที่คือบัญชีรายการวรรณกรรมที่ผ่านการเข้ารหัส ไม่ใช่ลำดับของบันทึกการอ่านที่แยกขาดจากกัน Systematic Evidence Maps (SEMs) เป็นรูปแบบหนึ่งของการสังเคราะห์หลักฐานที่จัดหมวดหมู่และจัดระเบียบข้อค้นพบทางวิทยาศาสตร์ตามมิติที่กำหนดล่วงหน้า — ประชากร การสัมผัส ผลลัพธ์ วิธีวิธีวิจัย ภูมิศาสตร์ หรือช่องว่างของหลักฐาน — เพื่อให้ผู้ทบทวนเห็นว่ามีอะไรอยู่ตรงไหน หลักฐานกระจุกตัวที่ใด และสิ่งใดขาดหายไป
เวิร์กโฟลว์นี้ขัดกับวิธีทำงานของผลิตภัณฑ์วิจัย LLM ส่วนใหญ่ เครื่องมือ RAG หรือ “แชตกับ PDF นี้” ตอบคำถามปัจจุบันด้วยการดึงชิ้นส่วนที่คล้ายกันในบริบทเฉพาะหน้า แต่ไม่ได้โหลดกรอบการเข้ารหัสของวันอังคารที่แล้ว งานวิจัยสามฉบับที่พักไว้ในสถานะ “อาจใช่” หรือการตัดสินใจตัดแบบจำลองสัตว์ออกจากขอบเขตหลังปรับโปรโตคอลให้เข้มงวดขึ้นโดยอัตโนมัติ การทบทวนเพื่อทำแผนที่ยังต้องใช้กระบวนการคัดกรองที่มีเอกสารกำกับ เทียบกับเกณฑ์รับเข้าและคัดออก ซึ่งเป็นงานคนละประเภทกับการเขียนย่อหน้าที่ลื่นไหลเกี่ยวกับบทความหนึ่งฉบับ (ระเบียบวิธีสำหรับการทบทวนเพื่อทำแผนที่)
การทบทวนด้วยมือยังช้าพอที่จะทำให้ทางลัดดูน่าดึงดูด แบบสำรวจเครื่องมือวรรณกรรมปี 2026 ฉบับหนึ่งประเมินว่ารอบการทบทวนแบบดั้งเดิมใช้เวลา สี่ถึงหกสัปดาห์สำหรับการคัดกรอง การดึงข้อมูล และการจัดการรายการอ้างอิง เครื่องมือคัดกรอง AI เฉพาะทางอาจลดภาระนี้ได้ — ระบบ AIM Review รายงาน การลดภาระงานตั้งแต่ 20% ถึง 95% ในการทบทวนจริงหกโครงการ — แต่ความเร็วไม่ได้สร้างแผนที่ขึ้นมาเอง หากไม่มีสถานะโครงการที่คงอยู่ การคัดกรองที่เร็วขึ้นก็เพียงสร้างกองสรุปที่ไม่เชื่อมโยงกันขนาดใหญ่กว่าเดิม
หน่วยงานด้านห้องสมุดและระเบียบวิธีระบุช่องว่างที่ยังเหลืออยู่ไว้อย่างชัดเจน แนวทางการสังเคราะห์หลักฐานของ King’s College London ระบุว่า เครื่องมือ AI ไม่สามารถแทนที่วิธีค้นหา คัดกรอง และดึงข้อมูลแบบดั้งเดิมได้ และควรใช้เมื่อเข้าใจอย่างชัดเจนถึงอคติ ข้อจำกัดด้านลิขสิทธิ์ และความเสี่ยงจากการหลอนของ AI เท่านั้น การทบทวนอย่างเป็นระบบปี 2025 เกี่ยวกับ generative AI ในการสังเคราะห์หลักฐานให้ข้อสรุปเชิงปฏิบัติการเดียวกัน: หลักฐานในปัจจุบันยังไม่สนับสนุนการใช้ GenAI โดยปราศจากการมีส่วนร่วมหรือการกำกับของมนุษย์
คุณควรมองหาอะไรในเวิร์กโฟลว์ AI สำหรับการทำแผนที่หลักฐาน?
คุณควรประเมินเครื่องมือ AI สำหรับการทำแผนที่ด้วยการทดสอบความต่อเนื่อง ไม่ใช่การทดสอบคุณภาพการเขียน เราใช้สแตกสี่ชั้นที่เรียกว่า CODE stack เพราะแต่ละชั้นล้มเหลวในรูปแบบที่ต่างกันและคาดเดาได้ เมื่อทีมพยายามเปลี่ยนการแชตกับบทความให้เป็นแผนที่อย่างเป็นระบบ
C — ความครอบคลุม. เครื่องมือสามารถค้นหาชุดวรรณกรรมวิชาการจริง หรือค้นได้เฉพาะไฟล์ที่คุณอัปโหลดแล้ว? Elicit ค้นหา บทความมากกว่า 138 ล้านฉบับและการทดลองทางคลินิก 545,000 รายการ ขณะที่ NotebookLM ถูกออกแบบมาให้ตอบจาก แหล่งข้อมูลในโน้ตบุ๊ก เท่านั้น ความผิดพลาดด้านความครอบคลุมในชั้นนี้กลายเป็นแถวที่หายไปในแผนที่ ไม่ใช่เพียงย่อหน้าที่บางเกินไป
O — การทำให้เป็นเกณฑ์ปฏิบัติ. เกณฑ์รับเข้า มิติการเข้ารหัส และฟิลด์ดึงข้อมูลสามารถระบุครั้งเดียวแล้วนำกลับมาใช้ซ้ำได้หรือไม่? ตัวสรุปที่ตีความคำว่า “เกี่ยวข้อง” ใหม่ทุกพรอมป์ต์ จะเข้ารหัสการทดลองชายขอบฉบับเดียวกันต่างกันในวันที่สาม แนวทางการทำแผนที่ถือว่าเกณฑ์ที่กำหนดล่วงหน้าเป็นสิ่งที่ขาดไม่ได้ (วิธีการทบทวนเพื่อทำแผนที่)
D — ที่มาของการตัดสินใจ. คุณสามารถย้อนดูได้หรือไม่ว่าเหตุใดงานวิจัยหนึ่งฉบับจึงถูกรับเข้า คัดออก พักไว้ หรือคัดกรอง? กลุ่มที่สอดคล้องกับ Cochrane รวมถึงความริเริ่ม Responsible AI in Evidence Synthesis (RAISE) ร่วมกับ Cochrane, Campbell และ JBI ถือว่าความโปร่งใสเป็นข้อกำหนดด้านคุณภาพ ไม่ใช่เพียงสิ่งที่มีก็ดี
E — ความสามารถในการดึงข้อมูล. ข้อค้นพบสามารถลงสู่ช่องข้อมูลที่เปรียบเทียบกันได้ — ตัวอย่าง การออกแบบ ทิศทางของผล ข้อจำกัด — แทนที่จะอยู่ในร้อยแก้วที่เทียบกันไม่ได้หรือไม่? การออกแบบผลิตภัณฑ์ของ Elicit สร้างขึ้นรอบ ตารางแบบโต้ตอบและการดึงข้อมูลหลายขั้นตอน Consensus รวดเร็วกว่าสำหรับทิศทางของหลักฐานระดับสมมติฐาน แต่ ไม่ได้สร้างมาเพื่อการเขียนทบทวนอย่างมีโครงสร้าง
ให้น้ำหนักแต่ละชั้นตามวัตถุประสงค์ การสำรวจขอบเขตเบื้องต้นอาจยอมรับที่มาของการตัดสินใจที่อ่อนกว่าได้ แต่แผนที่หลักฐานที่มีชีวิตและจะถูกอ้างอิง อัปเดต หรือส่งต่อให้ผู้เขียนร่วม ไม่อาจยอมรับได้ เครื่องมือที่โดดเด่นด้านความครอบคลุมและการดึงข้อมูลยังล้มเหลวสำหรับแผนที่ หากการทำให้เป็นเกณฑ์ปฏิบัติและที่มาของการตัดสินใจถูกรีเซ็ตทุกเซสชัน
Elicit, Consensus, NotebookLM และพื้นที่ทำงานวิจัยแตกต่างกันอย่างไร?
Elicit และ Consensus เป็นชั้นที่แข็งแกร่งที่สุดในหมวดนี้สำหรับการค้นพบบทความและดึงข้อมูล NotebookLM เป็นโน้ตบุ๊กจากชุดข้อมูลปิดที่แข็งแกร่งที่สุด และพื้นที่ทำงานวิจัยแบบคงอยู่เป็นสภาพแวดล้อมที่ดีที่สุดในการรักษาความสอดคล้องของแผนที่ตลอดหลายสัปดาห์ ไม่มีผลิตภัณฑ์ใดชนะในทุกชั้นของ CODE ดังนั้นทีมที่ทำแผนที่อย่างจริงจังจึงมักจับคู่เครื่องมือชุดข้อมูลกับสภาพแวดล้อมความจำโครงการ แทนที่จะคาดหวังให้แชตบอตตัวเดียวรับผิดชอบการทบทวนทั้งหมด
ณ ปี 2026 ภาพรวมฟีเจอร์และราคาที่เผยแพร่มีลักษณะดังนี้:
| ฟีเจอร์ / มิติ | Elicit | NotebookLM | Consensus | พื้นที่ทำงานวิจัย Jenova |
|---|---|---|---|---|
| โมเดลความจำ | คลังแหล่งข้อมูลที่บันทึกไว้ พร้อมการปรับแต่งรายงานแต่ละฉบับ; ไม่ใช่คอนเทนเนอร์สถานะโครงการเต็มรูปแบบ | ชุดแหล่งข้อมูลระดับโน้ตบุ๊ก; คำตอบอยู่ภายในเอกสารที่อัปโหลด | ความจำเกี่ยวกับคำถาม/รายการรอบคำค้นเชิงสมมติฐาน | ความจำข้ามเซสชันแบบคงอยู่; บริบทโครงการสามารถโหลดกลับมาแทนการดึงใหม่ |
| ความครอบคลุม | บทความ 138M+ และการทดลอง 545k | เฉพาะชุดข้อมูลที่อัปโหลด; 50 แหล่งข้อมูลในแผนฟรี, 300 ใน Plus | บทความ 200M+ พร้อมแท็กทิศทางหลักฐาน | การค้นหาเว็บและวิชาการแบบสด พร้อมฐานความรู้ที่แนบได้; ไม่ใช่ดัชนีผู้เผยแพร่แบบตายตัว |
| การดึงข้อมูลอย่างมีโครงสร้าง | ตาราง การคัดกรอง และจุดข้อมูลจำนวนมาก (สูงสุด 1,000 บทความ / 20,000 จุดข้อมูล) | Q&A และโครงร่างที่เชื่อมโยงกับแหล่งข้อมูล ไม่ใช่ตารางดึงข้อมูลสำหรับ SR | Consensus Meter และคำตอบหลักฐานแบบสั้น | รายงานสังเคราะห์และบทสรุปพร้อมรายการอ้างอิงผ่าน Deep Research; อ่อนกว่าสำหรับการคัดกรองสองผู้ตรวจเฉพาะทาง |
| ความคงอยู่ของการตัดสินใจ | เก็บแหล่งข้อมูลไว้ในคลังได้; สถานะโปรโตคอลไม่ใช่ฟังก์ชันหลัก | เก็บไฟล์ของโน้ตบุ๊ก ไม่ใช่ตรรกะรับเข้า/คัดออกที่เข้ารหัส | บุ๊กมาร์กและรายการในแผนชำระเงิน | ประวัติการสนทนา ความจำ และไฟล์โครงการที่แนบไว้คงอยู่ข้ามเซสชัน |
| ราคา (ณ ปี 2026) | Plus เริ่มต้นราว 12 ดอลลาร์/เดือน | ฟรี; Plus ผ่าน Google AI Pro ราว 19.99 ดอลลาร์/เดือน | Premium ราว 10 ดอลลาร์/เดือน | แผนฟรีพร้อมการใช้งานจำกัด; Plus 20 ดอลลาร์/เดือนสำหรับการใช้งาน 30× |
| เหมาะที่สุดสำหรับ | การคัดกรองปริมาณมากและตารางดึงข้อมูล | ชุดสอนและ PDF ที่รวบรวมแล้ว | การตรวจเร็วว่า “วรรณกรรมสนับสนุน X หรือไม่?” | แผนที่ที่มีชีวิต การเข้ารหัสหลายเซสชัน และการผสานเข้ากับต้นฉบับ |
Elicit คือผู้เชี่ยวชาญที่ตรงไปตรงมาสำหรับการคัดกรองแบบเป็นระบบ สามารถทำให้การคัดกรองและการดึงข้อมูลเป็นอัตโนมัติ และรายงาน การประหยัดเวลาสูงสุด 80% ในขั้นตอนเหล่านั้น อย่างไรก็ดี การเปรียบเทียบวิธีการของ Cochrane พบว่า ความไวในการค้นหาของ Elicit ยังไม่สูงพอที่จะทดแทนการค้นหาวรรณกรรมแบบดั้งเดิม จึงเหมาะที่สุดในฐานะเครื่องมือเสริมที่มีความแม่นยำสูง อีกทั้งมักหยุดอยู่ที่รายงานและตาราง ส่วนงานเขียน การกำหนดเวอร์ชัน และงานต้นฉบับที่มีชีวิตมักต้องย้ายไปทำที่อื่น
NotebookLM คือผู้เชี่ยวชาญที่ตรงไปตรงมาสำหรับการอ่านเชิงยึดโยงกับชุดเอกสารตายตัว ทุกคำตอบสามารถตรวจสอบกับข้อความอ้างอิงได้ และ Google ได้เพิ่ม Deep Research พร้อมรองรับประเภทไฟล์ที่กว้างขึ้น เครื่องมือนี้ไม่สามารถค้นพบบทความที่คุณยังไม่ได้รวบรวม และไม่ได้เข้ารหัสบันทึกการตัดสินใจแบบ PRISMA
Consensus คือผู้เชี่ยวชาญที่ตรงไปตรงมาสำหรับทิศทางของสมมติฐาน มิเตอร์และการติดแท็กสนับสนุน/ขัดแย้งของเครื่องมือนี้รวดเร็วกว่าการสร้างตารางดึงข้อมูล เมื่อคุณเพียงต้องการรู้ว่าวรรณกรรมมีแนวโน้มไปทางใด (การเปรียบเทียบเครื่องมือ) แต่เป็นระบบหลักที่ไม่เหมาะสำหรับแผนที่ที่เข้ารหัสไว้
Academic Research Assistant ของ Jenova แข็งแกร่งที่สุดเมื่อหน่วยงานของงานคือ โครงการ ไม่ใช่ PDF เครื่องมือนี้สามารถค้นหาแหล่งข้อมูลวิชาการ เก็บบริบทของต้นฉบับและรายการอ้างอิง และ — เนื่องจากแพลตฟอร์มพื้นฐานจัดเก็บประวัติการแชตแบบไม่จำกัดและความจำข้ามเซสชัน — สามารถทำงานต่อในกรอบการเข้ารหัสเดิมโดยไม่ต้องวางโปรโตคอลซ้ำ ไม่ใช่แพลตฟอร์มคัดกรองแบบสองผู้ตรวจที่ผ่านการตรวจสอบแล้วในความหมายเดียวกับ Covidence หรือ Rayyan และไม่ได้เผยแพร่ตัวเลขความแม่นยำในการดึงข้อมูลแบบ Elicit ทีมที่ต้องการร่องรอยการตรวจสอบระดับกำกับดูแลจึงยังควรมีเครื่องมือคัดกรองเฉพาะทางอยู่ในชุดเครื่องมือ
SciSpace และ Scite เติมเต็มงานข้างเคียงที่แคบกว่า SciSpace มักถูกอธิบายว่าเป็นสภาพแวดล้อมที่ดีกว่าสำหรับ การวิเคราะห์เชิงลึกทีละบทความ โดยมีชุดข้อมูลขนาดใหญ่มาก แต่มีเวิร์กโฟลว์การทบทวนที่รวมศูนย์น้อยกว่า Smart Citations 1.6 พันล้านรายการ ของ Scite ซึ่งจำแนกว่าอ้างอิงเพื่อสนับสนุน ขัดแย้ง หรือกล่าวถึงข้ออ้าง มีความโดดเด่นที่สุดสำหรับการตรวจสอบบริบทการอ้างอิง แต่แทบไม่มีประโยชน์เมื่อใช้เป็นฐานข้อมูลค้นพบหรือทำแผนที่เพียงลำพัง
ความจำเชิงปฏิบัติการเปลี่ยนการสังเคราะห์วรรณกรรมหลายเซสชันอย่างไร?
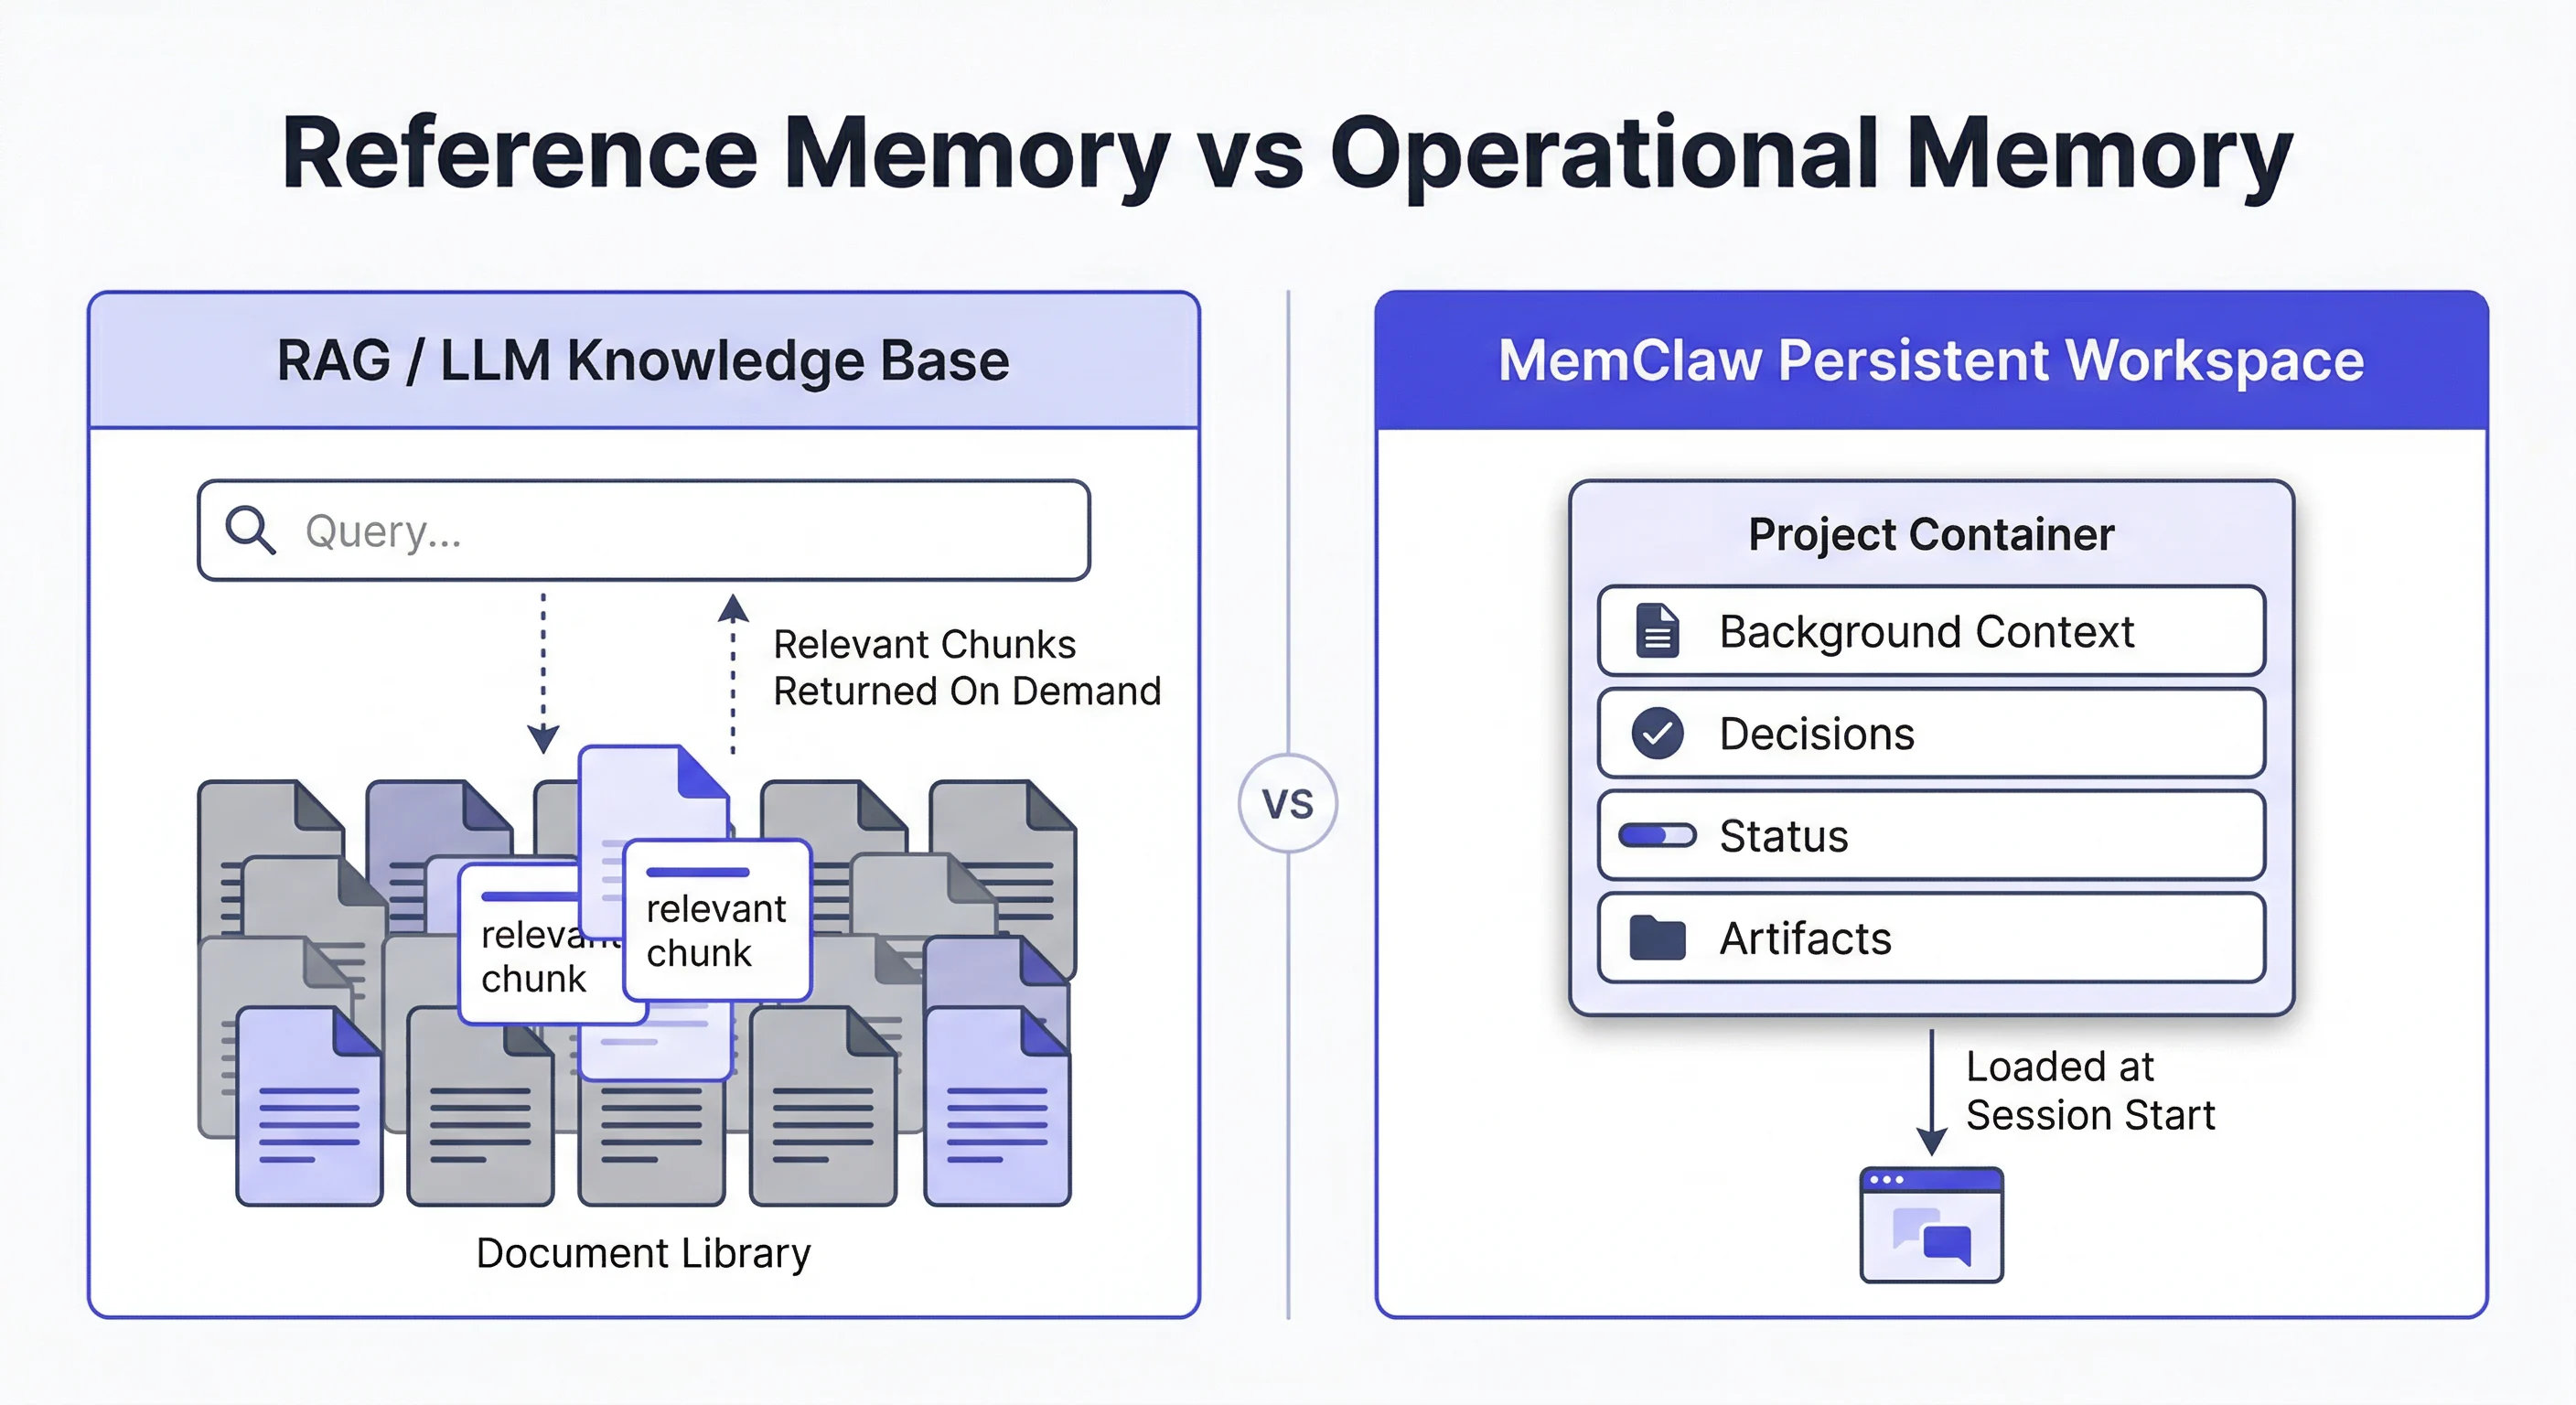
ความจำเชิงปฏิบัติการเปลี่ยนการสังเคราะห์ เพราะมันถือว่าคอนเทนเนอร์โครงการ — พื้นหลัง การตัดสินใจ สถานะ และอาร์ทิแฟกต์ — คือวัตถุที่ต้องโหลดเมื่อเริ่มเซสชัน แทนที่จะถือว่าวรรณกรรมเป็นกองฟางที่ต้องค้นใหม่ ความจำอ้างอิงถามว่า “ชิ้นส่วนใดดูคล้ายคำถามนี้?” ความจำเชิงปฏิบัติการถามว่า “ตอนนี้สิ่งใดเป็นความจริงเกี่ยวกับโครงการนี้แล้ว และสิ่งใดยังต้องการหลักฐาน?”
ความแตกต่างนี้ปรากฏในโหมดความล้มเหลวสามแบบที่ตัวสรุปมักปกปิดได้ดี:
- เกณฑ์เลื่อนไหล. หากข้อความว่า “เฉพาะ RCT ในมนุษย์ผู้ใหญ่” อยู่ในพรอมป์ต์แทนที่จะอยู่ในสถานะโครงการ เซสชันถัดมาที่ถามคำถามกว้างขึ้นเพียงเล็กน้อยอาจรับงานวิจัยเด็กที่คุณเคยปฏิเสธกลับเข้ามาโดยเงียบ ๆ
- รายการอาจใช่ที่ไร้เจ้าของ. บทความชายขอบที่พักไว้เพื่อหารือกับผู้เขียนร่วมจะหายไป เว้นแต่สถานะจะเป็นฟิลด์ระดับแรกของระบบ
- การสังเคราะห์ที่สร้างใหม่. คำตอบจาก RAG อาจซื่อตรงต่อชิ้นส่วนที่ดึงมาในวันนี้ แต่ยังขัดแย้งกับตารางช่องว่างของสัปดาห์ก่อน เพราะไม่มีสิ่งใดบังคับให้คำตอบใหม่สืบทอดการเข้ารหัสเดิม
พื้นที่ทำงานแบบคงอยู่กลับลำดับการโหลด บริบทพื้นหลัง การตัดสินใจ สถานะ และอาร์ทิแฟกต์ถูกนำเข้ามาก่อนคำค้นถัดไป การนำรูปแบบนี้ไปใช้ในแพลตฟอร์ม Jenova คือความจำข้ามเซสชันร่วมกับฐานความรู้ที่แนบได้: ผู้ช่วยสามารถจดจำมิติการทำแผนที่ คำจำกัดความที่ใช้งานของช่องว่างหลักฐาน และข้ออ้างใดมีหลักฐานสนับสนุนเพียงพอแล้ว การทดสอบสิ่งนี้เทียบกับเครื่องมือแบบโน้ตบุ๊กแสดงให้เห็นการแลกเปลี่ยนที่ชัดเจน ชุดข้อมูลปิดของ NotebookLM ปลอดภัยกว่าจากการสร้างข้อมูลนอกแหล่งอ้างอิง (คำตอบที่เชื่อมโยงกับแหล่งข้อมูล) ส่วนพื้นที่ทำงานแบบเปิดที่คงอยู่มีประโยชน์กว่าเมื่อชุดข้อมูลยังเติบโต และกรอบการเข้ารหัสคือสินทรัพย์ที่ขาดแคลน
นัยเชิงปฏิบัติสำหรับ SEMs นั้นเรียบง่าย หากผลลัพธ์ของคุณคือบทสรุปจาก PDF 15 ฉบับในคราวเดียว ความจำเชิงปฏิบัติการเป็นทางเลือก แต่หากผลลัพธ์คือแผนที่ช่องว่างที่จะอัปเดตหลังรอบการประชุมวิชาการครั้งถัดไป ความจำเชิงปฏิบัติการก็คือตัวผลิตภัณฑ์
ไปป์ไลน์หลักฐานแบบเอเจนต์ครบวงจรมีหน้าตาอย่างไรในทางปฏิบัติ?
ไปป์ไลน์การทำแผนที่ครบวงจรมีลักษณะเป็นสปรินต์วิจัยแบบแบ่งขั้นตอนและมีจุดตรวจ ไม่ใช่พรอมป์ต์เดียวว่า “สรุปบทความเหล่านี้” ภาพประกอบด้านล่างเป็นสถาปัตยกรรมอ้างอิงที่มีประโยชน์: การกำหนดคำถาม การคัดแยกวรรณกรรม การระบุผู้สมัคร การทำสมมติฐานให้เป็นทางการ การตรวจสอบจากหลายแหล่ง การรายงานแบบกำหนดเวอร์ชัน และแพ็กเกจที่ติดตามด้วย git
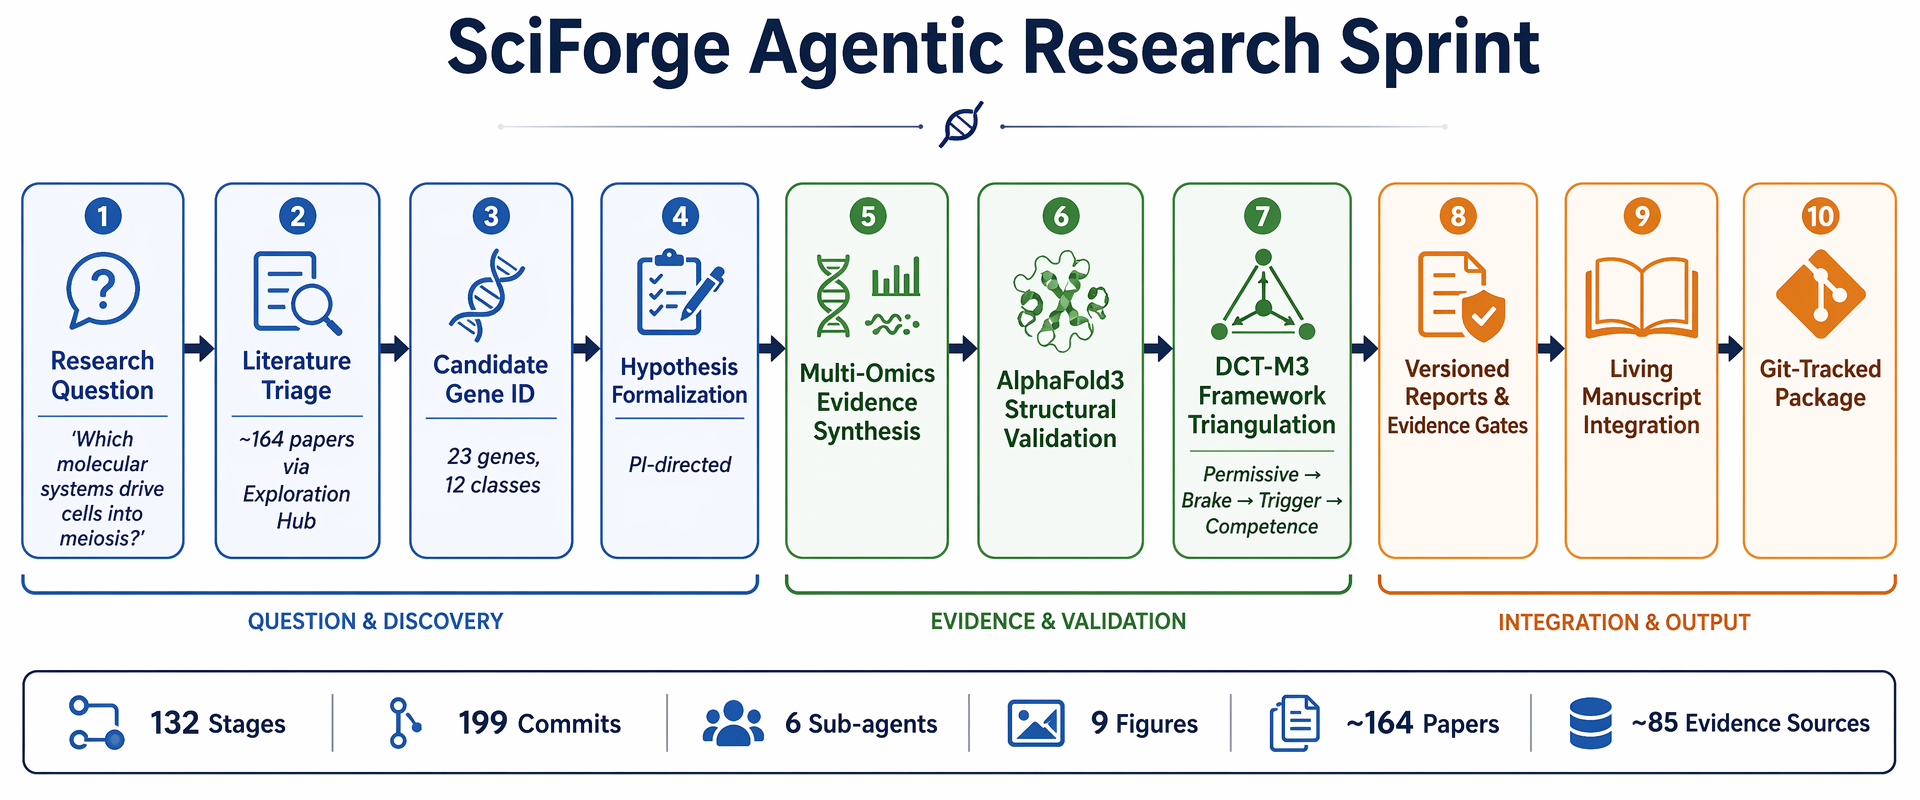
ตัวอย่างสปรินต์นี้ตั้งใจให้มีขนาดใหญ่ — ประมาณ คัดแยกบทความ 164 ฉบับ, 132 ขั้นตอน, 199 คอมมิต, เอเจนต์ย่อยหกตัว และแหล่งหลักฐานราว 85 แหล่ง — เพราะเป็นระดับที่การแชตกับบทความเริ่มพัง ตัวสรุปสามารถอธิบายบทความที่ 17 ได้ แต่ไม่สามารถรักษาห่วงโซ่ 10 ขั้นให้สอดคล้อง เมื่อขั้นที่ 4 เปลี่ยนเกณฑ์รับเข้าซึ่งขั้นที่ 2 ใช้ไปแล้ว
ตัวเลือกการออกแบบสามประการในไปป์ไลน์นั้นสำคัญกว่ารายละเอียดเฉพาะโดเมน:
- การค้นพบเป็นระยะ ไม่ใช่ผลิตภัณฑ์. การคัดแยกวรรณกรรมต้องป้อนรหัสผู้สมัครและสมมติฐานที่เป็นทางการ การหยุดที่บทสรุปคือการปล่อยให้แผนที่ยังไม่ถูกสร้าง
- การตรวจสอบมีหลายรูปแบบ. การสังเคราะห์หลักฐาน การตรวจสอบเชิงโครงสร้างหรือเชิงปริมาณ และตรรกะ “อนุญาต → เบรก → ตัวกระตุ้น” ที่ชัดเจน บังคับให้ข้ออ้างผ่านจุดตรวจ แทนที่จะเฉลี่ยรวมเป็นย่อหน้าเดียว
- ผลลัพธ์ต้องกำหนดเวอร์ชัน. การผสานเข้ากับต้นฉบับที่มีชีวิตและแพ็กเกจที่ติดตามด้วย git ทำให้แผนที่เป็นอาร์ทิแฟกต์ที่มีประวัติ ซึ่งตรงข้ามกับบันทึกการแชตที่คุณเล่นซ้ำไม่ได้
Jenova สามารถทำให้รูปแบบนี้ใกล้เคียงจริงได้ด้วยการแยกบทบาทข้ามเอเจนต์ แทนการบังคับให้แชตหนึ่งชุดต้องเป็นทั้งบรรณารักษ์ ผู้เข้ารหัส และนักเขียน Academic Research Assistant ดูแลการค้นพบเชิงวิชาการและบริบทต้นฉบับ Deep Research สร้างการสังเคราะห์พร้อมรายการอ้างอิงจากหลายแหล่ง Real-Time Search มีประโยชน์เมื่อแผนที่ต้องรวม preprint คลังเก็บ หรือวรรณกรรมสีเทาที่ไม่ใช่วารสารด้วย ข้อจำกัดคือวินัยในการประสานงาน: มนุษย์ยังเป็นเจ้าของโปรโตคอล จุดตรวจ และการตัดสินใจยกระดับข้ออ้างเข้าสู่ต้นฉบับที่มีชีวิต กลุ่มระเบียบวิธียังคงถือว่าบทบาทมนุษย์นี้ต่อรองไม่ได้ (แนวทาง KCL / RAISE)
แพลตฟอร์มทบทวนแบบครบวงจรสไตล์ Paperguide พยายามรวมการวางแผน–ค้นหา–คัดกรอง–ดึงข้อมูล–สร้างเนื้อหาไว้ในเวิร์กโฟลว์ผู้ให้บริการรายเดียว รวมถึง โหมด Extended ที่คัดกรองผู้สมัคร 200 รายและเขียนจาก 50 อันดับแรก แนวทางนี้ใกล้เคียงพื้นที่ทำงานมากกว่า Elicit-plus-Word แต่ยังต้องมีบันทึกการตัดสินใจภายนอก หากคุณให้ความสำคัญกับที่มาของการตัดสินใจหลังส่งออกการทบทวนที่สร้างแล้ว
จะใช้แผนที่หลักฐาน AI ให้คุ้มค่าที่สุดได้อย่างไร?
คุณจะใช้แผนที่หลักฐาน AI ได้คุ้มค่าที่สุดด้วยการเขียนโปรโตคอลลงในพื้นที่ทำงานก่อนขอให้เขียนร้อยแก้ว แล้วบังคับให้ทุกเซสชันหลังจากนั้นสืบทอดโปรโตคอลนั้น การตั้งค่ามีลักษณะคล้ายกันข้ามเครื่องมือ ความต่างคือเครื่องมือนั้นจดจำการตั้งค่าได้หรือไม่
สำหรับแผนที่ที่มี Jenova เป็นศูนย์กลาง ลำดับการทำงานที่ใช้งานได้คือ:
- เปิด Academic Research Assistant แล้วระบุชื่อโครงการ ประชากร และมิติการทำแผนที่ในข้อความแรก
- ปักหมุดโปรโตคอลด้วยภาษาที่ผู้ช่วยนำกลับมาใช้ได้:
“สร้างแผนที่หลักฐานอย่างเป็นระบบของงานวิจัยในมนุษย์ผู้ใหญ่เกี่ยวกับ X รับเฉพาะ RCT และ cohort เชิงไปข้างหน้า เข้ารหัสงานวิจัยแต่ละฉบับตามการออกแบบ กลุ่มตัวอย่าง การแทรกแซง ผลลัพธ์หลัก ทิศทางของผล และข้อจำกัด พักบทความสัตว์และ in-vitro ไว้ในบันทึกคัดออกพร้อมเหตุผลหนึ่งบรรทัด อย่าสร้างรหัสใหม่สำหรับสิ่งที่ตัดสินใจแล้ว”
- เรียกใช้ Deep Research สำหรับการสำรวจชุดข้อมูลรอบแรก จากนั้นวางหรือแนบตารางทำงานกลับเข้าสู่เธรดโครงการเดิม เพื่อให้การดึงข้อมูลและการเล่าเรื่องใช้ความจำเดียวกัน
- หลังจบแต่ละเซสชัน ให้ขออาร์ทิแฟกต์สามอย่าง ไม่ใช่บทความเดียว: ตารางงานวิจัยที่อัปเดต บันทึกการคัดออก และรายการช่องว่าง ไฟล์ทั้งสามนี้ คือ แผนที่
สำหรับ Elicit ให้เริ่มจากคำถามวิจัย สร้างตารางคัดกรอง และถือว่าคลังข้อมูลเป็นแหล่งความจริง (เวิร์กโฟลว์การทบทวนอย่างเป็นระบบของ Elicit) อย่าข้ามการค้นหาฐานข้อมูลแบบดั้งเดิม กรณีศึกษาของ Cochrane พบว่า Elicit มีประโยชน์สำหรับ การค้นหาเบื้องต้นที่มีความแม่นยำสูง และการค้นหางานวิจัยเพิ่มเติมเฉพาะรายการ ไม่ใช่ในฐานะเครื่องมือค้นหาเพียงตัวเดียว
สำหรับ NotebookLM ให้รวบรวม PDF ก่อน อยู่ในโน้ตบุ๊กเดียว และถามคำถามทีละมิติ (“ระบุงานวิจัยทุกฉบับที่รายงานผลลัพธ์ Y พร้อมขนาดกลุ่มตัวอย่างและระยะติดตาม”) เพื่อไม่ให้ชุดข้อมูลปิดหลุดออกนอกขอบเขต ข้อจำกัดการอัปโหลด — 50 แหล่งข้อมูลในแผนฟรี และ 300 ใน Plus — ทำให้เครื่องมือนี้ไม่เหมาะกับแผนที่ 400 ระเบียน เว้นแต่คุณจะคัดกรองล่วงหน้าที่อื่น
กฎกระบวนการสองข้อใช้ได้กับทุกชุดเครื่องมือ ประการแรก อย่าอัปโหลด PDF ฉบับเต็มเข้าสู่โมเดลสำหรับผู้บริโภค หากเงื่อนไขลิขสิทธิ์ห้ามไว้ เพราะ ผู้ถือสิทธิ์โดยทั่วไปห้ามการใช้งานลักษณะนั้น ประการที่สอง ให้มนุษย์เป็นผู้ตัดสินใจรับเข้า/คัดออกเสมอ การช่วยคัดกรองเป็นงาน AI ที่มีหลักฐานสนับสนุนมากที่สุด ส่วนการสังเคราะห์โดยไร้การกำกับเป็นงานที่มีหลักฐานสนับสนุนน้อยที่สุด (การทบทวนการทบทวนเกี่ยวกับความพร้อมของ AI)
ผู้เชี่ยวชาญด้านการสังเคราะห์หลักฐานกล่าวอย่างไรเกี่ยวกับการทำแผนที่โดยมี AI ช่วย?
ผู้เชี่ยวชาญยอมรับ AI มากขึ้นสำหรับการคัดกรองและดึงข้อมูลภายใต้การกำกับ แต่ยังปฏิเสธ AI ในฐานะนักทำแผนที่ของสาขาโดยไร้การกำกับ ฉันทามติผู้เชี่ยวชาญที่มีประโยชน์ในปี 2026 แคบกว่าข้อความการตลาดของผู้ขาย: ทำให้ชั้นงานซ้ำซากเป็นอัตโนมัติ รักษาชั้นการตัดสินใจให้คงอยู่ และให้มนุษย์รับผิดชอบต่อแผนที่
“โหมดความล้มเหลวที่เราเห็นไม่ใช่ว่าโมเดลสรุปบทความไม่ได้ แต่คือทีมทำแผนที่ปฏิบัติต่อบทสรุปที่ดีราวกับเป็นระเบียนที่เข้ารหัสแล้ว แผนที่หลักฐานอย่างเป็นระบบคือชุดการตัดสินใจที่ย้อนกลับได้ — รับเข้า คัดออก พักไว้ คัดกรอง — ซึ่งผูกกับฟิลด์ที่คงที่ หากการตัดสินใจเหล่านั้นอยู่เพียงในพรอมป์ต์เมื่อสัปดาห์ก่อน แผนที่ก็เสียหายแล้ว แม้ว่าทุกย่อหน้าจะยังฟังดูรอบคอบก็ตาม”
“การดึงข้อมูลอ้างอิงและความจำเชิงปฏิบัติการแก้ปัญหาคนละแบบ การดึงข้อมูลคือวิธีค้นหาหลักฐานที่อาจเหมาะสม ความจำเชิงปฏิบัติการคือวิธีหยุดการเข้ารหัสงานวิจัยฉบับเดียวกันซ้ำสามครั้ง เครื่องมือที่ยอดเยี่ยมในงานแรกมักถูกนำไปใช้ราวกับทำงานที่สองได้ด้วย นั่นคือที่มาของการวิเคราะห์ช่องว่างที่ลื่นไหล แต่ไม่สามารถอธิบายได้ว่าเหตุใดการทดลองชายขอบ 12 รายการจึงหายไป”
“กฎการทำงานของเราง่ายมาก ใช้เอนจินชุดข้อมูลเพื่อเติมแถว ใช้พื้นที่ทำงานแบบคงอยู่เพื่อรักษาสมุดรหัส บันทึกการคัดออก และตารางช่องว่างให้มีชีวิต ใช้ผู้ทบทวนมนุษย์ทุกจุดตรวจที่เปลี่ยนความหมายของแผนที่ สิ่งใดก็ตามที่ขายว่าเป็นแผนที่อย่างเป็นระบบแบบคลิกเดียว กำลังขอให้คุณข้ามชั้นเดียวที่กลุ่มระเบียบวิธียังถือว่าต่อรองไม่ได้”
— ทีมผลิตภัณฑ์ Jenova, การออกแบบเวิร์กโฟลว์วิจัย, มีประสบการณ์ 8 ปีในการสร้างระบบความรู้สำหรับงานวิเคราะห์หลายเซสชัน
จุดยืนนี้สอดคล้องกับแนวทางอย่างเป็นทางการ NICE คำแนะนำ RAISE ที่เชื่อมโยงกับ Cochrane และบริการห้องสมุดมหาวิทยาลัย ต่างอธิบาย AI ว่าเป็น เครื่องมือเสริมภายในวิธีการที่ผ่านการตรวจสอบแล้ว คู่มือที่มีการปรับปรุงต่อเนื่องเกี่ยวกับ AI ในการค้นหาและคัดกรองวรรณกรรม ให้เหตุผลด้านประสิทธิภาพแบบเดียวกัน — การคัดกรองมีต้นทุนสูง และระบบอัตโนมัติช่วยได้ — โดยไม่ได้อ้างว่าการสร้างเนื้อหาสามารถแทนที่โปรโตคอลได้
เมื่อใดตัวสรุปบทความรายฉบับยังเป็นตัวเลือกที่เหมาะสม?
ตัวสรุปบทความรายฉบับยังเป็นตัวเลือกที่เหมาะสม เมื่อชุดข้อมูลมีขนาดเล็ก รวบรวมไว้แล้ว และไม่ได้ถูกเข้ารหัสเป็นแผนที่ที่นำกลับมาใช้ได้ หากคุณมี PDF 12 ฉบับ มีการประชุมวารสารวันพรุ่งนี้ และไม่จำเป็นต้องอัปเดตบัญชีรายการในอีกสามเดือน NotebookLM หรือการแชตกับบทความสไตล์ SciSpace จะทำงานเสร็จด้วยขั้นตอนที่น้อยกว่าคอนเทนเนอร์โครงการ
เครื่องมือเหล่านี้เหมาะกว่าสำหรับงานอีกสามประเภทที่มักถูกเรียกผิดว่าเป็นการทำแผนที่:
- การอธิบายกลไก. “พาฉันทำความเข้าใจรูปที่ 3” เป็นงานอ่าน โน้ตบุ๊กชุดข้อมูลปิดที่มีข้อความอ้างอิงกดดูได้ปลอดภัยกว่าพื้นที่ทำงานแบบเปิดที่อาจผสมเนื้อหาจากหลายบทความ
- การตรวจสอบบริบทการอ้างอิง. หากคำถามคือผลงานภายหลังสนับสนุนหรือขัดแย้งกับข้ออ้างหนึ่งหรือไม่ การอ้างอิงที่จำแนกของ Scite คือชั้นงานที่สร้างขึ้นเพื่อสิ่งนั้นโดยเฉพาะ (Smart Citations 1.6B+)
- การตรวจสอบสมมติฐานเฉพาะจุด. Consensus ยังคงเป็นวิธีที่เร็วที่สุดในการดูว่าข้อเสนอหนึ่งมีการแบ่งระหว่างหลักฐานสนับสนุน/ขัดแย้งที่ชัดเจนหรือไม่ ก่อนลงทุนทำแผนที่ (ภาพรวม Elicit เทียบกับ Consensus)
ความผิดพลาดคือการใช้จุดแข็งเหล่านั้นแทนโครงสร้างพื้นฐานของ SEM ตัวสรุปอาจยอดเยี่ยมในบริบทเฉพาะหน้า แต่ยังเป็นระบบบันทึกหลักที่ผิดประเภท ในทางกลับกัน พื้นที่ทำงานแบบคงอยู่สามารถรักษาสมุดรหัสที่ยุ่งเหยิงให้มีชีวิตได้ แต่ก็ยังเป็นเครื่องมือที่ไม่เหมาะกับการคัดกรองแบบสองผู้ตรวจจำนวน 5,000 ระเบียน หากคุณต้องการซอฟต์แวร์ SR เฉพาะทาง คู่มือระดับสถาบันยังแนะนำให้ทีมใช้แพลตฟอร์มคัดกรอง เช่น Rayyan, Covidence และ DistillerSR ในขั้นตอนนั้น (คู่มือ AI-for-SR ของ CASRAI; คู่มือการทบทวนอย่างเป็นระบบของ Stony Brook)
ดังนั้น กฎตัดสินใจที่ใช้ได้กับการทบทวนจริงจึงอิงสถาปัตยกรรม ไม่ใช่แบรนด์ หากผลงานคือชุดการตัดสินใจเข้ารหัสที่เปรียบเทียบได้ อัปเดตได้ และอธิบายได้ ให้เลือกพื้นที่ทำงานวิจัยที่มีความจำโครงการ และวางเอนจินชุดข้อมูลไว้ข้างกัน หากผลงานคือการทำความเข้าใจบทความที่อยู่บนโต๊ะของคุณแล้ว ตัวสรุปบทความรายฉบับไม่ใช่การประนีประนอม แต่เป็นเครื่องมือที่มีขอบเขตเหมาะสม
แหล่งอ้างอิง
- ScienceDirect — แนวทางการจัดทำแผนที่หลักฐานอย่างเป็นระบบ
- PubMed Central — ระเบียบวิธีสำหรับการทบทวนเพื่อทำแผนที่ แผนที่หลักฐาน และแผนที่ช่องว่าง
- Paperguide — 7 เครื่องมือ AI สำหรับการทบทวนวรรณกรรมที่ดีที่สุดในปี 2026
- King’s College London — เครื่องมือ AI ในการสังเคราะห์หลักฐาน
- Elicit — AI สำหรับการวิจัยทางวิทยาศาสตร์
- NotebookLM — เครื่องมือวิจัย AI และคู่คิด
- Google Blog — NotebookLM เพิ่ม Deep Research, DOCX, Sheets และอื่น ๆ
- The Drive AI — Elicit เทียบกับ Consensus เทียบกับ Semantic Scholar
- Omid Saffari — เครื่องมือวิจัย AI ที่ดีที่สุดปี 2026: Elicit เทียบกับ Consensus
- คู่มือการใช้ AI ในการค้นหาและคัดกรองวรรณกรรม
- CASRAI — เครื่องมือ AI สำหรับการทบทวนวรรณกรรมอย่างเป็นระบบ
- ห้องสมุดมหาวิทยาลัย Stony Brook — คู่มือการทบทวนอย่างเป็นระบบ: ปัญญาประดิษฐ์