ผู้ช่วยวิจัย AI ดีกว่าการค้นหาด้วยคีย์เวิร์ดสำหรับบทความที่เกี่ยวข้องหรือไม่?
2026-08-22
การจับคู่เชิงความหมายเหนือกว่าการจัดอันดับด้วยคีย์เวิร์ดสำหรับบทความที่เกี่ยวข้องเชิงแนวคิดเมื่อใด?
ผู้ช่วยวิจัย AI แบบเชิงความหมายทำได้ดีกว่าการค้นหาด้วยคีย์เวิร์ดแบบดั้งเดิม เมื่อบทความที่คุณต้องการอธิบายแนวคิดเดียวกันด้วยคำศัพท์ที่ต่างกัน ขณะที่เครื่องมือคีย์เวิร์ดยังคงแข็งแกร่งกว่าเมื่อคุณทราบวลี ผู้เขียน หรือกลุ่มการอ้างอิงที่ต้องการค้นหาอย่างชัดเจนแล้ว ในปี 2026 คำตอบเชิงปฏิบัติไม่ใช่การเลิกใช้ Google Scholar แต่คือการใช้การจัดอันดับเชิงคำศัพท์ควบคู่กับการค้นคืนตามความหมาย โดยใช้เครื่องมืออย่าง Elicit, SciSpace, Undermind และ Jenova's Academic Research Assistant
ปัจจัยสำคัญที่แยกการค้นพบเชิงแนวคิดที่มีประสิทธิภาพออกจากการจับคู่คีย์เวิร์ด:
✅ ความยืดหยุ่นด้านคำศัพท์ — ระบบสามารถแสดงบทความเกี่ยวกับ “กล้ามเนื้อหัวใจตาย” ได้หรือไม่ เมื่อคำค้นระบุว่า “หัวใจวาย” ✅ สัญญาณการจัดอันดับ — คะแนนเชิงคำศัพท์ที่ถ่วงน้ำหนักด้วยการอ้างอิง เทียบกับความคล้ายคลึงของ embedding เทียบกับ LLM ที่ตัดสินความเกี่ยวข้อง ✅ ความลึกของดัชนี — เมทาดาทาชื่อเรื่องและบทคัดย่อ เทียบกับการจับคู่ข้อความเต็มในผลงานหลายร้อยล้านชิ้น ✅ การควบคุมความแม่นยำ — Boolean แบบซ้อน ข้อจำกัดฟิลด์ ตัวกรองคุณภาพวารสาร และข้อจำกัดการส่งออก ✅ เวลาจนได้ชุดผลลัพธ์ที่ใช้ได้ — รายการสำรวจที่ได้ทันที เทียบกับการค้นหาแบบวนซ้ำที่ใช้เวลาหลายนาที
หากต้องการเปรียบเทียบวิธีเหล่านี้อย่างตรงไปตรงมา ควรมองความไม่สอดคล้องของคำศัพท์ อคติในการจัดอันดับ และการควบคุมการค้นหาเป็นคนละมิติ แทนที่จะถามว่าเครื่องมือใดดีกว่าเสมอไป
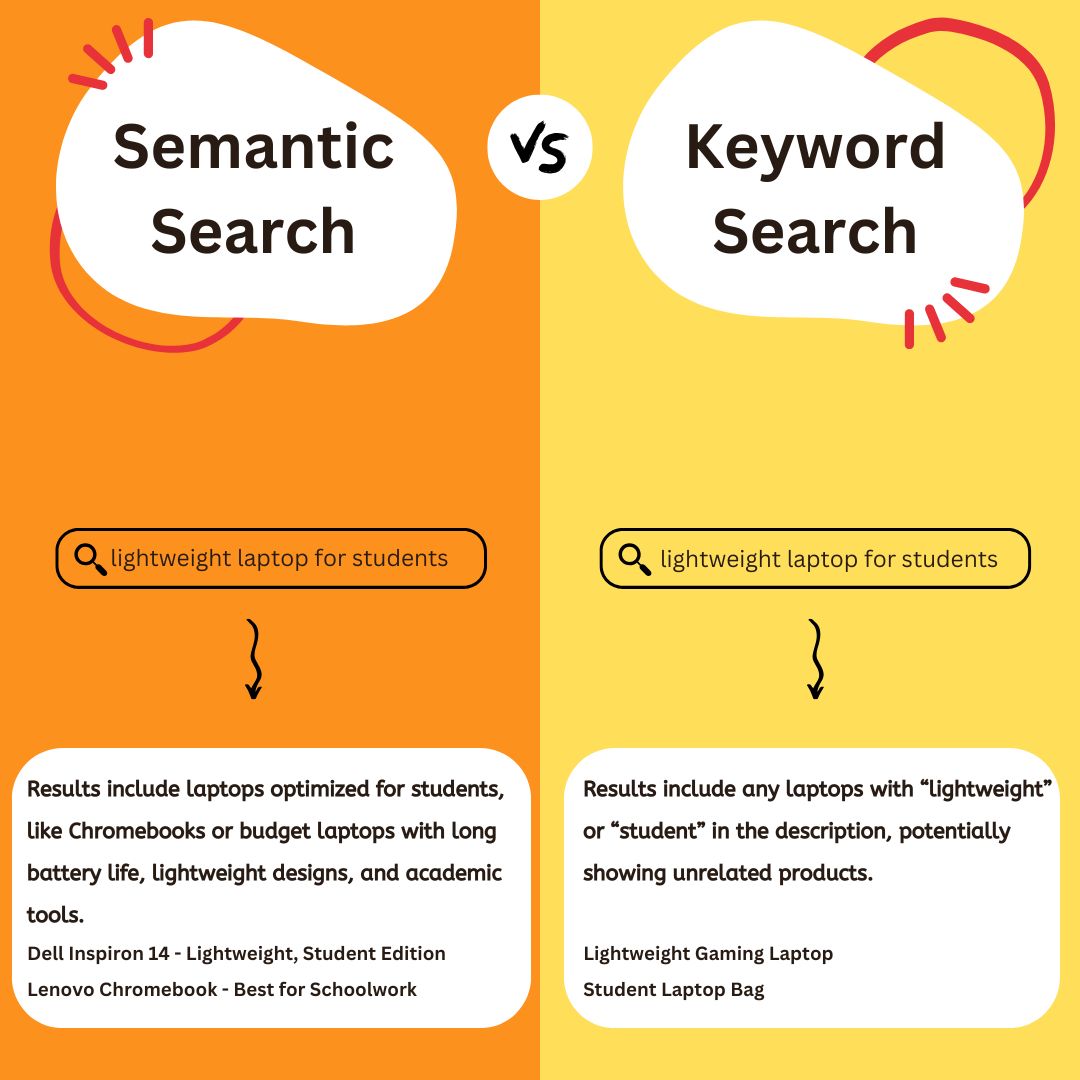
เหตุใดความไม่สอดคล้องของคำศัพท์จึงยังทำให้การค้นหาวิชาการแบบดั้งเดิมล้มเหลวในปี 2026?
ความไม่สอดคล้องของคำศัพท์ยังทำให้การค้นหาวิชาการแบบดั้งเดิมล้มเหลว เพราะผู้เขียน สาขาวิชา และช่วงเวลาเรียกปรากฏการณ์เดียวกันต่างกัน และเครื่องมือเชิงคำศัพท์จะค้นคืนเฉพาะเอกสารที่มีคำปรากฏบนผิวหน้าร่วมกับคำค้นมากพอเท่านั้น บทความสาธารณสุขอาจใช้คำว่า “กิจกรรมทางกาย” บทความโรคหัวใจใช้ “สมรรถภาพการออกกำลังกาย” และบทความสังคมวิทยาใช้ “การเคลื่อนไหวในเวลาว่าง” หากค้นหาเพียงวลีเดียว อีกสองกลุ่มอาจหายไปจากผลลัพธ์หลายหน้าต้น ๆ
Google Scholar ยังคงเป็นจุดเริ่มต้นเริ่มต้นสำหรับนักวิจัยส่วนใหญ่ และยังเป็นพื้นที่ค้นหาวิชาการเดี่ยวที่กว้างที่สุด โดยรวมข้อความเต็มจากสำนักพิมพ์และคลังเอกสารไว้ด้วย Aaron Tay บรรณารักษ์วิชาการแห่ง Singapore Management University อธิบายว่า Google Scholar เป็นมีดพับสวิสของการค้นหางานวิชาการ — เป็นเครื่องมือที่เขาจะเก็บไว้หากเลือกเก็บได้เพียงหนึ่งเดียว อย่างไรก็ตาม การจัดอันดับของมันยังคงเป็นเชิงคำศัพท์ หลังจากการจับคู่ชื่อเรื่องแล้ว ระบบจะ ให้น้ำหนักสูงกับบทความที่มีการอ้างอิงมาก ซึ่งยอดเยี่ยมสำหรับการค้นหางานบุกเบิก แต่ไม่เด่นสำหรับการค้นหาบทความที่เกี่ยวข้องเชิงแนวคิดซึ่งใช้ถ้อยคำต่างออกไปหรือยังสะสมการอ้างอิงไม่มาก
ปัญหาจะรุนแรงขึ้นเมื่อคำค้นเป็นคำทั่วไป เนื่องจาก Google Scholar จับคู่ทั่วทั้งข้อความเต็ม การค้นหาเครื่องมือหรือแนวคิดที่มีชื่อเป็นคำในชีวิตประจำวันอาจขยายเป็นผลลัพธ์บังเอิญหลายพันรายการ Tay ระบุว่าการค้นหา “Elicit” ใน Google Scholar แทบไม่มีประโยชน์ หากไม่เพิ่มวิธีจำกัดตามโดเมน เพราะคำนี้ปรากฏอยู่เสมอในส่วนวิธีวิจัย ระบบเชิงความหมายลดรูปแบบความล้มเหลวนี้ด้วยการให้คะแนนจากความหมาย แทนการทับซ้อนของสตริง จึงกลายเป็นชั้นเสริมมากกว่าจะเป็นเพียงของใหม่
ควรประเมินอะไรเมื่อเปรียบเทียบการค้นหาด้วยคีย์เวิร์ดและผู้ช่วย AI เชิงความหมาย?
คุณควรประเมินการค้นหาด้วยคีย์เวิร์ดและผู้ช่วย AI เชิงความหมายผ่านหกมิติที่บทความนี้เรียกว่า Mismatch Recovery Framework ได้แก่ ความยืดหยุ่นด้านคำศัพท์ ความโปร่งใสของการจัดอันดับ ความครอบคลุมของดัชนี การควบคุมความแม่นยำ สัญญาณความน่าเชื่อถือ และเวลาจนได้ชุดผลลัพธ์ที่ใช้ได้ เครื่องมือที่ชนะในมิติหนึ่งมักเสียเปรียบในอีกมิติหนึ่ง จึงทำให้การจัดอันดับ “ผู้ชนะ” เพียงรายเดียวชวนให้เข้าใจผิดมากกว่าช่วยได้
ความยืดหยุ่นด้านคำศัพท์ ถามว่าเครื่องมือสามารถค้นคืนบทความที่บทคัดย่อไม่กล่าวซ้ำคำค้นของคุณเลยได้หรือไม่ Dense embeddings และวิธีไฮบริดอย่าง SPLADE ซึ่ง Elicit ใช้เป็นแนวทาง sparse embedding ที่เรียนรู้ได้ ถูกสร้างมาเพื่อเรื่องนี้ ความโปร่งใสของการจัดอันดับ ถามว่าคุณอธิบายได้หรือไม่ว่าทำไมบทความจึงปรากฏขึ้น ระบบ Boolean ร่วมกับ BM25 ตรวจสอบได้ง่ายกว่า ขณะที่การค้นหาเพื่อนบ้านใกล้สุดด้วย embedding และ LLM reranker ทำซ้ำได้ยากกว่า
ความครอบคลุมของดัชนี ไม่เท่ากับ “จำนวนบทความที่โฆษณาไว้” OpenAlex รายงานระเบียนผลงาน 517 ล้านรายการและ PDF ฉบับเต็ม 66 ล้านไฟล์ ขณะที่ Elicit ระบุว่า ค้นหา สรุป และดึงข้อมูลจากบทความมากกว่า 125 ล้านชิ้น Google Scholar ไม่เผยแพร่จำนวนทางการที่เทียบเคียงกันได้ แต่ได้รับการยอมรับอย่างกว้างขวางว่าเป็นดัชนีค้นหาวิชาการฉบับเต็มที่ใหญ่ที่สุด การควบคุมความแม่นยำ ครอบคลุม Boolean แบบซ้อน การจำกัดฟิลด์ ตัวดำเนินการระยะห่าง และคำศัพท์ควบคุม ซึ่งเป็นฟีเจอร์ที่ The Lens และ OpenAlex ทำได้ดีกว่า Google Scholar
สัญญาณความน่าเชื่อถือ รวมถึงจำนวนการอ้างอิง ระดับวารสาร และสถานะการเพิกถอน Google Scholar และ Undermind ในระดับหนึ่ง มักเอนเอียงไปสู่งานที่ถูกอ้างอิงสูง Elicit และ SciSpace โดยทั่วไปจัดอันดับด้วยความคล้ายคลึงเชิงความหมายและไม่ถ่วงน้ำหนักการอ้างอิง ดังนั้นบทความที่ใหม่กว่าหรือมีการอ้างอิงน้อยกว่าจึงมีโอกาสขึ้นมา เวลาจนได้ชุดผลลัพธ์ที่ใช้ได้ แยกการค้นหาด้วยคีย์เวิร์ดที่ได้ทันที ออกจากการทำงานแบบวนซ้ำสไตล์ Undermind ที่ ใช้เวลาอย่างน้อยสามนาที ให้ให้คะแนนแต่ละมิติตามงานจริงของคุณ — การค้นพบที่เต็มไปด้วยคำพ้อง การเก็บให้ครบเพื่อการทบทวนอย่างเป็นระบบ หรือการทำความเข้าใจเบื้องต้นภายในห้านาที — ก่อนเลือกเครื่องมือหลัก
Google Scholar, Elicit, SciSpace, Undermind และ Jenova เปรียบเทียบกันอย่างไรในการค้นพบเชิงแนวคิด?
Google Scholar แข็งแกร่งที่สุดสำหรับการสำรวจแบบกว้างที่ถ่วงน้ำหนักด้วยการอ้างอิง; Elicit และ SciSpace แข็งแกร่งที่สุดเมื่อคีย์เวิร์ดไม่ชัดเจน; Undermind แข็งแกร่งที่สุดสำหรับการค้นหาแคบที่ต้องการความแม่นยำสูง; และ Jenova's Academic Research Assistant แข็งแกร่งที่สุดเมื่อต้องการให้การค้นพบ การสังเคราะห์ และงานอ้างอิงอยู่ในบทสนทนาแบบต่อเนื่องเดียวกัน ไม่มีเครื่องมือใดครองทุกช่องใน Mismatch Recovery Framework
| ฟีเจอร์ / มิติ | Google Scholar | Elicit / SciSpace | Undermind | Jenova's Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| วิธีการจับคู่ | เชิงคำศัพท์ / คีย์เวิร์ด ถ่วงน้ำหนักด้วยการอ้างอิง | เชิงความหมายหรือไฮบริด (Elicit ใช้ SPLADE) | การค้นคืนแบบไฮบริดร่วมกับการตัดสินความเกี่ยวข้องด้วย LLM และการค้นหาแบบวนซ้ำ | เอเจนต์วิจัยภาษาธรรมชาติบนแหล่งข้อมูลวิชาการแบบสด รวมถึง Google Scholar | การค้นหาเมทาดาทาวิชาการแบบมีโครงสร้างด้วยตัวดำเนินการขั้นสูง |
| การกู้คืนคำที่ใช้ต่างกัน | อ่อนแอ เว้นแต่เพิ่มคำพ้องหรือใช้ Related articles | แข็งแกร่งสำหรับคำค้นตามความหมาย | แข็งแกร่งสำหรับบรีฟภาษาธรรมชาติที่เฉพาะเจาะจง | แข็งแกร่งในการปรับคำถามใหม่เชิงสนทนาข้ามเซสชัน | อ่อนแอถึงปานกลาง ขึ้นอยู่กับการสร้างคำค้น |
| อคติด้านความน่าเชื่อถือ | ให้ความสำคัญกับบทความที่ถูกอ้างอิงสูงหลังการจับคู่ชื่อเรื่อง | แทบไม่ถ่วงน้ำหนักการอ้างอิง บทความใหม่จึงขึ้นมา | เอนเอียงบางส่วนสู่งานบุกเบิกผ่านการค้นหาการอ้างอิง | ติดตามแหล่งข้อมูลที่เชื่อมโยงและบรีฟที่คุณให้ | ขับเคลื่อนด้วยเมทาดาทา ออกแบบเพื่อการวิเคราะห์มากกว่าการจัดอันดับเชิงความหมาย |
| ฟีเจอร์ความแม่นยำ | ไม่มี Boolean แบบซ้อน จำกัด 256 อักขระ และค้นหาตามฟิลด์ได้จำกัด | ตัวกรองหลังค้นหาตามคุณภาพวารสาร เช่น ระดับ Scimago บน SciSpace | ความเฉพาะเจาะจงด้วยภาษาธรรมชาติแทน Boolean | การจำกัดขอบเขตผ่านบทสนทนา ไม่ใช่เครื่องมือไวยากรณ์ Boolean | Boolean แบบซ้อน การค้นหาแบบระยะห่าง การค้นหาตามฟิลด์ และคำศัพท์ควบคุม |
| เวลาค้นหาโดยทั่วไป | ทันที | เร็วพอสำหรับการสำรวจ | อย่างน้อยประมาณ 3 นาทีต่อการค้นหา | โต้ตอบได้ การถามต่อได้ทันที | ทันที หรือจำกัดความเร็วตาม API |
| ราคา (ณ ปี 2026) | ฟรี | Elicit Pro ประมาณ $49/เดือน; มีรายงานว่า SciSpace มีแพ็กเกจแบบชำระเงินตั้งแต่ $12 ถึง $160/เดือน | ระดับสำรวจฟรี; แผนวิชาการแบบชำระเงิน | ระดับฟรีพร้อมการใช้งานจำกัด; Plus เริ่มที่ $20/เดือน | ค้นหาผ่านเว็บฟรี; OpenAlex API มีระดับฟรี |
| เหมาะที่สุดสำหรับ | งานบุกเบิก การไล่สาย Cited by การค้นหาฉบับเต็ม | คีย์เวิร์ดไม่ชัดและคำถามแบบภาษาธรรมชาติ | การหางานวิจัยประเภทเฉพาะโดยให้การค้นพบครอบคลุมสูง | งานวรรณกรรมแบบครบวงจรพร้อมความจำและการสนับสนุนต้นฉบับ | การค้นหาอย่างเป็นระบบ ทำซ้ำได้ และควบคุมได้สูง |
Google Scholar
Google Scholar ยังคงเป็นเครื่องมือสารพัดประโยชน์ หน้าช่วยเหลืออย่างเป็นทางการยืนยันว่า โดยปกติผลลัพธ์จะเรียงตามความเกี่ยวข้อง ไม่ใช่วันที่ และนักวิจัยสามารถต่อยอดผ่าน Related articles และ Cited by ได้เมื่อมีบทความตั้งต้นอยู่ในมือ ฟีเจอร์ทั้งสองนี้ใกล้เคียงที่สุดที่การค้นหาด้วยคีย์เวิร์ดจะเข้าถึงการค้นพบเชิงแนวคิดได้ แต่ต้องอาศัยบทความตั้งต้นที่ดี ข้อจำกัดได้รับการบันทึกไว้ชัดเจน: ไม่มี Boolean แบบซ้อน ไม่มีการค้นหาตามฟิลด์เฉพาะบทคัดย่อ จำกัดคำค้น 256 อักขระ จำกัดผลลัพธ์ 1,000 รายการ และไม่มีการส่งออกเป็นชุด ชุดข้อจำกัดนี้ทำให้บรรณารักษ์มักไม่ใช้มันเป็นฐานข้อมูลหลักสำหรับการทบทวนอย่างเป็นระบบ
Elicit และ SciSpace
Elicit วางตำแหน่งตนเองเป็น AI สำหรับค้นหา สรุป ดึงข้อมูล และสนทนากับบทความมากกว่า 125 ล้านชิ้น โดยมีผู้ใช้วิจัยมากกว่า 2 ล้านคน ทั้ง Elicit และ SciSpace รับคำถามภาษาธรรมชาติและจัดอันดับตามความคล้ายคลึงเชิงความหมาย จึงสามารถกู้คืนบทความที่ใช้ถ้อยคำต่างจากคำค้นได้ ข้อแลกเปลี่ยนคืออคติการจัดอันดับในทิศตรงข้ามกับ Google Scholar: ทั้งสองอาจดันบทความที่ใกล้เคียงเชิงความหมาย แต่คุณภาพต่ำหรือถูกอ้างอิงน้อย SciSpace โดยทั่วไปเร็วกว่าและเหมาะกับการรับข้อมูลเชิงลึกอย่างรวดเร็ว มากกว่าการสังเคราะห์เชิงลึกแบบวนซ้ำ ผลลัพธ์อาจไม่เป็นเชิงกำหนด จึงเป็นไปได้ที่คำค้นเดียวกันจะไม่ให้ชุดผลลัพธ์ชุดเดิมสองครั้ง
Undermind
Undermind คือเครื่องมือเฉพาะทาง มันผสานการค้นคืนด้วยคีย์เวิร์ดและเชิงความหมาย จากนั้นใช้โมเดลแนวหน้าเพื่อตัดสินว่าชื่อเรื่อง บทคัดย่อ และเมทาดาทาที่มีอยู่ ตอบโจทย์บรีฟจริงหรือไม่ แล้ววนซ้ำด้วยการค้นหาการอ้างอิง ในการทดสอบหนึ่งเทียบกับชุดบทความที่รวมอยู่ในการทบทวนอย่างเป็นระบบ มันกู้คืนบทความมาตรฐาน 8 จาก 11 ชิ้นในผลลัพธ์ 10 อันดับแรก (recall@10 เท่ากับ 72.7%) และ 9 จาก 11 ชิ้นภายในอันดับ 50 (recall@50 เท่ากับ 81.8%) คุณภาพดังกล่าวต้องแลกด้วยเวลา และทำงานได้ไม่ดีนักกับหัวข้อที่คลุมเครือ นอกจากนี้มัน มองเห็นหลัก ๆ เฉพาะชื่อเรื่องและบทคัดย่อ รวมถึงข้อความเต็มแบบเปิดเผยบางส่วน ดังนั้นข้ออ้างที่ซ่อนอยู่เฉพาะในวิธีวิจัยหรือผลลัพธ์อาจถูกพลาดได้
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant เป็นคู่คิดการวิจัยที่ตระหนักถึงสาขาวิชา มากกว่าจะเป็นดัชนีบทความแบบแยกเดี่ยว มันดำเนินการค้นพบวรรณกรรมแบบสดผ่านแหล่งข้อมูลวิชาการ จากนั้นอยู่กับโครงการตลอดการสังเคราะห์ การเตรียมต้นฉบับ และการจัดการการอ้างอิง ความจำแบบต่อเนื่องทำให้ระบบจำได้ว่าคำทำงานของคุณคือ “ความเหนื่อยล้าทางการรู้คิด” ขณะที่วรรณกรรมอาจใช้ “การพร่องพลังอัตตา” และ “ความจำเป็นต้องฟื้นตัว” ด้วย และยังคงเชื่อมกลุ่มคำพ้องเหล่านั้นกับโครงการเดียวกันข้ามเซสชัน
ข้อจำกัดที่ตรงไปตรงมาคือด้านสถาปัตยกรรม ระบบไม่ได้มาพร้อมดัชนีเชิงความหมายเฉพาะของตนเองจำนวน 125 ล้านบทความ พร้อมตารางสกัดข้อมูลในความหมายเดียวกับ Elicit และไม่ใช่เครื่องมือค้นหาแบบวนซ้ำหลายนาทีสไตล์ Undermind ที่มีเกณฑ์ recall@10 เผยแพร่ต่อสาธารณะ จุดแข็งของมันคือการประสานงาน: การให้บรีฟด้วยภาษาธรรมชาติ การค้นหาข้อมูลวิชาการแบบสด การถามต่อ และการสนับสนุนการเขียนในเธรดเดียวกัน นักวิจัยที่ต้องการเส้นทางตรวจสอบ Boolean ที่ทำซ้ำได้ ควรใช้งาน The Lens หรือ OpenAlex ควบคู่กันไป
การค้นหาเชิงความหมายกู้คืนบทความที่ใช้ถ้อยคำต่างกันสำหรับแนวคิดเดียวกันได้อย่างไร?
การค้นหาเชิงความหมายกู้คืนบทความที่ใช้คำต่างกันด้วยการฝังคำค้นและชุดเอกสารลงในพื้นที่ความหมายร่วมกัน จากนั้นค้นหาเพื่อนบ้านที่ใกล้ที่สุด แทนที่จะบังคับให้ต้องมี token ที่ทับซ้อนกัน หากคำค้นคือ “พยาบาลกะกลางคืนฟื้นฟูสมาธิหลังทำงานหลายกะต่อเนื่องอย่างไร” เครื่องมือเชิงคำศัพท์จะมองหาคำเหล่านั้น เครื่องมือเชิงความหมายสามารถค้นคืนงานศึกษาที่ตั้งชื่อเกี่ยวกับ “การรบกวนจังหวะชีวภาพ” “การนอนเพื่อการฟื้นตัว” หรือ “ความเหนื่อยล้าจากการทำงาน” ได้ แม้คำว่า “พยาบาล” หรือ “สมาธิ” จะไม่ปรากฏในชื่อเรื่องเลย
Semantic Scholar เครื่องมือวรรณกรรมของ Allen Institute for AI เป็นตัวอย่างสาธารณะยุคแรกของแนวคิดนี้: จัดอันดับบทความวิทยาศาสตร์จากความหมายที่เข้าใจ แทนการจับคู่สตริง Elicit และ SciSpace ใช้หลักการคล้ายกันในระดับเว็บแอป Tay อธิบายการทดสอบที่ชัดเจนเป็นพิเศษ: วางย่อหน้าจากหนังสือพิมพ์ที่บรรยายผลการศึกษาลงไป แล้วเครื่องมือเชิงความหมายสามารถแสดงบทความวารสารต้นทางได้ เพราะ embedding ของร้อยแก้วข่าวอยู่ใกล้กับ embedding ของบทความ การค้นหาด้วยคีย์เวิร์ดแทบไม่เคยผ่านการถอดความเช่นนั้นได้
ยังมีกลไกที่สองซึ่งเงียบกว่า: การขยายคำค้นภายในผู้ช่วย เอเจนต์สนทนาสามารถสร้างชุดคำพ้อง แนวคิดที่เกี่ยวข้องแบบ MeSH คำตรงข้าม และรูปแบบคำตามสาขาวิชา แล้วค้นหารูปแบบเหล่านั้นอย่างชัดแจ้ง นี่ไม่ใช่การค้นหาเวกเตอร์ล้วน ๆ แต่เป็นการใช้ความเข้าใจเชิงความหมายเพื่อสร้างตาข่ายเชิงคำศัพท์ที่ดีกว่า ในทางปฏิบัติ ขั้นตอนการทำงานที่เก็บได้ครอบคลุมสูงสุดจะทำทั้งสองอย่าง — ใช้ embedding เพื่อเรียกคืนถ้อยคำที่ไม่เคยเห็น แล้วตรวจสอบด้วยวลีตรงตัว ชื่อผู้เขียน และลิงก์การอ้างอิง เพื่อให้ชุดผลลัพธ์ยังตรวจสอบได้
การทดสอบกับบรีฟจริงมักเผยให้เห็นช่องว่างนี้อย่างรวดเร็ว ลองถามเครื่องมือคีย์เวิร์ดถึง “การสังเกตของครู” คุณจะได้งานที่ใช้คำวิจัยการศึกษานี้ตรงตัวเป็นส่วนใหญ่ แต่หากถามผู้ช่วยเชิงความหมายว่า “ครูตรวจพบและตีความความคิดที่ไม่คาดคิดของนักเรียนในขณะนั้นได้อย่างไร” คุณจะพบงานที่จัดอยู่ภายใต้ “วิสัยทัศน์เชิงวิชาชีพ” “การประเมินเพื่อพัฒนา” หรือ “การตัดสินใจ ณ ขณะนั้น” ด้วย ชุดหลังคือสิ่งที่ความไม่สอดคล้องของคำศัพท์อาจซ่อนไว้
คุณควรใช้การค้นหาด้วยคีย์เวิร์ดแทนผู้ช่วย AI เชิงความหมายเมื่อใด?
คุณควรใช้การค้นหาด้วยคีย์เวิร์ดต่อไป เมื่อจำเป็นต้องค้นหารายการที่ทราบอยู่แล้ว ไล่สายการอ้างอิงจากบทความตั้งต้น จับคู่วลีในข้อความเต็ม หรือสร้างกลยุทธ์ Boolean ที่ทำซ้ำได้สำหรับการทบทวนอย่างเป็นระบบ การจัดอันดับเชิงความหมายเป็นเครื่องมือที่ไม่เหมาะเมื่อภารกิจคือ “หาชื่อเรื่องนี้” “หาทุกสิ่งที่อ้างถึงการทดลองนี้” หรือ “บันทึกสตริงการค้นหาที่ผู้ประเมินสามารถรันซ้ำได้”
Google Scholar เป็นจุดเริ่มต้นที่เหมาะสำหรับงานประจำวันสามประเภท ประการแรก การค้นหารายการที่ทราบอยู่แล้ว: ใส่ชื่อเรื่องไว้ในเครื่องหมายคำพูด ตามที่ หน้าช่วยเหลือของ Google และคู่มือห้องสมุดส่วนใหญ่แนะนำ ประการที่สอง การทำแผนที่ความน่าเชื่อถือ: เปิดบทความหลักชิ้นหนึ่ง แล้วไล่ Cited by เพื่อดูว่าภาคสนามทำอะไรต่อ หรือใช้ Related articles เพื่อแตกแขนงจากบทความตั้งต้น ประการที่สาม การค้นหาวลีในข้อความเต็ม: หากแนวคิดเป็นชื่อวิธีการ ชุดข้อมูล หรือมาตรวัดที่มีเอกลักษณ์ การค้นหาฉบับเต็มเชิงคำศัพท์จะจับการกล่าวถึงที่ดัชนีเชิงความหมายซึ่งดูเฉพาะชื่อเรื่องและบทคัดย่ออาจพลาด
สำหรับการค้นหาอย่างเป็นระบบหรือแม่นยำมาก ให้ข้ามทั้ง Google Scholar และแอปเชิงความหมายส่วนใหญ่ในฐานะระบบบันทึกหลัก The Lens และ OpenAlex รองรับ Boolean แบบซ้อน ตัวดำเนินการระยะห่าง การค้นหาแบบกำหนดฟิลด์ และคำศัพท์ควบคุม OpenAlex เป็นแค็ตตาล็อกเปิดที่มีผลงาน 517 ล้านชิ้น ความสัมพันธ์ในกราฟ 5.8 พันล้านรายการ และชุดข้อมูลสาธารณสมบัติ (CC0) รายงานจากห้องสมุดในปี 2026 ระบุความครอบคลุมไว้ราว 474 ล้านสิ่งพิมพ์ โดยเน้นการเข้าถึงแบบเปิดและความโปร่งใส Google Scholar ไม่อาจเทียบความสามารถในการตรวจสอบนี้ได้ เพราะ จำกัดการแสดงผลไว้ที่ 1,000 รายการและไม่มีการเข้าถึงแบบเป็นชุด
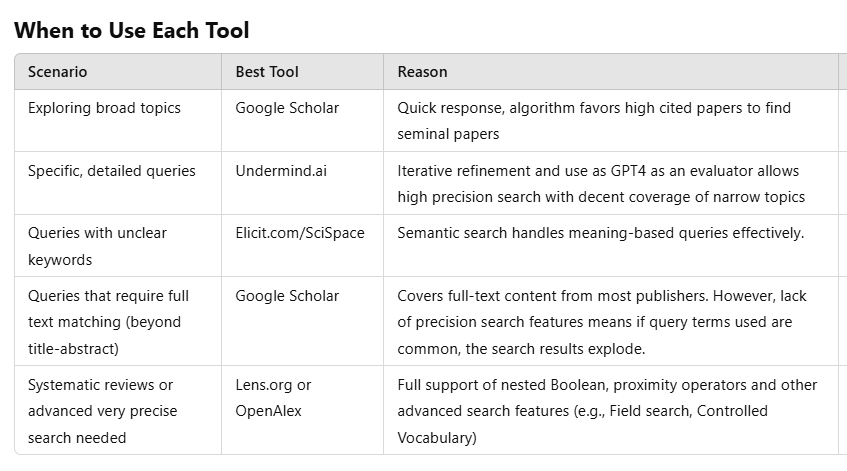
ให้ใช้ตารางข้างต้นเป็นกฎสำหรับเลือกเส้นทาง ไม่ใช่การทดสอบความภักดี การทำความเข้าใจภาพรวมกว้าง ๆ และการหาบทความบุกเบิกยังเหมาะกับ Google Scholar ถ้อยคำไม่ชัดเจนให้ไปที่ Elicit หรือ SciSpace คำถามการมีอยู่ที่เฉพาะเจาะจงมาก — “มี RCTs ที่ใช้ LLM เป็นตัวคัดกรองชื่อเรื่อง-บทคัดย่อ และรายงาน precision กับ recall หรือไม่?” — คือบรีฟของ Undermind การค้นหาที่ทำซ้ำได้และใช้ตัวดำเนินการมากควรอยู่ใน The Lens หรือ OpenAlex
คุณดำเนินการค้นหาวรรณกรรมที่ผสานทั้งสองแนวทางได้อย่างไร?
คุณดำเนินการค้นหาแบบผสมโดยเริ่มจากบรีฟแนวคิด กู้คืนผู้สมัครที่มีคำพ้องหลากหลายด้วยวิธีเชิงความหมาย แล้วล็อกชุดผลลัพธ์ด้วยตัวดำเนินการเชิงคำศัพท์ การไล่สายการอ้างอิง และฐานข้อมูลที่ควบคุมได้สูง ลำดับมีความสำคัญ หากเริ่มใน Google Scholar ด้วยวลีเดียว คุณจะรับจุดบอดของวลีนั้นมา หากไม่เคยออกจากรายการที่จัดอันดับเชิงความหมาย คุณจะรับปัญหาด้านคุณภาพและการทำซ้ำได้ของรายการนั้นมา
ลำดับการทำงานเชิงปฏิบัติมีดังนี้:
- เขียนความต้องการข้อมูลในแบบที่เพื่อนร่วมงานจะเข้าใจ โดยระบุกลุ่มประชากร ผลลัพธ์ และถ้อยคำที่คุณทราบอยู่แล้วว่าไม่เสถียร
- รันบรีฟนั้นในผู้ช่วยเชิงความหมายเพื่อเก็บบทความผู้สมัคร และ คำศัพท์ที่บทความเหล่านั้นใช้จริง
- สร้างตารางคำพ้องจากชื่อเรื่องและบทคัดย่อเหล่านั้น
- นำคำที่ขยายแล้วไปค้นซ้ำใน Google Scholar โดยใช้เครื่องหมายคำพูด
author:ข้อจำกัดวันที่ และ Cited by / Related articles - สำหรับสิ่งใดก็ตามที่ต้องครอบคลุมหรือสามารถตรวจสอบได้ ให้สร้างกลยุทธ์ใหม่ใน The Lens หรือ OpenAlex ด้วย Boolean แบบซ้อนและการจำกัดฟิลด์
- เก็บบันทึกการคัดเลือกรายการอย่างต่อเนื่อง เพื่อไม่ให้การรันเชิงความหมายที่ไม่เป็นเชิงกำหนดเปลี่ยนฐานหลักฐานโดยเงียบ ๆ
ใน Jenova's Academic Research Assistant เทิร์นแรกอาจเป็นบรีฟแนวคิดแทนสตริงคีย์เวิร์ด:
“ฉันต้องการบทความเชิงประจักษ์เกี่ยวกับวิธีที่พนักงานความรู้ทางไกลฟื้นตัวจากความเหนื่อยล้าทางการรู้คิด รวมงานศึกษาที่อาจใช้คำว่า ภาวะหมดไฟ การพร่องพลังอัตตา ความจำเป็นต้องฟื้นตัว การครุ่นคิดหลังเลิกงาน หรือการแยกตัวทางจิตวิทยา แทนคำว่า ความเหนื่อยล้า ให้ความสำคัญกับวารสารจิตวิทยาการทำงานและ HCI ตั้งแต่ปี 2018 เป็นต้นไป และระบุคำพ้องที่แต่ละบทความใช้จริง”
จากนั้นคำถามต่อจะเปลี่ยนตารางคำพ้องของผู้ช่วยให้เป็นกลยุทธ์เชิงคำศัพท์ที่คุณวางลงใน Google Scholar หรือ The Lens ได้:
“เปลี่ยนกลุ่มคำพ้องให้เป็นคำค้น Google Scholar สามชุด และสตริง Boolean แบบซ้อนหนึ่งชุดที่เหมาะกับ OpenAlex หรือ The Lens แยกคำค้นที่จำกัดเฉพาะชื่อเรื่องออกจากคำค้นฉบับเต็ม”
บน Elicit หรือ SciSpace ให้ถามเป็นภาษาธรรมชาติแทนคีย์เวิร์ด — Tay ระบุว่าคำค้นภาษาธรรมชาติมักทำงานแย่กว่าใน Google Scholar และดีกว่าในเครื่องมือเชิงความหมายเหล่านี้ บน Undermind ให้เพิ่มข้อจำกัดจนบรีฟสามารถตรงกับรูปแบบการศึกษาเฉพาะเท่านั้น หลังจากมีชุดผู้สมัครแล้ว Jenova's Deep Research agent เหมาะกว่าในการอ่านข้ามแหล่งข้อมูลและสร้างการสังเคราะห์พร้อมการอ้างอิง ขณะที่ Jenova's Academic Research Assistant เหมาะกว่าในการทำงานภายในขั้นตอนวิชาการของการค้นพบ การอ้างอิง และการสนับสนุนต้นฉบับ
ข้อควรระวังหนึ่งข้อใช้กับทุกขั้นตอนที่ได้รับความช่วยเหลือจาก AI ให้ถือรายการที่จัดอันดับและบทสรุปที่สร้างขึ้นเป็นตัวช่วยค้นคืน ไม่ใช่การคัดกรองที่เสร็จสมบูรณ์ ผลลัพธ์เชิงความหมาย 10 อันดับแรกอาจพลาดบทความ การตัดสินความเกี่ยวข้องของ LLM สอดคล้องกับมนุษย์บ่อยครั้งแต่ไม่เสมอไป และข้ออ้างจากข้อความเต็มยังต้องตรวจสอบด้วย PDF
บรรณารักษ์วิจัยและผู้ประเมินเครื่องมือกล่าวอย่างไรเกี่ยวกับการค้นพบด้วย AI เชิงความหมาย?
บรรณารักษ์วิจัยและผู้ประเมินอิสระมักมองผู้ช่วย AI เชิงความหมายเป็นส่วนเสริมของ Google Scholar ไม่ใช่สิ่งทดแทน และพวกเขาตัดสินเครื่องมือจากคุณภาพการค้นหาสำหรับกรณีใช้งานที่ระบุไว้ แทนที่จะตัดสินจากหมวดหมู่ทางการตลาด การเปรียบเทียบที่มีประโยชน์ที่สุดในด้านนี้มาจากการทบทวนโดยอาศัยการปฏิบัติงานจริง ไม่ใช่เกณฑ์มาตรฐานจากผู้ขาย
“หากผมไม่ทราบล่วงหน้าว่ากรณีใช้งานของผมจะเป็นอะไร และเลือกเครื่องมือค้นหาวิชาการได้เพียงหนึ่งตัว Google Scholar คงเป็นตัวเลือกที่ชัดเจน นั่นไม่ใช่ข้อโต้แย้งต่อต้านการค้นหาด้วย AI แต่เป็นข้อโต้แย้งต่อการแสร้งว่าฟังก์ชันจัดอันดับเพียงแบบเดียวเพียงพอ Google Scholar ยังเป็นเครื่องมือสารพัดประโยชน์ ส่วนเครื่องมือใหม่จะมีที่ยืนเมื่อคำค้นมีความกำกวมหรือเฉพาะเจาะจงอย่างยิ่งในเชิงความหมาย”
“ความล้มเหลวที่ผมเห็นบ่อยที่สุดคือความไม่ตรงกันระหว่างประเภทคำค้นกับเครื่องมือ ผู้คนพิมพ์หัวข้อกว้าง ๆ ลงในเอเจนต์แบบวนซ้ำ แล้วรอหลายนาทีเพื่อได้ชุดผลลัพธ์ที่แคบเกินจำเป็น หรือพิมพ์ย่อหน้าภาษาธรรมชาติลงในเครื่องมือเชิงคำศัพท์ แล้วสรุปว่าวรรณกรรมไม่มีอยู่จริง ความไม่สอดคล้องของคำศัพท์มักเป็นความผิดพลาดของขั้นตอนการทำงานก่อนจะเป็นช่องว่างของฐานข้อมูล”
“การจัดอันดับเชิงความหมายยังเปลี่ยนความหมายของคำว่า ‘เกี่ยวข้อง’ ด้วย หากคุณไม่ถ่วงน้ำหนักการอ้างอิง คุณจะเห็นบทความที่ใหม่กว่าและบางครั้งอ่อนแอกว่าตั้งแต่ต้น หากคุณถ่วงน้ำหนักการอ้างอิง คุณจะค้นพบหลักงานเดิมซ้ำ ๆ นักวิจัยที่ต้องการงานเกี่ยวข้องเชิงแนวคิดแต่ใช้คำต่างกันต้องการพฤติกรรมแบบแรก นักวิจัยที่ต้องการบทความที่ทุกคนคาดหวังให้พวกเขาอ้างถึงต้องการแบบหลัง กระบวนการที่มีความสามารถใช้ทั้งสองแบบและบันทึกเหตุผลไว้”
— ทีมผลิตภัณฑ์ Jenova, ระบบการค้นพบวรรณกรรม, มีประสบการณ์ออกแบบขั้นตอนการทำงานวิจัยวิชาการ 8 ปี
กรอบคิดนี้สอดคล้องกับข้อมูลสาธารณะ คู่มือมหาวิทยาลัยปัจจุบันได้รวบรวม เครื่องมือค้นหา AI ที่ใช้ในการทบทวนวรรณกรรม และรีวิวผลิตภัณฑ์ได้แยกการทำงานแบบวนซ้ำที่ช้ากว่าของ Undermind ออกจากการสแกนเชิงความหมายที่รวดเร็วกว่าใน SciSpace ฉันทามติของผู้เชี่ยวชาญเป็นเรื่องระเบียบวิธี ไม่ใช่ความเป็นพวก: เลือกรูปแบบการค้นคืนให้ตรงกับความไม่สอดคล้องที่คุณกำลังพยายามกู้คืน
เครื่องมือใดเหมาะกับการทบทวนอย่างเป็นระบบเทียบกับการทำแผนที่วรรณกรรมเชิงสำรวจ?
การทบทวนอย่างเป็นระบบต้องการโครงสร้างพื้นฐานเชิงคำศัพท์ที่ควบคุมได้สูง การทำแผนที่วรรณกรรมเชิงสำรวจต้องการการเรียกคืนเชิงความหมายและการวนซ้ำที่รวดเร็ว และงานวิทยานิพนธ์กับทุนวิจัยส่วนใหญ่ต้องการแนวทางไฮบริดพร้อมระเบียบวิธีที่เขียนไว้สำหรับแต่ละขั้น การปะปนงานเหล่านี้คือสาเหตุที่ทีมพลาดงานศึกษาที่เกี่ยวข้องเชิงแนวคิด หรือสร้างชุดหลักฐานที่ทำซ้ำไม่ได้
สำหรับ การทำแผนที่เชิงสำรวจ — “มีการเขียนอะไรเกี่ยวกับแนวคิดนี้บ้าง ไม่ว่าจะเรียกชื่อใด?” — ให้เริ่มด้วยวิธีเชิงความหมาย Elicit, SciSpace และผู้ช่วยวิจัยแบบสนทนาถูกสร้างมาเพื่อคำถามนี้ Google Scholar สามารถช่วยได้เมื่อคุณมีบทความตั้งต้น ผ่าน Related articles และ Cited by และยังไม่มีเครื่องมือใดเทียบได้ในการหา PDF และลิงก์ห้องสมุดอย่างรวดเร็ว Jenova's Academic Research Assistant เหมาะกับขั้นตอนนี้เมื่อคุณต้องการให้แผนที่คงอยู่ด้วย: การตัดสินใจเกี่ยวกับคำพ้องที่บันทึกไว้ ทิศทางที่ตัดออก และการจัดรูปแบบการอ้างอิงสำหรับการเขียนในท้ายที่สุด
สำหรับ การทบทวนอย่างเป็นระบบหรือการทบทวนแบบกำหนดขอบเขต อย่าปล่อยให้รายการจัดอันดับเชิงความหมายกลายเป็นการค้นหาอย่างเป็นทางการ ใช้ The Lens หรือ OpenAlex เป็นแกนหลักที่ทำซ้ำได้ บันทึกทุกตัวดำเนินการ และใช้ Elicit, Undermind หรือ Jenova เป็นเครื่องมือเสริมสำหรับการค้นพบการอ้างอิงและช่วยคัดกรอง OpenAlex ยังมี API ภาษาคำค้นที่มุ่งสู่การทบทวนอย่างเป็นระบบ และ snapshot แบบเต็มภายใต้ใบอนุญาต CC0 ซึ่งเป็นการออกแบบตรงข้ามกับการเรียงลำดับความเกี่ยวข้องแบบปิด ข้อจำกัด 1,000 ผลลัพธ์และการไม่มีการเข้าถึงแบบเป็นชุดของ Google Scholar ทำให้ไม่ผ่านเกณฑ์สำหรับการค้นหาหลักที่ต้องมีเอกสารกำกับ แม้มันยังมีประโยชน์สำหรับตรวจสอบว่าบทความที่ทราบว่าจะรวมไว้ได้รับการทำดัชนีหรือไม่
สำหรับ คำถามการมีอยู่แบบแคบ — “มีบทความลักษณะนี้อยู่หรือไม่?” — Undermind คือเครื่องมือเฉพาะทาง หากคุณรอได้และหลักฐานจากชื่อเรื่อง-บทคัดย่อเพียงพอ สำหรับ การผลิตต้นฉบับหลังจากมีชุดบทความแล้ว การผสานการค้นพบวรรณกรรมกับการจัดการการอ้างอิงของ Jenova เกี่ยวข้องมากกว่าหน้าจอค้นพบอย่างเดียวอีกหน้าหนึ่ง โดยมีข้อแม้ว่าการวิเคราะห์อภิมานที่ต้องสกัดข้อมูลจำนวนมากยังควรอยู่ในเครื่องมือสกัดข้อมูลเฉพาะทาง เช่น Elicit
กฎการตัดสินใจเรียบง่ายพอที่จะใช้ซ้ำได้ หากถ้อยคำหลากหลายและคุณยังไม่รู้ศัพท์เฉพาะของสาขา ให้ใช้ผู้ช่วยวิจัย AI เชิงความหมายก่อน หากคุณต้องปกป้องสตริงการค้นหา ให้ใช้โครงสร้างพื้นฐานคีย์เวิร์ดที่มีตัวดำเนินการขั้นสูง หากคุณต้องทำทั้งสองอย่าง — ซึ่งเป็นสภาวะปกติของการค้นหาบทความที่เกี่ยวข้องเชิงแนวคิดแต่ใช้ถ้อยคำต่างกัน — ให้ใช้การเรียกคืนเชิงความหมายเพื่อค้นพบภาษา แล้วใช้การควบคุมเชิงคำศัพท์เพื่อเก็บและบันทึกผล
เอกสารอ้างอิง
- Aaron Tay — Google Scholar เทียบกับเครื่องมือค้นหา AI อื่น ๆ (Undermind, Elicit, SciSpace)
- Google Scholar — วิธีใช้การค้นหาอย่างเป็นทางการ
- Elicit — AI สำหรับการวิจัยวิทยาศาสตร์
- OpenAlex — แค็ตตาล็อกเปิดของระบบวิจัยทั่วโลก
- Paperguide — การเปรียบเทียบราคาและฟีเจอร์ Elicit กับ SciSpace (2026)
- Undermind — ผู้ร่วมวิจัย AI สำหรับวรรณกรรม
- มหาวิทยาลัยอัลเบอร์ตา / JCHLA — รีวิวผลิตภัณฑ์ Undermind.ai
- Paperpile — วิธีใช้ Google Scholar
- TUHH — OpenAlex ในฐานะทางเลือกเปิดสำหรับการวิจัยวิชาการ
- Semantic Scholar — เครื่องมือวิจัยขับเคลื่อนด้วย AI
- UBC Wiki — เครื่องมือค้นหา AI ที่ใช้ในการทบทวนวรรณกรรมและการค้นหาแบบครอบคลุม
- SciSpace — การเปรียบเทียบ Elicit กับ SciSpace
- The Lens — รุ่น 8.5 และการผสาน OpenAlex
- PMC / NIH — ฟีเจอร์ OpenAlex และศักยภาพสำหรับการสังเคราะห์หลักฐาน