แบ็กเอนด์ AI เอเจนต์: API เดียวเทียบกับการสร้างเองตั้งแต่ต้น (กรกฎาคม 2026)
2026-07-24
ทุกทีมวิศวกรรมที่ส่งมอบฟีเจอร์ AI ในปี 2026 ต้องเผชิญทางเลือกเดียวกัน: สร้างแบ็กเอนด์เอเจนต์เองตั้งแต่ต้น หรือเชื่อมต่อใช้งานระบบที่มีอยู่แล้ว การสร้างเองหมายถึงการนำ model API, เฟรมเวิร์กการประสานงาน, ฐานข้อมูลเวกเตอร์, ที่เก็บหน่วยความจำ และเซิร์ฟเวอร์เครื่องมือมาต่อเข้าด้วยกัน — เป็นสแตกที่ใช้เวลาวิศวกรรมหลายไตรมาสก่อนจะเกิดการโต้ตอบกับผู้ใช้ครั้งแรก Jenova Agent API คือทางเลือก: แบ็กเอนด์เอเจนต์ที่มีการจัดการครบวงจร ซึ่งการประสานงาน หน่วยความจำ พื้นที่เก็บข้อมูล RAG และเครื่องมือทั้งหมดทำงานผ่านการเชื่อมต่อเพียงครั้งเดียว
- ✅ แทนที่สแตกเอเจนต์แบบ DIY ทั้งหมด — การกำหนดเส้นทางโมเดล การประสานงาน หน่วยความจำ RAG และเครื่องมือ — ด้วย API เดียว
- ✅ สร้างและเปิดตัวเอเจนต์แบบกำหนดเองระดับพร้อมใช้งานจริง ตามคำสั่ง โมเดล ฐานความรู้ และเครื่องมือของคุณ
- ✅ เข้าถึงโมเดลจาก OpenAI, Anthropic, Google, xAI, Qwen และอื่น ๆ ผ่านข้อมูลรับรองเพียงชุดเดียว
- ✅ ทำงานบนโครงสร้างพื้นฐานที่ผ่านการทดสอบในสภาพแวดล้อมจริงกับผู้ใช้มากกว่า 30,000 รายในกว่า 70 ประเทศ
หากต้องการตัดสินใจระหว่างการสร้างเองกับการเชื่อมต่อใช้งานอย่างตรงไปตรงมา คุณต้องเห็นตัวเลขจริง — ว่าแบ็กเอนด์เอเจนต์ที่สร้างเองตั้งแต่ต้นมีต้นทุนในการสร้าง ใช้งาน และบำรุงรักษาในปี 2026 เท่าใด
คำตอบแบบรวดเร็ว: แบ็กเอนด์ AI เอเจนต์คืออะไร?
แบ็กเอนด์ AI เอเจนต์คือชั้นโครงสร้างพื้นฐานที่ทำให้เอเจนต์ทำงานได้จริงในสภาพแวดล้อมการใช้งานจริง: การประสานงานระหว่างโมเดลและเครื่องมือ หน่วยความจำและบริบทแบบคงอยู่ การค้นคืนจากข้อมูลส่วนตัว และระบบคอมพิวต์ การปรับขนาด และความน่าเชื่อถือที่อยู่เบื้องหลัง การสร้างจากต้นหมายถึงคุณต้องดูแลระบบแยกกันอย่างน้อยห้าระบบ ขณะที่ managed agent API ส่งมอบทั้งหมดผ่านการเชื่อมต่อเดียว
ความสามารถหลักของแบ็กเอนด์เอเจนต์แบบมีการจัดการ:
- การประสานงานเอเจนต์ที่ทำให้โมเดล เครื่องมือ หน่วยความจำ และการค้นคืนทำงานร่วมกันในเวิร์กโฟลว์หลายขั้นตอน
- การกำหนดเส้นทางหลายโมเดลข้ามผู้ให้บริการ — ไม่มีการผูกติดกับผู้ให้บริการ และไม่ต้องจัดการคีย์แยกตามผู้ให้บริการ
- หน่วยความจำและบริบทการสนทนาแบบไม่จำกัดที่มาพร้อมทุกเซสชัน
- พื้นที่เก็บข้อมูลเชิงสัมพันธ์และเวกเตอร์แบบมีการจัดการครบวงจร พร้อม RAG ในตัว
- การเชื่อมต่อเครื่องมือผ่านเครื่องมือดั้งเดิมของแพลตฟอร์มและ remote MCP server ใดก็ได้
ปัญหา: การสร้างเองตั้งแต่ต้นมีต้นทุนจริงเท่าไร
แรงกดดันของตลาดให้เปิดตัวเอเจนต์นั้นสูงมาก ซอฟต์แวร์องค์กรกำลังมุ่งสู่การมี agentic AI อยู่ใน 33% ของแอปพลิเคชัน — เพิ่มจากไม่ถึง 1% ในปี 2024 (Datagrid) — และผู้บริหารระดับ C-suite 67% คาดว่า AI เอเจนต์จะทำงานอย่างอิสระภายในองค์กรของตนภายในปี 2027 (VAST Data)
แต่การสร้างแบ็กเอนด์เพื่อรองรับเอเจนต์หนึ่งตัวนั้นมีค่าใช้จ่ายสูงและใช้เวลามาก:
- ตรรกะการประสานงาน ที่กลายเป็นศาสตร์วิศวกรรมอีกแขนงหนึ่ง
- model API แบบไร้สถานะ ที่ไม่มีหน่วยความจำระหว่างการเรียกใช้
- ไปป์ไลน์ RAG ที่มีรูปแบบความล้มเหลวเกิดซ้ำซึ่งมีการบันทึกไว้
- โครงสร้างการเชื่อมต่อเครื่องมือ สำหรับทุกความสามารถภายนอก
- โครงสร้างพื้นฐานสำหรับใช้งานจริง ที่ต้องปรับขนาดได้ มีความน่าเชื่อถือ และผ่านการตรวจสอบด้านความปลอดภัย
- ต้นทุนรวมในปีแรก ที่สูงกว่าประมาณการของทุกต้นแบบอย่างมาก
งบประมาณจริง: การเรียกใช้โมเดลเป็นเพียง 2% ของเรื่องทั้งหมด
เดโมเอเจนต์ที่มีค่าใช้จ่าย “$100/เดือน” ซ่อนโครงสร้างต้นทุนที่แท้จริงไว้ การวิเคราะห์เชิงวิศวกรรมโดยละเอียดประเมินว่าต้นทุนปีแรกที่สมจริงของเอเจนต์สำหรับใช้งานจริงขนาดเล็กถึงกลางหนึ่งตัวอยู่ที่ **$270,000–$690,000** — โดยการเรียก model API คิดเป็นเพียงราว 2% ของต้นทุนรวม (Particle41)
ส่วนที่เหลือไปอยู่ในจุดที่ไม่มีใครแสดงในวิดีโอเดโม:
$30,000–$80,000 — สำหรับ prompt engineering และการปรับปรุงในช่วงเริ่มต้นเพียงอย่างเดียว ใช้เวลาวิศวกรรม 200–400 ชั่วโมงที่คิดราคา $150–200/ชั่วโมง (Particle41)
$1,000–$5,000/เดือน — สำหรับโฮสติ้งฐานข้อมูลเวกเตอร์ บวกอีก $1,000–$2,000/เดือนสำหรับการสร้าง embedding (Particle41)
$30,000–$60,000 — สำหรับงานวิศวกรรมการเชื่อมต่อข้อมูลเพื่อเชื่อมเอเจนต์เข้ากับระบบเดิมเพียง 4–5 ระบบ (Particle41)
$6,000–$10,000/เดือนต่อ FTE — สำหรับการกำกับดูแลโดยมนุษย์เพื่อตรวจสอบความล้มเหลว เพราะแม้เอเจนต์ที่แม่นยำ 95% และรองรับการโต้ตอบ 10,000 ครั้งต่อเดือน ก็ยังสร้างกรณี 500 กรณีที่ต้องตรวจสอบด้วยตนเอง (Particle41)
และต้นทุนไม่ได้จบลงเมื่อเปิดตัว: ปีที่สองยังมีค่าใช้จ่าย $150,000–$300,000 ต่อปีสำหรับการดำเนินงานและการปรับปรุง (Particle41) แม้แต่ประมาณการที่แคบกว่าเฉพาะการพัฒนาก็อยู่ที่ $20,000–$60,000 สำหรับเอเจนต์งานง่าย ๆ (Biz4Group) และ $10,000–$400,000+ สำหรับระบบหลายเอเจนต์ (Azilen)
การประสานงานกลายเป็นผลิตภัณฑ์ในตัวเอง
เอเจนต์ที่ใช้งานจริงไม่ได้ตอบเพียงครั้งเดียว — มันวางแผน เรียกใช้เครื่องมือ ค้นคืนบริบท ประเมินผลลัพธ์ระหว่างทาง และกู้คืนจากข้อผิดพลาดตลอดการทำงานหลายขั้นตอน การสร้างวงจรประสานงานนี้หมายถึง state machine ตรรกะการลองใหม่ การจัดการ timeout และขอบเขตควบคุมค่าใช้จ่าย ซึ่งไม่มีสิ่งใดเกี่ยวข้องกับผลิตภัณฑ์จริงของคุณโดยตรง
ผู้ปฏิบัติงานอธิบายช่องว่างนี้อย่างตรงไปตรงมา: การสร้างเอเจนต์ใช้เวลาเพียงไม่กี่วัน — แต่การทำให้พร้อมใช้งานจริงใช้เวลาหกเดือน โดยลูปที่ไม่มีการป้องกันทำให้ค่า API พุ่งสูง และสถานะที่สูญหายทำให้งานที่ทำงานระยะยาวล้มเหลว (
) เฟรมเวิร์กอย่าง LangGraph และ CrewAI มี abstraction สำหรับชั้นนี้ (Speakeasy) แต่ abstraction ไม่ได้ทำงานเอง: คุณยังต้องโฮสต์ ปรับขนาด รักษาความปลอดภัย และบำรุงรักษาทุกสิ่งที่อยู่ข้างใต้ไปป์ไลน์ RAG คือภาระผูกพันถาวร ไม่ใช่โครงการครั้งเดียว
การทำให้เอเจนต์อ้างอิงข้อมูลส่วนตัวของคุณ หมายถึงคุณต้องดูแลการนำเข้าข้อมูล การแบ่งส่วน การสร้าง embedding การทำดัชนี การจัดอันดับใหม่ และการสังเคราะห์คำตอบ — และผู้ปฏิบัติงานเตือนอย่างสม่ำเสมอว่าไปป์ไลน์ RAG “ไม่เพียงยากกว่าที่เห็น แต่ยังต้องอาศัยความเชี่ยวชาญอย่างต่อเนื่องใน LLMs, retrieval และ MLOps เฉพาะทาง” (Vectara)
กรณีศึกษาที่มีการบันทึกไว้กรณีหนึ่ง: โครงการ RAG ภายในที่ “เรียบง่าย” ซึ่งเริ่มในเดือนมกราคม ภายในเดือนมีนาคมได้ใช้วิศวกรเต็มเวลาหนึ่งคนแก้ปัญหา hallucination วิศวกรข้อมูลเต็มเวลาหนึ่งคนรับมือปัญหาการนำเข้าข้อมูล และวิศวกร DevOps หนึ่งคนต่อสู้กับโครงสร้างพื้นฐาน — พร้อมงบประมาณที่เพิ่มเป็นสามเท่า (Towards AI) บทความเดียวกันยังบันทึกวงจรชีวิตแปดสัปดาห์โดยทั่วไป: ปัญหา latency กรณีขอบ การเขียนใหม่ทั้งหมด ปัญหา hallucination ชุดใหม่ การย้าย vector DB และการเขียนใหม่อีกครั้ง
โครงสร้างพื้นฐานเดิมไม่ได้ถูกสร้างมาเพื่อเอเจนต์
ภาระงานของเอเจนต์ต้องการการเข้าถึงข้อมูลแบบต่อเนื่องและเรียลไทม์ — และโครงสร้างพื้นฐานข้อมูลเดิมที่สร้างขึ้นสำหรับงานธุรกรรม “ไม่สามารถรองรับการให้เหตุผลและการดำเนินการอย่างต่อเนื่องที่ AI เอเจนต์อัตโนมัติต้องการได้” (VAST Data) โครงสร้างพื้นฐานเอเจนต์ระดับองค์กรต้องการรากฐานข้อมูลแบบรวม พื้นที่จัดเก็บประสิทธิภาพสูง การทำเวกเตอร์แบบเรียลไทม์ การประสานงานอัจฉริยะ และการกำกับดูแลแบบ zero-trust — ห้าชั้นความสามารถที่แตกต่างกันก่อนที่คุณจะเขียนตรรกะผลิตภัณฑ์แม้แต่บรรทัดเดียว
40% — สัดส่วนโครงการ agentic AI ที่ล้มเหลวเพราะรากฐานโครงสร้างพื้นฐานไม่เพียงพอ (Landbase)
นี่คือปัญหาที่ Jenova Agent API ถูกสร้างขึ้นมาเพื่อขจัดโดยตรง
โซลูชัน: Jenova Agent API
Jenova Agent API คือบริการโครงสร้างพื้นฐานเอเจนต์แบบมีการจัดการครบวงจร: การเชื่อมต่อเดียวที่แทนที่สแตกแบบ DIY ซึ่งประกอบด้วย model API เฟรมเวิร์กการประสานงาน ฐานข้อมูลเวกเตอร์ ที่เก็บหน่วยความจำ และเซิร์ฟเวอร์เครื่องมือ คุณกำหนดคำสั่งของเอเจนต์ เลือกโมเดล อัปโหลดฐานความรู้ และกำหนดค่าเครื่องมือ — API จะจัดการการประสานงาน หน่วยความจำ พื้นที่เก็บข้อมูล และการปรับขนาด เพื่อให้คุณเปิดตัวเอเจนต์แบบกำหนดเองระดับพร้อมใช้งานจริงได้ภายในไม่กี่วันแทนที่จะเป็นหลายไตรมาส
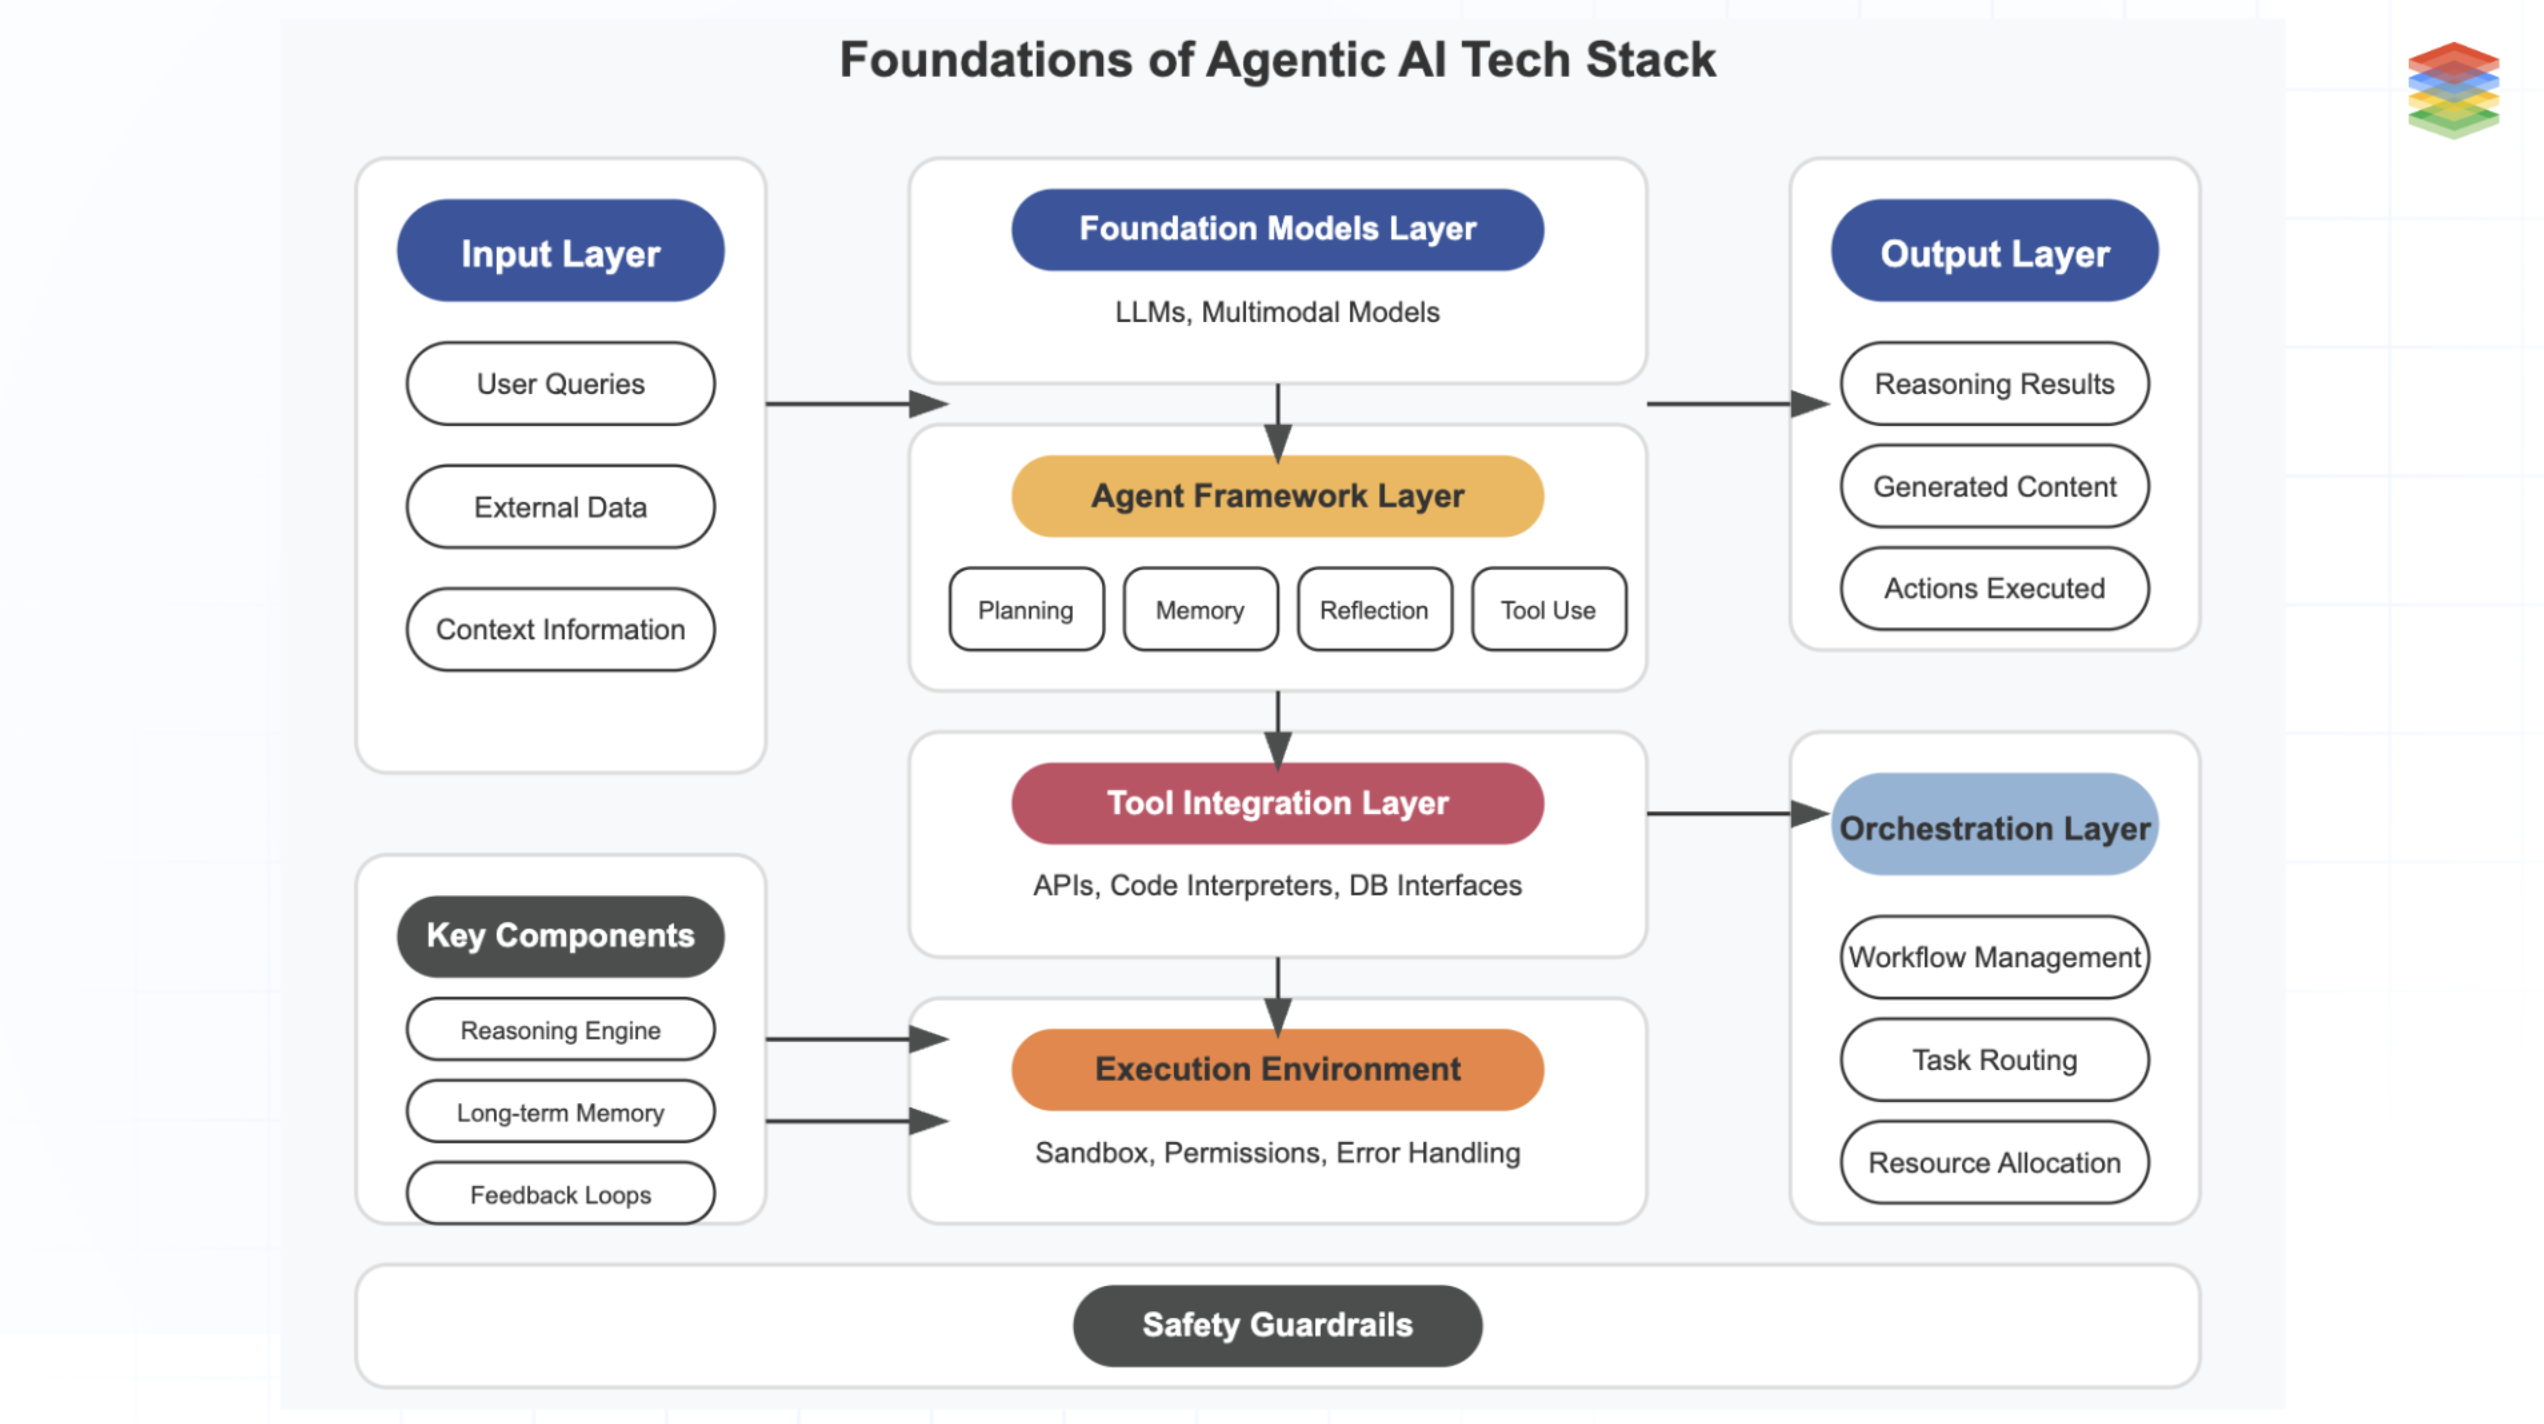
ทุกชั้นในแผนภาพข้างต้น — การวางแผน หน่วยความจำ การสะท้อนผล และการใช้เครื่องมือของเฟรมเวิร์กเอเจนต์; API และอินเทอร์เฟซฐานข้อมูลของชั้นการเชื่อมต่อเครื่องมือ; sandboxing และการจัดการข้อผิดพลาดของสภาพแวดล้อมการทำงาน; การจัดการเวิร์กโฟลว์และการกำหนดเส้นทางงานของชั้นการประสานงาน — ล้วนเป็นโครงสร้างพื้นฐานที่เส้นทาง DIY ทำให้คุณต้องสร้างเอง Jenova Agent API ทำงานทั้งหมดนี้ให้คุณ
| แบ็กเอนด์เอเจนต์แบบ DIY | Jenova Agent API |
|---|---|
| กราฟการประสานงานแบบกำหนดเอง ตรรกะการลองใหม่ schema สถานะ | การประสานงานที่ผ่านการทดสอบอย่างหนัก ซึ่งประสานโมเดล เครื่องมือ หน่วยความจำ และการค้นคืน |
| SDK, คีย์ และขีดจำกัดอัตราแยกตามผู้ให้บริการโมเดล | โมเดลหลักทุกค่ายผ่านการเชื่อมต่อเดียว — ไม่มีการผูกติดกับผู้ให้บริการ |
| สถานะเซสชันใน Redis/Postgres พร้อมการทำ serialization แบบกำหนดเอง | หน่วยความจำและบริบทแบบไม่จำกัดที่มาพร้อมทุกเซสชัน |
| ฐานข้อมูลเวกเตอร์ที่ต้องจัดเตรียม ไปป์ไลน์การแบ่งส่วนและ embedding ($1,000–$5,000/เดือน) | พื้นที่เก็บข้อมูลเชิงสัมพันธ์และเวกเตอร์แบบมีการจัดการครบวงจร พร้อม RAG ในตัว |
| wrapper เครื่องมือที่เขียนเอง โฟลว์ auth และ boilerplate สำหรับข้อผิดพลาด | เครื่องมือดั้งเดิมของแพลตฟอร์ม พร้อม remote MCP server ใดก็ได้ ใช้งานได้ทันที |
| เซิร์ฟเวอร์ คอนเทนเนอร์ นโยบายการปรับขนาด การตรวจสอบ uptime | โครงสร้างพื้นฐานแบบมีการจัดการระดับพร้อมใช้งานจริง พร้อม API ที่เสถียร |
การประสานงานเอเจนต์
การให้เหตุผลหลายขั้นตอน การเรียกใช้เครื่องมือ การค้นคืน และการสังเคราะห์คำตอบทำงานภายในแพลตฟอร์ม — ไม่ต้องสร้างหรือบำรุงรักษาคำนิยามกราฟ schema สถานะ หรือ workflow DAG คุณกำหนดว่าเอเจนต์ควรบรรลุ อะไร; โครงสร้างพื้นฐานจะกำหนด อย่างไร ด้วยการทำงานที่มีขอบเขตและควบคุมได้ตามที่ความน่าเชื่อถือระดับพร้อมใช้งานจริงต้องการ
ใช้โมเดลใดก็ได้
ขับเคลื่อนเอเจนต์ด้วยโมเดลจาก OpenAI, Anthropic, Google, xAI, Qwen และอื่น ๆ ผ่านข้อมูลรับรองเพียงชุดเดียว ใช้โมเดลระดับแนวหน้าสำหรับการให้เหตุผลซับซ้อน และใช้โมเดลที่คุ้มค่าสำหรับเซสชันปริมาณสูง — สลับได้อย่างอิสระในแต่ละเอเจนต์ โดยไม่ต้องจัดการคีย์แยกตามผู้ให้บริการ และไม่ต้องย้ายระบบเมื่อมีโมเดลรุ่นใหม่ออกมา ชั้นหน่วยความจำและความรู้ของคุณยังคงอยู่ตลอดทุกการสลับ
หน่วยความจำและบริบท
หน่วยความจำและบริบทการสนทนาแบบไม่จำกัดมาพร้อมในทุกเซสชัน ส่งตัวระบุเซสชันที่สอดคล้องกัน แล้วเอเจนต์ของคุณจะจดจำประวัติ ความชอบ และโครงการระยะยาวของผู้ใช้แต่ละคนได้ — ไม่ต้องใช้ที่เก็บสถานะภายนอก ไม่ต้องมีโค้ด serialization และไม่ต้องทำวิศวกรรม context window ชั้นที่มีโอกาสล้มเหลวมากที่สุดของสแตก DIY จึงไม่มีอยู่สำหรับคุณอีกต่อไป
พื้นที่เก็บข้อมูลแบบมีการจัดการครบวงจร
ฐานข้อมูลเชิงสัมพันธ์และเวกเตอร์แบบมีการจัดการ พร้อม RAG ในตัว อัปโหลดเอกสารและฐานความรู้ แล้วแพลตฟอร์มจะจัดการการแบ่งส่วน การสร้าง embedding การทำดัชนี และการค้นคืน ไม่มีฐานข้อมูลเวกเตอร์ที่ต้องจัดเตรียม ปรับแต่ง หรือปรับขนาด — รายการค่าใช้จ่าย $1,000–$5,000/เดือน และวิศวกรที่ต้องดูแลมันจะหายไป
เครื่องมือและ MCP
การเชื่อมต่อเครื่องมือแบบไม่จำกัดด้วยเครื่องมือดั้งเดิมของแพลตฟอร์มและ remote MCP server ใดก็ได้ พร้อมใช้งานทันที — การค้นหา อีเมล ปฏิทิน เอกสาร และ API ภายในของคุณเอง ไม่ต้องมีโค้ด wrapper ไม่ต้องวางโครงสร้างโฟลว์ auth และไม่ต้องบำรุงรักษา boilerplate เมื่อ API ของบุคคลที่สามเปลี่ยนแปลง
ระดับพร้อมใช้งานจริง
โครงสร้างพื้นฐานแบบมีการจัดการครบวงจรพร้อม API ที่เสถียร สร้างมาเพื่อทราฟฟิกระดับใช้งานจริง — คุณไม่ต้องจัดการเซิร์ฟเวอร์ คอนเทนเนอร์ หรือนโยบายการปรับขนาด แพลตฟอร์มผ่านการทดสอบในสภาพแวดล้อมจริงกับผู้ใช้มากกว่า 30,000 รายในกว่า 70 ประเทศ ดังนั้นเอเจนต์ของคุณจึงได้รับความน่าเชื่อถือที่ทีมของคุณไม่ต้องสร้างเอง
การเรียกใช้เพียงครั้งเดียวจะทำงานเอเจนต์ครบวงจร:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
การประสานงาน หน่วยความจำ การค้นคืน และการเรียกใช้เครื่องมือทั้งหมดทำงานภายใน request นั้น แอปพลิเคชันของคุณแสดงผลลัพธ์ ส่วนแพลตฟอร์มดูแลทุกอย่างที่อยู่เบื้องหลัง
สิ่งที่คุณสามารถสร้างได้
API นี้ออกแบบมาสำหรับนักพัฒนาที่ส่งมอบเอเจนต์แบบกำหนดเองและมีสถานะเป็นฟีเจอร์ภายในผลิตภัณฑ์ของตนเอง แต่ละตัวอย่างต่อไปนี้คือแอปพลิเคชันที่คุณสามารถสร้างและเปิดตัวได้ — กำหนดคำสั่งและฐานความรู้ของเอเจนต์ แล้ว API จะจัดการการประสานงาน หน่วยความจำ และการปรับขนาด
เอเจนต์ฝ่ายสนับสนุนที่เรียนรู้ผลิตภัณฑ์ของคุณ
สร้างเอเจนต์ฝ่ายสนับสนุนที่อ้างอิงศูนย์ช่วยเหลือ changelog และประวัติ ticket ของคุณ หน่วยความจำเซสชันติดตามเส้นทางการขอความช่วยเหลือทั้งหมดของลูกค้าแต่ละรายตลอดทุกการโต้ตอบ — ไม่มีคำถามว่า “กรุณาบอกหมายเลขบัญชีของคุณอีกครั้งได้ไหม?”
- การทำดัชนีและค้นคืนเอกสารมีการจัดการแบบครบวงจร
- ระบบ ticketing และ CRM เชื่อมต่อผ่าน MCP
- เปิดตัวได้ในไม่กี่วัน แทนการใช้เวลาหนึ่งไตรมาสกับการจัดการสถานะ
นักวิเคราะห์การเงินแบบฝังในผลิตภัณฑ์
เปิดตัวที่ปรึกษาพอร์ตโฟลิโอภายในแดชบอร์ด fintech ของคุณ ซึ่งจดจำการถือครอง ระดับการยอมรับความเสี่ยง และเป้าหมายของลูกค้าแต่ละรายตลอดการสนทนาหลายเดือน
- บริบทการให้คำปรึกษาระยะยาวได้รับการดูแลโดยอัตโนมัติ
- ข้อมูลตลาดและระบบบัญชีเชื่อมต่อผ่าน MCP
- สลับโมเดลตามความซับซ้อนของคำถามเพื่อเพิ่มประสิทธิภาพต้นทุน
ติวเตอร์เฉพาะบุคคลสำหรับแพลตฟอร์มการเรียนรู้ของคุณ
นำติวเตอร์ที่ปรับตัวได้ไปใช้งาน ซึ่งติดตามความก้าวหน้า จุดอ่อน และความชอบของนักเรียนแต่ละคนข้ามเซสชัน โดยอ้างอิงหลักสูตรของคุณ
- หน่วยความจำรายนักเรียนโดยไม่ต้องจัดการแถวฐานข้อมูลแยกตามผู้ใช้
- การอัปเดตหลักสูตรใช้งานได้ทันทีเมื่ออัปโหลด โดยไม่ต้องทำวิศวกรรมการค้นคืนใหม่
- ปรับขนาดเพื่อรองรับผู้เรียนพร้อมกันหลายพันคนบนโครงสร้างพื้นฐานแบบมีการจัดการ
ผู้ช่วยการค้าที่รู้จักแค็ตตาล็อกของคุณ
ฝังผู้ช่วยชอปปิงแบบสนทนาที่รู้จักแค็ตตาล็อกของคุณ จดจำความชอบและประวัติการซื้อของผู้ซื้อแต่ละคน และช่วยค้นพบสินค้าผ่านบทสนทนาแทนฟิลเตอร์
- แค็ตตาล็อกอ้างอิงผ่าน RAG แบบมีการจัดการ — การอัปเดตใช้งานได้ทันที
- หน่วยความจำความชอบรายผู้ซื้อโดยไม่ต้องใช้ที่เก็บสถานะภายนอก
- การทำงานพร้อมกันระดับพร้อมใช้งานจริงสำหรับทราฟฟิกช่วงพีก
เอเจนต์ปฏิบัติการภายในสำหรับทีมของคุณเอง
สร้างเอเจนต์ปฏิบัติการที่เชื่อมต่อกับเอกสารภายใน ระบบ ticketing และระบบข้อมูลของคุณ — ตอบคำถามพนักงานและดำเนินเวิร์กโฟลว์ตามปกติด้วยบริบทขององค์กรครบถ้วน
- ฐานความรู้ส่วนตัวได้รับการทำดัชนีโดยอัตโนมัติ
- API ภายในเชื่อมต่อผ่าน remote MCP server
- ความสามารถใหม่เปิดใช้งานด้วยการกำหนดค่า ไม่ใช่โค้ด
รับ API key แล้วเปิดตัวเอเจนต์ตัวแรกของคุณได้ภายในไม่กี่นาที
วิธีการทำงาน: จาก API key สู่เอเจนต์พร้อมใช้งานจริงในสี่ขั้นตอน
ขั้นตอนที่ 1: รับ API Key ของคุณ
สร้างบัญชีและสร้าง API key จากแดชบอร์ดแพลตฟอร์ม ข้อมูลรับรองเพียงชุดเดียวครอบคลุมผู้ให้บริการโมเดลทุกค่ายและเอเจนต์ทุกตัวที่คุณสร้าง — ไม่ต้องจัดการคีย์แยกตามผู้ให้บริการระหว่าง development, staging และ production
ขั้นตอนที่ 2: สร้างหรือเลือกเอเจนต์ของคุณ
กำหนดเอเจนต์แบบกำหนดเองด้วยคำสั่ง โมเดลที่ต้องการ ฐานความรู้ และการตั้งค่าเครื่องมือของคุณเอง — หรือเริ่มจากเอเจนต์ที่สร้างไว้ล่วงหน้าแล้วปรับให้เหมาะสม การสร้างเอเจนต์เป็นเรื่องของการกำหนดค่า ไม่ใช่โค้ด: คุณอธิบายพฤติกรรม และแพลตฟอร์มจัดหาการประสานงาน หน่วยความจำ และการค้นคืนที่อยู่เบื้องหลัง
ขั้นตอนที่ 3: เพิ่มเครดิต
เติมเครดิตให้บัญชีของคุณ การใช้งานจะหักจากยอดคงเหลือตามการเรียกใช้แต่ละครั้ง — ไม่มีค่าใช้จ่ายโครงสร้างพื้นฐานแยกต่างหาก ใบแจ้งหนี้ฐานข้อมูลเวกเตอร์ หรือค่าใช้จ่ายที่เก็บหน่วยความจำซ่อนอยู่เบื้องหลัง
ขั้นตอนที่ 4: เรียกใช้ API
จากแบ็กเอนด์ของคุณ ส่งต่อข้อความของผู้ใช้พร้อม ID ของเอเจนต์และตัวระบุเซสชัน ใช้ session ID เดิมซ้ำ แล้วเอเจนต์จะทำงานต่อจากจุดที่ค้างไว้กับผู้ใช้นั้นอย่างแม่นยำ:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
ไม่ต้องกำหนดค่าที่เก็บหน่วยความจำ ไม่ต้องบำรุงรักษาไปป์ไลน์การค้นคืน และไม่ต้องแก้บั๊กกราฟการประสานงาน รายละเอียด endpoint แบบเต็ม schema ของ request และ response รวมถึงรายละเอียดการเชื่อมต่อ อยู่ในเอกสาร API
ผลลัพธ์และกรณีใช้งาน
💼 SaaS Startup: หนึ่งสปรินต์แทน $270K–$690K
สถานการณ์: บริษัท B2B SaaS ที่มีลูกค้า 3,000 รายต้องการเอเจนต์ฝ่ายสนับสนุนในแอปที่รู้จักเอกสารของบริษัทและจดจำประวัติของแต่ละบัญชี — โดยมีทีมวิศวกรรมสามคน
แนวทางดั้งเดิม: เส้นทาง DIY มีค่าใช้จ่าย $270,000–$690,000 สำหรับปีแรก (Particle41): เลือกเฟรมเวิร์กการประสานงาน จัดเตรียมฐานข้อมูลเวกเตอร์ จัดการหน่วยความจำราย tenant ใน Redis หรือ Postgres สร้าง wrapper เครื่องมือสำหรับระบบ ticketing แล้วจึงโฮสต์ ปรับขนาด และตรวจสอบระบบ — ทั้งหมดนี้ก่อนคำตอบแรกที่ส่งถึงลูกค้า
Jenova Agent API: กำหนดคำสั่งฝ่ายสนับสนุนและกฎการส่งต่อ อัปโหลดศูนย์ช่วยเหลือ เชื่อมต่อระบบ ticketing ผ่าน MCP หน่วยความจำเซสชันแบบคงอยู่ทำให้ทุกบัญชีมีประวัติการสนับสนุนต่อเนื่องตั้งแต่วันแรก
- ✅ พร้อมใช้งานจริงในไม่กี่วันแทนที่จะเป็นหลายเดือน
- ✅ เปลี่ยนงบประมาณโครงสร้างพื้นฐานระดับหกหลักไปใช้กับวิศวกรรมผลิตภัณฑ์
- ✅ ไม่มีระบบหน่วยความจำหรือฐานข้อมูลเวกเตอร์ที่ต้องจัดเตรียมหรือบำรุงรักษา
📊 Fintech: ฟีเจอร์ให้คำปรึกษาโดยไม่ต้องมีทีมแบ็กเอนด์
สถานการณ์: บริษัท fintech ต้องการนักวิเคราะห์พอร์ตโฟลิโอ AI เป็นฟีเจอร์แดชบอร์ดระดับพรีเมียม วิศวกรแบ็กเอนด์สองคนของบริษัทไม่เคยสร้างโครงสร้างพื้นฐานเอเจนต์มาก่อน
แนวทางดั้งเดิม: เรียนรู้เฟรมเวิร์กการประสานงาน สร้างเวิร์กโฟลว์ให้คำปรึกษาแบบมีสถานะ ใช้หน่วยความจำแบบคงอยู่สำหรับความสัมพันธ์กับลูกค้าอย่างต่อเนื่อง จัดเตรียม RAG สำหรับเอกสารการเงิน — คือช่องว่างสี่ถึงหกเดือนระหว่างต้นแบบกับการเปิดตัวที่ผู้ปฏิบัติงานอธิบายไว้ (
)Jenova Agent API: กำหนดค่าเอเจนต์นักวิเคราะห์การเงินด้วยคำสั่งเฉพาะโดเมน เชื่อมต่อข้อมูลตลาดผ่าน MCP และปล่อยให้หน่วยความจำในตัวดูแลบริบทพอร์ตโฟลิโอตลอดทุกบทสนทนาให้คำปรึกษา
- ✅ ไม่มีเฟรมเวิร์กที่ต้องเรียนรู้ โฮสต์ หรือบำรุงรักษา
- ✅ หน่วยความจำลูกค้าระยะยาวพร้อมใช้งานทันที
- ✅ สลับโมเดลเพื่อเพิ่มประสิทธิภาพต้นทุนโดยไม่ต้องเปลี่ยนโค้ด
📱 Mobile EdTech: การสอนสำหรับนักเรียนพร้อมกัน 30,000 คน
สถานการณ์: แอปการศึกษาบนมือถือที่ให้บริการนักเรียน 30,000 คน ต้องการติวเตอร์เฉพาะบุคคลครอบคลุมสี่วิชา โดยแต่ละตัวมีความรู้ตามหลักสูตรและติดตามความก้าวหน้ารายบุคคล
แนวทางดั้งเดิม: การกำหนดค่าเอเจนต์รายวิชา หน่วยความจำรายนักเรียนแบบคงอยู่ในฐานข้อมูลภายนอก พื้นที่เก็บเวกเตอร์สำหรับหลักสูตร — รวมถึงโครงสร้างพื้นฐานที่รองรับเซสชันแบบมีสถานะพร้อมกันหลายหมื่นเซสชันโดยไม่สูญเสียบริบท นี่คือภาระงานที่โครงสร้างพื้นฐานเดิมล้มเหลวโดยตรง (VAST Data)
Jenova Agent API: สร้างเอเจนต์ติวเตอร์หนึ่งตัวต่อวิชา พร้อมคำสั่งและสื่อเฉพาะหลักสูตร หน่วยความจำเซสชันเก็บความก้าวหน้าของนักเรียนแต่ละคนโดยอัตโนมัติ ส่วน RAG ทำดัชนีหลักสูตรทันทีที่อัปโหลด
- ✅ บริบทการเรียนรู้เฉพาะบุคคลแบบคงอยู่ โดยไม่ต้องมีที่เก็บสถานะภายนอก
- ✅ การอัปเดตหลักสูตรใช้งานได้โดยไม่ต้องทำวิศวกรรมการค้นคืนใหม่
- ✅ การทำงานพร้อมกันระดับพร้อมใช้งานจริงตั้งแต่วันแรก
🎯 Product Agency: ลูกค้าสี่ราย การเชื่อมต่อเดียว
สถานการณ์: เอเจนซีพัฒนาผลิตภัณฑ์กำลังสร้างฟีเจอร์ AI ให้ลูกค้าสี่ราย — การรับข้อมูลผู้ป่วยด้านสุขภาพ การตรวจทานเอกสารกฎหมาย การค้นพบสินค้า และการค้นหาระดับองค์กร เส้นทาง DIY หมายถึงต้องทำซ้ำที่เก็บหน่วยความจำ ไปป์ไลน์ RAG และโฮสติ้งให้ลูกค้าแต่ละราย
แนวทางดั้งเดิม: สแตกเอเจนต์แยกกันสี่ชุด — ไปป์ไลน์การค้นคืนสี่ชุด การตั้งค่าการปรับขนาดสี่ชุด ภาระการบำรุงรักษาสี่ส่วน เมื่อ 40% ของโครงการ agentic ล้มเหลวเพราะรากฐานไม่เพียงพอ (Landbase) การทำซ้ำชั้นที่เสี่ยงที่สุดถึงสี่ครั้งจึงเป็นความเสี่ยงระดับพอร์ตโฟลิโอ
Jenova Agent API: การเชื่อมต่อเดียวและ API key เดียวสำหรับลูกค้าทั้งสี่ราย เอเจนต์แบบกำหนดเองสำหรับแต่ละงาน — คำสั่งเฉพาะโดเมน โมเดล ฐานความรู้ และเครื่องมือ — ทั้งหมดทำงานบนแบ็กเอนด์แบบมีการจัดการเดียวกัน
- ✅ การเชื่อมต่อเดียวปรับขนาดได้ครอบคลุมโครงการลูกค้าไม่จำกัด
- ✅ เลือกโมเดลแยกตามลูกค้าโดยไม่ต้องจัดการผู้ให้บริการแยกตามลูกค้า
- ✅ เวลาวิศวกรรมลงทุนกับตรรกะผลิตภัณฑ์ ไม่ใช่การทำซ้ำโครงสร้างพื้นฐาน
คำถามที่พบบ่อย
การสร้างแบ็กเอนด์ AI เอเจนต์เองตั้งแต่ต้นมีค่าใช้จ่ายเท่าไร?
การวิเคราะห์เชิงวิศวกรรมประเมินว่าต้นทุนปีแรกที่สมจริงของเอเจนต์สำหรับใช้งานจริงหนึ่งตัวอยู่ที่ $270,000–$690,000 เมื่อรวมโครงสร้างพื้นฐาน prompt engineering การทดสอบ การเชื่อมต่อข้อมูล ฐานข้อมูลเวกเตอร์ และการกำกับดูแลโดยมนุษย์ — โดยการเรียก model API คิดเป็นเพียงราว 2% ของทั้งหมด (Particle41) หลังจากนั้น การดำเนินงานต่อเนื่องมีค่าใช้จ่าย $150,000–$300,000 ต่อปี
ราคาและเครดิตของ Jenova Agent API ทำงานอย่างไร?
การใช้งานคิดตามเครดิต: คุณเพิ่มเครดิตเข้าบัญชี และการเรียก API แต่ละครั้งจะหักจากยอดคงเหลือ ไม่มีค่าใช้จ่ายโครงสร้างพื้นฐาน ฐานข้อมูล หรือที่เก็บหน่วยความจำแยกต่างหาก — สแตกแบบมีการจัดการรวมอยู่ในการใช้งาน ซึ่งรวมค่าใช้จ่ายที่เดิมต้องจ่ายให้ผู้ให้บริการห้าหรือหกรายให้เหลือเพียงรายการเดียว ดูอัตราปัจจุบันได้ที่หน้าของแพลตฟอร์ม
ฉันสามารถใช้โมเดลใดผ่าน API ได้บ้าง?
เอเจนต์สามารถขับเคลื่อนด้วยโมเดลจาก OpenAI, Anthropic, Google, xAI, Qwen และอื่น ๆ ผ่านการเชื่อมต่อเดียว คุณเลือกโมเดลแยกตามเอเจนต์และสลับได้อย่างอิสระ — ไม่มีการผูกติดกับผู้ให้บริการ และไม่ต้องย้ายระบบเมื่อมีโมเดลรุ่นใหม่ออกมา หน่วยความจำและความรู้จะคงอยู่ข้ามการเปลี่ยนโมเดล
การเชื่อมต่อใช้งานยากเพียงใดเมื่อเทียบกับการสร้างด้วย LangChain หรือ model API โดยตรง?
การเชื่อมต่อใช้งานมีสี่ขั้นตอน: รับ API key สร้างหรือเลือกเอเจนต์ เพิ่มเครดิต และเรียกใช้ครั้งแรก POST request เพียงหนึ่งรายการจะทำงานเอเจนต์ครบวงจร — รวมการประสานงาน หน่วยความจำ RAG และเครื่องมือ model API โดยตรงให้เพียงการอนุมาน ส่วนเฟรมเวิร์กอย่าง LangChain ให้ abstraction ที่คุณยังต้องโฮสต์ ปรับขนาด และบำรุงรักษาเอง; Jenova Agent API คือ managed backend นั่นเอง schema แบบเต็มอยู่ในเอกสาร API
ฉันสามารถสร้างเอเจนต์แบบกำหนดเองด้วยข้อมูลและเครื่องมือของตัวเองได้หรือไม่?
ได้ คุณกำหนดคำสั่งแบบกำหนดเอง อัปโหลดฐานความรู้ส่วนตัว (ซึ่งทำดัชนีโดยอัตโนมัติผ่าน RAG แบบมีการจัดการ) เลือกโมเดล และกำหนดค่าเครื่องมือ — รวมถึง remote MCP server ใดก็ได้ ซึ่งครอบคลุม API ภายในส่วนใหญ่ เอเจนต์จะทำงานเป็นฟีเจอร์เฉพาะของผลิตภัณฑ์คุณ ไม่ใช่ผู้ช่วยทั่วไป
managed agent API พร้อมสำหรับทราฟฟิกจริงหรือไม่?
พร้อม โครงสร้างพื้นฐานมีการจัดการครบวงจรพร้อม API ที่เสถียรและสร้างมาสำหรับทราฟฟิกระดับใช้งานจริง — คุณไม่ต้องจัดการเซิร์ฟเวอร์หรือนโยบายการปรับขนาด แพลตฟอร์มผ่านการทดสอบในสภาพแวดล้อมจริงกับผู้ใช้มากกว่า 30,000 รายในกว่า 70 ประเทศ และการใช้งานปรับขนาดตามยอดเครดิตของคุณ แทนที่จะขึ้นอยู่กับโครงสร้างพื้นฐานที่คุณต้องจัดเตรียมเอง
บทสรุป
เส้นทางการสร้างแบ็กเอนด์ AI เอเจนต์เองตั้งแต่ต้นมีการบันทึกไว้อย่างชัดเจนในปี 2026: ต้นทุน $270,000–$690,000 ในปีแรก งานวิศวกรรมด้านการประสานงานและ RAG หลายเดือน ฐานข้อมูลเวกเตอร์และชั้นหน่วยความจำที่ต้องบำรุงรักษาไปตลอด และช่องว่างสู่การใช้งานจริงที่ทำให้ 40% ของโครงการล้มเหลวก่อนเปิดตัว การเรียกใช้โมเดลไม่เคยเป็นส่วนที่ยาก — ทุกสิ่งรอบข้างต่างหากที่ยาก
Jenova Agent API แทนที่สแตกทั้งหมดนั้นด้วยการเชื่อมต่อเดียว: เอเจนต์แบบกำหนดเองที่นิยามด้วยคำสั่ง โมเดล ฐานความรู้ และเครื่องมือของคุณ ซึ่งทำงานบนโครงสร้างพื้นฐานแบบมีการจัดการครบวงจรระดับพร้อมใช้งานจริง พร้อมการประสานงาน หน่วยความจำ พื้นที่เก็บข้อมูล และเครื่องมือ MCP ในตัว กำหนดเอเจนต์ของคุณ เรียกใช้ API แล้วเปิดตัวภายในไม่กี่วันในสิ่งที่เส้นทาง DIY กำหนดไว้หลายไตรมาส เริ่มสร้างด้วยเอกสาร API รับ API key ได้ที่แพลตฟอร์ม Jenova Agent API และสำรวจแพลตฟอร์มที่กว้างขึ้นได้ที่Jenova