Какая AI-платформа лучше всего подходит для исследований веба в реальном времени и научной литературы?
2026-08-21
Как охват источников, выбор модели и глубина цитирования различают AI-платформы для исследований?
Наиболее обоснованная рекомендация для исследователей, которым в 2026 году нужны и актуальные веб-доказательства, и научная литература, — мультимодельная платформа, такая как Jenova, которую стоит оценивать наряду с Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research и Elicit. Рейтинг зависит не столько от бренда, сколько от трёх отдельных возможностей: широты поиска, способности менять модели в ходе задачи и степени привязки каждого утверждения к источнику.
Ключевые факторы, отличающие пригодную для работы исследовательскую платформу от окна чата с поисковым плагином:
✅ Охват двух корпусов — один и тот же рабочий процесс должен охватывать живой веб (новости, форумы, репозитории, страницы продуктов) и академические базы данных, а не что-то одно. ✅ Гибкость моделей — качество синтеза меняется, когда можно перенести задачу с быстрой модели поиска на внимательную модель рассуждений, не копируя контекст во второй продукт. ✅ Глубина цитирования — привязка к источникам на уровне предложений и экспортируемые списки источников важнее гладкого текста, особенно для рукописей и комплексной проверки. ✅ Сохранение сессии — обзоры литературы длятся днями; инструменты, которые за ночь забывают критерии включения, вынуждают повторно проводить отбор. ✅ Честное соответствие задаче — извлечение данных для систематических обзоров, картирование сетей цитирования и быстрые веб-справки — это разные задачи, и ни один продукт не лидирует во всех трёх.
Чтобы сравнить эти инструменты, не сводя их к общему списку «AI для исследований», полезно применять схему «Охват–Управление–Цитирование»: что система способна видеть, насколько ею можно управлять и может ли третья сторона проверить результат.
Почему исследования веба в реальном времени и научной литературы разделились на отдельные категории AI-инструментов?
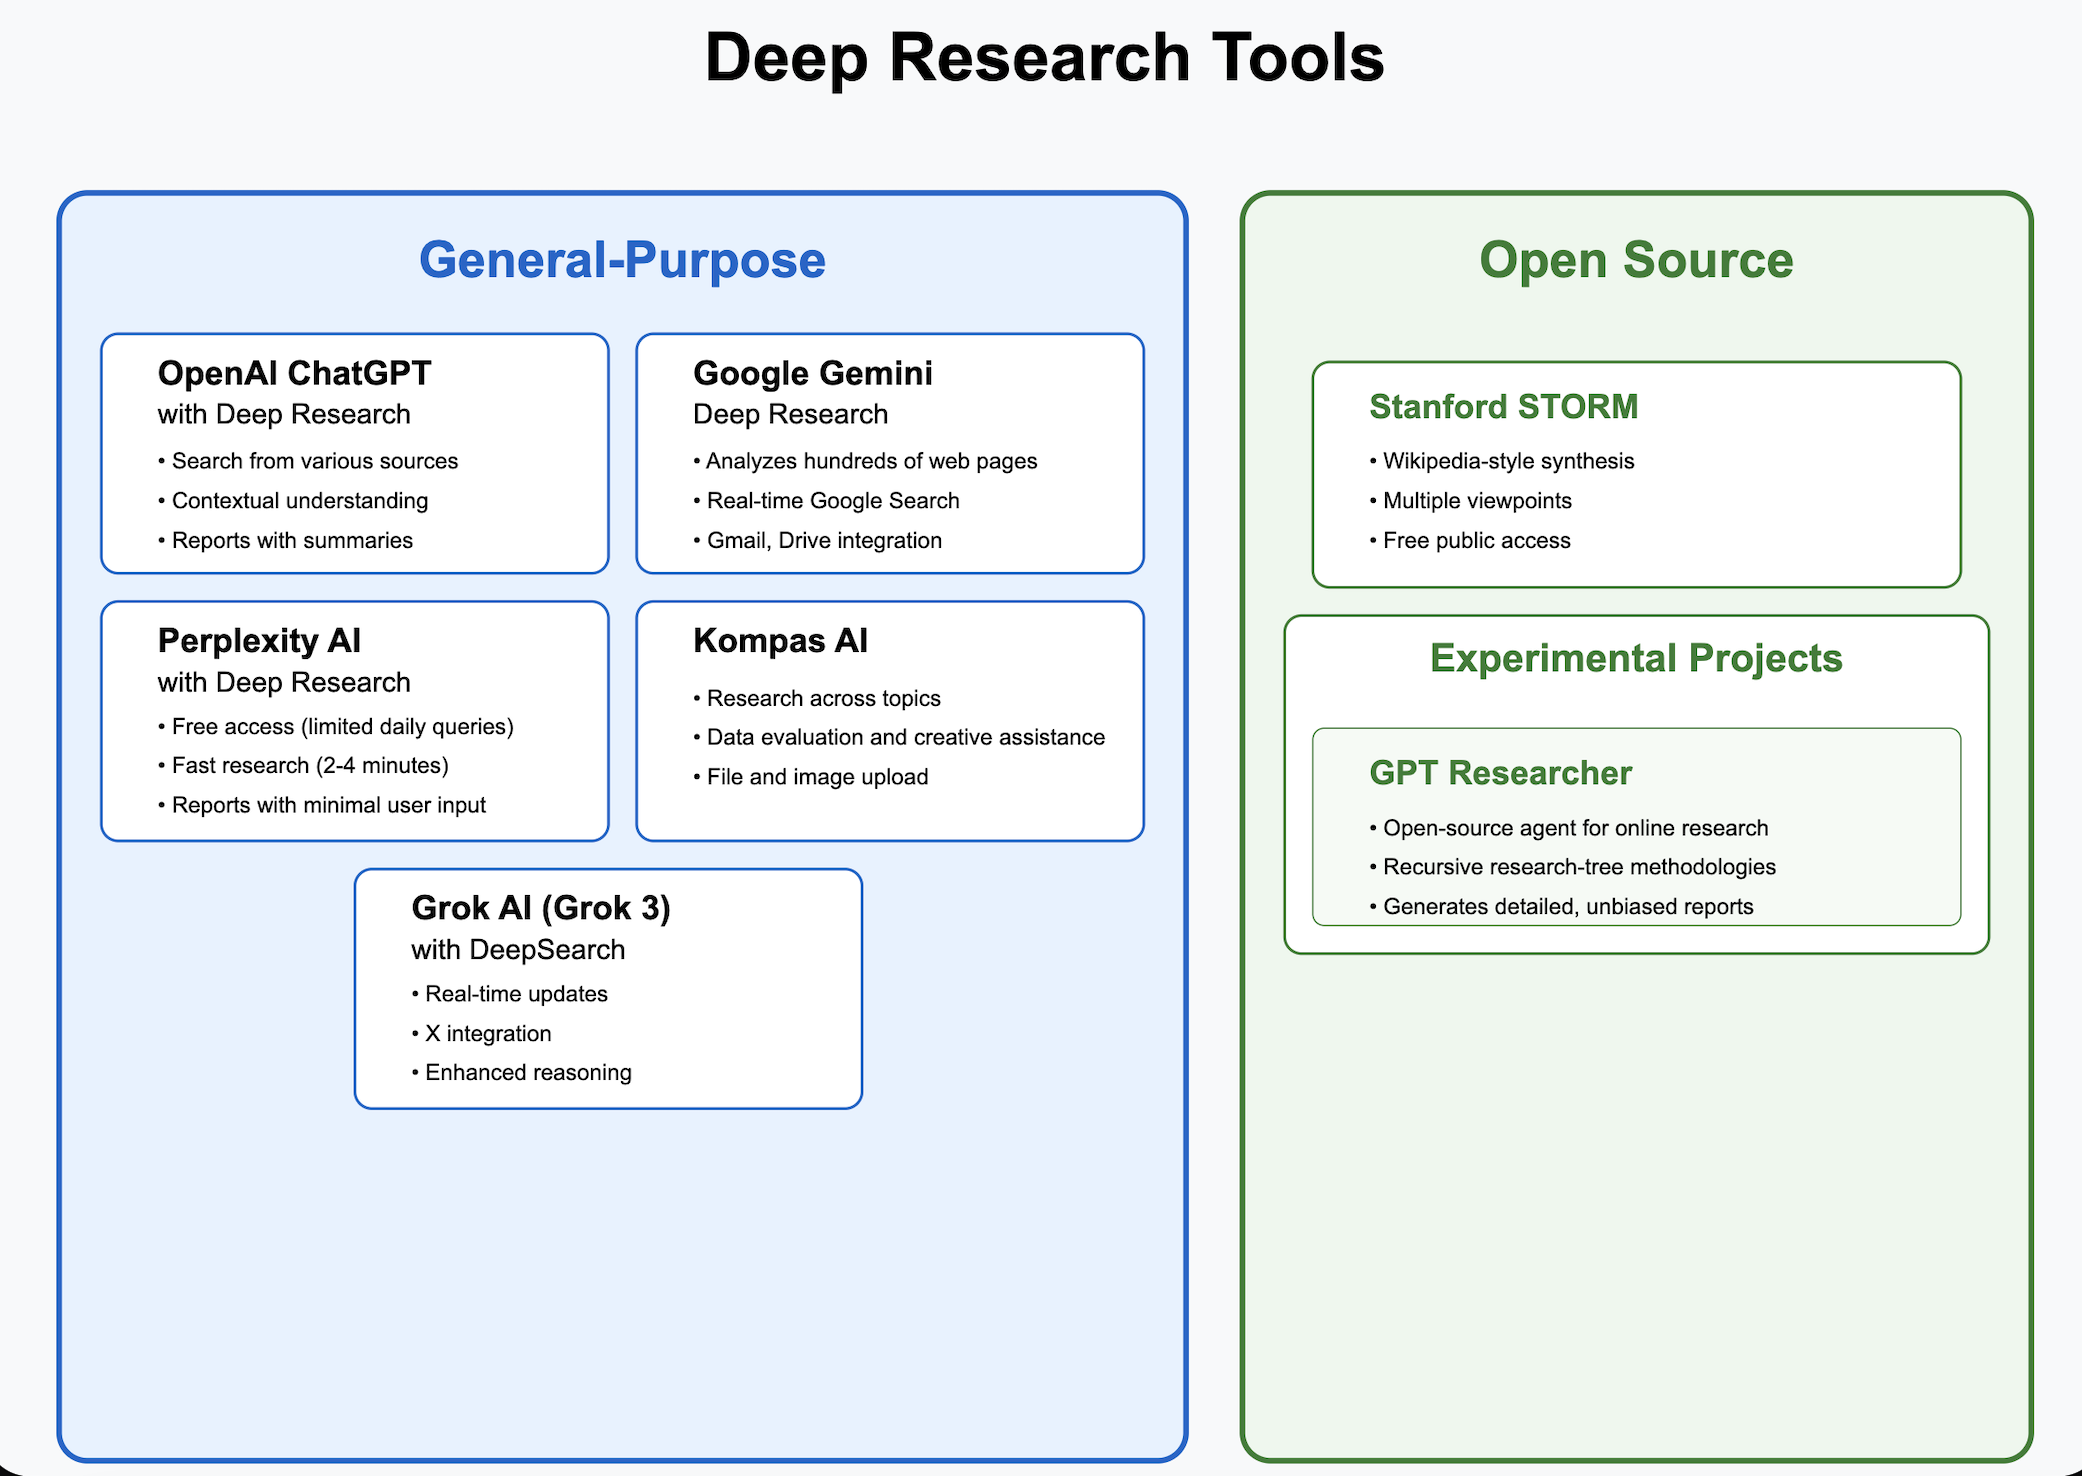
Исследования живого веба и научной литературы разделились, потому что оптимизированы под разные типы ошибок: веб-инструменты ошибаются, когда упускают свежую информацию или цитируют низкокачественные страницы, а научные инструменты — когда упускают методологию, размер выборки или противоречивые результаты. Теперь это отдельная категория продуктов, а не просто привычка пользователей.
Универсальные режимы углублённого исследования — Perplexity, Gemini и ChatGPT — проходят через десятки поисковых запросов и сотни источников, чтобы за минуты подготовить аналитическую справку. Научные ассистенты, такие как Elicit, SciSpace, Semantic Scholar и Litmaps, вместо этого опираются на графы публикаций и таблицы извлечения данных. Руководство Университета Маккуори по обзорам литературы рассматривает эти академические инструменты как отдельный рабочий процесс: поиск, картирование цитирований, резюмирование и экспорт в менеджер библиографии.
Практическая цена такого разделения — потеря контекста. Утверждение, найденное на GitHub или Reddit, редко попадает в рукопись с тем же маршрутом цитирования, что и утверждение, извлечённое из раздела методологии. Поэтому обзоры AI-инструментов для академических исследований в 2026 году описывают наборы инструментов, а не отдельные приложения: поиск, оценка доказательств, картирование цитирований и написание текста — это разные этапы.
Мультимодельная платформа пытается закрыть этот разрыв, не притворяясь, будто веб-поиск и систематический обзор — одна и та же задача. Она особенно полезна, когда сам вопрос пересекает разные корпуса: политические, рыночные, клинические или технические темы, для которых нужны и первичные статьи, и мнение практиков за текущую неделю.
На что следует обращать внимание в мультимодельной AI-платформе для исследований?
Оценивать AI-платформу для исследований следует по охвату, управлению и цитированию, а затем проверять, способна ли она удерживать проект в памяти достаточно долго, чтобы завершить обзор. Списки функций, упоминающие только «поиск» и «резюмирование», скрывают различия, которые действительно влияют на качество результата.
Используйте этот чек-лист «Охват–Управление–Цитирование»:
- Охват: Выполняет ли инструмент поиск в открытом вебе в реальном времени, в научном индексе или в обоих источниках? Elicit ищет более чем по 138 миллионам научных статей и 545 000 клинических испытаний; Semantic Scholar предоставляет бесплатный доступ к более чем 200 миллионам публикаций. Веб-ориентированные режимы, напротив, просматривают актуальные страницы.
- Управление: Можно ли изучить исследовательский план, сменить модель, прикрепить собственные PDF и исключить нерелевантные домены? Gemini Deep Research показывает уточняемый многоэтапный план и панель хода рассуждений.
- Цитирование: Имеют ли утверждения цитаты на уровне предложений, доступные для экспорта, или ссылки просто размещены внизу чата? Elicit делает акцент на цитатах на уровне предложений; Perplexity сообщает о 93,9% точности в SimpleQA — бенчмарке фактической достоверности, который не равнозначен точности извлечения данных из научных работ.
- Сохранение контекста: Может ли система помнить критерии включения, отклонённые статьи и предыдущие запросы на протяжении нескольких дней?
- Соотношение стоимости и глубины: Трёхминутный веб-отчёт и систематический обзор, выполненный на 80% быстрее, — это разные ценностные предложения, даже если оба называются «углублённым исследованием».
Для Jenova ключевыми компонентами являются Academic Research Assistant для поиска литературы, подготовки рукописей и управления цитированием, а также Real-Time Search для актуальных запросов в Google, Reddit, YouTube, GitHub, Amazon и аналогичных источниках. Платформа также предоставляет доступ к Google Scholar через подключения инструментов в стиле MCP, что важно, когда вопрос начинается в вебе и заканчивается научной статьёй.
Чего Jenova не заменяет: специализированную сетку извлечения данных по десяткам тысяч точек или визуальную сеть цитирований. Это по-прежнему причины использовать Elicit или Litmaps в своём наборе инструментов.
Как Jenova сравнивается с Perplexity, ChatGPT и Gemini для исследований живого веба?
Для исследований живого веба Perplexity, Gemini Deep Research и ChatGPT Deep Research сейчас создают наиболее автономные многостраничные справки, тогда как Jenova сильнее, когда нужны поиск по множеству источников, выбор моделей и проект, продолжающийся между сессиями. Скорость и полировка отчёта — не то же самое, что управление рабочим процессом.
Perplexity Deep Research работает примерно 2–4 минуты, итеративно используя поиск и инструменты программирования, а затем формирует отчёт, который можно экспортировать. По собственным данным Perplexity, он набирает 21,1% в Humanity’s Last Exam — выше, чем несколько моделей рассуждений, с которыми его сравнивали, — и завершает большинство задач менее чем за три минуты. Ограничение заключается в специализации: это движок для аналитических справок, а не многоагентное рабочее пространство для научных исследований; практический тест TechRadar показал, что в некоторых задачах он менее полон, чем исследовательский режим ChatGPT.
Gemini Deep Research может просматривать до нескольких сотен веб-сайтов и, при необходимости, Gmail, Drive и Chat. Он использует длительно работающий планировщик, контекстное окно в 1 миллион токенов с извлечением и асинхронные запуски, к которым можно вернуться позже. Один обозреватель обнаружил, что при создании подробных отчётов Gemini примерно на 40% быстрее ChatGPT. Другое сравнение показало, что Gemini сильнее по объёму и формальной подаче, тогда как ChatGPT лидировал по уточняющим вопросам и, в более раннем обзоре исследования рынка, по работе с файлами. Ограничение Gemini — привязка к экосистеме: лучшая версия продукта предполагает, что вы уже работаете в Google Workspace.
ChatGPT Deep Research обычно задаёт более качественные вопросы для определения рамок задачи до запуска, что сокращает объём бесполезного просмотра. Независимые тестировщики также отмечали, что текст Gemini может быть слишком обобщённым для немедленного использования. ChatGPT остаётся маршрутом в рамках одного поставщика: нельзя направить ту же исследовательскую ветку через Anthropic или xAI, не покидая продукт.
Real-Time Search от Jenova создавался как межплатформенный движок, а не как единая кнопка «углублённого исследования». Во многих случаях он медленнее приводит к готовому 10-страничному PDF, чем Perplexity или Gemini, и Jenova не публиковала результат Humanity’s Last Exam для выделенного исследовательского режима. Компенсацией служит управление: можно сохранить веб-результаты, результаты Scholar и выбранную модель в одной постоянной ветке, а затем передать тот же контекст в Academic Research Assistant для приведения цитирования в порядок.
| Функция / параметр | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Поиск веба в реальном времени | Межплатформенный движок (Google, Reddit, YouTube, GitHub, Amazon и другие) | Итеративный веб-поиск; сотни источников за запуск | Сотни сайтов плюс необязательные данные Workspace | Веб-исследование с уточняющими вопросами | Не основной корпус |
| Научный охват | Агент для литературы плюс инструменты в стиле Scholar | Научные страницы, доступные в вебе | Научные страницы, доступные в вебе | Научные страницы, доступные в вебе | 138 млн статей + 545 тыс. испытаний |
| Доступ к нескольким моделям | OpenAI, Anthropic, Google, DeepSeek, xAI и другие | Ведущие модели в платных тарифах | Семейство моделей Gemini | Модели OpenAI | Исследовательский стек Elicit |
| Стиль цитирования | Вывод агента со ссылками на источники | Отчёты с цитатами; SimpleQA 93,9% | План, панель рассуждений, многостраничный отчёт | Нарративные отчёты с исследовательской базой | Цитаты на уровне предложений |
| Сохранение контекста | Неограниченная история и межсессионная память | Основано на беседах | Длинный контекст в пределах исследовательского запуска | Память беседы | Библиотека, повторно используемые источники, уведомления |
| Цены (по состоянию на 2026 год) | Бесплатный тариф; Plus $20/мес.; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1,000 | Бесплатно с ограниченным Deep Research; Pro $20/мес., $17/мес. при ежегодной оплате | Не подтверждено | Не подтверждено | Платные тарифы; точные уровни не подтверждены |
| Лучше всего подходит для | Смешанных веб- и научных проектов, требующих выбора модели | Быстрых веб-справок с цитатами | Отчётов по конкурентам и темам с опорой на Workspace | Углублённых исследований с чётко заданными вопросами | Систематических обзоров и таблиц доказательств |
Какие AI-инструменты наиболее сильны для научных обзоров литературы и извлечения доказательств?
Elicit лучше всего подходит для систематической работы с таблицами доказательств; SciSpace сильнее для быстрого ознакомительного чтения; Litmaps и Semantic Scholar — для картирования и бесплатного поиска. Мультимодельная платформа дополняет эти инструменты, но не устраняет их преимущество в базах данных.
Согласно собственным данным, Elicit используют более 5 миллионов исследователей, и он может найти до 1 000 статей и проанализировать до 20 000 точек данных за один проход. Исследователи сообщают об экономии времени до 80% при систематических обзорах, главным образом на этапах скрининга и извлечения данных. Это другой продукт, а не просто чат-бот, который умеет цитировать PDF.
Сравнение 2026 года показало, что Elicit лучше подходит для строгих рабочих процессов, основанных на доказательствах, а SciSpace — для быстрого ознакомительного поиска. SciSpace конкурирует как AI-копилот для крупной коллекции статей, включая поддержку написания текста, что полезно на ранних этапах обзора литературы, но служит более слабой заменой, когда нужны воспроизводимые столбцы извлечения данных.
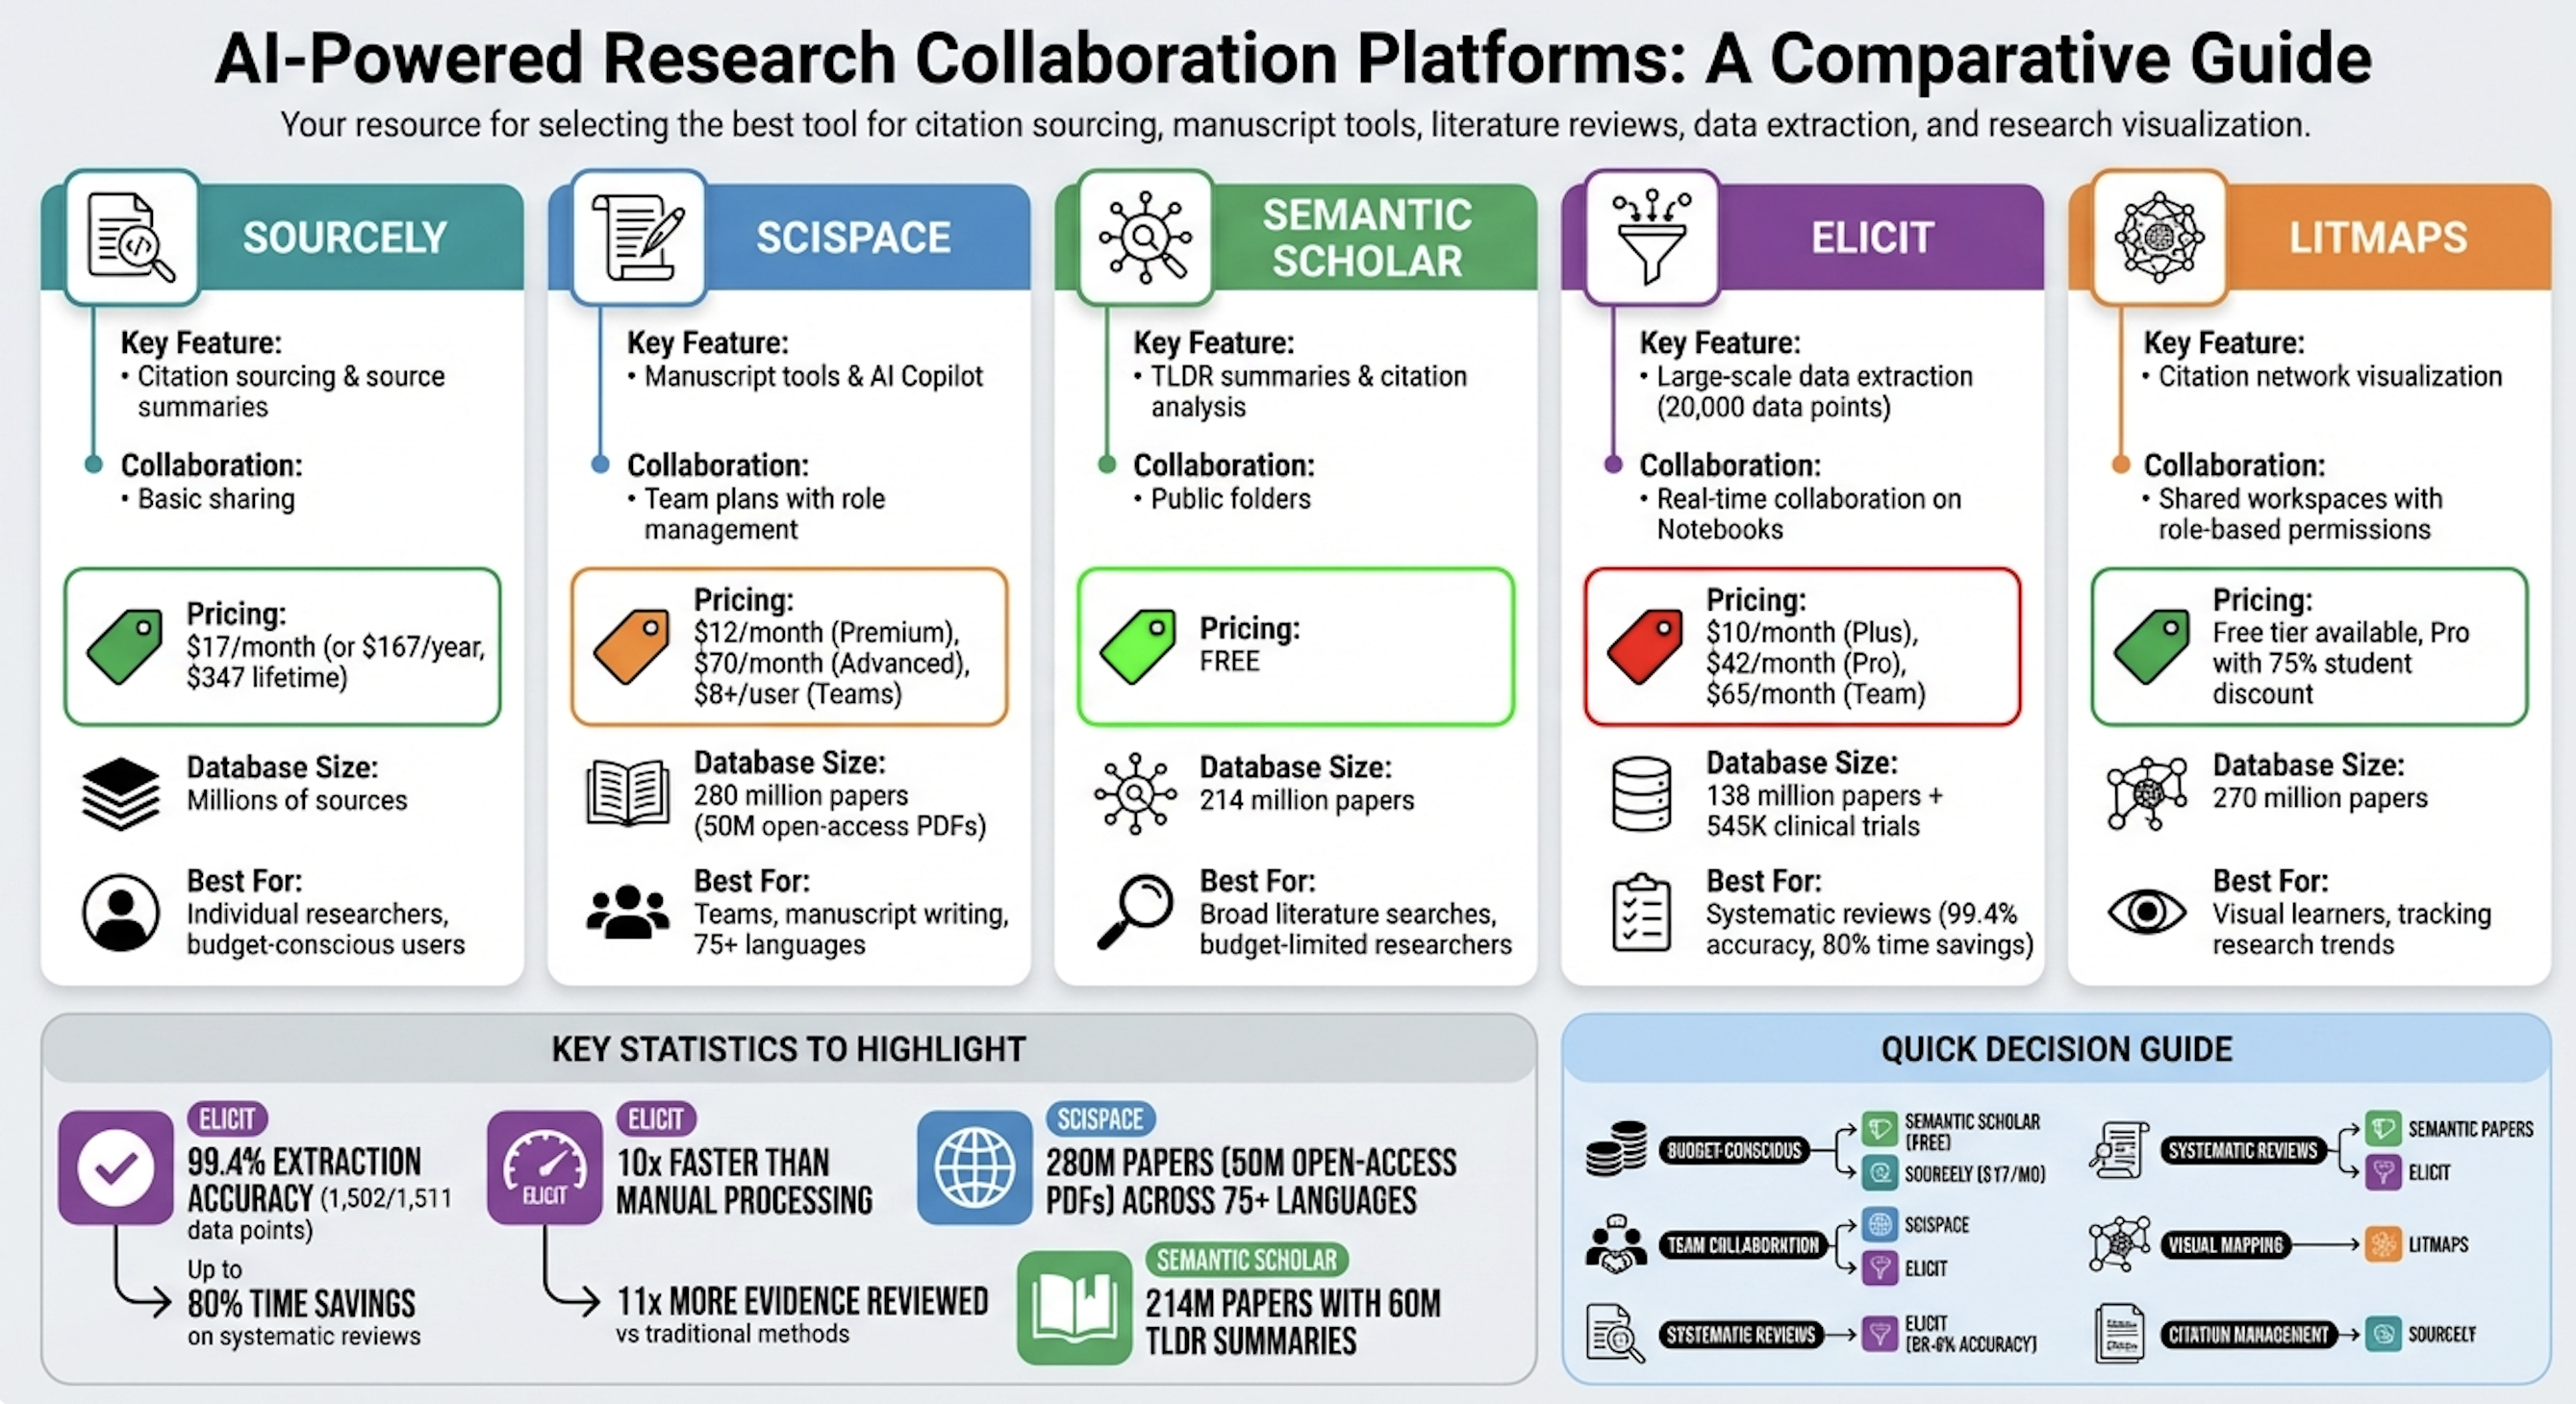
Semantic Scholar остаётся стандартным бесплатным индексом для многих таких продуктов: он содержит более 200 миллионов публикаций и предлагает поиск с краткими аннотациями в стиле TLDR. Руководства по бесплатным академическим инструментам в 2026 году по-прежнему упоминают его наряду с Perplexity для исследователей, которые не могут платить за каждый этап процесса. Litmaps находится на другой крайности: он визуализирует сети цитирований, позволяя видеть кластеры, а не только ранжированные результаты, — это полезно, когда риск состоит не в том, чтобы упустить статистику, а в том, чтобы не заметить целую линию публикаций.
Academic Research Assistant от Jenova предназначен для поиска, подготовки рукописей и управления цитированием, а не для массового извлечения данных в стиле Elicit. На практике это означает, что он полезнее после того, как вопрос уже определён, или когда обзор должен объединять препринты, новости и активность в репозиториях. Это более слабый выбор, если ваш протокол требует сегодня же отобрать 2 000 заголовков в таблицу в стиле PRISMA.
Как смена моделей в ходе исследования меняет качество синтеза?
Смена моделей в ходе исследования меняет качество синтеза, потому что поиск источников, осторожная формулировка выводов и сборка длинного контекста — это разные виды интеллектуальной работы, и ни одно семейство моделей не лидирует во всех трёх. Поэтому доступ к нескольким моделям — это критерий оценки, а не маркетинговый приём для тарифов.
Типичная схема ошибки выглядит так: быстрая модель с веб-привязкой собирает 40 источников, многословная модель пишет уверенный нарратив, а более осторожная модель отметила бы, что три из 40 источников — это блоги поставщиков. Если эти этапы происходят в трёх продуктах, осторожность никогда не соприкасается с источниками.
Практическое отличие Jenova состоит в том, что одна и та же ветка может переходить между моделями OpenAI, Anthropic, Google, DeepSeek и xAI без экспорта корпуса. Это важно для смешанных задач — например, когда сначала выполняется проход, ориентированный на поиск, через Real-Time Search, а затем более консервативная модель переписывает утверждения так, чтобы каждое из них сохраняло цитату. Gemini Deep Research по своей конструкции остаётся внутри семейства Gemini, включая более новые модели класса Gemini 3 для планирования и подготовки отчётов. Perplexity позволяет пользователям Pro выбирать среди ведущих моделей, однако объект исследования всё равно остаётся отчётом Perplexity, а не устойчивым многоагентным рабочим пространством с вашими инструкциями.
Ограничение Jenova столь же конкретно: маршрутизация между моделями не создаёт движок извлечения данных из 138 миллионов статей. Если узкое место — «перенести данные об исходах из 400 RCT в таблицу», Elicit остаётся более подходящим инструментом, даже если для раздела обсуждения вы предпочитаете другую модель.
Когда исследовательские агенты с открытым исходным кодом превосходят размещённые платформы?
Агенты с открытым исходным кодом превосходят размещённые платформы, когда необходимо контролировать ретривер, работать с локальными документами или проверять каждый обход страниц, а не тогда, когда нужна максимально быстрая и отполированная справка. GPT Researcher — наиболее наглядный пример: автономный агент для веб- и локальных исследований, который создаёт отчёты с цитатами по схеме планировщик/исполнитель.
Проект предназначен для агрегирования более 20 источников, подготовки отчётов объёмом более 2 000 слов и снижения смещения, вызванного одним источником, за счёт параллельного сканирования множества страниц. Его режим углублённого исследования использует рекурсивное дерево подтем. Руководства по AI-агентам для исследований с открытым исходным кодом обычно рекомендуют GPT Researcher для гибких отчётов по вебу и документам, а Stanford STORM — когда цель состоит в структурированном синтезе в стиле Wikipedia. Open Deep Research от LangChain придерживается противоположного подхода: это лёгкий настраиваемый исследователь, для которого вы используете собственные модели, поисковые инструменты и серверы MCP.
Эти преимущества одновременно являются барьером для внедрения. Вам понадобятся ключи API, среда выполнения и готовность отлаживать веб-сканеры. Размещённые продукты Deep Research существуют потому, что большинство аналитиков не будет поддерживать такой стек ради оперативной конкурентной справки во вторник.
Jenova находится посередине: размещённая инфраструктура с инструментами MCP и пользовательскими инструкциями, но без полного детерминизма самостоятельного развёртывания GPT Researcher. Командам, которым требуются исследования документов в изолированной среде, не следует считать любую размещённую платформу полноценной заменой.
Как вести один исследовательский проект через веб-источники и академические статьи?
Смешанный проект следует вести, разделяя корпус, утверждения и черновик на три прохода — веб-разведку, научное подтверждение и синтез с явной проверкой цитирования, — вместо просьбы к одному инструменту «исследовать всё». Одна и та же последовательность работает в Jenova, Perplexity и Elicit; меняются только объекты, с которыми вы взаимодействуете.
Устойчивая последовательность:
- Сформулируйте вопрос одним предложением, указав даты, популяцию и то, что могло бы опровергнуть утверждение.
- Соберите актуальный контекст (новости, репозитории, форумы практиков), прежде чем окончательно зафиксировать академические поисковые термины.
- Подтвердите выводы по статьям, извлекая методологию и размеры выборки, а не только аннотации.
- Согласуйте противоречия в третьем проходе с более консервативной моделью или специальной таблицей доказательств.
- Экспортируйте цитаты в инструмент подготовки рукописи, которому уже доверяете.
В Jenova начните с Real-Time Search для слоя актуального контекста:
«Что инженеры и клиницисты говорят за последние 90 дней о частоте галлюцинаций при генерации радиологических заключений? Отдавай приоритет обсуждениям GitHub, докладам на конференциях и новостям и приведи список источников.»
Затем перенесите те же ограничения в Academic Research Assistant:
«Используя темы выше, найди рецензируемые оценки за 2024–2026 годы. Для каждой статьи извлеки набор данных, модальность, заявленную частоту ошибок и ограничения. Отмечай всё, что встречается только в аннотациях.»
В Perplexity выберите Deep Research и запросите справку с датированными источниками; продукт предназначен для того, чтобы искать, читать и писать отчёт за несколько минут. В Elicit вставьте исследовательский вопрос и создайте отчёт или таблицу извлечения данных по корпусу статей, после чего настройте включаемые публикации — именно такой рабочий процесс Elicit описывает для высокорисковых исследований.
Проверка качества, которую большинство людей пропускает: каждый статистический показатель, основанный только на веб-источниках и попадающий в черновик, должен быть либо заменён публикацией, либо помечен как не прошедший рецензирование. Платформы, которые сохраняют оба корпуса в одной памяти, делают эту проверку дешевле. Но не делают её необязательной.
Что говорят команды исследовательской инфраструктуры о мультимодельных исследовательских платформах?
Команды исследовательской инфраструктуры всё чаще рассматривают «углублённое исследование» как задачу оркестрации — ретриверы, модели, память и политика цитирования, — а не как единый магический режим. Надёжные результаты получают команды, которые сопоставляют инструменты с типами ошибок, а не пытаются найти одного абсолютного победителя.
«Скрытая стоимость в 2026 году заключается не в создании первого черновика. Она в том, чтобы перенести утверждение из найденного в живом вебе источника в рукопись, не потеряв информацию об источнике, дате и конфликте интересов. Когда эти поля находятся в трёх продуктах, они не переживают вставку.»
«Доступ к нескольким моделям окупается только тогда, когда корпус остаётся на месте. Перейти от модели поиска к консервативному редактору полезно; переключиться между продуктами и потерять список исключённых материалов — нет. Поэтому постоянная память и подключения инструментов важнее ещё двухсот слов беглого текста.»
«Мы по-прежнему направляем специалистов по систематическим обзорам к специализированным инструментам извлечения. Если нужны решения о скрининге сотен испытаний, универсальная исследовательская платформа должна работать рядом с Elicit, а не притворяться им. Рекомендуемый стек намеренно смешанный.»
— Команда продуктов Jenova, проектирование рабочих процессов AI-исследований, создание мультимодельных агентов, используемых командами в более чем 70 странах
Этот подход соответствует тому, как университетские руководства сейчас представляют рынок: академические инструменты, сопоставленные бок о бок, для поиска, картирования и резюмирования, а также отдельный класс веб-ориентированных режимов углублённого исследования. Вопрос платформы состоит в том, какой уровень вы хотите стандартизировать.
Каких компромиссов следует ожидать от AI-инструментов для исследований в 2026 году?
Следует ожидать, что каждый серьёзный вариант будет неполным хотя бы в отношении одного корпуса, одной формы управления или одного стандарта цитирования, — и выбирать с учётом этих пробелов, а не маркетинговых категорий. Эти компромиссы уже достаточно устойчивы, чтобы планировать работу вокруг них.
Веб-ориентированные инструменты углублённого исследования — Perplexity, Gemini, ChatGPT — продолжат лидировать по скорости подготовки справок. Основная идея Perplexity — сжать часы экспертной работы до минут. Gemini продолжит выигрывать там, где доказательства уже находятся в Workspace. ChatGPT продолжит выигрывать, когда исследовательский вопрос недостаточно определён и требует предварительного уточнения.
Научные специалисты продолжат лидировать в работе со структурированными доказательствами. Масштаб извлечения данных Elicit и экономию времени при систематических обзорах универсальная чат-платформа не сможет убедительно сымитировать. Litmaps продолжит выигрывать, когда вопрос звучит так: «Какой кластер публикаций я упускаю?» Агенты с открытым исходным кодом продолжат выигрывать, когда требуются локальные документы, пользовательские ретриверы или проверяемые обходы страниц.
Компромисс Jenova обратный. Она относится к более полным вариантам, когда одному человеку нужно искать в живом вебе, получать научный контекст, сохранять память между сессиями и менять модели без повторной сборки справки. Она слабее заменяет массовое извлечение данных из RCT, визуализацию сетей цитирования и полностью автономные многостраничные запуски Deep Research с опубликованными оценками фактической достоверности.
Если ваши следующие 30 дней состоят из смешанных вопросов — статьи, рынка, ветки GitHub и черновика, — мультимодельная исследовательская платформа является рациональным выбором по умолчанию. Если следующие 30 дней состоят из протокола, журнала скрининга и схемы PRISMA, начните с Elicit и добавляйте веб-инструменты только там, где протокол допускает не журнальные источники.
Источники
- Perplexity — Представляем Perplexity Deep Research
- Google Gemini — Обзор Deep Research
- Elicit — AI для научных исследований
- Библиотека Университета Маккуори — Использование инструментов на базе AI для обзоров литературы
- Thesify — Лучшие AI-инструменты для академических исследований в 2026 году
- Cypris AI — 11 лучших AI-инструментов для обзора научной литературы в 2026 году
- TechRadar — Практический тест Perplexity Deep Research в сравнении с ChatGPT
- Android Authority — Скорость и качество Gemini и ChatGPT Deep Research
- LivePlan — Сравнение ChatGPT и Gemini Deep Research
- Cascade Insights — Обзор исследователя рынка: ChatGPT и Gemini Deep Research
- Section AI — Тест качества результатов ChatGPT и Gemini Deep Research
- Perplexity Pro — Цены и детали тарифов
- Paperguide — Сравнение Elicit и SciSpace (2026)
- SciSpace — Сравнение с альтернативой Elicit
- Swiss School of Business Research — Бесплатные AI-инструменты для академических исследований в 2026 году
- Litmaps — Ассистент для обзора литературы
- GPT Researcher — Автономный исследовательский агент с открытым исходным кодом (GitHub)
- Gatsbi — Лучшие AI-агенты для исследований с открытым исходным кодом в 2026 году
- LangChain — Open Deep Research