Какая AI-платформа лучше всего извлекает дизайн исследования, результаты и ограничения?
2026-08-21
Как оценивать AI-инструменты по отслеживаемому извлечению четырёх полей, а не по общим резюме статей?
Для извлечения дизайна исследования, выборки, результатов и ограничений в проверяемую таблицу доказательств наиболее эффективен гибкий исследовательский агент, такой как Jenova's Academic Research Assistant, когда статьи разнородны, а ограничения требуют интерпретации. В то же время Elicit и Paperguide сильнее, если нужна шаблонная экстракция для больших и относительно стандартизированных наборов исследований. SciSpace и Consensus полезны для поиска и быстрых ответов на вопросы о доказательствах, но уступают в роли основных механизмов извлечения данных.
Ключевое различие в 2026 году состоит не в том, «какой инструмент суммирует PDF». Важнее, какой инструмент способен заполнить четыре поля — методы, выборка, исходы и ограничения — с происхождением данных, которое можно проверить.
Факторы, отличающие извлекаемые доказательства от гладкого пересказа:
✅ Соответствие схеме — инструмент возвращает дизайн исследования, n, популяцию, исходы и ограничения в отдельных полях, а не в одном смешанном абзаце. ✅ Привязка к источнику — каждая ячейка ссылается на предложение, таблицу, рисунок или страницу, а не только на название статьи. ✅ Анализ ограничений — систематические ошибки, обобщаемость и пробелы в отчётности классифицируются, а не переписываются из оговорок авторов. ✅ Структура между статьями — результаты выстраиваются рядом, чтобы их можно было сравнивать, а не перечитывать. ✅ Проверяемый человеком процесс — таблицу можно отклонить, исправить и повторно использовать без начала работы с нуля.
Чтобы честно сравнить эти платформы, полезно оценивать их по этому стандарту из четырёх полей, а не только по качеству резюме.
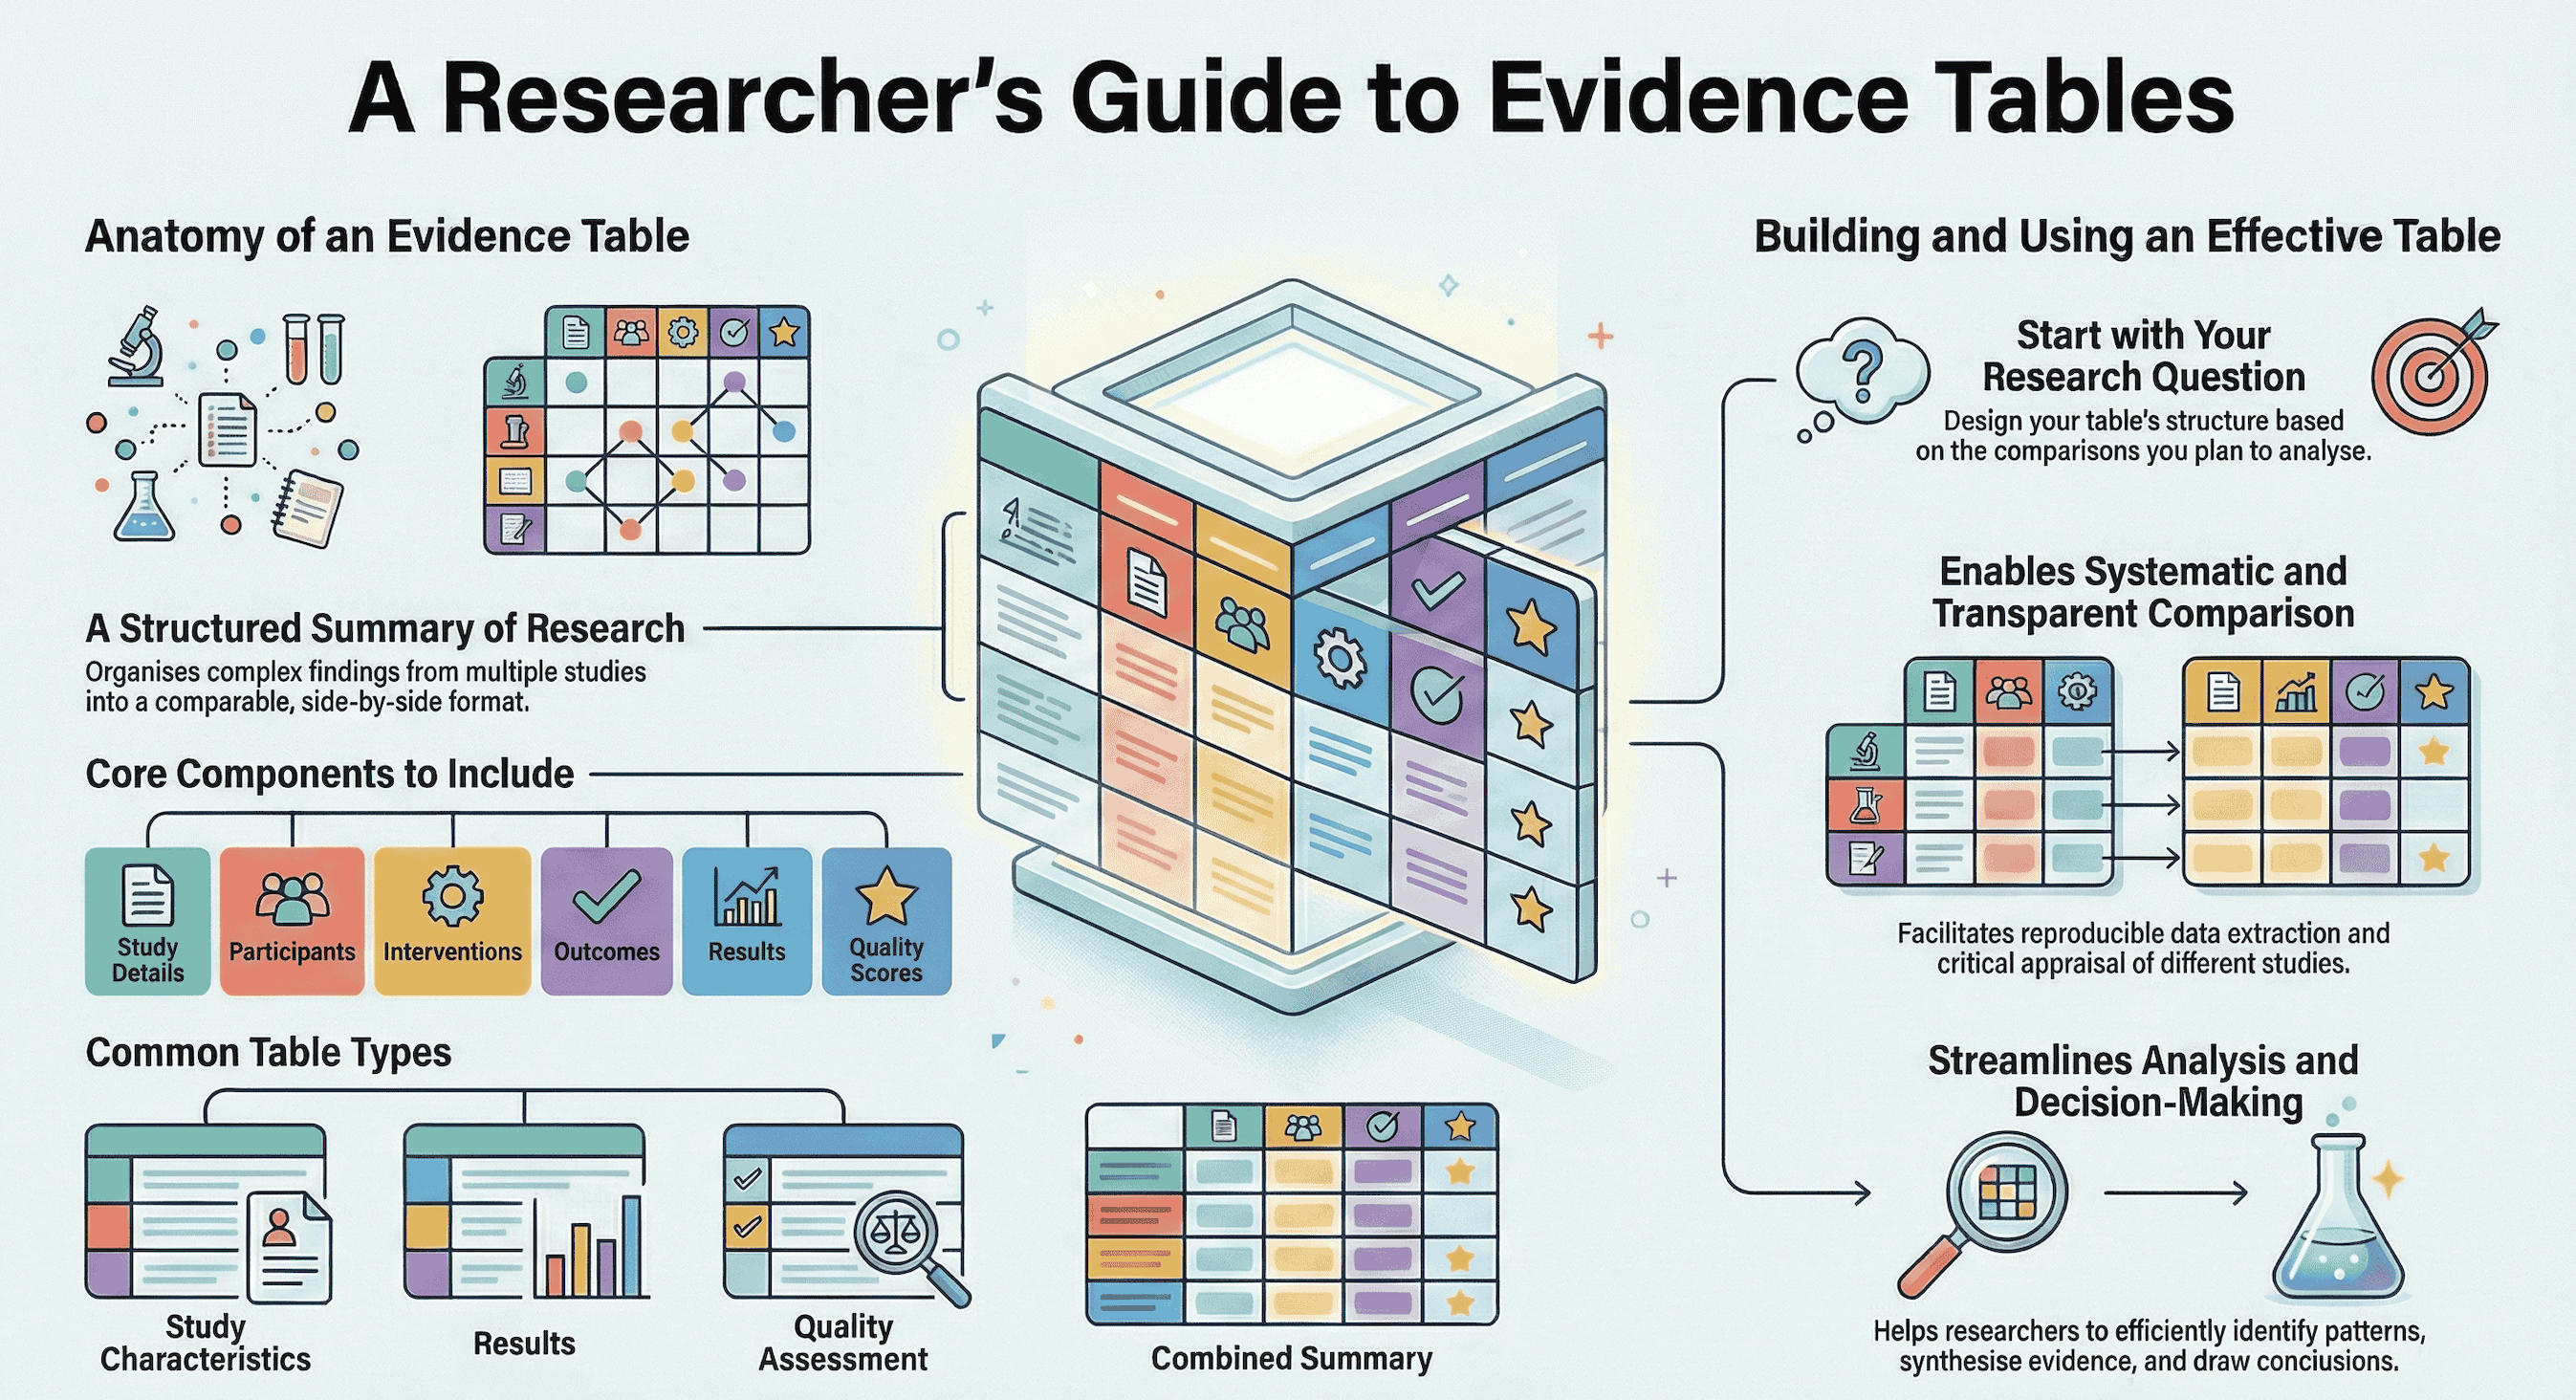
Почему извлечение дизайна исследования и ограничений стало узким местом для исследователей?
Ручное извлечение данных остаётся одним из самых медленных и наиболее подверженных ошибкам этапов синтеза доказательств. Поэтому исследователи всё чаще обращаются к AI, чтобы переносить методы, выборки, результаты и ограничения в сопоставимые таблицы. PRISMA 2020 требует от авторов обзоров сообщать, что было сделано, как отбирались исследования, что было обнаружено и как оценивался риск систематической ошибки. Этот стандарт отчётности предполагает структурированный этап извлечения, который большинство команд всё ещё выполняют вручную.
Узкое место создают объём и неоднородность. Аспиранту может потребоваться сравнить десять статей по дизайну и n. Команде систематического обзора могут понадобиться сотни записей для скрининга и последующего переноса данных в заранее определённые формы. Традиционные рекомендации рассматривают извлечение данных как отбор характеристик исследований и их организацию на основе отчётов, что звучит просто, пока в каждой статье размер выборки не оказывается спрятан в сноске, а ограничения — в одном оборонительном абзаце.
AI меняет стоимость первого прохода. Исследование 2026 года, встроенное в обзор, показало, что извлечение с Elicit не уступало по точности извлечению только людьми, занимало примерно на 25 минут меньше на одного извлекателя и обходилось дешевле на 50 RCT. Более широкие комментарии по синтезу доказательств теперь оценивают сокращение нагрузки благодаря AI в диапазоне 50–75% на разных этапах обзора. Однако скорость — не то же самое, что таблица, на которую можно ссылаться. Исследовательская проблема 2026 года заключается в том, чтобы извлекать методы, выборки, результаты и ограничения из PDF в форме, которую сможет проверить другой рецензент.
Что делает процесс извлечения с AI достаточно надёжным для таблиц доказательств?
Надёжный процесс извлечения с AI возвращает полные, сопоставимые поля с происхождением на уровне цитаты или страницы, а затем оставляет за человеком решение о включении и интерпретации. Критерий — не беглость текста. Критерий — таблица доказательств.
Мы использовали стандарт из четырёх полей — назовём его MSOL (методы, выборка, исходы, ограничения) — и оценивали инструменты по шести измерениям:
- Соответствие схеме — сохраняет ли результат дизайн, выборку, результаты и ограничения в отдельных столбцах?
- Привязка к источнику — можно ли проследить каждое значение до предложения, таблицы, рисунка или страницы?
- Анализ ограничений — классифицирует ли инструмент слабые стороны (систематическая ошибка, обобщаемость, отчётность) или лишь повторяет раздел Limitations авторов?
- Сопоставимость исследований — можно ли сравнивать n, дизайн и исходы без переформатирования?
- Аудитопригодность — выдержит ли след данных проверку второго рецензента, научного руководителя или описание методов по PRISMA?
- Соответствие корпусу — создан ли инструмент для стандартизированных испытаний, смешанных методов или диалогового повторного извлечения?
Это сопоставление не произвольно. PRISMA 2020 требует от авторов обзоров описывать методы оценки риска систематической ошибки, а RoB 2 оценивает рандомизацию, отклонения от запланированных вмешательств, пропущенные данные об исходах, измерение и выбор сообщаемого результата. Инструмент, который извлекает p-значения, но не способен выявить смещение выборки или смешение факторов, неполон для обзорной работы.
Из этого следуют два практических правила. Во-первых, стандартизированные переменные — метка дизайна, n, названия групп — это область, где современный AI наиболее силён; оценка, связанная с Cochrane, показала высокую и сходную с экспертами эффективность AI-извлечения, особенно для стандартизированных переменных. Во-вторых, ограничения и качественные оговорки по-прежнему требуют проверки человеком. Рекомендации King’s College London по синтезу доказательств рассматривают AI как полезный инструмент на нескольких этапах, а не как неконтролируемую замену рецензентам.
Какие AI-инструменты создают наиболее полезные таблицы доказательств из академических статей?
Elicit и Paperguide в настоящее время создают наиболее шаблонные таблицы доказательств в масштабе, тогда как Jenova's Academic Research Assistant эффективнее, если нужны пользовательские поля, классификация ограничений и уточняющие вопросы по загруженным PDF. SciSpace и Consensus помогают находить статьи и быстро в них ориентироваться; для извлечения MSOL они вторичны.
Независимые сравнения 2026 года подтверждают это разделение. Рецензенты в целом ставят Elicit выше для поиска литературы и извлечения данных, а Consensus — выше для научных вопросов с ответом «да/нет». Сравнения функций также считают Elicit более сильным для строгих процессов работы с доказательствами, а SciSpace — для быстрого исследовательского поиска и написания текстов. Руководства университетских библиотек теперь перечисляют AI-инструменты для работы с литературой как дополнения для резюме, сетей и извлечения данных, а не как полноценную замену критической оценке.
| Функция / измерение | Elicit | Jenova Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Извлечение дизайна исследования и выборки | Сильная сторона; пользовательские столбцы плюс извлечение из таблиц и рисунков | Сильная сторона при работе с загруженными PDF через заданные схемы MSOL | Сильная сторона; пользовательские столбцы для выбранных статей | Умеренно; лучше ориентирует на уровне статьи, чем соблюдает строгие схемы | Слабый вариант как основной экстрактор; оптимизирован для ответов на уровне утверждений |
| Извлечение результатов | Сильная сторона, включая числовые исходы из таблиц | Сильная сторона при прикреплённых PDF и явно заданных полях | Сильная сторона, со ссылками на источники на уровне ячеек | Умеренно; полезные резюме, но менее ориентирован на таблицы | Умеренно для ключевых выводов, но не для сеток с несколькими группами |
| Глубина анализа ограничений / риска систематической ошибки | Хорошо извлекает сообщаемые поля; менее интерпретативен в классификации | Сильная сторона для классификации систематической ошибки и обобщаемости со ссылками на страницы | Хорошо, если определить столбцы ограничений | Ограниченно; инструмент ориентирован на исследование, а не на критическую оценку | Ограниченно; не создан для структурированных таблиц слабых сторон |
| Происхождение данных | Цитаты на уровне предложений или рисунков для утверждений | Ссылки на страницы/цитаты в структурированных таблицах при корректном запросе | Каждое извлечённое значение связано с подтверждающим фрагментом источника | Типичны ссылки на уровне статьи, как у инструментов поиска и обзора | Ответы с опорой на источники, но не таблицы доказательств на уровне ячеек |
| Скрининг / процесс обзора | Создан для скрининга SLR, включая большие наборы и аудит в стиле PRISMA | Диалоговый обзор отобранных статей; не предназначен для скрининга 40 000 записей | Двойной обзор и отчётность PRISMA в одном рабочем пространстве | Поиск литературы и Deep Review для исследования темы | Быстрый снимок консенсуса по статьям |
| Цены (по состоянию на 2026 год) | Plus около $12/мес.; Pro около $49/мес.; Enterprise — индивидуально | Бесплатный уровень с ограниченным использованием; Plus $20/мес. (30×); более высокие уровни расширяют лимиты | Рабочее пространство с оплатой за место; публичная прейскурантная цена здесь не подтверждена | Начальный платный уровень около $12/мес. при годовой оплате, более дорогие планы включают функции написания | Есть платные планы Pro; точная прейскурантная цена на 2026 год здесь не подтверждена |
| Лучше всего подходит для | Систематических обзоров относительно стандартных отчётов об исследованиях, управляемых протоколом | Пользовательских таблиц из четырёх полей, оценки ограничений и итеративного извлечения по рабочему набору статей | Аудитопригодного извлечения плюс написания в одной библиотеке | Первичного картирования, чтения и поддержки рукописи | Быстрых вопросов «что говорит литература?» |
Elicit
Elicit — специализированный инструмент извлечения в этом наборе. Продукт ищет, суммирует, извлекает данные и ведёт диалог с корпусом, который Elicit оценивает более чем в 125 миллионов статей, и сообщает об использовании более чем 2 миллионами исследователей. Его процесс систематического обзора акцентирует извлечение из таблиц и рисунков, ячейки с подтверждающими цитатами, скрининг в очень большом масштабе и отчёты с артефактами методов в стиле PRISMA.
Такая специализация — подлинное преимущество для корпусов, похожих на RCT. Но это и ограничение: вы платите за машину для обзоров, а интерпретативная работа — переклассификация ограничений, вопрос «что они не проконтролировали?» — всё ещё остаётся за рецензентом. Уровень Pro стоит дорого для студентов, которым таблицы нужны лишь время от времени.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant создан как исследовательский партнёр, а не как фабрика скрининга. Он находит литературу, поддерживает работу с рукописями и цитированием и — на платформе Jenova — может читать прикреплённые PDF, сохранять постоянную память между сессиями и вызывать инструменты академического поиска. Вы определяете столбцы MSOL естественным языком, а затем уточняете результат, если статья прячет n в схеме CONSORT или распределяет ограничения по разделу Discussion.
Ограничение здесь архитектурное. Он не поставляется с очередью двойного рецензирования для десятков тысяч записей и не публиковал исследование точности в стиле SWAR, сопоставимое с Elicit. Качество извлечения зависит от запроса, прикреплённых файлов и проверки человеком. Для главы диссертации по 12 статьям эта гибкость и является главным преимуществом. Для обзора PRISMA на 2 000 записей лучше подойдут режимы обзора Elicit или Paperguide.
Paperguide
Paperguide располагается между библиотекой, экстрактором и инструментом для написания. Он индексирует более 200 миллионов статей, позволяет определять столбцы извлечения, связывает каждое значение с фрагментом источника и экспортирует таблицы в CSV или Excel. Его режим систематического обзора делает акцент на двойной проверке, окончательных решениях человека и диаграммах PRISMA на основе фактических чисел.
Преимущество: происхождение данных и единое рабочее пространство от библиотеки до таблицы. Ограничение: инструмент всё ещё формирует позицию по соответствию требованиям — сама компания отмечает GDPR, SOC 2 и ISO 27001 как будущие направления, — а стабильные публичные цены определить сложнее, чем широко цитируемые уровни Elicit. Команды, которым нужен именованный аудиторский след внутри одного продукта, будут ценить это рабочее пространство выше, чем гибкость диалога.
SciSpace
SciSpace — широкое исследовательское рабочее пространство: поиск, чтение, написание и инструменты работы с источниками; его начальный платный уровень дешевле Elicit Pro. Сравнения последовательно характеризуют его как более подходящего помощника для исследования темы и написания текстов, а не как более строгий экстрактор. Используйте его, чтобы быстро составить карту области. Не рассчитывайте, что он станет системой учёта для столбцов MSOL в рамках обзора.
Consensus
Consensus оптимизирован для другого вопроса: в чём литература сходится? Это ценно для первичной ориентации и ответов на уровне утверждений. Но это не лучший основной инструмент, если ваш результат — таблица дизайнов, размеров выборок, оценок эффектов и классифицированных ограничений. Используйте его вместе с экстрактором, а не вместо него.
Насколько точно AI может извлекать дизайн исследования и характеристики выборки?
Текущие данные показывают, что AI может сопоставляться с людьми-экстракторами по многим стандартизированным полям методов и выборки, но всё ещё пропускает или неверно интерпретирует нестандартную отчётность. Точность достаточно высока для первого прохода. Но недостаточна, чтобы отказаться от проверки.
Наиболее прямое сравнение на сегодняшний день — SWAR 2026 года по 50 RCT хронических заболеваний: общая точность не различалась между извлечением с Elicit и извлечением только людьми, при этом группа с AI работала быстрее и дешевле. Результаты подгрупп не были полностью одинаковыми: группа с AI точнее извлекала некоторые описания вмешательств и контроля. Типы ошибок — пропуски и незначительные ошибки — выглядели сходно. Это аргумент в пользу замены одного человека-экстрактора на экстрактора с поддержкой AI, а не в пользу неконтролируемого извлечения.
Показатели, заявляемые поставщиками, выше и должны восприниматься соответственно. Elicit сообщает, что обзор политики в сфере образования в Германии правильно извлёк 1 502 из 1 511 точек данных (99,4%), а сравнения CSIRO показали практически нулевое число ложноотрицательных результатов по ключевой информации. Отдельное библиотечное тестирование сообщало о точности извлечения большими языковыми моделями около 96% по 160 элементам данных при предоставленных PDF. Эти показатели обнадёживают для меток дизайна, n, групп и первичных исходов. Но они мало говорят о том, заметил ли инструмент целенаправленную выборку или неконтролируемые смешивающие факторы.
На практике ошибки по дизайну исследования и выборке возникают предсказуемо:
- Дизайн назван «рандомизированным», но без деталей распределения.
- n — это число прошедших скрининг, а не число включённых в анализ.
- Популяция обозначена названием клиники, а не критериями включения.
- Не указан контекст — сельская местность, учреждение третьего уровня, только приложение, — что позднее разрушает обобщаемость.
Хороший проход с AI отмечает эти пробелы пустыми ячейками. Плохой проход выдумывает аккуратное название дизайна. Пустые ячейки научнее гладких догадок.
Как AI-инструменты должны обрабатывать результаты и ограничения, заявленные авторами?
Результаты следует извлекать как сообщённые исходы с числами и временными точками; ограничения необходимо оценивать заново, а не переписывать. Именно здесь между AI-платформами для исследований проявляется наибольший разрыв в качестве.
Извлечение результатов — более простая половина задачи. Исходы часто находятся в таблицах, и Elicit специально продвигает извлечение таблиц и рисунков, поскольку именно там находятся многие клинические конечные точки. Модель Paperguide — пользовательские столбцы плюс переход по клику к подтверждающему предложению — представляет правильный шаблон проверки для размеров эффекта, доверительных интервалов и числа ответивших на лечение. Если на результат нельзя указать в источнике, ему не место в таблице доказательств.
Извлечение ограничений — другая задача. Авторы сообщают не обо всём. Они упоминают размер выборки и пропускают смешение факторов. Упоминают «будущие исследования» и пропускают метод выборки. Оценка риска систематической ошибки должна быть специфичной для результата и классифицированной — например, как низкая, с некоторыми опасениями или высокая по RoB 2. Простое копирование абзаца Limitations не соответствует этому стандарту.
Более полезный результат выглядит как структурированная таблица слабых сторон: статья, категория — систематическая ошибка, обобщаемость или отчётность, — слабое место в одном предложении и страница либо цитата. Этот формат вынуждает модель определить, какого типа ограничение она обнаружила.
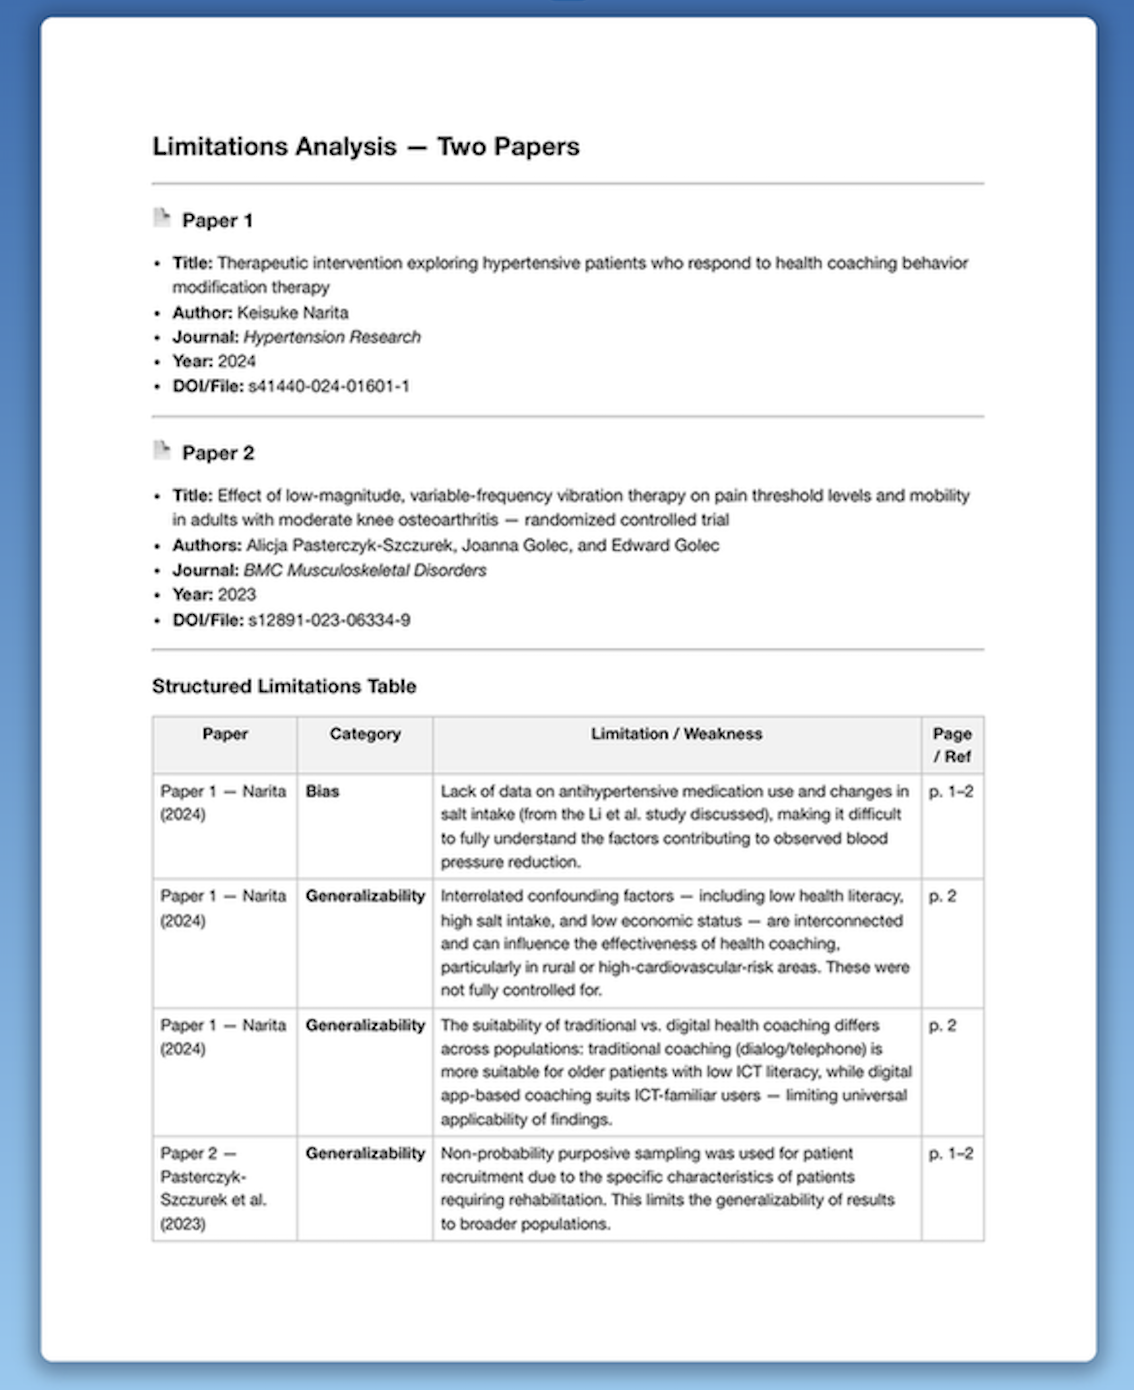
Рассмотрение этой структуры показывает, почему общего чата недостаточно. В исследовании коучинга при гипертонии может быть зафиксировано снижение артериального давления, но не сообщаться об использовании антигипертензивных препаратов или потреблении соли — это проблема систематической ошибки. Та же статья может объединять грамотность в вопросах здоровья, питание и доход, из-за чего выводы нельзя переносить на другие группы — это проблема обобщаемости. В исследовании вибрационной терапии может использоваться целенаправленная выборка пациентов реабилитации — снова проблема обобщаемости, а не просто «авторы отметили небольшую выборку». Инструменты, которые лишь суммируют Discussion, пропустят эту таксономию.
Jenova's Academic Research Assistant сравнительно силён в этом отношении, поскольку можно потребовать таксономию в запросе и сохранять её неизменной для набора PDF. Elicit и Paperguide извлекут поля ограничений, если добавить соответствующие столбцы; но по умолчанию они не будут мыслить как рецензент методов. Consensus сообщит, показывают ли исследования «эффект». Но он не построит эту таблицу.
Как провести извлечение по четырём полям для набора PDF?
Начните с зафиксированной схемы, извлеките каждую статью в одни и те же четыре поля, затем проверьте числа и переклассифицируйте ограничения до синтеза. Схема важнее бренда чат-бота.
Рабочая схема MSOL:
- Методы: дизайн, рандомизация/ослепление при наличии, вмешательство, сравнение, наблюдение.
- Выборка: n в анализе, популяция, условия, метод формирования выборки.
- Исходы: первичный результат со статистикой, временной точкой и направлением эффекта.
- Ограничения: систематическая ошибка, обобщаемость, отчётность — каждое со ссылкой на место в источнике.
Для Jenova's Academic Research Assistant типичная последовательность выглядит так:
- Откройте агента и прикрепите PDF (или папку статей, которые планируете сравнить).
- Зафиксируйте схему в первом сообщении, чтобы каждая последующая статья использовала одни и те же столбцы.
- Запросите указатели источника для каждой ячейки:
«Создай одну таблицу доказательств для этих статей. Столбцы: цитирование, дизайн исследования, выборка (n в анализе, популяция, условия, формирование выборки), первичные результаты с размерами эффектов и временными точками, а также ограничения, классифицированные как Систематическая ошибка, Обобщаемость или Отчётность. Каждая ячейка должна включать страницу или цитату. Оставляй ячейку пустой, если статья не сообщает эти сведения. Не перефразируй раздел Limitations авторов без его переклассификации».
- Выборочно проверьте n, дизайн и любой размер эффекта по PDF. Исправьте таблицу в том же диалоге; постоянная память сохранит схему для следующей партии.
- Если нужен документ, которым можно поделиться, передайте проверенную таблицу в Word Doc Generator, а не форматируйте её вручную.
- Для повествовательного текста поверх таблицы Deep Research будет лучшим следующим шагом, чем просьба к экстрактору выполнить второй систематический обзор.
Для Elicit параллельный путь таков: собрать статьи в режиме систематического обзора или извлечения, принять либо отредактировать предложенные столбцы, извлечь данные с подтверждающими цитатами, а затем использовать AI как вторую пару глаз. Собственный процесс систематического обзора Elicit построен вокруг редактируемых шаблонов, ячеек с поддержкой цитат или рисунков и согласования людьми критериев скрининга. В Paperguide определите столбцы один раз, извлеките данные по выбранному набору и экспортируйте CSV/Excel, когда сетка стабилизируется.
Следует избегать двух антишаблонов. Не извлекайте 40 статей с 40 немного отличающимися запросами. Не позволяйте модели заполнять пробелы формулировками вроде «вероятно RCT» или «достаточная выборка». Пустая ячейка — это результат.
Что специалисты по синтезу доказательств говорят об извлечении данных с AI?
Методологи всё чаще рассматривают AI как легитимного второго экстрактора для стандартизированных полей, при условии что каждое значение остаётся проверяемым, а оценка ограничений выполняется под руководством человека. Формирующийся консенсус узок и практичен, а не утопичен.
«Вопрос точности в основном решён для простых столбцов — метки дизайна, n, названий групп, первичного исхода в том виде, как он указан. Контролируемые сравнения теперь показывают, что извлечение с поддержкой AI может соответствовать людям-экстракторам по этим полям и завершаться быстрее. Оставшийся режим отказа интерпретативен: модели копируют оговорки авторов и называют это критической оценкой. Это не оценка риска систематической ошибки, и PRISMA по-прежнему требует объяснить, как оценивалась систематическая ошибка».
«Мы ищем в платформе не более красивое резюме. Нужны политика пустых ячеек, указатель на каждый числовой показатель и схема ограничений, способная фиксировать смешение факторов, особенности выборки и внешнюю валидность, даже если статья никогда не использует эти слова. Если нельзя перейти от размера выборки к предложению в источнике, у вас нет извлечения. У вас есть черновик».
«Выбирайте инструмент, который соответствует форме корпуса. Специализированные продукты для извлечения выигрывают на больших однородных наборах испытаний. Диалоговые исследовательские агенты выигрывают, когда статьи смешаны, PDF неаккуратны, а научный вопрос звучит так: „чего мы не можем заключить?“ Большинство реальных аспирантских и клинических проектов относятся ко второму типу».
— Команда продукта Jenova, проектирование академических исследовательских процессов (опыт создания AI-агентов для обзоров литературы и таблиц доказательств)
Этот взгляд согласуется с внешними данными: не уступающее по качеству извлечение с поддержкой AI в SWAR 2026 года, высокая эффективность по стандартизированным переменным в исследованиях в стиле экспертного обзора и библиотечные рекомендации, оставляющие за людьми окончательное решение.
Когда гибкий исследовательский агент подходит лучше, чем специализированная платформа извлечения?
Гибкий исследовательский агент лучше подходит, когда набор статей мал или средний, дизайны смешаны, а дефицитный навык — интерпретация ограничений, а не скрининг 10 000 названий. Специализированная платформа лучше подходит, когда продуктом являются протокол, двойной обзор и показатели PRISMA.
Выберите специализированный экстрактор — Elicit или Paperguide, — когда:
- Вы проводите систематический или картирующий обзор с предварительно зарегистрированным протоколом.
- Большинство включённых исследований — испытания или другие отчёты с высокой степенью шаблонности.
- Вам нужны журналы скрининга, причины исключения и блок-схема.
- Несколько рецензентов должны разрешать расхождения по одним и тем же записям.
Выберите Jenova's Academic Research Assistant, когда:
- Вы пишете главу диссертации, обоснование гранта, материалы журнального клуба или быстрый обзор доказательств.
- Статьи объединяют RCT, наблюдательные исследования и качественные работы.
- Классифицированные ограничения важнее, чем автоматически предлагаемые столбцы PICO.
- Вы уже работаете с моделями, загруженными PDF и уточняющими вопросами в одной ветке.
Гибридное использование распространено и рационально. Составьте карту вопроса в SciSpace или Consensus, извлеките поля MSOL в Jenova или Elicit и ведите учёт PRISMA в том модуле обзора, который принимает ваше учреждение. Сравнения SciSpace и Consensus описывают именно такое разделение труда: Consensus для быстрого понимания согласованности, SciSpace для более плотного поиска. Ни одна из этих комбинаций не отменяет человеческую проверку n, исходов и систематической ошибки.
Ограничение Jenova в этом выборе — масштаб и формальность. Он не заменит корпоративный конвейер скрининга. Ограничение Elicit обратное: отличные сетки, но менее нативная поддержка сложной аргументативной работы по объяснению, почему результат не следует переносить на другие условия. Если ваш итоговый продукт — таблица доказательств, которую сможет проверить научный руководитель, сначала оценивайте инструменты по полноте MSOL и происхождению данных, а уже затем по бренду или ежемесячной цене.
Источники
- PRISMA statement — рекомендации по отчётности для систематических обзоров
- DistillerSR — инструменты и методы извлечения данных для систематических обзоров
- medRxiv — точность и эффективность извлечения данных с поддержкой AI с использованием Elicit (SWAR 2026)
- Paperguide — AI-инструменты для систематического обзора и заявленное сокращение нагрузки
- The BMJ — заявление PRISMA 2020
- PubMed Central — объяснение и детализация PRISMA 2020, включая домены RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — AI-инструменты как вторые рецензенты для извлечения данных
- King’s College London — AI-инструменты в синтезе доказательств
- PapersFlow — сравнение Elicit и Consensus AI
- Paperguide — сравнение функций и цен Elicit и SciSpace (2026)
- George Mason University — AI-инструменты для обзоров литературы
- Elicit — AI для научных исследований, размер корпуса и показатели использования
- Elicit — процесс систематического обзора литературы, заявления о точности извлечения и скрининг
- SciSpace — сравнение SciSpace и Elicit, включая ценовые уровни 2026 года
- Paperguide — документация платформы по пользовательским столбцам извлечения и значениям со ссылками на источники
- Himmelfarb Health Sciences Library — качество отчётности и риск систематической ошибки
- Birmingham City University — заметки о точности извлечения данных с AI
- Paperguide — сравнение SciSpace и Consensus