Какие AI-помощники для исследований наиболее рекомендуются в 2026 году?
2026-08-21
Чем ведущие AI-помощники для исследований отличаются по достоверности цитирования, охвату баз данных и полноте рабочих процессов?
Наиболее часто рекомендуемые AI-помощники для исследований в 2026 году — Elicit для структурированного извлечения доказательств, SciSpace для понимания содержания научных статей, Paperguide для процессов от обзора литературы до черновика, Scite для анализа контекста цитирования и Academic Research Assistant от Jenova для непрерывной многомодельной работы с литературой, охватывающей поиск, синтез и подготовку рукописи. Важен не выбор единственного «победителя», а соответствие инструмента трём параметрам: какую часть научных публикаций он реально может искать, основаны ли его утверждения на цитированиях и покрывает ли он одну исследовательскую задачу или весь рабочий процесс.
Ключевые факторы, которые в 2026 году отличают полезного академического помощника от обычного чат-бота:
✅ Достоверность цитирования — ответы со ссылками на реальные статьи и достаточными библиографическими данными для проверки, а не гладкие, но непроверяемые резюме
✅ Охват литературы — доступ к крупным научным индексам (порядка 125 миллионов статей в Elicit и более 300 миллионов публикаций в Scite), а также к серой литературе при необходимости
✅ Работа с доказательствами — скрининг, извлечение и синтез, которые может проверить второй исследователь
✅ Полнота рабочего процесса — объединены ли поиск, чтение, цитирование и подготовка текста в одном месте или требуют набора инструментов
✅ Проектирование с участием человека — функции, поддерживающие верификацию, поскольку текущие доказательства не поддерживают использование генеративного AI для синтеза доказательств без человеческого контроля
Эти пять критериев образуют практическую основу для приведённых ниже сравнений. При выборе между такими инструментами полезнее считать их специалистами, работающими на общем исследовательском конвейере, а не взаимозаменяемыми продуктами категории «AI для научных статей».
Почему специализированные AI-помощники для исследований стали востребованы среди академического сообщества?
Специализированные AI-помощники для исследований перешли из категории необязательных дополнений в стандартную академическую инфраструктуру, поскольку одновременно изменились объём публикаций, распространённость их использования студентами и институциональная политика. Научное издательское дело теперь выпускает более трёх миллионов новых статей ежегодно, поэтому поиск по ключевым словам и ручной скрининг без вспомогательных средств становятся всё более затратными по времени.
Данные о внедрении в высшем образовании однозначны. Опрос HEPI о генеративном AI среди студентов за 2025 год показал, что 92% британских студентов бакалавриата использовали генеративный AI, по сравнению с 66% в 2024 году, а 88% применяли его при выполнении оценочных заданий. Наиболее распространёнными академическими сценариями были объяснение понятий, суммирование статей и предложение исследовательских идей — именно для этих задач и создаются исследовательские помощники.
Институты всё ещё догоняют этот процесс. Опрос UNESCO показал, что две трети учреждений высшего образования уже имеют или разрабатывают рекомендации по использованию AI, однако HEPI обнаружил, что лишь 36% студентов прошли обучение навыкам работы с AI в своём учебном заведении. Именно этот разрыв объясняет, почему для работы с литературой рекомендуют специализированных помощников — инструменты, которые ищут по научным базам данных, прикрепляют цитирования и сохраняют исследовательский след, — а не универсальные чат-боты.
Ещё один фактор — риск. Респонденты HEPI назвали страх ложных результатов или галлюцинаций (51%) одной из главных причин не использовать AI; этот показатель почти совпадает с опасениями по поводу списывания. Помощники, извлекающие данные из академических индексов и раскрывающие источники, напрямую противодействуют этому типу ошибок.
Какие критерии должны определять выбор AI-помощника для исследований?
Исследователям следует выбирать AI-помощника для исследований по шестимерной модели — охват, достоверность, извлечение, написание, постоянство контекста и соотношение стоимости с возможностями, — а не по спискам функций или рейтингам «лучший в целом». Проверка по этой модели «Охват–Достоверность–Рабочий процесс» (CIW) делает компромиссы очевидными: инструмент может лидировать в объяснении PDF, но быть слабым в систематическом скрининге, либо отлично работать с контекстом цитирования, почти не помогая с подготовкой текста.
Шесть параметров, взвешенных для типичного академического использования:
- Охват литературы — ищет ли инструмент по крупному научному корпусу, нескольким базам данных или лишь по одному индексу, например Semantic Scholar?
- Достоверность цитирования — связаны ли утверждения с идентифицируемыми статьями и можно ли увидеть, поддерживают или оспаривают их последующие исследования?
- Извлечение доказательств — можно ли переносить методы, размеры выборки, результаты и ограничения в сопоставимые структуры?
- Поддержка написания — создаёт ли инструмент черновики или редактирует текст с учётом библиотеки источников либо ограничивается резюме?
- Постоянство контекста — помнит ли он многомесячный проект диссертации или сбрасывается после каждого сеанса?
- Соотношение стоимости с возможностями — что реально включает бесплатный тариф и на каком этапе платные лимиты становятся ограничением для объёма систематического обзора?
Методологические рекомендации должны рассматриваться наряду с функциями продукта. Библиотекари по синтезу доказательств из King’s College London отмечают, что инструменты AI не могут заменить традиционные методы систематического обзора, и их лучше считать вспомогательными средствами. Руководство OHSU по систематическим обзорам аналогично считает AI наиболее полезным на поздних, трудоёмких этапах, таких как поддержка скрининга и извлечение данных, но не как замену разработке протокола или поиску по базам данных.
Из этого следует практическое правило: если результат нельзя проверить — нет списка источников, логики включения и способа повторить поиск, — перед вами средство для чтения, а не исследовательский помощник.
Как Jenova, Elicit, SciSpace, Paperguide и Scite сравниваются в академических рабочих процессах?
Academic Research Assistant от Jenova наиболее силён в длительной диалоговой исследовательской работе с постоянной памятью и доступом к нескольким моделям; Elicit — в структурированном извлечении; SciSpace — в чтении сложных PDF; Paperguide — в объединении поиска, таблиц обзора и подготовки текста с цитатами в одной подписке; Scite — в демонстрации того, как именно цитируется статья. Ни один из пяти инструментов не доминирует по всем параметрам CIW, поэтому «наиболее рекомендуемые» в 2026 году — это короткий список, а не одно название.
| Параметр | Academic Research Assistant от Jenova | Elicit | SciSpace | Paperguide | Scite |
|---|---|---|---|---|---|
| Охват литературы | Поиск по актуальным академическим и веб-источникам через инструменты платформы, включая научные базы данных | Семантический поиск по 125 миллионам статей; используется более чем 2 миллионами исследователей | Более 200 миллионов статей и загруженные PDF | Поиск по вопросам в более чем 200 миллионах статей | Более 300 миллионов научных публикаций, проиндексированных для контекста цитирования |
| Достоверность цитирования | Ответы с опорой на источники; верификация пользователем всё ещё необходима | Резюме с цитированиями; документированные пробелы в чувствительности по сравнению с традиционным поиском | Ответы, основанные на открытой статье | Поиск, таблицы и помощник для написания с цитированиями | Показывает, поддерживают ли цитирования утверждение, противоречат ему или лишь упоминают его |
| Извлечение доказательств | Диалоговое извлечение и синтез между сеансами | Структурированные столбцы и процессы систематического обзора | Резюме на уровне статьи, методы и вопросы-ответы | Таблицы литературы и отчёты Deep Research | Извлечение контекста цитирования, но не таблицы результатов |
| Поддержка написания | Подготовка рукописи и управление цитированиями | Отчёты и резюме, но не полноценные статьи | Объяснения внутри PDF | AI Paper Writer, создающий черновики на основе библиотеки источников | Не является средой для написания текста |
| Постоянство контекста | Неограниченная история чатов и межсеансовая память | На основе проектов и рабочих процессов | Сеансы чтения, ориентированные на документы | Рабочие книги и библиотеки источников | Сохранённые статьи и представления цитирований |
| Цены (по состоянию на 2026 год) | Бесплатный тариф; Plus за $20 в месяц с объёмом использования в 30× выше бесплатного | Бесплатные и платные тарифы | Бесплатные и платные тарифы | Бесплатно; Plus $12 в месяц; Pro $24 в месяц | Бесплатные и платные тарифы (платные цены здесь не проверены) |
| Лучше всего подходит для | Многомесячных исследовательских диалогов, сочетающих поиск, синтез и подготовку текста | Скрининга и извлечения данных из определённого набора статей | Понимания сложной статьи непосредственно в процессе чтения | Полного цикла от обзора до черновика на одной платформе | Проверки того, как литература рассматривает конкретное утверждение |
Независимые сравнения подтверждают такое разделение. Анализ Paperguide 2026 года, сопоставляющий Elicit и SciSpace, пришёл к выводу, что Elicit сильнее для строгих рабочих процессов на основе доказательств, тогда как SciSpace лучше подходит для быстрого поискового изучения темы. Собственный бенчмарк SciSpace на 200 запросах сообщил о 26,3 высокорелевантных статьях на запрос для Deep Review, что опередило Elicit и Consensus в этом внутреннем тесте — это полезный сигнал, но его следует рассматривать как результат тестирования поставщика, а не как замену поиску, валидированному библиотекарями.
Честные ограничения так же важны, как и преимущества. Jenova не предлагает встроенный индекс на 200 миллионов статей или сетку скрининга в стиле PRISMA; это исследовательский агент с актуальным поиском, памятью и поддержкой написания, а не DistillerSR. Было показано, что воспроизводимость и полнота поиска Elicit уступают классическому скринингу баз данных. SciSpace остаётся скорее инструментом для чтения, чем механизмом систематического обзора. Лимиты Deep Research и рабочих книг Paperguide по-прежнему ограничивают масштаб автоматизации на младших тарифах. Scite не напишет за вас раздел с обзором связанных исследований.
Насколько различается достоверность цитирования у AI-помощников для исследований?
Достоверность цитирования различается между инструментами сильнее, чем качество их интерфейсов, и именно этот параметр чаще всего определяет, безопасно ли использовать помощника в диссертации, грантовой заявке или систематическом обзоре. Scite специально создан, чтобы показывать как утверждение поддерживается или оспаривается в более чем 300 миллионах статей; Elicit, Paperguide и SciSpace извлекают результаты из крупных корпусов статей и прикрепляют ссылки, тогда как универсальные чат-боты часто не делают ни того, ни другого.
Этот тип сбоя хорошо задокументирован. В методологическом исследовании 2025 года, сравнивавшем Elicit с обзором зонтикового типа, выполненным людьми, исследователи обнаружили, что Elicit выявил лишь 17,6% исследований, включённых при классическом скрининге, но при этом нашёл три релевантные статьи, пропущенные человеческим поиском. Воспроизводимость была нестабильной при трёх одинаковых запросах. Авторы также сообщили, что при создании резюме Elicit неверно процитировал протокол обзора — это серьёзная ошибка достоверности, а не косметический недостаток.
Именно поэтому библиотечные руководства постоянно повторяют одно и то же ограничение. Систематический обзор 2025 года по генеративному AI в синтезе доказательств заключил, что текущие данные не поддерживают применение GenAI без участия человека. Служба систематических обзоров Memorial Sloan Kettering также возлагает на специалистов по синтезу доказательств ответственность за любой используемый ими AI, включая само решение о его применении.
Полезная шкала достоверности для 2026 года:
- Уровень 1 — бегло, но без цитирований. Ответы универсальных чатов. Неприемлемо для академических утверждений.
- Уровень 2 — поиск с цитированиями. Инструмент называет статьи. Вам всё ещё нужно проверить, что статья существует и действительно содержит заявленное.
- Уровень 3 — контекст цитирования. Инструменты наподобие Scite показывают, согласны ли последующие статьи с работой, противоречат ей или только упоминают её.
- Уровень 4 — проверяемый синтез. Критерии включения, ячейки с привязкой к источникам и выгрузки, которые соавтор или библиотекарь могут повторно выполнить.
На практике Academic Research Assistant от Jenova действует на уровнях 2–3: он ищет актуальные источники и должен обосновывать утверждения, но не является графом контекста цитирования, как Scite, и не сертифицирует диаграмму потока PRISMA. Его сочетание со Scite для проверки того, как цитируется статья, или с менеджером библиографии для канонической записи часто надёжнее, чем требовать от одного помощника самостоятельно контролировать себя.
Как AI-помощники работают с синтезом доказательств и систематическими обзорами?
AI-помощники сегодня охватывают отдельные части синтеза доказательств, особенно скрининг заголовков и аннотаций и извлечение данных, но пока не заменяют систематический обзор, основанный на протоколе. Рекомендуемая модель в 2026 году — автоматизация под контролем человека на конкретных этапах, а не обзоры в один клик.
Наиболее сильная эмпирическая поддержка относится к скринингу. Обзор обзоров 2026 года обнаружил рецензируемые доказательства готовности AI к скринингу заголовков и аннотаций под контролем человека, при ограниченных доказательствах для других задач синтеза. Инструмент скрининга AIM Review сообщил о сокращении рабочей нагрузки от 20% до 95% в шести реальных обзорах, однако это результат для скрининга, а не разрешение автоматизировать выводы. Сравнение, связанное с Cochrane, показало, что Elicit не выполнял поиск с достаточно высокой чувствительностью, чтобы заменить традиционный поиск литературы, хотя его точность может быть полезна для предварительных запросов и выявления уникальных дополнительных исследований.
Рабочие процессы продуктов сходятся к одному и тому же шестиступенчатому каркасу, хорошо иллюстрируемому конвейером синтеза доказательств Paperguide: определить вопрос, часто в форме PICO/PICOC, выполнить поиск по большому корпусу, провести скрининг с сигналами качества, извлечь данные в таблицы с привязкой к источникам, синтезировать материал с цитированиями и экспортировать результаты.
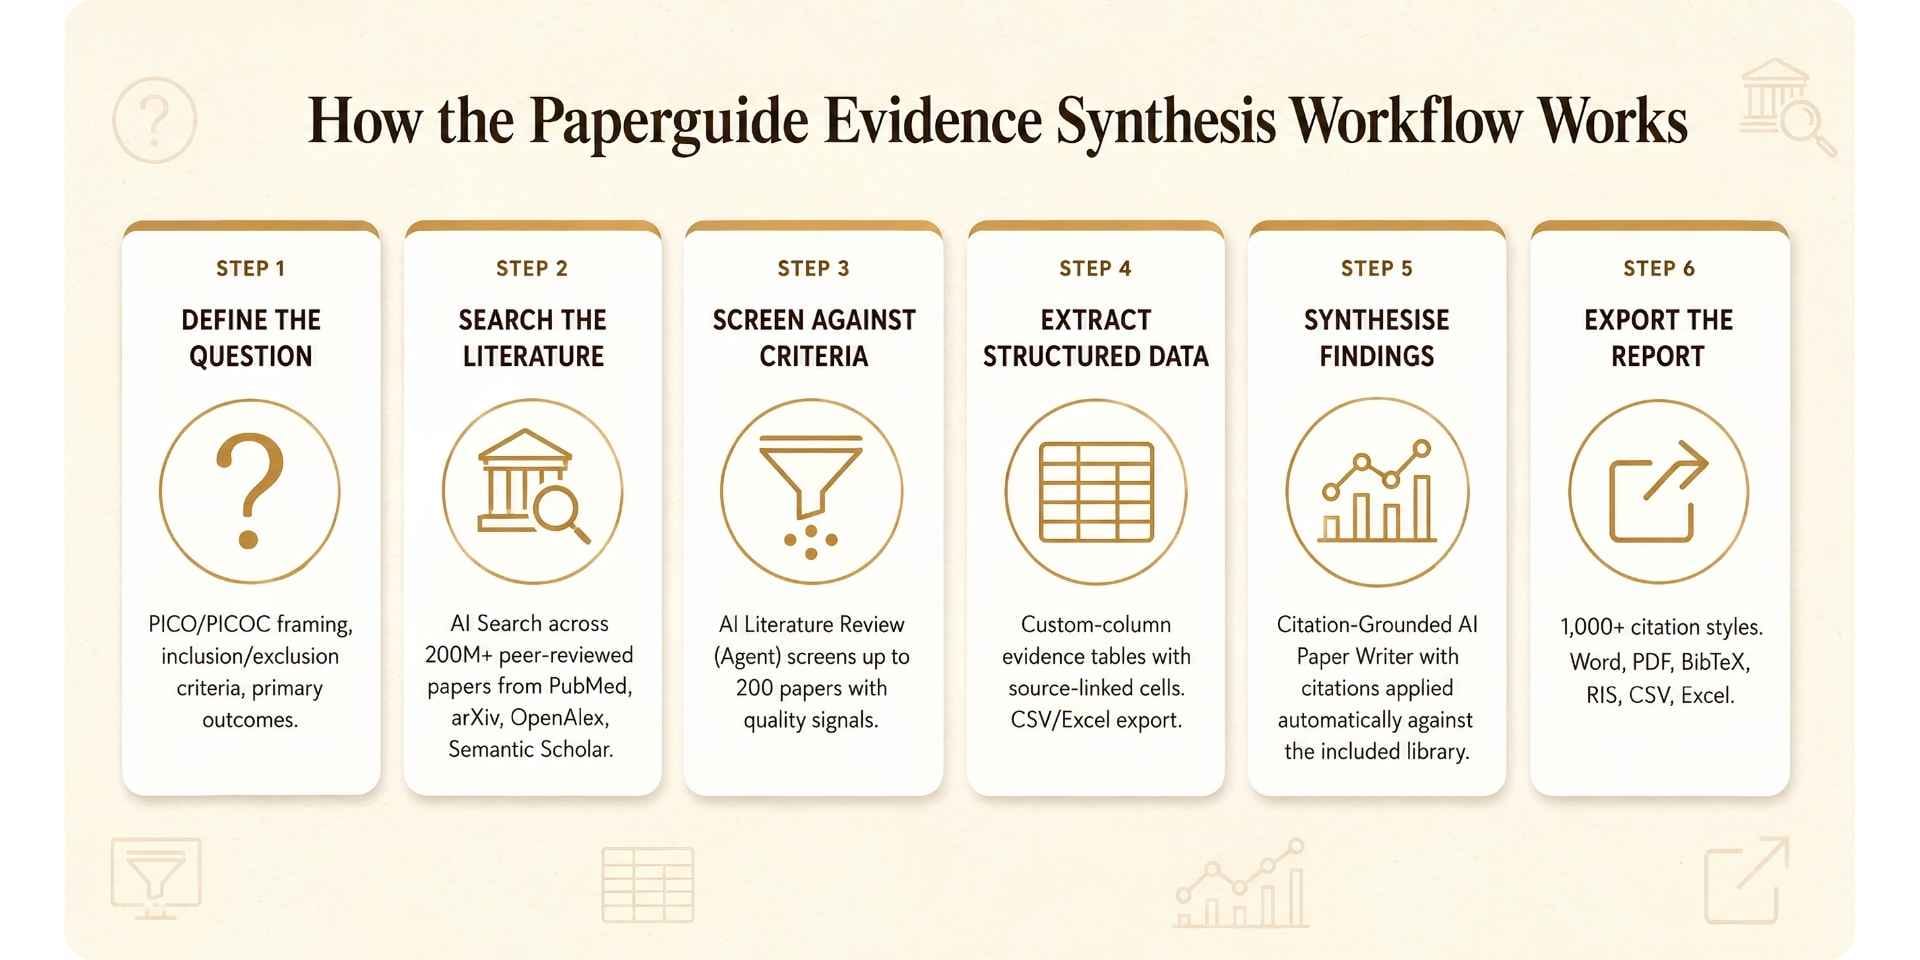
Эта схема хорошо показывает работу, но не доказывает, что кнопка «Deep Research» любого поставщика соответствует стандартам Cochrane, JBI или Campbell. Совместная позиция Cochrane, Campbell Collaboration, JBI и Collaboration for Environmental Evidence 2025 года рассматривает AI как поддержку, которая не должна ухудшать качество или доверие. В собственных материалах Paperguide описан скрининг порядка сотен статей за один запуск и лимиты на отчёты Deep Research даже в платных тарифах — например, 50 отчётов в месяц на Pro. Это быстрый синтез, а не постоянно обновляемый обзор Cochrane.
Jenova занимает в этом конвейере место аналитика, работающего поверх него: формулирует вопросы PICO, сопоставляет таблицы извлечения, находит статьи, пропущенные первым поиском, и готовит повествовательный синтез, помня предыдущие решения о включении. Она слабее в роли специализированного интерфейса скрининга. Elicit остаётся более естественным выбором, когда задача звучит так: «превратить 80 аннотаций в таблицу методов и результатов». SciSpace более естественен, когда задача: «объяснить этот раздел методов и это уравнение».
Как провести обзор литературы с AI-помощником для исследований?
Наибольшую пользу от AI-помощника для исследований даёт чётко ограниченный вопрос, правило включения и этап верификации, а не запрос «сделай обзор литературы» одним промптом. Один и тот же цикл работает в разных инструментах; меняется лишь интерфейс.
Надёжная последовательность:
- Сформулируйте вопрос в форме PICO или эквивалентной модели — популяция, вмешательство или явление, сравнение, результаты и типы исследований.
- Определите правила включения и исключения до начала любого суммирования.
- Запустите поиск более чем в одной системе — в специализированном академическом индексе и через актуальный веб-поиск или поиск научной литературы, — поскольку ни один корпус не является полным.
- Извлекайте данные в таблицу (исследование, дизайн, n, результаты, ограничения), а не принимайте готовый прозаический обзор.
- Выборочно проверьте каждое цитирование по PDF или странице издателя.
- Пишите на основе таблицы, а не на основе нарративной памяти помощника о таблице.
Для Academic Research Assistant от Jenova настройка начинается с одного сообщения, задающего рамки:
«Я пишу нарративный обзор адаптивных систем обучения в STEM-программах бакалавриата. Включи эмпирические исследования за 2020–2026 годы. Исключи статьи с мнениями и работы не на английском языке. Создай таблицу с авторами, годом, дизайном, выборкой, результатами и ограничениями, затем перечисли вероятные пробелы. Отмечай любое цитирование, которое не можешь проверить.»
Затем выполните второй проход и попросите агента получить полные библиографические данные, а также отделить высококачественные доказательства от близких по теме, но не входящих в рамки работ. Поскольку агент сохраняет межсеансовую память, последующие чаты могут продолжать ту же логику включения без повторного объяснения протокола.
Для Elicit аналогичным началом будет исследовательский вопрос с фильтрами по типу исследования и году, а затем пользовательские столбцы для интересующих вас переменных. Считайте первый набор результатов дополнением, ориентированным на точность. Оценка BMC Medical Research Methodology признала Elicit дополнительным, а не достаточным самостоятельным инструментом поиска, и это правильная практическая позиция.
В SciSpace загрузите или откройте PDF и задавайте вопросы, привязанные к документу: «Какова была первичная конечная точка?» или «Какие ограничения признают авторы?», — вместо запроса самостоятельного обзора литературы. Такой подход использует преимущество продукта — объяснение содержания непосредственно в документе.
Серая литература, политические документы, препринты и форумы практиков часто находятся за пределами академических индексов. Агент Real-Time Search от Jenova является естественным дополнением, когда обзору также необходимы обсуждения Reddit, реализации на GitHub, новости или другие нежурнальные источники, после чего академическое ядро можно передать обратно Academic Research Assistant.
Что команды исследовательской инфраструктуры говорят о научной работе с поддержкой AI?
Команды исследовательской инфраструктуры считают AI-помощников для исследований высокоэффективными партнёрами для подготовки текстов и скрининга, которые всё ещё терпят неудачу при закрытом поиске по полноте, воспроизводимости и точности цитирования. Поэтому рекомендуемый подход — постоянный контекст в сочетании с обязательной верификацией, а не полностью автоматизированные обзоры.
«Проблема цитирований состоит не в том, что модели иногда ошибаются. Она в том, что они звучат убедительно, когда ошибаются. В академических процессах мы видели, как помощники выдумывали правдоподобные DOI, объединяли две реальные статьи в одну и цитировали протокол так, будто это результаты. Поэтому мы оцениваем инструменты по тому, может ли соавтор проверить след: список источников, правило включения и путь обратно к PDF, — а не по тому, насколько отшлифованно выглядит первый абзац.»
«Постоянная память меняет экономику работы над диссертацией сильнее, чем ещё один инструмент суммирования. Литературный обзор PhD — это объект, существующий от шести до восемнадцати месяцев. Если помощник забыл, что в марте вы исключили перекрёстные исследования, в октябре он будет снова их рекомендовать. Межсеансовая память в таких условиях — не удобная функция; это способ сохранить протокол при плотном расписании.»
«Доступ к нескольким моделям важен по простой причине: разным этапам нужны разные профили ошибок. Для скрининга и извлечения требуются осторожные, насыщенные цитированиями ответы. Для текста раздела связанных работ нужен более сильный автор. Ни одна модель не лучшая в обоих случаях, а привязка лаборатории к одному поставщику создаёт то же узкое место, которое эти инструменты должны были устранить.»
— Команда продукта Jenova, проектирование академических рабочих процессов, восемь лет создания исследовательских агентов для студентов и преподавателей
Эта позиция согласуется с библиотечной литературой. van Dijk и коллеги утверждают, что AI в систематических обзорах перспективен при корректном использовании — как контролируемая поддержка, а не как основной рецензент. Разрабатываемый стандарт отчётности PRISMA-AI пытается сделать такой контроль видимым в публикациях, и именно в этом направлении уже движутся серьёзные лаборатории.
Какой AI-помощник для исследований подходит аспирантам, командам систематических обзоров и преподавателям?
Оптимальный помощник зависит от работы, которую нужно выполнить в ближайшие 30 дней: поискового чтения, структурированного извлечения, проверки цитирований или долгосрочного проекта, объединяющего все три задачи. Соответствие профиля пользователя инструменту позволяет не переплачивать за полный исследовательский комплект, когда нужен лишь помощник для PDF, и не использовать помощника для PDF так, как будто это платформа систематического обзора.
Аспиранты и авторы диссертаций. Academic Research Assistant от Jenova — сильный вариант по умолчанию, когда проект длится месяцами, источники накапливаются, а одни и те же правила включения нужно применять повторно. SciSpace лучше дополняет его в дни, проведённые за двумя или тремя сложными статьями. Paperguide конкурентоспособен, если вы хотите получить поиск, таблицы и черновик с цитированиями, не покидая экосистему одного поставщика.
Команды систематических обзоров и синтеза доказательств. Elicit и специализированные инструменты скрининга, такие как Rayyan, DistillerSR и аналоги, должны находиться в центре процесса при двойном скрининге людьми. Библиотечный консенсус в 2026 году по-прежнему состоит в том, что AI является вспомогательным средством для поиска, скрининга и извлечения. Отчёты Deep Research от Paperguide способны ускорить обзор области; их не следует представлять как результат уровня Cochrane без традиционного поиска и документированного скрининга.
Преподаватели, авторы грантовых заявок и участники журнальных клубов. Scite — самый быстрый способ спросить: «Подтвердился ли этот результат?» Инструменты вопросов и ответов в стиле Consensus полезны для первичного ответа на вопрос «Что говорит область?», при соблюдении того же правила верификации. Jenova полезна, когда преподаватель переключается между литературой, черновиками и ответами рецензентам и нуждается в сохранении контекста.
Студенты бакалавриата и обучающихся магистерских программ. Обычно достаточно инструмента, ориентированного на чтение, такого как SciSpace, в сочетании с проверкой цитирований. Вывод HEPI о том, что 51% студентов беспокоятся о галлюцинациях, отражает правильную интуицию: выбирайте помощников, которые показывают источники, и никогда не вставляйте непроверенные ссылки в библиографию.
Когда не следует использовать ни один из этих инструментов в качестве основного. Разработка протокола, оценка риска систематической ошибки и окончательные решения о включении остаются задачами человека. Авторское право также ограничивает загрузку PDF: KCL отмечает, что загрузка защищённого авторским правом полного текста в инструмент AI обычно запрещена правообладателями. Прежде чем загрузить платный PDF в любой помощник, проверьте как условия издателя, так и политику своего учреждения.
Таким образом, наиболее рекомендуемые AI-помощники для исследований в 2026 году — это небольшой набор специалистов, используемых совместно: Elicit или Paperguide для структурированной работы с доказательствами, SciSpace для понимания статей, Scite для контекста цитирования и Academic Research Assistant от Jenova, когда работа представляет собой длительный диалог с опорой на источники, который должен помнить проект. Критерий качества — не самый беглый интерфейс. Это сочетание инструментов, оставляющее след, который вы были бы готовы защитить на устном экзамене, в рецензировании или при аудите.
Источники
- Elicit — AI для научных исследований (125 миллионов статей; более 2 миллионов исследователей)
- Scite — AI для исследований с ответами, основанными на цитированиях, по более чем 300 миллионам статей
- Paperguide — AI-платформа для рабочих процессов научных исследований
- Paperguide — 7 лучших инструментов AI-помощников для научных исследований в 2026 году
- HEPI — Опрос студентов о генеративном AI за 2025 год
- ERIC / Министерство образования США — Опрос студентов о генеративном AI за 2025 год, аналитическая записка HEPI 61
- UNESCO — Две трети учреждений высшего образования уже имеют или разрабатывают рекомендации по использованию AI
- Библиотечные руководства King’s College London — Инструменты AI в синтезе доказательств
- Библиотека OHSU — AI в систематических обзорах
- Memorial Sloan Kettering Cancer Center — Служба систематических обзоров: AI и обзоры
- Bernard et al., BMC Medical Research Methodology — Использование искусственного интеллекта для систематического обзора (PMC11921719)
- Paperguide — Elicit и SciSpace: сравнение инструментов AI для исследований (2026)
- SciSpace Literature Review — внутренний бенчмарк на 200 запросах в сравнении с Elicit и Consensus
- Paperguide — 5 лучших инструментов AI для систематического обзора в 2026 году
- ScienceDirect — Меняет ли генеративный AI академические практики во всём мире?
- MDPI — Мета-обзор генеративного AI в образовании: тенденции (показатели HEPI 92% / 66%)